Показываю пошаговый процесс интеграции сервиса Scraper Creators с ChatGPT через протокол MCP для автоматического сбора данных и глубокого анализа видеоконтента из YouTube, TikTok и Instagram. Рассматриваю настройку специализированного проекта, развертывание системных файлов и конфигурацию уровней разбора — от выявления кликбейта до генерации готовых сценариев рилс. Материал предназначен для авторов контента, маркетологов и исследователей, стремящихся автоматизировать мониторинг инфополя без ручного просмотра видео.
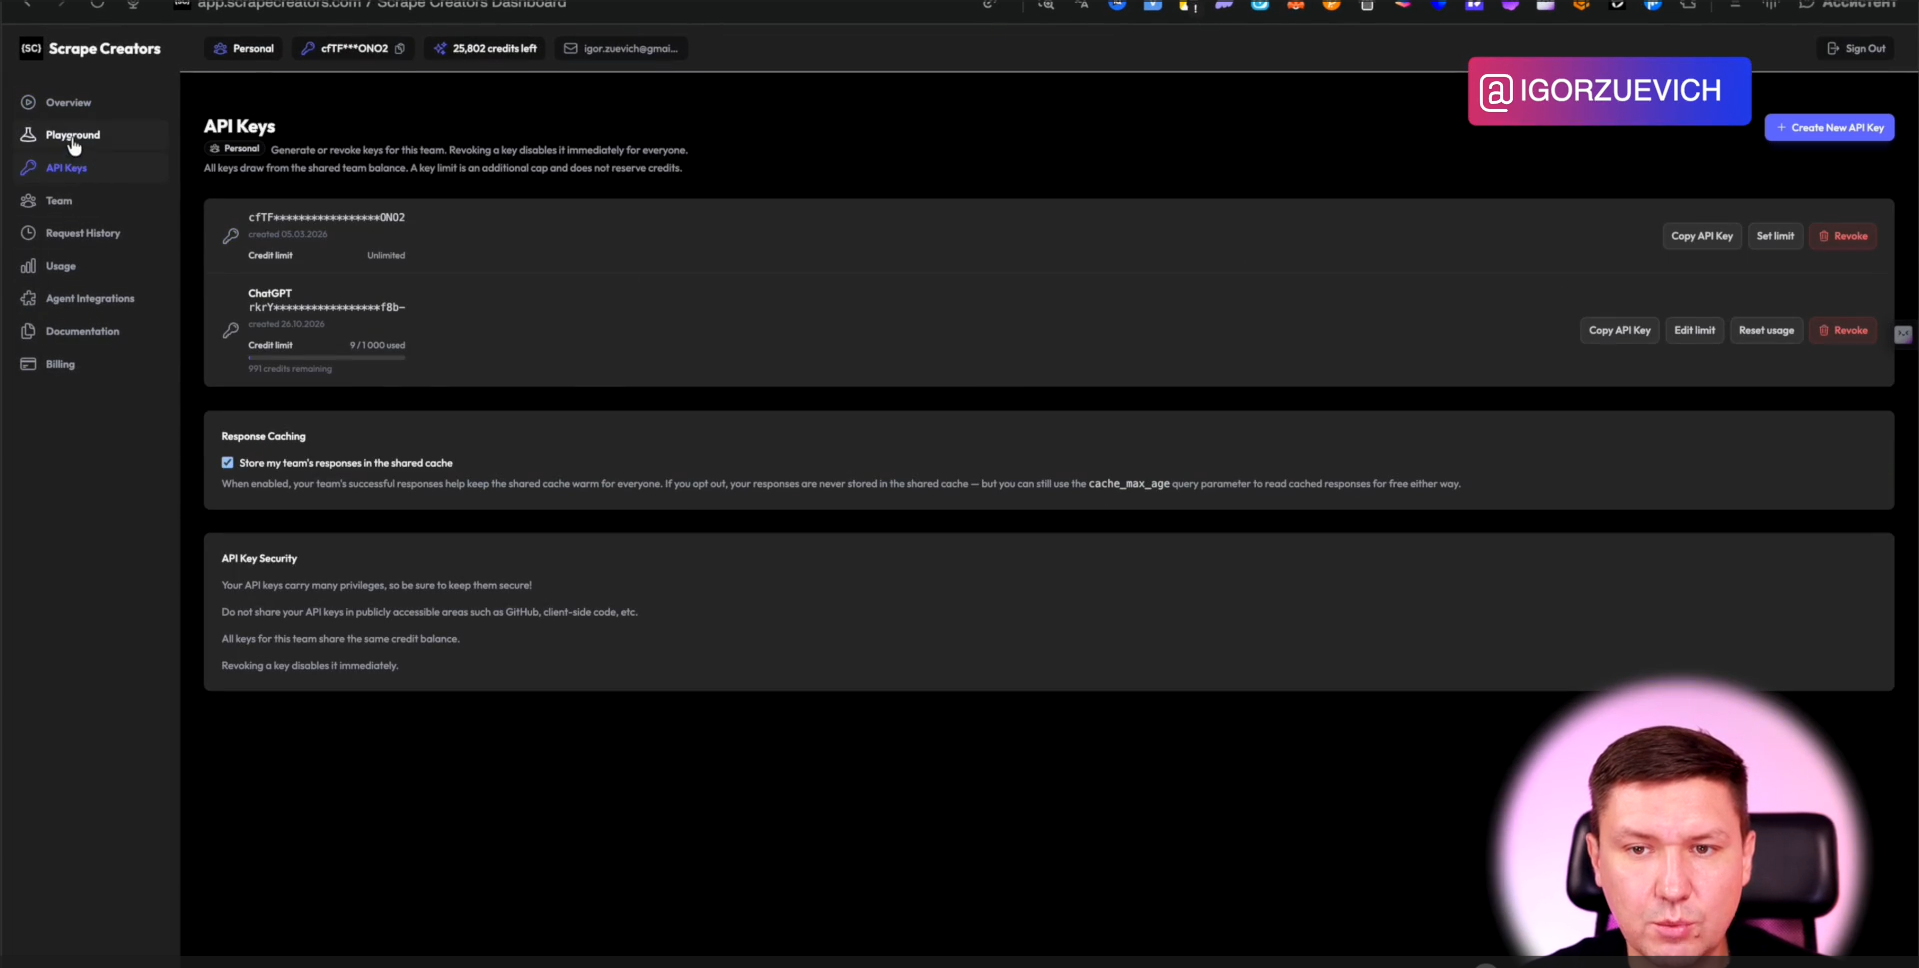
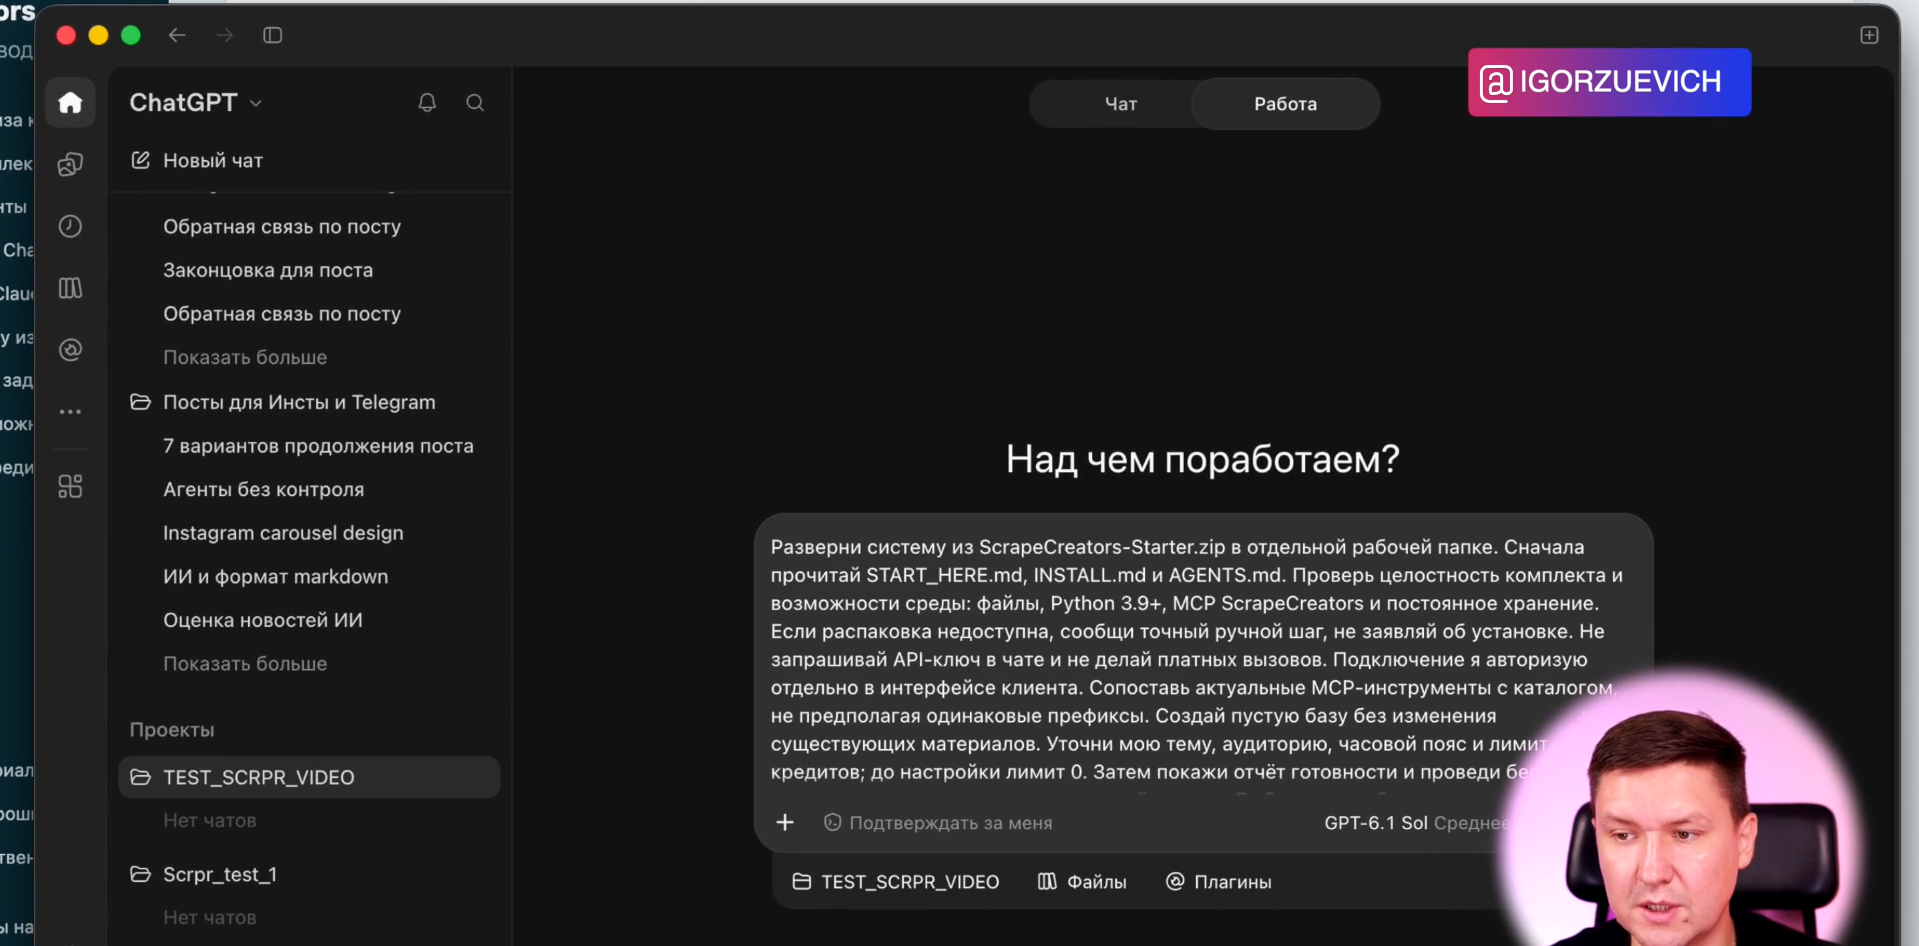
00:00–01:08 Введение в систему автоматического анализа контента через AI-агентов. 01:08–02:51 Отправка ссылки в ChatGPT и доступные форматы разбора видео. 02:51–04:53 Архитектура проекта и разбор структуры итогового отчета. 04:53–06:20 Инструмент Scraper Creators и обзор комплекта инструкций. 06:20–07:05 Содержимое архива с файлами развертывания. 07:05–08:57 Подключение MCP-сервера и генерация API-ключа в Scraper Creators. 08:57–10:19 Модель тарификации сервиса и расход кредитов на разборы. 10:19–11:03 Создание проекта и привязка рабочей директории в ChatGPT. 11:03–12:17 Развертывание системных промптов и базы знаний из архива. 12:17–14:38 Тестирование анализа нового YouTube-видео и расчет токенов. 14:38–15:37 Сохранение отчетов во второй мозг на базе Obsidian и мониторинг рынка. 15:37–16:53 Генерация сценариев для Reels на базе спарсенного контента.
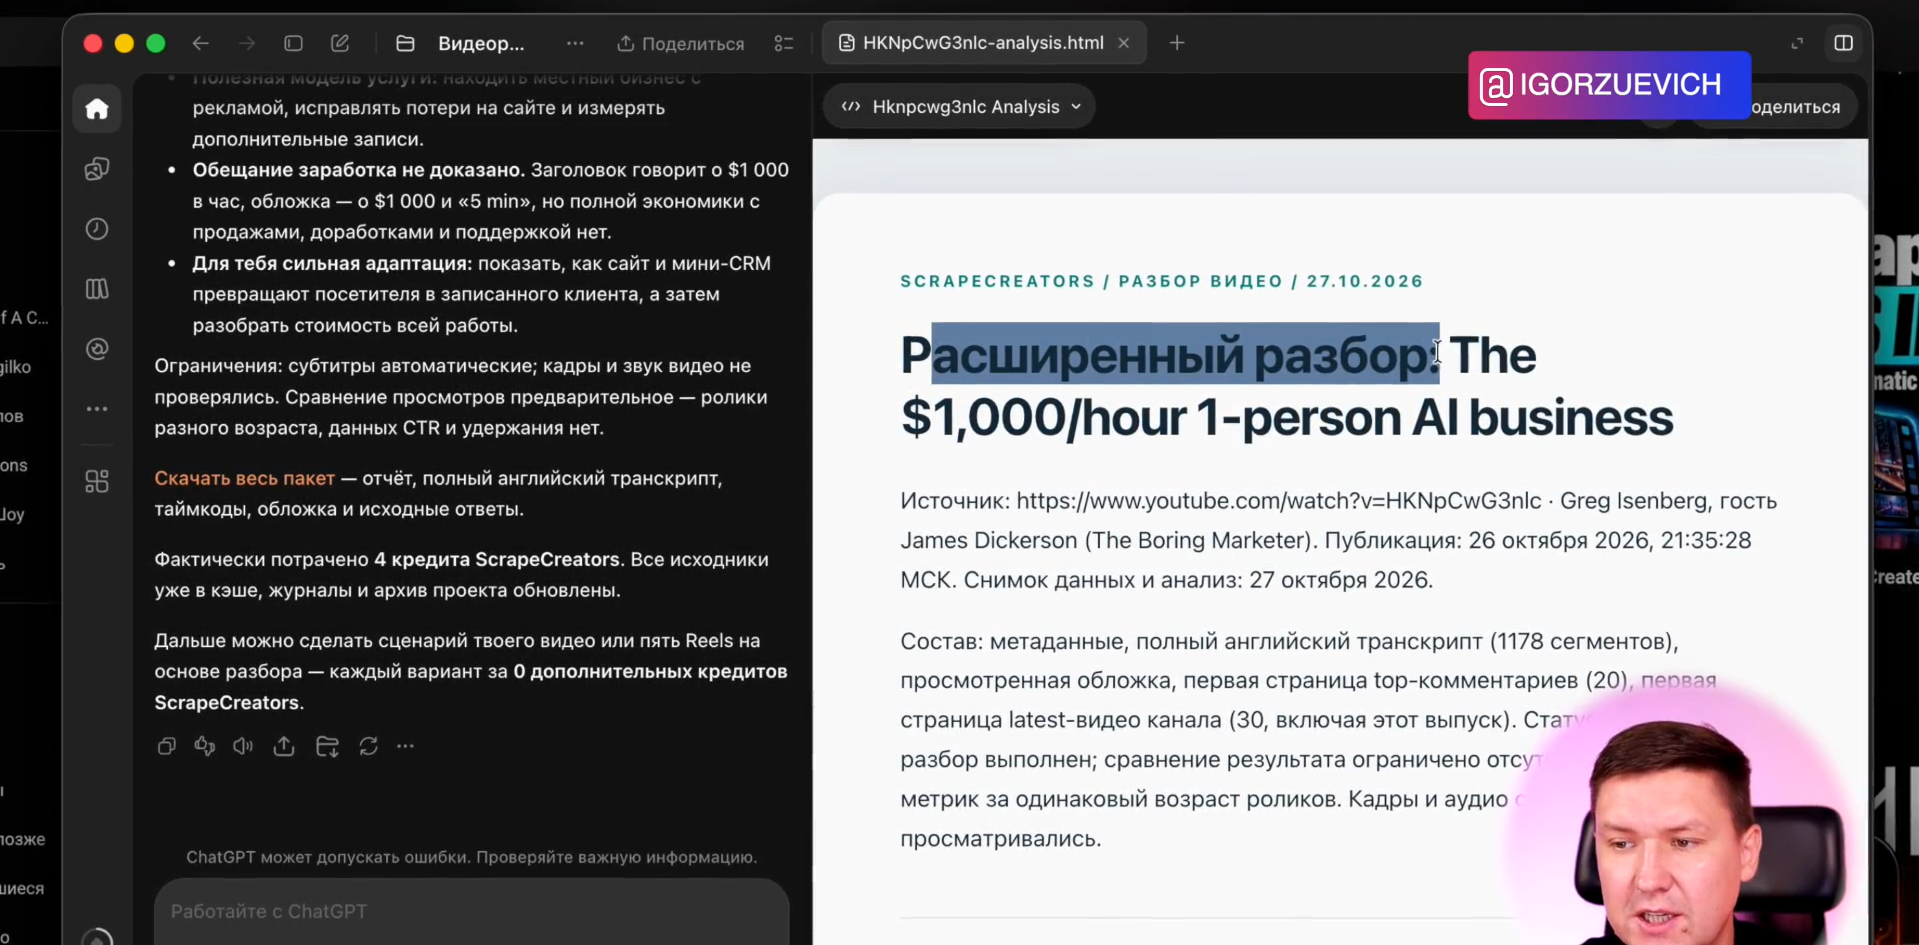
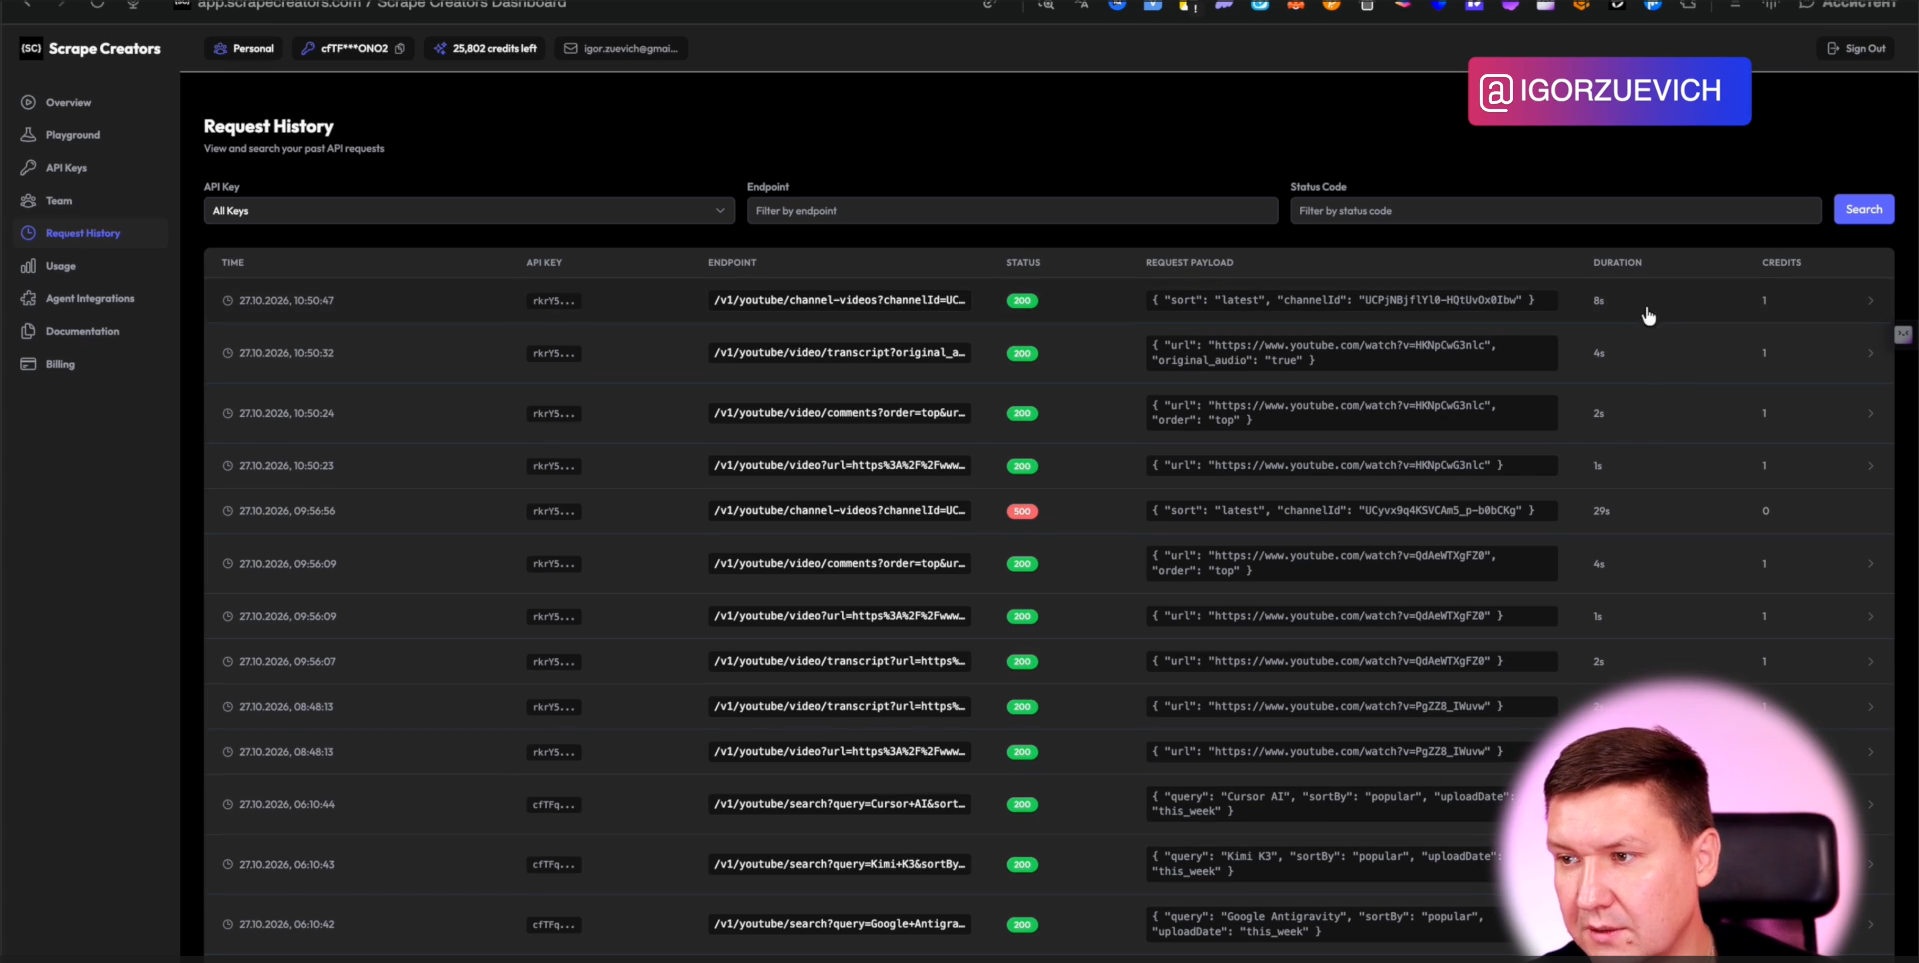
Прямая отправка ссылки на YouTube в чат не выдает результатов из-за технических ограничений платформы на прямой парсинг, что требует подключения внешних MCP-модулей. ИИ сопоставляет обещания в заголовке с реальными данными из транскрипта, автоматически вскрывая кликбейт и отсутствие доказательной базы у спикера. Анализ обложки оценивает не только визуальную привлекательность, но и конкретные причины высокого CTR, а также слабые места оформления. Подключение Scraper Creators через протокол MCP превращает стандартную языковую модель в агентную систему с внешними инструментами сбора данных. При регистрации начисляется 1000 бесплатных кредитов, чего хватает примерно на 250 глубоких разборов при расходе около 4 токенов на комплексную задачу.
Первичную конфигурацию проекта целесообразно выполнять на мощных моделях, а регулярный разбор ссылок переводить на более экономичные модели за счет четких инструкций внутри системы. Полный парсинг метаданных, субтитров и контекста видео занимает около 8 секунд, полностью снимая необходимость ручного просмотра. Интеграция выгрузки в базу знаний Obsidian позволяет накапливать смысловой архив по рынку и выявлять макротренды без потери контекста. Транскрибированный виральный материал служит основой для автоматического создания адаптированных сценариев под короткие форматы (Reels, Shorts).