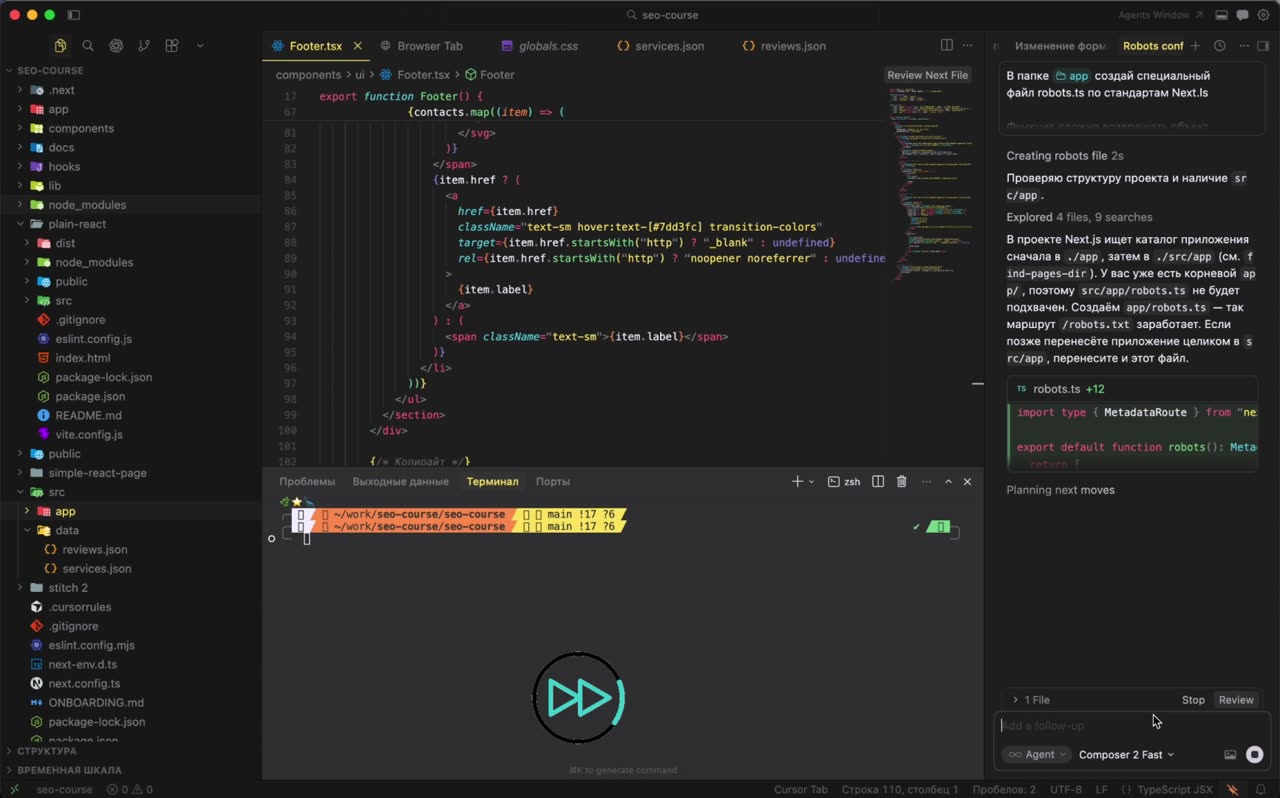
В этом уроке мы с помощью Cursor создаём два файла, по которым поисковик находит страницы сайта: robots.txt и sitemap.xml. Раньше их делали через сторонние сервисы, теперь они генерируются автоматически из JSON с данными. Добавляем новый курс в services.json, и он сразу попадает в карту сайта. Затем мы убираем лишнюю страницу из sitemap и разбираем разницу между Disallow и Noindex. Урок рассчитан на тех, кто делает сайт с фабрикой посадочных страниц на Next.js и хочет, чтобы Яндекс и Google обходили его правильно.
0:00–1:03 Вступление. Мета-теги уже оптимизированы, но поисковик должен сначала найти страницы. Если фабрика генерирует сотни статей или услуг, без карты сайта уходит краулинговый бюджет, и часть страниц может остаться ненайденной.
1:03–2:48 Промпт для robots.txt. Просим Cursor создать в папке app файл robots.ts по стандартам Next.js, разрешить обход для всех агентов и добавить ссылку на…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.