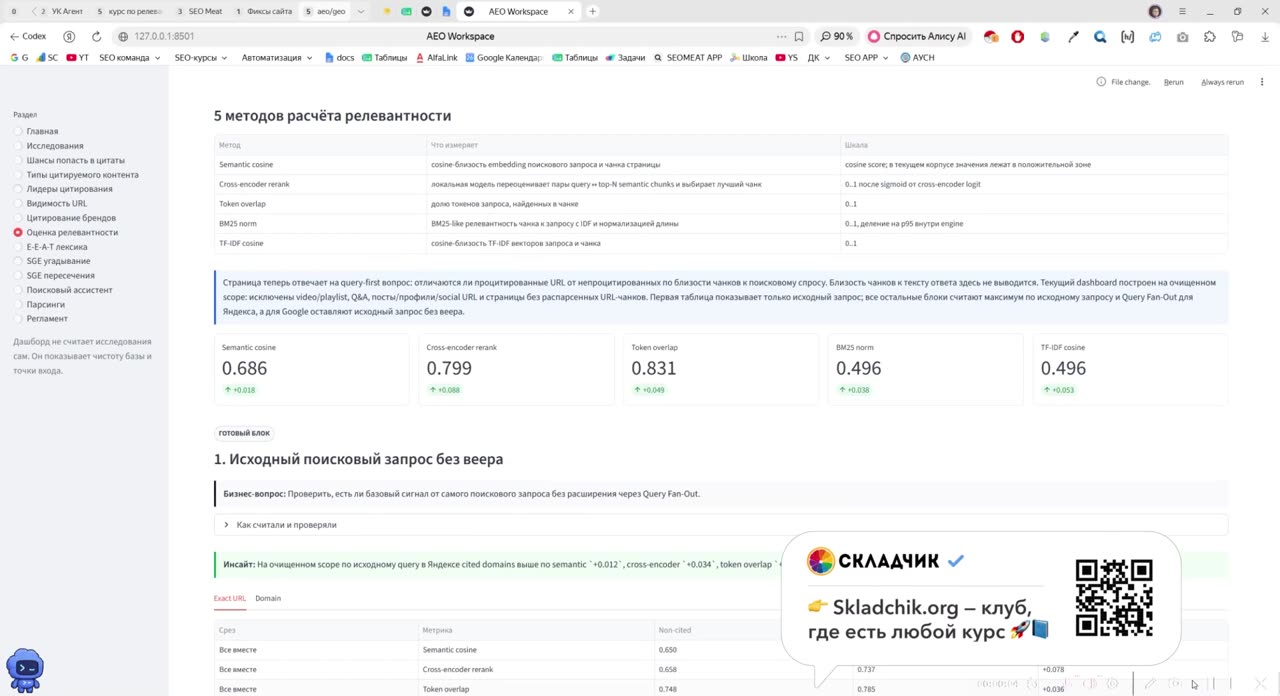
В уроке я показываю исследование текстовой релевантности фрагментов страниц для AEO. Страницы разбиты на чанки, каждый чанк оценён пятью методами относительно запроса, после чего сравниваются цитируемые и нецитируемые страницы в Яндексе и Google. Из урока видно, какие методы определения релевантности работают лучше, насколько мала разница между цитируемыми и нецитируемыми фрагментами и что стоит делать со страницами, которые находятся в топе, но не цитируются. Материал полезен SEO-специалистам, которые оптимизируют тексты под ИИ-ответы.
0:00–1:49 Как проводилось исследование. Страницы разделены на чанки несколькими методами с ориентиром на заголовки, как это делают поисковые системы. Каждый чанк векторизован для косинусной близости, для лексических методов (TF-IDF, BM25, Token Overlap) использовались леммы и n-граммы, для Cross-Encoder отдельной подготовки не требовалось. Близость чанков к запросу измерялась с учётом query fan-out для Яндекса; для Google веер не применялся, так как он и без того очень точен на топ-10. Главный вывод: текстовая релевантность фрагментов важна и для обычного SEO, и для AEO. 1:49–3:15 Сравнение методов. Лучше всего работает Cross-Encoder: он пропускает через веса модели и запрос, и фрагмент и даёт самый большой контраст между релевантными и нерелевантными чанками. Следом идут обычный TF-IDF и Token Overlap (вхождение слов запроса в текст). BM25…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.