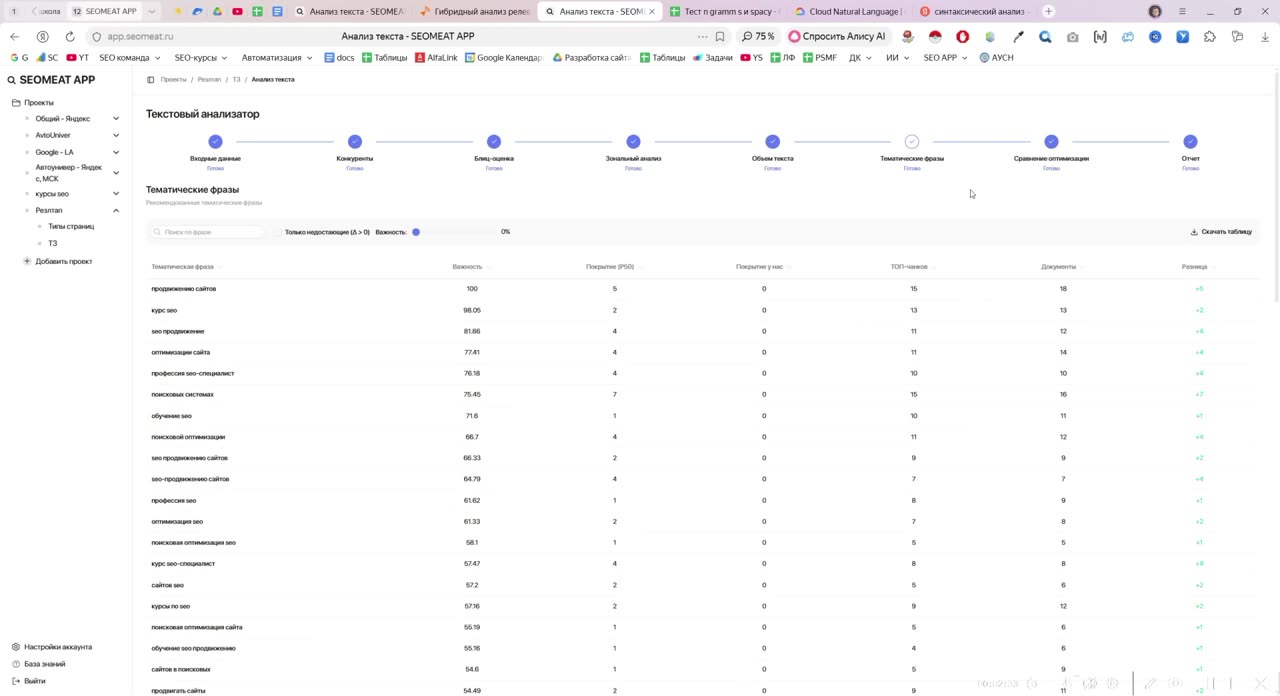
Технический урок про то, как в анализаторе устроено выделение тематических фраз. Рассказываю, почему обычный перебор N-грамм выдаёт в рекомендации водянистые связки вроде «которые хотят», и как мы вместо этого разбираем предложения по частям речи и оставляем только осмысленные связки — объект и его свойства. Показываю демонстрационную таблицу с шаблонами частей речи, антипример из другого сервиса и то, как отчёт выглядит у нас. Отдельно разбираю проблемы, которые мы ловили при отладке: нейросеть — это не статистика, починишь одно место и может отлететь другое, и часть багов видна прямо в кадре. В конце объясняю, почему тематические фразы дают лучшую оптимизацию, чем зональный анализ, и в каком порядке я рекомендую оптимизировать страницу. Урок для тех, кто хочет понимать, откуда в отчёте берутся фразы, а не просто вписывать их по списку.
0:00–1:06 Основная задача, которую мы решали, — выделять осмысленные фразы из предложений, а не просто перебирать N-граммы. Разбираю на предложении «чтобы всегда коржи оставались хрустящие». При переборе мы режем его на все возможные куски, выписываем их списком и оцениваем, как часто они встречаются. И вполне может оказаться, что водянистая связка «чтобы всегда» встречается часто, хотя никакого смысла в ней нет — это просто слово-связка в предложении. Смысловая основа здесь только «коржи оставались хрустящие» или даже короче — «коржи хрустящие».
1:07–2:14 На новоязе это называется семантический триплет: есть основной объект, есть слово-связка и есть его свойства или действия над ним. По сути это школьный синтаксический разбор: берём предложение, разбиваем на части, смотрим, какое слово с чем связано, и анализируем основное слово вместе с теми словами, которые к нему относятся. Сейчас то же самое делается быстро и просто языковой моделью, причём даже не большой — обычной language model, которой достаточно понять, что в предложении есть существительное и прилагательное, и связать их в одну фразу «коржи хрустящие».
2:15–2:53 Этим путём мы и идём: в тематических фразах мы работаем с частями речи. Берём тексты конкурентов, можем в том числе нарезать их на N-граммы — биграммы, триграммы, четырёхграммы — и дополнительно сделать синтаксический…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.