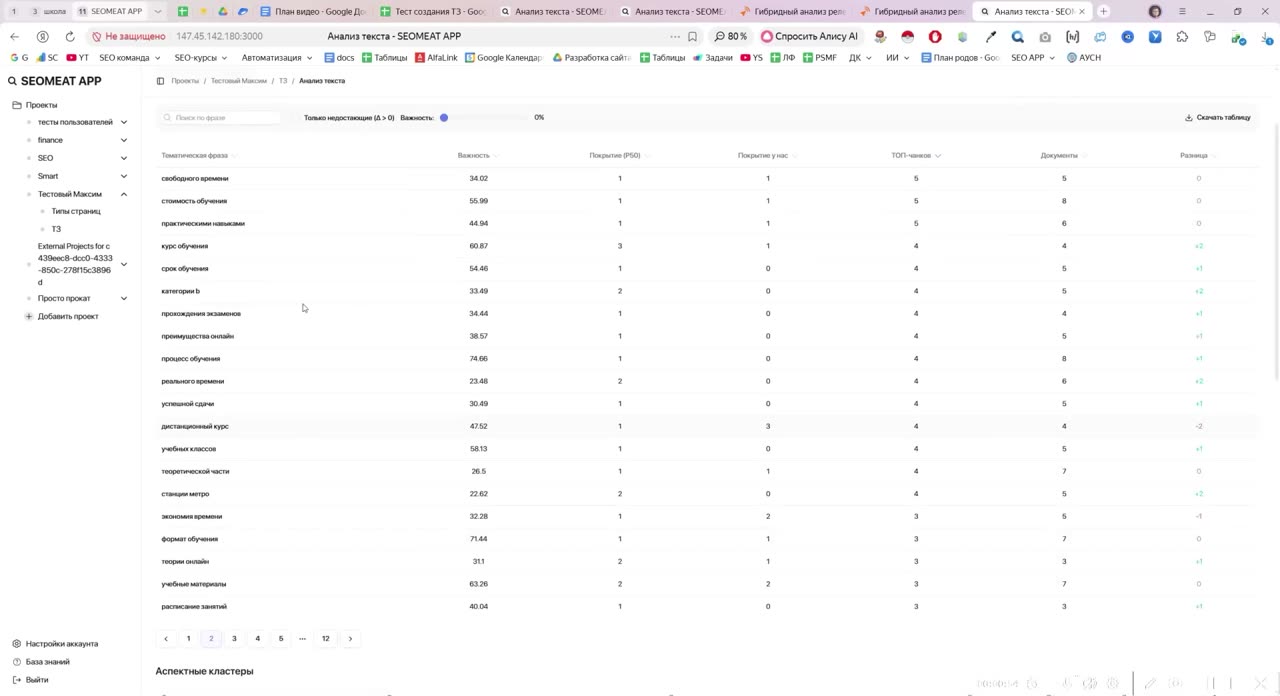
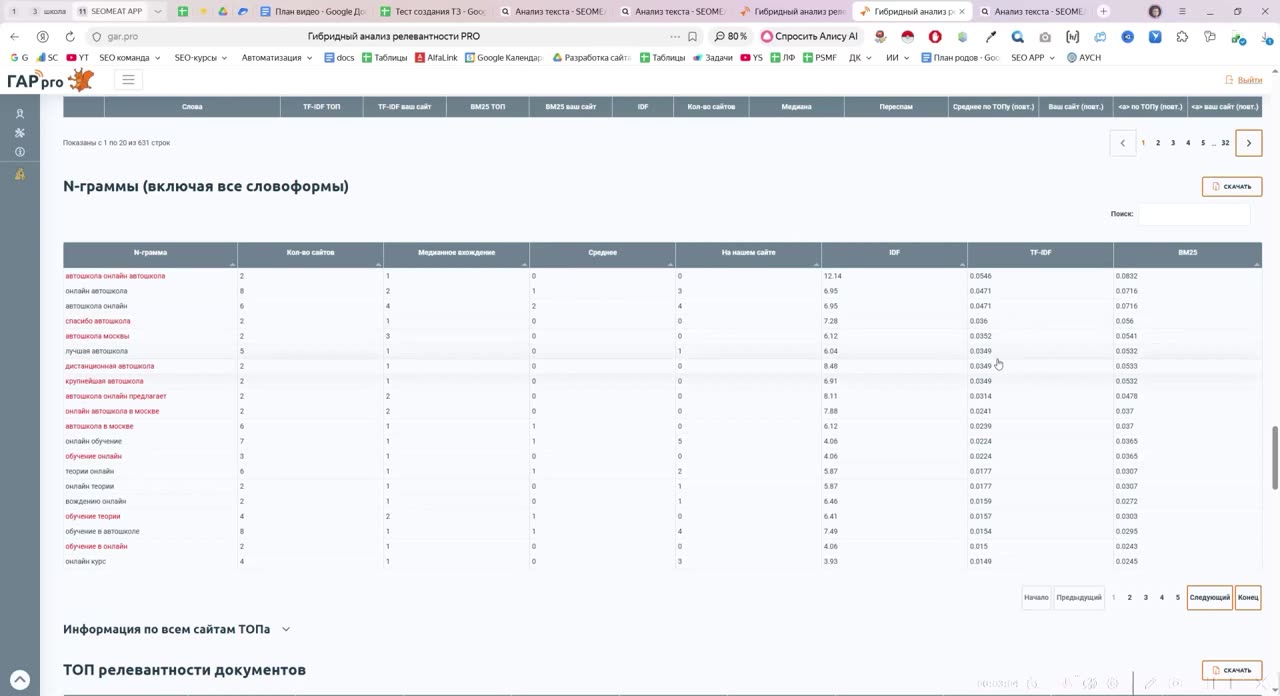
Разбираю вкладку тематических фраз — внешне она проще зонального анализа, но внутри у неё самая тяжёлая часть проекта. Показываю, почему чистый TF-IDF выносит наверх мусор вроде «спасибо автошкола», и из каких слоёв мы собрали свою формулу важности: семантическая близость к теме и к аспектам, количество конкурентов, умноженное на важность фразы, и статистика по топ-чанкам. Отдельно объясняю, что такое топ-чанки и почему прямая косинусная близость хорошо ловит синонимы, но теряет подаспекты темы. Показываю, как сейчас выделяются аспектные кластеры и как это будет работать на нейронке. В конце — практическая часть: как фильтровать список по важности и документам, чтобы забрать ключевое ядро темы, и как комбинировать тематические фразы с зональным анализом.
0:00–1:04 Вкладка тематических фраз. Выглядит попроще, чем зональный анализ; в будущих итерациях добавим сюда фразы из кластеров и некую зональность. С фразами была одна из самых сильных заморочек за весь проект: в зональном анализе проблемы ушли достаточно быстро, а при анализе фразового соответствия они возникают чаще. Первая задача — выделить фразы почище, без мусора: биграммы, триграммы и определённые сочетания вроде существительное плюс существительное, глагол плюс существительное, прилагательное плюс существительное. Фразы выделяет нейросеть spaCy.
1:05–2:05 Цель была не просто нарезать страницу на биграммы и триграммы, а наладить более осмысленное деление — чтобы получались сущности и атрибуты сущностей. Дальше разбираем, что такое важность, покрытие, топ-чанки и документы, а также аспекты. Поиск по фразе работает по полному вхождению.
2:06–3:24 Проблематика алгоритма определения важности. Основной алгоритм здесь — TF-IDF: он работает на статистике и подсвечивает важные для набора документов фразы. Проблема в том, что важной может оказаться фраза, которая встречается у очень небольшого числа конкурентов: здесь 11 конкурентов, а самой важной TF-IDF считает «автошкола онлайн автошкола», на третьем месте — «спасибо автошкола». Хорошие фразы в списке тоже есть, но вместе с примесью мусора, и наша задача этот мусор убрать. На подобных алгоритмах мы отбираем первый пул кандидатов.
3:25–4:34 Дальше задачу переформулируем: переранжировать отобранные фразы так, чтобы реально полезные уходили наверх, а неполезные — вниз. Сделали много итераций с формулами и весами, сейчас нашли рабочую сборку. Один из слоёв — количество конкурентов, у которых встречается слово: если оно есть у многих, слово скорее всего важное. Но сама по себе эта метрика подтягивает неинтересные слова с низким TF-IDF, поэтому мы перемножаем важность на количество сайтов. Частое, но нерелевантное слово занижается, а редкое с очень высоким TF-IDF поднимается.