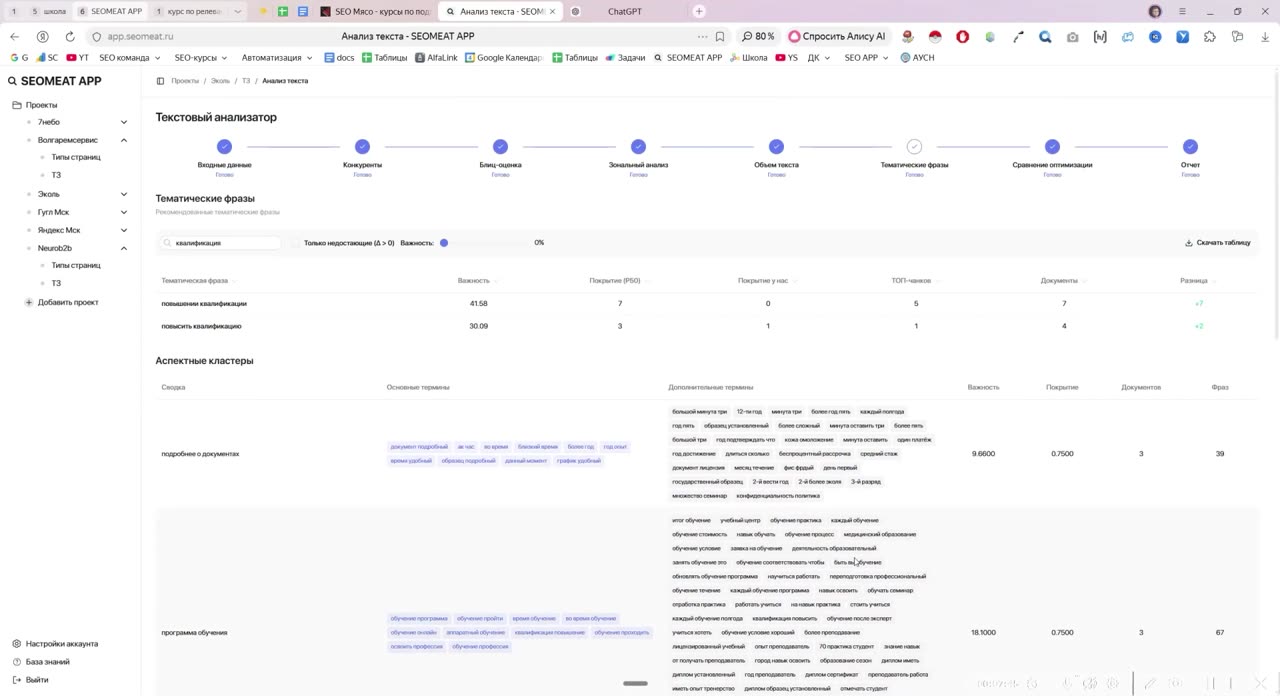
Разбираю, как работать с анализатором на сайтах услуг. Основной отчёт здесь — тематические фразы: в них закрываются хвосты ключей, сущности и их атрибуты, и внедрять их нужно релевантными блоками, а не сплошным текстом внизу страницы. Сначала объясняю, почему это вообще работает: как устроены слои отбора и до ранжирования у поисковых систем, на чём обучались трансформеры и почему документ из ключей и воды наверх не выходит. Дальше показываю практику на обучении мастеров аппаратной косметологии: как превратить выгрузку в структуру «сущность — атрибут», что вытаскивать из заголовков конкурентов, какие пороги ставить для услуг, как дооптимизировать заголовки и тайтл и как построить работу копирайтера или нейронки по шагам.
0:00–0:36 О чём урок: оптимизация услуг с помощью нашего анализа релевантности. Направление услуг мы ещё будем прокачивать, и прежде всего подтянется анализ тематических фраз — для услуг он основной. В нём закрывается много хвостов запросов, много семантических сущностей, их атрибутов и связей между ними.
0:37–1:11 Отчёт по тематическим фразам можно просто взять и внедрить на страницу — это самый простой путь. Но вываливать его на страницу одним SEO-текстом бесполезно: такой текст, скорее всего, вообще не будет учитываться. Нужны релевантные блоки. Про это я говорил в уроке по магазинам, повторю здесь: вы могли сразу перейти к услугам.
1:12–2:46 Почему так устроено. У поисковой системы есть несколько слоёв отбора релевантных страниц. На нижнем слое отбираются кандидаты — страницы, которые содержат ключевые слова и леммы из ключей в тайтле и в тексте, прям самая база. Дальше кандидатов уточняют быстрые алгоритмы сортировки вроде BM25, потому что на нижнем слое их могут быть миллионы и подробно изучать каждого никто не будет. Потом идут следующие слои до ранжирования: фильтры по локации и прочему, пока не останется десятка. За счёт одной текстовой релевантности до промежуточного топа дойти вполне реально.
2:47–3:49 У Яндекса есть алгоритмы на трансформерах, которые учились на массиве «запрос — документ»: брались страницы, получавшие клики по запросам, плюс экспертная разметка, где эксперт отмечал, что этот URL хорошо отвечает на вопрос. Экспертная оценка даёт больше вклада. На чём именно натренирована модель, мы точно не знаем, поэтому нам нужны связи сущностей и семантических элементов, которые задают релевантность по теме. Страницу, напичканную водой и ключами, в топе вы не увидите: связей слов в таком документе нет.
3:50–4:59 Поисковые системы умеют отжимать текст от воды — у них огромный массив данных, они видят самые популярные слова и…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.