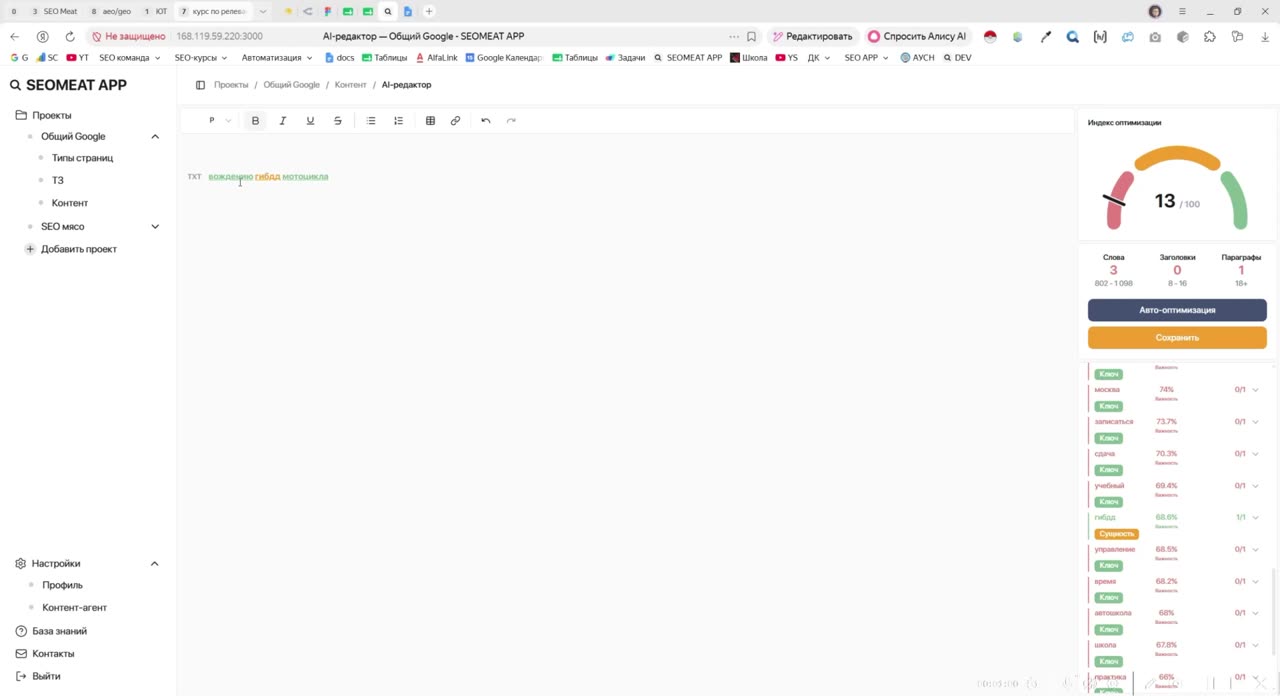
Разбираю, по каким правилам контент-оптимизатор засчитывает вхождения. Логика простая: леммы из фразы в пределах одного предложения и одной строки дают зачтённую фразу, слова между ними этому не мешают, а точка или перенос строки связь разрывают — тогда остаются только отдельные леммы. Показываю на живом примере, как одно насыщенное предложение закрывает сразу несколько вхождений, почему морфология не имеет значения, и как работает разбивка по зонам: заголовки, текст, ссылки. Эти же правила объяснены и самой модели, поэтому она в первую очередь работает с фразами. Урок короткий и нужен для понимания того, что именно показывают счётчики в правой панели.
0:00–0:31 Как работает учёт вхождений. Если леммы из фразы стоят в одном предложении или в одной строке, фраза учитывается. Точное вхождение засчитывается, вставка слов между леммами тоже. А вот точка между ними ломает…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.