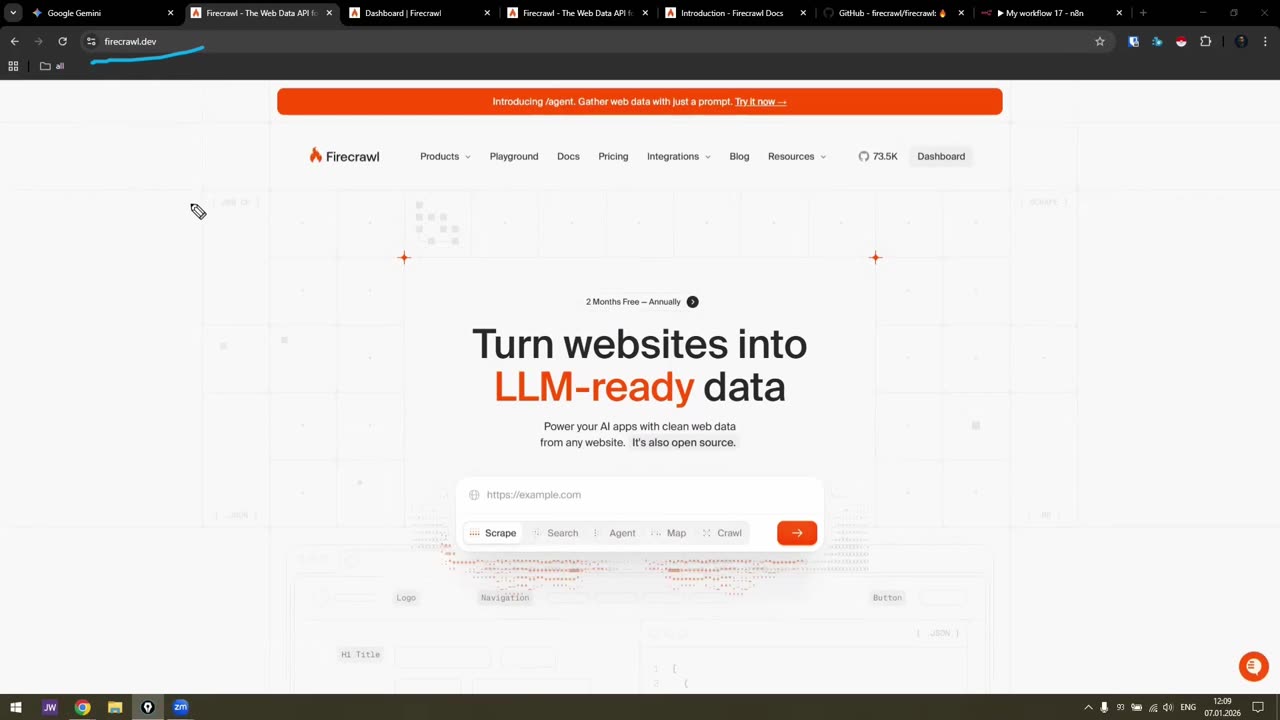
Открывающий урок мини-курса по Firecrawl — сервису, который превращает сайты и страницы в данные для LLM: markdown, JSON, скриншоты, ссылки. Сайты всё активнее защищаются от ботов, и Firecrawl сегодня один из тех парсеров, который грузит JS, обходит Cloudflare и капчи и отсекает мусор в коде. Разбираем, что умеет сервис по документации (scrape, map, crawl, search, extract, агент), как читать эту документацию через NotebookLM, Cursor или Claude Code, сколько стоят кредиты и где взять API-ключ. В конце — первая мини-практика без n8n: парсим главную страницу resultup.agency прямо в Playground и смотрим, что приходит в markdown и JSON. Отдельно смотрим на интеграцию с n8n: официальной ноды нет, есть community-нода и готовые шаблоны, но весь курс мы пройдём через HTTP Request, чтобы понимать API глубже. Урок для SEO-специалистов, которые хотят автоматизировать анализ своих сайтов, конкурентов и выдачи.
0:00–0:34 Начинаем серию уроков по Firecrawl. Это система для парсинга, скрейпинга и краулинга интернета — конкретных сайтов, страниц сайтов и выдачи. Заходим на firecrawl.dev и регистрируемся: регистрация стандартная, через Google или через GitHub, у меня аккаунт уже есть, поэтому вместо кнопки регистрации виден дашборд.
0:34–1:44 Зачем вообще отдельный сервис. Сайты всё больше защищаются от ботов и парсинга, парсеры в ответ улучшаются, и Firecrawl — один из лучших на этом поле: грузит JS на страницах, обходит Cloudflare и капчи, отсекает мусор в коде. На главной так и написано: LLM-ready data. Он берёт сайт, страницу или кучу страниц и превращает их в markdown, JSON или другой нужный формат — для нас, сеошников, это анализ собственных сайтов, конкурентов, трендов и выдачи. Документация лежит на docs.firecrawl.dev.
1:44–3:22 Что видно в документации: scrape — ходить по одной странице и вытягивать оттуда информацию, map — быстро получать карту сайта, все страницы в свой рабочий процесс, crawl — прогонять много страниц одного сайта, search — идти в поисковик и парсить выдачу, extract —…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.