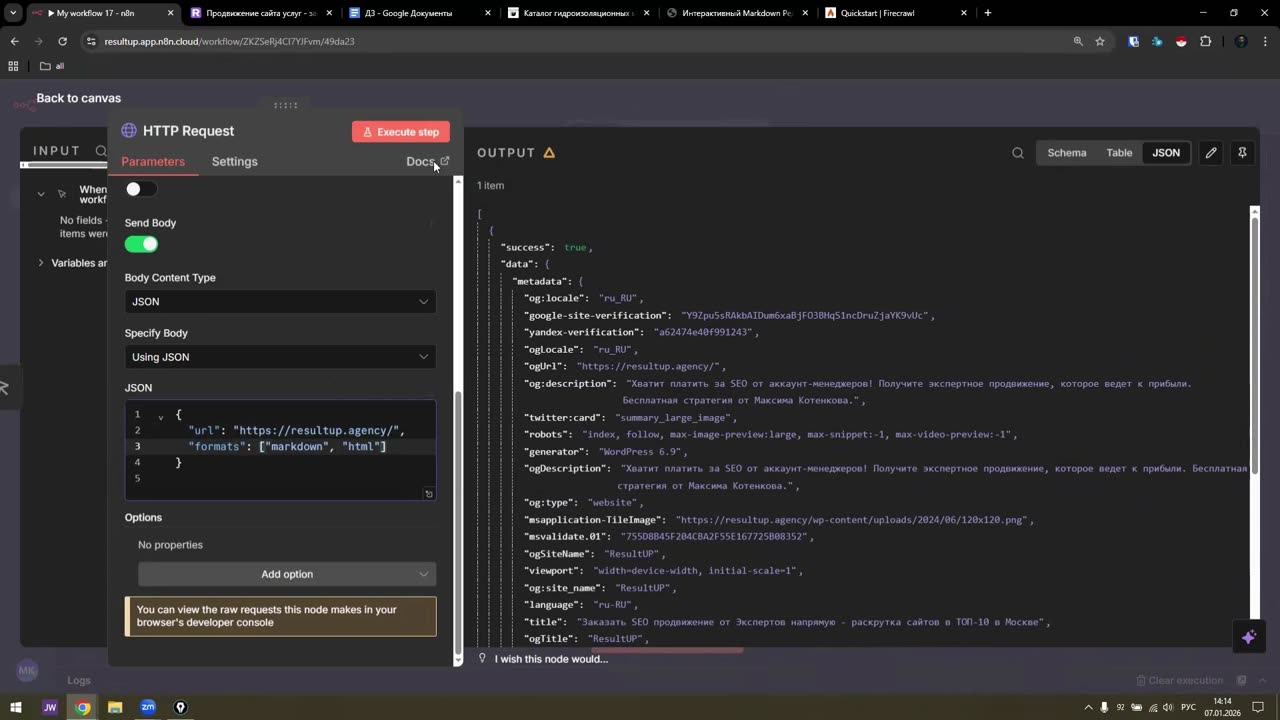
Парсим мы страницы не просто так, а чтобы отправить их в LLM, а в LLM мы платим за токены. Поэтому в этом уроке уточняем режим scrape: берём со страницы только то, что нужно, и выбрасываем шапку, подвал, фильтры и прочее, что не несёт смысловой нагрузки в конкретном рабочем процессе. Разбираем форматы — markdown, html и оба сразу в одном запросе, — отдельно смотрим скриншот страницы и параметры, без которых он получается куцым. Вторая половина урока про includeTags и excludeTags: на каталоге гидроизоляционных мембран сравниваем объём обычного парсинга и парсинга только карточек товаров, а заодно показываю, откуда взять сами селекторы. В конце — честный разбор onlyMainContent из второй версии Firecrawl и домашнее задание.
0:00–0:34 Зачем вообще что-то убирать со страницы. Чем больше лишних токенов мы отправим в нейронку, тем больше денег потратим. Хорошо бы отдавать не только понятный для LLM формат, но и только нужные данные: например, только товары и цены, без футера, хедера и фильтров.
0:34–1:38 Форматы парсинга. Сейчас у нас markdown, рядом есть html — та же самая страница, но со всей технической начинкой. HTML — это техническое SEO: проверка тегов, микроразметки, наличия h1, h2, h3, canonical. Можно без проблем запросить сразу два формата в одном запросе: сначала придёт markdown, потом параметры и даты, потом HTML. Дальше в workflow это разделяется и уходит в разные анализаторы.