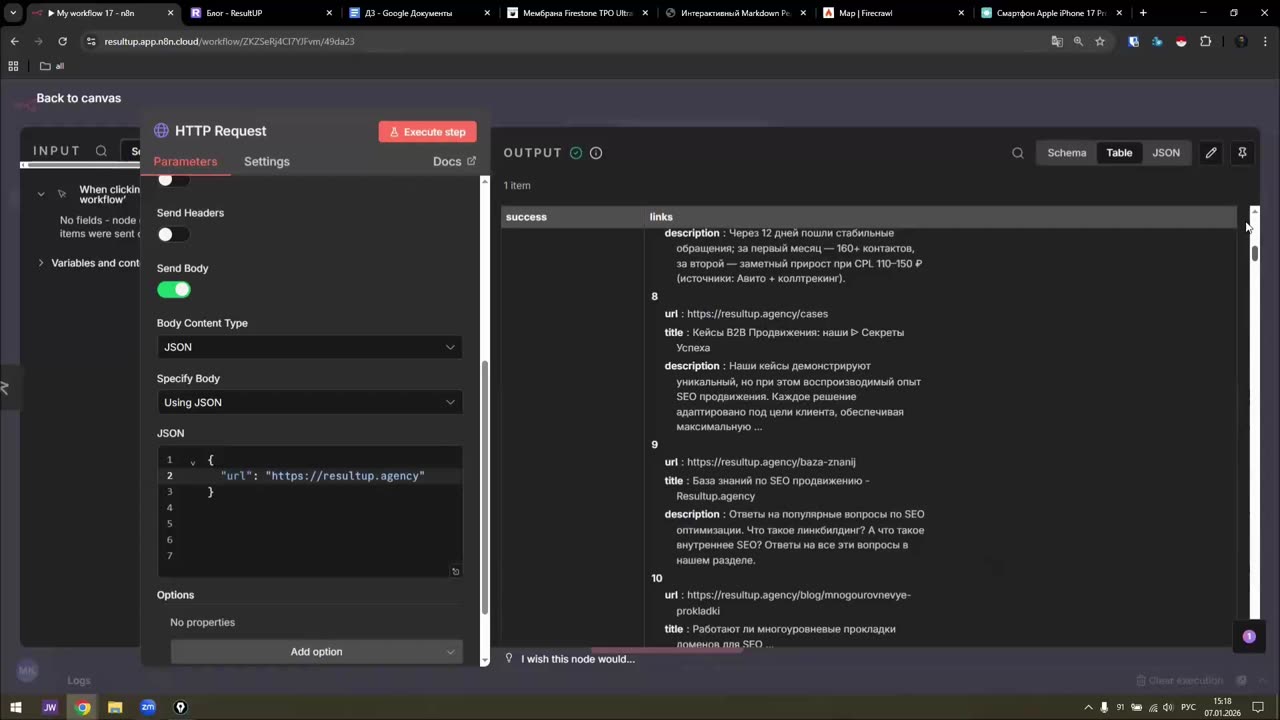
Разбираем режим map — в отличие от scrape, который заходит на одну страницу и забирает её содержимое, map собирает список URL: либо все страницы сайта, либо только те, что нам нужны. В той же ноде HTTP Request меняем адрес на map и в теле запроса играем параметрами: url, search, sitemap, limit, ignoreQueryParameters, includeSubdomains. На практике смотрим три сценария — выгрузку всех страниц агентства, сбор статей блога конкурента для контент-стратегии и подбор карточек товаров в интернет-магазине под мониторинг цен. Отдельно видно, как сильно на чистоту результата влияет то, какую страницу подать на вход: не корень сайта, а раздел блога или каталога. Урок для SEO-специалистов, которым нужен управляемый список адресов на входе в дальнейший парсинг.
0:00–0:33 Переходим к mapping. Scrape, который был до этого, — это зайти на страницу и что-то с ней сделать: взять html, взять markdown, сделать скриншот. Map — это другое: взять пачку страниц, список каких-либо страниц, либо всех страниц сайта, либо каких-то конкретных. Это сбор именно URL, а не заход на каждую страницу.
0:33–1:07 В поле URL меняем адрес: тот же Firecrawl второй версии, но уже map. Переходим в Body, и если в этом режиме просто передать url, получим все страницы данного сайта — он спарсит все-все страницы, которые найдёт. В представлении таблички у меня 83 страницы. Уже полезно: супер-интернет-магазины так парсить вряд ли стоит, но если сайт небольшой, то почему бы и нет.
1:07–2:10 Как и в краулинге, всё нужно не так часто — можно взять что-то конкретное. Например, мы строим контент-стратегию и хотим проанализировать блоги конкурентов, берём один из них, resultup.agency. Сюда же может подставляться переменная сайта: пошли в Google, прогнали там 15 запросов, спарсили 10 выдач, и дальше каждый сайт закидывается в качестве переменной — его блог выгружается, следующий сайт, его блог выгружается. Сейчас на автоматизации не отвлекаемся, но всё это с прицелом на конвейер. Нас интересует только блог, а не услуги и главная.
2:10–2:47 Через запятую добавляем параметр search со значением «блог» и смотрим, что приходит. В целом неплохо — блог, статья, блог, блог. Но вместе с ними пробрались услуги и база знаний. Базу знаний с блогом перепутать можно, а услуги зацепились, потому что это продвижение сайтов. В общем, выдача получилась не супер чистая.