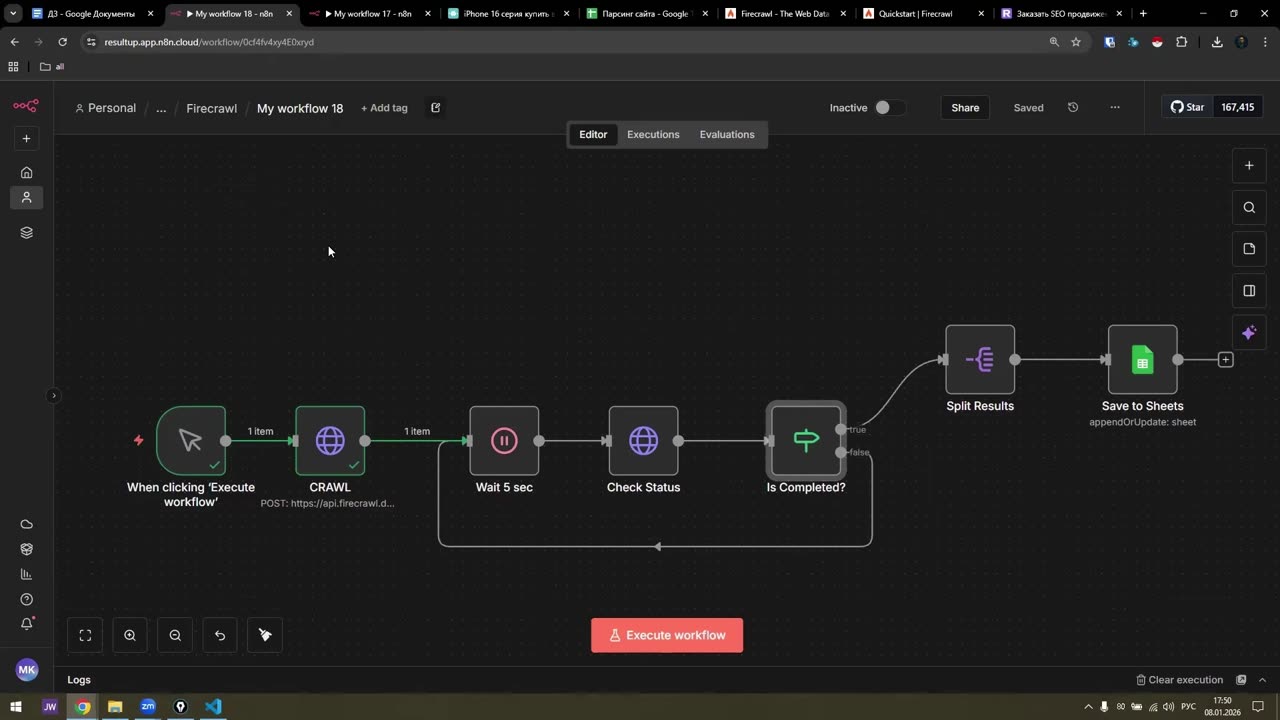
Краулинг — это map и scrape в одном флаконе: мы подаём одну главную страницу и говорим «дальше ищи сам». Разбираю, почему такой запрос нельзя обработать одной нодой HTTP Request, и собираю схему с опросом: нода CRAWL возвращает id задачи, дальше Wait, Check Status и обычный if гоняют проверку по кругу, пока не придёт completed. Показываю на реальном сайте с защитой от ботов, как простое выражение собирает мусор вместо тайтлов и как это чинится через delay между страницами и actions с ожиданием прогрузки. В конце прохожусь по остальным опциям краулера — регулярные выражения для include и exclude, поддомены, sitemap, мобильная версия, клики по селекторам и скроллинг — и объясняю, почему следующим шагом будут вебхуки. Урок для тех, кто уже собрал связку map + scrape и хочет сканировать сайт целиком.
0:00–0:37 Чем краулинг отличается от того, что делали раньше. Упрощая, это mapping и scraping внутри, под капотом: мы даём одну главную страницу и говорим «дальше сам ищи страницы, анализируй их, нам только результат». Map и scrape — более управляемые процессы, мы сами отправляем нужную часть страниц, а crawl больше для полного аудита сайта.
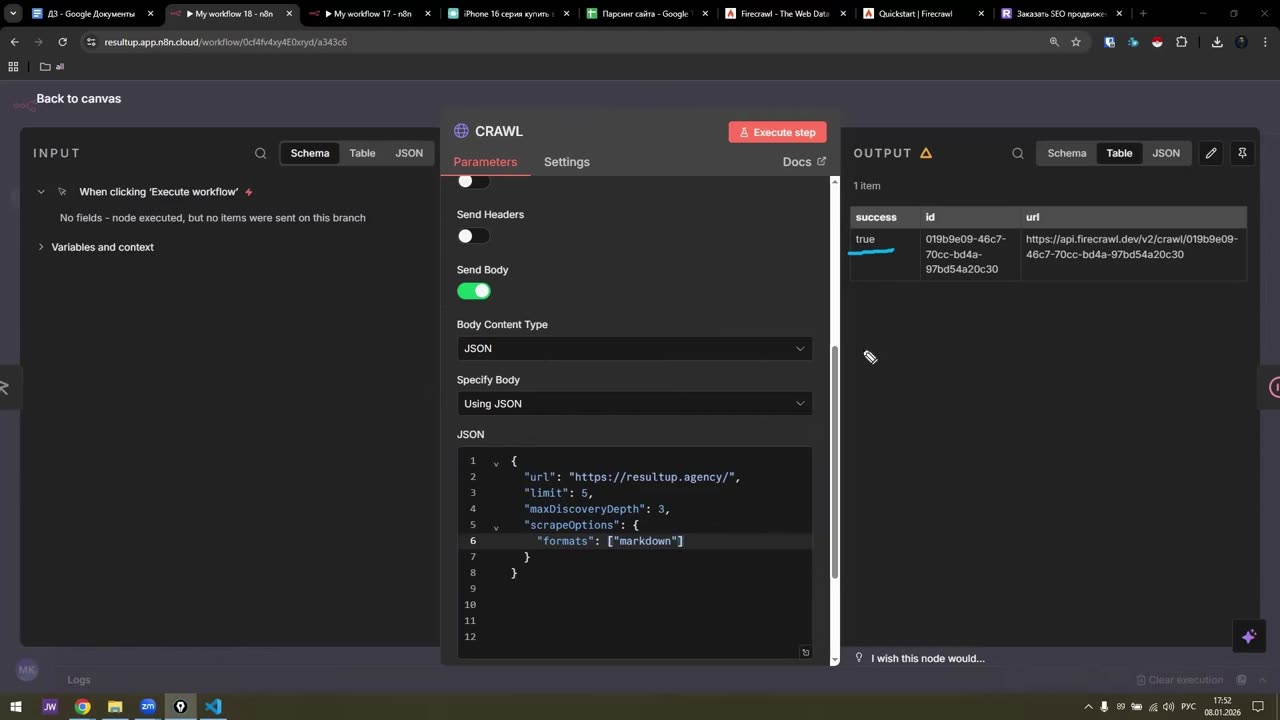
0:37–1:41 Нода CRAWL и небольшой workflow вокруг неё. В теле запроса url главной страницы, лимит — сколько страниц хотим (я поставил пятёрку, чтобы быстрее отрабатывало, но можно и больше), максимальная глубина — уровень вложенности: единица это только главная, двойка — главная плюс страницы через слэш от неё, тройка — третий уровень. Дальше знакомые scrapeOptions, формат markdown.
1:41–2:51 В чём особенность по сравнению с map. Там страницы шли пакетами через wait и нода HTTP Request всё обрабатывала. Краулинг может занимать пять минут, десять, больше — и нода HTTP Request через 30, 60, может быть, 90 секунд решит, что всё зависло, и упадёт. Поэтому выполненная нода CRAWL сразу отдаёт success true, id задачи и её url: endpoint здесь уже не map и не scrape, а crawl, а url задачи — это тот же адрес с приклеенным id.
2:51–3:58 Как реализовано ожидание. Мы говорим «просканируй нам этот сайт», в ответ получаем номер задачи — а сколько ждать, непонятно. Поэтому ждём пять секунд и чекаем по этому id: окей — идём дальше, не окей — цикл продолжается, снова пять секунд и снова вопрос «как ты там». Интервал настраивается, можно спрашивать реже или чаще. Решает это обычная нода if: статус из предыдущей ноды перетаскивается в условие,…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.