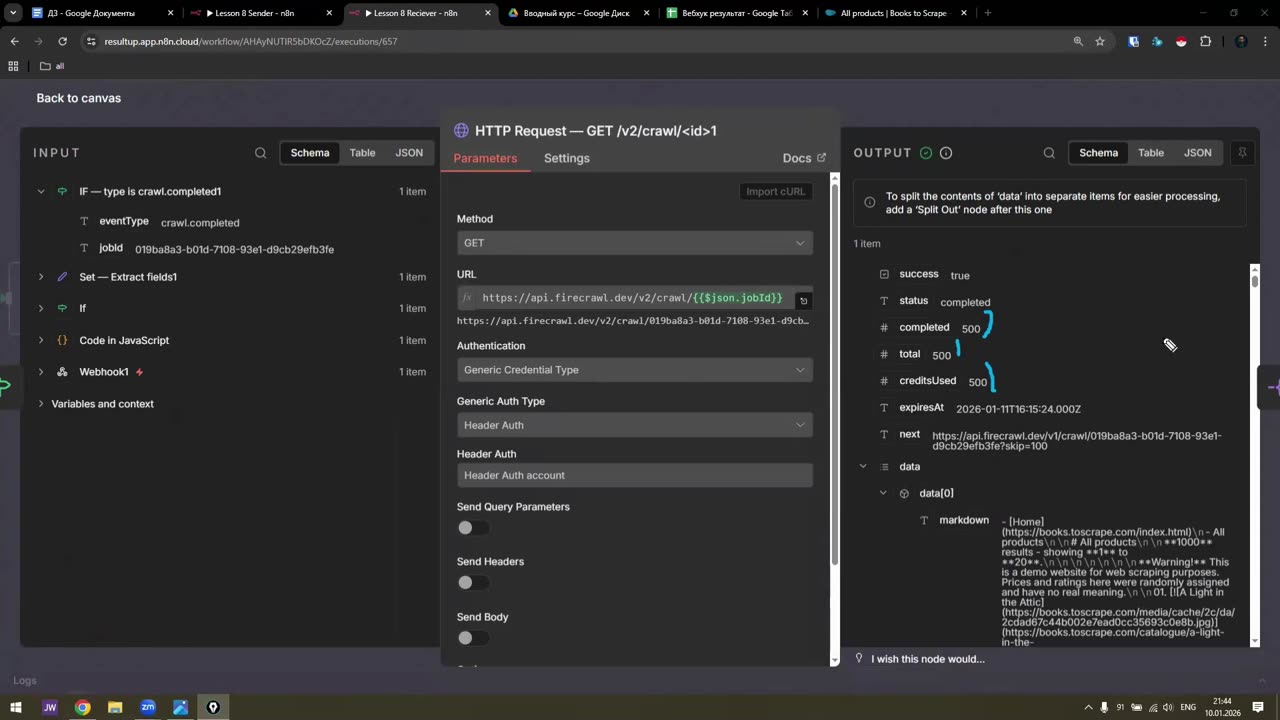
Разбираемся, что делать, когда страниц слишком много. На тестовом сайте с книжками ставлю краулингу лимит 500 страниц, краулинг честно отрабатывает и списывает 500 кредитов, но в таблицу попадает только 100 строк: Firecrawl отдаёт результат порциями и кладёт в ответ поле next — адрес следующего пакета. Показываю, как апгрейдить одну-единственную ноду получения данных, чтобы она шла по этим пакетам сама: включаем опцию Pagination, выбираем режим с Next URL, подставляем туда поле next из тела ответа и задаём условие остановки. Плюс страхующий лимит на количество запрошенных страниц, чтобы не упереться в память инстанса. В конце сравниваем результат с прошлым прогоном и смотрим, сколько весят полученные данные.
0:00–0:32 Представим, что парсим большой портал, где миллион страниц. Для теста взял сайт books to scrape: там страницы с книжками, категории, у каждой книжки своя страница. В краулере ставлю лимит 500 страниц, глубину выставил максимальную, всё остальное оставил как было.
0:32–1:53 Прогон уже сделан заранее. В таблицу записалось 100 страниц, хотя лимит был 500. Смотрим ответ от Firecrawl: статус completed, completed 500, total 500, потрачено 500 кредитов. Данные пришли не все, потому что сервис понимает — весь объём мы разом не примем. Поэтому в ответе появляется поле next: URL, по которому загружается следующий пакет данных этого же краулинга. Поле будет присутствовать до тех пор, пока есть неприсланные данные.