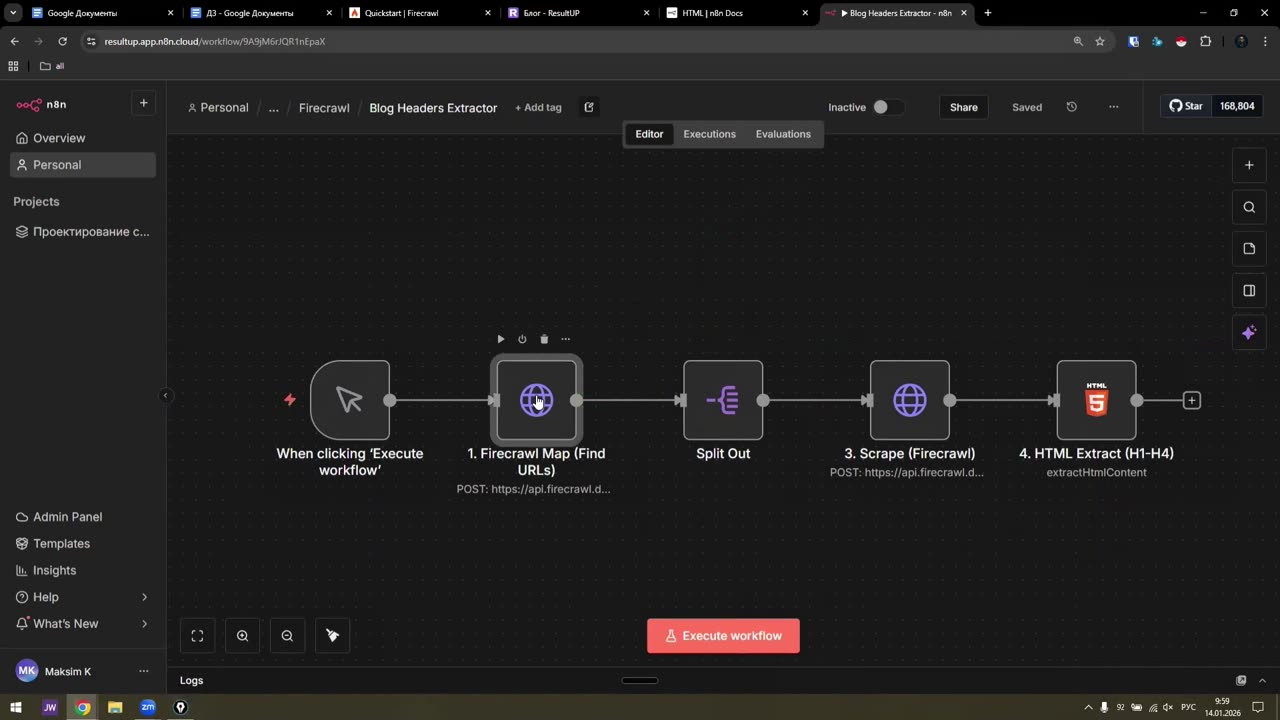
Разбираем HTML Node — официальную ноду n8n, которая умеет доставать нужные куски из уже полученного HTML по CSS-селекторам. Со стороны Firecrawl ничего нового: короткий демонстрационный workflow собирает ссылки через Map, разделяет их через Split Out и забирает HTML со страниц через Scrape. Дальше начинается то, ради чего урок и собран: настраиваем извлечение, собираем структуру статьи — h1 отдельным полем и остальные заголовки списком. Подробно смотрим параметры ноды: откуда берётся источник, что означают Attribute, HTML, Text и Value, когда включать возврат списка и зачем нужны Trim и Clean Up Text. В конце запускаем сценарий целиком и смотрим, что приходит на выход. Урок пригодится, если вы уже умеете скрейпить страницы и хотите разбирать их содержимое дальше — например, отдавать структуры конкурентов AI-агенту на анализ.
0:00–0:32 Что разбираем на уроке и как устроен демонстрационный workflow. Со стороны Firecrawl ничего нового: Map собирает ссылки, в запросе дополнительно стоит параметр block на всякий случай, а лимит выставлен в три странички — просто чтобы не ждать долго во время демонстрации.
0:32–1:04 Маппим три статьи блога и получаем массив ссылок. Split Out уже обсуждали: он разделяет массив по ссылочкам, и дальше по одной за раз идут links 0, links 1, links 2 и так далее. Сам массив links подставлен в ноду как параметр.
1:04–1:43 Scrape забирает HTML со страниц: endpoint scrape, авторизация всё та же. Ожидание здесь выставлено аж по 22 секунды, потому что страницы длинные и большие, и нужно, чтобы они точно прогрузились. И дальше — HTML Node. Она есть в…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.