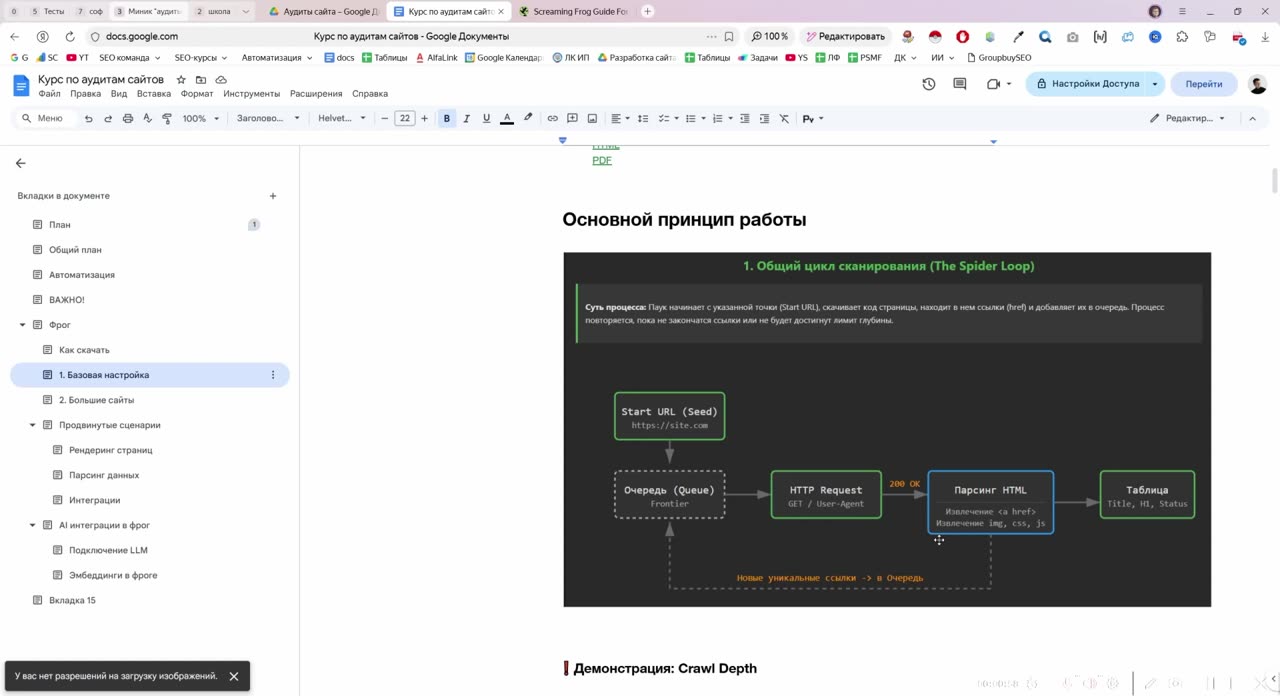
В этом уроке я начинаю разбор настроек Screaming Frog с самой базы: как программа обходит сайт. Я показываю схему цикла «стартовый URL → очередь → HTTP-запрос → разбор HTML → новые URL в очередь» и на живом примере меняю лимит глубины сканирования, чтобы было видно, как меняется результат. Затем разбираю два режима работы, Spider и List, и объясняю, чем они отличаются и как лимиты ведут себя в списке. Урок подойдёт тем, кто только начинает работать с Frog и хочет понимать, откуда берутся данные в отчётах.
0:00–0:32 Вступление: что будет в блоке настроек. Базовый разбор всего, затем отдельные уроки по рендерингу, большим сайтам, парсингу данных, интеграциям с API (в первую очередь Google Search Console) и подключению нейросетей.
0:32–1:09 Схема работы Frog. Вы задаёте стартовый URL, обычно главную. Программа собирает с неё ссылки и формирует очередь, делает HTTP-запрос к каждой странице и получает ответ. Если ответ 200, она разбирает HTML, достаёт новые URL,…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.