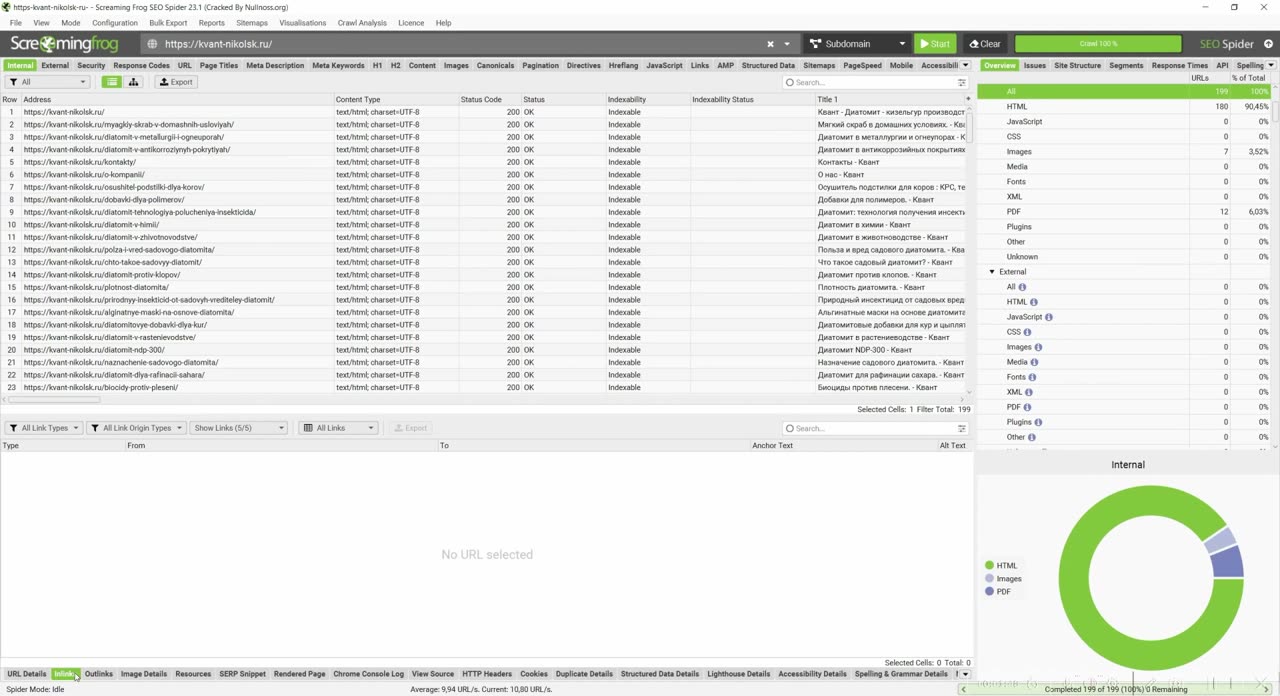
В этом уроке я разбираю вкладку Configuration → Spider → Crawl, где у каждого типа ресурсов и ссылок есть два флажка: Crawl и Store. Crawl отвечает за переход по ссылкам этого типа, Store за сохранение подробной информации о них: связей между URL, атрибутов и данных, которые появляются при полном обходе. На примерах с внутренними ссылками и изображениями я показываю, как меняется результат при разных комбинациях. Затем прохожу блок Links on Page и настройки Crawl Behavior: папки, поддомены, nofollow и XML Sitemap. Урок пригодится тем, кто хочет настраивать Frog под конкретную задачу аудита и экономить память на больших сайтах.
0:00–2:03 Введение. Понятия Crawl и Store встречаются и в других отчётах, поэтому их нужно понимать как базу. Crawl означает переход по ссылкам определённого типа, Store означает сохранение подробной информации о них. Включаю только Crawl для внутренних ссылок: сайт обходится, парсятся title, description и коды ответов, но связи URL между собой не сохраняются, потому что они требуют много ресурсов. После включения Store появляются связи и другие данные, которые возможны только при сохранении всех связей сайта.
2:03–4:25 Примеры с внутренними ссылками и изображениями. Если выключить Crawl у внутренних ссылок, спарсится…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.