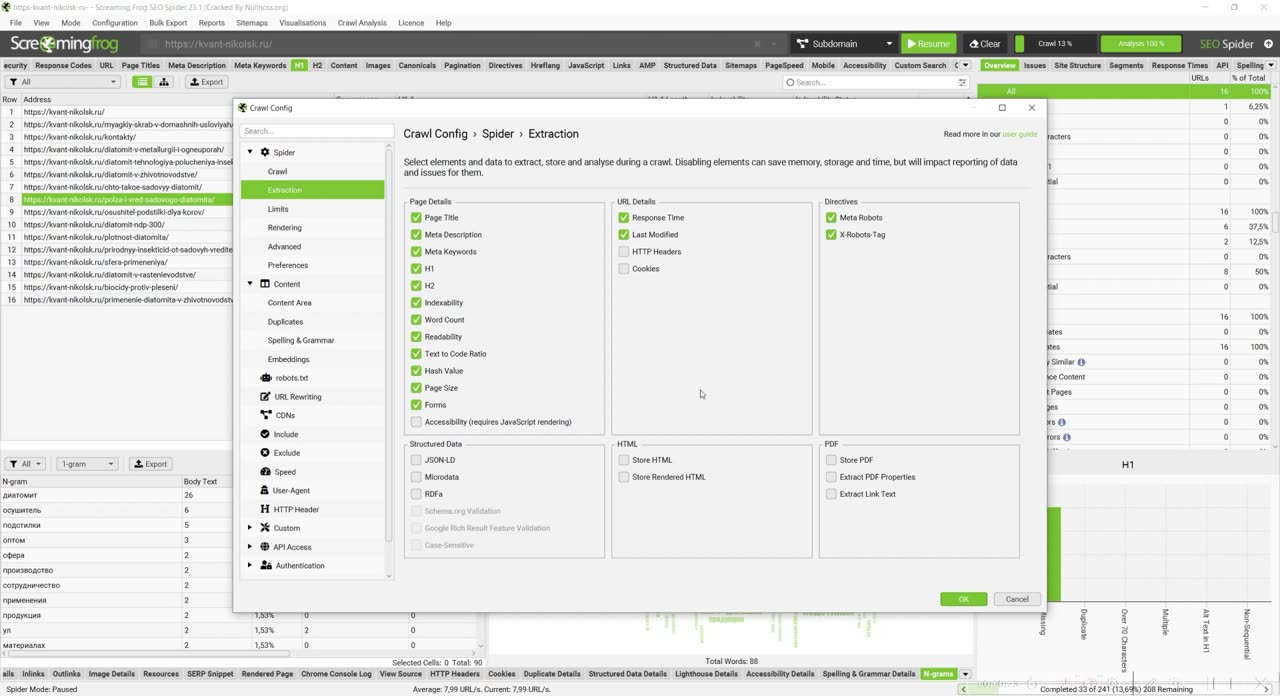
В этом уроке я начинаю разбирать вкладку Extraction в настройках Crawl и первый её блок, Page Details. Это данные, которые Screaming Frog записывает со страниц во время сканирования. Я показываю, как управлять набором этих данных, чтобы собирать только нужное и не тратить ресурсы на лишнее. Прохожу по параметрам первой колонки: мета-теги, индексируемость, количество слов, хеш страницы, размер страницы, формы и проверка доступности. В чек-листе и конспекте к курсу есть общие рекомендации, когда что включать. Урок пригодится тем, кто работает с большими проектами и хочет настроить парсинг под конкретную задачу.