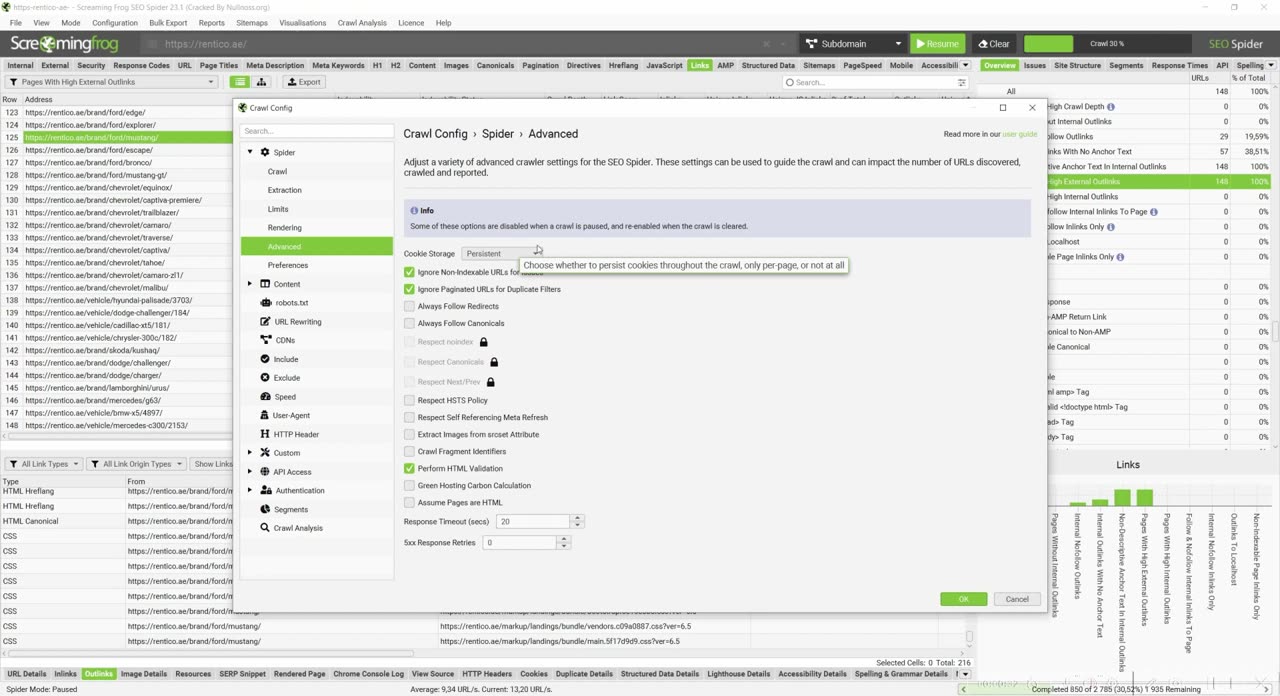
В этом уроке я кратко прохожу по всем пунктам вкладки Crawl Config → Spider → Advanced. Разбираю режимы хранения cookies, игнорирование неиндексируемых URL и пагинации в отчётах, поведение при редиректах и canonical, настройки Respect, HSTS и meta refresh, извлечение изображений из srcset и якорных ссылок, валидацию HTML, а также таймаут ответа и повторы при ошибках 5xx. Для каждой настройки я объясняю, когда её стоит включать или отключать. Урок подойдёт тем, кто уже знает базовые параметры сканирования и хочет понимать, как каждая галочка влияет на данные в отчётах.
0:00–0:38 Cookie Storage: три состояния. Session Only: куки действуют только для конкретной страницы и затем сбрасываются. Persistent: куки сохраняются между всеми потоками и общие. Do Not Store: куки на сайте не учитываются. 0:38–1:50 Ignore Non-Indexable URLs for Issues. Issues — это фильтры ошибок вроде отсутствующего или дублирующегося H1. По умолчанию неиндексируемые URL в них не попадают. Настройку отключают, когда нужно увидеть ошибки на всех страницах, в том числе закрытых от индексации, например на сайте, полностью закрытом от индексации. 1:50–2:21 Ignore Paginated URLs…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.