В финальном уроке раздела про большие сайты я объясняю, почему полный парсинг почти всегда можно заменить частичным. Показываю, как сделать небольшой пробный краул, найти «взрывы» страниц из параметров, пагинации и сортировок, закрыть их через Exclude и убрать лишние ресурсы вроде изображений. Рассказываю, как выставлять лимиты по уровням и папкам и какие ограничения по памяти и диску возникают на миллионе URL. Урок пригодится тем, кто готовится к аудиту сайта на сотни тысяч и миллионы страниц.
0:00–1:36 Цель урока: отговорить от парсинга больших сайтов и начать с малых краулов. Полный обход нужен только когда стало понятно, что без него проблемы не выявить. Перед стартом стоит прочитать справку Screaming Frog.
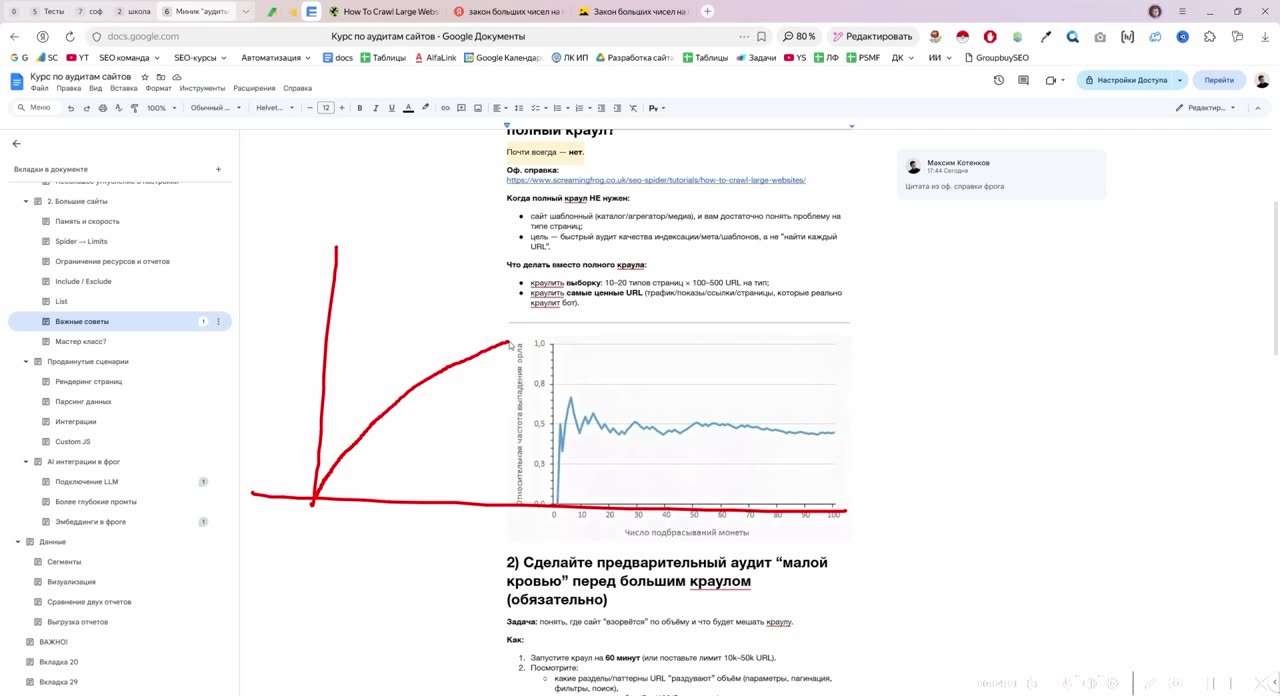
1:36–3:23 Большие сайты шаблонные, поэтому достаточно найти закономерности и затем искать частные случаи. Для оценки title на двадцати типах страниц хватает 500–1000 страниц каждого типа. Пример с подбрасыванием монеты показывает закон больших чисел: после определённого объёма выборки точность почти не растёт.
3:23–6:26 График вероятности выявления проблем: сначала она быстро растёт,…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.