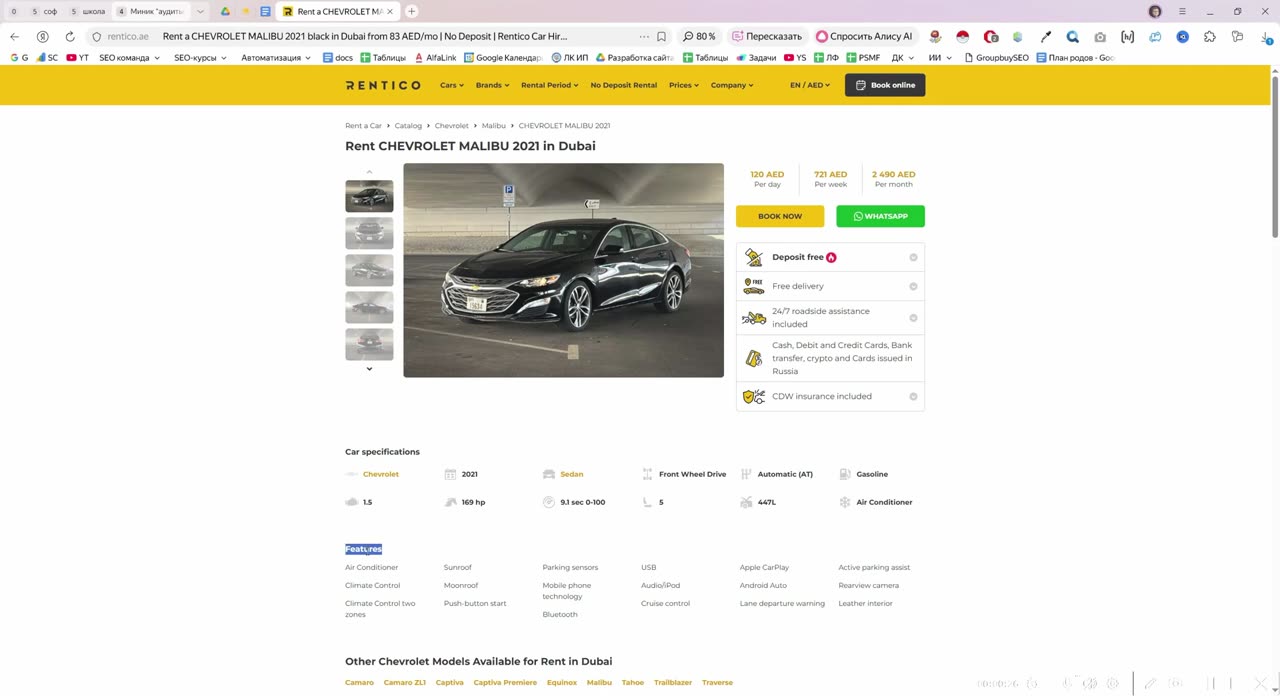
В этом уроке я собираю парсер на основе Screaming Frog для сайта аренды автомобилей. С каждой страницы товара нужно получить спецификацию, особенности и цены, каждое поле в отдельной колонке. Показываю два способа настроить Custom Extraction: вручную через браузер и через нейросеть, которая пишет XPath или CSS Path по HTML страницы. Дальше разбираю, как дотянуться до страниц товаров через Include и regex, что делать, если правила обхода не срабатывают, и как подать список URL из sitemap. Урок подойдёт тем, кто хочет собирать данные конкурентов или структурировать контент для своего сайта.
0:00–1:04 Задача: спарсить с сайта аренды авто спецификацию, особенности и цены, каждое значение в своей колонке. Два пути: нейросеть пишет XPath или CSS Path…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.