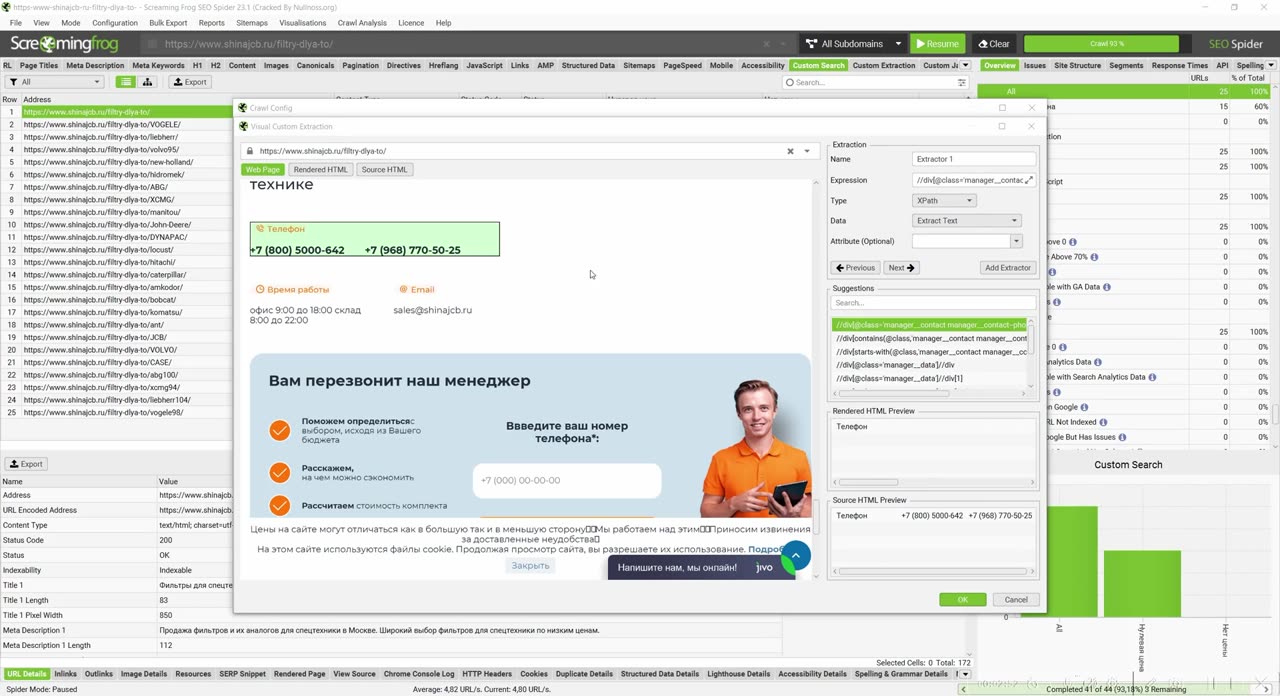
В этом уроке я разбираю Custom Extraction в Screaming Frog: как задать правило извлечения, какие бывают способы выбора элемента (XPath, CSSPath, Regex) и что именно можно вытащить со страницы. На примере блока с телефонами показываю разницу между режимами Inner HTML, Extract HTML Element и Extract Text, затем перехожу к колонкам с несколькими совпадениями, атрибутам и Function Value. Во второй части курса на этой основе собирается простой парсер карточек товаров. Урок подойдёт тем, кто хочет собирать данные со страниц сайта и проверять разметку и контент в масштабе.
0:00–1:08 Вводная: на основе Custom Extraction делаем свой скрейпер. Урок построен на официальной документации Screaming Frog, ссылку на неё я прикладываю. Рекомендую посмотреть видео, прочитать документ и попробовать извлечь что-нибудь самостоятельно. 1:08–2:16 Способы…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.