Смотреть урок
Дополнительные файлы из урока
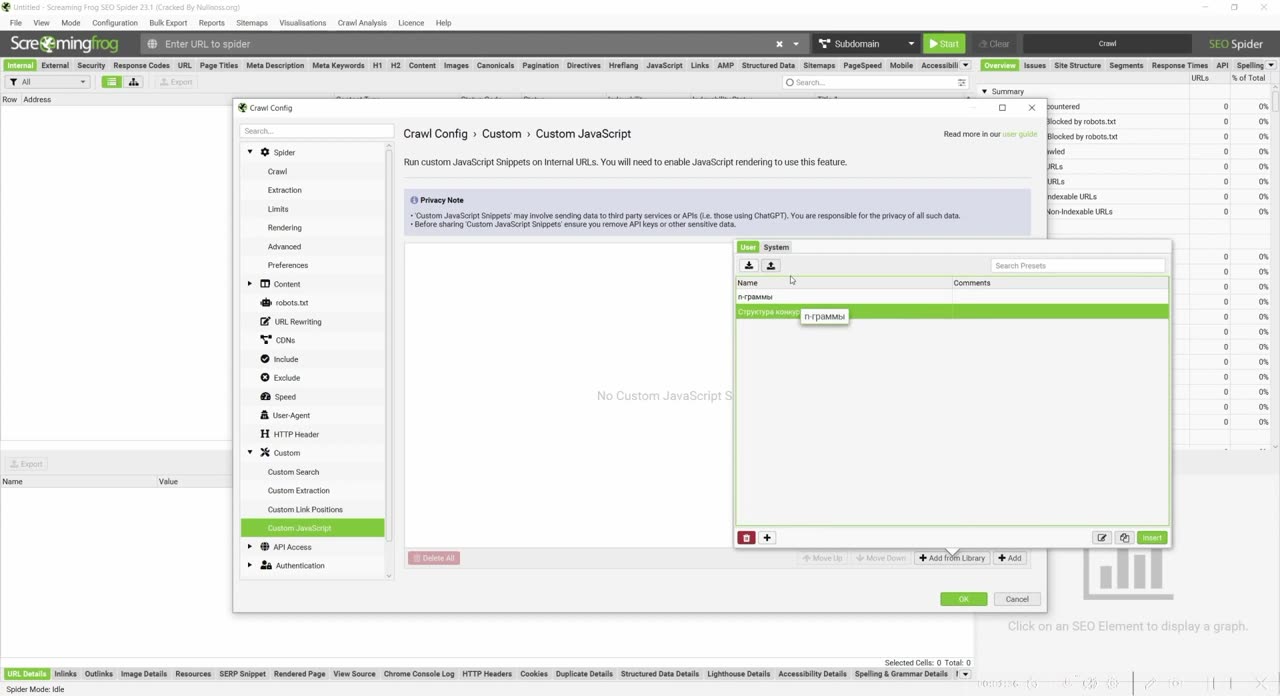
В уроке разбираю Custom JavaScript в Screaming Frog: скрипты, которые выполняются на страницах с ответом сервера 200 во время парсинга. Показываю, где подключается библиотека скриптов, как работают системные сниппеты (список шрифтов, сохранение изображений) и как вызвать внешний API из скрипта. В примере скрипт берёт H1 страницы, идёт с ним в топ Google через API Firecrawl и возвращает заголовки конкурентов. Отдельно объясняю разницу между Extraction и Action, таймаут и порядок выполнения сниппетов. Урок подойдёт тем, кто хочет доставать из страниц данные, которые не видны при обычном рендеринге, и подключать внешние сервисы прямо в краулинг.
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.
Войти
Вступить / купить доступ