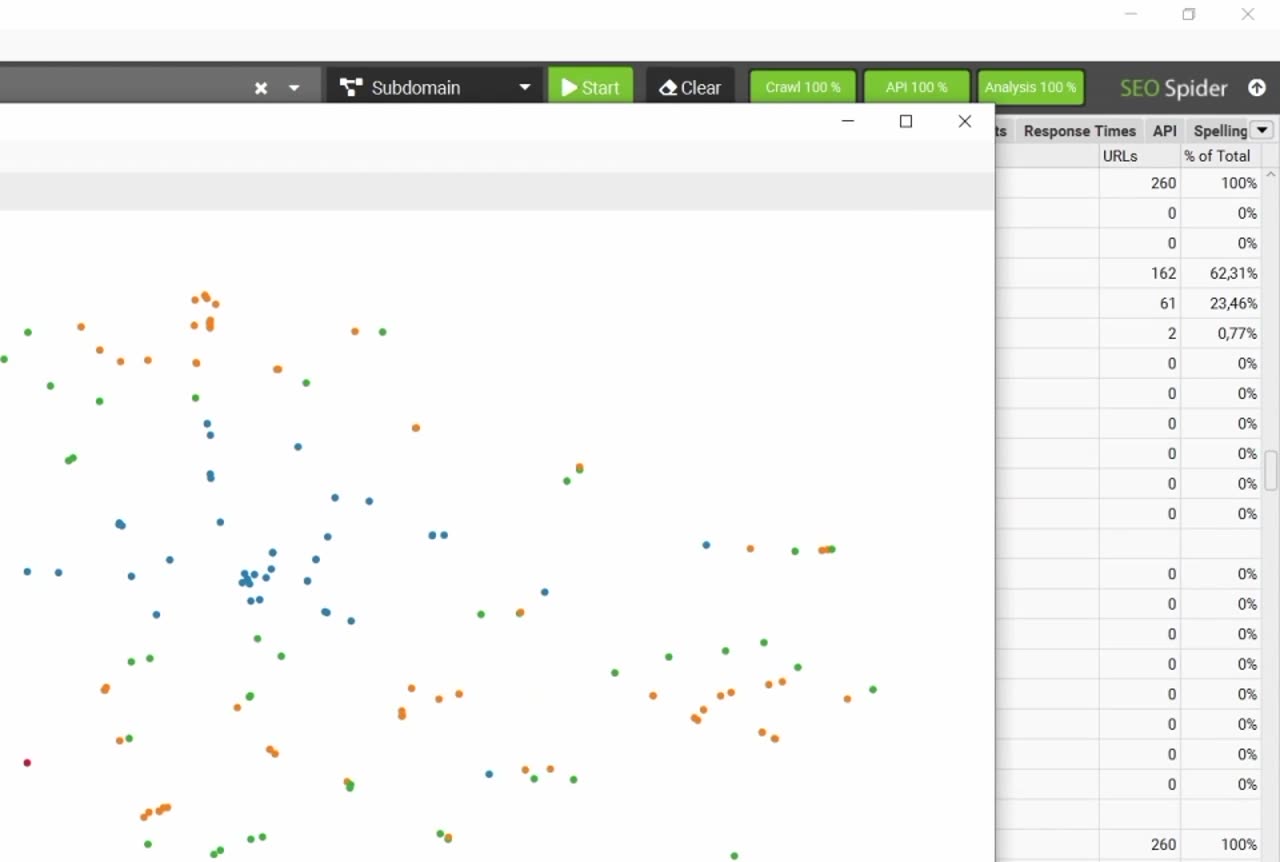
В уроке я разбираю эмбеддинги в Screaming Frog: что это такое, какие отчёты они дают и как их настроить. Сначала коротко объясняю базу, затем показываю результаты на сайте проката автомобилей: семантические дубли, поиск нерелевантного контента относительно центроида, семантический поиск и Content Cluster Diagram. После этого иду в настройки API и вкладку Embeddings. Отдельно показываю, почему при векторизации текста нужно исключать шапку и подвал, и где у векторного поиска проявляются слабые места. Урок подойдёт тем, кто ещё не работал с эмбеддингами и хочет понять, пригодятся ли они в их задачах.
0:00–2:10 Что такое эмбеддинг. Это векторное представление текста в многомерном пространстве модели. Близкие по смыслу понятия оказываются рядом, и расстояние между векторами показывает их близость. Из векторов в Screaming Frog можно получить несколько отчётов.
2:10–4:06 Отчёт о смысловых дублях. После сбора эмбеддингов запускается анализ и появляется отчёт по семантической близости. Он оценивает совпадение смыслов, а не контента. Страницы с одинаковым текстом определяются как абсолютные дубли, а соответствия около 0.95 показывают частичные дубли, например страницы разных моделей BMW.