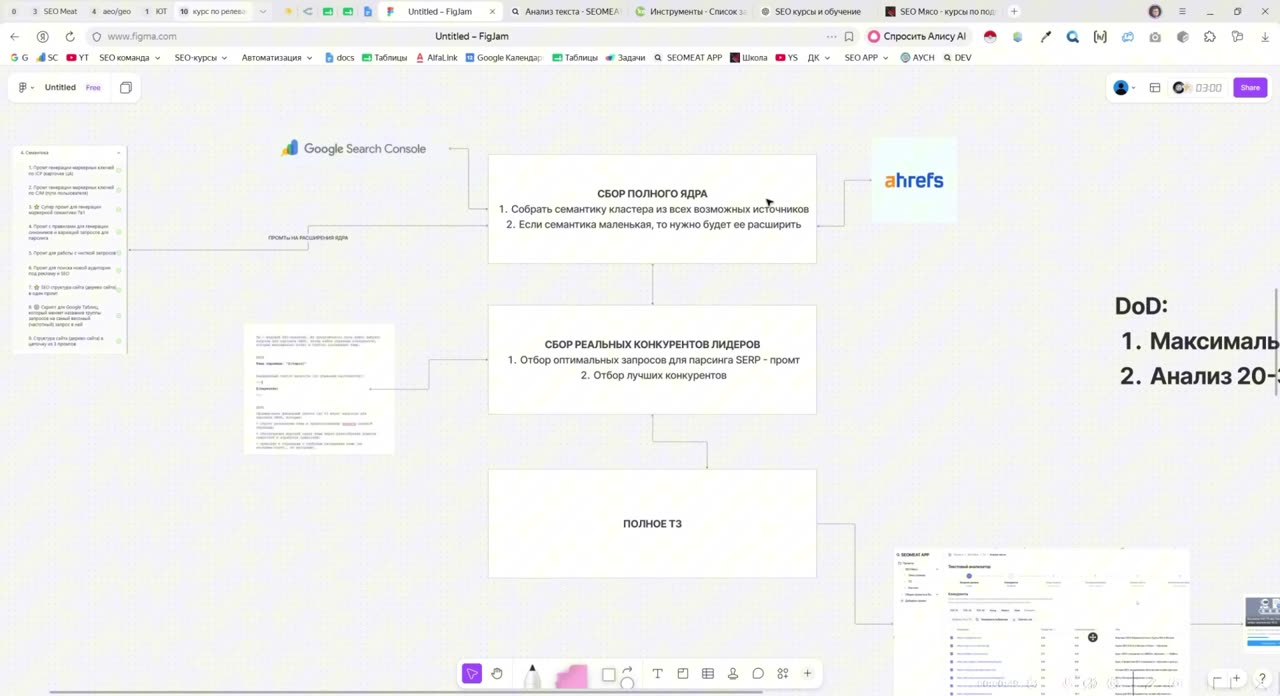
Разбираю на доске весь маршрут до полного ТЗ и объясняю, зачем он устроен именно так. Полное ТЗ здесь — это ТЗ по всей семантике страницы и по хорошо отобранным конкурентам; выгрузки по одному ключу для этого мало. Показываю первый шаг, сбор ядра: Search Console, Ahrefs, промты на расширение семантики и что делать, если инструментов под рукой нет. Дальше идёт второй шаг — сжатие тысячи с лишним запросов в 10–20 разнообразных, по которым уже собираются конкуренты, и объяснение, почему от разнообразия этого пула зависит, насколько полно ТЗ раскроет аспекты темы. Отдельно проговариваю быстрый формат для случая, когда страницу нужно просто сдать, и упоминаю ленивый вариант с агентом. Видео вводное: само ТЗ собираем дальше, в SEOMEAT APP.
0:00–0:34 Что я называю полным ТЗ. Это ТЗ, которое охватывает всю семантику страницы, весь кластер, и собрано по лучшим конкурентам. Закинуть один ключик в анализатор и выгрузить 20 конкурентов для этого мало: нужна полная семантика, хорошо отобранные конкуренты, посчитанные плотности, вхождения слов из запросов и других связанных с этими словами сущностей. На доске результат зафиксирован как DoD: максимально полная семантика и анализ двадцати-тридцати конкурентов.