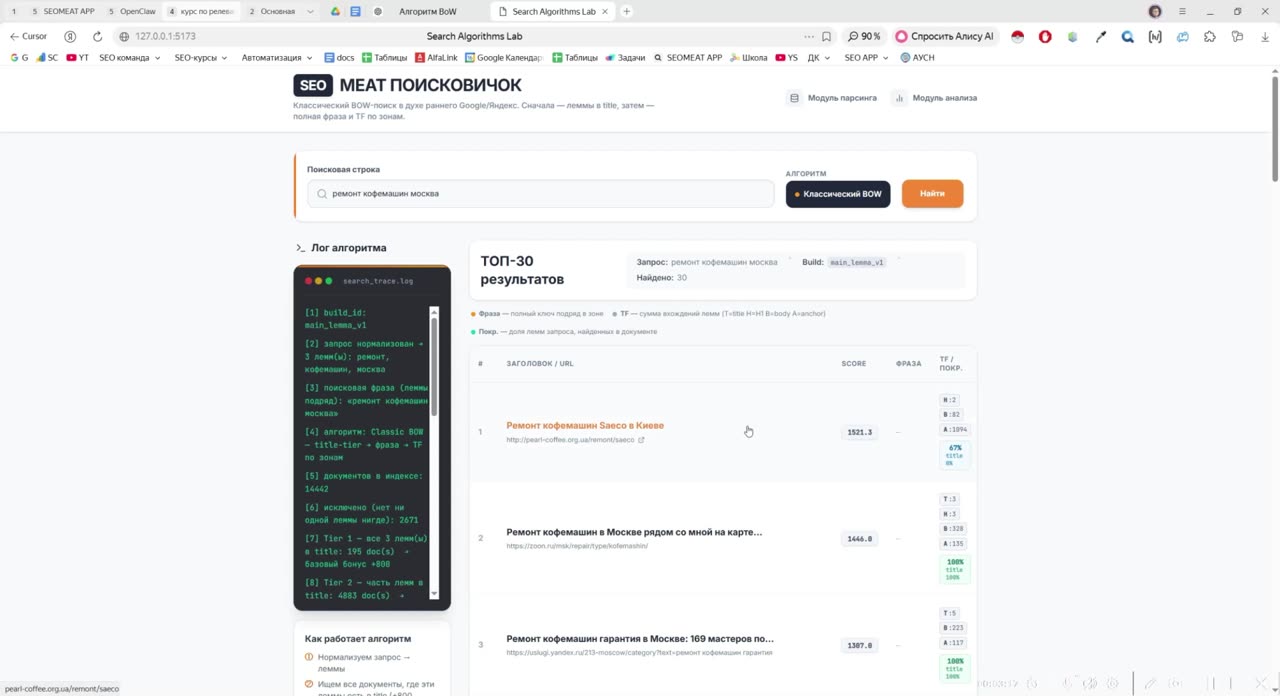
Этим уроком начинается модуль про алгоритмы поисковых систем. Я кратко объясняю, что такое Bag of Words (мешок слов), и показываю его работу на своём учебном поисковичке: запрос нормализуется до лемм, затем документы ищутся по совпадению лемм в title и в тексте. Дальше разбираю, где этот алгоритм применим (поиск по заголовкам, магазины, маркетплейсы, простые текстовые анализаторы) и чем он отличается от TF-IDF и BM25. Урок пригодится тем, кто хочет понимать основу, на которой строятся более сложные алгоритмы текстового ранжирования.