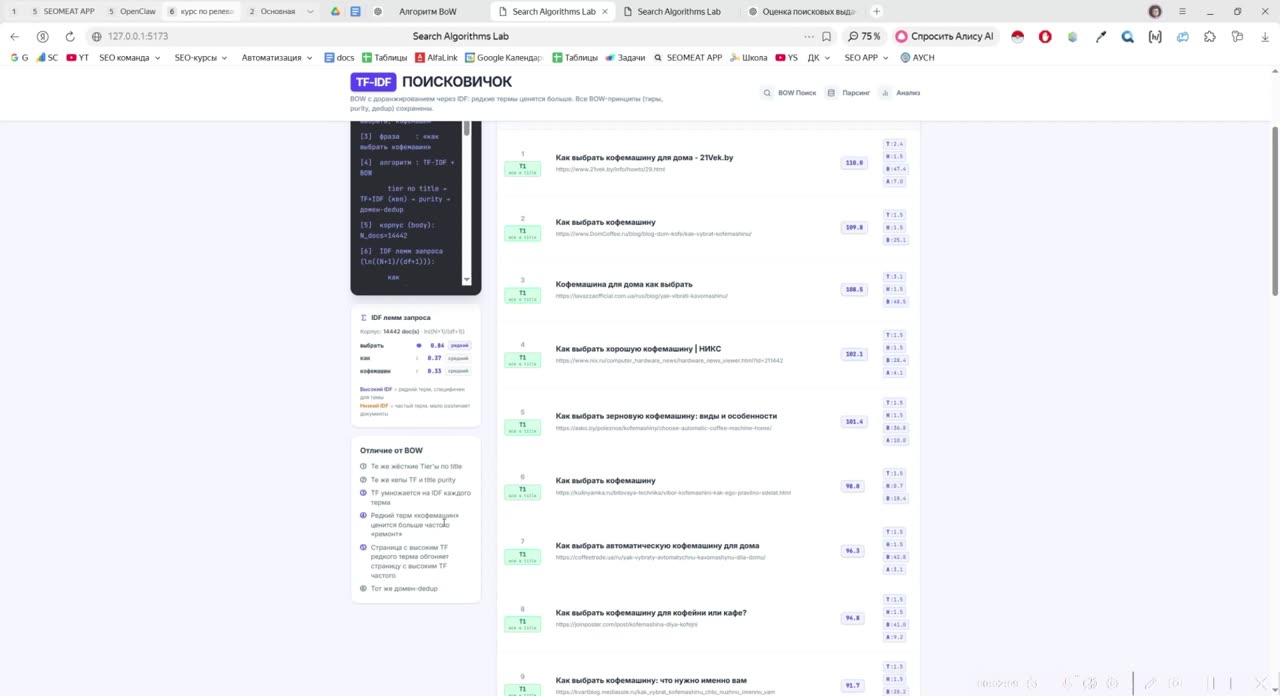
Я добавил в учебный поисковичок слой ранжирования по TF-IDF поверх алгоритма Bag of Words. В уроке показано, как алгоритм отличает общие слова запроса от редких и важных, как он переранжирует документы внутри тиров и на каких запросах работает хорошо. Отдельно разобраны два слабых места: отрицание в запросе и перекос на высокочастотном слове. Урок подойдёт тем, кто хочет понять, почему поисковые системы считают важность слов статистически, и подготовиться к алгоритму BM25.
0:00–1:44 Как устроен мой поисковичок под TF-IDF: берётся тот же Bag of Words, сайты так же отбираются по тирам, но дополнительно рассчитан IDF всех слов по всем документам. Индекс состоит из сайтов про кофемашины (магазины, ремонт, информационные статьи), поэтому слово «кофемашины» встречается почти везде, а слово «выбрать» в запросе «как выбрать кофемашину» редкое и лучше характеризует страницу. 1:44–2:55 Принцип TF-IDF: TF умножается на IDF каждого термина, чем реже термин в коллекции, тем выше его важность, и чем больше…
🔒
Этот материал доступен участникам Клуба. Войдите или оформите доступ,
чтобы читать целиком, открывать видео и комментировать.