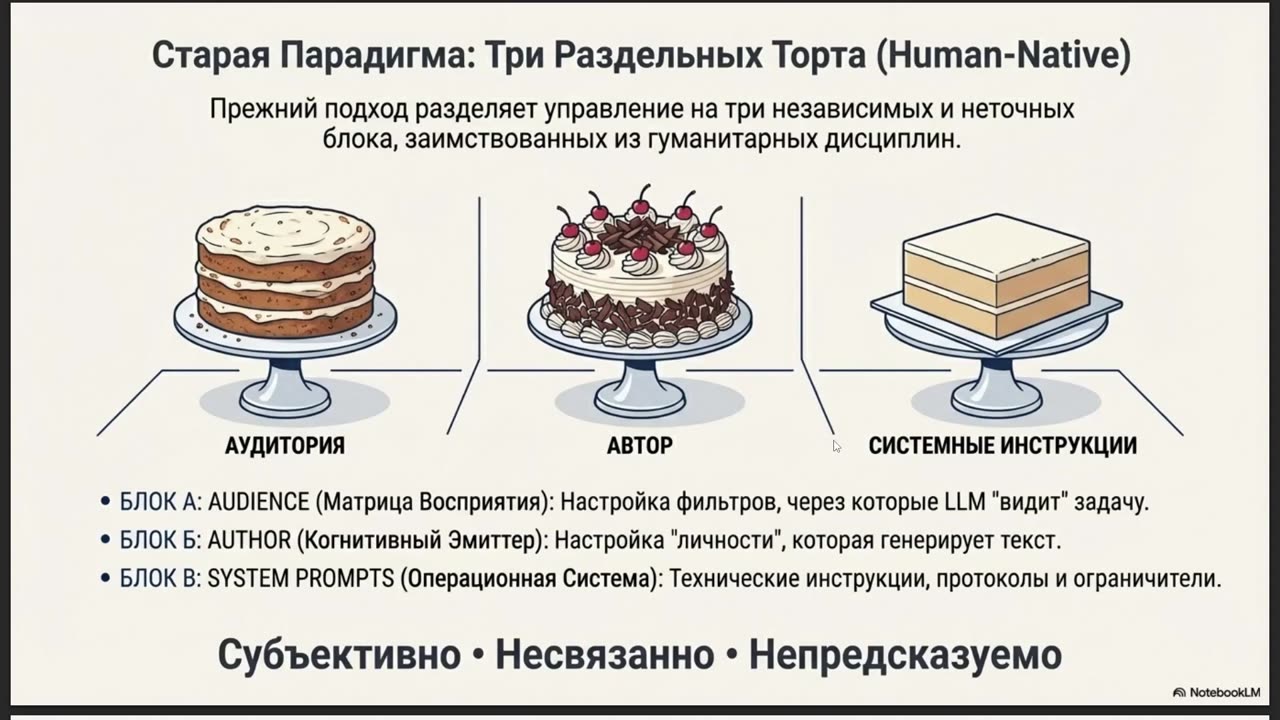
Небольшое лингвистическое исследование, которое я провёл, настраивая «убийцу копирайтеров» под себя. Я долго общался с Gemini в режиме реверс-инжиниринга, и мы выделили две парадигмы, по которым можно получать предсказуемый результат от нейросети. Результат исследования я загрузил в NotebookLM и попросил подготовить презентацию, по ней и построен урок. В первой парадигме запрос раскладывается на три линзы: аудитория, автор и системные инструкции. Во второй промпт описывается как распределение «бюджета внимания» между четырьмя эшелонами. В конце разбираются синтаксисы промпта (Markdown, XML, JSON) и числовой «эквалайзер». Урок пригодится тем, кто собирает промпты для статейных воркфлоу и хочет понимать, как устроены профили автора и читателя.