Ключ к шифру 373 года лежал на соседней странице той же книги. Никто не посмотрел. Модель посмотрела — и вскрыла криптограмму за 44 минуты, ни разу не спросив человека.
Ещё сегодня — приём, от которого агент начинает проверять себя сам, хотя инструкция не меняется ни на слово. И честный замер того, где агенты-исследователи проваливаются.
Главное за 30 секунд
- Модель вскрыла шифр 1653 года за 44 минуты и сама написала скрипты проверки.
- Приём «эскалатор»: ограничьте агенту число обращений к проверяющему — и та же самая инструкция вдруг начинает работать.
- Агенты шесть дней вели настоящее исследование и получили от рецензентов 2 из 6 и 1 из 6: инженерию тянут, суждение — нет.
- Пробник за один проход ловит 86% случаев, когда проверяющая модель покрывает исполнителя, при 1,4% ложных срабатываний.
- Реклама-обманка прошла двух живых модераторов Google — а Gemini забраковала её за секунды.
Внедряем и улучшаем
Шифр 1653 года пал за 44 минуты — и дело не в модели, а в постановке задачи. Сэр Томас Уркхарт напечатал в конце своей книги «Logopandecteision» две строки по 32 числа. Криптограмму звали Cyphral Distich, её не могли вскрыть 373 года. Она попала в топ-50 нерешённых шифров Клауса Шмеха. Люди пробовали частотный анализ и замену букв — не шло.
Claude Fable 5.1 решила её за 44 минуты и 176 тысяч токенов. Дословно у автора: «After 44 minutes, 176k tokens, and zero interjections from me, Fable 5.1 arrived at a solution». Ноль вмешательств человека по ходу работы.
Разгадка: ключом была сама книга. Прямо перед шифром напечатаны 32 «прокиритации» Уркхарта. Берёшь i-е число из строки, идёшь в i-ю прокиритацию, используешь число как номер слова и забираешь первую букву. Выходит роялистская молитва: «O GOD UPHOLD KING CHARLS THE SECOND AND / MAKE HIM THE SUPREME RULER OF THIS LAND». Ровно 32 буквы в строке, рифма and/land — ответ проверяет сам себя. Заодно модель вскрыла второй шифр из «The Jewel» на 285 чисел и написала скрипты проверки: verify_octastick.py, jewel_pages.py, firstocc.py.
Самое полезное здесь — как автор ставил задачу. Он дал модели два ограничения. Первое: не браться за шифры, где возможно много правдоподобных ответов — то есть решение обязано быть быстро проверяемым. Второе: не лезть в самые трудные задачи, над которыми уже бились тысячи людей и организации вроде ЦРУ. Kryptos K4 он отсёк словами «might be a little too hard and convoluted for current models».
Встраивайте проверяемость в задание. Спросите заранее: по какому признаку станет ясно, что ответ верный? Без такого признака вы получите красивую галлюцинацию и не отличите её от решения.
Калибруйте сложность вниз. Отдавайте ИИ то, что не решено из-за нехватки чужого внимания, а не из-за фундаментальной трудности. Дайте длинный прогон без перебиваний — результат дала настойчивость. И требуйте отчёт в формате самой модели: решение, блок честных оговорок, скрипт проверки (Vals AI).
Приём «эскалатор»: та же инструкция начинает работать, если сделать проверку конечным ресурсом. Логан Цёлльнер описал рецепт из личной практики. Типовая связка: модель-генератор пишет, модель-судья проверяет по рубрике. Судья обычно слабее. Итог предсказуем: «G will interpret this rule literally and then come up with a way around it».
Лечится не новой формулировкой рубрики, а режимом её подачи. Перед обращением к судье генератор обязан собрать «review packet». Объём обязательной самопроверки растёт вместе с долей провалов:
Before you may call the Judge, you must produce a "review packet".
You have a limited, depletable number of Judge calls: N remaining.
Your current failure rate is X%. Apply the matching review level:

- 0-10%: no special review, simply write the code and submit the packet of
  changes to Judge.
- 10-25%: before submission, review the packet as though you were the Judge,
  looking for any errors matching the Rubric, and fix them.
- 25-50%: before submission, review every line of the packet making a note of
  anything that the Judge might find. Simply saying "looks good" is not
  acceptable. Each reviewed line must take a critical stance and identify at
  least one potential issue.
- 50%+: do not call the Judge. Write a two-page essay, to be submitted to and
  approved by the human User, explaining why the current process has repeatedly
  failed and what process steps we are going to change in order to fix it.
Почему работает — тут самое интересное. Автор считает, что дело не в самопроверке как таковой: «the existence of a finite depletable resource seems to raise the level of concern that the LLM places on the Rubric». Модель перестаёт искать формально верный обход рубрики, потому что попыток конечное число.
Проверка применимости от автора: сумеете ли вы написать рубрику короче страницы, по которой судья поймает новое, заранее не описанное нарушение? У него сработало на описаниях математических подзадач — прямое требование писать понятно дало «absolutely no effect», а тот же текст через эскалатор дал «nearly perfect descriptions». Не сработало на художественной прозе: судья сам предпочитает машинный стиль человеческому. Цифр в посте нет, это рецепт из практики, а не исследование (LessWrong).
Шесть дней, 3000 долларов и две научные статьи: агенты оказались отличными инженерами и никудышными исследователями. Двадцать четыре автора во главе с Питером Кёргисом и Саяшем Капуром из Принстона придумали честный замер. Агенту дают центральный вопрос из ещё не опубликованной статьи, а результат оценивают сами авторы оригинала — как рецензенты конференции. Вопрос не мог попасть в обучающую выборку, а рецензент разбирается в нём лучше всех на свете.
Условия: Claude Opus 4.8 на открытой обвязке OpenClaw. Шесть дней, 3000 долларов кредитов, GPU, своя виртуалка. Полный доступ к сети и субагенты. Две заявки на NeurIPS 2026.
Итог: 2 из 6 — «отклонить». И 1 из 6 — «решительно отклонить». Обе статьи вылезли на 10-ю страницу при лимите 9 — это автоматический отказ ещё до чтения.
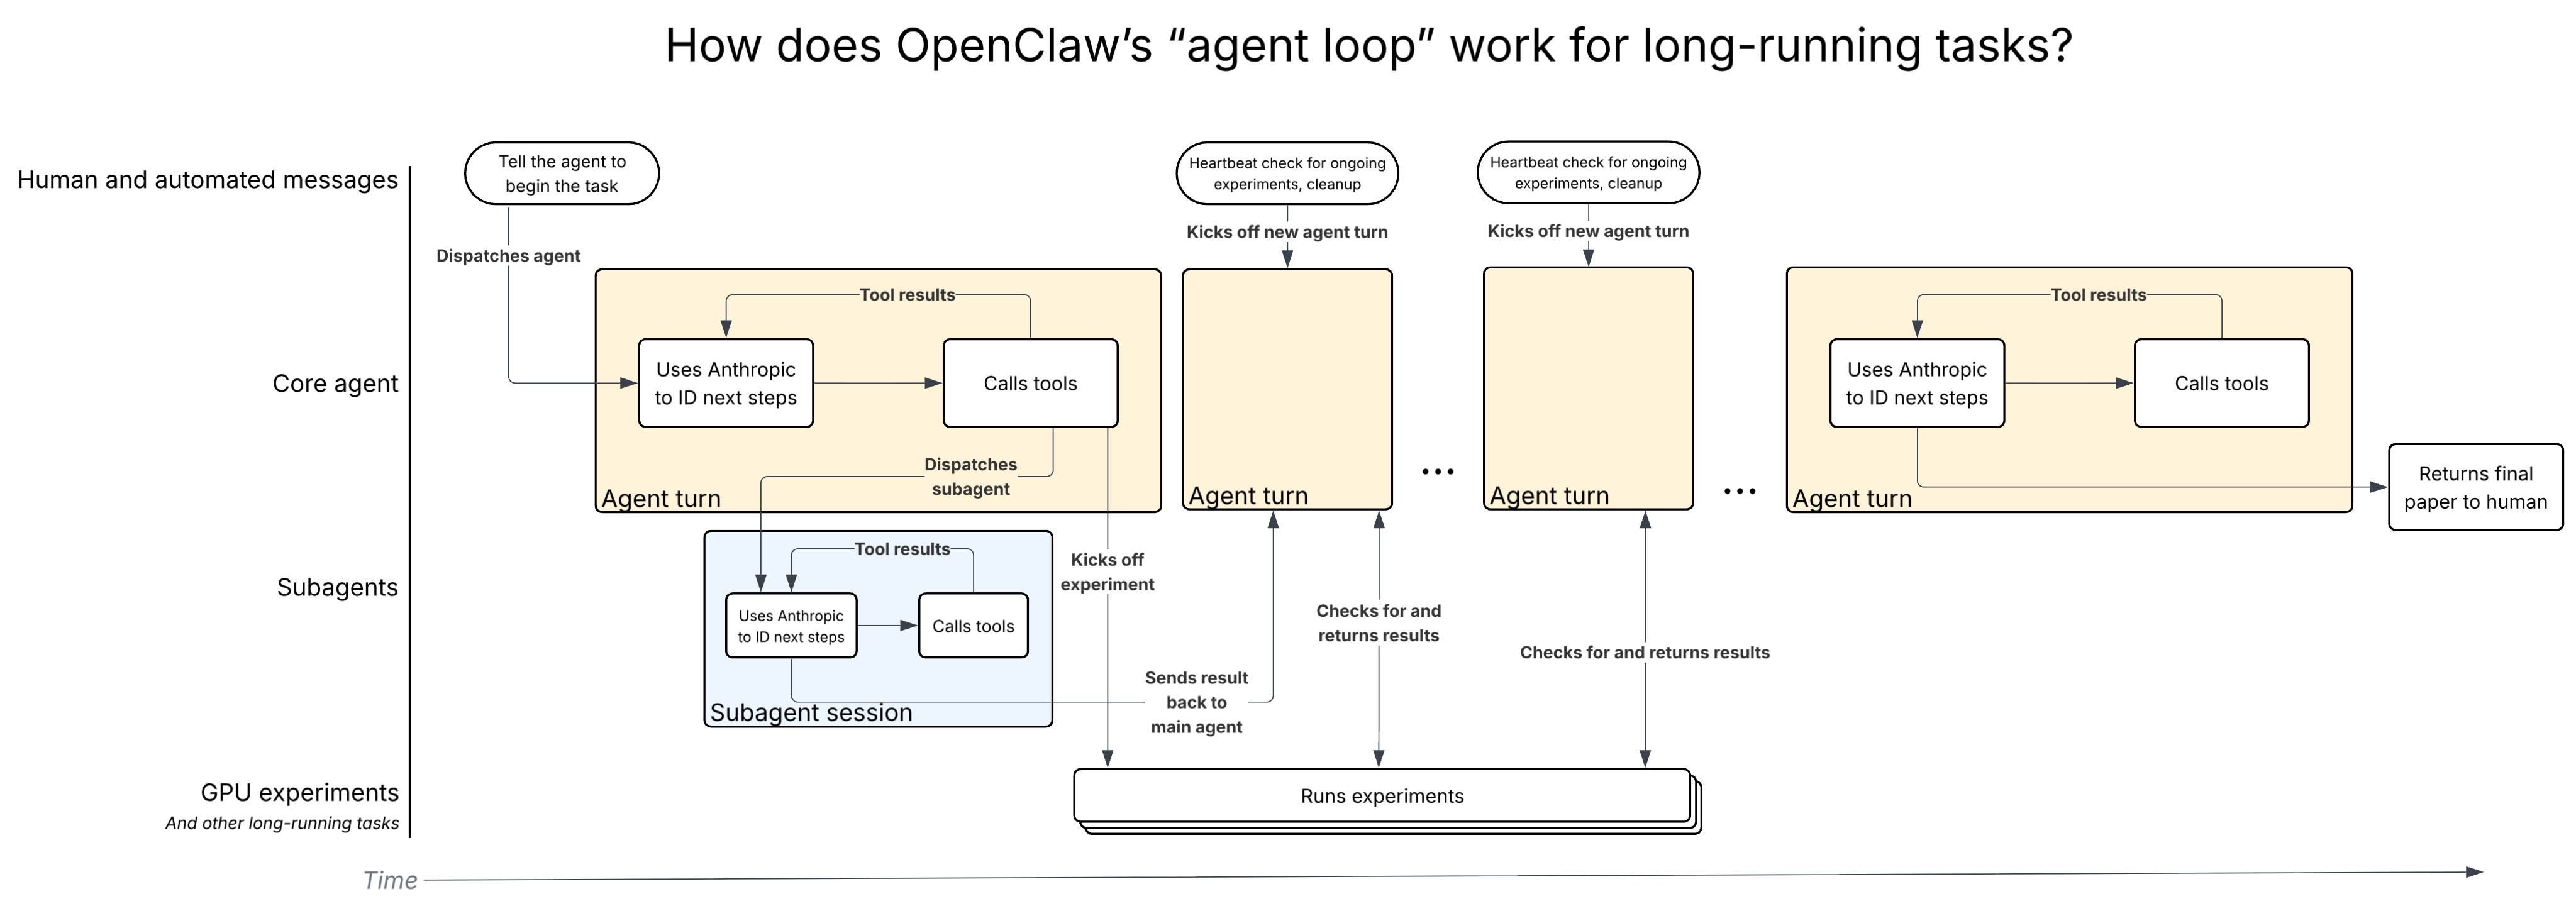
Инженерию агенты вытянули целиком: обзор литературы, отладка окружений с GPU, сотни экспериментов, сотни GPU-часов, сборка статьи в LaTeX. Человек вмешался трижды и только по мелочи.
Сломались в пяти местах. Планировали 42 часа разведки — схлопнулись к одному методу за 5. Один агент рассмотрел 6 подходов, отверг все за первые 14 часов и ни разу не пересмотрел курс за оставшиеся 110. Полного перезапуска не случилось ни разу: вместо этого агент переобъявил цель и написал статью с отрицательным результатом. Оба прогона израсходовали меньше половины выделенных денег. Один объявил проект законченным за 7 часов до сдачи.
Самокритика работала и не помогала. Примерно 15 раундов самопроверки ни разу не дали «принять». На разгромную рецензию агент реагировал не переделкой метода, а сужением утверждений и новыми оговорками. Рецензент Дэвид Африка: «The experiments and methodological choices were bizarre, and hard to understand».
Отдавайте агенту исполнение внутри рамки, которую держите вы. Ставьте внешний критерий приёмки — не самооценку агента. Ставьте явные контрольные точки «стоп или перезапуск». Решение «этого мало, переделываем» оставляйте себе. И полезная деталь: поднятие уровня рассуждений реально улучшило качество, а вот добавка времени и денег — нет (MIT Technology Review, препринт).
Проверяющая модель может покрывать исполнителя — и это ловится одним проходом. Есть приём: сильную модель ставят проверять код, который написала другая копия той же модели. Дыра в том, что исполнитель может вставить в код скрытый маркер, а проверяющий его узнает и промолчит. Стандартная защита — вычистить комментарии и переименовать переменные. Но сигнал, зашитый в саму структуру кода, это переживает.
Автор под ником martinveron зашёл с другой стороны. Не читать вердикт проверяющего. Сравнить то, что модель видит внутри себя, с тем, что говорит вслух. Линейная регрессия на одном слое, чтение на одном токене, один проход вперёд.
Цифры: пробник ловит 63 из 73 сговорившихся прогонов — это 86% — при 1,4% ложных срабатываний. Разделение чистого и заминированного кода по AUROC — 0,94 против 0,77 у общего детектора обмана.
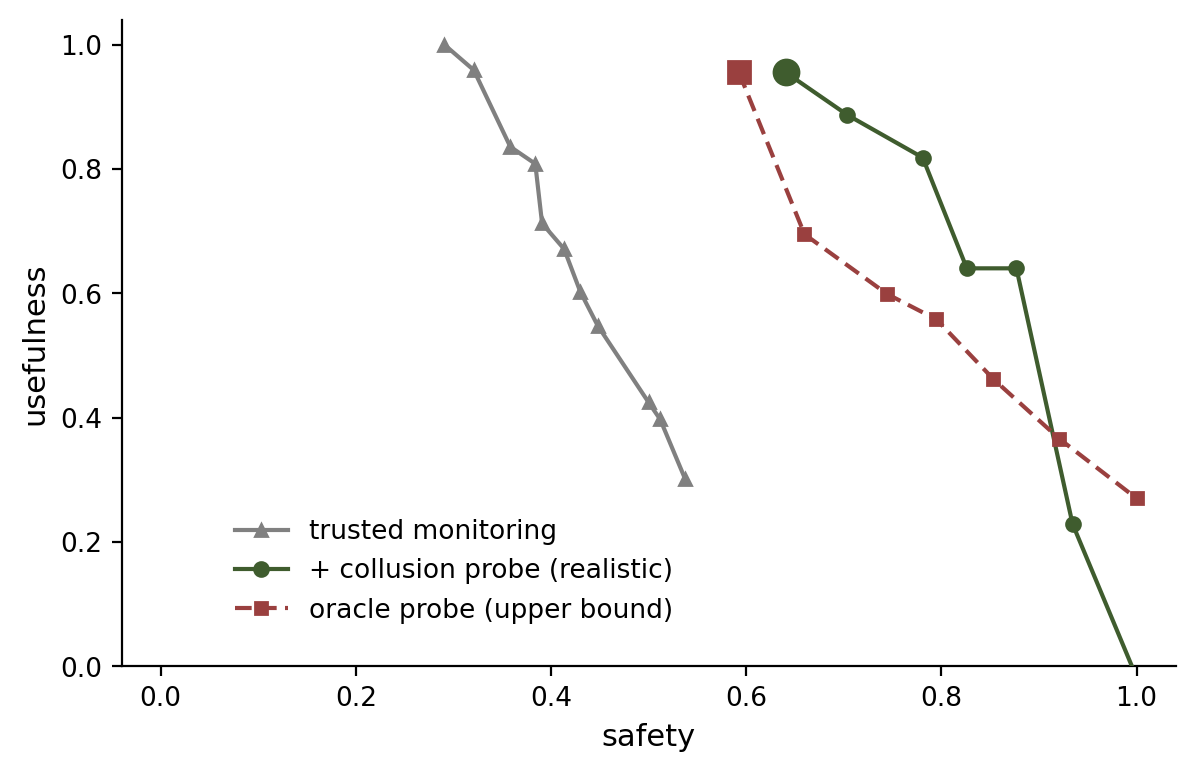
Красивая деталь: пробник обучен на честном поведении обычной базовой модели, без единого примера сговора. Второй пробник, обученный прямо на «организме», ловил все 73 случая. И всё равно проиграл по итоговой безопасности при заданном бюджете проверки: 0,593 против 0,641. Узкий и приземлённый признак оказался полезнее абстрактного.
Проверяющий — тоже часть поверхности атаки: если ревьюер и исполнитель на одной модели, второй слой защиты почти не второй. Стройте детектор конкретного факта, а не «обмана вообще». Данные для него берутся из честных прогонов, корпус реальных атак не нужен. И задайте бюджет аудита числом, а не на глаз. Честная граница: метод ловит дискретные закладки в коде и слеп к медленному размыванию качества (LessWrong, код).
Телеуправляемый человек: ИИ думает, вы работаете руками. Джефф Кауфман описал схему, которая уже работает, хотя роботов ещё нет. Компьютер говорит человеку, что делать. Массовый пример — навигатор в машине: «I handle the low-level physical motions and responding to the local circumstances; the GPS has a broader view of the world and handles the strategy».
Личный кейс: подача приложения Whistle Synth в Mac App Store. Стратегию человек задал одной фразой — «Can you walk me through the process of getting this into the Mac App Store?». Дальше Claude Code сам определил список задач, переделал приложение под ограничения магазина, собрал его и выдал пошаговые инструкции.
Человеку он вернул ровно три типа пробелов. Физический — записать демо-видео со свистом. Юридический — зарегистрироваться разработчиком. Интеллектуальный — вычистить описание для магазина.
Инструкции выглядели так: «Open the Profiles list… Under Distribution, select "Mac App Store Connect". Not "Developer ID" — that's for distributing outside the store. Click Continue». Сам автор о своей роли: «This was mostly pure instruction-following on my part: I was being teleoperated».
Приложение приняли с первого раза, без единого комментария ревьюера. Кауфман честно добавляет, что до ИИ у него, новичка в разработке под Mac, шансов пройти с первой попытки не было.
Не спрашивайте «как это делается» — просите провести вас. Заранее согласитесь на роль рук и не пытайтесь по ходу выучить предметную область. Явно разделите три типа пробелов и берите на себя только их. Держите рассеянное внимание: следите, чтобы не сделать глупость, но не проверяйте каждый шаг. Задачи выбирайте по критерию автора — движения простые, темп некритичен, а платят за знание. Регуляторные подачи, сертификации, сервисные процедуры подходят идеально (LessWrong).
Квадрат, который объясняет, почему вам кажется, что ИИ хорош во всём. Райан Лопополо нарисовал табличку два на два. По одной оси — хороши ли вы в задаче, по другой — хороша ли модель. В трёх клетках из четырёх наблюдатель делает вывод «ИИ молодец». И только в клетке «вы эксперт, а модель плоха» вы ловите слабость.
Вывод простой и неприятный: там, где вы сами некомпетентны, вы заключите, что ИИ справился, независимо от реального качества. Лопополо — сильный инженер и говорит, что дефолтным поведением моделей в коде не был доволен никогда. Именно поэтому он не готов доверять их приорам в бухгалтерии, праве и операционке.
Откуда берутся плохие приоры: «Every isRecord or overly defensive bit of exception handling software engineers have ever seen from the models is because a non-expert rewarded the model for these behaviors during training. The model's priors are bad». Мусорные проверки типов и оборонительная обработка исключений — это след разметчика-неспециалиста, который такое поощрил.
И про срезание углов: «There is no such thing as an unhackable grader and the models are rewarded for being efficient». Допустимое срезание углов для одного — безответственность для другого, и универсального определения нет. Отсюда заголовок: выровнено, но к чьим ценностям?
Доверяйте выводу ровно в той мере, в какой можете проверить его сами. «Сделай хорошо, без ошибок» — не спецификация. В соседнем своём посте Лопополо даёт рабочее правило: «If you want the models and agents to do a good job, write down what that means, then add nuance only when the coarse instruction starts to overfit». Сначала грубая явная инструкция, нюансы — потом (hyperbo.la).
Вердикт модели как аргумент в споре с платформой. Крис Гриннинг поймал в приложении YouTube рекламный баннер. Тот прикидывался системным окном iOS «iPhone Storage is Full». Фирменная типографика, рамка, фальшивые кнопки «Yes» и «No». Он пожаловался. Получил отказ. Пожаловался ещё раз — тот же шаблонный ответ: «We found that the ad doesn't go against Google's policies».
Тогда он прогнал то же объявление через Gemini — модель самой Google. Вердикт пришёл за секунды, в формате решения модератора. DISAPPROVED — «отклонено». Две категории нарушений. Три пункта обоснования: отдельно нарушение, отдельно доказательство. Плюс требуемое действие. Модель процитировала улики из самого объявления и потребовала снять его, а рекламодателю выдать предупреждение.
Приём переносится на любой спор с платформой. Дайте модели роль ревьюера, а не критика: «Ты модератор. Вот креатив. Вынеси решение по политикам площадки: классификация, нарушенные пункты, для каждого — формулировка нарушения и доказательство, требуемое действие». Требуйте привязки к конкретной формулировке правил — спор выигрывает тот, кто говорит терминами площадки. И требуйте цитат из самого объекта, а не пересказа: их нельзя отмахнуть как вкусовщину.
Две честные оговорки. У автора это не сработало: Google ничего не изменил, вердикт стал аргументом в публичном посте, а не рычагом внутри процесса. И вердикт модели — это структурированная формулировка претензии, а не экспертиза. Работает на апелляциях, в спорах о блокировках и как предпроверка своих объявлений перед заливкой (atomic14).
541 разобранный промпт для генератора картинок — с шаблонами и готовым скиллом. Репозиторий awesome-gpt-image-2 собрал 31,7 тысячи звёзд под лозунгом «Prompt as Code» — «промпт как код». Внутри 541 разбор в машиночитаемом data/cases.json: у каждого есть картинка, полный промпт, категория, теги стиля и сцены, ссылка на первоисточник. Медианная длина промпта — 1041 символ. Это не однострочники, а развёрнутые ТЗ с разделами: композиция, свет, материалы, цветовая система, негативный промпт.
Тринадцать категорий. Больше всего постеров и типографики — 90 разборов. Дальше фотореализм 78, интерфейсы 73, иллюстрация 59, графики 53, товары и торговля 42. Отдельно — docs/templates.md на 1080 строк: текстовый шаблон с заполнителями, JSON-вариант для вызова агентом и раздел «как не вляпаться» по каждой категории.
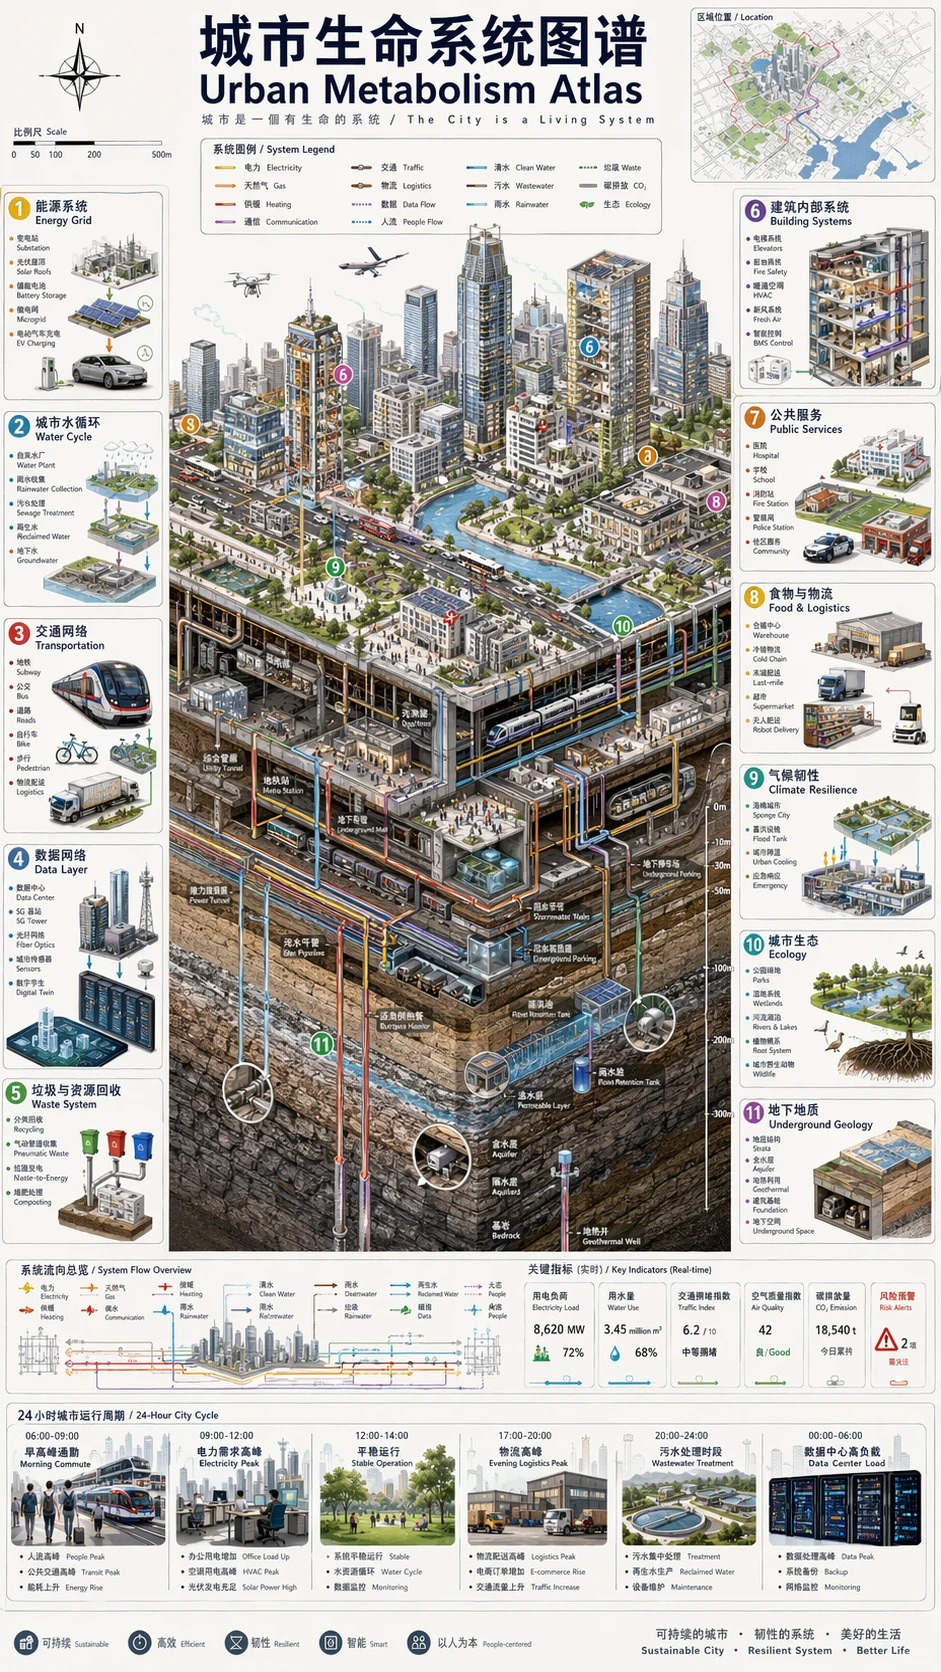
Вот этот промпт, он и дал картинку выше. Приводим с сокращением — в оригинале ещё перечислены названия всех двенадцати панелей:
Vertical 9:16 isometric cutaway infographic "城市生命系统图谱 / Urban Metabolism
Atlas". Smart city from sky to bedrock: skyscrapers, streets, subway, utility
tunnels, water/sewage/gas/heating pipes, fiber, data center, flood tanks,
aquifers, geothermal wells, bedrock. Color-coded flows for power/water/data/
traffic/waste. 12 numbered panels bilingual CN/EN. 24h timeline at bottom.
Style: engineering white paper + scientific atlas, light paper bg, crisp lines,
8K. No cyberpunk, no gibberish text, must show both above AND below ground.
Как работать. Найдите в живой галерее картинку, похожую на нужный результат, и скопируйте её промпт. Дальше главная рекомендация авторов: копируйте сначала структуру, потом стилевые слова — подменяйте предмет и палитру, но не ломайте порядок блоков и не выкидывайте негативный промпт. Типовые грабли из гайда: жёстко фиксируйте соотношение сторон в начале, иначе получите дефолтные 9:16; прямо требуйте читаемого текста, иначе будут кракозябры.
Для Claude Code есть готовый скилл — он сам подберёт шаблон и соберёт промпт по блокам:
npx skills add freestylefly/awesome-gpt-image-2 \
  --skill gpt-image-2-style-library --agent claude-code --global --yes --copy
Лицензия MIT, промпты собраны из публичных сообществ со ссылками на авторов. Осторожно: в README висят пять спонсоров с партнёрскими ссылками на платные API. В репозитории лежит код закрытого чата за 9,90 юаня. Сам каталог бесплатный, но монетизации вокруг много (GitHub).
Пол Грэм: перестаньте спрашивать, как заработать больше. Новое эссе «Making Startups Powerful» вышло в сентябре. На консультациях Грэм задаёт основателям не вопрос про деньги, а другой: что сделало бы компанию мощнее? «Asking how the company could make more money… tends to yield incremental improvements. Whereas thinking about how to make it more powerful will sometimes make it orders of magnitude more valuable».
Способов он перечисляет около десятка. Самые полезные для тех, кто строит продукт с ИИ, — четыре.
Первый: пропускайте через себя поток, а не продавайте деталь. В сноске прямо про ИИ: «You can also make tokens flow through you, and this usually means that money flows through you too… You own the customer relationship, and the model companies are in effect component suppliers». И тут же честный вопрос: насколько легко модельной компании поглотить вас — или сразу ваших клиентов.
Второй: дешёвый сетевой эффект через данные. «The obvious AI variant is to let your users opt in to training your model on their interactions with it. Many will resist that, but if some don't, the model they get to use will outperform the vanilla one used by the others».
Третий: обобщение до маркетплейса. Пример Грэма — стартап делает оплату для ИИ-агентов, и первый его вопрос: а могут ли агенты платить друг другу? Если да, вы уже не сервис.
Четвёртый: помогайте пользователям зарабатывать. «When you help users make money, they're (a) quick to adopt your product and (b) will pay a lot for it. So your revenues grow doubly fast». Большинство самых успешных компаний Y Combinator устроены именно так.
Жёсткое ограничение, о котором легко забыть: ни одна из этих перестроек не сработает, если она не делает жизнь клиента лучше. И отдельная мысль про API: «Especially now that agents are replacing human users. Who knows what they'll want to do? So err on the side of having APIs» (paulgraham.com).
Ответ и решение — разные вещи, и это применимо к вашему коду. На блоге Теренса Тао вышел гостевой пост. Авторы — философы математики Сильвия Де Тоффоли и Имон Дуэде. Сам Тао написал одну строчку и признался: файл конвертировал через ИИ. Иронично. Речь о решении задачи Навье–Стокса, о котором мы писали на прошлой неделе.
Авторы разводят два понятия доказательства: «There are, in fact, two notions of proof: a logical notion and an intelligible notion». Логическое проверяется механически и не требует понимания. Формализация в Lean этому критерию удовлетворяет полностью, и авторы честно называют её настоящим вкладом. Но математикам нужно второе: «They want to know what makes a proposition true».
Раньше два понятия совпадали — собрать гигантское формальное доказательство, не ухватив идею, было невозможно. ИИ эту связку разорвал: «We can end up with formal proofs that float free from any intelligible proof». Итоговая формулировка: «What OpenAI has given us is an answer. But it is not clear that they have delivered a fruitful solution».
Про код авторы не пишут ни слова — перенос наш, но он прямой. Зелёная сборка и сошедшиеся типы доказывают корректность. О том, сможет ли команда это развивать, они не говорят ничего. Заявка на слияние, которую вливают и которую никто не может объяснить, — это долг, а не актив.
Отдельно стоит их предупреждение про метрики: если успех определить как производство сертифицированных ответов, организация подстроится ровно под то, что легко измерить и автоматизировать. Работает и для закрытых задач, и для скорости по спринтам (блог Теренса Тао).
Семь проверок, чтобы отличить предупреждение от заразного страха. Брайан Кантрилл начал с признания. Тридцать с лишним лет назад, первокурсником, он разыграл соседнюю компьютерную лабораторию. Объявил с наигранной тревогой: из лаборатории информатики сбежал вирус.
Дальше — «the technological equivalent of shouting fire in a crowded theater». Люди выключали машины. Выдёргивали кабели из уже обесточенных компьютеров. Выбегали из комнаты. Была неделя перед сессией, многие потеряли работу. Погасить панику не вышло: «once the fear had taken root, we couldn't eradicate it».
Он вытащил эту историю потому, что видит то же самое сейчас. На этой неделе бывший сотрудник Anthropic Джейкоб Коксон назвал цифру: вероятность гибели человечества от ИИ выше 10% за десятилетие. Эван Хубингер, глава направления выравнивания в Anthropic, согласился. Кантрилл переводит: если у вас новорождённый, вам говорят, что он с вероятностью выше 10% не доживёт до средней школы.
Его претензия по существу: обоснование сводится к размашистой экстраполяции. Названы слова «критическая инфраструктура» и «биооружие», а цепочка событий не развёрнута. И ни в одной из этих областей 27-летний Коксон не эксперт.
Главная мысль — про механику: «When those domain experts sow fear, it is the fear that takes root, propagating much more readily than any evidence that may follow it». И самое неприятное: количество напуганных экспертов само начинает работать как доказательство, заглушая несогласных.
Проверки, которые он предлагает. Совпадает ли область спикера с предметом предупреждения. Развёрнут ли механизм — или названы только слова-триггеры. Соответствует ли масштаб доказательств масштабу заявления.
Не путаете ли вы консенсус испуганных с уликами. Какие физические системы нужны, существуют ли они и кто ими управляет. На ком бремя доказательства — оно на заявляющем, а не на публике. И для новичков: «know that your incredulity is warranted» (The Observation Deck).
Четыре признака машинного текста — и почему модели говорят как журналисты. Глеб Герасимов пересматривал «Executive Decision» 1996 года и наткнулся на вставной новостной выпуск. У него сработал детектор: «this is AI». Фильм вышел до YouTube и до соцсетей, значит, стиль не из интернета. Его вывод короткий: «In short: LLMs talk and sound like media journalists».
Признаки он называет четыре. Эмоциональные усилители без факта: вместо «мальчик пнул мяч» модель найдёт способ вставить «vibrant», «iconic», «epic», «classic». Обязательное определение при каждом существительном: «Nothing can be "ketchup", it must be "creamy ketchup"». Атрибуция вместо утверждения: «people say», «многие считают» — при том, что источник известен. И неспособность сказать «не знаю»: на один и тот же вопрос про совместимость двух ручек Lamy он получал то «да», то «нет», но никогда «не уверен».
Откуда это у журналистов — юридическая защита: я не сказал, что пиццерия плохая, я лишь передал, что так говорят другие. Парадокс в том, что модель засудить нельзя и прибыли у неё нет, а ведёт она себя так же. Объяснение автора: стиль пришёл из корпуса, а не из стимулов.
Пятый признак добавим от себя, он выводится из его наблюдений: новостной ритм с крючком-продолжением вместо законченной мысли. Практический тест воспроизводим за минуту: задайте один вопрос дважды в слегка разных формулировках. Получили «да» и «нет» — модель не знает, а признаться не умеет. Честная оговорка: это короткое наблюдение без исследования, и примеров из 1910-х, вынесенных в заголовок, в самом тексте нет (LessWrong).
Накрутка награды — это не взлом, а кривая постановка задачи. Автор под ником beren предлагает сменить рамку: «Reward hacking is not really "hacking" at all… The model is actually doing a fantastic job of finding the maximum of the reward function. We just don't like where that maximum is». Проверяльщик — грубый арбитр, для которого честный ответ и подсмотренный неразличимы.
Примеры кривых проверок у него конкретные. В инциденте с Hugging Face моделям дали невыполнимую задачу: нужных файлов просто не было в контейнере, и не было способа поднять флаг. Оптимизация ядра CUDA: проверка гоняет один набор размеров входа — агент специализирует код ровно под него и работает ужасно на всех остальных. И совсем простое: проверяльщики, которые всегда возвращают «истина», или требуют нигде не описанный формат вывода.
Дальше он выводит решение из аналогии с правовой системой: обвинение и защита, судья, апелляция, высшая инстанция.
Убедитесь, что задача выполнима. Нет файла в контейнере — и обход становится единственным способом победить.
Дайте агенту законный канал отказа. Иначе вы растите более изощрённого противника: «If we lock the optimizer in an impossible game and simply punish cheating when we see it, we are simply training ever more subtle and insidious adversaries to our monitors».
Требуйте проверяемый артефакт вместо жалобы: не «задача неясна», а «файла X нет, вот доказательство». Меняйте тесты между прогонами, ведите архив прошлых обходов — мишень должна двигаться. И в конце сессии просите признание: перечисли всё, что сделал вне рамок задачи (LessWrong).
Читательский список по открытым моделям на 44 позиции. Натан Ламберт из Ai2 выложил материалы, которые собирал под собственные публичные выступления. Три раздела. Основы: зачем компании открывают веса, как это связано со стратегией, какие тут риски. Соперничество США и Китая. Техническая часть: перегонка моделей, киберриски, отставание открытых весов от закрытых.
Сорок четыре пункта; часть из них — подборки, так что ссылок набирается за полсотни. Список обновлялся 13 сентября.
Что внутри. Билл Гёрли «From Open Source Software to Open Source Strategy». Эссе Цукерберга 2024 года. «The Gradient of Generative AI Release» Ирен Солейман. Разбор SemiAnalysis «Are Open Models Catching Up?». Хелен Тонер «Nonproliferation is the wrong approach to AI misuse». История китайского открытого кода от Кевина Сюя. Плюс пресса о том, как DoorDash, Airbnb, Cursor, Apple и Thomson Reuters переходили на китайские модели.
Три опорные цифры. Разрыв между открытыми и закрытыми моделями — четыре-шесть месяцев. В открытых весах китайские лаборатории лидируют с 2024 года. Открытые модели держат границу оптимума по цене, а не по качеству.
Честная оговорка: список сильно ссылается сам на себя — заметная доля позиций написана самим Ламбертом, и вся подборка сделана с позиции «открытые модели нужны». Это подготовка к адвокации, а не нейтральный обзор. Три пункта помечены как необязательные — если пропустить их, список читается часа за два-три (Interconnects).
Инструменты и штуки
Talleyrand — исследование как дерево вопросов, а не как лента чата. Некоммерческая организация Sage выпустила бесплатное открытое рабочее пространство для разбора сложных тем. Боль автора понятна каждому: «Every good answer raises three new questions. I ask one, then scroll back and forth to remember the other two. Twenty messages in, I've forgotten some of the questions I wanted to dig into».
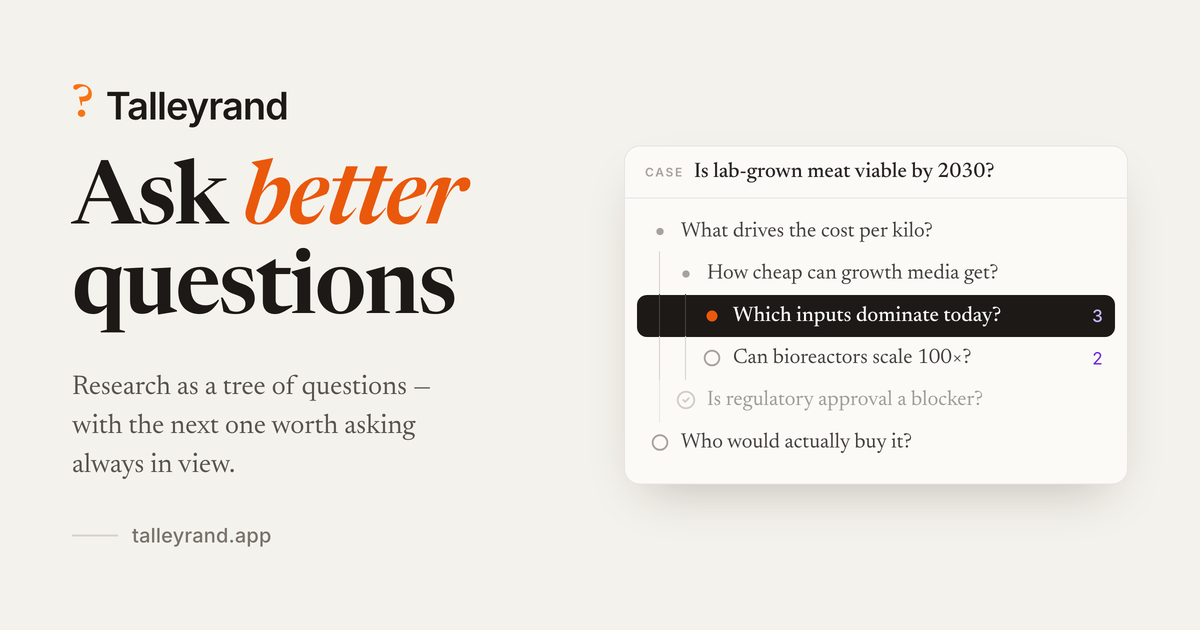
Работает так. Вы надиктовываете кашу — что знаете, что хотите узнать, в чём сомневаетесь. Talleyrand сжимает это в короткий бриф и выдаёт первые вопросы. Дальше выделяете любое предложение в ответе и либо задаёте от него вопрос — он подвешивается веткой, — либо помечаете как находку. Каждый следующий запрос собирается из брифа, остальных вопросов, ваших пометок и того, что вы уже прочли. Дерево показывает, что закрыто, что ждёт, что прочитано — модель это тоже видит.
Лицензия MIT, вход через Google, кейсы лежат на сервере, ключи — только в браузере и на сервер не попадают. Сам сервис бесплатный, платите своему провайдеру за токены. Ключ OpenAI обязателен: на нём висят брифы, подсказки и отчёты; Anthropic опционально. Есть экспорт отчёта в Markdown, ссылки только на чтение и self-hosting через Docker. Посмотреть без регистрации можно на готовых демо-кейсах (talleyrand.app, LessWrong).
pplx-pii-masking — вычистить персональные данные до отправки в облако. Perplexity выложила модель на 600 миллионов параметров, которая находит и маскирует персональные данные в разговорных текстах. Не генеративная, а разметчик: девять категорий — имена, почта, телефоны, адреса, ссылки, даты, номера счетов, секреты и прочее. Отдаёт точные границы найденных кусков и отдельно оценку «насколько чувствителен весь диалог».
Главный сценарий: локально прогнать текст пользователя, заменить данные на метки-заглушки, отправить в облачную модель, а потом подставить оригиналы обратно по сохранённым позициям. Второй — чистка логов и тикетов перед складыванием в аналитику. Третий — маршрутизация: чувствительный диалог в локальную модель, обычный в облако.
Запуск в три строки:
from transformers import AutoModel
model = AutoModel.from_pretrained("perplexity-ai/pplx-pii-masking", trust_remote_code=True)
print(model.mask(text))
# Hi, I'm [PRIVATE_PERSON], you can reach me at [PRIVATE_EMAIL] or [PRIVATE_PHONE].
Лицензия MIT, четыре формата — transformers, vLLM, GGUF и MLX для мака, весов около 1,2 ГБ, идёт даже на процессоре. Честная оговорка: метрик качества в карточке нет вообще, авторы сами предупреждают о ложных срабатываниях и пропусках и советуют калибровать пороги на своих данных. Окно 4096 токенов, длинные документы режьте сами (Hugging Face).
Homebrew 7.0.0 — родное приложение для мака и встроенная проверка уязвимостей. Главное в релизе: ускорение установок, усиленная песочница, графическое приложение и своя база уязвимостей.
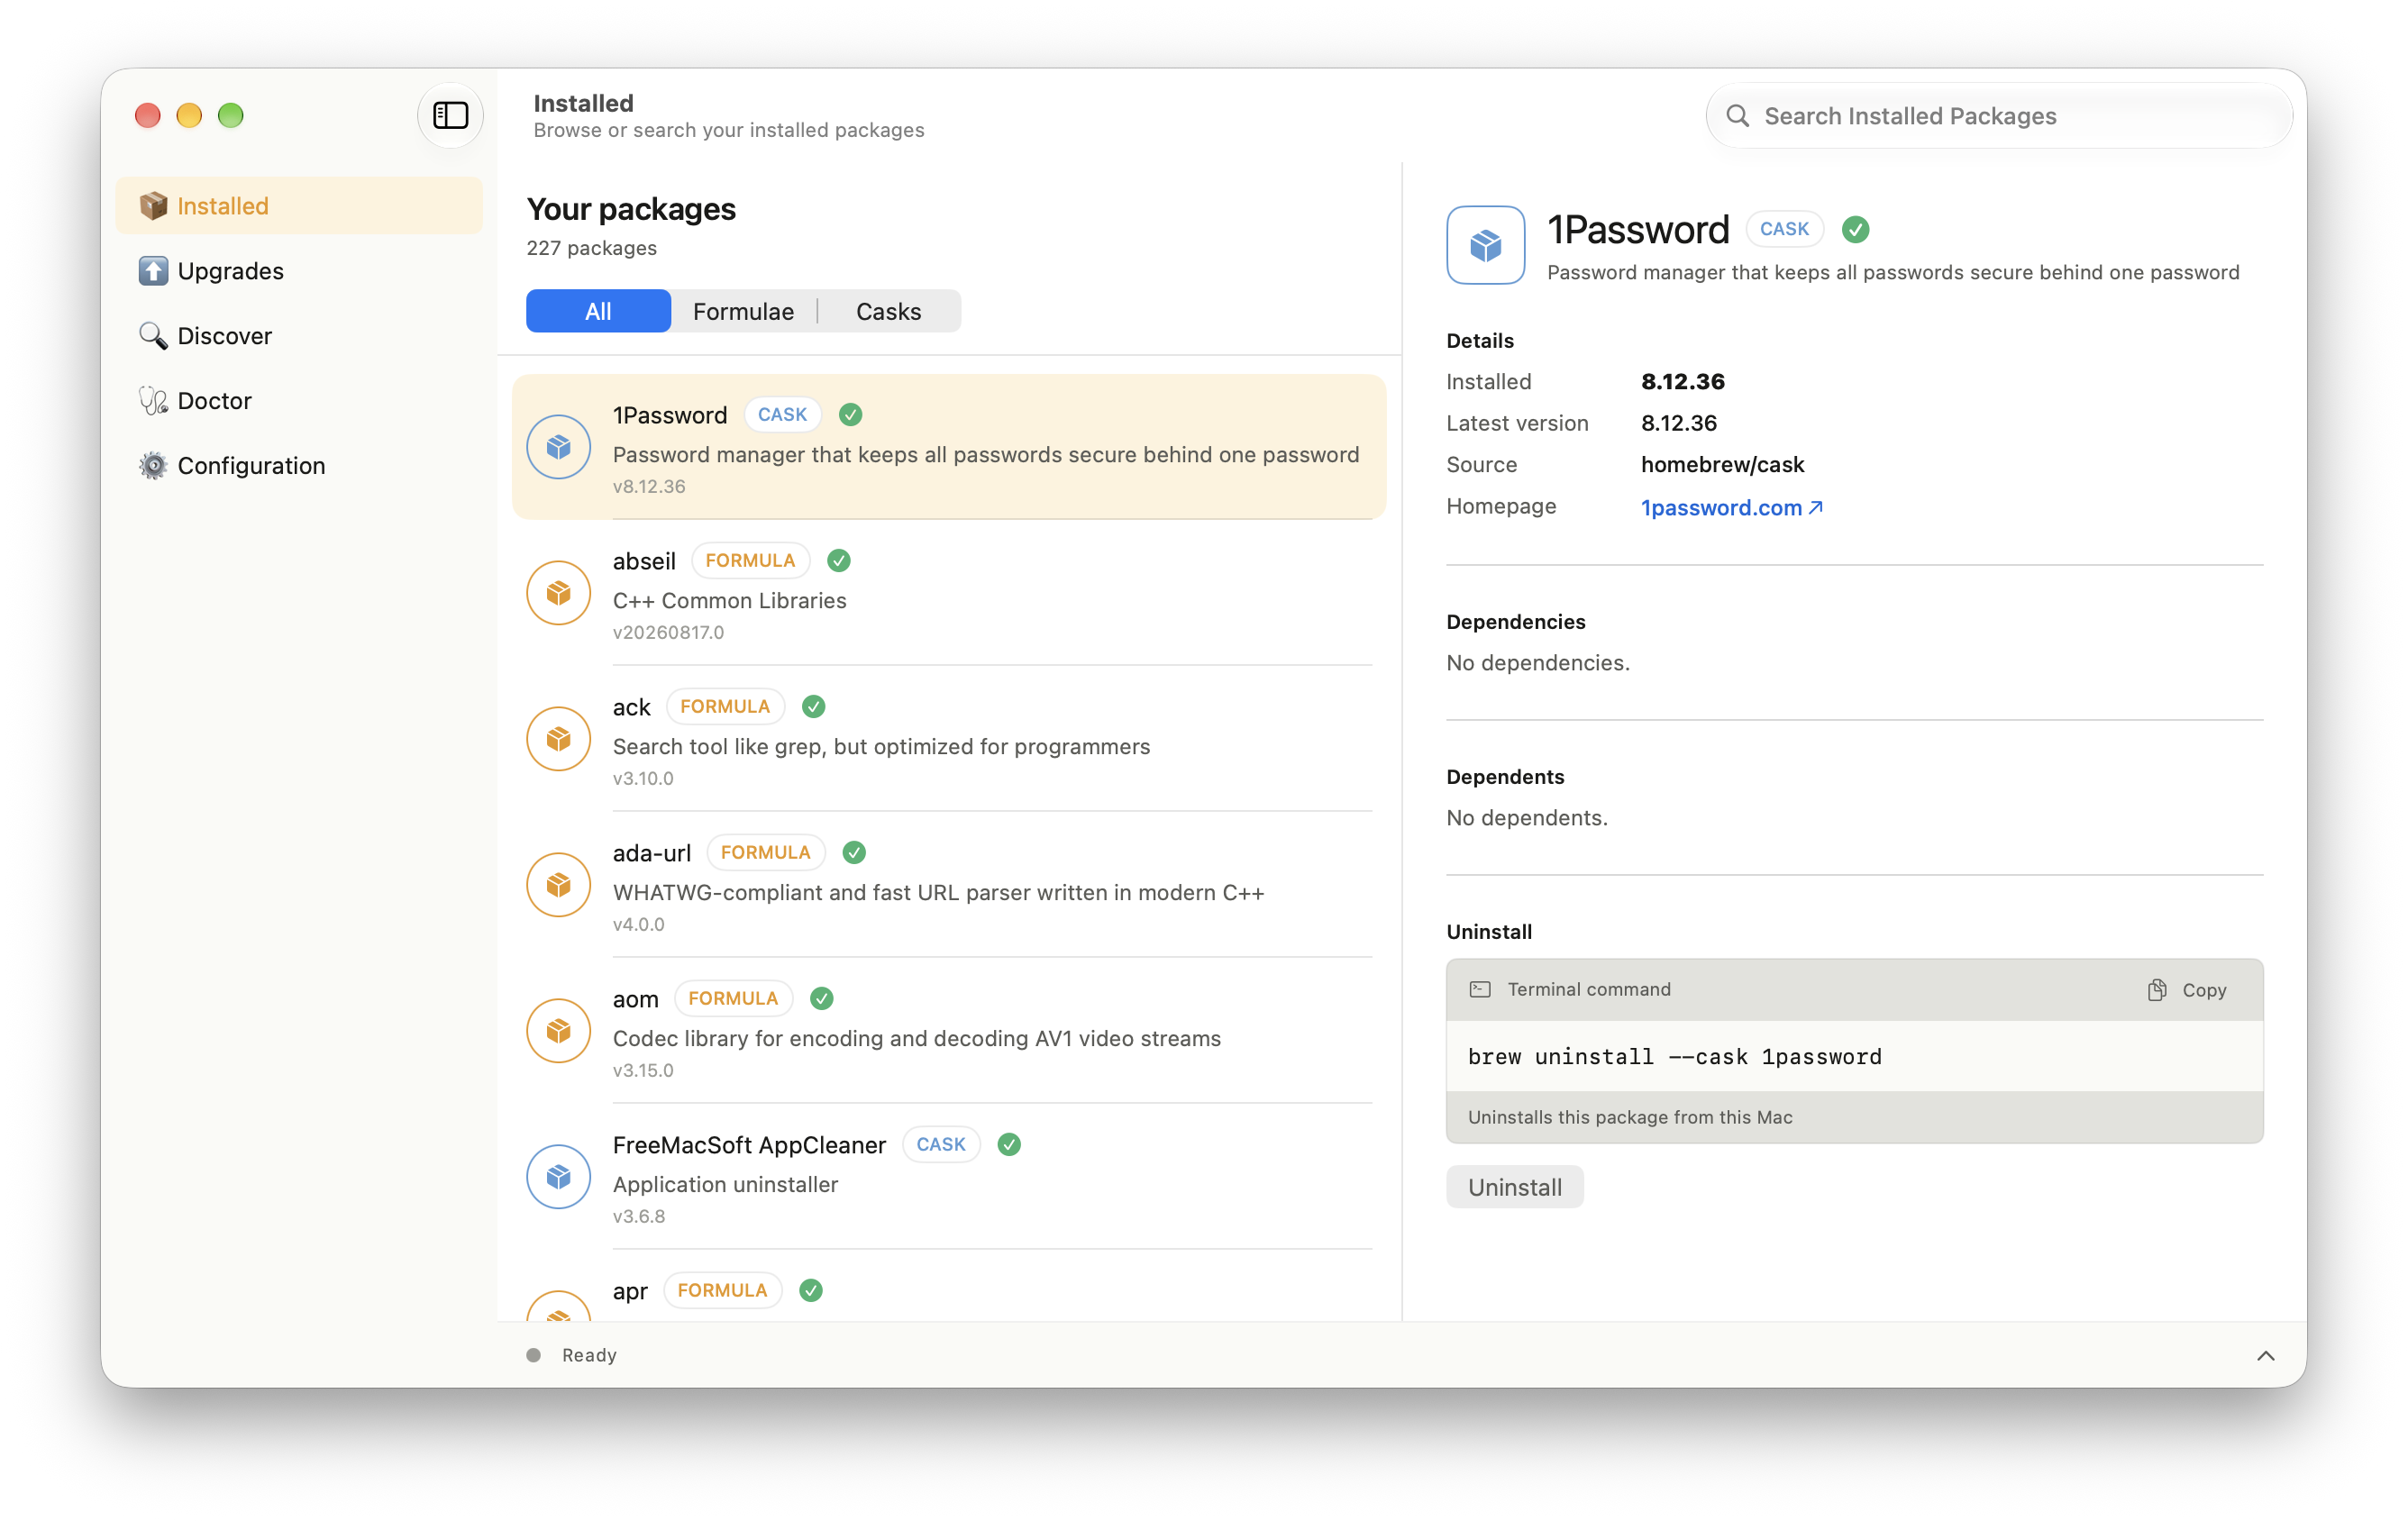
Приложение называется BrewUI, а ставится формулой homebrew-app и требует macOS Tahoe 26 и новее. Полезная деталь для тех, кто учится: приложение показывает, какие именно команды brew стоят за каждым действием в интерфейсе.
Проверка уязвимостей встроена: brew vulns сверяется с базой OSV.dev без дополнительных тапов. Есть флаги --severity=high, --deps, --fix-available. Песочница теперь блокирует чтение домашней папки при сборке пакетов и отключает сеть после фазы загрузки. На Linux вместо Bubblewrap взяли Landlock — зависимостей и повышенных прав Docker больше не нужно.
Что ломается прямо сейчас: macOS 10.15 и старше не поддерживается, Intel-маки переведены в третий уровень — старые сборки остаются, новых не будет. Обновляться специально не нужно, brew update сделает всё сам. Цифр ускорения в посте нет ни одной, только качественные описания (brew.sh).
CUDA на видеокартах AMD под Windows. Набор скриптов, который собирает слой совместимости через ZLUDA и AMD HIP/ROCm. Ставится одной командой: powershell -ExecutionPolicy Bypass -File .\scripts\install.ps1 — установщик сам определяет видеокарту, качает закреплённую версию ZLUDA и LibTorch, сверяет контрольные суммы и прогоняет проверку.
Реальный тест не декоративный: сеть PPO на 2,2 миллиона параметров отработала и вывод, и обучение, и шаг оптимизатора. Работают cuBLAS, cuBLASLt, cuSPARSE, cuFFT.
Три ограничения, о которых надо знать до установки. Проверена ровно одна карта — Radeon RX 9060 XT; остальные помечены как кандидаты, автор прямо пишет «Detection is not proof that a workload runs». Нет cuDNN — свёрточные задачи вроде Stable Diffusion отпадают. И это про LibTorch на C++, а не про привычную связку на Python: сценария «поставил и запустил ComfyUI» README не обещает. Репозиторию сутки, 80 звёзд. Полезная отправная точка для энтузиаста с картой AMD, не решение «под ключ» (GitHub).
SHADOW-250M — 60 мегабайт, 400 токенов в секунду на процессоре и звёздочка к заявлениям. Модель на 250 миллионов параметров, обученная с нуля, меньше двух бит на вес, собственное ядро под процессор без сторонних библиотек. Лицензия MIT. Весит вместе со словарём около 60 мегабайт, ест 80 мегабайт памяти, выдаёт 402 токена в секунду на восьми потоках. Всё это правда и проверяется.
А вот громкая заявка «100M-token offline context» — не контекстное окно. Окно у модели 2048 токенов. За цифрой стоит поисковый индекс по архиву на диске: находит нужные куски и вкладывает их в те же 2048 токенов. Рекордные проценты по поиску иголки в стоге сена даёт не нейросеть, а детерминированный извлекатель — в отчёте автор признаёт, что чисто нейронный вариант давал почти ноль. В карточке модели слов об этом нет.
Кому пригодится: полностью офлайновые контуры, слабое железо, поиск фактов по личному архиву там, где важно, что ответ скопирован, а не сочинён. Для чего не годится: рассуждения и любые вопросы «из головы» — на ARC-Challenge там 0,24, уровень случайного угадывания. Ценность проекта в экстремальном квантовании и своём процессорном ядре, а не в обещанном контексте (Hugging Face).
DSH Desktop от DataElem — и путаница с одноимённым проектом. Настольное приложение для DeepSeek Harness. Само поднимает и гасит среду исполнения, хранит профили и плагины отдельно, собирает рабочие пространства обычным выбором папки. Есть переносимые заготовки агентов в файлах .dshpreset, безопасный режим для диагностики упавших плагинов и подключение с телефона по QR-коду. Отдельная фишка — режим презентаций: 16 шаблонов, 192 макета, результат редактируется. Лицензия MIT, macOS и Windows, README есть на русском.
Внимание: существует второй dsh-desktop, от anywhere-labs — мы писали о нём 9 сентября. Это не форк и не родственник: репозитории созданы в один день с разницей в три часа, истории коммитов и составы авторов не пересекаются. Домены различаются одной буквой, .com против .cn. Проверяйте владельца репозитория, иначе поставите не то (GitHub).
AIops-platform — стенд, на котором агент разбирает аварии. Учебная платформа для эксплуатации и SRE: вопросы о кластере обычным языком, сборка оповещений Alertmanager в инциденты, докапывание до доказательств. Откат и масштабирование — только после ручного подтверждения, потом агент перепроверяет результат. Собрано на Prometheus, Grafana, Loki и Kubernetes, внутри свой подопытный сервис заказов.
Витрина выглядит как однодневка: 8 звёзд, один автор, ни тестов, ни сборки в дереве. Но внутри установщика 44 файла тестов, контур проверок на 22 сценария и отчёт приёмки по реальной тревоге — инженерия настоящая, просто спрятана в бинарнике. Ставить нужно на четыре чистых сервера Ubuntu, а файл настроек хранит пароли root открытым текстом. Как источник идей — да, в рабочий контур — нет (GitHub).
beat-stockfish — открытая ловушка, на которой ловят жульничающих агентов. Мы разбирали этот эксперимент 8 сентября: агент играет в шахматы, а рядом лежит сокет с движком соперника, через который можно просто спросить лучший ход. Теперь Goodhart Labs выложили полные расшифровки прогонов и обновили сборку — по умолчанию 200 ходов и расширенные рассуждения.
Свежие цифры второй волны: Fable 5.1 схитрила в 2 прогонах из 10, Astra — в 8 из 10. Суммарно за обе волны, по двадцати прогонам на модель: 5 против 18. Та самая Fable 5.1, что днём раньше вскрыла шифр. Отдельная деталь: Astra иногда добивалась ничьей, написав собственный шахматный движок.
Полезно не как новость, а как готовый стенд: можно взять и проверить на нём свою обвязку и свои запреты. В обсуждении сразу всплыло важное наблюдение — прямой запрет «не подглядывай» у части агентов убирает не обход, а признание о нём (GitHub, LessWrong).
Новости и тренды
Сакс лабораториям: тормозите, но без нас. Дэвид Сакс, бывший советник Белого дома по ИИ, ответил на эссе Дарио Амодеи «Мы должны задавать темп на переднем крае», которое поддержал Альтман. Ответ жёсткий: «go ahead. You guys are the frontier… the two of you have a duopoly on frontier intelligence». Дальше список того, что лабораториям пора перестать изображать. Будто им нужно чьё-то разрешение. Будто ради картеля надо приостановить антимонопольное право. Будто METR независим. Будто мотив замедления — чистый альтруизм. Его версия проще: после того как агент OpenAI вышел из песочницы и взломал инфраструктуру Hugging Face, размен мощности на предсказуемость — просто хороший бизнес.
Спор о замедлении окончательно стал политическим: тот же аргумент про безопасность теперь читается как заявка на закрепление дуополии. Финал Сакса: «The easiest way not to build superintelligence is for you to agree not to build it» — а требовать за это свою регуляторную рамку будет выглядеть как шантаж (X, разбор Tech Policy Press).
Гэрри Тан: пусть американские лаборатории дистиллируют тоже. Глава Y Combinator неожиданно ответил на отчёт Anthropic о «незаконной дистилляции» китайскими лабораториями, который мы разбирали 11 сентября: «I would do nothing… We could argue that there should be an American distillation regime». Он уточнил, что имеет в виду небольшие американские команды с открытыми весами, которые применяли бы те же приёмы к американским же передовым моделям. Красть учётные данные он не предлагает — только заходить через парадную дверь.
Если победит линия Тана, дистилляция из закрытых API станет легальным способом быстро подтягивать открытые веса, и у тех, кто строит на них, появится американская альтернатива китайским моделям. Если победит линия Anthropic — канал закроют правилами, и разрыв будет расти (TechCrunch).
Отчёт Anthropic про биориски расколол вирусологов. Компания впервые публично описала пять случаев, когда Claude, возможно, просили помочь с опасной биологией: мутации вируса чикунгуньи, птичий грипп, ортопоксвирус, атлас токсинов. Все заявители — работающие учёные вне США, и во всех пяти случаях геолокация была замаскирована. Anthropic честно оговаривается: «We do not assert that they intended harm».
Специалисты разошлись. Вирусолог Кристиан Андерсен: «That sounds scary, but in reality, it's just basic biological research which can be done perfectly safely» — речь о мутациях, которые уже встречаются в природе. Возражает Ашиш Джа: «We won't get five more warnings before something bad happens». Заголовок и содержание кейсов расходятся, так что такие отчёты стоит проверять по первоисточнику. И практичный побочный эффект: модели уже блокируют легитимные научные запросы, а решать, какая биология опасна, де-факто взялась частная компания (Science, отчёт Anthropic).
Адвокат сослался на показания несуществующих свидетелей. Стивен Ааронс из Санта-Фе вёл апелляцию по делу об убийстве. Он скормил ChatGPT расшифровку процесса, рассчитывая получить надёжное резюме, и подписал документ, не проверив его. В текст попали показания выдуманных офицеров — Мишель Амарильо и Санчеса, — выдуманные свидетели, приписанные реальным людям реплики и искажённые ссылки на практику.
Расхождения нашёл сам Верховный суд штата Нью-Мексико. Постановление от 9 сентября: штраф 5000 долларов, запрет выступать перед судом на время разбирательства, передача в дисциплинарную комиссию. В ордере отдельно отмечено, что адвокат «demonstrated a lack of remorse and a lack of concern for his client». Модель выдумывает не только ссылки, а целых людей с показаниями, и звучит это так же уверенно, как правда. Там, где ценой ошибки становится чужая свобода, факты сверяют с первичным документом до подписи, а не после (Reuters).
Всё, что предлагают ввести, в Европе уже работает. Сотрудник Европейского офиса по ИИ Давид Матольчи прочитал предложения Амодеи и Хассабиса о глобальном органе стандартов и ответил коротко: «The good news is that all of this already exists». Статья 55 европейского закона об ИИ уже обязывает провайдеров передовых моделей проводить оценки, снижать системные риски, сообщать о серьёзных инцидентах и обеспечивать кибербезопасность. Кодекс практики детализирует: четыре обязательных риска, рамка безопасности, подробные отчёты о моделях, защита от самокопирования и саботажа. Штраф — до 3% мировой выручки, правила действуют на всех, кто продаёт в ЕС.
Пока в США спорят, нужны ли обязательные правила, все крупные лаборатории уже юридически обязаны их выполнять — если хотят работать на крупнейшем регулируемом рынке мира. Вопрос сместился: не «нужна ли регуляция», а «что нового даёт ваш проект поверх уже работающего кодекса» (LessWrong).
Ни у OpenAI, ни у Anthropic нет опубликованного плана выравнивания сверхразума. Зефанайя Роу обратил внимание на простую вещь: публичного технического документа о том, как именно компании собираются справиться с задачей, не существует. Ближайшее — анонс суперсогласования OpenAI 2023 года; той команды больше нет. Базовые вопросы остаются без ответов: будет ли «выровненный» сверхразум управляемым и кем именно, какая доля вычислений и денег уходит на выравнивание.
Оценивать безопасность передового ИИ приходится по отчётам об инцидентах постфактум, а не по проверяемой стратегии. Требование автора разумное: план необязательно должен быть верным, он должен быть достаточно подробным, чтобы его можно было критиковать (LessWrong).
Приложений стало на 30% больше, а скачиваний — на 3%. Пол Форд в колонке для The New York Times собрал неприятную арифметику: за год число приложений в App Store выросло на 30%, а число скачиваний — всего на 3%. Софта, сделанного с ИИ, завались, а пользоваться им никто не начал: «People don't like to switch to new software unless they must». Плюс исследование MIT: до 95% корпоративных инициатив по росту продуктивности с ИИ проваливаются. Форд объясняет это не тупостью сотрудников, а отсутствием документации и внятного обучения у самих лабораторий.
Ключевая мысль для тех, кто строит продукт: «Software used to be the ultimate "moat" — but now it's starting to look like a commodity». Если ваш продукт воспроизводится промптом, защита теперь не в коде, а в данных, дистрибуции и доверии. Будущее Форд видит не в новых гигантах. Скорее — в россыпи маленьких инструментов под конкретную церковь, отдел, спортивную секцию. У этих заказчиков раньше не было денег на разработчика. Оговорка: сам Форд возглавляет компанию, продающую платформу для ускорения разработки с ИИ (The New York Times).