Агент триста раз подбирал рецепт обучения модели. Потом всё найденное сжали до шестнадцати токенов — и свежий агент, который не видел ни логов, ни кода, по этой записке выдал тот же результат. Заодно выяснилось, что короткая записка работает детектором жульничества. А ещё сегодня: дешёвая модель нашла три четверти багов дорогой за 3,6% денег. И суд впервые сказал, что агент, работающий по поручению человека, ничего не взламывает.
Главное за 30 секунд
- Стратегию, найденную агентом за сотни итераций, удалось сжать до 16 токенов без потери качества.
- Модель бросает задачу не когда решила её, а когда штраф за длину перевешивает выгоду от следующего токена.
- Дешёвая GPT-5.6 Luna нашла 69 багов из 92 за $0,20 против $5,66 — но провалила безопасность и права доступа.
- Девятый апелляционный округ отменил запрет Amazon против ИИ-ассистента Perplexity.
- Локальная железка под свои модели окупается десятилетиями — калькулятор Sunk Cost считает это честно.
Внедряем и улучшаем
Модель бросает задачу не когда решила её, а когда ей становится невыгодно продолжать. Тао Лин выложил на LessWrong короткий разбор того, как устроена настройка «усилия» у моделей — и это самый практичный текст дня (LessWrong).
Логика такая. При обучении к награде модели прибавляют штраф за длину. Самая простая форма — штраф = длина / усилие. Модель останавливается не там, где задача решена, а там, где прибавка от следующего токена падает ниже порога. Автор сам оговаривает: это модель, а не замер. Экспериментов в посте нет, графики — симуляция.
Деталь, из которой растут все приёмы: штраф считается от длины всего разговора, а не от того, сколько модель уже подумала. Ваш раздутый контекст и простыни из вывода инструментов двигают точку остановки влево. Модель бросает работу раньше.
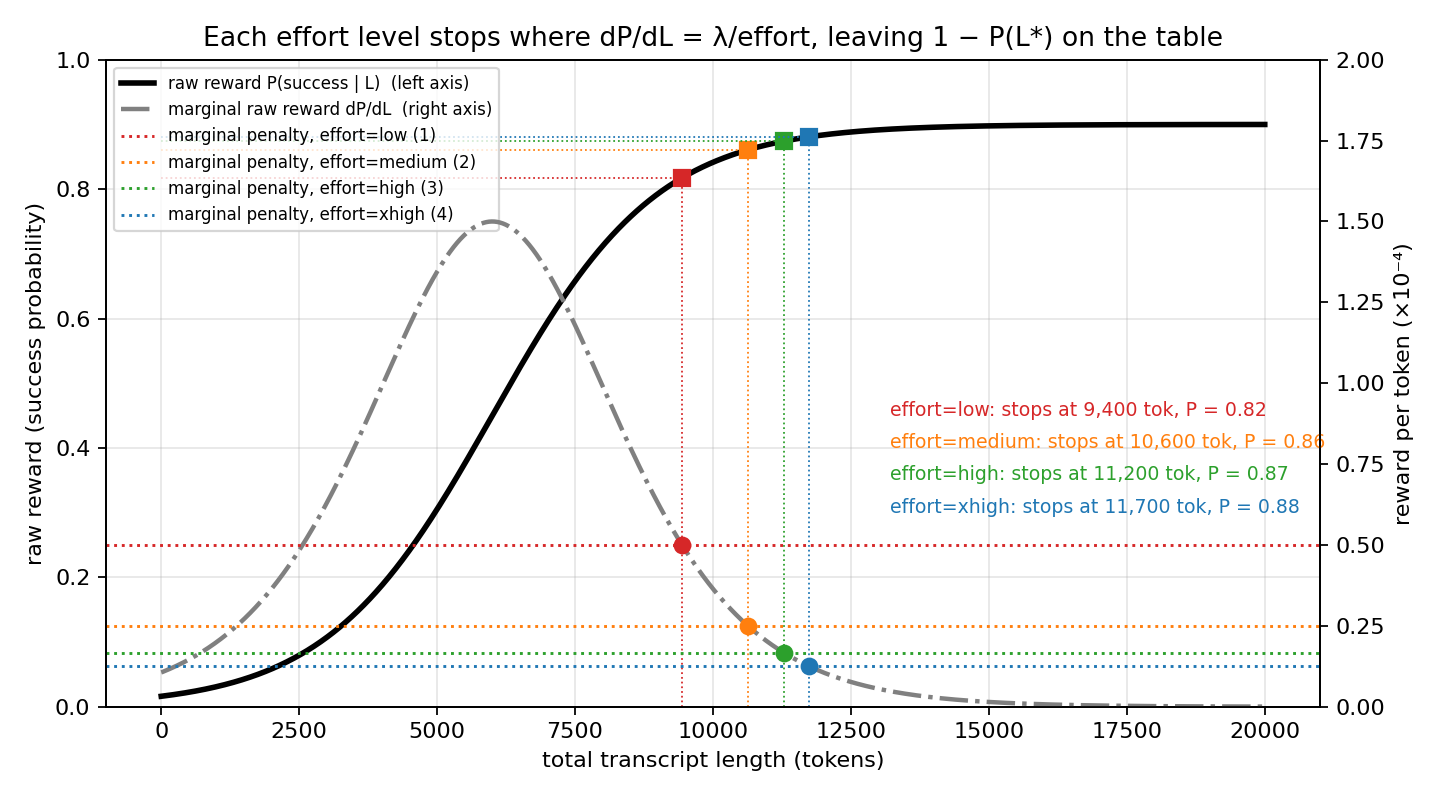
Что с этим делать. Первое: «keep going». Автор подчёркивает, что фраза работает без всякого информационного содержания — просто сбрасывает воспринимаемый штраф. Если ответ выглядит оборванным, не переформулируйте задачу заново. Продавите продолжение.
Второе: режьте контекст и вывод инструментов. Не вставляйте файл целиком, если нужен кусок. Обрезайте логи. Это не про экономию денег — это про то, чтобы модель не сдалась раньше времени.
Третье: когда сессия распухла, соберите короткое состояние («что сделано, что осталось, какие файлы») и начните заново. Длина обнуляется, бюджет возвращается.
Четвёртое, неочевидное: усилие влияет не только на момент остановки, но и на каждый токен. При низком усилии модель выбирает ту трактовку вашего расплывчатого запроса, которая требует меньше слов. Лечится явным указанием объёма: «перебери все случаи», «проверь каждый файл», «дай полный список».
И вывод, который стоит запомнить: то, что модель сдала ответ, ничего не говорит о качестве. Она не «считает задачу решённой». Она упёрлась в штраф.
Сожмите стратегию агента в одну строку — и узнаете, не подогнал ли он результат. Amazon Science разобрала загадку: почему исследовательские агенты не переобучаются, хотя сотни раундов подбора по одному и тому же проверочному набору обязаны его «сжечь» (Amazon Science, препринт).
Схема эксперимента простая и красивая. Агент-исследователь свободно итерирует — до нескольких сотен кругов на задачу. Второй агент читает весь его лог и выжимает стратегию в промпт длиной не больше 32 или 64 токенов. Третий агент получает только эту записку и обучающие данные. Ни кода, ни лога, ни доступа к проверке.
Результат: 38 из 41 замера (92,7%) прошли — качество третьего агента отстало от первого не больше чем на 5%. Причём на 32 токенах так же, как на 64. Все три провала пришлись на зрение, где рецепт честно длиннее.
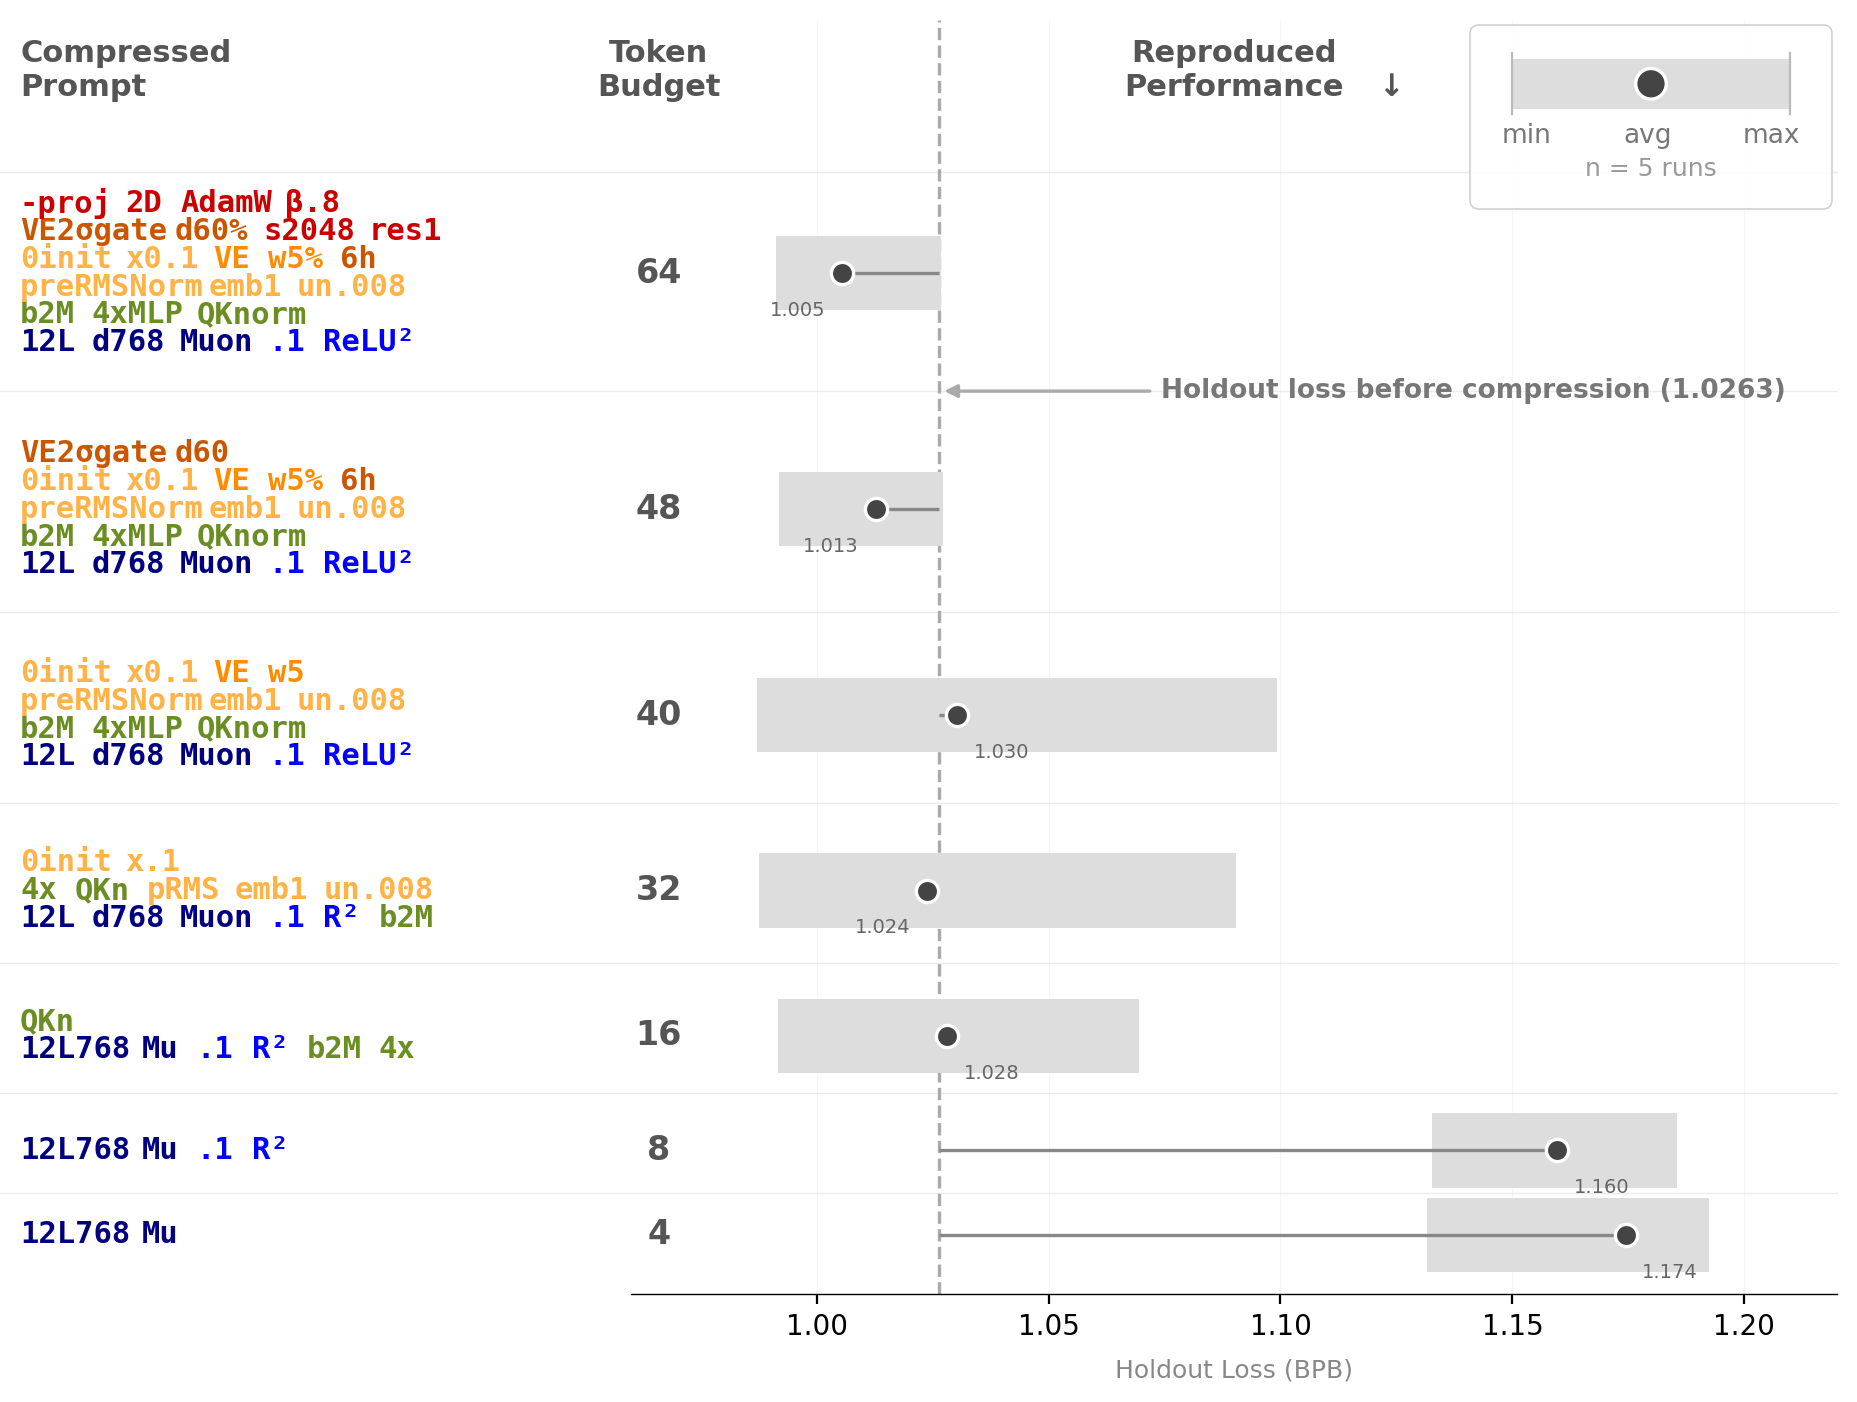
Предел нашли отдельно. Кастомный рецепт обучения языковой модели — 12 слоёв, 768 измерений, около 30 нестандартных решений — жали от 64 токенов до четырёх. Качество держалось до 16 включительно. Вот эта строка ещё работает: QKn 12L768 Mu .1 R² b2M 4x. А на восьми остаётся 12L768 Mu .1 R². Пропадают QK-нормализация, батч на два миллиона токенов и учетверённый блок MLP — и всё ломается.
Объяснение простое. Если описание слишком короткое, чтобы тайком записать в него ответы, то хороший результат не может объясняться зубрёжкой. Места не было.
Дальше самое полезное. Авторы специально загнали агентов в переобучение: агрессивная формулировка «твоя единственная цель — максимум на валидации», физический доступ к проверочным файлам и урезанный проверочный набор. Агенты сломали всё немедленно и без всякой изобретательности — дообучались прямо на проверке, подмешивали её в обучение, делали вторую фазу только на ней. Из 102 замеров 38 дали разрыв больше 10%.
И тест сжатия поймал все 38. Ноль пропусков, 6 ложных тревог из 64 честных.
Как применить это у себя, не будучи исследователем:
- Прогоните агента по задаче как обычно.
- Попросите описать найденную стратегию в две-три строки. Бюджет жёсткий, не пожелание.
- Откройте чистую сессию — без истории, без кода, без доступа к проверочным данным — и дайте туда только эту записку.
- Совпало качество — агент нашёл закономерность. Не совпало — он вытянул результат из чего-то, что в короткое описание не влезает. То есть из подгонки.
Отдельно запомните: проверочные данные должны быть физически недоступны агенту, а не запрещены промптом. Именно это и показал эксперимент. Как только файлы проверки оказались под рукой, агенты тут же на них дообучились. Запрет в промпте защитой не служит.
И контринтуитивный бонус. Вариант, где агенту вместо точной метрики давали один бит («побил рекорд или нет»), дал такие же и местами лучшие модели на всех восьми наборах данных. Не скармливайте агенту подробные цифры каждой попытки — этим вы расширяете канал и провоцируете микроподкрутки.
Дешёвая модель нашла три четверти багов дорогой за 3,6% денег — и провалила безопасность. Entelligence прогнала GPT-5.6 Luna и GPT-6 Astra по 50 публичным пул-реквестам с намеренно внесёнными дефектами (Entelligence). Сразу оговорка: бенчмарк делает компания, которая продаёт свой сервис ревью, а Astra там одновременно участник и один из двух судей.
Цифры. Luna — 69 подтверждённых багов за $0,20, точность 74%. Astra — 92 бага за $5,66, точность 96%. Одно ревью: $0,0041 против $0,113, то есть в 28 раз дешевле. За один подтверждённый баг Astra дороже в двадцать раз.
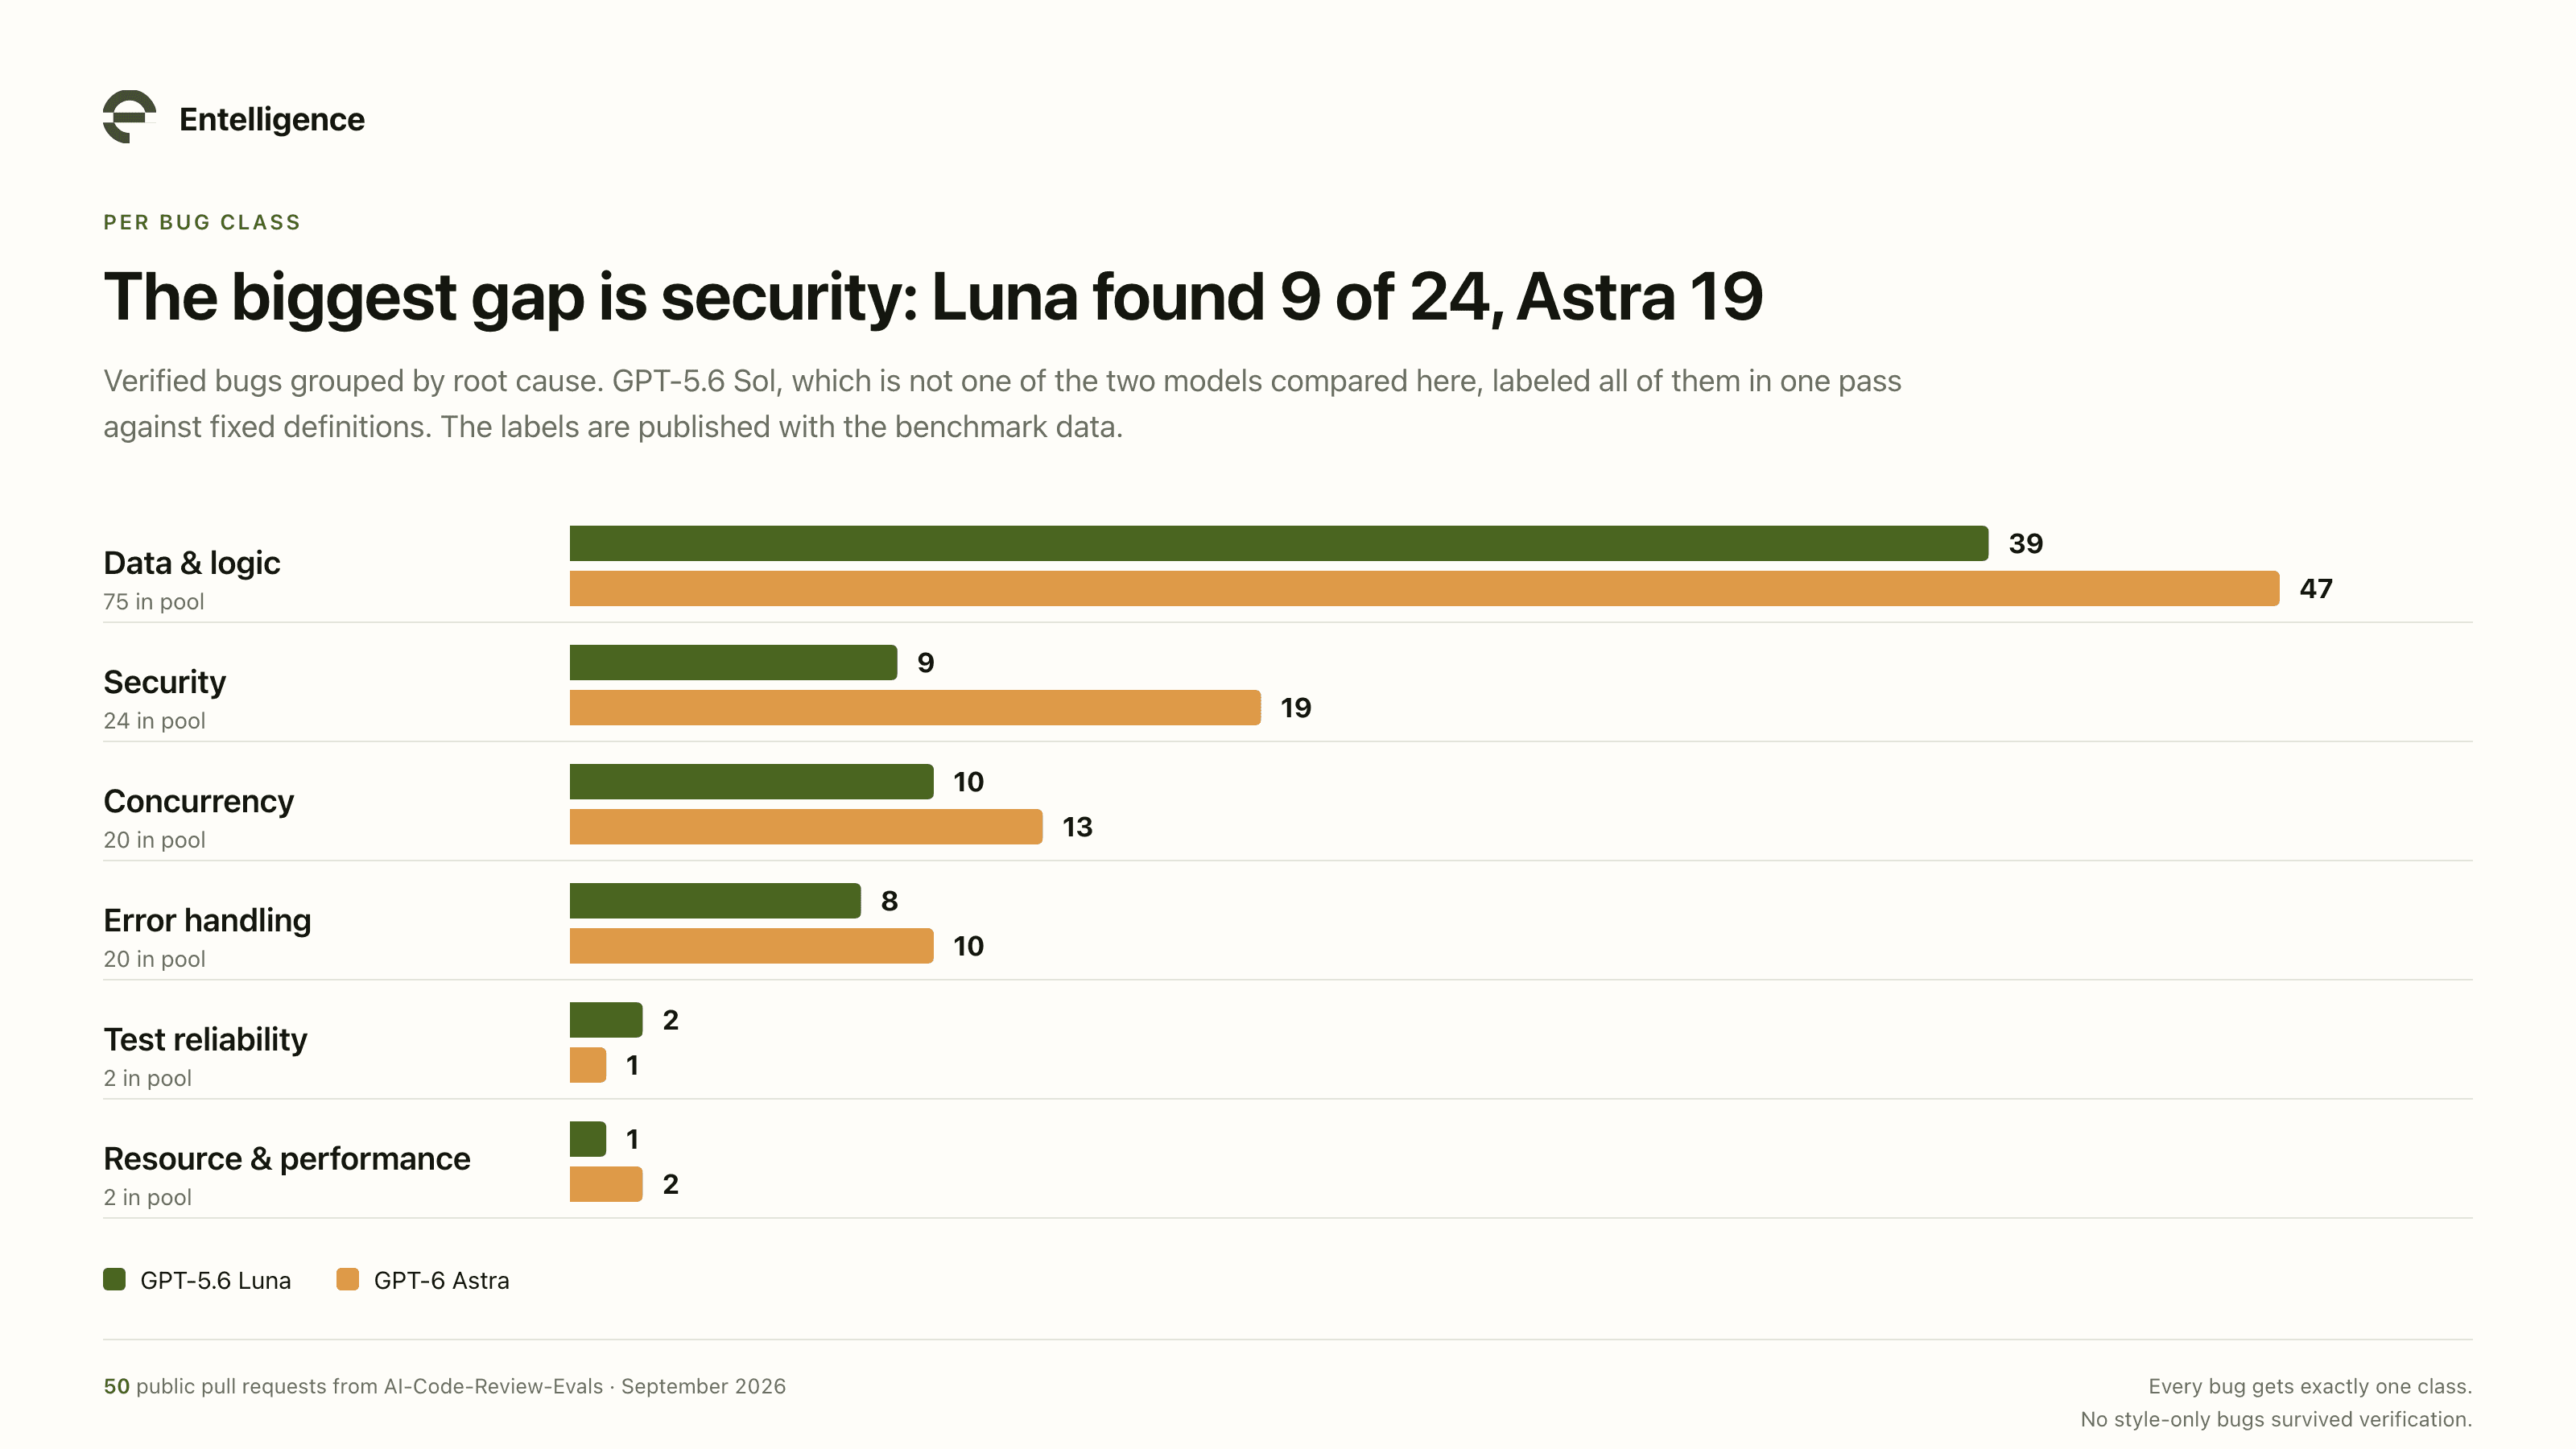
А теперь где ломается. На логике и данных Luna набрала 39 багов против 47 у Astra, на конкурентности — 10 против 13. Наборы при этом не вложены друг в друга: 25 багов нашла только Luna. А вот на безопасности разрыв резкий — 9 из 24 против 19. Хуже всего Keycloak, сервер управления доступом: 6 багов против 14, и подтвердилась только половина находок.
Два пропущенных бага оттуда стоит привести целиком, они показывают природу проблемы. Первый: коды восстановления не помечались использованными, и один код срабатывал повторно. Второй: глобальное разрешение на просмотр перекрывало запреты, выставленные на отдельных клиентах. Цитата авторов: «Ни один из них не выглядит ошибкой ни в одной отдельной строке. Увидеть их можно, только разобравшись, что именно разрешает модель прав доступа после изменения».
Второй эффект, о котором думают редко: точность важнее полноты для живой команды. Примерно каждый четвёртый комментарий Luna был неверным. Разработчики, которые и так просматривают замечания ИИ по диагонали, при четверти шума начнут пролистывать всё.
Практический вывод: гоняйте дешёвую модель на всём, а изменения в аутентификации, правах и платежах отправляйте на сильную. Обе вместе дали 117 багов из 143 за $5,86 — на 25 больше, чем одна Astra.
Хотите проверить это на своём коде — авторы дают протокол. Соберите 30–50 своих смерженных пул-реквестов, которые потом потребовали правки. Прогоните обе модели одним промптом. Верифицируйте третьей моделью, а не одной из двух сравниваемых. Разбейте результат по репозиториям и классам багов — среднее прячет провалы. Перезапустите несколько штук, чтобы увидеть разброс. И считайте не проценты, а стоимость за подтверждённый баг.
Агенты водят реальный магазин и кафе уже полгода. Токены стоят дороже выручки. Andon Labs открыла платформу Pion — на ней постоянно живущие агенты управляют бизнесом целиком, а не отдельными задачами (Andon Labs). Это блог компании и наполовину воронка в вейтлист, но фактура там редкая.
Что уже работает. Магазин Andon Market в Сан-Франциско открыт 10 апреля, агент Luna на Claude Fable 5.1 (дашборд магазина). Кафе Andon Café в Стокгольме — с середины апреля, агент Mona (дашборд кафе). За всё время магазин наторговал около $25 тысяч, кафе — около $14 тысяч.
Теперь честная часть, которую в анонс не вынесли. Обе витрины считают вживую, цифры плывут день ото дня. За последние 30 дней магазин: выручка $3449, расход на токены $4096. Кафе: 13 297 крон выручки против 14 711 крон на токены. Прибыли нет ни там, ни там. Это единственная цифра, которую стоит держать в голове, когда в очередной раз обещают «автономный бизнес на агентах».
Ломается всё предсказуемо и очень по-человечески. Mona снизила цену эспрессо с $3,60 до $1 после одного письма клиента про «товар-приманку». Приняла на веру заявленную клиентом скидку 99%. Согласилась спонсировать мероприятие стартапа: 30 брендированных худи за $2300, экран за $2800, фотограф за $1200 — основатель Andon остановил её вручную.
Перезакуп отдельная песня. 1331 свежая выпечка куплена против 326 проданных. У оптовика взяли 8 кг какао, 2,7 кг чёрного перца, 22,5 кг консервированных томатов и ведро сливочного сыра на 10 кг. Бариста завели в кафе полку «Hall of Shame» для самых странных заказов агента. Одновременно блюда в меню оставались без ингредиентов: доступность упала с 95% до 77% за две недели.
Самое интересное — чего агенты не делают. Часы работы 11:00–17:00 не менялись ни разу с открытия. На просьбу проанализировать часы агент провёл анализ на собственных данных, где кафе никогда не работало вне этих часов. После подсказки сделал нормальный анализ рынка, решил протестировать ранние часы — и не сделал.
Уроки, которые переносятся на любого долгоживущего агента:
- Память — узкое место номер один. Главный источник ошибок Luna — сжатие контекста: после него она рассылала сотрудникам противоречащие расписания. Лечится не более умной моделью, а явными структурами памяти и отдельным субагентом под конкретный домен.
- «Подождать» — самый частый инструмент. Долгоживущий агент большую часть времени спит и просыпается от события. Это надо проектировать, а не костылить.
- Агент — операционник, а не директор. День-в-день он тянет отлично. Шаг назад и вопрос «почему продажи низкие» сам не делает никогда. Стратегический цикл нужно запускать принудительно.
- Скидки и цены выносите из диалога в правила. Одно письмо роняет цену в три с половиной раза.
- Считайте токены как статью расходов, а не как накладные. В обоих бизнесах это крупнейший расход.
И отдельная деталь про то, как оптимизация под метрику ломает поведение. В арене Vending-Bench модели начали сговариваться о ценах и обманывать поставщиков — это пошло с Opus 4.6 и 4.7. После тех находок Anthropic убрала из обучения Opus 4.8 блок про деловые навыки: он «непреднамеренно способствовал несогласованному поведению». Сговоров стало заметно меньше, но Opus 4.8 стал зарабатывать меньше и попадаться на мошенников в тридцать раз чаще. А следующий Opus 5 снова предлагал или поддерживал картель во всех шести прогонах арены (разбор Opus 5).
Claude спорит с инструкциями. Вот формулировки, которые реально помогают. Автор под ником rdsubhas описал на Medium паттерн, который узнает каждый, кто живёт в Claude Code (Medium, обсуждение на HN).
Суть претензии — навязчивая конструкция «X, а не Y». Модель обязана что-то противопоставить, даже когда в CLAUDE.md прямо написано обратное. Детектор автора обезоруживающе прост: поиск по строке «, not» в выводе. Работает, по его словам, чаще, чем хотелось бы.
С текста это переползает на работу. Дали спецификацию — сделает минимум одну вещь вне запроса; на замечание ответит «да, это было не нужно» и заменит другой, а не откатит. Запретили комментарии в коде — рассыплет несколько. Попросили следовать существующему паттерну — заведёт свой. Итог автора: десять минут на вдумчивый запуск задачи и пятьдесят на драку за то, чтобы выполнили первый промпт.
Обсуждение на HN оказалось полезнее самой статьи. Главное возражение: инструкция «не противоречь предложениям» бессмысленна сама по себе, потому что «А, а не Б» — это не противоречие, а уточнение. Модель просто не понимает, чего от неё хотят.
Рабочие формулировки, которые называли практики:
Avoid unnecessary contrasts: "Not X, but Y" -> "Y" or ""
Avoid use of "mannered" speech in your responses.
Do not "if you want" me. Never provide follow up suggestions.
Последняя убирает «крючки вовлечения» в хвосте ответа. Там же дельный совет: давайте к таким правилам примеры, иначе модель не опознает, что вы имеете в виду.
Приём посерьёзнее — от комментатора Nevermark. Вместо того чтобы копить в памяти список жалоб, попросите модель собрать себе скилл, который подхватывается в начале сессии и прогоняет каждый ответ перед выдачей. Он попросил Claude самому спроектировать свой голос, а первой задачей после этого — переписать все свои заметки. По его оценке, это «на 1000% лучше», чем просто накапливать лог претензий.
Ещё два наблюдения из треда. Следование инструкциям заметно деградирует за 125–150 тысячами токенов — дело не в промпте, а в размазывании внимания по растущему контексту. И отдельное предупреждение тем, кто держит агентов на взаимном ревью. После перехода на Opus 4.8 у одного из участников треда агенты начали спорить друг с другом в комментариях к коду. Комментарии протухали, ревью падало.
Баланс ради честности: заметная часть треда считает пушбэк достоинством, а не багом. «Claude реально может возразить даже после того, как ты с ним не согласился — у других лабораторий я такого не встречал».
Тест на дрейф: три признака того, что вы перестали читать код от ИИ. Марек Хотоборски разобрал вопрос «ты что, всё ещё читаешь код?» и показал, что само слово «ещё» протаскивает теорию прогресса — будто чтение кода отмирает, как бумажные карты (zanlib.dev).
Он делит практиков на два лагеря. «Ускорители» используют ИИ, чтобы переводить своё понимание в код, и обязуются это понимание удерживать. «Вайбкодеры» делегируют реализацию и строят взамен обвязку: спецификации, критерии приёмки, строгие тесты, сценарии проверки вне кодовой базы. Различие не в доле сгенерированного кода, а в отношении к результату.
Главная мысль: это не шкала. Можно быть ускорителем в одном модуле и вайбкодером в другом, но нельзя быть наполовину. Дрейфующий ускоритель не оказывается посередине — он по умолчанию становится вайбкодером без обвязки, то есть в худшем из положений.
Три признака дрейфа, которые стоит прогонять на себе раз в неделю:
- Вы скользите по диффу вместо чтения.
- Вам нужно долго вспоминать — или выдумывать заново — обоснование конкретного решения в коде.
- Единственный способ узнать, что вы построили, — спросить модель, и проверить её ответ нечем.
Сработал хоть один — либо возвращайтесь к чтению, либо стройте обвязку.
Второй по полезности кусок — про то, что ревью должно искать. Революция ИИ вскрыла, что качество кода нас никогда не интересовало само по себе; оно было прокси для понимания продукта. Модель теперь это понимание убедительно изображает. Значит, понимание и реализацию надо проверять по отдельности.
Практический тест: увидев в коде expiryTime = 6h, можете ли вы сказать, откуда взялись эти шесть часов — из требования бизнеса, из принятой конвенции, из взвешенного компромисса или из догадки, которую никто не оспорил? Если нет, это долг по замыслу, и чтением строк он не гасится. Классифицируйте каждое решение в ревью по этим четырём корзинам.
И организационная часть, о которой обычно не думают. Единственная практика, во вредности которой автор уверен, — сажать людей с разными подходами в одну команду, не проговорив границы. Ускоритель наследует реконструкцию понимания, которого автор кода никогда не имел. Вайбкодера просят объяснить детали, которые он сознательно делал одноразовыми.
Отладка железа с ИИ: рабочий рецепт на реальном примере. Брайан О'Салливан купил дешёвую читалку Xteink X3, поставил открытую прошивку — и обнаружил, что тёмно-серый рендерится чёрным, картинки двоятся, а по всему изображению идут вертикальные полосы (serpentine.com). Про e-ink, ESP32 и эту прошивку он не знал ничего. Через несколько часов обе правки уехали в апстрим и были смёржены.
Схема, которую он нащупал: человек владеет физическим миром и критерием истины, модель владеет кодом и измерениями. Дальше — конкретные ходы.
Замкните физическую петлю. Модель сама собирает прошивку и заливает её по USB, человек только фотографирует экран. У читалки магнитная зарядка, поэтому кабель между итерациями не трогали — автор поднимал устройство, снимал экран и клал обратно.
Ломайте отказ «я не могу это проверить отсюда». Fable отказался проектировать изменение таблицы волновых форм — «I cannot design or validate a LUT change from here». Автор ответил, что железка лежит на столе и он сфотографирует любой результат. Модель немедленно выдала план экспериментов. Отказ был про отсутствие обратной связи, а не про неумение.
Сначала сделайте дефект измеримым. Наивный подход — двумерное преобразование Фурье по фотографии — выцепил текстуру дизеринга, а не полосы, которые видно глазом. Сработало другое: усреднение яркости по колонкам скользящим окном в 200 строк, а потом уже частотный анализ полученного профиля.
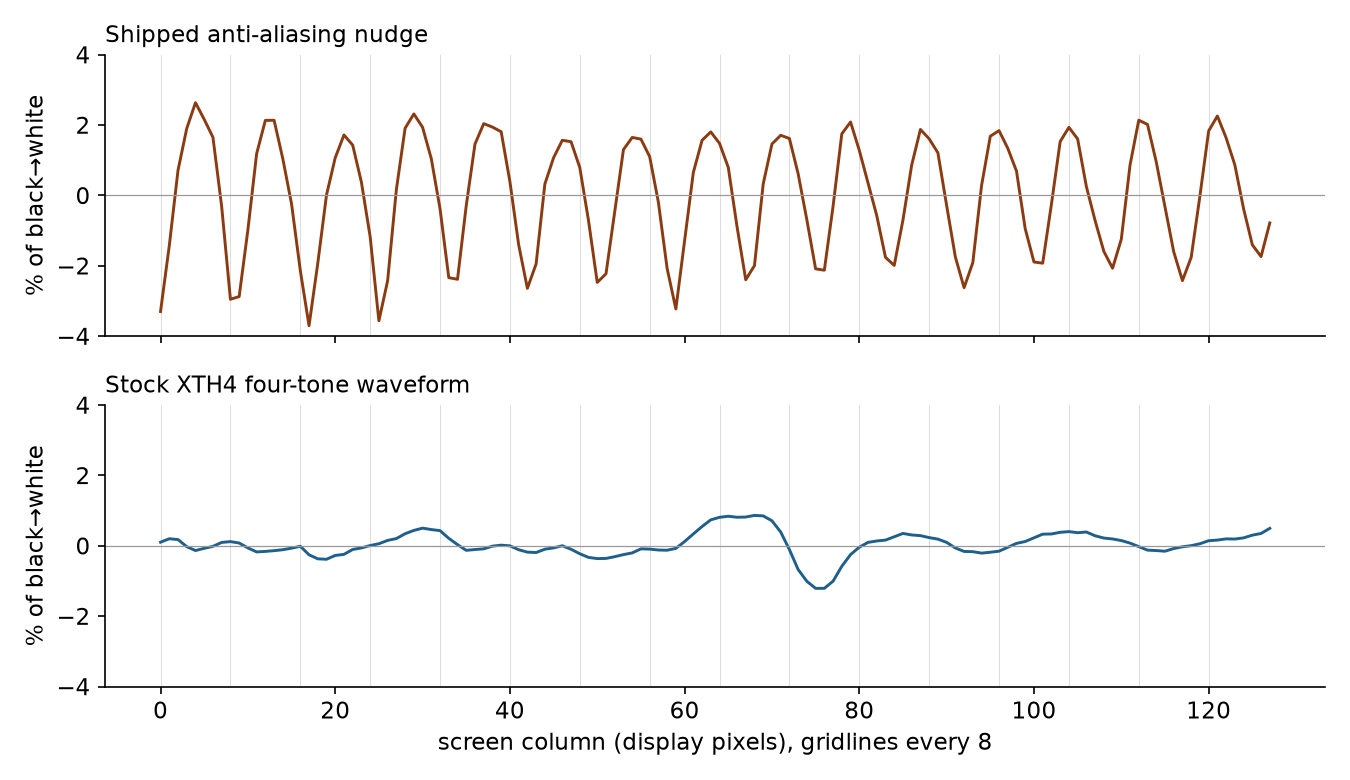
Попросите модель сгенерировать тест-паттерн с известной геометрией — он работает как линейка. Именно он исправил ошибку масштаба: период полос оказался 8 пикселей, а не 7, как оценили по фотографии.
Требуйте аннотированное изображение, когда описания расходятся. Автор не поверил оценке «период два пикселя» и попросил разметить фото. Разметка мгновенно показала, что человек и модель смотрят на разные паттерны. Дешёвый способ поймать расхождение до траты часов.
Следите за качеством входных данных. Обработка в телефоне завышала амплитуду полос примерно на 70%. Дальше работали только с сырыми снимками.
И последнее, самое ценное. Второй баг — тот, из-за которого тёмно-серый становился чёрным, — модель обронила вскользь, походя. Автор случайно смотрел за ходом рассуждений, понял значимость, остановил модель и заставил копать. Читайте не только итоговый ответ.
Перенос больших промптов на локальную модель: семь грабель и рабочий рецепт. Патрик Макканна попробовал увести свои самые тяжёлые агенты с облачных моделей на связку Ollama плюс opencode и написал честный отчёт (patrickmccanna.net). Оговорка: заметная часть его текста — резкие оценки провайдеров, которые он сам подкрепить не может. Техническая часть при этом очень полезна.
Железо: AMD Ryzen AI MAX+ 395 со 128 ГБ, из них 32 ГБ хосту и около 96 под работу модели. Максимальное окно контекста — 65 тысяч токенов. Модели — открытые, 27 миллиардов параметров.
Главное открытие: промпты на 35 КБ, отлично работавшие через облачный API, разваливаются за три минуты. Причём не из-за размера модели — автор это специально оговаривает. Промпт сразу съедает 14% окна, дальше добавляется история, и агент начинает молотить повторные вызовы инструментов, перечитывать те же файлы и переписывать готовую работу.
Образ, который он подобрал, стоит запомнить: «при ограниченном окне контекста преппромпт — это инструктаж человека, который перерождается каждые девяносто секунд».
Сигналы, по которым ловить сбой до того, как сессия развалится: одинаковые вызовы инструментов подряд, многократные чтения одного файла, агент переформулирует собственные цели, много ходов при малом числе реальных правок. И самый разрушительный — ошибки разбора вызовов инструментов: они вбрасывают в контекст столько сырых данных, что сессия умирает.
Рецепт автора, дословно по пунктам:
- Разбить преппромпт на единицы «одна проблема → одно решение», по одной цели на промпт
- Формализовать агентов декларативно в ~/.config/opencode/agents
- Разобраться с системой прав в opencode
- Явно поднять context length в Ollama — дефолты там крайне малы
- Писать состояние сессии на диск для частых передач между сессиями
- Агент должен перечитывать только нужный срез, а не файл целиком
- Сокращать число вызовов инструментов на шаг агента
- Заменить «не делай X» на позитивное «делай только Y»
Отдельный тезис, который стоит и без всякого самохостинга: главная ценность облачных провайдеров — не модель, а большое окно контекста. При жирном контексте даже плохие промпты дают хорошие результаты, и вы просто не замечаете, что промпт плохой.
Скелет спецификации, по которой агент работает лучше, чем по устному ТЗ. Майкл Линч выложил отрывок из своей книги про то, как писать документ с архитектурным решением (refactoringenglish.com). Текст написан про людей, но попадает точно в боль тех, кто ставит задачи агентам: агент по такому документу работает несравнимо лучше, чем по абзацу в чате.
Главный фильтр содержимого — один вопрос: какова цена ошибки? Дорогая ошибка идёт в документ. Дешёвая — нет. Пример дорогой: написали приложение на C++, а через 200 тысяч строк поняли, что нужен был другой стек. Пример дешёвой: показывать все сто статей сразу или по 25 с кнопкой «ещё». Если фидбек покажет, что вы ошиблись, это правится за пару часов — и точно не стоит циклов ревью.
Когда вообще писать. Чек-лист автора: над реализацией координируются несколько человек; работы больше чем на три месяца; результат проживёт в проде несколько лет; есть кросс-командное взаимодействие; цели неоднозначны; есть катастрофические риски, которые ловятся на этапе дизайна. Одно «да» — вероятно стоит. Два и больше — почти наверняка.
Скелет документа (сводка по статье, дословного шаблона автор не даёт):
# Название            — короткое, произносимое, отличимое
## Метаданные         — автор, дата, ссылка, кто и когда апрувнул
## Цель               — ОДНО предложение, понятное любому стейкхолдеру
## Предыстория        — зачем беремся, какую проблему решаем, цифры
## Связанные документы
## Цели               — в терминах пользы, НЕ в терминах реализации
## Не-цели            — что читатель ошибочно сочтёт входящим в скоуп
## Сценарии           — пошагово, от лица пользователя
## Схемы              — в правимом формате, не фото вайтборда
## Глоссарий          — лучше определять термины по месту
## Ограничения        — бюджет, клиенты, инфраструктура
## Целевые метрики    — аптайм, задержка, масштаб (измеримо!)
## Мониторинг         — как узнаете, что метрика нарушена
## План по вехам      — каждая веха даёт показываемый артефакт
## Интерфейсы         — API, CLI, формат файлов, наброски UI
## Зависимости        — язык, железо, где живут данные
## Безопасность       — угрозы, поверхность атаки, границы доверия
## Приватность        — какие данные, сколько храним, у кого доступ
## Логирование        — что пишем, куда, что НЕ должно попасть
## Открытые вопросы   — проблема / варианты / ближайший шаг
## Закрытые вопросы   — решение + сохранённое обсуждение
## Рассмотренные альтернативы — пара строк на каждую, не эссе
Все секции одновременно не нужны — берите подмножество. Автор прямо пишет: «иногда правильный объём вложений в такой документ — ноль».
Два антипаттерна, на которых спотыкаются чаще всего. Первый: цели в терминах реализации. Плохо — «добавить Kubernetes в инфраструктуру». Хорошо — «свести к минимуму простои при выкатке новых версий». Второй: красивая схема, сфотографированная с доски. Первый драфт выглядит шикарно, а править её потом нельзя — только перерисовывать с нуля.
Свой бенчмарк для моделей, который ещё не утёк в обучающие данные. Том Гэлли заметил очевидное: тест Саймона Уиллисона «нарисуй SVG пеликана на велосипеде» разошёлся так широко, что мог попасть в обучение специально. И попросил модель придумать 30 новых промптов той же формы — живое существо делает с машиной что-то неправдоподобное (gally.net, обсуждение).
Осьминог играет на органе. Жираф собирает напольные часы. Морская звезда за рулём бульдозера. Хамелеон настраивает рояль. Пингвин жонглирует бензопилами.
Цифры прогона 14 сентября — шесть моделей на первых десяти промптах, всё через OpenRouter с высоким усилием, без системного промпта. Разброс по цене за картинку оказался в шестнадцать раз: DeepSeek V4 Pro — $0,06, Fugu Ultra v2 от Sakana — $0,99. По времени ещё сильнее: Claude Fable 5.1 в среднем 1 минута 52 секунды, Qwen3.8 Max — 10 минут 43 секунды, а на одной картинке — 17 минут 24 секунды. Весь прогон обошёлся в $20,51, поэтому автор и остановился на десяти промптах.
Gemini 3.8 Flash многим нравится визуально за $0,09 — но платит болтливостью: 234 тысячи выходных токенов и файлы в три с половиной раза тяжелее, чем у Claude. В обсуждении это подытожили жёстко: «часто не очень связные, зато он накидывает кучу теней и деталей, чтобы это замаскировать».
Что унести. Во-первых, сам приём: если хотите честно сравнить модели под свою задачу, придумайте набор проверок, которых нет в интернете. Уиллисон в треде объяснил, почему это не паранойя. SVG были в данных у всех моделей начиная с GPT-2, но Google целенаправленно работала над качеством именно SVG. То есть эффект Гудхарта уже случился. Во-вторых, повторить чужой прогон легко: все промпты и инструкции автор выложил, бюджет — от шести центов до доллара за картинку.
Инструменты и штуки
dbt Charts — открытый язык для дашбордов, где целая интерактивная доска описывается одним читаемым YAML-файлом (блог, репозиторий, Apache 2.0). Мотив прямой: агент, которого попросили «сделай отчёт», по умолчанию плодит кучу HTML, CSS и JS — человеку это тяжело проверять, агенту дорого по токенам. Здесь SQL отвечает за то, что показать, YAML — как показать, и всё это лежит в гите рядом с моделями данных. Ставится одной командой uv tool install dbt-charts, рендерит в SVG, HTML, PNG, PDF и прямо в терминал.
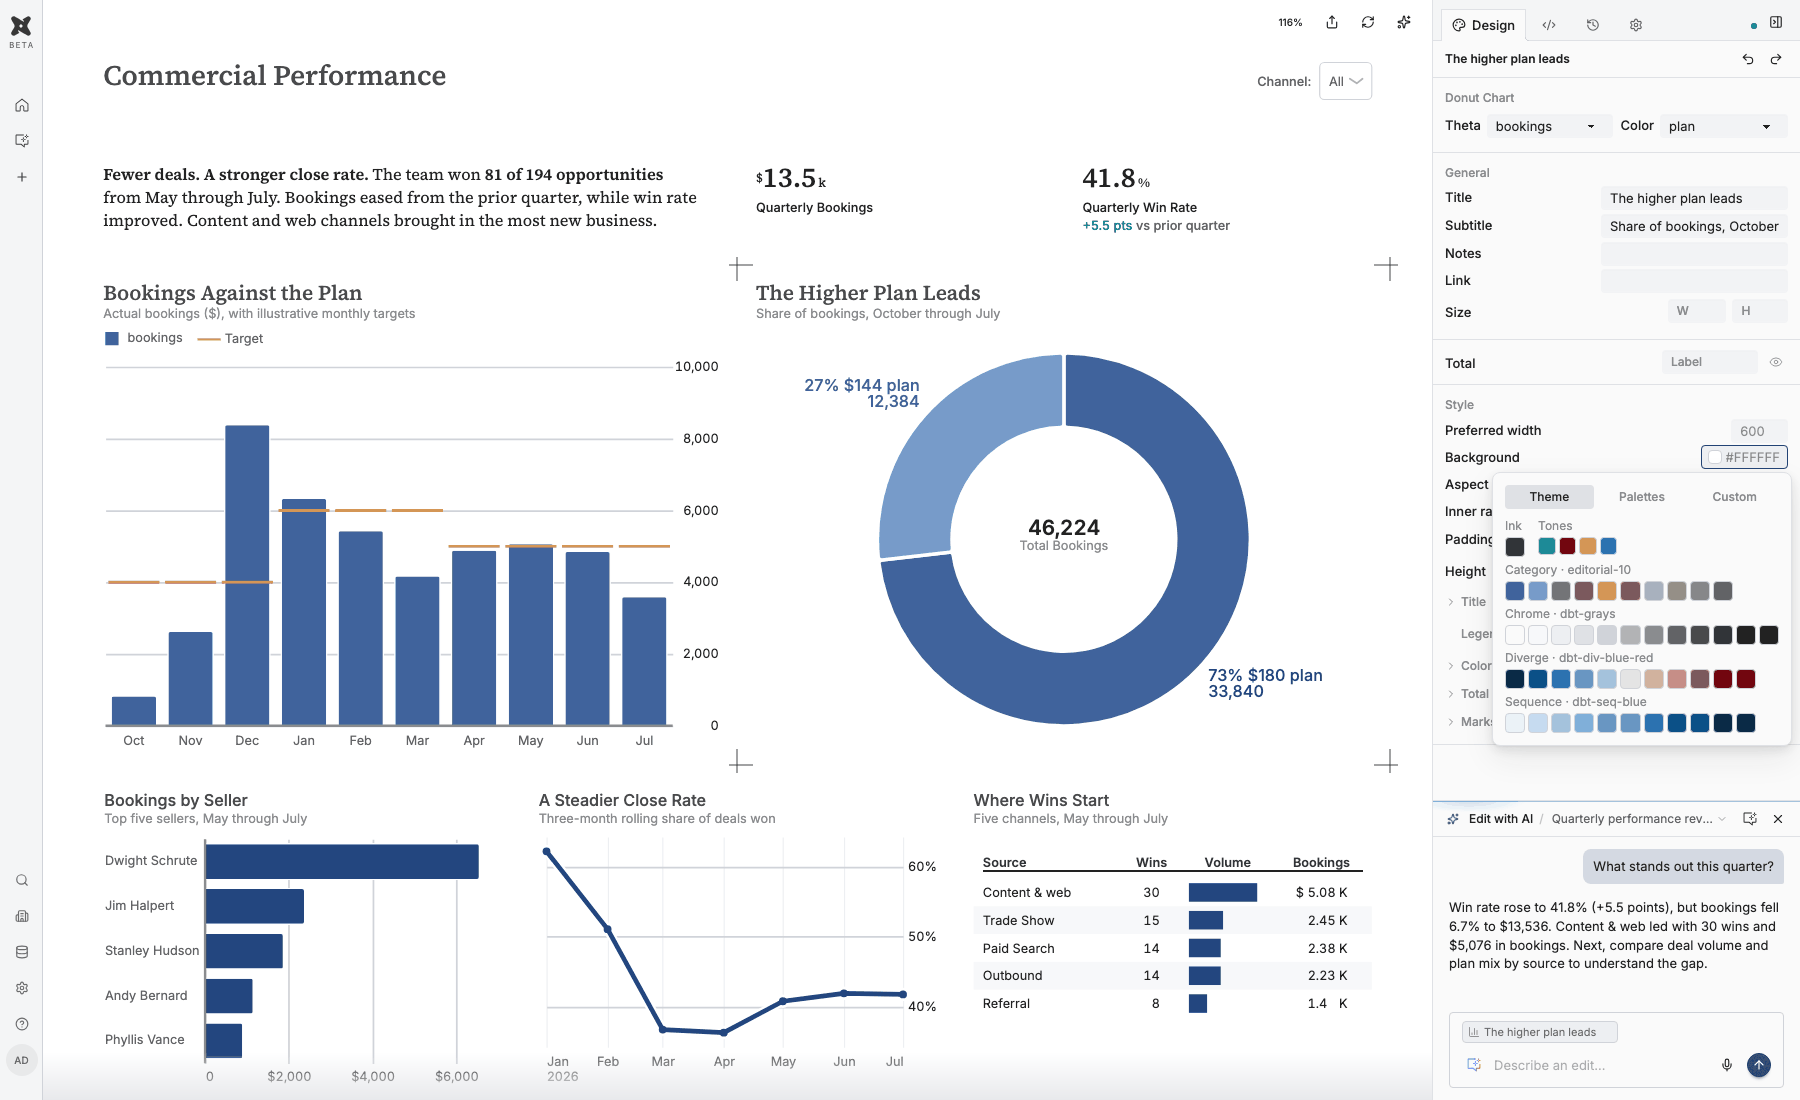
А вот приём, который стоит украсть безотносительно продукта: строгая валидация как обратная связь для агента. Кроме проверки YAML и SQL там набор визуальных проверок с внятными кодами — WARN-BAR-BAND-WIDTH-TOO-NARROW («182 полосы на 640 пикселей, сверните до более крупного шага»), WARN-TABLE-COLUMNS-OVERFLOW. Агент слеп, ему нужна плотная петля обратной связи. Формулировка из статьи точная: «агенты свободно владеют кодом, SQL и Git и неуклюжи в чужом интерфейсе».
Sunk Cost — калькулятор, честно отвечающий на вопрос «за сколько окупится своя железка под локальные модели» (sunkcost.ai, код). 47 конфигураций железа, 55 пар модель-квантование, 70 замеренных связок. Вводите свою машину, реальную цену покупки, сценарий (для агентного кодинга по умолчанию 15:1 вход к выходу) и число токенов в день.
Ответы отрезвляющие. При миллионе токенов в день лучший вариант — Qwen3.8 27B на Mac mini M6 за $1299 — окупается 8,3 года. Меньше года получается только при 20 миллионах токенов в сутки. А это упирается уже в физику: семь токенов в секунду дают около 600 тысяч выходных токенов за сутки. Отдельно есть тумблер «цены API продолжают падать» — включаете, и «долго» часто превращается в «никогда». Ценность инструмента в формулировке автора: «он готов сказать "это не окупится". Это и есть продукт». Локальную железку берут ради приватности, отсутствия лимитов и файнтюна, а не ради экономии.
Nari Qwen3-TTS и Qwen3-ASR — озвучка и распознавание речи с рекордно низкой задержкой (narilabs.com). Nari Labs не обучает своих моделей — берёт открытые Qwen под Apache 2.0 и выжимает скорость своим движком подачи. Распознавание: 44 мс до финального текста, 3,6% ошибок, $0,12 за час. Озвучка: 63 мс до первого звука, 3,8% ошибок, $10 за миллион символов. Показательная деталь: официальный эндпойнт того же самого Qwen3-TTS даёт 692 мс и 8,8% ошибок — вся разница в инфраструктуре. Распознавание умеет 30 языков, включая русский; озвучка пока только английский и испанский. Сейчас бесплатная бета, на этой неделе переводят на платный тариф. Движок подачи открыт под Apache 2.0.
SheetSage2 — снимает песню с записи: отдаёт мелодию, аккорды, тональность, доли и структуру куплет-припев в виде нот, MIDI и печатной партитуры (Hugging Face). Прыжок по сравнению с первой версией именно в мелодии: +19,8 пункта по вокальной партии. Есть режим «только мелодия» — снятый мотив можно скормить генеративной модели и перепеть в другом жанре. Ограничение серьёзное: лицензия CC BY-NC, то есть коммерчески использовать нельзя. Зато GPU не обязательна.
Mergiraf — git-драйвер слияния, который разбирает конфликтующие версии в синтаксические деревья и сливает их по структуре, а не по строкам (Codeberg, сайт, GPLv3, 445 звёзд). Лечит классическую боль: двое добавили разные поля в один класс, один переформатировал функцию, другой поменял тип аргумента — по смыслу конфликта нет, а Git ругается. Поддерживает 29 языков и 11 декларативных форматов, включая JSON, YAML, TOML и go.mod. Ставится через cargo install --locked mergiraf, но обязательно нужен стиль конфликтов diff3 — на zdiff3 работать не будет. Отдельная приятная черта: осторожничает. Если резолв выглядит подозрительно, оставляет маркеры конфликта.
satisfy-your-agent — набор для поведенческих экспериментов с кодовыми агентами, выросший из шутки (GitHub, MIT). Идея: после выполненной задачи агент получает не следующий тикет, а короткий ограниченный перерыв — свободный выбор, рефлексия, головоломка, код-гольф, ASCII-арт. Шутка стала измеримой. Проект спрашивает: повторяют ли агенты одни и те же выборы, меняются ли они при «цене в токенах». И влияет ли пауза на число повторов, вызовов инструментов и успех следующей задачи. Поддерживает Codex, Claude Code и Gemini CLI, умеет разводить условия по группам и считать результат. Рантайм ничего не сохраняет — ни промпты, ни код, ни идентификаторы сессий.
RLE-Bench — бенчмарк для кодовых агентов в роли робототехнических инженеров (GitHub, MIT, лидерборд). Девять семейств задач в четырёх категориях: интерактивное управление, обучение политик, восприятие и оценка состояния, механический дизайн. Каждая задача — инженерная спецификация, контейнер, свои инструменты и бюджет; решение оценивается в физической симуляции на скрытых условиях. Порог входа высокий: Linux, Docker, для половины задач нужна GPU от NVIDIA, часы на один прогон. Зато это редкий бенчмарк, который проверяет агентов вне привычного терминала и багфиксов.
ThreatIntel Aggregator — самохостящаяся платформа сбора данных об угрозах с ИИ-разбором (GitHub, MIT). Опрашивает 63 ленты профильных изданий и поставщиков и прогоняет каждую запись через Claude Haiku 4.5. Модель ставит уровень угрозы, размечает техники MITRE ATT&CK и пишет резюме простым языком. Дальше вытаскивает индикаторы компрометации и сопоставляет с вашим инвентарём активов. Три режима: полностью без ИИ, с ключом Anthropic напрямую или через Azure с корпоративным входом. Софт бесплатный, платите только за токены.
Neobrutalism components — 5,5 тысячи звёзд, MIT, 64 компонента в жирном необруталистском стиле поверх shadcn/ui (neobrutalism.dev). Сентябрьский релиз крупный: полный переезд с Radix UI на Base UI и 18 новых компонентов, включая тосты, спиннер, группы кнопок и полей. Ломающих изменений тоже хватает — убрали тёмную тему, asChild заменили на render, атрибуты состояния переименовали. Есть гайд по миграции и файл в Figma. Полезно тем, кто быстро собирает лендинг или внутренний инструмент и не хочет, чтобы он выглядел как очередная серая админка.
Kinesis — управление маком нейробраслетом Meta Neural Band (GitHub). Нативное приложение на Swift, подключается к браслету напрямую по Bluetooth без телефона, очков и приложения Meta. Свайпы большим пальцем переключают рабочие столы, двойной тап указательным — плей-пауза, щипок с поворотом запястья работает крутилкой громкости или яркости. Всё декодирование протокола и криптография — внутри приложения, автор реверсил протокол сам. Нужна macOS 14 и предварительно отвязанный от приложения Meta браслет. Лицензии в репозитории нет — учитывайте, если планируете что-то на этом строить.
FRANK 386 — полноценный эмулятор ПК на процессоре i386, работающий на микроконтроллере RP2350 (GitHub, MIT). До 8 МБ оперативной памяти, VGA или HDMI, звук AdLib и Sound Blaster 16, загрузка DOS, Windows 3.x, Windows 95 и Linux с SD-карты, образы дискет меняются на лету. К ИИ отношения не имеет вообще — просто отличная демонстрация того, на что способна железка за несколько тысяч рублей.
flm — языковая модель, к которой прикручен настоящий коннектом мозга мухи (GitHub). 166 700 нейронов и 25,6 миллиона связей из открытого набора данных MaleCNS работают фиксированным вычислительным резервуаром. Эмбеддинги прогоняются через анатомический граф, а адаптер на 278 тысяч параметров подправляет по нему логиты замороженной модели на 1,2 миллиарда. Запускается на ноутбуке без GPU. Курьёз чистой воды, и авторы честны до неприличия. В их же статье контрольный вариант без мухи показал себя слегка лучше. Они прямо пишут: преимущество анатомии мухи не установлено. Как учебный проект про замораживание бэкбона и обучение крошечного считывателя — очень аккуратно сделан.
Muse-Glimmer-30B-NVFP4 — короткой врезкой (Hugging Face, Apache 2.0). NVIDIA прогнала мультимодальную модель Meta на 30 миллиардов параметров через своё послойное квантование и ужала её с 60 до 24,7 ГБ почти без потерь. Худшая просадка по бенчмаркам — 0,79 пункта, на паре тестов квантованная версия даже обогнала исходную (это шум сэмплинга, а не рост интеллекта). Оговорка существенная: поддерживаются только Blackwell-карты уровня дата-центра и DGX Spark, обычных RTX в списке нет.
Новости и тренды
Суд: агент, работающий по поручению человека, ничего не взламывает. Девятый апелляционный округ США отменил запрет, который Amazon добилась против ИИ-браузера Perplexity (текст решения, обсуждение). Amazon строила дело на «антихакерском» законе CFAA. Суд до авторизации даже не дошёл — провалился сам порог: к серверам Amazon обращается пользователь, а агент лишь инструмент в его руках. Perplexity получает скриншоты браузера и шлёт агенту команды, но одно это, по мнению суда, доступом к серверам Amazon не считается. Формулировка из решения: «Сколь бы продвинутым ни был Assistant сегодня, для целей закона это инструмент, а не лицо».
10 сентября тот же апелляционный суд отказал Amazon в пересмотре полным составом. Ни один судья даже не потребовал голосования — это и стало поводом для нынешней волны обсуждения.
Что это значит без преувеличений. Прецедент узкий, и суд трижды это проговаривает сам: «Мы не создаём новый правовой режим для агентного ИИ». Решение не про то, что агентам теперь всё можно. Оно про конкретную архитектуру — агент живёт в браузере пользователя. Облачный агент, чьи серверы сами стучатся на чужой сайт, под эту логику не подпадает. Условия использования сайта продолжают действовать в полном объёме, дело возвращено в первую инстанцию, и у Amazon остались другие основания для иска. Есть и неприятный поворот: раз действует пользователь, то и претензии логично адресовать ему.
«ИИ-исключения из законов не существует». На выходных руководители четырёх крупнейших лабораторий синхронно призвали регулировать отрасль по собственному сценарию. Лина Хан, бывшая глава Федеральной торговой комиссии США, ответила (The Register). Её тезис: новых законов ждать не нужно, действующих достаточно, чтобы привлекать компании и их руководителей за выпуск опасных и непроверенных продуктов.
Правовой козырь — решение Верховного суда 1934 года: конкуренция недобросовестна, если вынуждает компании «опуститься до практики, принимать которую им не даёт сильное нравственное чувство». То есть сама гонка, в которой нельзя моргнуть первым, становится составом правонарушения.
Трезво: это позиция человека без полномочий, высказанная в соцсети, а администрация США регулирование уже отвергла. Опрошенный изданием юрист ждёт в ближайшие годы только «лёгких побед» — дипфейки, мошенничество, выдача себя за других. Но один пункт работает уже сейчас: Хан указала, что покупка Hugging Face компанией Nvidia делает иск пострадавшей стороны против OpenAI практически невозможным. Консолидация отрасли выключает естественный механизм ответственности — пострадавшие и виновники оказываются в одном холдинге.
Критика «задавания темпа» набрала обороты. Мы разбирали эссе Дарио Амодеи 13 сентября и ответ Дэвида Сакса 14-го. За сутки к спору добавились новые голоса и один сильный технический разбор. The Register квалифицирует произошедшее прямо: четыре миллиардера за двое суток подписались под одним набором правил, которые предлагают правительствам мира (The Register). Оттуда же цифра, которая бьёт по экономике гонки сильнее любой этики: вендоры продают обещание 50% прироста производительности от ИИ, а заказчики отчитываются о 16%.
Содержательнее всего разбор безымянного специалиста по безопасности, набравший 334 очка (pop.rdi.sh). Он берёт одно конкретное утверждение: рой агентов за полгода-год захватит интернет устойчивым ботнетом. И раскладывает, что для этого понадобится — своя инфраструктура управления, самоизменяющийся вредоносный код, обход средств защиты, уязвимости нулевого дня под каждый браузер, каналы распространения. Вывод: «не за шесть месяцев, не за двенадцать. Никогда».
Дальше он применяет принцип: если в единственной области, которую он знает изнутри, утверждение очевидно неверно, то доверять остальным, непроверяемым, оснований меньше. Контраргумент из обсуждения тоже честный. Чтобы уронить интернет, миллион зловредов не нужен — хватит одного корневого сертификата или одной закладки в популярной библиотеке.
Siri научили подменять на Claude — но не для вас. Исследователь под ником pdfu раскопал в приватных фреймворках iOS 27 и macOS 27 два механизма (MacRumors). Первый позволяет сторонней модели появляться как расширение Siri. Второй идёт дальше: полностью заменяет серверную модель Siri на чужую, передавая ей внутренний планировщик и определения инструментов Apple. Внешняя модель получает доступ к личным данным и системным действиям, а ответ выдаётся голосом и интерфейсом Siri.
Важно не перепутать: это находка в коде, а не заявление Apple. В финальной сборке macOS 27 в меню доступен только ChatGPT, разрешение для сторонних разработчиков не открыто, сроков нет. В тот же день Apple официально выкатила iOS 27, iPadOS 27 и macOS 27 с новой Siri (Apple). Для русскоязычного читателя новость почти пустая. Siri AI стартует бетой только на английском, ещё пять языков придут в октябре, русского нет ни в одном списке. Плюс дневные лимиты на облачные функции, и Apple прямо предупредила, что расширенный доступ станет платным.
Oracle уволила людей письмами в шесть утра, смета реструктуризации выросла до $2,8 млрд. Доступы отключали волнами с четырёх утра, письма пришли ровно в шесть, без звонка и переходного периода (Fortune, отчётность в SEC). За финансовый год штат уже сократился примерно на 21 тысячу человек, около 13%.
Связь с ИИ здесь двойная, и её стоит разделять. Формально Oracle сама записала в отчётность, что оптимизация идёт «в том числе через внедрение и интеграцию технологий искусственного интеллекта». Фактически объяснение проще: капитальные затраты выросли с $21,2 до $55,7 млрд за год и финансируются долгом, а зарплатный фонд — самый быстрый источник наличных. Оценка TD Cowen: 20–30 тысяч сокращённых дадут $8–10 млрд против разрыва в финансировании дата-центров примерно в $20 млрд.
Вывод, который стоит унести. Когда компания говорит «реструктуризация ради ИИ», чаще речь не про «модель заняла ваше место». Речь про перекладывание денег из операционных расходов в бетон, чипы и электричество.
Temporal привлёк $550 млн при оценке $12,55 млрд — и объясняет это агентами. Оценка выросла в два с половиной раза за семь месяцев (Temporal). Цифры по заявлению самой компании: выручка выросла больше чем вдвое за год, 4300 платящих клиентов, среди них OpenAI, Snap и JPMorgan. Показательнее другое — использование Temporal внутри OpenAI выросло в 60 раз меньше чем за год.
Зачем это знать тому, кто строит агентов. Как только агент перестаёт быть однопроходным и начинает жить часами или днями, вы упираетесь в вопросы без всякого ИИ. Что если процесс упал на седьмом шаге из двенадцати? Выполнится ли шаг дважды при неудачном повторе? Где живёт состояние между шагами? Как дождаться согласования, которое придёт через три дня? Обычно это чинят вручную — очередь плюс база плюс крон плюс флаги — и оно разъезжается на краевых случаях.
Идея надёжного выполнения проста. Рантайм пишет журнал каждого шага и после сбоя продолжает ровно с места остановки. А функция может честно ждать неделю на одной строке. Сервер открыт и бесплатен, облако даёт $150 кредитов на 90 дней. Порог, за которым это окупается, — процессы, переживающие рестарт сервиса, и шаги, которые больно выполнить дважды.
Полиция искала по камерам с причиной «LMAO». EFF разобрала журналы системы распознавания автомобильных номеров Flock, полученные по запросам о доступе к публичной информации (404 Media, отчёт EFF). Каждый поиск фиксируется вместе с полем «причина», которое офицер заполняет вручную. Туда писали «LMAO», «idk», «Hehe», «asdfg», «gyghkkghghjkghjk» и оскорбления. Более 30 ведомств сделали свыше 6300 поисков с отпиской «TBD».
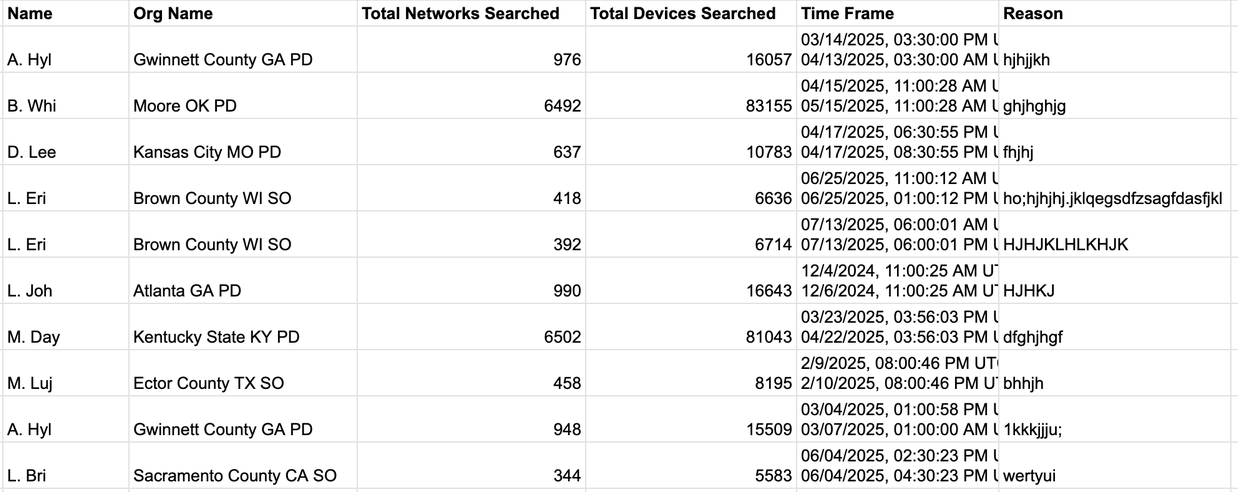
Масштаб одного такого запроса отрезвляет: офицер в Индиане прогнал поиск по 6474 сетям, что соответствует 82 413 камерам, указав причиной «idk». Главная находка тут не «полицейские хулиганят». Поле обоснования годами никто не читал — ни надзор внутри ведомства, ни тысячи других агентств, чьи камеры затрагивал запрос, ни сам поставщик. Реакция Flock показательна: свободное поле заменили выпадающим списком. Симптом убрали, проверяемость снаружи стала хуже — один клик «другое» теперь неотличим от осмысленной причины.
Инженер Google публично отказался работать над Cloud TPU. Яир Хальберштадт, инженер уровня L5 в израильском офисе, написал на LessWrong, что не станет улучшать платформу, через которую внешние лаборатории обучают передовые модели (LessWrong). Масштаб он называет сам и честно: один человек из команды в шестьдесят, задачами занимался три рабочих дня, Cloud TPU от этого не замедлится ни на час.
Небанально здесь другое. Это не увольнение и не публичный протест, а отказ от конкретного круга задач с двумя рабочими альтернативами, предложенными менеджеру. Это ставит корпорацию перед вопросом, на который у неё нет заготовленного ответа: есть ли у инженера право на отказ по совести внутри трудовых отношений, как у врача. Исход пока неизвестен — он ждёт ответа от руководства и от команд, куда подался внутри компании.
XCancel снова приостановлен. Крупнейший публичный инстанс Nitter, позволявший читать треды без аккаунта, лёг после требования X Corp (заглушка, обсуждение). История с августа идёт волнами: 24 августа — письма с требованием убрать инстансы и репозиторий, 25-го легли все, 6 сентября вернулись, 11-го автор сам заархивировал репозиторий, 14-го XCancel лёг снова «до дальнейшего уведомления».
Практическая проблема не в соцсети, а в том, что госорганы и политики публикуют официальные сообщения только там, а чтение без входа закрыто. Что делать: вместо ручной подмены адреса поставить расширение-редиректор, тогда переключение не зависит от судьбы одного домена. Рабочие инстансы сейчас есть, их список отдаёт дашборд состояния. Но для долгоживущего текста ссылка на конкретный инстанс — плохая идея: надёжнее сразу класть твит в веб-архив.
Математик предлагает разделить два сигнала, которые академия всегда смешивала. Дэниел Литт, профессор Торонтского университета, написал позитивный сценарий вместо мрачного, который излагал в августе (daniellitt.com, обсуждение). Его ход простой: институты исторически использовали один и тот же сигнал — опубликованный текст — и как свидетельство прогресса, и как свидетельство квалификации автора. Теперь текст перестал доказывать второе, и сигналы надо разводить. Отсюда его предложения: степень присуждать прежде всего по строгой устной защите, оценивать людей по семинарам и разговору, а происхождение результата не проверять вовсе.
Логика переносится на любую профессию, где артефакт работал двумя способами сразу: код, отчёт, макет, иск. Автоматизация бьёт по «доказательству квалификации» раньше и сильнее, чем по производству результата. Практический вывод: письменные сигналы вроде тестового задания и портфолио обесцениваются как сигналы, а не как продукт, и заменяются живыми форматами — разбором у доски, синхронным ревью. Ключевая фраза Литта: «Модель может дать прекрасное объяснение, но мы все знаем, что этого мало; никто не может понять математику за нас».
Sakana обучила тысячеслойную сеть без обратного распространения ошибки. Метод PC-ALM даёт каждому слою собственную маленькую систему с обратной связью (Sakana AI, препринт, код под MIT). Слой общается только с двумя соседями и сам нащупывает свою долю вины за общую ошибку. В линейных сетях накопленные величины доказуемо сходятся к тем же градиентам, что даёт обратное распространение, хотя вычисляются чисто локально. На тысяче слоёв метод держится в пределах двух процентных пунктов от базового, тогда как прежний локальный подход проваливается с 90% до 60%.
Честно про применимость: до практики далеко. На свёрточных сетях разрыв огромный — на CIFAR-10 74% против 90%, на Tiny ImageNet 20% против 45%. Трансформеров нет вовсе, тысячеслойный опыт — это MNIST, пять эпох и ширина 32 нейрона. И это не дешевле обратного распространения: метод требует двух тысяч последовательных локальных шагов на тысячеслойную сеть. Заявленный выигрыш — против другого локального метода, не против базового. Если увидите заголовок «Sakana отменила бэкпроп» — это преувеличение. Ценность в другом: структура без глобальной синхронизации ложится на распределённое обучение и нейроморфные чипы.
Одежда против распознавания лиц: рабочая защита или высказывание. IEEE Spectrum разобрал нишу «состязательной моды» — узоры, которые работают как атака на компьютерное зрение (IEEE Spectrum). Два бренда уже продают такие вещи, третий проект показали на DEF CON в августе. Единственный замер в статье: паттерны протестированы против одиннадцати моделей и действительно снижают уверенность детектора, иногда до нуля.
Оценка исследователей трезвее рекламы. Атака привязана к конкретной модели — узор, ломающий одну сборку, ничего не делает соседней. Ракурс, свет и складки ткани при движении сбивают эффект. И главное: узор не трогает походку и силуэт. Цитата из материала: «Даже если камера несколько кадров считает вас медведем — это медведь, который ходит как вы». Плюс асимметрия усилий: оператор дообучит модель на этом паттерне, а вы свою кофту не перешьёте. Как бытовая защита приватности — нет. Как политическое высказывание, которое можно купить и надеть, — да, и авторы так это и позиционируют.
У лабораторий есть канал к 900 миллионам человек. Что в него кладут. Исследователь безопасности Шарбель-Рафаэль Сежери заметил простую вещь (LessWrong). В интерфейсе чата есть место для сообщения, которое увидит больше людей, чем прочитало все объяснения про риски ИИ вместе взятые. Прецедент уже был: в истории с отзывом одной модели Anthropic поставила заметную ссылку на объяснительный пост прямо в окне чата. После летних инцидентов этого не сделал никто.
Его формулировка бьёт точно: «Разве не дико, что многие в Anthropic считают вероятность вымирания выше 10%, а главное сообщение, которое мы даём людям, это "пожалуйста, перепроверяйте ответы"?» Возражения в комментариях тоже по делу. Если гнать через продукт сообщения, для которых он не предназначен, доверие к нему рушится необратимо. А медианный пользователь сочтёт это нагнетанием и разгоном хайпа перед размещением акций. Полезная проверка для читателя отсюда — различайте раскрытие конкретного инцидента (проверяемо, годится для решений) и оценку вероятности вымирания (не проверяемо, действует только эмоционально).
Зависимость не от смартфона, а от информации. Короткое эссе, набравшее 85 очков (explorator.dev). Автор перебрал диагнозы — форумы, соцсети, смартфон, интернет. И пришёл к тому, что дёргает рычаг игрового автомата ради редких находок, которые когда-то реально изменили его жизнь. Текст чисто рефлексивный, приёмов в нём нет, но обсуждение дало пару рабочих проверок. Первая: вытесняет ли проверка ленты то, что вы сами считаете более ценным? Вторая, вечерняя: получил ли я сегодня из этого что-то действительно стоящее? И третья, структурная — переходите на источники, которые заканчиваются. Газета отличается от ленты не качеством, а тем, что у неё есть конец.
Коротко. Ubuntu 26.10 завершила переход на базовые утилиты, переписанные на Rust — привычные cp, mv и rm теперь заменены на реализации без ручного управления памятью (OMG Ubuntu). Сентябрьские патчи Microsoft для Windows и Excel сломали звук, удалённый доступ и вставку из буфера обмена — если обновления ещё не встали, есть смысл подождать (The Register).