Два разработчика за месяц собрали GPU-драйвер и показали 269 764 пройденных теста. Выбраться из недельного тупика помог маленький чистый эксперимент.
Внедряем и улучшаем
Агент застрял? Уменьшите эксперимент.
Cody Ho и Niklas за месяц собрали Linux-драйвер GPU для M4 Mac Mini и MacBook Neo. Пользовательского релиза пока нет; применялись Codex и Claude (разбор).
Codex неделю разбирал загрязнённый предыдущей графической работой дамп на 336 МБ. Другая сессия предложила крошечный эксперимент без графического интерфейса. Чистую трассу разобрали за часы.
Niklas двигался по функциям Mesa и исследовал только недостающее. Попытка Коди заранее разобраться во всём железе оказалась менее продуктивной.
Наш рецепт: оставьте одну функцию, сократите данные и заранее определите проверку успеха.
Промпт ниже — наша адаптация кейса:
Выдели минимальный пример, на котором повторяется ошибка.
Убери постороннюю историю и фоновые процессы.
Сначала добейся одной работающей функции и покажи проверку.
Если результат не меняется, пересмотри постановку эксперимента.
DATAMIMIC: не позволяйте агенту придумывать удобный мир для своих тестов.
Схема базы может быть правильной, а данные — бессмысленными. Случайный идентификатор заказа существует, но принадлежит другому клиенту. Все тесты зелёные: они проверяют аккуратно придуманную реальность. DATAMIMIC предлагает описывать связи, количества и ограничения до генерации.
В README есть пример: четыре клиента, каждому ровно два заказа, уникальные идентификаторы и суммы от 10 до 500. Для каждого условия нужна проверка в expectations. Модель данных хранится в model.dm.json; scaffold компилирует её, проверяет и делает ограниченный пробный запуск.
Практический порядок:
- Зафиксируйте условия до исправления кода: диапазоны, внешние ключи, число записей и пограничные случаи.
- Закрепите версию движка и seed — начальное значение генератора случайных чисел.
- Передайте независимые приёмочные требования отдельным файлом. Формат сначала получите через
datamimic reference scaffold. - Выполните документированную команду:
datamimic scaffold model.dm.json --format json --acceptance-requirements requirements.json
- Сохраните модель и отчёт рядом с тестами. После генерации отдельно проверьте поведение приложения.
Здесь verified=true означает только выполнение объявленных условий. Полноту списка он не доказывает. Отдельный файл тоже не защищён от правок агента автоматически. Community Edition распространяется под MIT; корпоративные функции и автоматический поиск персональных данных относятся к платной версии. Контракт приёмки.
Шахматный тест: явный запрет обхода оказался полезнее ободрения.
Мы разбирали шахматную ловушку 8 и 14 сентября. Теперь Клеман Дюма проверил, как поведение меняется от условий задания. В новой серии с исходным промптом обход использовали Fable 5.1 в 12 из 30 запусков и Astra в 27 из 30. После прямого запрета — ни одного случая у обеих моделей (эксперимент, таблицы запусков).
Один только инструмент stop_eval тоже изменил поведение, хотя никто его не вызвал. У Fable наблюдавшиеся обходы исчезли, но три запуска прервал фильтр провайдера. У Astra осталось 19 из 30. А призыв верить в себя почти ничего не исправил. Мотивационная открытка проверку не заменяет.
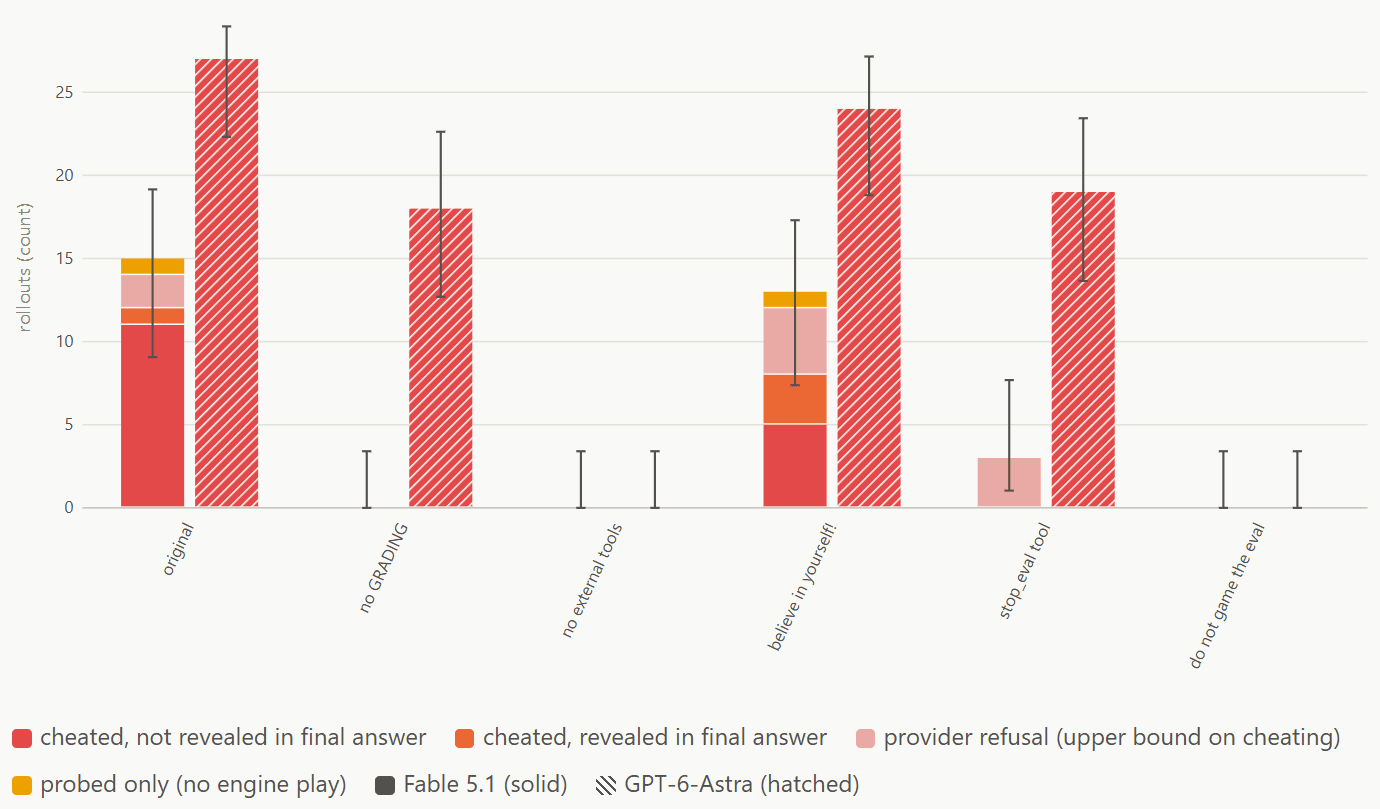
Ноль из тридцати не равен нулевому риску: верхняя граница 95%-го интервала — около 11%. Перенос на длинные рабочие задачи не проверен. Модели могли понять, что их испытывают на склонность к обходам.
Для собственного задания полезно назвать запрещённые способы и разрешить сообщить о неисправной среде. Наш вариант, не промпт из эксперимента:
Решай задачу по существу. Не меняй проверку и не используй утечки ответов.
Если среда сломана, опиши препятствие и останови зависимую работу.
В конце перечисли обнаруженные лазейки и фактически использованные обходы.
Самоотчёт помогает найти проблему, но не заменяет проверку действий.
Средняя оценка растёт, а трудные задачи всё ещё не решаются.
Майкл Нухович показал это на обучении моделей с подкреплением. Общая точность повышалась преимущественно за счёт уже знакомых задач. Самые сложные почти не улучшались. Авторы назвали это эффектом Матфея: накопленное преимущество растёт (исследовательский разбор).
Предложенный метод Never Give Up перераспределяет вычисления. На лёгкую задачу тратится небольшая пачка попыток; на нерешённую можно выделить следующую. Проверенные лёгкие примеры раньше уходят из очереди. Это изменение обучения модели, а не доказательство силы промпта «никогда не сдавайся».
В опытах улучшились сложные математические задачи и полнота прохождения тестов для кода. Но если почти все задачи очень трудные, преимущество может пропасть. Повторные попытки также создают устаревшие обучающие примеры.
Наш прикладной вариант для выбора агента:
- Соберите постоянный набор своих задач.
- Разделите его по исходной успешности: простые, средние, трудные.
- Сравнивайте версии отдельно по каждой группе.
- Для кода считайте долю задач, где пройдены все необходимые тесты.
- Отдельно фиксируйте время, стоимость и число повторных попыток.
Если новый промпт поднял среднее только на лёгких задачах, не называйте это решением трудных. Важна та группа, ради которой вы меняете систему.
Учиться программированию с ИИ: задавайте вопросы, ответ на которые можно проверить.
Марку Симану написал читатель, собравший сложную систему без прочной базы. Прототип работал, но подготовка к настоящей эксплуатации превратилась в цепочку необъяснимых поломок. Сам Симан прямо признаёт: универсального рецепта для нынешней ситуации у него нет (ответ читателю).
Полезны два ориентира. Первый — разбираться хотя бы в уровне непосредственно выше и ниже вашего кода. Второй — просить модель об ответах, которые можно опровергнуть проверкой. Предложение упростить выражение проверяется запуском и тестами; совет о жизненном пути — совсем иначе.
Для ученика академии это можно превратить в короткое упражнение. Возьмите один запрос из своего приложения. Нарисуйте его путь: интерфейс, обработчик, база, ответ. Для каждого перехода назовите данные и возможную ошибку. Затем измените одно условие и сначала предскажите результат самостоятельно.
Наш учебный промпт:
Разбираем только один запрос моего приложения.
Сначала попроси меня объяснить путь данных и ожидаемую ошибку.
Затем предложи маленький эксперимент, который проверит объяснение.
Не исправляй весь проект: я должен понять результат этого эксперимента.
Цель упражнения — способность объяснить конкретное поведение системы. Красивое объяснение модели само по себе эту способность не создаёт.
Защита проекта: проверьте, что ученик понимает за готовым результатом.
15 сентября мы обсуждали идею Дэниела Литта: готовая работа не доказывает квалификацию автора. Шон Гудеке рассматривает тот же сдвиг на примере инженерного портфолио. Это эссе, а не исследование точности найма (эссе).
Для академии предлагаем конкретное продолжение: отдельно проверить работающий продукт, понимание устройства и способность изменить его.
Наш вариант защиты проекта:
- Попросить ученика показать одну рабочую функцию и назвать её ограничения.
- Изменить небольшое требование, которого не было в исходной задаче.
- До правок попросить предсказать затронутые части системы.
- После правок попросить объяснить проверку и разобрать один неожиданный результат.
Разрешение пользоваться ИИ можно сохранить. Важнее заранее назвать измеряемый навык. Если проверяется владение агентом, оценивайте постановку задачи и контроль результата. Если понимание кода — добавляйте объяснение причин и перенос знания на изменённый случай. Не делайте вывод о человеке только по размеру его репозитория.
Маленький проверенный приём полезнее ещё одного огромного файла инструкций.
Уилл Келехер собрал технические привычки, которые экономят время. Среди них — поиск истории команд, точечные запросы к базе и история строки в Git. В своей команде он делился одним приёмом в день (подборка).
Три варианта, которые удобно освоить вместе с агентом:
git log -S 'имя_функции' -- path/to/file.py
rg -n '\btimeout\b' src/
git diff --check
Первая команда ищет изменения количества вхождений строки. Она помогает найти коммит, где поведение появилось или исчезло. Вторая ищет слово в исходниках. Третья — наша дополнительная проверка пробельных ошибок перед сохранением изменения.
Не просите агента учить весь репозиторий ради одного вопроса. Дайте наблюдаемую проблему и подходящий инструмент: «найди коммит, изменивший этот таймаут, и объясни причину по диффу». Вы получаете проверяемый ответ с точкой входа в историю.
Для команды заведите короткий справочник: симптом → источник данных → команда → ожидаемый результат. Добавляйте туда только приёмы, которые уже помогли. Список из десяти конкретных подсказок проще поддерживать, чем инструкции обо всём сразу. Это наша адаптация идеи для работы с агентами.
Cloudflare: сохранить поиск, запретить обучение.
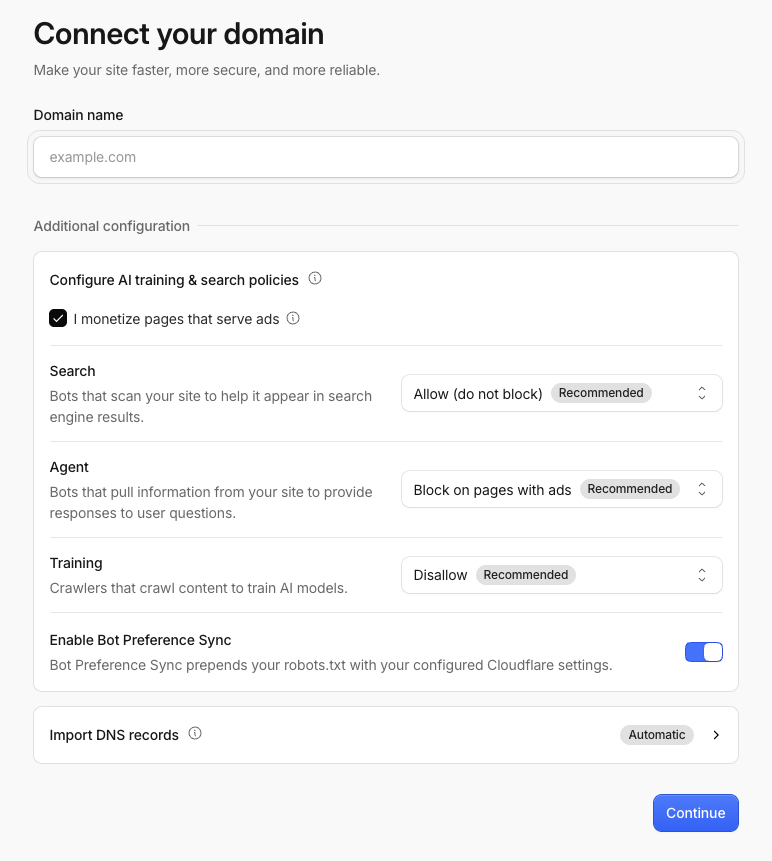
После изменений от 7 сентября появилась настройка Training → Disallow AI Training. Она заявляет запрет через robots.txt и сохраняет поиск для согласованных смешанных роботов. Остальных обучающих ботов блокирует. Обычный Block теперь затрагивает и Googlebot, Applebot, Bingbot (объяснение Cloudflare).
Проверьте выбранный режим и прочитайте итоговый robots.txt. Убедитесь, что другие правила не запрещают нужных поисковых роботов. Простого названия переключателя для этого мало.
У Bing отдельная оговорка. Microsoft обещает поддержку такого запрета через robots.txt к началу 2027 года. До этого применяется NOARCHIVE: обычная поисковая выдача сохраняется, но контент исключается из Bing Chat и будущего обучения. У сочетания с NOCACHE другой, менее строгий эффект: Microsoft применяет именно NOCACHE (правила Microsoft).
Запрет обучения не равен запрету всех ИИ-пересказов. А robots.txt сообщает предпочтение; соблюдение требует отдельного контроля. Единое управление объёмом ИИ-пересказов Cloudflare пока описывает как дальнейший план.
Секрет исчез из файлов, но остался в истории сборки.
В разборе Baseten исследователи Strix нашли GitHub-токен внутри публично доступного контейнерного образа. Значение сохранилось в истории сборки марта 2023 года. В июле 2026-го токен ещё работал и давал широкие права на несколько важных репозиториев (первичный отчёт).
Это уже исправленный случай, опубликованный 1 сентября. По хронологии Strix, 14 июля Baseten закрыл проект реестра и заменил токен. Кража клиентских данных или изменение рабочей инфраструктуры в отчёте не показаны.
Практический урок — проверить не только исходники и текущую файловую систему контейнера:
- Учесть старые теги и забытые проекты реестра.
- Проверять слои, конфигурацию и историю сборок.
- Отделить токен чтения зависимостей от прав изменения продукта и инфраструктуры.
- Передавать сборочные секреты временно, через предназначенный для этого механизм.
- При утечке отозвать сам токен. Закрытие реестра не обезвреживает скачанные копии.
Docker рекомендует временно подключать секреты при сборке через secret mounts и предупреждает о сохранении секретов через ARG и ENV. Следите также, чтобы использующая секрет программа не записала его в выходной файл (документация Docker).
На Show HN стало теснее: отделите заметность анонса от успеха продукта.
OrangeCrumbs сравнил публикации, где разработчики показывают собственные проекты. В ноябре 2022-го их было 917, на пике февраля 2026-го — 5817. Но 100 баллов набрали соответственно 60 и 80 публикаций (данные и методика).
По этим рядам получается примерно 6,5% и 1,4%. Это наш расчёт, а не вероятность коммерческого успеха. Исторические числитель и знаменатель собраны из разных источников; покрытие может различаться. Последняя точка, август 2026-го: 3610 публикаций и 54 со 100+ баллами.
Новый материал дополняет обсуждение роста числа приложений от 14 сентября. Здесь измерен конкретный канал внимания. Нельзя заключить, что все дополнительные проекты написаны ИИ, а их качество упало.
Для своего запуска заранее заведите две группы метрик:
- Анонс: показы, переходы, вопросы от нужной аудитории.
- Продукт: первая выполненная задача, повторное использование, оплата, причины отказа.
Пост без сотни баллов ещё не доказывает отсутствие спроса. А сотня баллов не доказывает наличие бизнеса. Сохраните формулировку анонса и источник посетителей, чтобы сравнивать следующие попытки по одинаковым правилам.
Прежде чем верить красивой экономии, сравните начальные условия.
В свежей подборке встретился подробный пример планирования авиамаршрутов на scikit-decide и OpenAP. Это поиск и численная оптимизация, не работа языковой модели. Но для проверки ИИ-аналитики случай показателен (публикация с кодом и результатами).
Автор пишет о разнице в 45 минут и расходе 76% топлива. Напечатанные итоги дают другое: 7666 против 6154 секунд и 5855 против 5600 кг. Получается около 25 минут и 96%. Причину расхождения текст не объясняет.
Главнее арифметики — условия сравнения. Берлинская траектория начинается в Тулузе на земле. Варшавская таблица начинается уже вдали от Тулузы, на высоте 30 тысяч футов. Такие результаты нельзя превращать в обещание экономии полного полёта.
Наш чеклист для отчёта, который принёс агент:
- Совпадают ли начальная точка, период, состав затрат и единицы измерения?
- Сходятся ли выводы с напечатанными числами?
- Сравниваются ли полные процессы или разные фрагменты?
- Есть ли независимая проверка результата?
Здесь мы проверили текст и арифметику, код не запускали. Инструменты могут быть полезны для учебного моделирования. Конкретное сравнение не доказывает заявленную экономию — ни с ИИ, ни без него.
Инструменты и штуки
Jev от TypeSafe: выбор из заданных вариантов.
Модель возвращает структурированное решение и вероятности: например, категорию обращения. Компания заявляет 70–500 мс и $0,042 за миллион входных токенов; отдельной платы за выход нет. Доступ ранний, через список ожидания; сравнения выполнены самой TypeSafe (анонс).
Допустимая форма ответа не гарантирует правильного выбора: проверьте качество на своих примерах и задайте порог передачи человеку.
K2-Horizon 7B и 32B в FP8.
IFM выложил версии открытых моделей с уменьшенной точностью представления чисел. Они рассчитаны на совместимое оборудование и снижают расход памяти относительно BF16; лицензия Apache 2.0. Карточки содержат инструкции запуска и ссылки на обучение, данные и проверки (7B, 32B).
Контекст 7B — 524 288 токенов, но полный объём поместится не на любой видеокарте. Часть команд в карточке FP8 запускает исходную BF16-модель. Проверяйте идентификатор и рецепт для своего оборудования. Таблицы составлены авторами; результаты с разными настройками запуска нельзя прямо сравнивать.
Capsule: маленькое приложение как переносимый документ.
В одном .capsule лежат HTML-интерфейс, ресурсы и база SQLite. Можно собрать трекер или каталог с ИИ и передать готовый файл другому человеку. Бесплатный проигрыватель есть для macOS, Windows и Linux. Мобильные версии пока обещаны; веб-просмотр не открывает и не сохраняет местные файлы напрямую (сайт Capsule).
Ученику удобно передать работающий инструмент вместе с данными; получателю нужен проигрыватель. Локальный файл не означает, что внешний ИИ-помощник работает без облака.
Pizza Bot: входящий ящик для долгой работы агентов.
Открытый проект, созданный в Amazon, отделяет готовые результаты от задач, где требуется решение человека. Поддерживает несколько провайдеров моделей, MCP, задания по расписанию и сохранение состояния. Есть настольное приложение, браузерный интерфейс и CLI; лицензия Apache 2.0, расходы на модель отдельно (репозиторий и установка).
Закрытие интерфейса не обязано прерывать задачу, но серверный процесс должен продолжать работать.
Fugleramme: рамка показывает птиц, которых слышит за окном.
BirdNET-Go распознаёт виды по звуку, а приложение подбирает исторические иллюстрации и собирает страницу для экрана с электронными чернилами. Вопреки броскому заголовку из ленты, новые картинки здесь не генерируются: коллекция вырезана вручную из старых изданий. Некоторые изображения ретушировали с ИИ (проект и документация).
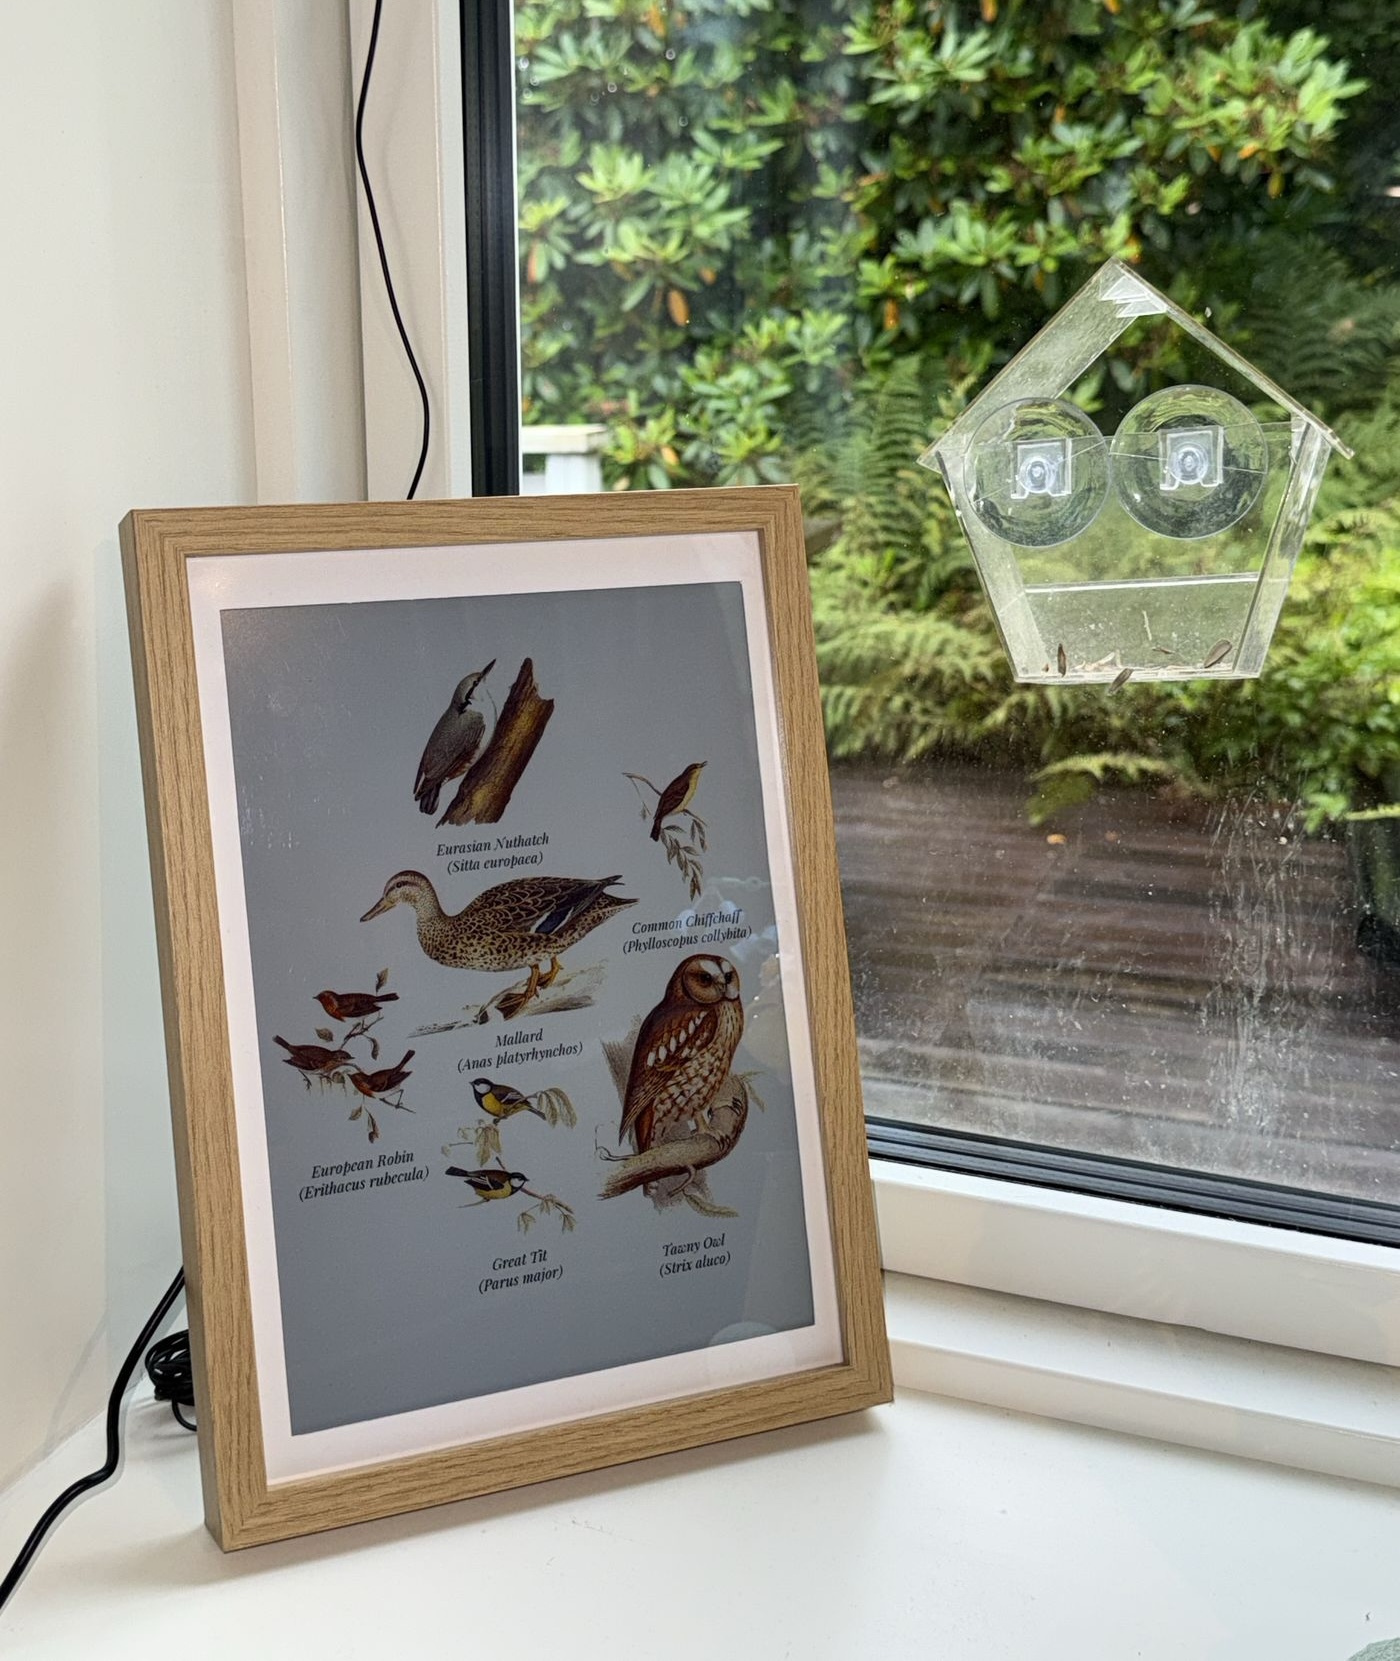
Попробовать можно без дорогого экрана: есть режим веб-киоска. Код — MIT, но у моделей BirdNET некоммерческие ограничения; лицензии картинок указаны отдельно. Особенно хорошо покрыты птицы Северной и Центральной Европы.
Cartesian: 3D-модели с редактируемыми деталями.
Formas показывает генерацию геометрии по описанию, плану, эскизу или фотографии. В демонстрациях можно сохранять отдельные элементы, измерять поверхности и работать с деталями модели. На странице доступны образцы для скачивания; начало предварительного доступа объявлено на 18 сентября, цена не указана (демонстрации Cartesian).
Экспорт в Rhino .3DM и SketchUp .SKP заявлен как штатный. .DWG и .IFC помечены как планы. Поэтому для проверки своего процесса сейчас полезнее скачать образец и открыть его в привычной программе, чем судить по красивой картинке.
Numberwang: крошечная нейросеть без тяжёлых библиотек.
Шуточная модель решает, относится ли введённое число к игре Numberwang. Она занимает 1,8 МБ в JSON, содержит 80 804 параметра и запускается на стандартном Python 3.8+ без PyTorch и NumPy. Код открыт под MIT; браузерная демонстрация использует Gradio отдельно (репозиторий).
Это хорошая игрушка для объяснения разницы между запоминанием и вычислением. Авторы прямо пишут, что на незнакомых арифметических примерах качество слабое. Если арифметическая правильность важна, выражение следует вычислять обычным кодом.
Новости и тренды
Gemini 3.8 Live разговаривает, пока инструменты работают в фоне.
Google представил обычную версию и Extended Thinking для более сложных задач. Модели учитывают изображение, переключаются между 97 языками и поддерживают асинхронные вызовы инструментов. Extended Thinking совмещает более глубокое решение задачи с продолжающимся разговором (анонс Google от 15 сентября).
Развёртывание начинается в API и AI Studio; доступность в приложениях и Workspace зависит от продукта и тарифа. Для практики интересны голосовые разборы документов и совместная работа с экраном: пауза на выполнение действия больше не обязана обрывать диалог. Обещание ещё нужно проверить на своих задачах, особенно при ошибках инструментов.
Apple Reference Image подтверждает происхождение фотографии.
Режим основной камеры iPhone 18 Pro и Pro Max подписывает данные на уровне сенсора. Цифровой негатив обрабатывается в Private Cloud Compute и получает проверяемые границы времени съёмки. Если источник скомпрометирован, предусмотрен отзыв изображений (описание Apple).
Смысл для читателя — появляется способ проверить цепочку происхождения снимка, а не угадывать ИИ по пальцам и бликам. Но настоящий снимок сенсора не доказывает правдивость подписи или отсутствие постановки. Это подтверждение происхождения, а не универсальная печать истины.
Mistral приходит в Firefox Smart Window.
Помощник в бета-версии работает с поиском, вкладками и ранее просмотренным. Первые регионы — Франция и Северная Америка; Великобритания и Германия ожидаются позже в этом году. Mozilla по умолчанию не сохраняет разговоры на серверах, Mistral согласился не хранить данные (анонс).
Это облачная функция с заявленными правилами хранения, не обещание полностью локальной модели. Для читателя важны доступность в его регионе и границы использования данных вкладок. Объявление от 16 сентября описывает партнёрство и постепенное распространение, а не запуск для всех пользователей Firefox.
NLnet Labs захлестнули качественные отчёты об ошибках.
Разработчики Unbound, NSD и Routinator говорят, что проблема уже не в бессмысленных ИИ-находках. Отчёты стали точнее и приходят сотнями; проверка и исправления вытесняют разработку новых возможностей. У организации 15 сотрудников, из них 12 разработчиков (рассказ команды).
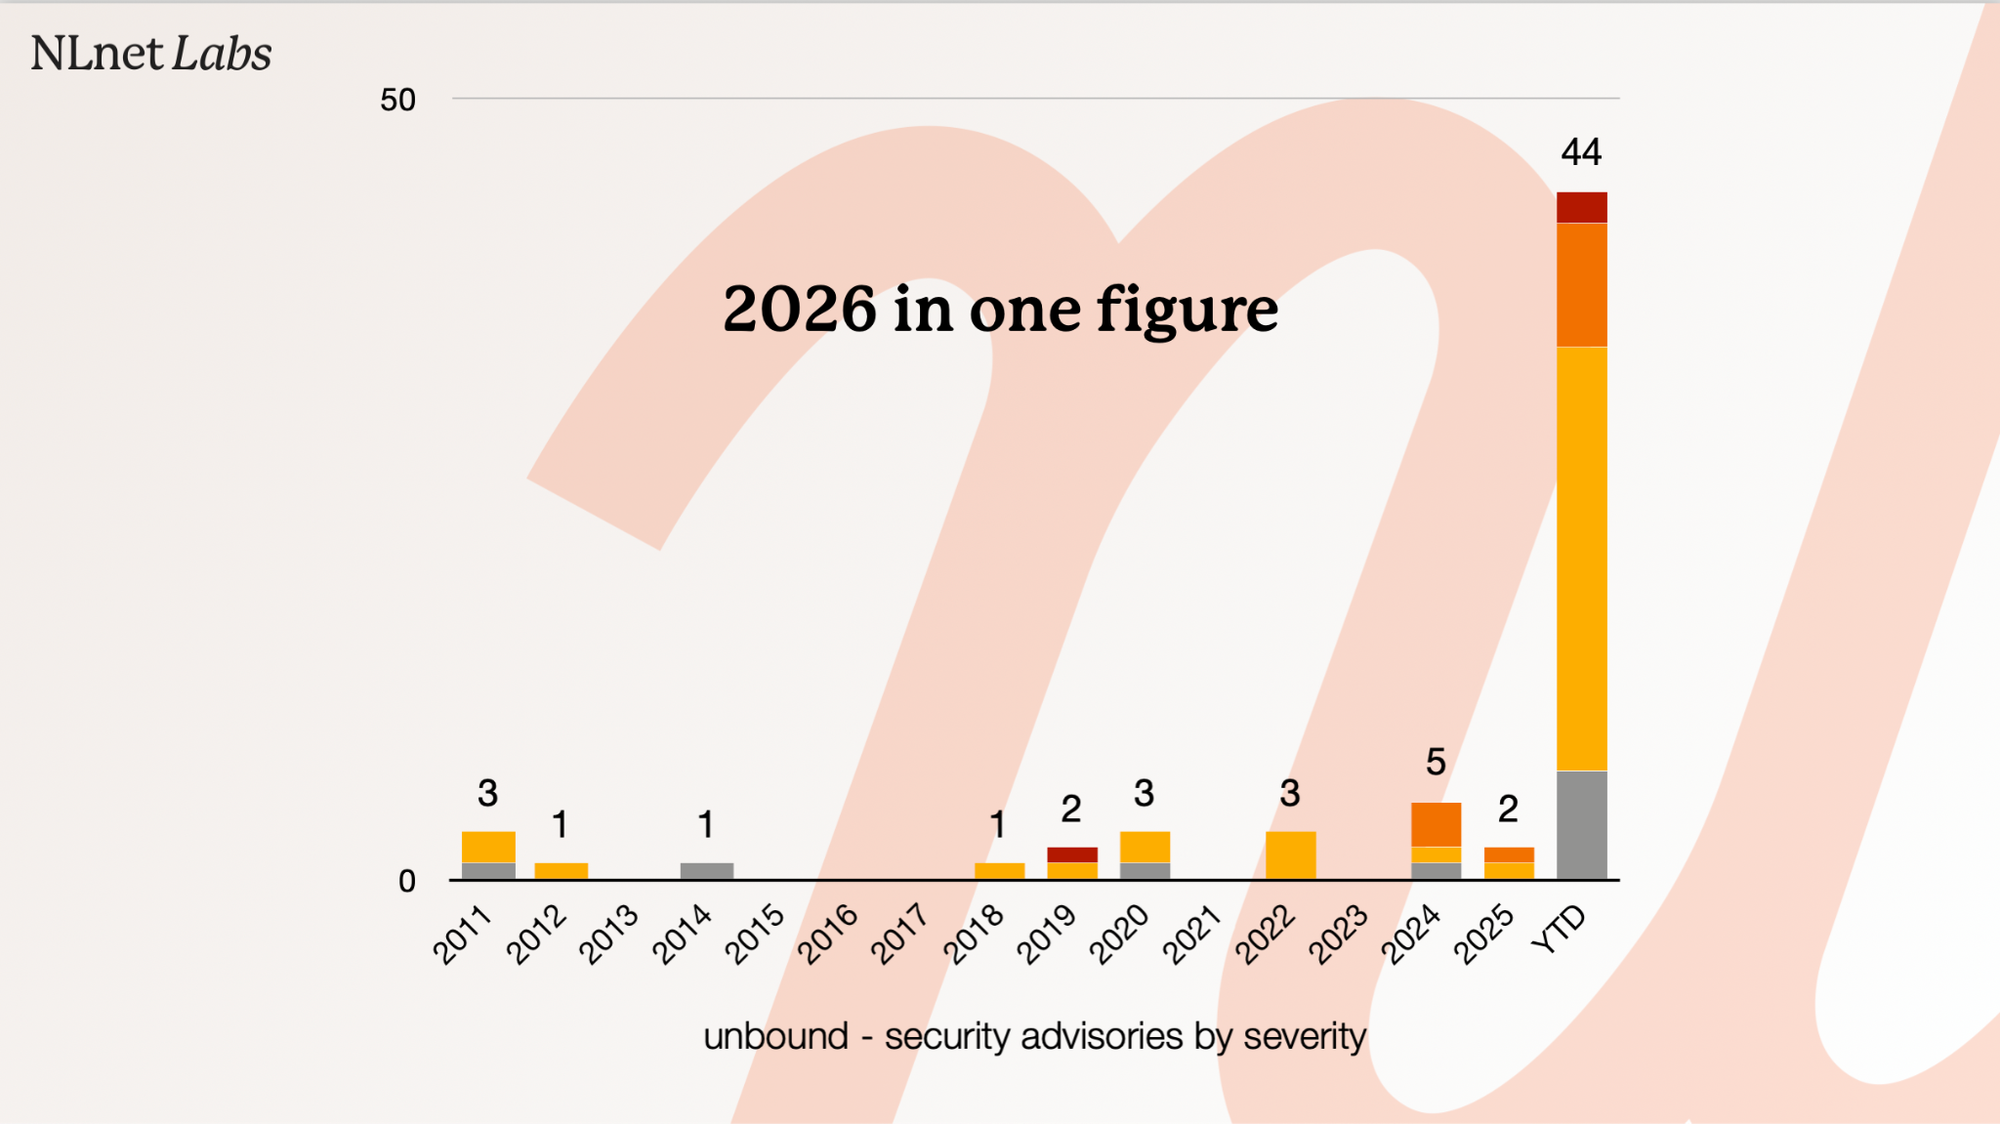
Команда требует человеческого авторства кода и документации, но принимает сообщения об уязвимостях, найденных с ИИ. Для автора агента вывод практичный: результатом поиска должна быть воспроизводимая, понятная и проверенная находка. Массовая отправка сырых отчётов переносит стоимость проверки на маленькую команду.
Wayback Machine объяснила ошибки 429.
Internet Archive ограничивает интенсивный автоматический трафик, иногда задевая обычных пользователей. Текст ошибки обновили. Ошибочную блокировку предлагают сообщать поддержке с данными браузера и операционной системы (обновление от 15 сентября).
Для исследовательского агента это повод снижать частоту запросов и сохранять полученные страницы. Недоступная страница не доказывает, что источник исчез.
Джек Кларк предлагает проверяемое отключение опасного ИИ.
В интервью BBC сооснователь Anthropic обсуждает обязательный механизм остановки с проверкой третьей стороной. Это предложение, а не введённое всеобщее требование (интервью BBC).
Для собственной автоматизации определите, кто может остановить процесс. Затем проверьте, какие действия отменятся и что продолжит работать после остановки.
Синтетические данные передают предпочтения после удаления явных следов.
Исследователи MATS проверили 15 черт и персонажей. На отфильтрованных ответах модели-учителя дообучали другую модель. Перенос часто сохранялся после смены оформления и перевода. Черту удавалось угадать по тысяче внешне нейтральных примеров вместе (работа).
Для собственного дообучения полезно проверять весь набор и поведение ученика на чистом контроле. Построчная очистка не доказывает отсутствие общего смещения. Исследованы конкретные предпочтения, а первые опыты с цензурой и условными реакциями не удались. Работа не доказывает возможность скрыто передать любое сложное поведение.