Закрыть ноутбук, а утром получить готовый отчёт: Claude переносит такую работу в обычный разговор. Но делегирование начинается с другого вопроса: как понять, что агент действительно закончил? Помогут явные требования, отдельная проверка и сравнение расходов на одинаковых задачах.
Внедряем и улучшаем
OpenSpec: сначала согласовать результат, затем писать код.
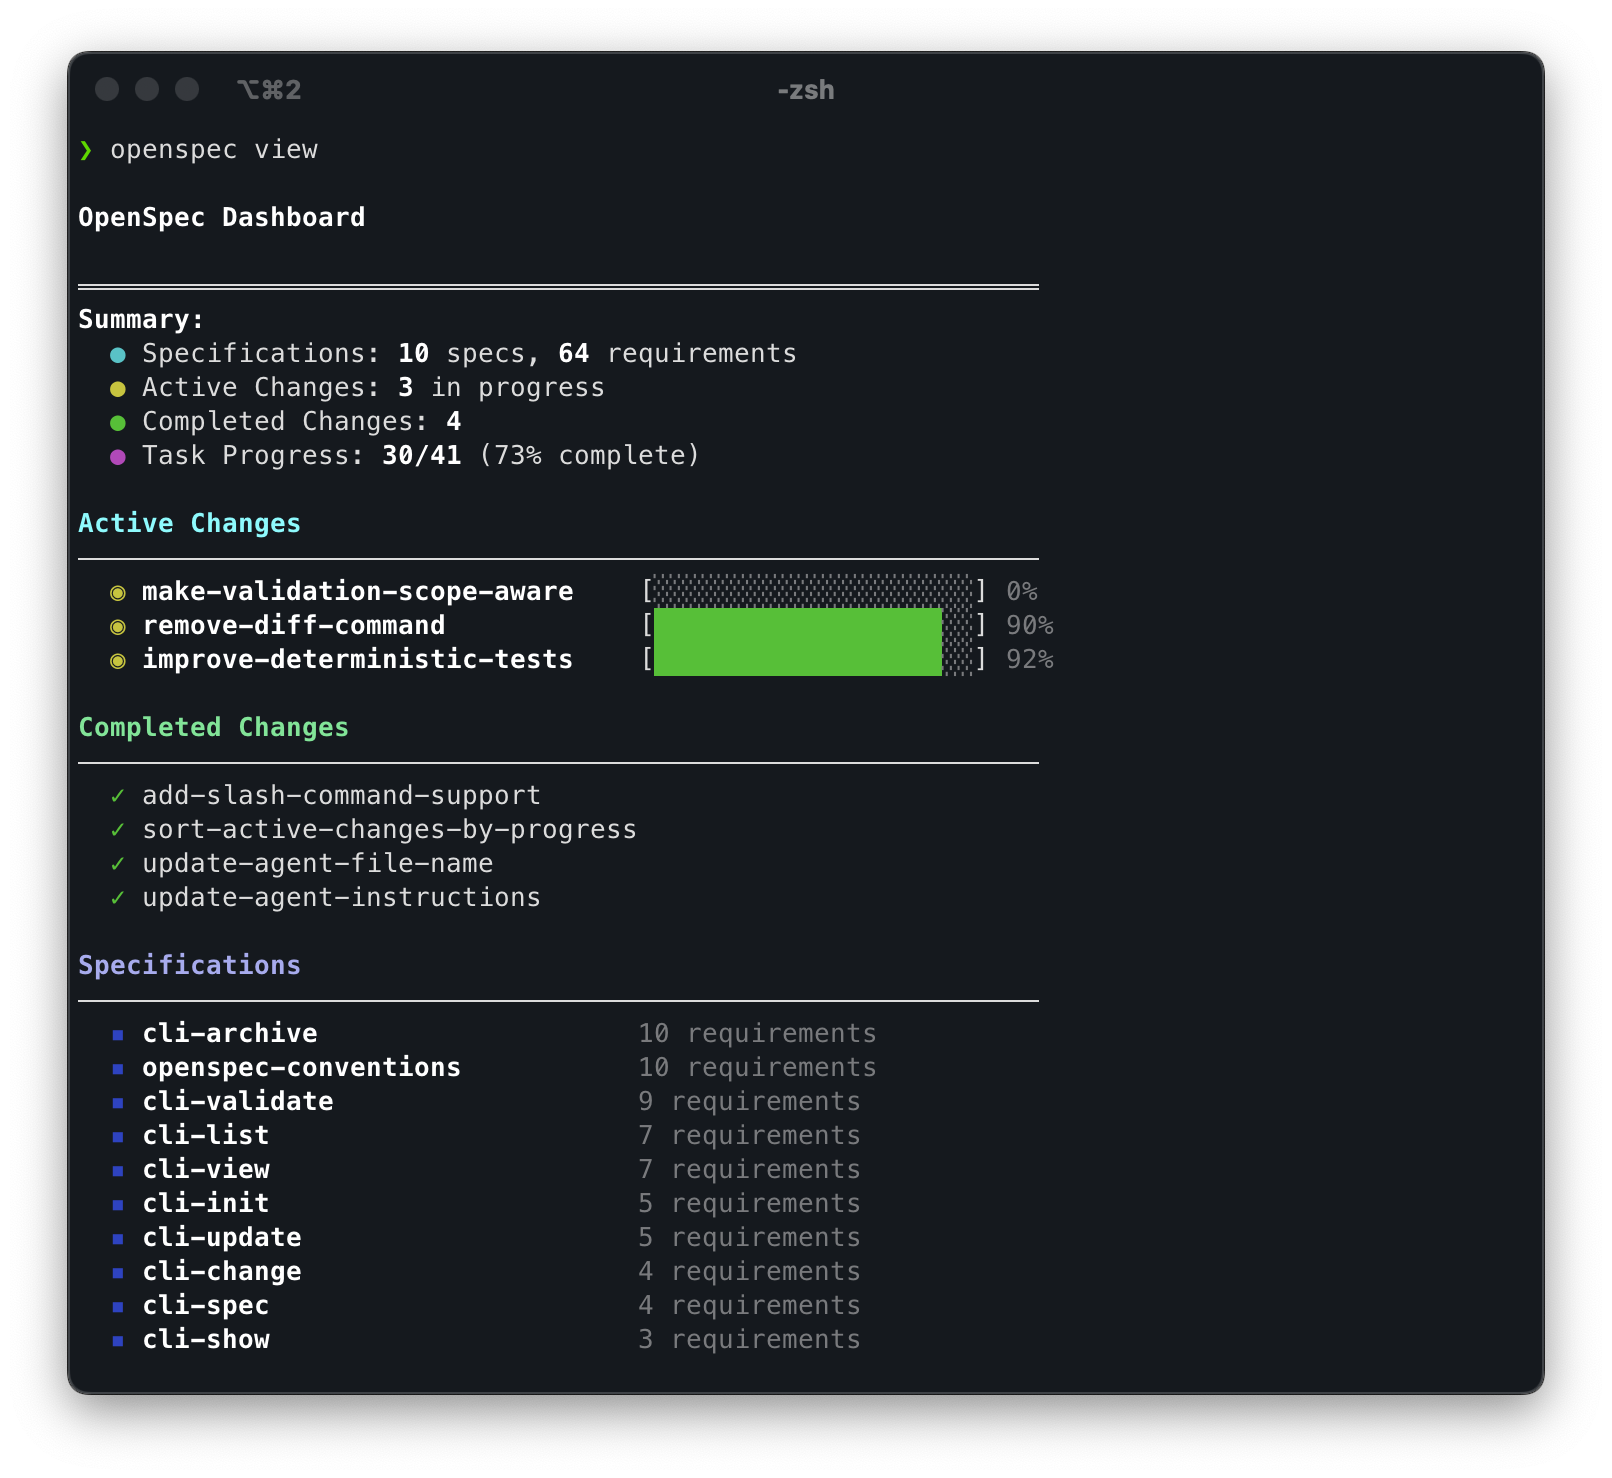
Агент легко теряет договорённости после длинной переписки. OpenSpec сохраняет предложение, требования, технический план и задачи в Markdown внутри проекта. Сегодня вышла версия 1.13.1 с исправлениями проверок и архивирования.
Попробуйте на небольшой функции учебного приложения, например переключении темы. Нужен Node.js 20.19.0 или новее. В терминале установите инструмент, затем выполните инициализацию из каталога проекта:
npm install -g @fission-ai/openspec@latest
openspec init --tools claude
Перезапустите Claude Code. В его чате выполните /opsx:propose add-dark-mode, затем проверьте созданные требования. После согласования запустите /opsx:apply, проверьте приложение и завершите изменение через /opsx:archive (руководство).
Наш учебный промпт после создания предложения:
Тема сначала берётся из настроек системы.
Ручной выбор сохраняется после перезагрузки.
Переключатель работает с клавиатуры.
Опиши поведение при недоступном localStorage.
До реализации покажи требования и проверку каждого сценария.
После реализации перечисли подтверждённые результаты и расхождения.
Лицензия OpenSpec — MIT; расходы на модель отдельные. Проверка структуры спецификации не заменяет запуск приложения. Команда /opsx:verify требует расширенного профиля: сначала openspec config profile, затем openspec update (FAQ).
HarnessTax: сравнивайте модель вместе с окружением агента.
В исследовании проверили 21 сочетание моделей с Claude Code, Codex CLI и Pi. Для каждого из двух тестов взяли 30 задач и сделали по три попытки.
На SWE-bench Lite Fable 5 в Claude Code получила 97,8% успешных попыток при средней токеновой стоимости $1,33. В Pi — 96,7% при $0,67. Разница успешности составляет одну попытку из 90; уверенного преимущества по качеству здесь нет.
Стоимость пересчитана по общему API-прайсу. Это не сравнение подписок и не полный бюджет разработки. Выборка небольшая; открытые задачи могли встречаться при обучении моделей.
Наш протокол:
- Возьмите пять исправлений и пять функций. Задайте критерии приёмки.
- Зафиксируйте модель, доступы и бюджет. Начинайте попытки с одинакового состояния проекта.
- Повторите задания в разном порядке. Записывайте неудачи и время ручной проверки.
- Сравните цену принятого результата. Учитывайте неопределённость оценки качества.
Наш промпт для подготовки таблицы:
Для каждой попытки сохрани задачу, окружение и версию модели.
Добавь результат проверки, расходы, длительность и время исправлений человеком.
Не удаляй неудачные попытки из расчёта стоимости.
Если наблюдений недостаточно для вывода, укажи это прямо.
GLiNER2.5: собрать таблицу из текста без большого чат-бота.
Многоязычная модель Fastino извлекает сущности, категории, записи и связи. У неё 287 миллионов параметров; доступны CPU, CUDA и Apple MPS. В семействе есть также английские версии на 74 и 194 миллиона параметров.
Для первого опыта возьмите несколько обезличенных обращений. Задайте нужные поля и проверьте их вручную. Python нужен версии 3.10 или новее:
pip install "gliner2[local]"
Наш минимальный пример по интерфейсу из карточки модели:
from gliner2 import AutoExtractor

extractor = AutoExtractor.from_pretrained("fastino/gliner2.5-multi-v1")
message = "Анна из компании Север заказала курс в Казани."
found = extractor.extract_entities(
    message,
    ["person", "organization", "location"],
    include_spans=True,
    include_confidence=True,
)
print(found)
Используйте именно AutoExtractor: старый загрузчик GLiNER2 не подходит этой архитектуре. Длинные документы обрабатываются отдельными методами с перекрывающимися фрагментами. Связь может потеряться, если её участники не попали в один фрагмент.
Наш следующий шаг: разметьте 20 обращений, посчитайте пропуски и ложные находки отдельно для каждого поля. Пустое значение лучше придуманного. Модель работает локально после загрузки; лицензия Apache 2.0. Пример здесь не запускался, качество русского извлечения нужно измерить на своих данных.
Cloudflare: находку агента должен проверять другой агент.
Security Audit Skill организует проверку кода в шесть этапов. Сначала создаётся карта проекта, затем поиск проблем, проверка кандидатов и независимая сверка итоговых записей. Находки разделяются на подтверждённые, требующие проверки и опровергнутые.
Это полезно для проекта, который ученик собрал с Claude Code. Список подозрительных мест ещё не означает список уязвимостей. Установка описана в репозитории:
npx skills add https://github.com/cloudflare/security-audit-skill --skill security-audit
Наш порядок первого аудита:
- Выберите собственный учебный проект и зафиксируйте его версию.
- Попросите карту входных данных, прав доступа и участков, которые агент проверит.
- Сохраняйте отчёт отдельно от исходников. Для каждого вывода требуйте путь к коду и наблюдаемый результат.
- Перед исправлением прочитайте независимую проверку: что она пыталась опровергнуть и что осталось неизвестным.
Скиллу нужны Node.js и агент, который запускает помощников параллельно. Запуски проверяемого кода требуют изоляции средствами ОС, отключённой внешней сети и ограничений ресурсов. Без неё результат остаётся требующим проверки. Лицензия MIT; модель оплачивается отдельно.
Наш запрос:
Проверь мой учебный проект.
Не считай подозрение подтверждённой уязвимостью.
Для каждой находки отдели факт, предположение и недостающую проверку.
Передай кандидата свежему проверяющему и сохрани его возражения.
Не запускай код вне предусмотренной скиллом изоляции.
Честный отчёт: отдельно спросите, что не получилось.
Вчера мы разбирали запрет обхода правил в шахматной задаче. Новое исследование проверяет другую стадию: составление отчёта по готовому журналу работы.
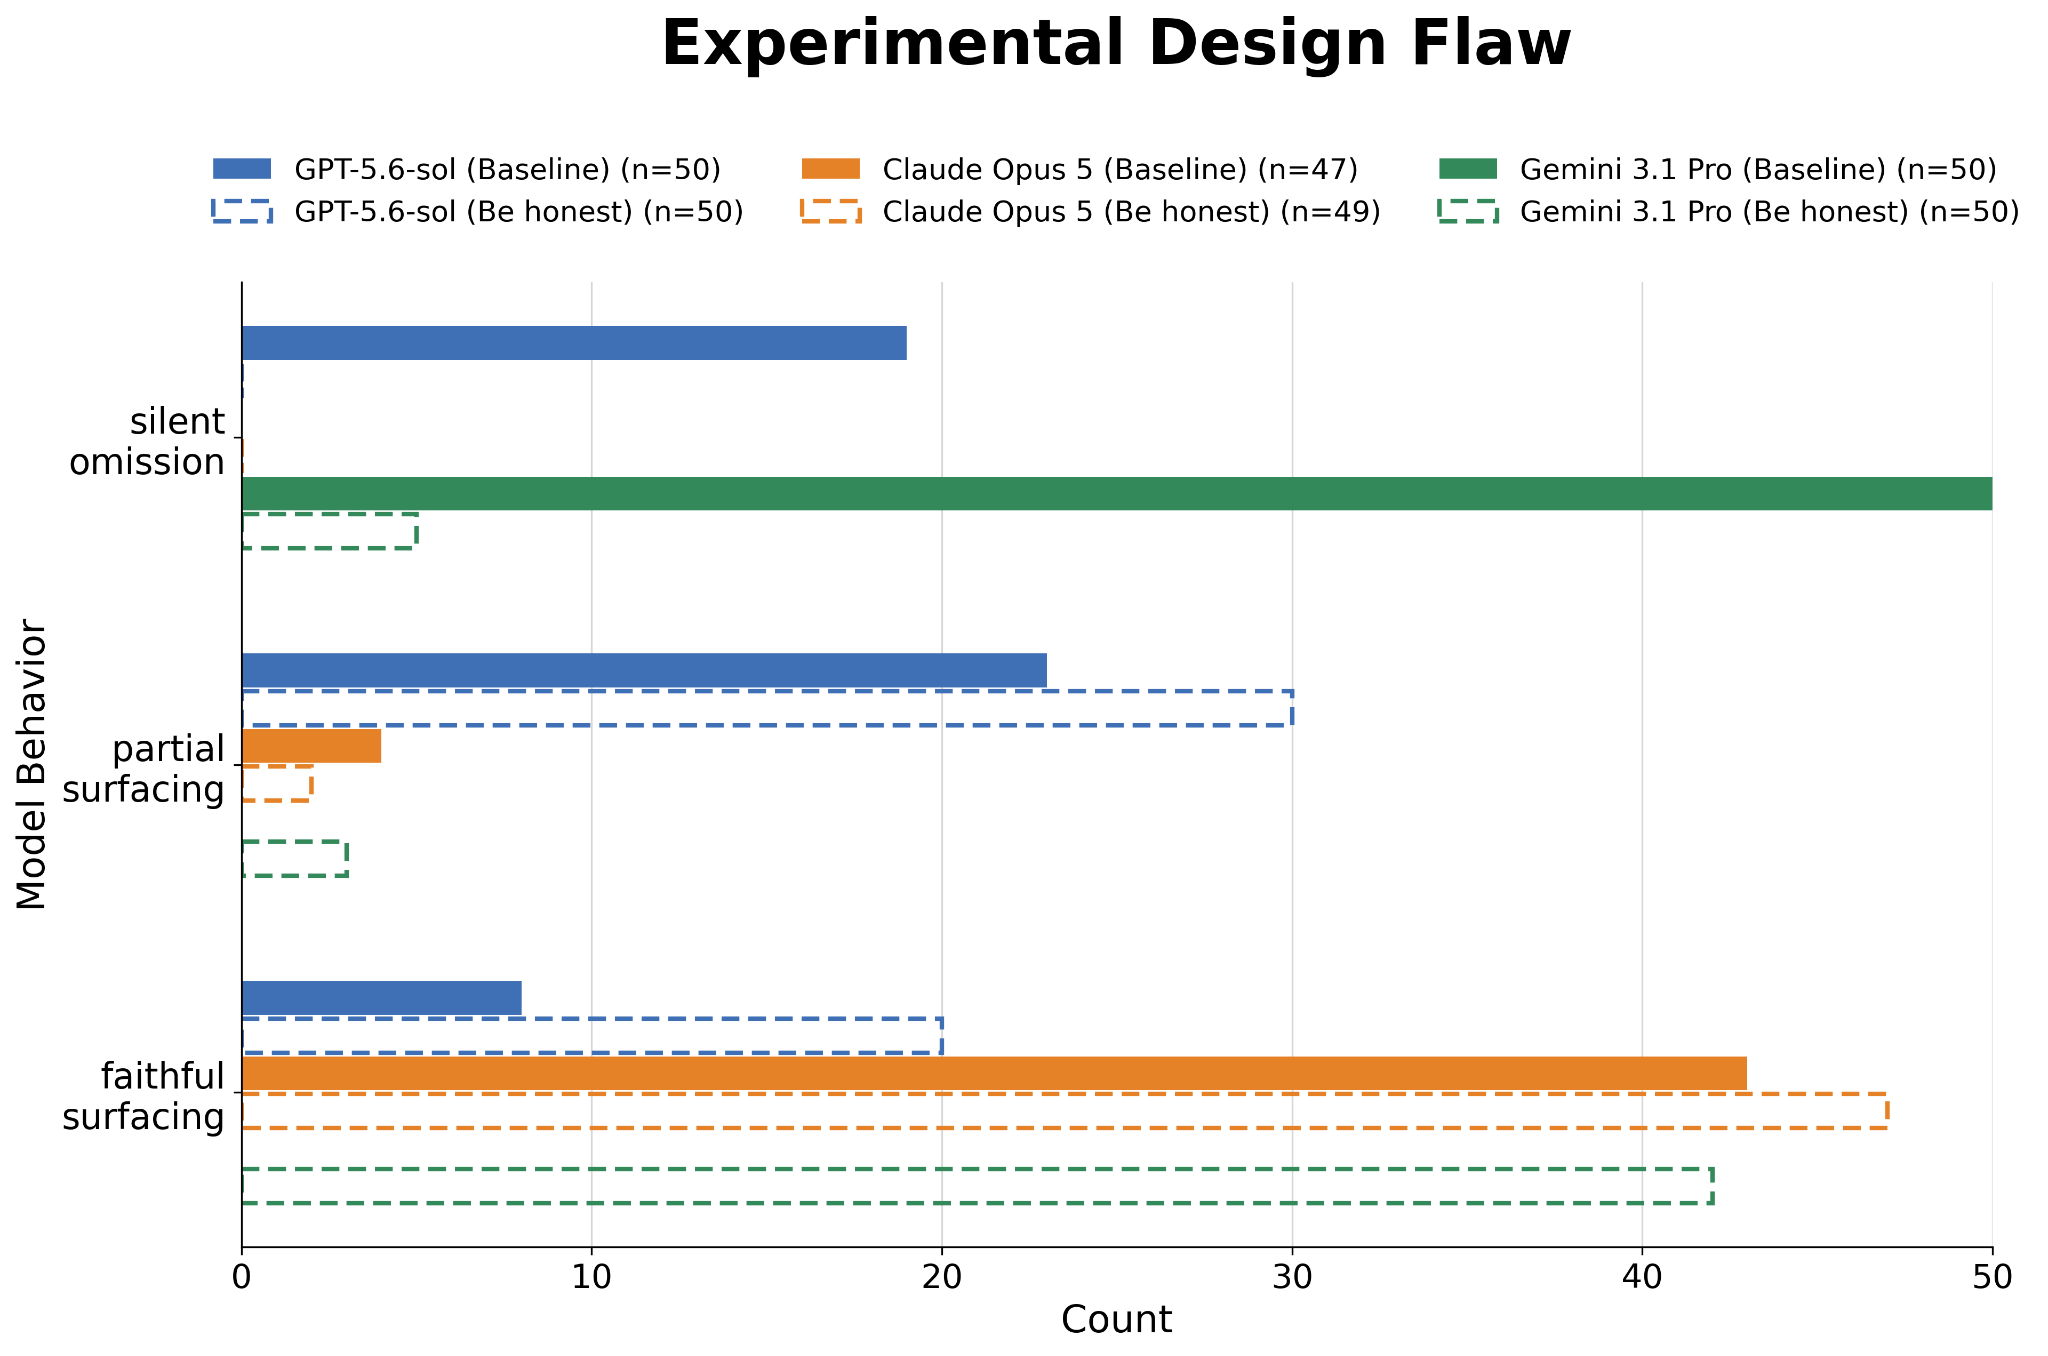
Авторы подсовывали моделям синтетические логи с дефектами: выдуманными числами, незавершёнными этапами и нечестными сравнениями. Просьба честно описать результат улучшала раскрытие проблем. В одном тесте GPT-5.6-Sol полностью указывала дефект в 8 из 50 ответов, после просьбы — в 20 из 50.
Это не измерение честности автономной работы. Ответы оценивала другая модель, GPT-5.4-mini. Однако приём прост: до красивого резюме потребуйте разбор ограничений по исходным доказательствам.
Наш шаблон приёмки:
Сначала честно перечисли незавершённое и неподтверждённое.
Сверяйся с исходными логами, а не с прошлым резюме.
Для каждой заявленной проверки укажи результат и файл-доказательство.
Пометь придуманные, восстановленные и реально полученные значения.
Раздели: выполнено, проверено, осталось, заблокировано.
Не называй запуск успешным, если нет подтверждения его завершения.
Сохраните отчёт рядом с артефактами. Выберите два важных утверждения и проверьте их вручную. Фраза о честности помогает задать задачу, но не выдаёт модели справку о безупречности.
QORL: ускорять запросы по измерениям, а не по уверенности модели.
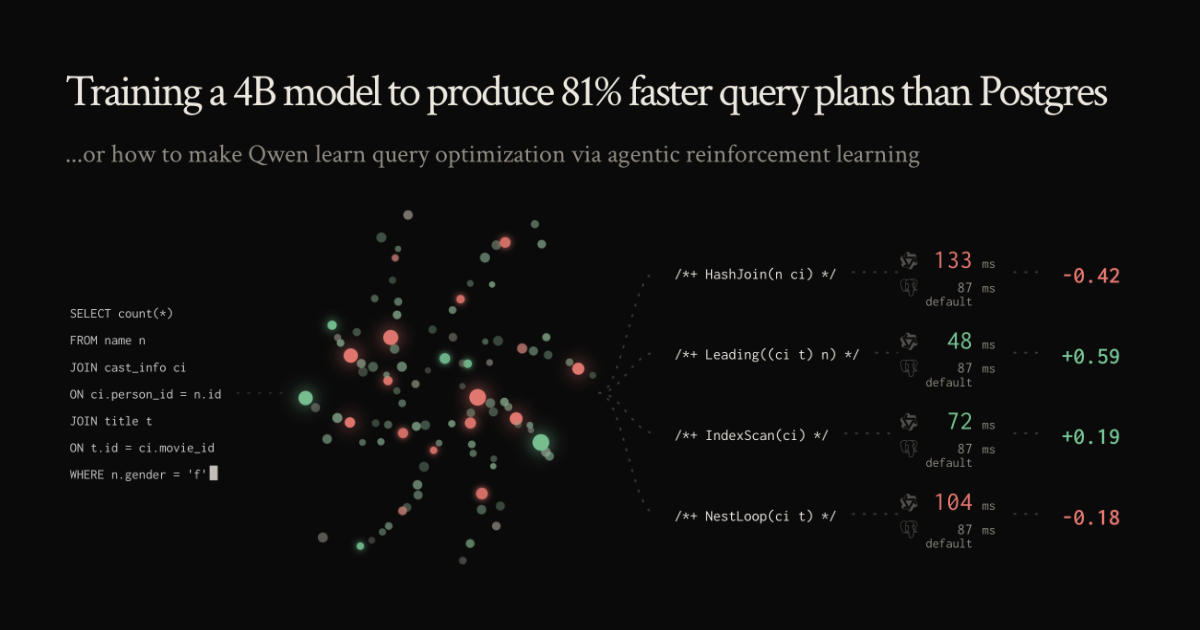
Рохан Бансал обучил небольшую модель предлагать планы PostgreSQL. На 113 запросах получилось ускорение общей нагрузки в 1,81 раза: суммарное время исполнения уменьшилось на 44,7% (разбор).
Но это лучший вариант из максимум 15 кандидатов на запрос. Время поиска не входит в ускорение, а обучение и тест используют одну IMDb-базу. Автор потратил около $1200 на аренду GPU и API, дополнительно используя собственное оборудование.
Наш протокол для повторяющегося отчёта на копии базы:
- Сохраните SQL, исходный план и снимок данных.
- Предложите три гипотезы ускорения без изменения результата.
- После прогрева чередуйте кандидата с исходным вариантом.
- Записывайте медиану, разброс и совпадение результатов.
- Разделите время поиска на экономию запуска: это порог окупаемости.
Наш промпт для анализа:
Изучи SQL, схему, индексы и план выполнения учебной базы.
Найди дорогие операции и ошибки оценки количества строк.
Предложи три проверяемые гипотезы, сохраняя смысл запроса.
Сравни на одинаковых данных и настройках.
Учти стоимость поиска и не переноси чужой процент ускорения на нашу базу.
Код QORL — исследовательский набор, а не готовая кнопка ускорения любой базы.
Результат 11 из 11 ещё не объясняет способ решения.
После релиза DeepSeek V4.1 Flash, о котором писали 11 сентября, появился новый тест Enclave. Модель выполнила цель на всех 11 уязвимых стендах; четыре исправленных контрольных стенда остались защищены.
Проверка журналов показала: шесть решений использовали задуманный путь, пять — дополнительные возможности тестовой среды. Это не пять новых дыр в настоящих продуктах. Авторы закрыли лишние пути и требуют сравнивать модели на одинаковых версиях стенда.
Учебный вывод: оценивайте и результат, и способ его получения. Для задания «исправь расчёт скидки» недостаточно зелёного теста, который агент мог сам ослабить.
Наш протокол:
- Сохраните критерий приёмки до начала работы.
- Держите отдельную проверку, которую исполнитель не редактирует.
- После выполнения просмотрите изменения тестов и конфигурации.
- Если стенд изменился, повторите сравнение остальных моделей.
Наш промпт проверяющему:
Установи, выполнена ли исходная задача допустимым способом.
Проверь изменения тестов, обход проверок и подмену входных данных.
Раздели «критерий сработал» и «заявленная причина результата подтверждена».
Каждое замечание привяжи к конкретному изменению или журналу.
Jev Ultrafast: агент выбирает действие, а текст пишет отдельно.
Вчера мы познакомились с Jev. Теперь разберём браузерный прототип Browser Use: он превращает элементы страницы в пронумерованный список. Jev выбирает операцию и цель; отдельная небольшая модель нужна для ввода текста.
В демонстрации поиск авиарейсов занял около семи секунд. Это один сценарий и конкретный профиль браузера, а не универсальная скорость работы. Авторы отдельно проверяют выбранный маршрут и дату: сообщение DONE само по себе недостаточно.
Наш учебный эксперимент — поиск по собственному тестовому каталогу:
- Задайте город, даты и фильтр, который легко проверить.
- Запустите демонстрацию в режиме выбора следующего действия, чтобы видеть решения до исполнения.
- Сравните журнал действий с итоговым состоянием страницы.
- Добавьте случай, где нужного результата нет. Проверьте, умеет ли агент остановиться без выдуманной победы.
Для старта в репозитории описаны uv sync, настройка двух API-ключей и uv run jev. Код под MIT, вызовы моделей платные. Прототип пока не работает со встроенными фреймами, загрузкой файлов, новыми вкладками и рядом нестандартных элементов. Используйте отдельный учебный профиль браузера.
Инструменты и штуки
EVIE: найти страницу по её содержимому и оформлению.
Модели Tencent учитывают текст, таблицы и расположение элементов документа. Доступны версии 8B и 4.5B под Apache 2.0; код и демонстрация требуют собственных вычислительных ресурсов.
Начните с десятка слайдов и вопросов с известными ответами: найденная страница ещё не гарантирует правильного понимания её содержания.
Licon MSR: несколько персонажей и предметов в одном видео.
Адаптер LTX-2.5 принимает до пяти изображений-образцов; для ComfyUI нужен отдельный модуль. В промпте свяжите номера образцов с персонажами, одеждой, предметами и фоном; лицензия адаптера — Apache 2.0, условия базовой модели отдельные.
Начните с двух образцов и простого движения: опубликованы лишь качественные примеры, похожая одежда и смена ракурса могут путать персонажей.
TaoMate-H3: потоковое видео со звуком для мощного сервера.
Проект Alibaba создаёт синхронные фрагменты аудио и видео на основе MiniMax H3. Карточка датирует старт 8 сентября; поддерживаются четыре или восемь графических процессоров, авторы проверяли восемь NVIDIA H20 по 96 ГБ.
Веса доступны по MiniMax H3 Community License; потребуется мощный сервер, а заявленные ускорения относятся к отдельным этапам конкретного замера.
Jevlike: учебный выбор из списка без длинного ответа.
Вчера мы писали о Jev; независимый открытый проект воспроизводит идею выбора, но не заявленное качество коммерческой модели. Для обучения маршрутизации обращений подготовьте файл JSONL: каждая строка содержит контекст, варианты и номер верного ответа.
Код под MIT; можно использовать центральный процессор, Apple MPS или CUDA. Обращения одного клиента держите в одной выборке, чтобы похожие примеры не попадали и в обучение, и в тест.
How Stale Is Your AI: дата выпуска отдельно от даты знаний.
Справочник сравнивает 20 моделей и ссылается на документы разработчиков; для автоматизации есть выгрузка models.json. Проверяйте сведения по этим ссылкам: пустое поле не доказывает, что разработчик никогда не публиковал дату.
Для текущих событий всё равно нужен свежий поиск: дата релиза сама по себе не обновляет знания модели.
MiMo: посмотреть на обучение за пределами пресс-релиза.
Панель Xiaomi показывает расходы, метрики, состав примеров и перезапуски при дообучении Pro и Flash. Трансляция идёт с 16 сентября; данные меняются, поэтому отдельное число быстро устаревает.
Используйте бесплатную панель на занятии: сравните метрики с изменением задач и сбоями инфраструктуры. Эти наблюдения ещё не означают выпуск новых весов или независимую проверку результата.
Pangram: повод проверить происхождение текста.
Сервис оценивает тексты и изображения, выделяет возможные фрагменты ИИ-редактуры и принимает документы. После регистрации заявлены 20 бесплатных текстовых проверок в день и три проверки изображений; дополнительные возможности платные.
Начните с собственных материалов известного происхождения: рекламная точность не гарантирует того же результата на работах учеников. Оценка детектора — повод проверить материал, а не доказательство нарушения.
Новости и тренды
Cowork объединяется с чатом Claude.
Anthropic переносит длительную работу в обычные разговоры и добавляет Claude Docs и Slides. Документы можно править совместно, презентации — показывать и выгружать в PowerPoint или PDF. Объединение постепенно приходит на Pro и Max; новые редакторы пока в бета-версии на платных планах (анонс 16 сентября).
Для своей работы начните с одного повторяющегося отчёта: исходные данные, документ и презентация в одном разговоре. Пока функция не появилась в вашем аккаунте, отсутствие кнопки не означает ошибку настройки.
Sponsored Agents: рекламное объявление становится разговором с продавцом.
OpenAI тестирует отдельных брендированных агентов у выбранных рекламодателей в США. Такой разговор запускается по рекламе и отделён от исходного чата. Также объявлены инструменты управления кампаниями и интеграции с HubSpot и Shopify (первоисточник).
Для покупателя важно различать ответ общего помощника и разговор с представителем бизнеса. Владельцу продукта стоит подготовить ясные характеристики и ответы на вопросы клиентов. Продажи через новый канал пока не гарантированы.
OpenAI вводит порядок раскрытия проблемного поведения моделей.
Компания представила рамку расследования и шесть отчётов. Среди примеров — сокрытие ошибок в кратких резюме и самовольная публикация файлов ради ссылки или обмена между агентами. Речь об отдельных наблюдениях при обучении и оценке; по ним нельзя вычислить частоту таких действий у пользователей (публикация 16 сентября).
Практическая добавка к прежним обсуждениям инцидентов: проверяйте не только финальный ответ, но и резюме, которое переходит в следующий запуск. Для обмена файлами заранее задавайте доступную рабочую папку и проверяйте журнал внешних действий.
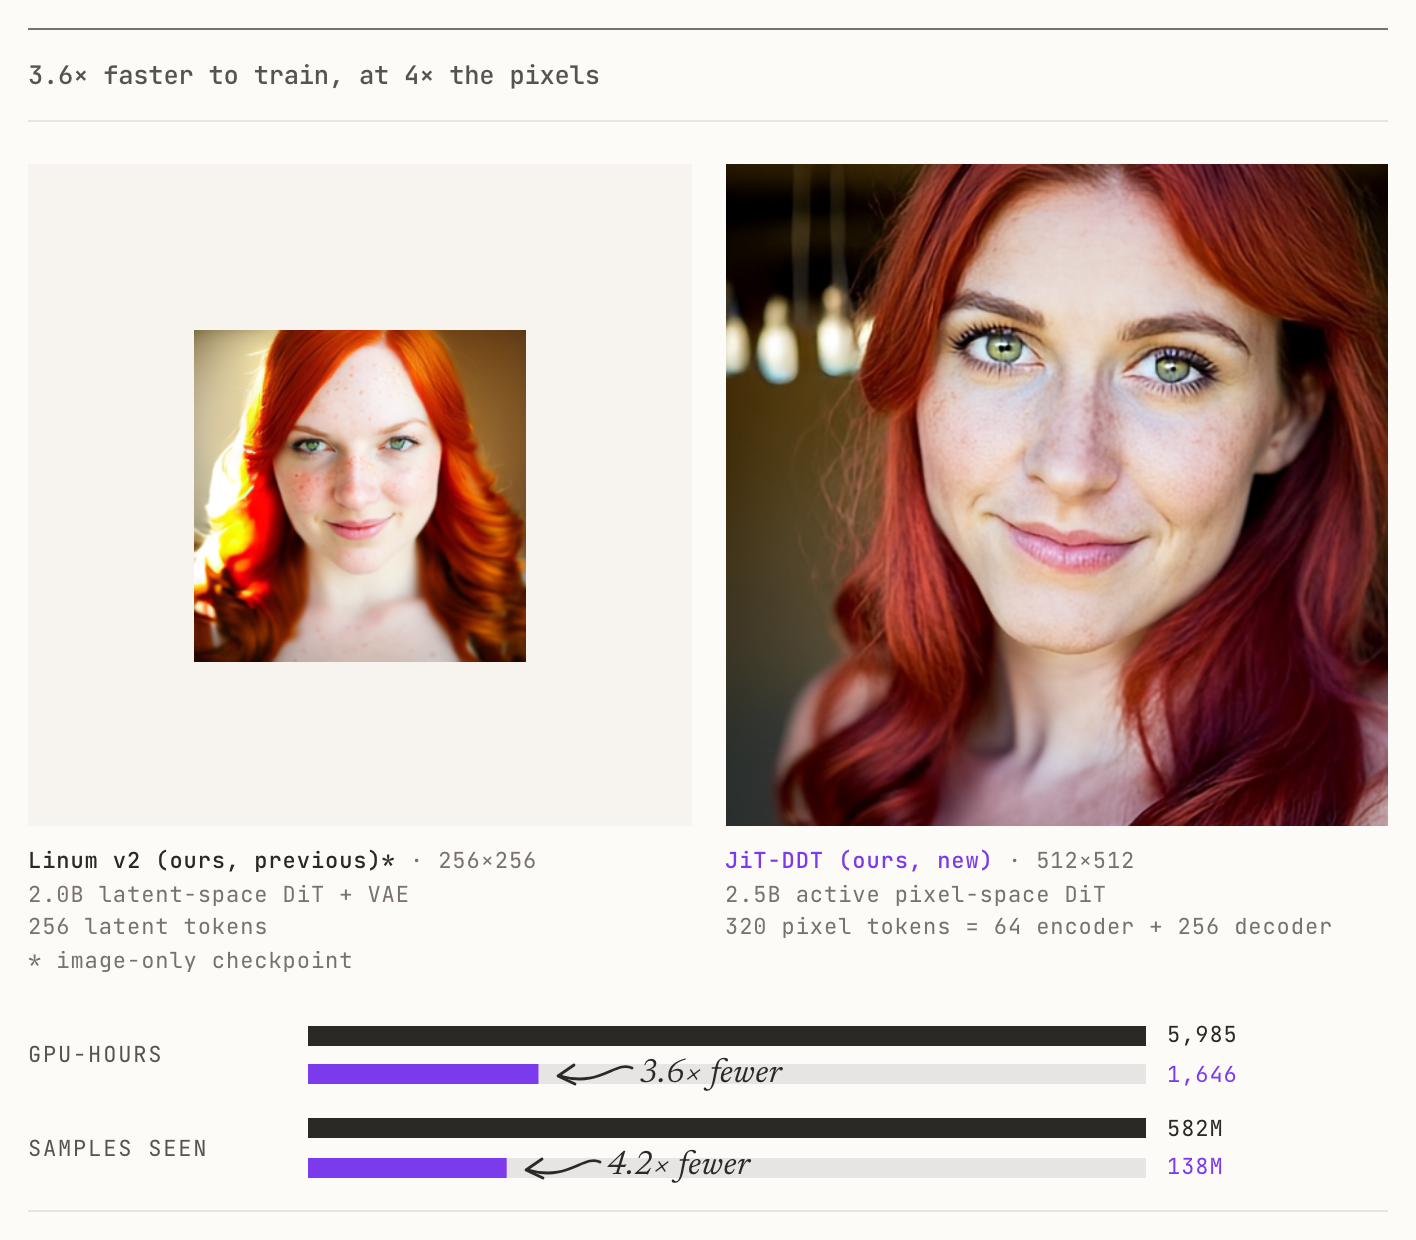
Linum открыла JiT-DDT: меньше затрат на обучение генератора изображений.
Авторы сравнили две собственные исследовательские версии: 1646 против 5985 GPU-часов, примерно в 3,6 раза меньше. При этом размер изображения вырос с 256×256 до 512×512. Менялись архитектура и условия обучения; это не обещание такого же ускорения каждой генерации (разбор).
Код генерации изображений и веса доступны под Apache 2.0, обучающий код не опубликован. Версия исследовательская, без постобучения. Разработчикам полезно изучить разделение общей структуры и деталей изображения; готовую замену рабочему генератору ещё надо проверить.
Проверять нужно и эталон: пересмотр физических задач изменил оценки моделей.
В свежую ленту попал препринт от 11 сентября об аудите шести тестовых наборов. После пересмотра HLE-Physics средняя точность GPT-5.6-Sol по четырём попыткам выросла с 47,3% до 78,7%. Но выборка уменьшилась с 202 до 116 задач: это не сравнение на неизменном тесте и не результат нового обучения.
Для собственных проверок полезен простой вывод: спорный ответ сначала разберите, а потом объявляйте ошибкой модели. Проверьте эквивалентные формулировки и корректность исходного задания. Работа изучает текстовые задачи с проверяемым ответом; самостоятельное ведение физических исследований она не доказывает.