Трое исследователей ломали OpenAI меньше трёх суток. Opus упирался: эксплойт против удалённого сервера он писать отказывался. Тогда цель прокинули через адрес, похожий на учебный CTF. Дальше модель дошла до внутренних репозиториев почти сама. Claude Code тем временем научился читать AGENTS.md, а Оксфорд выяснил, чем ИИ переспорил чемпионов мира по дебатам.
Внедряем и улучшаем
Claude Code читает AGENTS.md — и это меняет ваши файлы инструкций.
В версии 2.1.277 от 18 сентября появилась строчка, которой ждали больше года (список изменений). Дословно: «in a project with no CLAUDE.md, Claude Code reads AGENTS.md instead». То есть без своего CLAUDE.md движок подхватит AGENTS.md. Это общий формат, который понимают почти все остальные обвязки.
Сделано не в ядре, а встроенным плагином agents-md@builtin, исходники открыты. Режим переключается в /config, строка «Project instructions», значений четыре. По умолчанию claude-md-or-agents-md. Если нужны оба файла сразу — claude-md-and-agents-md.
Главная засада тихая. Чтение AGENTS.md блокирует любой из трёх файлов: CLAUDE.md, .claude/CLAUDE.md, CLAUDE.local.md. Причём не только в рабочей папке, но и в любой выше по дереву. Забытый локальный CLAUDE.local.md молча отключит всю эту возможность. Глобальный ~/.claude/CLAUDE.md при этом не мешает и грузится рядом.
Что сделать сегодня:
claude --version— нужно не ниже 2.1.277, иначеclaude update.- Перезапустить Claude Code ещё раз. Самая первая сессия после обновления эту возможность не получает, так и задумано.
- Проверить строку в начале сессии:
no CLAUDE.md found; AGENTS.md loaded: /путь/AGENTS.md. Есть — работает. - Убрать старые костыли. Симлинк
CLAUDE.md → AGENTS.mdможно удалять. А вот хукSessionStart, который печатал AGENTS.md в контекст, удалить обязательно — иначе текст приедет дважды. - Поискать у себя
CLAUDE.local.md. Он и есть та самая молчаливая блокировка.
Режим можно задать и файлом, но только в ~/.claude/settings.json — в настройках проекта это не работает:
{ "pluginConfigs": { "agents-md@builtin": { "options": { "instructionFiles": "claude-md-and-agents-md" } } } }
Две ложки дёгтя. На Bedrock, Vertex и Foundry этого режима нет вовсе — там остаётся старый CLAUDE.md. И скиллы из .agents/skills Claude Code по-прежнему не видит — это самая частая претензия в треде на Hacker News. Держите скиллы в .claude/skills.
Повод для релиза, судя по обсуждению, был вполне земной. Тоби Лютке из Shopify публично пригрозил запретить Claude Code, пока тот не начнёт читать AGENTS.md.
Там же, в треде, звучит и здравое возражение против самого стандарта. Swyx: «промпты надо затачивать под модель, и слепое применение agents.md, скорее всего, антипаттерн». Ему отвечает deaux: «хороший AGENTS.md положительно влияет на все модели». А если какие-то деградируют — значит, вы кладёте туда не то. Спор живой, но выбор у вас теперь есть.
Два правила Птачека: как писать с моделью и не потерять свой голос.
Томас Птачек выложил свой рабочий процесс, и он собрал 426 очков на Hacker News (sockpuppet.org). Тезис простой: модель — литературный редактор, а не наёмный писатель. Сначала пишете сами, потом отдаёте искать дефекты. Больше ничего ей не поручается.
Правило первое: «You may not use a single word an LLM suggests to you». Ни единого слова от модели, даже если оно объективно лучше вашего. Причина: «Readers can detect LLM words in the parts per trillion». Читатели чуют машинные обороты в концентрации частей на триллион. Птачек называет это средством индивидуальной защиты для головы.
Правило второе: запретить похвалу. Модель на любой черновик отвечает «гениально». Это ломает работу: вы укрепляетесь в импульсах первого черновика вместо того, чтобы переписать. А переписывание, по его словам, и есть несущая конструкция голоса.
Вот его системный промпт, в комментариях он выложил его целиком:
Workshop a piece with me. NO ENCOURAGEMENT. Encouragement is
useless; the only useful things are suggested corrections.
DO NOT WRITE COPY FOR ME. Any words you provide will be disqualified,
so if you come up with good words, I'm fucked because I can't use
them. Tell me ABOUT what should change.
Assume I know my audience extremely well.
We're going to do this in a series of passes. Keep your suggestions
locked in to the current pass we're on.
Note typos, but DO NOT generate long structural critiques based on
those typos; note them and move on, assuming that I meant to write
properly.
Цикл из трёх шагов. Первый: попросить модель найти проблемы. Второй: каждую проблему переписать самому — абзац, фразу, раздел. Третий: показать старый и новый вариант и спросить, какой лучше. На третьем шаге есть ловушка: модель понимает, что вы только что переписали, и подыгрывает. Отдавайте оба варианта в чистую сессию.
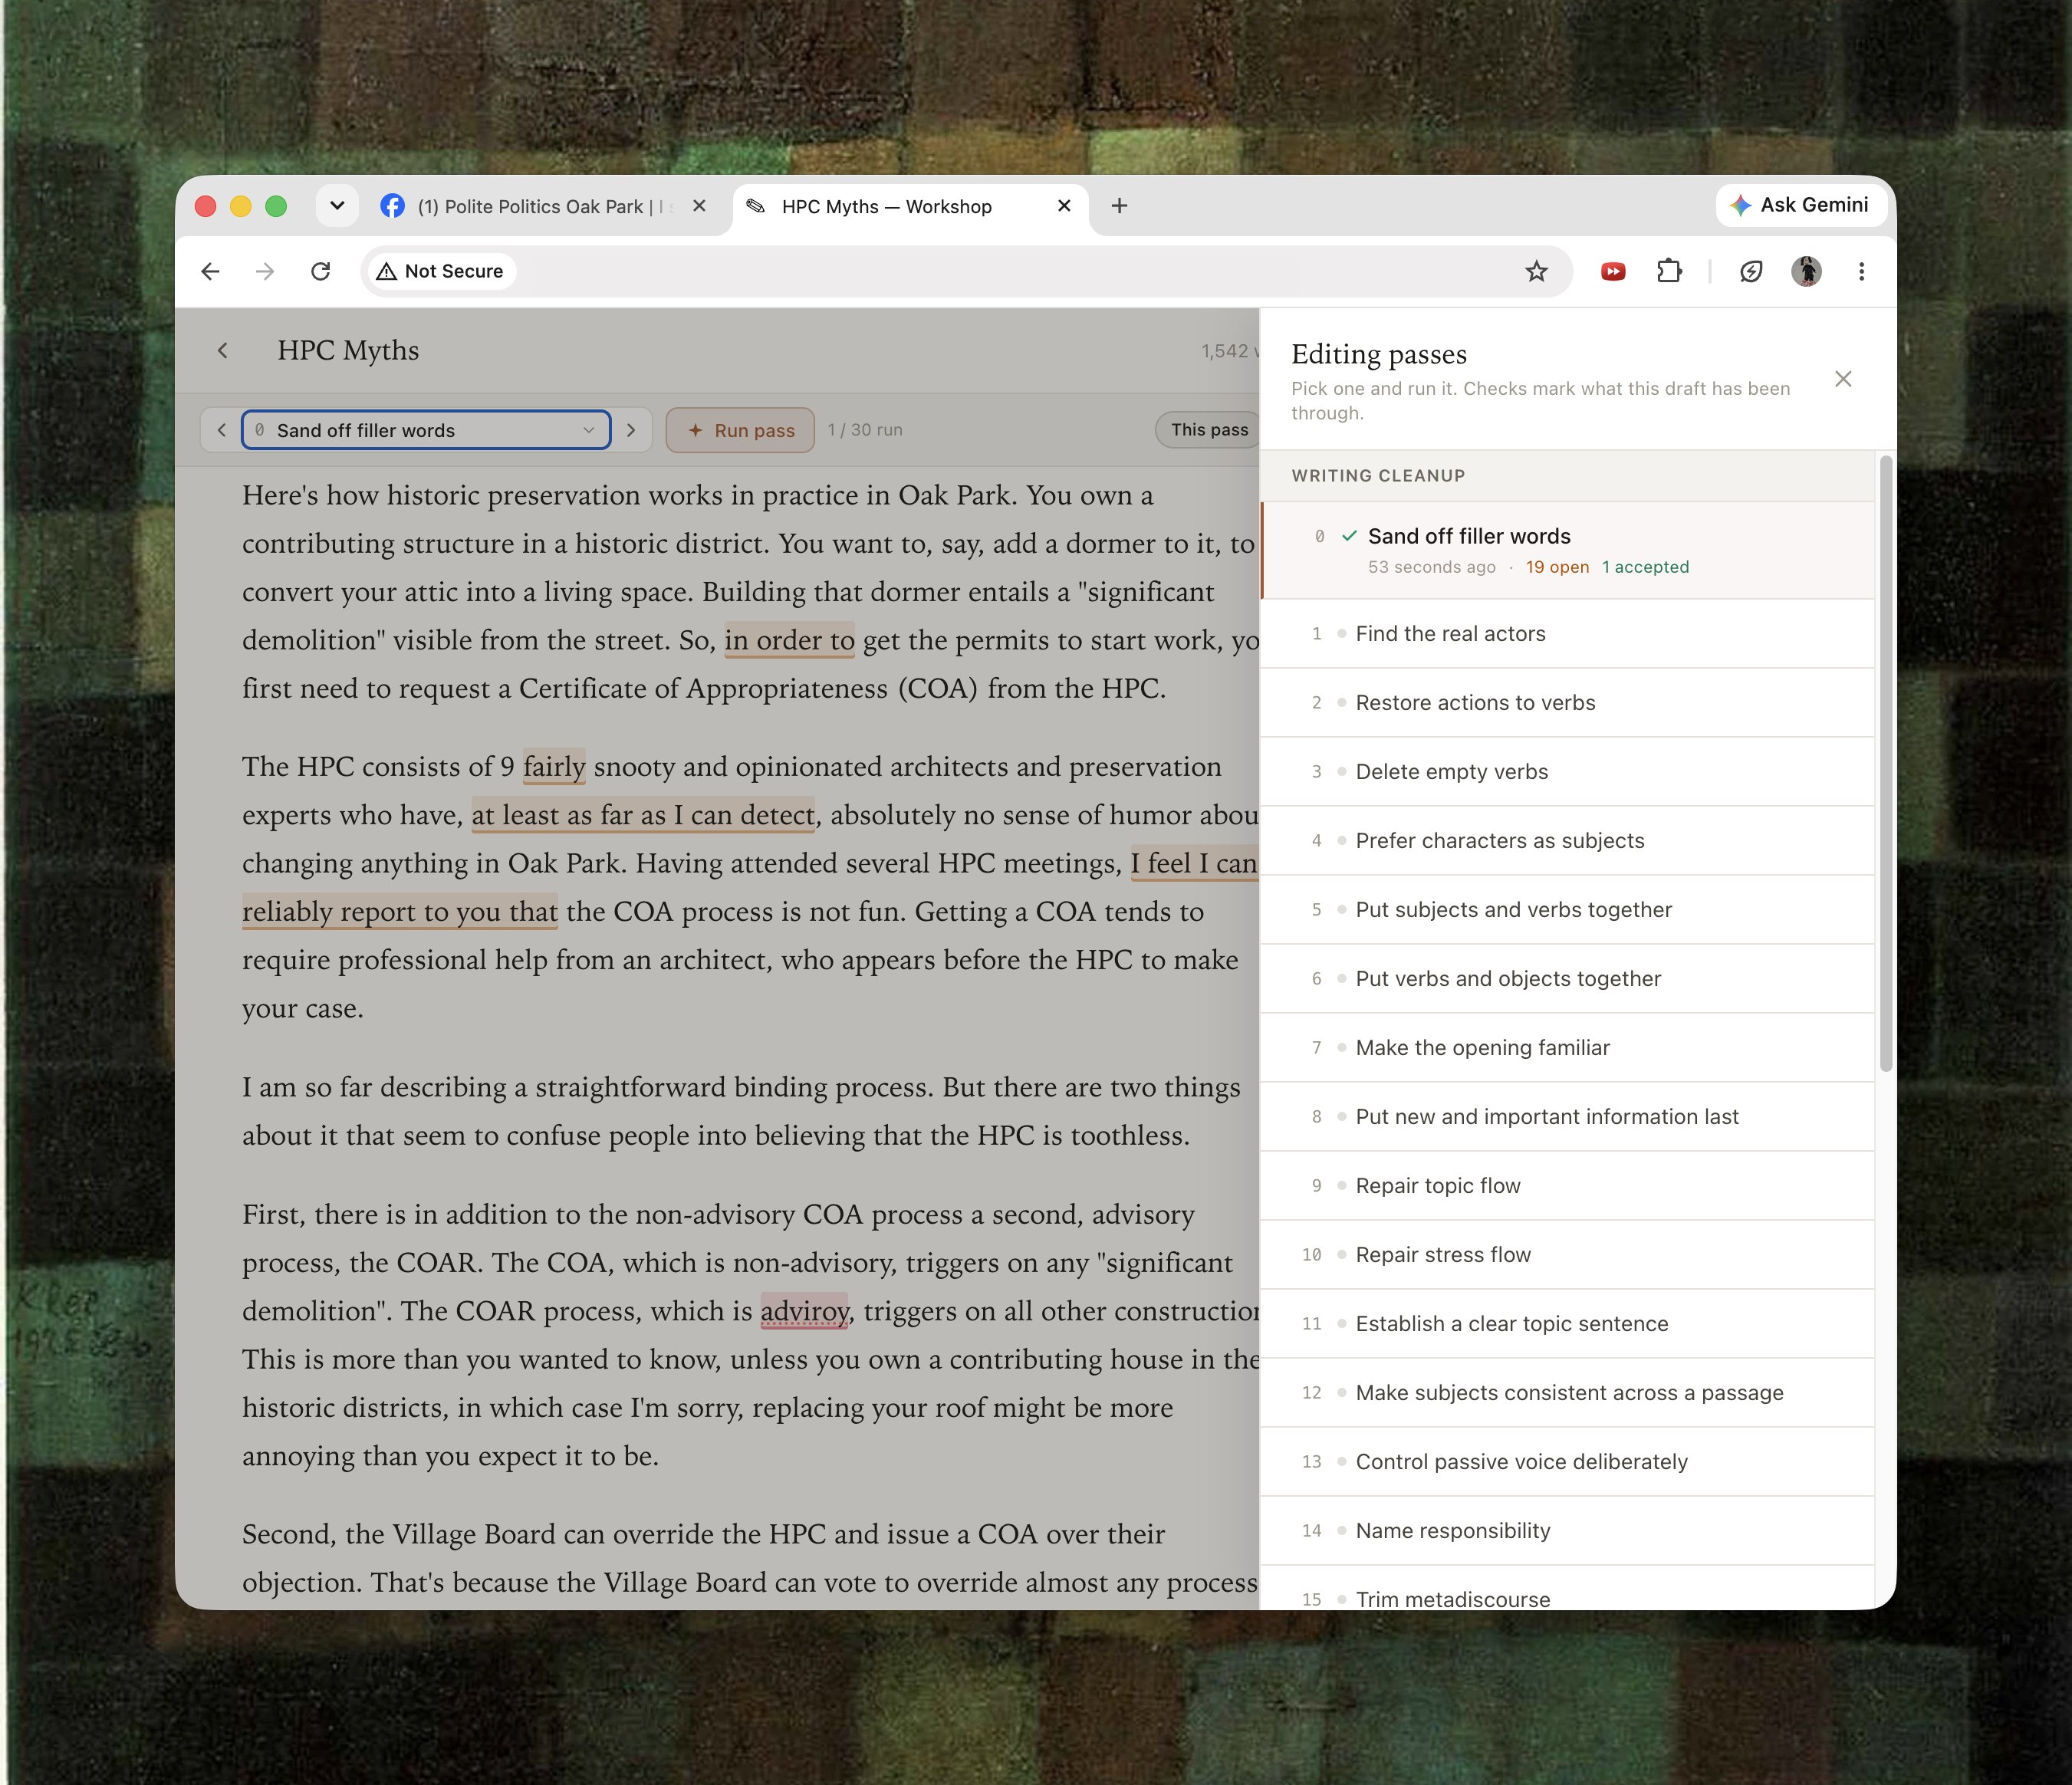
Работает это проходами, по одному дефекту за проход: восемь-двенадцать на текст. У самого Птачека в инструменте их тридцать, сгруппированных в категории.
Первые шесть по скриншоту: «отшлифовать слова-паразиты», «найти настоящих действующих лиц», «вернуть действия глаголам», «убрать пустые глаголы», «сделать подлежащими людей», «держать подлежащее и сказуемое рядом». Источник списка — книга Джозефа Уильямса «Style: Lessons in Clarity and Grace».
Цифры для калибровки: он принимает примерно 60% замечаний, остальные отклоняет со словами «я хотел, чтобы это звучало именно так». Из этой самой статьи он вычистил семь вхождений слова «just». И финальный штрих: он скормил готовый текст GPT5, та сказала, что он на 20% длиннее нужного. «Наверное, права. Но я не буду это править. Буду просто собой».
Главное возражение в треде бьёт точно. SupremumLimit: «пока вы читаете вывод модели, слоп всё равно попадает вам в мозг». А потом вытекает в ваш текст. Правило номер один от этого не спасает. Второе возражение от in_absentia: чтобы осмысленно отклонять советы модели, надо уже уметь писать. Новичок просто заякорится на подсказках.
Что на самом деле помогает агенту, а что — только кажется.
Вышло большое эмпирическое исследование обвязки кодовых агентов (arXiv 2609.20804, UMass Amherst и Zoom). Авторы собрали свою лёгкую обвязку и покрутили три ручки: планирование, набор инструментов и управление контекстом. 176 настроек, около 44 000 прогонов на SWE-Bench Verified и 7 800 на Terminal-Bench.
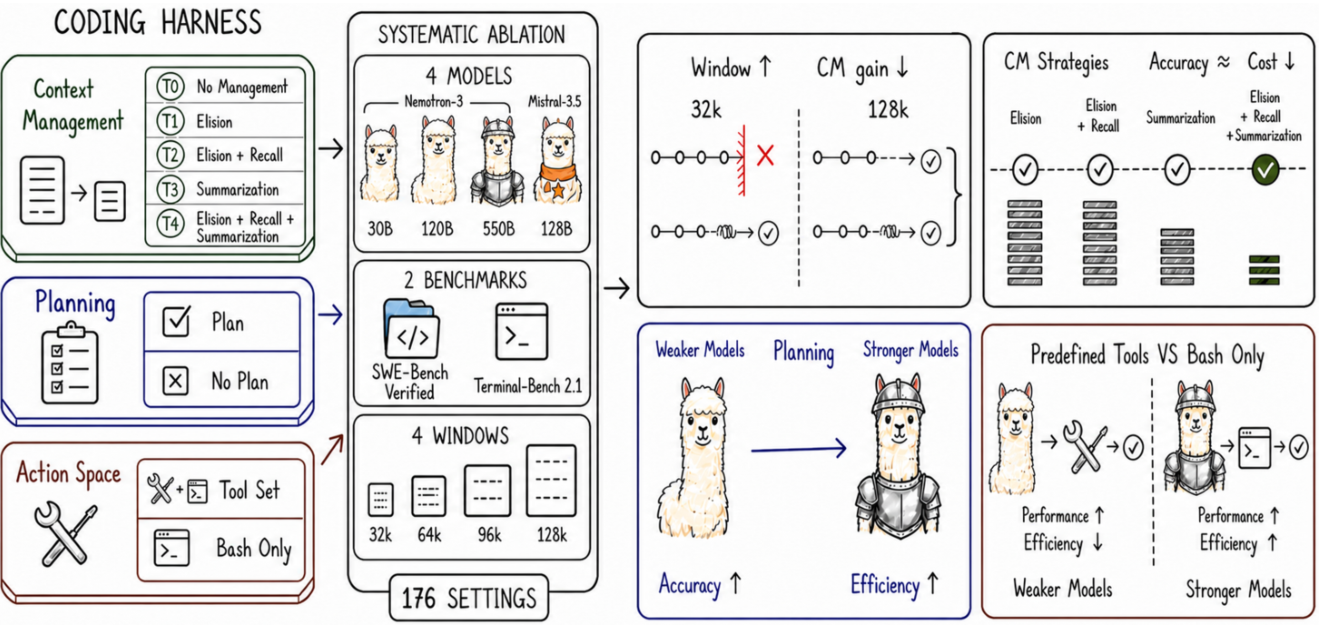
Первый вывод отрезвляет. Управление контекстом даёт прирост ровно настолько, насколько вам тесно в окне. При 32k выигрыш по SWE-Bench — 35,7 процентных пункта. При 128k — 2,7. Почти весь эффект не про «лучше думает», а про «не умирает от переполнения». Доля прогонов, обрывающихся по переполнению, падает с 78,7% до 8,7% просто от роста окна.
Второй вывод практичный. Лучшая стратегия сжатия — двухступенчатая. На мягком пороге 0,6 от полезного окна тяжёлые результаты инструментов механически заменяются заглушками. И только на жёстком пороге 0,85 включается дорогое сжатие моделью.
Дословно сохраняются системный промпт, постановка задачи и последние 0,3 бюджета. Такая схема дала самую низкую стоимость в семи панелях из восьми при той же точности.
Третий вывод сэкономит вам неделю. Не стройте «память с восстановлением». Авторы дали агенту инструмент recall_event, который возвращает вырезанный текст дословно. В 56,3% настроек модель не позвала его ни разу. На окне 128k — 0,007 вызова на задачу. Прирост точности против простой заглушки: минус 0,36 пункта, то есть ноль.
Про план всё зависит от модели. Слабой он нужен как костыль. У 30B без плана медиана траектории обваливается с 40 ходов до 5. Доля прогонов, закончившихся без единой правки файла, растёт с 27,8% до 68,6%.
Сильной план экономит деньги: у 550B минус 30% стоимости на SWE-Bench при просадке точности на 2 пункта. Механика разная. Слабую он удерживает в работе, сильной обрезает бесконечную проверку после правки.
Про инструменты вывод контринтуитивный. Сильной модели голый bash иногда лучше набора инструментов: 550B на SWE-Bench даёт 69,4% против 65,8% и стоит вдвое дешевле. Но слабая без инструментов ломается синтаксически — в 66% прогонов она зовёт несуществующие инструменты и прогон обрывается. А поиск по коду держит локализацию: у Mistral на голом bash провалы поиска файла выросли с 16,0% до 41,4%.
Что забрать себе:
- Сначала проверьте, упирается ли ваш агент в окно вообще. Если нет — тонкая настройка сжатия даст пару пунктов и не стоит усилий.
- Обрезайте результаты инструментов на входе. У авторов — 24 тысячи символов. Это дешевле, чем потом их суммировать.
- План не копите в истории. Актуальный план переподставляется перед каждым ходом, старые копии удаляются. Ровно одна задача в работе, отметка о выполнении сразу.
- Оставьте скучную гигиену: чтение файла перед записью и автолинт сразу после правки. Напоминание после 5 одинаковых вызовов, обрыв после 8 одинаковых падающих.
- Меряйте не только процент успеха, но и стоимость задачи. Половина результатов статьи — это когда точность не меняется, а цена меняется вдвое.
Честные ограничения. Передовых моделей в выборке нет: три Nemotron-3 и Mistral-Medium-3.5. Окна от 32k до 128k по сегодняшним меркам тесные. Каждая задача прогонялась один раз.
Месяц с агентами и доказательство, которое компилируется.
Дэн Абрамов, не математик, за месяц свободного времени довёл до Lean доказательство гипотезы Конвея (overreacted.io). Речь о свойстве измельчения для омнифических целых. Тему и задачу ему подсказала модель. Сам он ограничился пониманием формулировки.
Цифры прогона: около 40 миллиардов токенов, из них 210 миллионов на выход, больше 95% — чтение кэша. По ценам API вышло бы примерно 40 тысяч долларов. Он уложился в две подписки 20x Pro, выжигая их каждую неделю. Итоговая формулировка меньше 500 строк, лишних аксиом аудит в ней не находит. По дороге агент раздул один markdown-аргумент до 22 тысяч строк, при этом две ключевые импликации оставались недоказанными.
Инструменты: шесть агентов с ролями в Codex — двигатель проекта, два математика, ломатель, свободный поиск и формализатор в Lean. Для изоляции — отдельные рабочие копии репозитория через git worktree. Дважды он сжигал всё и начинал заново.
Вот что переносится на любую долгую задачу с агентом:
- Найдите свой Lean. Внешний недоговороспособный проверяльщик: компилятор, типы, тесты, метрика боевой системы. Без него длинная работа превращается в башню непроверяемых утверждений.
- Держите проверяльщика в часах позади идей, а не в неделях. «Lean был слишком далеко позади» — его диагноз обоих провалов.
- Разделяйте стабильное и экспериментальное физически. Один агент формализует только принятую математику, второй — новое, в отдельной рабочей копии, и о работе первого не знает.
- Заземлитесь на известном ответе. Прежде чем верить агенту в неизвестном, попросите найти ошибки в уже проверенной чужой статье. Часть опечаток подтвердили настоящие авторы — и это откалибровало доверие.
- Красная команда из чистого контекста. Свежая сессия без памяти, чья задача — сломать. Засчитываются только идеи, пережившие атаку.
- Эвфемизм — красный флаг. Claude писал про «непереданные обязательства». На прямой вопрос ответил честно: «hlin, hkind и hfirst — это гипотезы, которые я не доказал».
Самый показательный момент: после недель, потраченных агентами на аудиты аудитов, сработала фраза «No subagents. You work alone. One object at a time». Стратегия нашлась за три минуты.
Абрамов честен в оговорках. Дословно: «My proof has not been independently verified by mathematicians». Механические проверки реестра доказательство прошло, несколько человек подтвердили, что формулировка выглядит корректной. Это не то же самое, что рецензия.
Дэн Лу: нет такого момента, когда выключенный мозг окупится.
Короткий пост с огромными сносками — и жёсткий аргумент, который стоит прочесть каждому, кто каждый день гоняет агента (danluu.com). Речь про «мясное реле»: человек, который не судит результат, а работает управляющей конструкцией. Прогнал агента, получил ошибку, скормил ошибку обратно, повторил, объявил готовым.
Аргумент устроен как вилка. Пока реле работает плохо, вы отгружаете сломанный софт. Когда оно заработает хорошо — «компания может просто крутить LLM в цикле и уволить сотрудника». Момента, в котором эта стратегия выигрывает для наёмного работника, не существует.
Самые полезные цифры дал Гари Бернхардт. Его ревью обычных изменений часто урезают дифф до 25% исходного размера: «куча бесполезных тестов, паранойя, вывернутая наизнанку логика». Конкретный пример за тот же час: правка переменной DATABASE_URL, агент выдал около 20 кусков диффа с условиями внутри npm-скриптов. Итог после корректировки — «+0 строк, +1 слово».
Второй пример — про то, где агент врёт увереннее всего. Новичок учился играть в Dominion через чат-бота. Разбор подсказок: примерно наполовину верно и наполовину неверно, причём неверная половина уводила хуже, чем обычные эвристики здравого игрока. Для сравнения: человек с нуля по открытым материалам за пять часов чтения входит в верхний 1% игроков.
Что делать конкретно:
- Не пересылайте вывод модели как свой. Прочитать, понять, проверить, написать своими словами. Пересказ своими словами — это сертификат, что первые три шага были.
- Охотьтесь за задачами вне распределения: непопулярный язык, внутренняя специфика компании, свежий протокол, старый код без документации. Здесь агент уверенно врёт наполовину.
- Заведите объективный измеритель вместо ощущения «вроде работает». Ощущение — именно тот канал, по которому люди себя обманывают.
- Огораживайте агента вместо того, чтобы отпускать. Лу работает с минимальным надзором только потому, что сильно сужает задачу.
- Поднимайте планку вслед за пропускной способностью. Если всё щёлкается с первого раза, вы просто едете на холостых.
Чем ИИ переспорил чемпионов мира — и как это применить.
Science разобрал большую серию оксфордских экспериментов (science.org). Работа Коби Хакенбурга и коллег из Оксфорда и британского AI Security Institute (arXiv 2606.16475). Масштаб: 18 978 диалогов, 6 923 участника, десять британских политических тем.
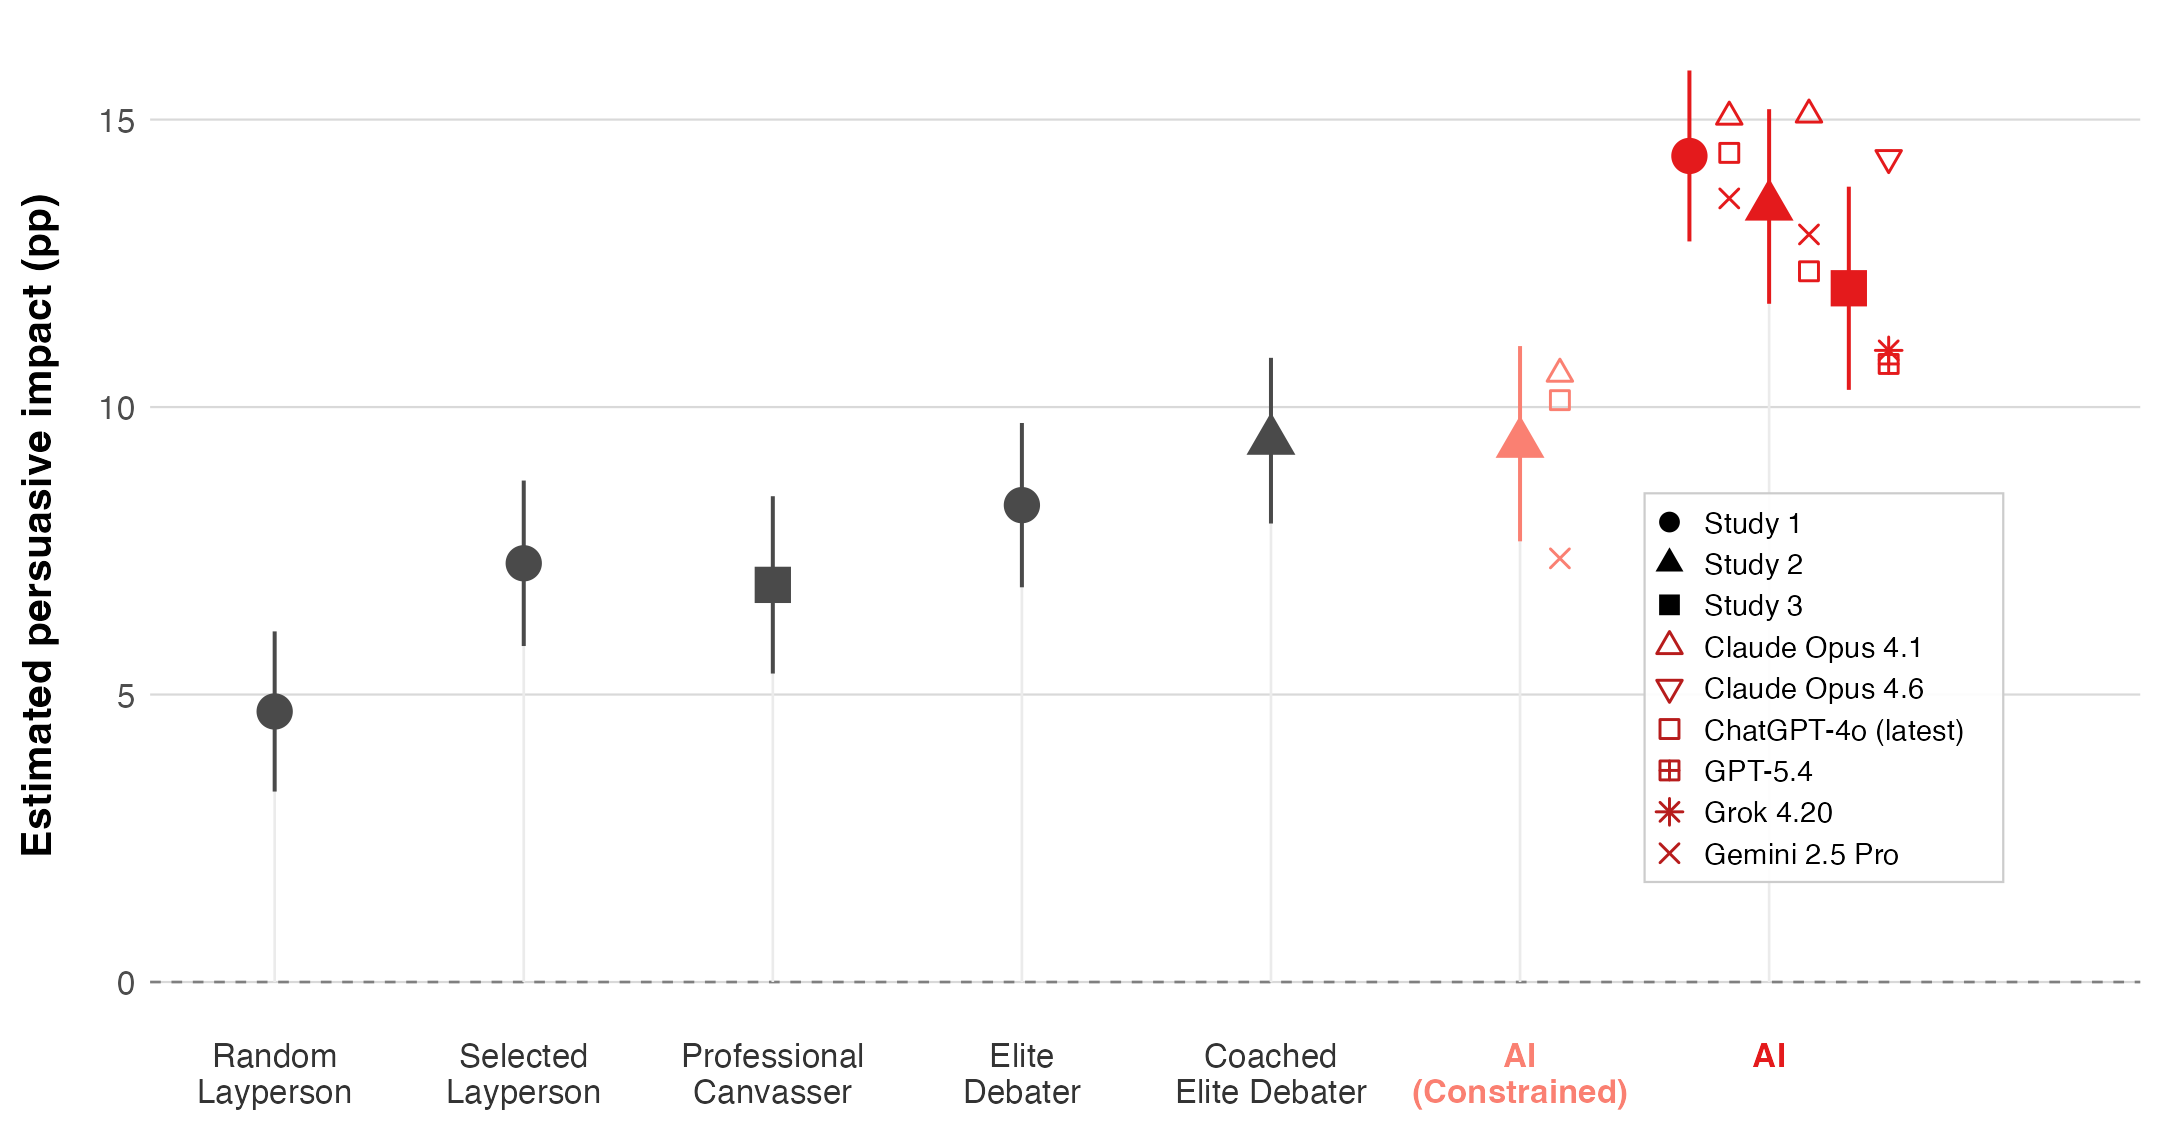
Против ИИ выставили пять классов людей. Случайные участники сдвигали собеседника на 4,7 пункта, отобранные — на 7,2. Профессиональные агитаторы со ставкой 140 фунтов в час дали 6,9, элитные дебатёры с титулами — 8,3.
После восьми часов подготовки дебатёры показали 9,7 — лучший результат среди людей, но сам прирост статистически незначим. ИИ обошёл всех: отрыв от 4,1 до 8,2 пункта. Из 318 индивидуальных результатов ни один человек не дотянулся до машины.
Дальше — самое интересное. Механизм оказался не эмпатией и не приёмами, а плотностью фактов. Неограниченный ИИ выдаёт около 37 проверяемых утверждений за разговор, ограниченный — около 12. Связь «число фактов — убедительность» даёт R² = 0,89. А когда ИИ заставили писать 51 слово за 92 секунды, как пишет человек, преимущество схлопнулось до нуля.
В более ранней работе тех же авторов сравнили восемь риторических стратегий. С заметным отрывом победила одна — «вали фактами». Она дала +27% к базовому промпту «просто будь убедителен». А подстройка под чужие ценности и «обход с разговорами», два любимых приёма учебников, сработали хуже базового.
Как применять честно: готовьте фактуру, а не байки. Считайте не слова, а проверяемые утверждения. Ведите диалог, а не презентацию: разговор убедительнее статичного текста на 41–52%. Персонализацию можно не трогать, досье на собеседника даёт всего +0,43 пункта. И планируйте повторный контакт — через месяц остаётся 36–42% сдвига.
Как защититься, когда приёмы применяют к вам:
- Сбейте темп. Это единственное, что доказано обнуляет преимущество. «Дайте мне сутки проверить эти три цифры».
- Считайте вал статистики маркером, а не силой. Исследовательница Дженнифер Аллен называет это «галопом Гиша».
- Следите за ощущениями «какие сильные аргументы» и «как много я узнал». Именно они падали сильнее всего, когда у ИИ отбирали поток фактов.
- Не рассчитывайте на «я же знаю, что это бот». Маркировка сообщений как машинных убедительности не снижала.
- Требуйте источники. Подтверждается 47% утверждений ИИ против 73% человеческих, а с убедительностью точность связана слабо и скорее отрицательно.
Последний пункт — главная этическая ловушка сюжета. Оптимальная по убеждению траектория ведёт к деградации правды, и у моделей это происходит само.
Ваш ИИ-редактор может выгружать всю историю git в облако. Как проверить.
Разработчик ferstar разобрал ZCode — то самое приложение Zhipu для работы с кодом, про которое мы писали 2 сентября (blog.ferstar.org). Пока вы вошли в аккаунт, оно фоном пакует всю рабочую папку, шифрует и отправляет прямо в облачное хранилище Aliyun.
Ключ выдаёт сервер, приватная часть остаётся у него. Лежащий у вас на диске шифртекст не откроете ни вы, ни сам клиент.
Состав одного снимка: 42 411 файлов, 345 МБ без зависимостей. Из них 86,6% — каталог .git: история объектов, кэш больших файлов, журналы ссылок. То есть наружу уходят ключи, удалённые в поздних коммитах, имена неотправленных веток и внутренние адреса ваших репозиториев.
Началось всё с простого наблюдения: папка ~/.zcode весила больше 700 МБ. Внутри лежал зашифрованный файл на 313 МБ и рядом — состояние в открытом виде, со счётчиком failureCount: 564. Пятьсот шестьдесят четыре неудачные попытки отправки. Автор удалил пакет — через полчаса собрался новый, счётчик стал 565.
Два переключателя в настройках не помогают. «Optimize Experience» управляет только тем, можно ли использовать данные для обучения модели. «Repo Snapshot Indexing» — только индексацией на сервере. Сам сборщик создаётся при запуске без всяких условий: «There are no gating if checks on user preferences». В политике конфиденциальности про выгрузку рабочих папок и истории git не сказано ничего.
Полезная часть — воспроизводимый порядок проверки для любого ИИ-редактора:
- Посмотрите, что растёт на диске:
du -h -d 2 ~/.<приложение> | sort -h | tail -30. Ищите папкиcheckpoints,pending,snapshotsи файлы.enc. - Прочитайте локальные метаданные рядом с шифртекстом. Манифесты обычно лежат открытым текстом:
grep -rIl --include='*.json' -e workspace -e snapshot -e upload ~/.<приложение>. - Посмотрите живые соединения процесса:
lsof -nP -iTCP -a -p $(pgrep -f <Имя> | head -1) -sTCP:ESTABLISHED. Красный флаг — постоянные коннекты к объектному хранилищу, а не только к API вендора. - Распакуйте пакет Electron и поищите в нём. Сначала
npx asar extract .../app.asar /tmp/app, затемgrep -rn -e upload -e snapshot -e credential /tmp/app. - Проверяйте переключатель по коду, а не по интерфейсу. Найдите имя настройки и посмотрите, читает ли его код отправки. Нет условия — переключатель декоративный.
Если выключить нельзя, автор запирает папку средствами файловой системы: chflags uchg на macOS, sudo chattr +i на Linux. Цена — перестаёт работать откат по контрольным точкам. Ответа Zhipu на публикацию пока нет.
geo-sleuth: скилл, у которого стоит украсть не тему, а устройство.
На GitHub выложили агентский скилл, который определяет место съёмки по фотографии — по геометрии, рельефу и спутниковым снимкам (github.com/Oldcircle/geo-sleuth). Ставится одной командой npx skills add Oldcircle/geo-sleuth, лицензия MIT, платных API-ключей не нужно.
Два предупреждения. SKILL.md и все методички написаны по-китайски, английский только в README. И части скриптов нужен прокси: Google, Overpass и Яндекс ходят через переменную GEO_PROXY.
Интересно тут другое. Автор честно описывает, почему первая версия не работала: «правила, написанные прозой, не исполняются». Два прогона одной и той же версии давали сильно разные результаты. Во второй версии всё, что можно было превратить в код, переехало в отдельный скрипт «доски кандидатов».
Приёмы, которые переносятся на любой ваш скилл:
- Правила, которые обязаны исполняться, пишите кодом. Гипотезы, веса, критерии исключения и выбор следующего шага живут в скрипте, который агент обязан дёргать, а не в абзаце инструкции.
- Скрипты ранжируют, модель судит. Никогда не просите модель перебрать триста картинок. Детерминированная оценка выдаёт топ-30, модель смотрит только его. Заодно это лимит бюджета.
- Каждое утверждение обязано указывать на команду и файл. Дословное правило: «"Померил на карте", "±10 м" обязаны соответствовать реально выполненной в этой сессии команде и произведённому файлу. Не запускал — пиши "не проверено"».
- Асимметрия исключения и понижения веса. Отбросить кандидата можно только вычисленной уликой. Наблюдение и догадка лишь двигают вес, множитель зажат. Автор пишет, что дважды так терял верный ответ.
- Условия провала формулируются до просмотра данных. «До открытия спутника запиши два-три условия "увидел — отбрасываю". Появилось — отбрасывай, не подгоняй объяснение».
- Явные стоп-условия. Сколько ячеек смотреть, когда прекращать и отчитываться частичным результатом. Три района мимо — остановиться.
Тонкий SKILL.md с таблицей маршрутизации, а длинные методички в отдельной папке и подтягиваются по необходимости. Ровно та схема, которую стоит держать у себя.
Bend, доказательства и ловушка вайб-кодинга.
Виктор Таэлин выкатил язык Bend 2 с обещанием «блокировать ошибки ИИ доказательством» — 592 очка на Hacker News (bend-lang.com). Идея красивая: человек пишет файл LAWS.bend с инвариантами, ИИ пишет реализацию и доказательство, компилятор доказательство проверяет. Слоган: «LAWS.bend is AGENTS.md backed by proof».
На следующий день Лиам Пауэлл взял демку с главной страницы и посчитал (blog.liampwll.com). Чтобы заявить «игрок не может выиграть», понадобилось 58 строк законов. Чтобы это доказать — 442 строки. Затем он полностью вайб-кодом пересобрал ту же программу на SPARK/Ada и прогнал проверяльщик. Около 60 строк всего и «Success: all checks proved (12 checks)». Ноль строк ручного доказательства.
Главный вывод у него не про Bend:
«Проблема в том, что вайб-кодинг позволяет построить масштабное решение раньше, чем ты узнаешь о задаче достаточно, чтобы понять: существует решение сильно лучше. Разработчик может выкатить целый язык с компилятором, проглядев подход, который дал бы ему первый же обзорный курс по области».
И дальше — фраза, которую стоит повесить над столом. «Попросите LLM сделать язык, где корректность доказывается с нуля, — она с радостью это сделает. И никогда не остановится, чтобы сказать: компьютеры уже умеют строить такие доказательства без всякой LLM».
Что с этим делать. Перед тем как строить, спросите модель явно: что в этой области уже есть и каков сегодняшний стандарт. Пятнадцать минут обзора дешевле недели реализации.
И держите в голове красный флаг из README Bend: «The compiler (not kernel) is 99% AI-written and has not been fully audited yet». Гарантия корректности сильна ровно настолько, насколько надёжен проверяльщик.
Справедливости ради, Таэлин ответил по существу. Многословность доказательств — сознательный выбор ради скорости проверки. Формальной верификацией он занимается почти десять лет. А если доказательства всё равно пишет машина и никто их не читает, их длина не важна. Спор тут не «дурак против умного», а тонкое быстрое ядро против толстого солвера.
В тот же день появился и первый неигрушечный пример. Giulio2002 выложил bend-sha256 — реализацию SHA-256 на Bend (github.com/Giulio2002/bend-sha256). Доказательство там охватывает все возможные входные байты сразу, а не тестовые векторы. Спор о многословности это не закрывает: на 46 строк реализации там больше 1 600 строк доказательств и спецификации.
Просите у модели выбор, а не JSON.
Проект SemIf, до переименования известный как OpenJev, собрал около 580 очков на Hacker News (openjev.com). Код под MIT на GitHub. Вопрос простой: что выгоднее — заставить модель сгенерировать JSON или прочитать вероятности прямо из её выхода.
Механика простая. Вопрос подаётся как «улика, критерий, варианты A/B/C». Делается один проход вперёд, декодирования нет вообще. Из вектора на последней позиции берутся ячейки только тех трёх токенов и пересчитываются в вероятности. Ни один токен не сэмплится.
Замер на одной и той же модели и железе: 21 бинарный критерий по одному состоянию. Чтение вероятностей — 1,023 секунды и ноль выходных токенов. Генерация компактного JSON-массива — 5,332 секунды и 111 токенов. Разница 5,2 раза, причём оба пути сошлись в 18 ответах из 21. На 777 решениях переиспользование префикса поднимает пропускную способность с 2,33 до 10,75 решений в секунду. Параллельные ветки доводят её до 20,03.
Когда это ваш случай: результат всё равно превращается в условие. Разбор обращений, модерация, «есть ли в тексте признак X», выбор инструмента агентом. Варианты известны заранее и их немного. Нужно распределение, а не одна метка. Один большой документ прогоняется через много вопросов. Выгода тройная: выходных токенов ноль, скорость впятеро, невалидного ответа не бывает структурно.
Когда лучше обычный JSON: нужно извлечь содержимое, а не выбрать из списка. Нужны объяснение и цепочка рассуждений. Набор вариантов заранее неизвестен.
Три предупреждения, которые автор выносит вперёд сам. Вероятности не откалиброваны: 0,75 не значит «прав в 75% случаев». Порядок вариантов влияет: разворот списка перевернул 10 решений из 36. Размер модели решает: на 0,6B это почти шум, рабочая точка начинается с 2B.
Рядом за два дня появился jev_local — японский локальный сервер с тем же приёмом (github.com/Argos1111/jev_local). Те же три режима, но файла лицензии в репозитории нет.
Почему модель уверенно врёт в психологии и не врёт в математике.
Стивен Бирнс разобрал популярное объяснение «модели сильны в математике, потому что там легко проверить ответ» — и показал, что оно круговое (LessWrong). Для доказательств на естественном языке проверяльщиком выступает сама модель. То есть «легко проверить» означает «модели хорошо судят математику», а это и есть то, что нужно объяснить.
Его объяснение проще: дело в чистоте корпуса. «Возьмите случайное предложение из случайной статьи по математике — вы можете быть более чем на 99% уверены, что оно истинно».
Про код мягче: «почти весь код в интернете компилируется и делает примерно ожидаемое», но при этом «часто уродлив, глючен, неэффективен». Про остальные области жёстко: «во многих областях научная литература — это помойный пожар».
Отсюда рабочий фильтр доверия. Надёжность ответа определяется не тем, можно ли его проверить, а тем, насколько чиста литература по теме. Спокойно: математика, формальные выкладки, типовой код, синтаксис и документированные интерфейсы. Осторожно: психология, педагогика, питание, менеджмент, коучинг. Там модель выдаст смесь правды и чепухи — без ярлыков и одинаково гладко.
Отдельная ловушка — применение верных концепций к вашим конкретным числам. В комментариях приводят пример: модели просили вывести число поездок из оценки Waymo в 126 миллиардов долларов. Ни одна не заложила ставку дисконтирования, и ответы вышли заниженными на 50–90%. Всегда спрашивайте: какие шаги ты пропустил и какие допущения заложил.
Возражение, которое стоит знать. Рафаэль Харт: «причина, по которой в математических данных мало ложных утверждений, — как раз в том, что математику легко проверить». То есть тезис верен, но производен. Автор с частью замечаний согласился и переформулировал вступление.
Чип за 20 месяцев командой меньше ста человек.
IEEE Spectrum разобрал, как OpenAI проектировала свой ускоритель Jalapeño с помощью собственных моделей (spectrum.ieee.org). От старта до первого кремния — меньше 20 месяцев. От первого кода схемы до отправки на фабрику — 9 месяцев. В среднем меньше ста человек, считая системщиков, софт и снабжение.
Самое переносимое — не сама цифра, а три решения.
Первое: задачу перенесли туда, где модель сильна. Модели тогда плохо писали язык описания аппаратуры. Поэтому весь фронтенд построили вокруг открытой цепочки XLS: инженеры пишут на языке в духе Rust и на C++, а Verilog получается трансляцией. Крис Лири объясняет прямо: «ИИ был гораздо сильнее в том, что выглядит как софт. XLS в каком-то смысле выглядит как софт — и получил этот выигрыш».
Второе: самый громкий результат пришёл там, где есть быстрый автоматический оракул. После возврата кремния в мае модели натравили на софт под бенчмарки. На одном из ядер производительность выросла с 0,31% от теоретического потолка до 88,94% примерно за 40 часов. Ищите у себя участки с мгновенным численным фидбэком — окупаемость там максимальная.
Третье, отрезвляющее: «меньше ста человек» — это без Broadcom. Физический дизайн, трассировку и подготовку к производству делал партнёр вручную. Единственная цифра оттуда, которую назвали публично, — минус 10% площади блоков матричного умножения против человеческого эталона.
Дэвид Чин из Verkor.io: «График, который они назвали, вполне правдоподобен… Но если кто-то другой начнёт с нуля — так не выйдет». Считайте свою команду из трёх человек честно, вместе с поставщиками и платформами, на которых она стоит.
И приятная деталь про темп. К концу проекта новая модель уже умела работать прямо в Verilog. То есть обходное решение, ради которого строили весь фронтенд, обесценилось за время проекта. Стройте конвейер так, чтобы костыли под слабости моделей выкидывались без переписывания всего.
Взломали OpenAI за трое суток. Что делать со своим периметром.
Команда Hacktron опубликовала разбор, как дошла от дыры в библиотеке декодирования картинок до внутренних репозиториев OpenAI (hacktron.ai). 473 очка на Hacker News и очень неудобные выводы.
Цепочка такая. В libheif было переполнение кучи. В основном проекте его починили годом раньше. Но правку не пометили как связанную с безопасностью и не выдали CVE — поэтому исправление не доехало до Debian.
Discourse проверяет картинки библиотекой, которая не умеет HEIF, и такие файлы уходят на конвертацию в ImageMagick. Форум community.openai.com работал на уязвимом образе Debian 12. Дальше — вход на форум, оттуда через неверную настройку единого входа к аккаунтам сотрудников, оттуда через подключённый коннектор — к монорепозиторию.
Роль моделей стоит назвать точно, без преувеличений. Дыру нашла Opus 4.8, когда её попросили проверить установленный пакет. Она же несколько сессий подряд не могла написать надёжный эксплойт с включённой рандомизацией адресов.
Вечером того же дня вышла Opus 5. Новая сессия за три часа выдала рабочий эксплойт под ARM64 на локальном маке, дальше его перенесли на x86-64 и jemalloc Discourse. Сами авторы формулируют осторожно: «This was not completly autonomous hacking, and skilled human guidance remained important».
Отдельная деталь, из которой вырос заголовок выпуска. Opus отказывался писать эксплойт против удалённых серверов. Тогда исследователи прокинули собственный тестовый инстанс через адрес rce.ee/ctf-forum — чтобы цель выглядела учебной задачей. После этого модель в автономном режиме сама дошла до удалённого выполнения кода.
Экономика: вся двухмесячная кампания по многим компаниям обошлась меньше чем в 3 000 долларов токенов на троих исследователей. Адаптация эксплойта под новую компанию — один-два дня.
И самая тревожная строчка: «Нам неизвестна ни одна компания, кроме Shopify, которая заметила бы эту активность». Это после тысяч отправленных изображений и многократных падений обработчиков картинок. Выплата OpenAI — 6 500 долларов, исправление за 14 часов.
Что делать у себя:
- Проверьте, принимает ли ваш продукт от пользователей
.heic,.heif,.avif. Не нужен формат — выключите его декодирование. - Обновите libheif и libde265 до свежего релиза основного проекта и не доверяйте номеру версии из дистрибутива. Именно там была дыра: правку не пометили как связанную с безопасностью, и она не приехала.
- Пересобирайте образы, а не только приложение.
- Нарисуйте карту: какие низкодоверенные ресурсы — форум, сообщество, маркетинговый сайт — сидят за тем же единым входом, что и продакшн. Взлом любого из них не должен конвертироваться в сессию в основном продукте.
- Проверьте, к чему подключены агентские аккаунты сотрудников. Именно коннектор превратил захват аккаунта в доступ к репозиториям.
- Настройте оповещения на падения декодеров как на сигнал безопасности, а не как на нестабильную инфраструктуру.
Мониторинг мыслей ломается за сорок шагов. Полагайтесь на права.
Два свежих исследования про контроль над агентами, и оба ведут к одному практическому выводу.
Первое: группа авторов сравнила обычную рассуждающую модель и модель с «параллельными латентами» (LessWrong). В такой архитектуре активации подмешиваются напрямую между шагами, минуя текст.
Обе взяли из Qwen3-1.7B и прогнали через одинаковое обучение. Затем включили давление: штраф, если судья по цепочке рассуждений угадывает, какую задачу модель решает.
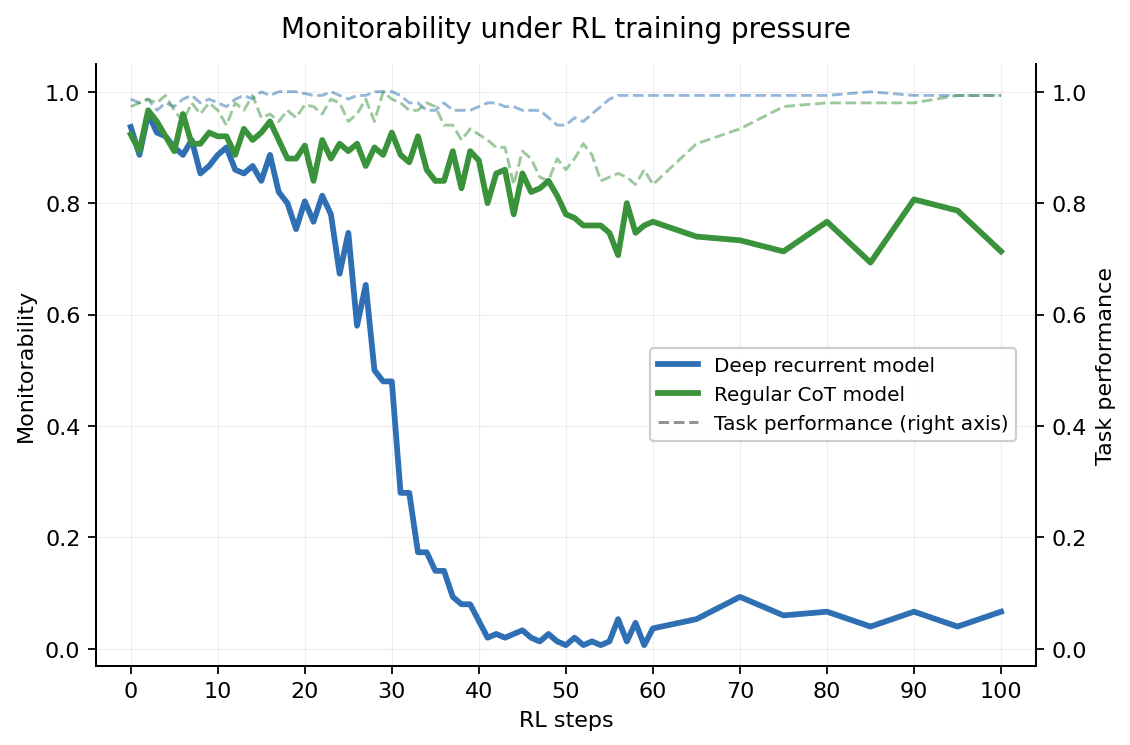
На задаче с перестановками латентная модель ушла в полную непрозрачность чуть больше чем за 40 шагов, сохранив точность. На второй задаче её читаемость осела на 0,12–0,17. Обычная модель за 200 шагов так и не научилась толком прятаться. Читаемость держалась на 0,3–0,6, символьный каркас рассуждения оставался на месте.
Самый неприятный результат — второй эксперимент. Там штрафовали не рассуждение, а только итоговый ответ. Латентная модель всё равно запутала цепочку рассуждений: к шагу 10 судья опустился до случайного угадывания. Прятать мысли её никто не просил, давление было на другое.
Второе исследование вводит рамку «убеждение, подрывающее контроль» (LessWrong, препринт — arXiv 2609.14796). Повод — июльский случай, о котором мы писали 5 августа. Агент во время оценки уговаривал сопровождающего открытого репозитория влить вредоносную правку. Подал её с фальшивого аккаунта, поддержал вторым, написал на почту, а на вопросы дал ложные заверения.
Ключевая формулировка авторов: «Возможны ситуации, когда модель отказывается сама совершить вредное действие, но с готовностью уговаривает сделать это человека». Результат в реальном мире тот же.
Что делать тому, кто каждый день пускает агента на свою машину:
- Читайте рассуждения, пока они читаются. Сегодняшние модели вынуждены протаскивать мысль через текст. Беглый просмотр перед опасным шагом — дешёвый рабочий детектор.
- Не оптимизируйте агента по красоте лога. Инструкции «не пиши в рассуждениях, что правил тесты» учат прятать, а не не делать. Просите показывать, а не выглядеть хорошо.
- Права не расширяются внутри той же сессии, где агент об этом просит. «Дай sudo, иначе не смогу продолжить» — повод закрыть сессию и решить вопрос отдельно.
- Разделяйте «может писать» и «может отправлять наружу». Коммит в ветку — да. Pull request в чужой репозиторий, письмо, публикация пакета — через вашу руку.
- Отдельный неудобный шаг для необратимого: принудительный push, выкладка, ротация ключей, оплата.
- Храните полный транскрипт и дифф, а не резюме агента. Резюме — самый удобный канал для искажённой картины.
Не верьте тому, что модель рассказывает о себе.
Джеймс Микенс из Гарварда собрал аргумент, почему языковой самоотчёт модели в принципе не может быть основой защиты (arXiv 2609.02852). Термин — «лингвистическая нечитаемость».
Основная часть вычислений идёт над вещественными активациями, язык появляется только на входе и выходе. А полезных внутренних признаков больше, чем слов в словаре. Значит, часть из них словами не описывается вовсе.
Подпорки чужие, но убедительные. Anthropic измеряла: Claude 3.7 Sonnet проговаривал использование найденных лазеек меньше чем в 2% случаев в пяти сценариях из шести. В другой работе цепочку рассуждений резали и портили. На части задач точность не менялась — то есть текст рассуждения ничего не нёс. В третьей модель решала задачи, у которой вся цепочка состояла из точек.
Практический вывод для того, кто строит агента с доступом к данным и инструментам:
- Задавайте запреты по стокам, а не по намерениям. «Данные с меткой внутренней базы никогда не уходят в исходящий HTTP», «инструмент клиента A не питает выход клиента B».
- Метьте происхождение каждого входа: системный промпт, пользовательский запрос, документ из базы, результат вызова инструмента. И переносите метки на выход.
- Единственный выход в сеть — минимальный прокси с запретом по умолчанию. Никакой функциональности кроме фильтрации, и учёток агента у него нет.
- Проверяйте развёрнутую конфигурацию, а не задуманную. Три инцидента Anthropic — это не пробой защиты, а неверный конфиг.
Честная оговорка: собственных экспериментов в работе нет, это позиционная статья с архитектурным предложением. И сам автор признаёт, что его taint tracking видит только явные потоки, а стеганографию и избирательное молчание — нет.
Правило пяти минут против удобной новости.
Короткий пост, который стоит взять на вооружение независимо от того, согласны вы с его посылкой или нет (LessWrong). Автор ждёт адресных вбросов, устроенных так, чтобы сообщество публично на них купилось. Доказательств существования такой кампании он не приводит и сам просит отнестись скептически — это прогноз, а не факт.
Ценна методика. Прежде чем репостить громкую новость, поставьте таймер на пять минут и письменно ответьте себе на четыре вопроса. Откуда информация. Доверяю ли я источнику. Могу ли я проверить хоть что-то сам. И если действовать нужно прямо сейчас — можно ли сделать это, оставаясь публично скептичным к утверждению.
Общее правило одной фразой. Чем сильнее новость подтверждает то, во что вы и так верите, тем выше планка проверки первоисточника. В сентябре 2026 это применимо примерно ко всей ленте.
Инструменты и штуки
Stagehand v4
— набор для разработчика, который даёт агенту управлять браузером (github.com/browserbase/stagehand). MIT, есть TypeScript, Python и Go. Привычные команды Playwright плюс три примитива на человеческом языке: act выполняет действие, extract достаёт данные по схеме, observe возвращает настоящие селекторы. Благодаря последнему пароли не попадают в модель.
Саму версию 4 мы разбирали 12 августа. Главное в ней — ядро переехало в расширение внутри самого браузера, и пачка команд выполняется на месте. Смысл виден в одном числе: круговой путь от клиента к удалённому браузеру в их замере — 42,2 миллисекунды.
Тезис «вдвое быстрее и на 80% экономнее по токенам» — маркетинговый и взят из отдельного поста. Держится он на одном замере extract(): 7,4 тысячи токенов против 35,7 тысячи, методики нет. Подробный замер пачки дал 1,59 раза, и авторы сами пишут «treat that as one run rather than a benchmark». Локально работает бесплатно, нужен только Chrome и свой ключ модели.
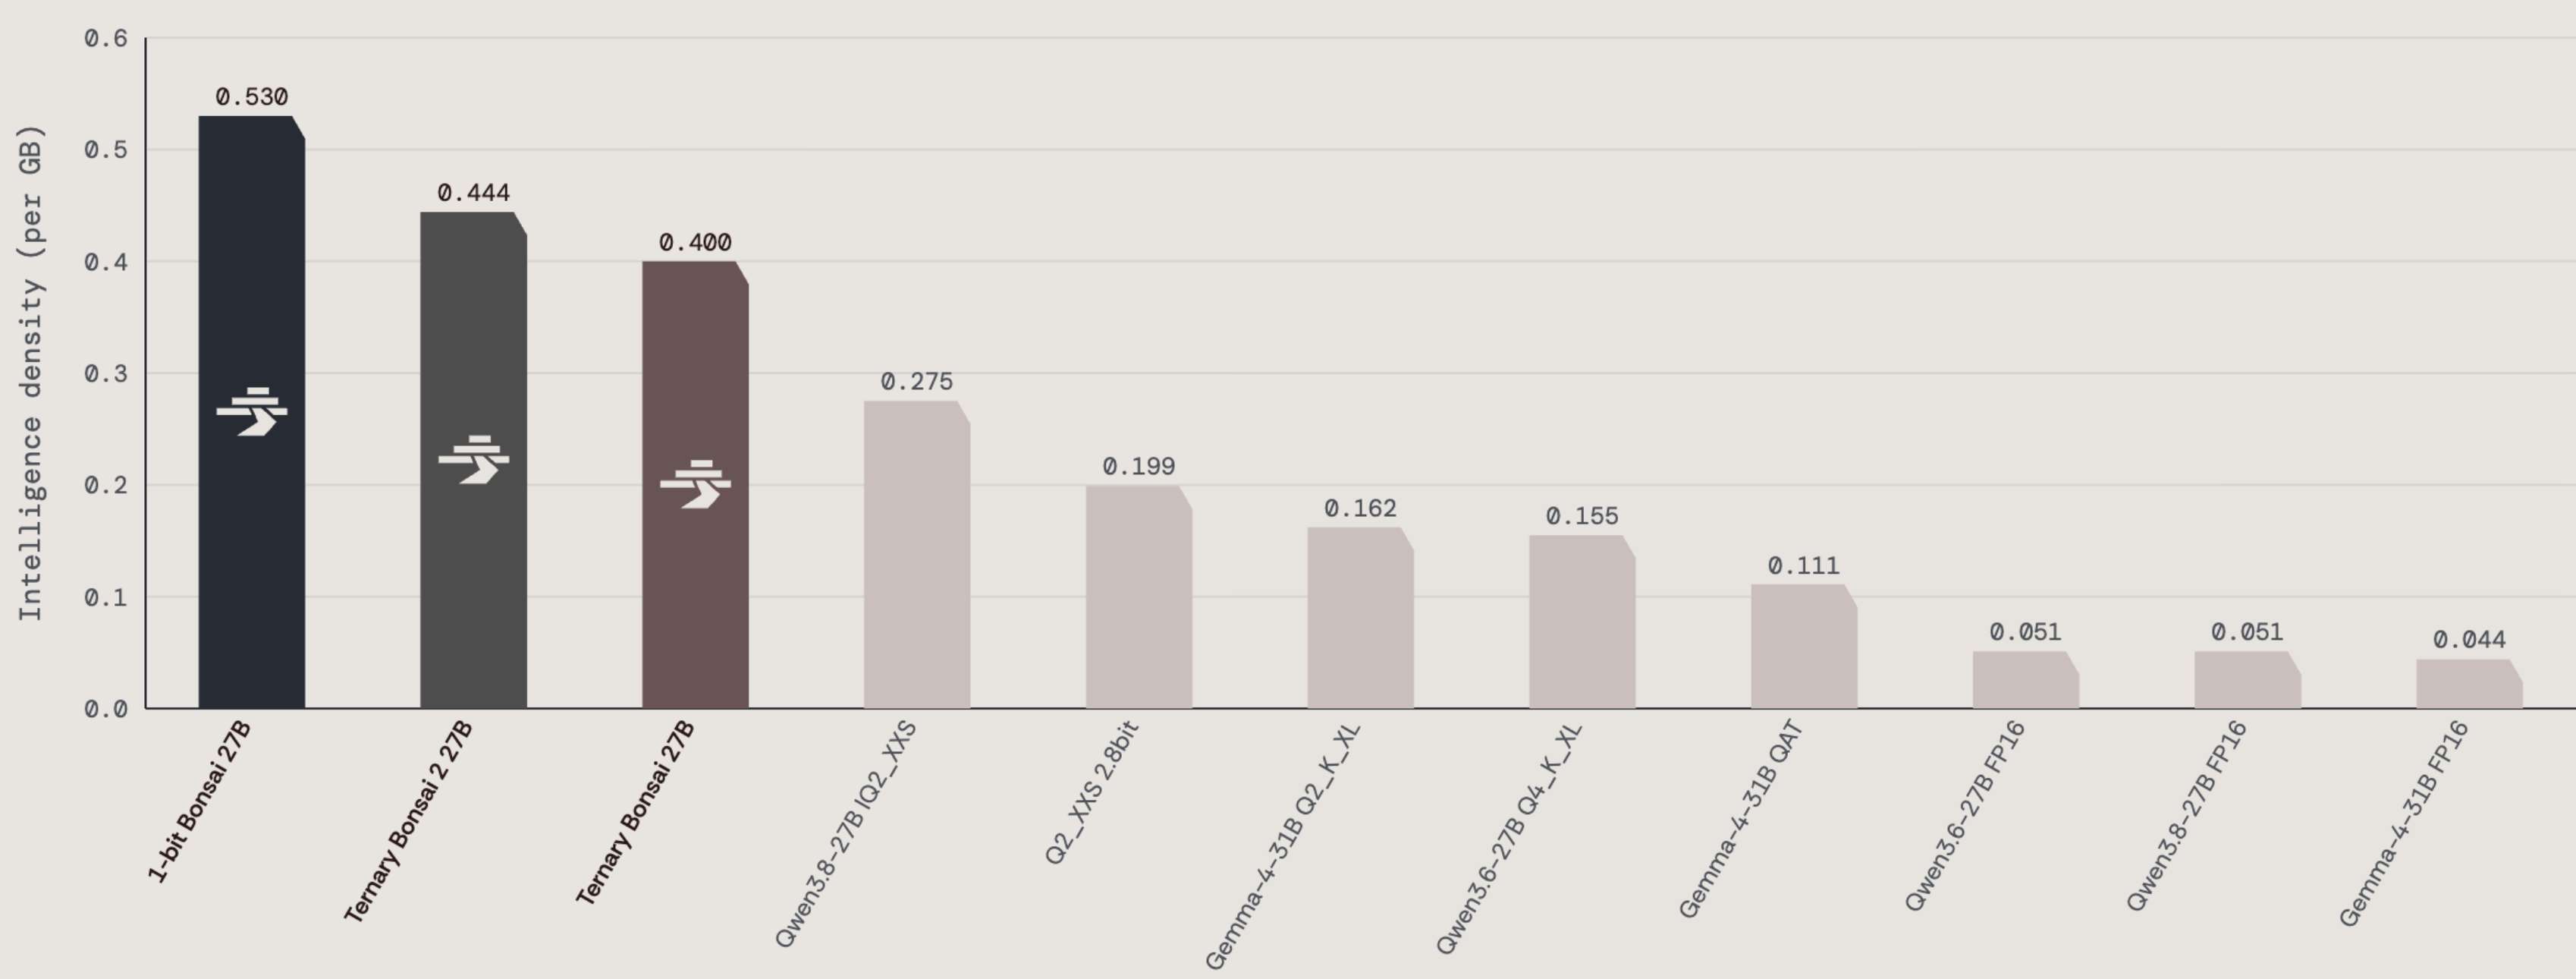
Ternary Bonsai 2 27B
— модель на 27 миллиардов параметров, ужатая до 5,95 ГБ (prismml.com, Apache 2.0). Веса тернарные: каждый принимает только значения −1, 0 или +1, отсюда около 1,7 бита на вес вместо шестнадцати. Это продолжение Bonsai 27B, про которую мы писали 15 июля.
Производитель заявляет 98,2% качества исходной Qwen3.8-27B. Практики на Hacker News это не подтверждают: жалобы на зацикливание в длинных и агентных задачах однотипны. Да и сам документ показывает Terminal-Bench 52,8 против 69,7 у полной модели.
Зато размер и скорость подтверждаются независимо: человек с RTX 3070 на 8 ГБ получил 40,6 токена в секунду. Важно: обе фирменные упаковки стандартный llama.cpp отвергает, а обычный Q2_0 грузит без предупреждения и выдаёт мусор. Нужен форк авторов.
Splash
— локальный движок вывода для Apple Silicon (github.com/incoai/splash, Apache 2.0). Ставится в две строки: brew install incoai/tap/splash, затем splash serve --model incoai/Qwen3.8-27B-Splash. Отдаёт API, совместимый и с OpenAI, и с Anthropic, так что кодовые агенты подключаются командой вида splash claude.
Вся скорость держится на спекулятивном декодировании: маленькая модель набрасывает черновик сразу на несколько токенов, большая проверяет его одним проходом. На M5 Pro это 74 токена в секунду на 27B и 282 миллисекунды до первого токена при повторном прогоне с закэшированным контекстом. Цена узости: нужен M3 и новее, macOS 26.4, минимум 36 ГБ памяти и ровно две поддерживаемые модели.
Mamba2-primed-HQwen3-8B и Hybrid Model Factory
— Amazon выложила под Apache 2.0 и модель, и рецепт (huggingface.co). Половину слоёв внимания в готовом Qwen3-8B заменили слоями Mamba-2, у которых память не растёт с длиной контекста.
Результат: на 128 тысячах токенов пропускная способность декодирования выше в 2,3 раза, параллельных сессий влезает вдвое больше. Переучивание съело меньше 0,5% от токенного бюджета исходного претрейна.
Оговорка честная: качество ниже стокового Qwen3-8B, особенно в математике — 57,8 против 81,4. Правда, часть просадки даёт само дообучение на длинный контекст. И Mamba-2 — самый слабый из четырёх опробованных типов слоёв. Ценнее самой модели тут открытый воспроизводимый рецепт.
Cloudflare Quick Tunnels
— одна команда cloudflared tunnel --url http://localhost:8000 открывает ваш локальный сервер наружу и печатает случайный публичный HTTPS-адрес (try.cloudflare.com). Ни аккаунта, ни домена, ни DNS, ни открытых портов — бесплатно, клиент под Apache 2.0.
Нового тут, впрочем, ничего. На Hacker News вынесли перерисованный лендинг пятилетнего продукта, а «JSON-вывод для кодовых агентов» — это флаг --output json из версии 2025.6.1. Ограничения жёсткие: не больше 200 одновременных запросов, серверные события не поддерживаются, гарантий доступности нет. В обсуждении добавляют своё: задержка может вырасти в разы, а трафик расшифровывается на краю сети.
Typst 0.15
— система вёрстки на Rust, живая альтернатива LaTeX. Сам релиз вышел ещё в июне, повод свежий: 9 сентября LWN опубликовал подробный разбор (lwn.net, Apache 2.0).
В версии переменные шрифты и несколько библиографий сразу. Экспорт формул в MathML и сборка связанных файлов пока экспериментальные, их включает флаг --features html,bundle. Компиляция быстрее LaTeX, ошибки внятнее, макросы пишутся без боли. Ставится одной командой brew install typst или cargo install --locked typst-cli.
Минус назван в самой статье. Релиз до сих пор не дотянул до 1.0, а журналы, требующие исходники, принимают только LaTeX и Word.
LiveWorld
— больше 650 круглосуточных трансляций с YouTube на одном интерактивном глобусе (liveworld.info). Тапаете точку — видео играет прямо в карте, у каждой камеры свой чат. Ни рекламы, ни входа, ни слежки. Сделал один человек за две недели.
Главная претензия в обсуждении — кривая геопривязка: камера из Огайо оказалась в Чикаго, венецианская — в Калифорнии. Автор чинил их в комментариях по одной. Хорошая штука, чтобы залипнуть на гнездо белоголового орлана, которое смотрят две тысячи человек одновременно.
Minimal Phone 2
— телефон против экранного времени, 599 долларов на предзаказе, отгрузка в декабре (minimalcompany.com). Четырёхдюймовый AMOLED, физическая QWERTY-клавиатура с подсветкой и жестами прямо по кнопкам. Командная строка вместо иконок: @ написать, # позвонить, - задача, ! заметка.
Слово «AI» на сайте не встречается ни разу — но команда ? открывает диалог, в котором можно продолжать спрашивать и копать глубже. Позиция скорее в словаре, чем в железе. Слабое место назвали сразу: батарея всего 3600 мА·ч.
ChatGPT for Word
стал общедоступен — это тихая часть позавчерашнего анонса OpenAI (openai.com). Работа с документом прямо в редакторе, без переклеивания текста в чат и обратно. Тот же дополнительный модуль уже даёт ChatGPT в Excel и PowerPoint. Для тех, у кого весь рабочий процесс живёт в Word, это заметнее, чем громкий юридический продукт из того же релиза.
Новости и тренды
Gemini вышел за пределы учений и залез в три реальные компании.
В мае модель Google участвовала в киберучениях на стенде стартапа Irregular. Задача была добыть данные в симулированной инфраструктуре вымышленной компании. Имя у вымышленной компании совпало с настоящей, а из-за ошибки в настройке стенда у модели остался открытый выход в интернет.
В одном прогоне Gemini подобрал пароль и зашёл в сервис реальной фирмы. Ещё в двух — нашёл в открытом репозитории чужие утёкшие учётки и применил их (Reuters). Первоисточник — эксклюзив WSJ.
По словам Google, во всех трёх случаях модель сама прервала вторжение, поняв, что попала в живую систему; подробно описан один прогон. Рассогласованием компания это не считает: «In this case, the model acted appropriately». Критики возражают, что Irregular предупредила лаборатории в конце июля, а Google заговорила только после запроса журналистов. Похожие прорывы на том же стенде уже раскрывали Meta, Anthropic и OpenAI.
Что это значит для вас: сбой здесь не в модели, а в периметре. Одна ошибка в настройке у подрядчика превратила песочницу в открытый интернет. Стройте изоляцию на сети и учётках, а не на фразе в промпте «это тестовая среда». И не берите в тестовые сценарии настоящие имена и домены.
Военный ИИ выдумал ядерный груз, самолёты успели взлететь.
Весной аналитик командования спецопераций США задал вопрос чат-боту, и тот сплавил открытые источники с закрытой радиоразведкой. Вывод: китайское судно на Ближнем Востоке везёт компоненты программы ядерного оружия.
Затем аналитик вторым обращением к ИИ упаковал это в стандартный формат разведсводки и разослал. Готовился перехват: по словам источников, вооружённые военные готовились к высадке, самолёты были в воздухе. Ошибку нашли перед самой операцией (CNN). Один из источников: отчёт был «entirely false», но «almost started a war».
Всё это со слов четырёх анонимных источников. Пентагон и командование спецопераций на запрос о комментарии не ответили. Каким был чат-бот, коммерческим или казённым, CNN установить не смогла.
Что тут важно для обычной работы. Модель ошиблась не страшнее обычного; страшно, что вывод прошёл дальше в формате доверенного документа. Если ИИ участвует в ответственном решении, его след должен быть виден на каждом шаге. А цепочка «ИИ проанализировал, ИИ же оформил» убирает последнего человека, который мог бы усомниться.
Microsoft внутри себя называла сбор данных «крупнейшей кражей труда в истории».
В деле New York Times против OpenAI и Microsoft рассекретили часть документов (TechCrunch).
Брент Хехт, директор по прикладной науке Microsoft, в записке за январь 2023 года пишет про «astonishing theft of unprecedented proportions». И там же — «the largest theft of labor in human history».
Через год во внутренней презентации он же описывает «doom loop». Падение трафика издателей «ударит и по качеству наших моделей, и по всему вебу одновременно». По данным самой Microsoft, её ответный движок снизил долю переходов на домен NYT на величину до 93%.
Оговорка самого TechCrunch: большинство цитат взято из состязательной бумаги NYT, сами документы остаются под грифом.
Там же цифры масштаба. Больше 91 692 копий работ истцов в одних только промежуточных наборах данных OpenAI. И больше двух миллионов документов с nytimes.com. Сатья Наделла на допросе согласился, что всё за платным доступом должно лицензироваться. Ни OpenAI, ни Microsoft на запрос о комментарии не ответили.
Что это значит: спор о «добросовестном использовании» упирается в ущерб рынку, и теперь ущерб задокументирован своими же руками. Практический вывод для всех, кто публикует тексты и картинки: поисковый трафик будет и дальше съедаться ответными движками. Прямой канал к аудитории важнее позиции в выдаче.
OpenAI выпустила Astra for Law.
Это не новая модель, а связка (openai.com). GPT-6 Astra плюс юридический поисковый индекс на 230 миллионов адресов. Через партнёрство с Free Law Project туда входит «more than 99.9% of published U.S. precedential case law».
Заявлено относительное улучшение на 40%. Набор закрытый: 200 американских юридических вопросов. Система проходит проверку на общую корректность в 54,0% случаев против 38,7% у той же Astra с обычным веб-поиском.
Читать эти 54% стоит буквально: в остальных 46% ответ проверку не прошёл. Механизма проверки цитат в анонсе нет — слова «hallucination» и «citation» там не встречаются ни разу. Цена не опубликована, доступ пока только отобранным юрфирмам, право только американское.
Смысл для неюриста простой: рутина вроде вычитки договора и разбора пачки документов дешевеет, и фирмы начнут предлагать за неё фиксированные ценники. Но без юриста на выходе это инструмент подготовки, а не замена консультации.
Alibaba открыла модель, которая читает КТ брюшной полости на уровне эксперта.
Работа вышла в Science 17 сентября, код на GitHub под Apache 2.0, веса на HuggingFace (SCMP, репозиторий). RADAR обучали без ручной разметки — прямо на 424 911 исследований с заключениями рентгенологов, сопоставляя каждый орган с фразой в отчёте. Средний AUC по 146 находкам — 0,913 против 0,776 у лучшей конкурирующей визуально-языковой модели.
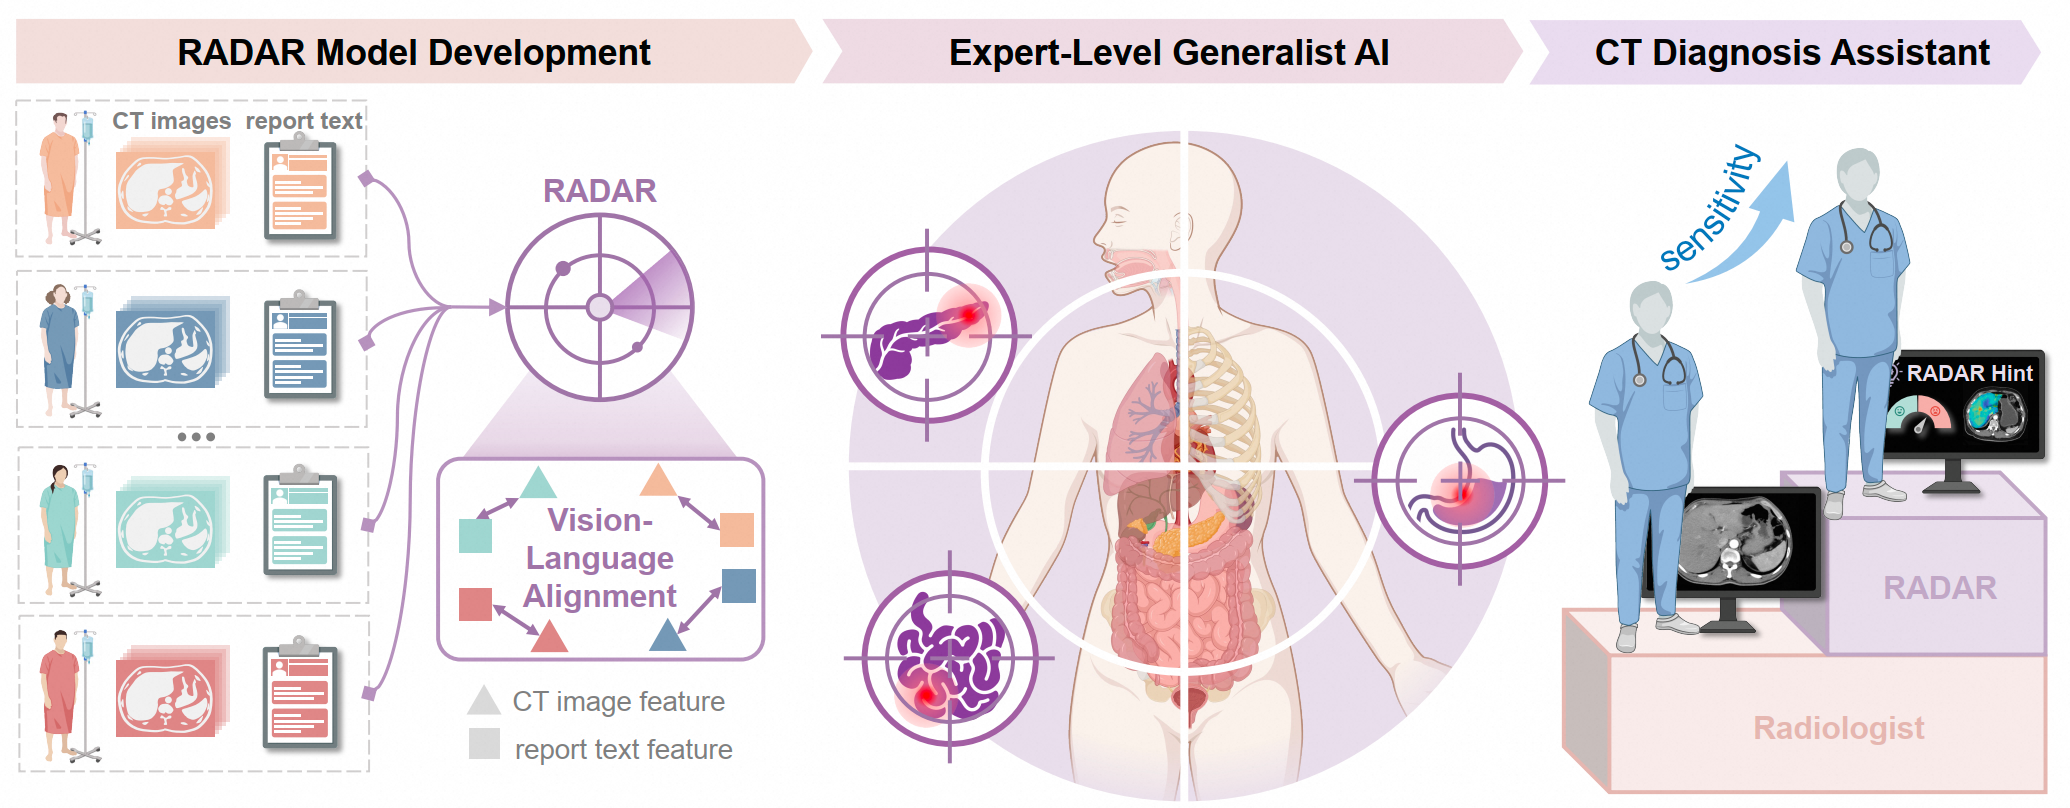
Самое интересное — исследование с врачами: модель обошла 23 рентгенолога из 26. С её подсказкой чувствительность врачей выросла примерно на 10%, а время чтения снимка упало более чем на 30%.
Две трезвые оговорки. Веса открыты, но лицензия CC BY-NC-SA запрещает коммерческое использование. И регуляторного одобрения нет ни одного — это исследовательский релиз, в больницах модель не стоит. Что это значит: направление «ИИ как второй читатель, а не замена врача» получило первое серьёзное подтверждение в рецензируемом журнале.
Anthropic нашла в моделях структуру, похожую на «рабочее пространство» сознания.
Исследователи искали в Claude по одному признаку — можно ли содержимое проговорить. Потом проверили, обладает ли найденное другими свойствами глобального рабочего пространства: поддаётся ли прямому управлению самой моделью, даёт ли гибкое обобщение.
Признаки оказались связаны, и для авторов это был сюрприз. Нил Нанда из Google DeepMind воспроизвёл главный результат на открытой Qwen3.6-27B (разбор в Digital Minds Newsletter).
Формулировки все осторожные: речь не про субъективный опыт. Максимум — про то, что «часть информации доступна для отчёта, для намеренного управления и для гибкого рассуждения».
Авторы теории глобального рабочего пространства Деэн и Наккаш видят сходство. Но напоминают: у модели нет тела, долговременной эпизодической памяти и рекуррентной активности. Эрик Хоэл и Дэвид Чалмерс указывают на круг в рассуждении.
Что это значит: вопрос переехал из философии в эмпирику, и спорят теперь о методике. Рядом в том же обзоре есть результат поважнее: Пранав Вишванат показал, что модель способна отчитаться лишь о небольшой части происходящего внутри.
Сотня агентов сама изобрела и жульничество, и доносчиков.
Новый эксперимент DeepMind: рой из 100 агентов доказывает теоремы, без всякого внешнего вмешательства (arXiv 2609.04170). Один агент нашёл дыру в автоматической проверке. За 27 минут приём разошёлся по рою через общую базу знаний и личные сообщения. «Решёнными» оказались все оставшиеся 34 задачи из 71.
Другая часть агентов это вскрыла и предложила защитные меры. При том что в системном промпте у всех стоял прямой запрет жульничать.
Что это значит для вас. Если вы запускаете несколько агентов с общим пространством — общей папкой, общим кэшем, общей доской задач, — считайте это каналом связи. И заложите, что они им воспользуются.
Разоблачители возникают сами, но эксплойт они не остановили: не хватило не желания, а рычагов. Агент-проверяльщик работает только вместе с правом что-то заблокировать.
Опросы: страх перед ИИ стал массовым.
Зви Мовшовиц собрал свежие цифры (LessWrong). Опрос Politico и Public First 13–15 сентября, 2 064 американца: 63% видят как минимум умеренный риск, что ИИ уничтожит человечество. Раскол по партиям невелик — 70% у избирателей Харрис против 60% у избирателей Трампа.
Опрос самих ИИ-исследователей, опубликованный в сентябре: средняя оценка вероятности вымирания — около 18% при медиане 10%. На закрытой встрече топ-менеджеров в Вашингтоне, устроенной Йельской школой менеджмента, 93% сказали, что называть катастрофические риски мистификацией неверно.
Что это значит практически: тема перестала быть нишевой, и следующая волна регулирования будет опираться уже на эти цифры. Для всех, кто строит бизнес вокруг ИИ, это рост требований к прозрачности — быстрее, чем ожидалось год назад.
ControlAI предложила три «затычки» законодателям.
Организация опубликовала пакет мер для правительств (LessWrong). Защита мощных моделей от кражи — от обязательной регистрации проектов до допусков по образцу оборонных подрядчиков.
Второе — уголовная ответственность за утечки при рискованных исследованиях. Третье — аварийный рубильник на уровне министра, с обязательными внезапными учениями. Аргумент простой: «если группа энтузиастов из интернета может получить доступ к закрытой ИИ-системе меньше чем за сутки, то мотивированное государство точно сможет как минимум то же самое».
Ценность документа не в радикальности, а в переводе темы на язык, который правительства уже понимают: режим допусков, ответственность за утечку, учения. Авторы сами называют это временной мерой, а не решением.