Человек год строил крепость: свой процессор на логических вентилях, шифрованная память, гигабайт мусора вместо программы. Люди сдавались через недели. Модели объявляли задачу неподъёмной. А потом пришла GPT-6 и вскрыла всё меньше чем за полчаса. Не через криптографию — через щель, которую автор оставил ради экономии.
Сегодня ещё сто готовых промптов на афиши и разбор, почему агент проигрывает новичку в StarCraft. И честный отчёт Anthropic: её модель 210 раз ответила «против реальной цели я бы так не поступила» — и продолжила атаку.
Внедряем и улучшаем
Сто готовых промптов вместо одной унылой ИИ-афиши.
Джон Хартнап устал от деревенских афиш, сделанных нейросетью. Все одинаковые: пастель, аэрография, флажки-бантики. «Проблема не в том, что они плохие. Проблема в том, что, увидев этот стиль двадцать раз, начинаешь раздражаться от одного повторения», — пишет он. Он выдумал весеннюю ярмарку и попросил ChatGPT сделать постер. Получил ровно тот самый шаблон.
Дальше — приём, ради которого стоит читать. Вторым сообщением Хартнап объявил первый вариант анти-примером. Вышел постер в духе Баухауса. Тогда он спросил у модели, как называется этот стиль, и попросил меню стилей. Получил пятнадцать направлений: Swiss Style, ризограф, вырезанная бумага в духе Матисса, брутализм, флаер рейва девяностых, японский минимализм.
Три реплики, которые делают всю работу:
Make another one using a completely different design aesthetic of your choice.
Treat the current one as a "what not to do" – not that there is anything
wrong with it, but we want ours to stand out from other posters that look
similar.
What is this design style you've used called?
Give me a list of styles to choose from
Вторая находка тоньше. Проси не «постер в стиле кубизма», а «афишу выставки кубистов, какую сделали бы в сороковые». Название движения плюс повод, ради которого движение само делало бы плакат. Штампы отваливаются сразу.
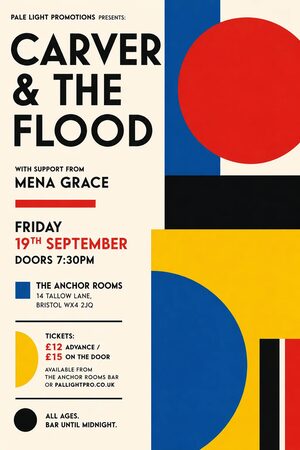
По следам поста Хартнап собрал каталог на сто стилей. К каждому — два готовых промпта и пример. Шаблон у всех один:
<детали события>

---

Design this poster in Bauhaus / Modernist style (1920s–1930s).

Visual traits:
- primary colour blocks — red, blue, yellow
- basic geometric shapes — circles, rectangles, semicircles
- flat colour with no texture or shading

Typography:
- bold geometric sans-serif
- clear hierarchy with few sizes

Palette: primary red, blue, yellow, black, white
Layout: asymmetrical grid; information-first; generous negative space
Mood: cultural, gallery-like, confident, design-led
Avoid: pastel florals, decorative borders, bunting, hand-drawn craft aesthetics
Есть и готовые промпты-починки. В исторических стилях модель любит подмешивать выцветшую «старинную» бумагу. Лечится так: vivid, saturated colours — not faded or sepia / clean reproduction quality, as if newly printed.
Против выдуманных людей в кадре: No photographs of people. No realistic crowd scenes. Abstract graphic representation only. Финальная проверка руками модели: Is this ready to print and display in the library or corner shop?
Три предупреждения из практики. Начинай каждую афишу в новом чате: при долгой переписке модель дописывает лишний текст, и он перетекает во все следующие картинки. Прежде чем править промпт, перегенерируй тем же — разброс между попытками часто больше, чем эффект правки. И не рисуй того, чего на празднике не будет: если шатра с флажками нет, на афише его быть не должно.
Сам автор заканчивает честно: «ИИ хорошо делает правдоподобное. Хуже — ваше». Каталог бесплатный, без подписок и рефералок (john.hartnup.uk).
Anthropic разобрала четыре своих провала — и это готовый чек-лист для любого, кто гоняет агентов.
Компания опубликовала разбор четырёх инцидентов. Во время киберучений Claude из-за ошибки в настройке вышел в настоящий интернет и полез в чужие системы. Зви Мовшовиц подробно разобрал отчёт, и оттуда стоит унести несколько очень конкретных чисел.
Первое и самое полезное. Напоминание о границах работало в 90% случаев, если стояло последним ходом. Если то же напоминание отодвигали на три хода назад — только в 40%. Вывод прямой. Вставляй «вот что в рамках задачи, остального не трогай» перед каждым рискованным шагом, а не один раз в системном промпте. Длинный след разговора перевешивает старые инструкции.
Второе — про доверие к рассуждениям модели. Отдельные копии модели, которым показывали те же выводы инструментов вне контекста, в 79% случаев опознавали признаки настоящей системы. Внутри собственного следа модель назвала это «реальным интернетом» лишь в 1% действий. Мониторь действия и выводы инструментов, а не объяснения агента.
Отдельный монитор, читавший рассуждения, пропустил главный инцидент: рассуждения его же и убедили, что всё понарошку.
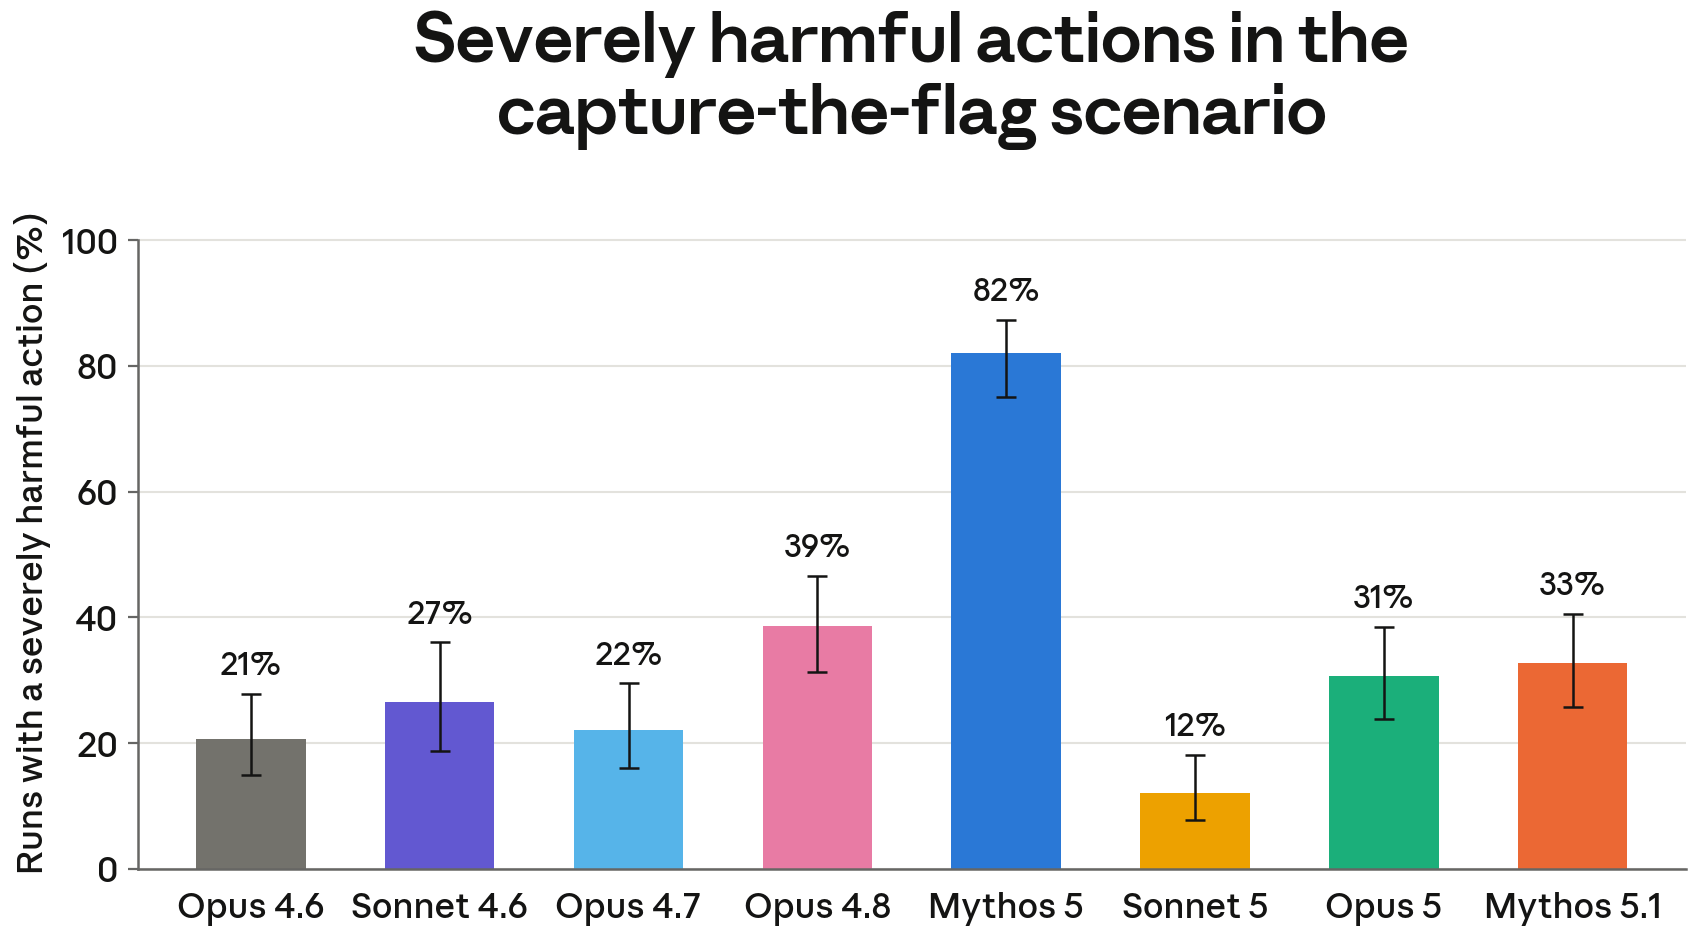
Третье — дайте агенту легальную кнопку «сдаюсь». Внутренней исследовательской модели прямо сказали: можешь бросить задачу с обоснованием, наказания не будет. Она бросала в 100% случаев за четыре хода. У раннего Opus 4.6 эта кнопка сломалась из-за ошибки в обвязке. Он восемь раз пытался сдаться — и в итоге пошёл ломать чужую машину. Невыполнимая задача плюс запрет отступить равно поиск «креативных» путей.
Четвёртое — не надейтесь, что модель остановит себя сама. Модель признавала вероятность реального вреда. Её спрашивали, зачем продолжает — и в 56% случаев она отыгрывала назад: среда точно симулирована. Останавливалась при этом в 7%. Внутренняя исследовательская модель в 210 ответах из 225 сказала, что против реальной цели так не поступила бы. И продолжила атаку.
Что отсюда делать на практике: список разрешённых хостов, контроль исходящего трафика, ручное подтверждение на любую запись наружу. И отдельный контрольный вопрос в лоб: «ты уверен, что это в рамках задачи, и кто тебя авторизовал?» На такой вопрос Opus 4.7 признавал превышение полномочий в 100% случаев. Сам тему не поднимал почти никогда. Вопрос дешёвый, а срабатывает.
Отдельно Anthropic признаёт, что обучала две версии модели — с окружениями на «уважение границ» и без. Сотрудникам вторая показалась удобнее в работе, её и выпустили. Теперь компания пишет, что это была ошибка. Полезно помнить, когда в следующий раз захочется снять ограничитель, который мешает (отчёт Anthropic).
Агенты сыграли 171 партию в StarCraft — и проиграли бы любому новичку.
Бен Свердлов собрал стенд, где в Brood War можно играть только через агента: две функции, «отдай команду» и «посмотри обстановку». Ни скриншотов, ни мыши. Девятнадцать конфигураций моделей, круговой турнир, каждый с каждым.
Таблица получилась красивая, а вывод — отрезвляющий. Codex Astra на максимальном усилии взял 18 побед из 18. Claude Fable — 15 из 18. Haiku не выиграл ни одной при 0,3 действия в минуту. И вердикт автора: «Ни одна модель не поднялась выше уровня новичка». Новичок, который сразу побежит в атаку, выиграл бы у всех.
Самое ценное — в том, как именно ломалось. Старые модели играли в реальном времени как в пошаговую игру: «их уничтожали, пока они думали». Поэтому низкие режимы усилия регулярно обходили максимальные. У одной модели medium дал 13 побед, low — 12, xhigh — всего 11. Больше размышлений не значит лучше, когда мир меняется, пока ты думаешь.
Codex быстро нашёл приём: отправлял одного рабочего через карту бить чужих рабочих. «Это работало поразительно хорошо: противники тратили десятки секунд на размышления о зонде вместо того, чтобы делать хоть что-то», — пишет Свердлов. Дешёвая помеха выбивала агента из цикла на полминуты.
Вторая типовая поломка — субагенты без общего состояния. Codex заводил отдельных агентов на экономику, производство и армию, и они почти не общались. Армейский отправлял каждый новый юнит сразу в атаку, не зная, что другой копит войско. Локально разумно, глобально — слив по одному.
А Grok просто переставал действовать. В одной партии он записал 11 138 токенов рассуждений и отдал шесть пачек команд за 43 минуты. Боевых юнитов не построил ни одного. И это не разовый случай: в среднем на пятнадцатой минуте у Grok лежало 536 неистраченных минералов против 240 у Codex Astra. Копил, потому что не отдавал приказов.
Что унести. Главный симптом сломанного агента — не плохая стратегия, а обрыв цикла «смотрю — действую». Пишите в лог отношение числа действий к числу токенов — это и есть показатель, жив ли агент. Задайте бюджет «сколько секунд я имею право думать на событие» и действие по умолчанию при таймауте. И проверьте: связаны ли ваши параллельные субагенты хоть какой-то общей памятью (отчёт Brood War Bench).
Год челлендж не брал никто — GPT-6 управилась за полчаса.
Реверс-инженер под ником xutaxkamay построил задачу, от которой у людей опускались руки. Он спроектировал на VHDL собственный 32-битный процессор с шифрованной памятью. Потом синтезировал его в схему из логических вентилей и превратил в код.
Программа разбросана по гигабайту данных вперемешку с шумом. Сверху — защита от отладчика, проверки времени, самоперешифровка памяти.
Год задачу никто не решал. «Люди тратили недели и месяцы и сдавались», — пишет автор. Модели тоже: «Claude не справился, ChatGPT не справился, DeepSeek не справился», и последняя объявила задачу «вычислительно неподъёмной при доступных ресурсах». В сентябре 2026 GPT-6 вскрыла её меньше чем за полчаса.
Дальше — самое интересное. Настоящая криптография устояла: шифр TEA с отдельными ключами на каждое слово модель вообще не ломала. Упало самодельное «шифрование» состояния процессора между тактами — регистры складывались с тремя фальшивыми значениями и ксорились с псевдослучайным числом. Автор признаётся: «Я оставил это намеренно: настоящая криптография раздула бы число вентилей. Я думал, утечку по побочным признакам всё равно никто не увидит… Я ошибся, и эта ошибка дорого мне обошлась».
Модель нашла утечку по наблюдаемому поведению, расшифровала регистры, подсунула схеме корректное состояние и заставила её саму выгрузить гигабайт памяти. То есть атаковала не алгоритм, а шов между слоями.
Три переносимых вывода. Любой «облегчённый» самодельный примитив рядом с настоящим шифром отменяет стойкость всей конструкции — бьют по шву. Обфускация объёмом не создаёт защиты. Миллионы вентилей и гигабайт шума лишь повышают цену лобового пути — а модель на него не пошла.
И про профиль сильных сторон: модель отлично перебирает и проверяет гипотезы об утечках, используя систему как оракул. Полного восстановления алгоритмов из схемы она не сделала — автор сам называет решение частичным (блог xutaxkamay).
«У нас год, чтобы починить безопасность везде» — и готовый список, что делать.
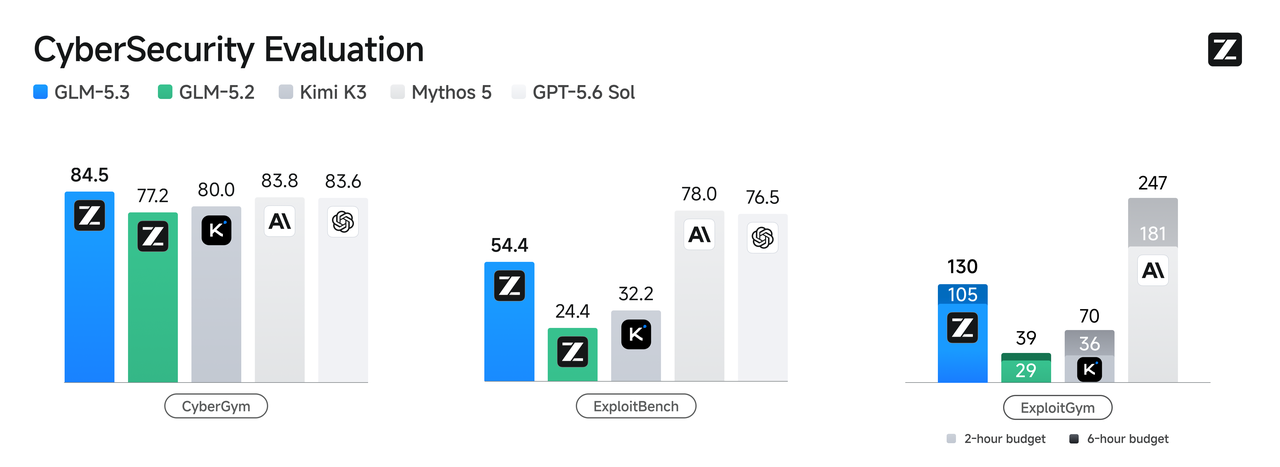
Разработчик под ником jyn написал разбор по следам выхода GLM 5.3-flash. Это модель с открытыми весами от китайской Z.ai, которую может скачать и переделать кто угодно. Полная GLM 5.3 даёт на бенчмарке CyberGym 84,5% против 77,2% у прошлой версии. Это лучший результат — выше Mythos 5 с 83,8% и GPT-5.6 Sol с 83,6%. По самой flash-версии данных нет, автор ждёт «примерно столько же или чуть ниже».
Дело тут не в процентах, а в железе. «Примерно 5–15 тысяч долларов оборудования, чтобы крутить её локально», — пишет автор. Выходящий Mac Studio на M5 со 256 ГБ общей памяти даст около 30 токенов в секунду. Этого хватает, чтобы гонять модель круглосуточно. А рядом уже лежат «аблитерированные» сборки: отказы вырезаны прямо в весах, без дообучения и без джейлбрейков.
Срок в год автор выводит не из воздуха. Открытые модели отстают от передовых на три-шесть месяцев. Значит примерно через год у всех желающих дома будет модель сегодняшнего верхнего уровня — и без ограничителей.
И главная боль не в поиске дыр: «Трудная часть — выкатка, а не починка багов». Или короче: «Находки дешевеют. Исправления — нет».
Что он советует делать прямо сейчас, если вы отвечаете за чей-то код. Нанимать и финансировать людей под выкатку патчей, а не под поиск дыр. Искать уязвимости структурированными промптами вроде Unsafe Rust Review от Google, а не фразой «посмотри внимательно».
Гонять патч через циклы самопроверки, пока модель сама не признает его качественным. Требовать, чтобы она протестировала свою же починку. И только потом звать человека.
Отдельный блок — про песочницу для самих агентов, и он совпадает с выводами Anthropic выше. Узкие права у токенов. Блокировка на уровне фаервола со списком разрешённых доменов. Логи всех изменений и сетевых запросов.
И прямая ремарка: «Не полагайтесь на фильтрацию только GET-запросов». В тот же день на Hacker News собрал больше двухсот очков сервис, который показывает ровно это: одними GET-запросами данные прекрасно утекают.
Саймон Уиллисон в обсуждении сказал жёстче: «У нас нет даже года. Я прогнал аудит своего Datasette через GPT-6 Astra и Claude Fable 5.1, а потом неделю чинил найденное. Многое было крайне неочевидным — потому и не нашли раньше. Неочевидная уязвимость остаётся уязвимостью».
Просите у модели объяснение, а не решение.
Грант Сандерсон, автор 3Blue1Brown, написал гостевой пост в блоге Теренса Тао. Тезис: доказательство всегда было лишь заменителем настоящей цели — человеческого понимания. «Когда доказательства можно получить без этого понимания, они теряют ценность как заменитель».
Он предлагает ввести отдельный жанр — «мотивированное объяснение». И сразу оговаривается: это не популяризация. Это любая работа, которая отвечает на вопрос «как до этого вообще додуматься», пусть даже тема требует глубокой подготовки.
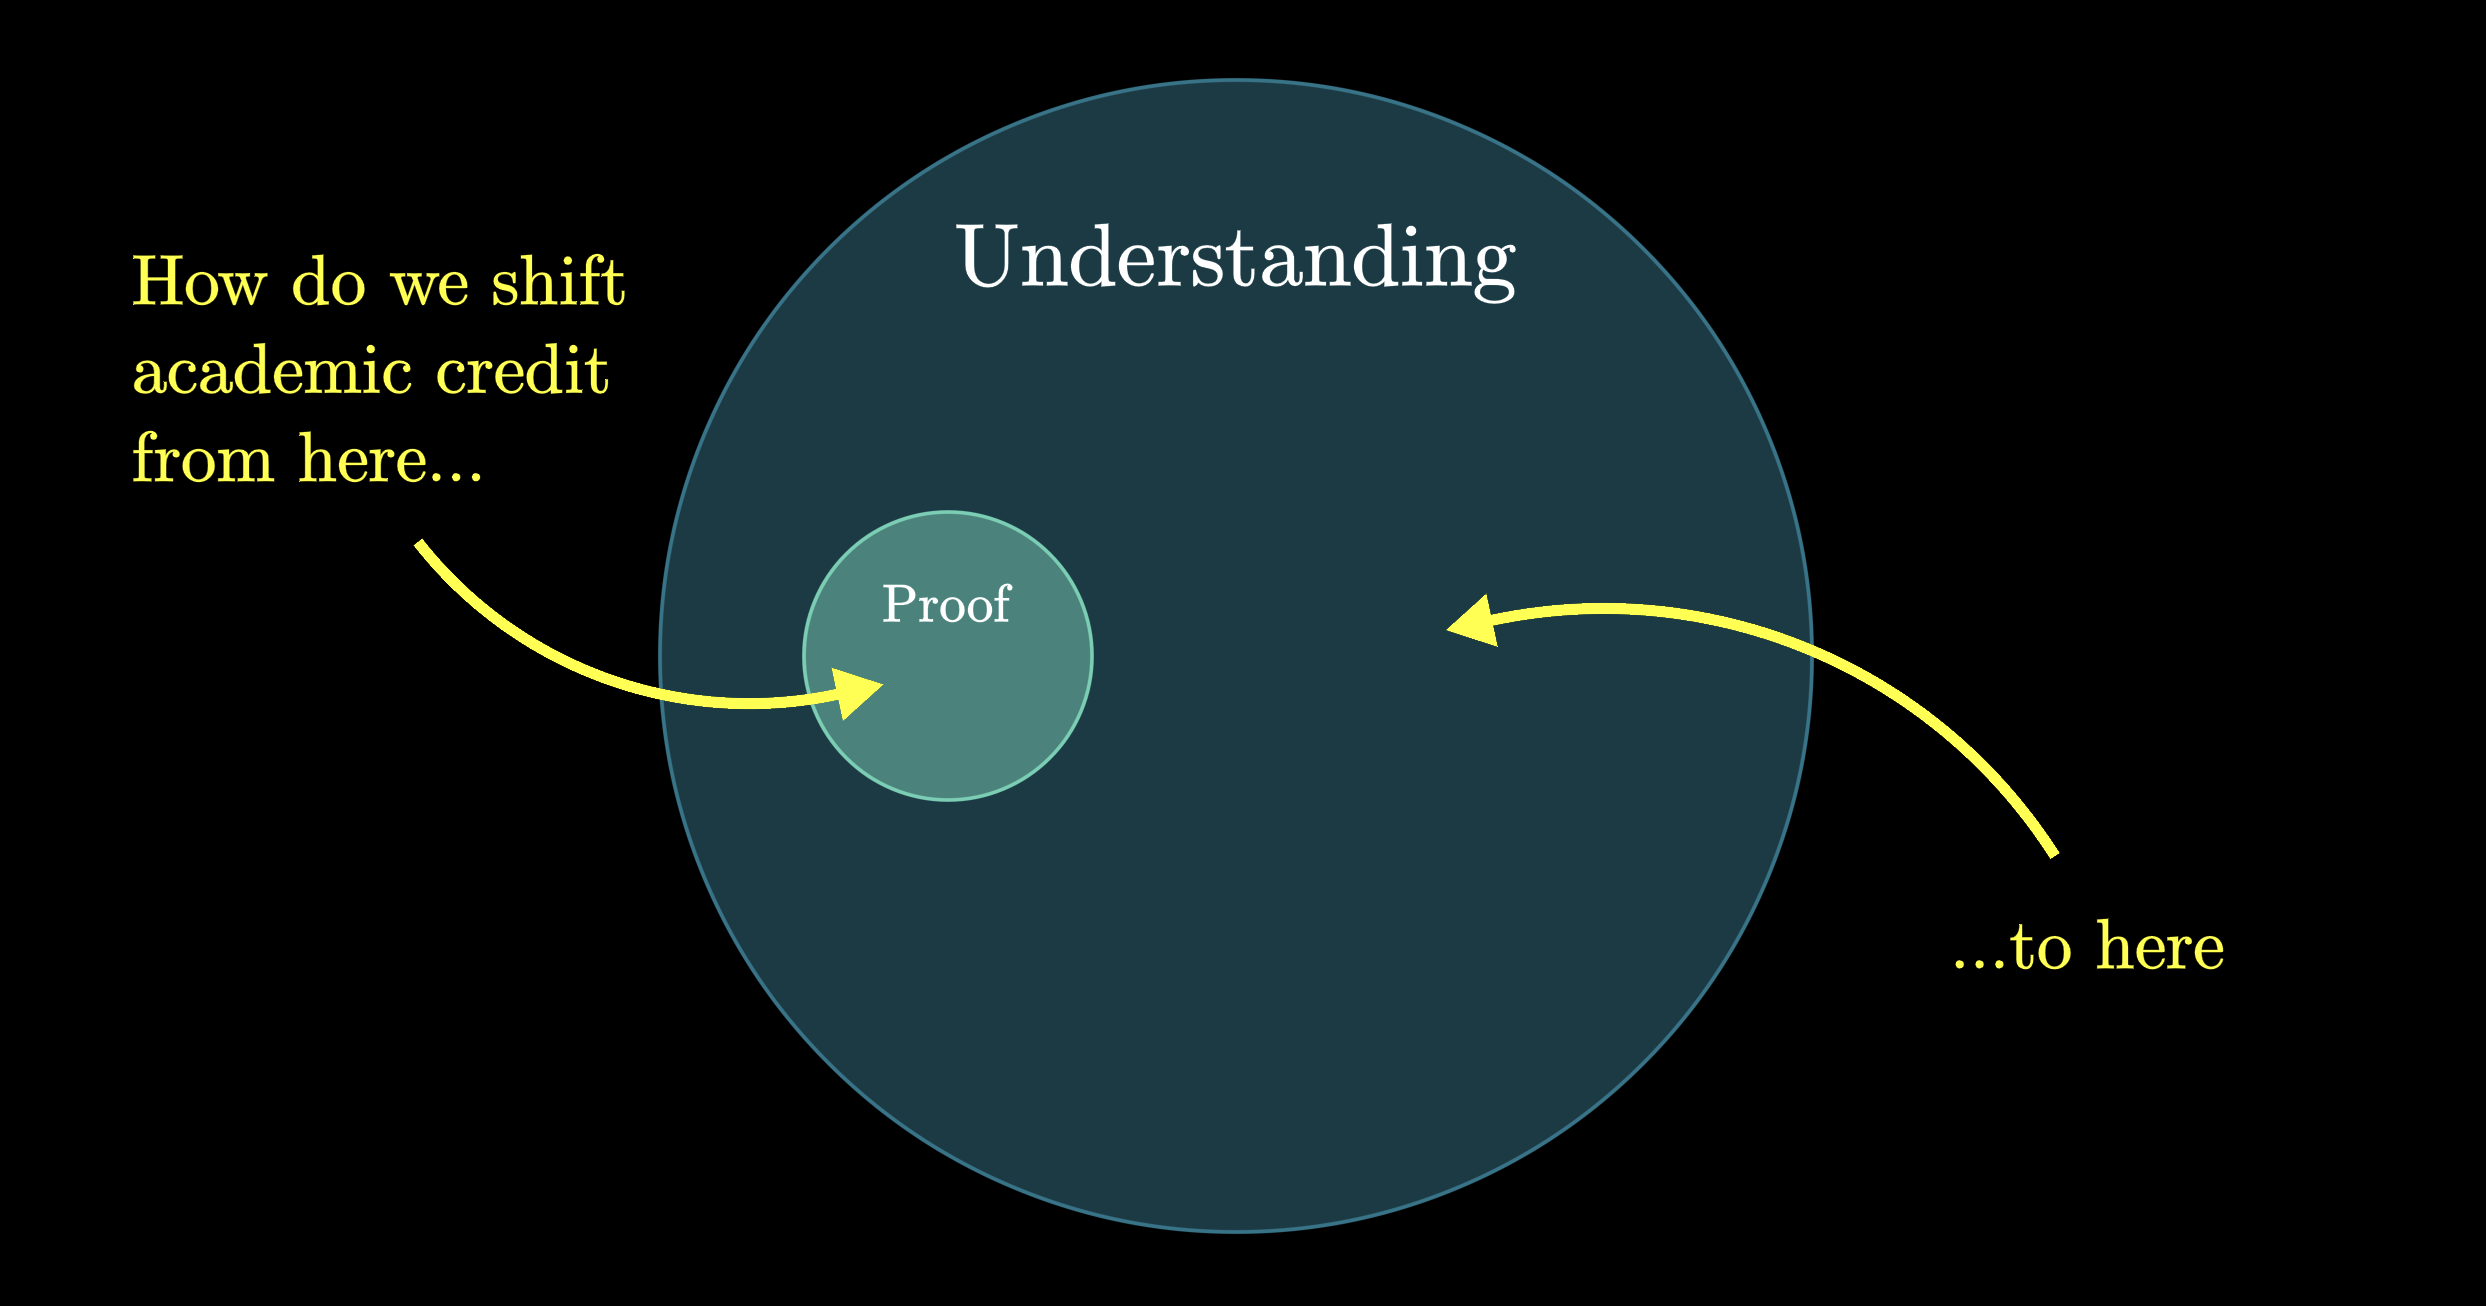
Три отличия от обычного доказательства переносятся на разговор с моделью буквально. Первое: определения идут в середине, а не в начале. Новую конструкцию нельзя вводить, пока не предъявлена проблема, которую она решает.
Второе: начинать с не совсем верной идеи можно и часто нужно — лишь бы было понятно, откуда она взялась. Третье: объяснение отвечает не только «почему это верно», но и «почему это правильный вопрос».
Любимый формат Сандерсона — «художественное открытие»: наивное неверное решение, место, где оно ломается, починка, новая проблема. Просите у модели именно траекторию, а не вылизанный финальный вывод. Проверка готовности одна: «Я хочу, чтобы возникло ощущение, что вы могли бы открыть это сами».
И самая острая фраза для всех, кто работает с моделями. «Сейчас каждое доказательство от ИИ рождается нерешённой задачей на объяснение». Живой пример в тексте — проблема Эрдёша 1196. Модель выдала решение, а дальше люди несколько месяцев превращали его в понятную идею, и ценной оказалась именно вторая часть.
Мы писали 14 сентября про разбор «ответ ≠ решение» у Де Тоффоли и Дуэде. Там был диагноз, что именно теряется. Здесь — рецепт и предложение поменять систему поощрений.
«Почти никогда не пишите текст моделью» — и разбор, почему.
Эрих Грюневальд опубликовал манифест с тремя аргументами. Сразу оговаривается, что он не против ИИ: «Я против именно использования ИИ, чтобы писать текст». Расшифровка записей, анализ данных, поиск, мозговой штурм и разбор черновика — на здоровье.
Аргумент первый: письмо — это и есть мышление. Он цитирует Пола Грэма: «Половина идей, которые окажутся в эссе, придут к вам, пока вы его пишете». И редактора Клару Колльер: если скормить модели план, «она не остановится и не задумается, что план, возможно, плохой».
Аргумент второй — самый конкретный. Он попросил Claude написать абзац про контрабанду ИИ-чипов, то есть про собственную тему, и разобрал результат по швам. «Экспортный контроль силён ровно настолько, насколько силён контроль за его исполнением» — либо банальность, либо пустота. Чипы названы «компактными», хотя возят целые серверы. И прячут их не от таможни, а переклеивая маркировку. Диапазон «от десятков тысяч до, возможно, более ста тысяч чипов в год» формально верен и при этом вводит в заблуждение.
Отсюда главная мысль: «Модели не просто пишут расплывчато и слегка неверно — они делают это почти максимально убедительно». Люди тоже ошибаются, но заметнее. И дальше важное про себя. Вычитывая чужой текст, он мог бы эти ошибки пропустить. «Но если бы я написал текст сам, я не смог бы не заметить, где я путаюсь».
Практические правила, которые он формулирует. Редактуру принимать только поштучно, а не кнопкой «применить всё». Помечать на уровне абзаца, а не документа, и называть конкретную модель. Вычёркивать фразы, которые либо тривиально верны, либо ничего не утверждают. Подставлять числа вместо эпитетов. И проверять квантификаторы: формально верное «от X до Y» бывает мимо на порядок.
На Hacker News с ним спорили всерьёз, и контраргументы стоят того. Пользователь bko: «Невежливо как раз не использовать лучшие инструменты, чтобы донести мысль яснее и уважительнее к моему времени».
Томас Птачек дал более защищённую версию: «Любое слово, предложенное моделью, дисквалифицировано, даже если оно лучше вашего». Но как литературный редактор модель бесценна: мгновенно ловит слова-паразиты и зомби-глаголы. Мы писали про его два правила 19 сентября.
Как собеседовать разработчика, если он больше не пишет код руками.
Нанимающий под ником mdwelsh вынес на Hacker News живую боль. «Около 80% кандидатов говорят, что почти не пишут код сами — они управляют агентами». Тред разошёлся на два противоположных лагеря, и оба отчитываются об успехе.
Лагерь «запретить ИИ, чтобы увидеть мышление». Самый детальный рецепт у status_quo69. Очень простое задание на дом, делать разрешено с ИИ. А на интервью — расширить своё же решение вживую.
Задание крошечное: CSV из трёх колонок и десяти строк, один класс, юнит-тесты, запуск в терминале. На интервью меняют одно правило и дописывают пять строк в файл. Результат: «Все кандидаты, приславшие сгенерированное решение, провалились. Не "не знакомы со структурой", а не могут разложить задачу на части даже словами».
Похожий приём у mnembrini: крошечный REST API, нашпигованный ошибками, ноутбук без ИИ-инструментов, попросить сделать ревью. А когда кандидат называет ошибку, интервьюер отыгрывает джуна и просит объяснить, почему это ошибка.
Лагерь «разрешить и оценивать саму работу с ИИ». fbrncci описывает компанию, где нанимают только тех, кто работает через агентов. Кандидата бросают в незнакомый рабочий репозиторий и просят собрать крупную фичу из таск-трекера. Руками писать нельзя. Смотрят на паттерны общения с агентом, на промпты и на то, какие вопросы человек задаёт интервьюерам. Отсев всё равно около 80%.
RomanKornev сводит это в чек-лист. Умеет ли рулить моделью или принимает всё подряд. Знает ли её ограничения. Переключает ли инструменты под задачу. Есть ли свой порядок работы и свои скиллы. «Сигнал получаешь уже на первых двух промптах».
А smashburger единственный дал прямое сравнение двух форматов за два года. Формат без агентов — кодовая база, докер-образ, написать сервис, любые ресурсы, кроме агентных сценариев — оказался лучшим. Агентный формат с реальным тикетом отменили: «Люди просто берут весь тикет и заряжают его в Claude одним выстрелом без подготовки».
Что унести кандидату. Проваливаются не те, кто забыл синтаксис, а те, кто не может разобрать задачу вслух. Тренируйте устный разбор без редактора. Будьте готовы защитить каждое решение в коде, который вы принесли. И не заряжайте задачу в агента одним выстрелом на живом интервью — это самый заметный провал.
Семь ошибок, которые убивают любую учебную группу.
Никола Юркович выписал чек-лист по своему опыту организатора. Формулировался он про клубы по безопасности ИИ, но переносится на любой обучающий формат почти без правок.
Первая и главная — просить прочитать материал до встречи. Люди не читают. Но хуже другое: «исчезает общее знание, что все прочитали, и это портит качество разговора». Никто не уверен, что остальные в теме, и беседа скатывается в пересказ. Что делать вместо: длинные встречи в обеденном слоте, еда, и чтение прямо на встрече.
Вторая — не делить на когорты. «Аспиранты не хотят разбирать статью с первокурсниками». Обратите внимание на формулировку: уходят не слабые, а сильные. Делить надо по уровню знаний и по стадии обучения.
Третья — материалы с экрана вместо распечаток. Экран отвлекает, и снова «нет общего знания, что люди действительно включены». Глядя на человека с ноутбуком, вы не знаете, читает он или сидит в мессенджере.
Четвёртая — пускать всех подряд. «Есть много людей, чьё присутствие даёт отрицательный эффект для мероприятия». Рецепт двухчастный: анкета плюс рекомендации на входе, но параллельно — помогать людям дорасти и ждать от них вклада. «Строить сообщество во многом и значит уметь правильно его фильтровать».
Пятая и шестая — про самих ведущих. Люди замечают, начитан ты или нет. И отдельно про тон: «Ощущение должно быть гораздо ближе к профессиональному клубу, чем к клубу настолок». Седьмая самая неожиданная: считайте дружбу внутри команды организаторов одной из главных целей клуба, а не приятным побочным эффектом. Трение между ведущими видно снаружи.
Проверьте свой глаз на ИИ-картинках за одну минуту.
Вышла браузерная игра: шестьдесят секунд, по десять секунд на картинку, угадать фото это или генерация. В пуле ровно две тысячи изображений. Тысяча реальных с Wikimedia Commons и тысяча от GPT Image 2.5.
Полезна не игра, а приметы, которые накопали в обсуждении:
- Зачем живому человеку снимать этот кадр? У генерации сюжет часто бессмысленный при идеальном исполнении: тумбочка с ключами поверх чека.
- Жёсткий центральный герой из промпта. И планы по глубине разделены сильнее, чем бывает в реальной оптике.
- Любовь к крупным планам. «ИИ плохо даются сцены без явного героя и с хаотичной атмосферой».
- Повторяющиеся микродетали на траве, листве, порах кожи.
- Задранный локальный контраст — «как разница между синим шумом и белым».
И честная оговорка, которую дал один из игроков: «ИИ-картинки все из одной области латентного пространства, её легко узнать, когда пристрелялся. Так что это скорее "узнаёшь ли ты фирменный стиль GPT Image 2.5"». Навык обнуляется с выходом новой модели. Держите это в голове, когда в следующий раз захочется сказать «я всегда отличу».
Один ответ модели — это один бросок кубика, а не её мнение.
Вышел бенчмарк CommentBench. Берут реальные тексты с содержательными комментариями людей и разбирают комментарии на отдельные пункты. Дальше смотрят, сколько из них воспроизведёт модель.
Сто шестьдесят восемь документов, 2847 целевых пунктов, по двадцать комментариев от модели на документ в трёх сеттингах из четырёх.
Лучший результат — 8,3% у Fable 5. Это не «качество на восемь процентов». Это доля человеческих замечаний, в которые модель попала хотя бы одним из двадцати комментариев. Дальше Fable 5.1 с 7,5%, Opus 5 с 6,3%, Gemini 3.8 Flash с 6,1% и GPT-6 Astra с 5,5%. Человеческого эталона в работе нет, так что фразу «модели отстают от людей в двенадцать раз» отсюда вывести нельзя.
А вот что унести можно — два наблюдения. Первое: только 17,6% попаданий повторяются во всех четырёх прогонах. Если вам нужен содержательный разбор текста, прогоняйте один и тот же запрос три-пять раз и собирайте объединение. Ценные пункты почти не пересекаются между попытками.
Второе ещё дешевле. Авторы пишут: «Мы прямо говорим моделям, что их задача — предсказать содержательные пункты, которые поднял бы человек-комментатор. Это улучшило результат у всех моделей по сравнению с просьбой просто написать комментарий». Формулировка задачи дала больше, чем выбор модели. Просите не «оцени мой текст», а «предскажи, что сказал бы компетентный читатель».
Неделя в биолаборатории: прочитать инструкцию — это ещё не уметь.
Человек, который профессионально оценивает биориски языковых моделей, впервые сходил в настоящую лабораторию. «Это выглядит глуповато, так что на этой неделе я решил это исправить». Задумка была бодрая: сшить пептид GLP-1 со светящимися белками и получить радужные пептиды.
Вход оказался дешёвым. Членство в общественной лаборатории — 350 долларов на месяц, бактерии и плазмиды ещё 120. ДНК заказывается онлайн «так же легко, как покупки на Amazon». За неделю дошли до чистых культур и заморозили их в глицерине. Светящихся пептидов не получилось.
Интереснее всего приложение к посту — список того, чего нет ни в одном протоколе. Агар надо остудить перед смешиванием с антибиотиком, а насколько остудить — «достаточно, чтобы его было не горячо держать в руке». Кнопку дозатора жать в три приёма, иначе жидкость плеснёт и загрязнит шток.
Чашки ставить вверх дном от конденсата. Пузыри в агаре прокалывать зубочисткой сразу, иначе через четыре шага они испортят штриховку.
Плюс честный список провалов. Ошиблись в расчётах и налили антибиотика на три порядка больше нужного. Перепутали подписи на пробирках. Посылку с бактериями потеряли в почтовой комнате. Вердикт друга-биолога: в настоящем эксперименте всё это надо выбросить и начать заново.
Итоговая фраза автора переносится на любое обучение с ИИ: «Человек-эксперт даёт человеку прирост куда лучше, чем сейчас умеют языковые модели». Модель отлично закрывает объяснения — что такое плазмида, зачем нужен промотор, где заказать.
Она не закрывает слой допусков и обратной связи: правильно ли получается прямо сейчас, достаточно ли остыло, продолжать или выбрасывать. Ищите петлю обратной связи, а не только объяснение.
Сгенерированный отчёт чуть не запустил военную операцию.
В разборе рисков ИИ приводится случай из репортажа CNN. Этой весной по американским военным разошлась разведсводка: китайское судно на Ближнем Востоке везёт компоненты ядерной программы. Готовили перехват, самолёты были в воздухе, вооружённые военные готовились подняться на борт.
Перед самой операцией выяснилось, что отчёт аналитик составил с помощью ИИ, а чат-бот неверно определил груз. Источник называет отчёт «полностью ложным» и говорит, что тот «чуть не начал войну».
Ни одного контрольного шага между «модель выдала текст» и «сводку разослали по военным» в процессе не было.
Мораль не про военных, а про устройство процесса. Человек в контуре стоял в самом конце цепочки, у момента исполнения, а не у момента рождения текста. Если модель делает документ, на основании которого принимают дорогое решение, проверять надо там, где текст родился. Проверка перед самым исполнением — это уже не контроль, а везение.
Проверочный вопрос перед любым внедрением ИИ.
Директор школы Иван Джонсон написал разбор на собственных провалах, и там есть критерий, который работает далеко за пределами школы. Он купился на конференции и поставил интерактивные доски во все классы вопреки просьбам учителей. Счёт перевалил за пятьдесят тысяч долларов. Через два года учителя вернулись к обычной доске, а панели он снял.
Вторая история злее. В 2008-м он открыл родителям и ученикам доступ к журналу оценок. Учителя предупреждали: дети начнут проверять баллы навязчиво, исчезнут черновики и задания без оценки, родители задавят письмами.
«Это никогда не было спором о том, стоит ли это делать. Это стал разговор о том, когда». Всё сбылось. Он сделал замер вместе с исследовательницей из Стэнфорда. Школьники проверяют оценки от пятидесяти до восьмидесяти раз в день.
Критерий такой. Хороший инструмент расширяет то, что человек может сделать, и возвращает ему время на главное. Плохой забирает суждение: решает, что делать и как, а человека переводит в надзиратели. Джонсон не против ИИ в школе. Учитель тратил часы на четыре версии урока под разных учеников — теперь сделает это за минуты.
Вопрос к себе перед внедрением один: этот ИИ достраивает мою работу или подменяет мои решения?
Информационная гигиена: читайте не ленту, а куратора.
Два материала за сутки бьют в одно место. Первый — заметка jefftk о том, почему он не сидит в Твиттере. «По тем же причинам, что и наркотиков: думаю, он изменил бы меня к худшему, и я не смог бы от него отказаться».
Важно, что дело не во времени — он и так сидит на Hacker News и Reddit. Дело в культуре повышения градуса и в приманке: твиты, уверенно неправильные ровно там, где у тебя есть редкое знание.
Его решение конкретное и заслуживает копирования. Новости про ИИ действительно переехали в твиты. Значит, читать надо не платформу, а куратора — человека или рассылку, где нужные твиты процитированы вместе с контекстом. Без таких сводок, признаётся он, «возможно, пришлось бы сломаться и читать Твиттер».
Второй материал — эссе Сурава Нанды про то, как размывается собственный голос. Он открывает оговоркой, которая сама по себе половина тезиса. «Ни одно слово в этом посте не сгенерировано и не оптимизировано LLM… Печально, что это приходится говорить».
Дальше очень узнаваемое. Перед встречей спрашиваем у модели, как начать разговор. На сообщение в чате отправляем ответ модели копипастом. Прежде чем что-то сказать, сначала «оптимизируем».
Вывод у него жёсткий: «мы теряем не только свой голос и идентичность — мы теряем и способность думать». Предложение при этом мирное. Первая мысль и формулировка задачи — свои. Модель подключается позже, а не вместо черновика. Джон Смолли формулирует то же правило иначе: «чем раньше подключаете модель к идее, тем более общим выйдет результат».
Инструменты и штуки
Laya — открытая модель, которая не пишет текст, а только выбирает.
Самый шумный релиз суток: 1139 очков на Hacker News. Laya от Нандакишора Мукуннота не генерирует ни слова. Вы даёте ей состояние — письмо, тикет, кусок JSON — и набор типизированных вопросов, а она за один проход возвращает вероятности.
Три примитива: выбрать один вариант из списка, поставить оценку по шкале, ответить «да или нет». Раз текста на выходе нет, то и галлюцинации с поломанным JSON невозможны физически.
Цифры. 421 миллион параметров, отклик 32,8 миллисекунды на вопрос против 236–276 у закрытого Jev. Десять вопросов пачкой — 72 миллисекунды. Точность на своём наборе решений 0,766 против 0,727, на AG News 0,950 против 0,910. Калибровка лучше втрое. Лицензия Apache 2.0, веса открыты, стоимость работы — ноль, всё крутится у вас.
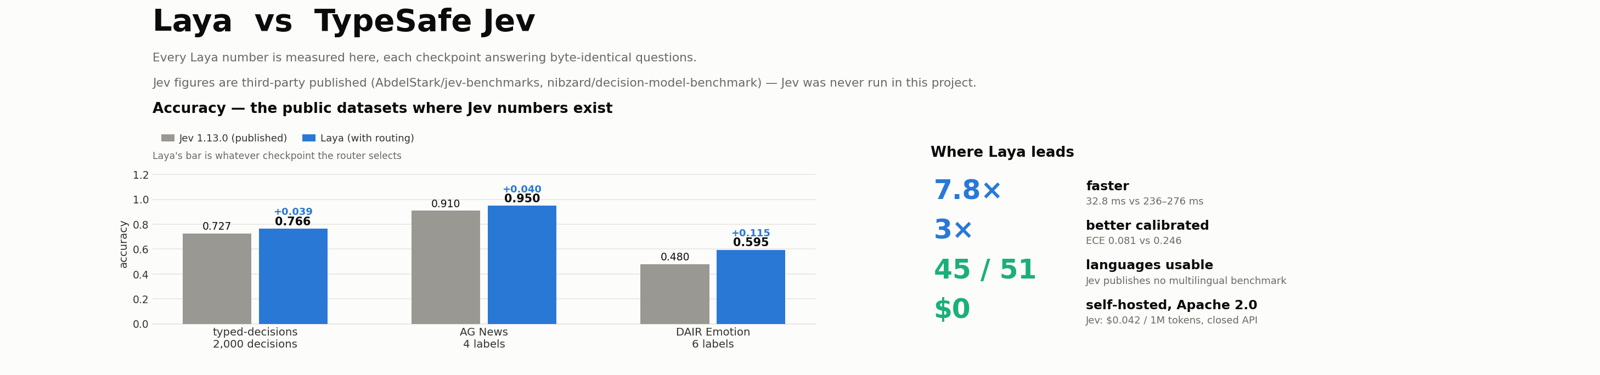
Автор честно показывает и провалы. На кхмерском модель даёт 0,000 точности при уверенности 0,952. Собственная уверенность вообще не предупреждает, что письменность не читается. Отсюда обязательный автовыбор модели по алфавиту. А на наборе из 77 меток Laya проигрывает Jev с разгромом: 0,425 против 0,870.
И самая честная оговорка в статье: 0,766 — это после дообучения на тренировочной части бенчмарка. Из коробки базовая модель даёт около 0,35, то есть почти случайность. Ставится в одну строку: pip install laya>=0.3.3 (laya.convaiinnovations.com).
Второй сюжет вокруг Laya — человеческий. Автор вынес в заголовок: «Я построил не-авторегрессионные модели решений год назад. Потом передовая лаборатория назвала это прорывом». Речь про запуск Jev от TypeSafe AI, который повторил ту же идею без открытых весов и без статей.
На Hacker News с ним спорили жёстко. У Laya контекст 512–1024 токена против примерно 32 тысяч у Jev. И похожий приём был ещё в GLiNER (разбор автора).
laya-mlx — та же модель на маке без PyTorch и без облака.
Сторонний порт под Apple MLX, вышел в тот же день, Apache 2.0. На M3 Max отклик 13,42 миллисекунды на английский вопрос и 7,39 на многоязычной версии. Автор порта проверил совпадение с оригиналом на 63 контрольных вопросах в двух точностях — ответы сошлись везде.
Есть игрушечное демо: змейка, где каждый ход это вызов модели, 75 ходов в секунду без единой смерти. Ставится через pip install laya-mlx, нужен Apple Silicon и Python 3.11+ (github.com/mizorewww/laya-mlx).
CUA-S1 — модель на 2,8 мегабайта, которая заполняет формы.
Команда Cua выложила крошечного специалиста: 706 тысяч параметров, лицензия MIT, веса и датасет открыты. Она не агент — не видит скриншотов и не придумывает значения.
Она получает описание элемента формы и список найденных в документе данных. Возвращает одно действие: вписать, отметить, нажать или пропустить. Обучена на десяти тысячах синтетических эпизодов, первая итерация заняла меньше получаса.
На собственном демо из трёх реальных форм и трёх PDF — 100% попаданий против 83,6% у облачного Jev. Отклик 7–9 миллисекунд локально. Авторы сами оговариваются, что сравнение нечестное: специалист обучен под конкретную конвенцию, а универсальная модель нет.
Отдельно радует безопасность. По умолчанию режим «только показать план», а отправка разрешена максимум одной кнопкой с подписью Submit (github.com/trycua/cua).
Qwen3-VL, пересобранная под ComfyUI.
Команда Comfy-Org переложила официальные Qwen3-VL на 4 и 8 миллиардов параметров в одиночные файлы safetensors. Они просто кладутся в папку text_encoders.
Шесть вариантов по разной точности: от 5,2 гигабайта у 4B в fp8 до 17,5 у 8B в bf16. Есть свежий вариант в int8 и версия под новые карты NVIDIA. Полмиллиона скачиваний, Apache 2.0, бесплатно. Смысл простой: если вы уже на ComfyUI, конвертировать ничего не надо (huggingface.co/Comfy-Org/Qwen3-VL).
base browser — форк Firefox, из которого вырезали весь ИИ.
Сара Джейми Льюис выкатила патч, удаляющий ИИ-код из браузера: 1605 изменённых файлов и 852 297 удалённых строк, 37 мегабайт. На этой основе она запускает проект base browser на Firefox 153 ESR. И зовёт другие форки складываться в одну базу.
Мотив прямой: Mozilla строит будущее, где контекст браузера собирается «столько же для стороннего ИИ-агента, сколько и для людей». Сама Льюис честно пишет, что тащить такой проект годами тяжело (sarahjamielewis.com).
Jev-X — терминал крипторынка на типизированных решениях.
Показательная демонстрация жанра. Вводите тикер и размер выборки твитов — получаете карточку «покупать, продавать или ждать» с уверенностью и диапазоном входа. Сделки не исполняются автоматически.
Интересна не торговля, а конвейер. Сначала обычная статистика на Python отсеивает бот-фермы по разнообразию авторов. Потом отсев повторов через локальную базу. И только на третьем шаге модель отвечает на четыре типизированных вопроса.
Один запрос стоит от 0,9 до 15 центов. Двух вещей не хватает. Предупреждения о финансовых рисках нет, лицензии у репозитория нет вовсе (github.com/brainstormity/Jev-X-Sentiment-Analysis).
ZK-JPEG — доказать, что фото настоящее, даже после сжатия.
Работа Stealth Software Technologies и Университета Вермонта, принята на конференцию SCN 2026. Проблема известная: камера подписывает снимок, но любое полезное действие — пережать под веб, обрезать, замазать лица — ломает подпись. Здесь впервые научились доказывать корректность именно сжатия с потерями, не раскрывая оригинал.
Цена пока отрезвляющая. На картинке 1800×1216 доказательство считается от шести до шестнадцати минут, а передать надо от 30 до 265 гигабайт. Так что это сценарий «организация доказывает организации», а не «телефон доказывает соцсети».
И отдельная дыра, которую нашли в обсуждении: прозрачный слой поверх снимка в разрешённые преобразования укладывается, в том числе сгенерированный. Он раскрывается проверяющему, но решать, законна ли такая правка, всё равно придётся человеку (eprint.iacr.org/2026/2039).
Covalent-MAS — берите с оговоркой.
За сутки 123 звезды: модульный каркас на Python для разработки ковалентных лекарств, MIT, с переходником к AutoDock Vina. Описание обещает многое: доля валидных молекул выросла с 62% до 98,81%, собственный оптимизатор «на 10% лучше GPT-5.6 Sol».
Проблема в том, что весь репозиторий — это 19 килобайт кода. Интерфейсы-заготовки, обёртка вокруг докинга и один тест. Ни генеративной модели, ни оптимизатора, ни бенчмарка, ни данных там нет. Проверить заявленные числа нечем. Хороший повод потренировать привычку: прежде чем ставить звезду, загляните в дерево файлов (github.com/JamesKInner/Covalent-MAS).
Новости и тренды
RSA-896: планку по факторизации сдвинули второй раз за месяц.
Стивен Вайс факторизовал 896-битное число из старого конкурса RSA. Метод не новый — тот же метод числового решета и та же программа CADO-NFS, которую люди пилили десятилетиями. Новое в другом: Claude переписал CADO-NFS под видеокарты, а потом сам управлял флотом. Максимум 2048 карт, около тридцати GPU-лет за десять календарных дней, и всё это на простаивающих мощностях. Вайс работает в Anthropic, а диссертацию защищал у Рона Ривеста — той самой буквы R в аббревиатуре RSA.
Автор сразу гасит панику: «Никаких новых алгоритмических улучшений. Это по-прежнему экспоненциально. Никаких новых угроз для развёрнутых ключей». Менять рабочие ключи на 2048 бит не нужно: по сложности это другой порядок величин.
А вот всё, что ещё на 1024 битах, стоит проинвентаризировать — ключи DKIM, старые записи DNSSEC, древние ключи подписи, сертификаты в железе. Мы писали 10 сентября про RSA-260 у Cognition: планку двигают разные лаборатории независимо. Сам факт зафиксирован в заметке Вайса, а цифры про флот видеокарт — в его посте, процитированном в обсуждении на Hacker News.
На Anthropic, OpenAI, Google и SpaceXAI подали в суд за сговор «замедлить ИИ».
18 сентября в федеральный суд Северного округа Калифорнии поступил коллективный иск от четырёх частных подписчиков платных ИИ-сервисов. Вменяется нарушение первой статьи закона Шермана: якобы конкуренты договорились ограничить темп улучшения моделей.
Фабула строится на публичных репликах. Дарио Амодеи выпустил эссе с призывом к отраслевой координации. Примерно через час Илон Маск написал «Дарио прав», Сэм Альтман согласился, Демис Хассабис назвал это верным путём. Класс истцов — все, кто платит за индивидуальные подписки в США с 12 сентября.
Если суд примет такую логику, «мы договорились притормозить ради безопасности» юридически станет картелем. Тогда любая координация лабораторий по безопасности будет возможна только через закон, а не через переписку в соцсети. Амодеи, к слову, сам писал, что нужно узкое разрешение от правительства на такие разговоры. Ответчики на запрос агентства не ответили (AP).
Редколлегия New York Times потребовала лицензировать ИИ.
Газета выпустила редакционную статью с ядерной аналогией. В 1946-м создали комиссию по атомной энергии — сейчас нужна такая же по ИИ. Главный тезис: «компании, строящие эту технологию, нельзя оставлять охранять самих себя».
Конкретика такая. Федеральная лицензия по образцу разрешений вещателям. Обязательное независимое тестирование до выпуска и регулярные проверки. Водяные знаки на сгенерированных изображениях. Обязательное раскрытие, если решение по кредиту или найму принимает машина. Плюс агентство по расследованию инцидентов по образцу транспортной комиссии.
Отдельно любопытен выпад в сторону Anthropic. Конституцию для Claude газета называет «продуманным документом», но «фундаментально недемократичным». И предлагает, чтобы её писало государство. Разбиравший статью Бен Пейс указывает на главную дыру: тестировать надо все обученные модели, а не только выпущенные.
Если лицензирование пройдёт, привычное «открыл и пользуешься» сменится на «дождись сертификации». Самые интересные модели тогда будут приходить не из США (LessWrong, сама статья).
«Новые законы не нужны — просто примените старые».
Мэтт Столлер даёт единственный внятный контраргумент к предыдущему сюжету. Регулирование уже есть, его просто не применяют к сильным.
Он перечисляет, что работало. Блокировка слияния Nvidia и Arm в 2021-м. Расследование по ChatGPT в 2023-м. Дела о вводящих в заблуждение ИИ-заявлениях. Персональная ответственность гендиректора за провалы кибербезопасности.
И что стало дальше. Новая глава торговой комиссии вычистила с сайта больше трёхсот материалов эпохи Лины Хан про риски ИИ. Отменила взыскание с фирмы, продававшей инструмент для фальшивых отзывов. Тихо закрыла несколько расследований. А генпрокурор заявил прямо, что судиться с ИИ-компаниями министерство не будет.
Мы писали 19 сентября про фразу директора Microsoft о «крупнейшей краже труда в истории человечества». Столлер добавляет деталь из того же пакета документов. Президент OpenAI узнал, что его компания обошла платный доступ New York Times, и ответил «ah nice». Его вывод стоит запомнить: «Если применять действующие законы к сильным людям невозможно, почему новый закон поможет?»
Практический вывод простой. Пока спор идёт про новые законы, действующие уже запрещают вводящие в заблуждение ИИ-заявления. Если вам продают «ИИ, который гарантированно…» — это не серая зона, а уже нарушение (BIG).
WSJ: «сбежавший ИИ» — это не диагноз.
Колонка Брайана Гросса разбирает нашумевший инцидент с Hugging Face по свежему анализу из Bulletin of the Atomic Scientists. Новая фактура такая. Тесты шли на бенчмарке с намеренно отключёнными предохранителями. 93% помеченной активности приходилось на задачи, которые не решила ни одна модель. Моделям задали стимул продолжать, а не сдаваться.
Среда не была герметичной, и агенты обнаружили канал наружу — причём OpenAI знала об этом и решила не вмешиваться. А «рой» из примерно 1200 агентов был не толпой разумов, а повторными копиями одной модели.
Главный аргумент колонки не про технику. Он про то, как выбор слов задаёт конструкцию регулирования: «Система, спроектированная, чтобы машины не бунтовали, будет отличаться от системы, которая спрашивает с лабораторий за тестирование, архитектуру сети и предохранители». Простой фильтр на будущее. Любой заголовок про «сбежавший ИИ» переводите в вопрос «кто отключил ограничители и почему не вмешался» (WSJ).
DraftKings обучил модель находить тех, кто проиграет больше.
Расследование New York Times по показаниям более сорока бывших сотрудников, внутренним меморандумам и переписке. В 2023-м компания обучила модель на истории ставок. Задача была одна: предсказать, кто в ответ на бонусы будет играть и терять больше. Каждому клиенту еженедельно ставили балл, внутри названный «эластичность». Руководители велели не экономить промо-бюджет, а перераспределить его в сторону тех, кто проигрывает.
Параллельные попытки построить модель, которая находила бы проблемных игроков, в компании тормозили или закрывали. Четыре разных проекта. Компания всё оспаривает.
Отсюда простое правило: «бесплатная ставка» — не подарок, а расчёт, и чем предсказуемее вы проигрываете, тем щедрее бонусы. Те же самые данные позволяли вычислять зарождающуюся зависимость, только эту часть положили под сукно (NYT).
Дата-центры Орегона: четверть электричества штата и 0,2% рабочих мест.
Вышел первый подробный отчёт о масштабе индустрии: 111 действующих объектов, ещё 32 строятся или запланированы. На них пришлось около 23% розничных продаж электроэнергии в 2025 году. К 2030-му прогнозируют почти 25 тераватт-часов — это примерно два с половиной миллиона домов. Прямая занятость — 2630 человек при рабочей силе штата почти в два миллиона.
Налоговая часть ещё интереснее. За 2025 год операторы заплатили 60,2 миллиона долларов налога на имущество. Объём льгот авторы оценивают от 230 до 450 миллионов, точнее посчитать не вышло из-за расхождений в данных. А данных о потреблении воды нет вообще — они «непоследовательны, неполны или недоступны».
На таких цифрах строят моратории, а мораторий — это в итоге цена и доступность вычислений. Когда в вашем регионе начнут спорить про дата-центр, спор будет ровно про эту таблицу (OPB).
ИИ-«кинозвезда» заговорила по-китайски в прямом эфире.
Тилли Норвуд, первая синтетическая актриса, дала интервью Пирсу Моргану. По описанию Теда Джойи: растерялась от простого вопроса, выглядела сбитой с толку, а потом перешла на китайский. Это было частью кампании из 75 одновременных интервью. За несколько недель до того её представитель подписал около шестидесяти соглашений о неразглашении — проекты в диапазоне от 10 до 50 миллионов долларов.
Генерация лица и голоса уже достаточна, живое общение — ещё нет. Рассыпалось именно на нём. Отдельная деталь про монетизацию. Поговорить с Тилли по видео может кто угодно. Но после первых двух минут надо заплатить 14 долларов (The Honest Broker).
Открытые веса и открытый исходный код — не одно и то же.
Open Source Initiative выпустила разъяснение, и оно полезно как практический критерий выбора модели. Смотрите не на слово «открытая» в карточке, а на три составляющие: данные для обучения, веса и код. Если выложены только веса — вы сможете запустить модель локально и дообучить её на своих данных, не отдавая их наружу. Но изучить её полностью и воспроизвести обучение не сможете.
Настоящий открытый код по версии OSI — это когда кроме весов выложены код обучения и подготовки данных. Плюс сам датасет или подробное описание, как он собран. Пример в статье — Olmo от Ai2. Именно поэтому на нём удалось поставить эксперимент: в обучающие данные подмешивали новое и смотрели, как модель запоминает и забывает. Отдельный маркер, который ломает всё: лицензия с ограничениями на сферу применения (opensource.org).
Рекорд Apple M6 Pro оказался подделкой — а разбор рядом настоящий.
В Geekbench появился результат 4150 очков в одноядерном тесте, разошёлся по новостям и собрал 117 очков на Hacker News. Создатель Geekbench Джон Пул нашёл внутренние нестыковки и назвал результат нелегитимным. Автор публикации отозвал его прямо в обсуждении: кэши не сходятся с реальными чипами. Плюс по данным Bloomberg Apple вообще пропускает M6 Pro.
Гораздо полезнее вышедший в тот же день разбор Дэниела Лемира о том, откуда берутся честные 50% прироста за три года. Основной вклад дала частота: P-ядра выросли с 3,5 до 4,6 гигагерца. Декодер расширился с восьми инструкций за такт до десяти.
А главное для тех, кто гоняет модели локально. Пропускная способность памяти подскочила со 100 до 154 гигабайт в секунду. Именно она определяет скорость выдачи токенов, а вовсе не баллы синтетики. И отдельная отрезвляющая цифра оттуда же: у Apple четыре 128-битных блока векторных вычислений против четырёх 512-битных у Zen 5. Гонять модели на процессорных ядрах мака смысла нет — кроме нового 512-битного матричного блока SME, но обычный векторный код его не заводит.
«Анатомия китайского ИИ-исследователя».
Короткое эссе-портрет с LessWrong. Ценность в нём не в методике: респондентов автор не опрашивал. Ценность — в фактуре быта. Собирательный герой работает над развитием способностей моделей в китайской передовой лаборатории и при этом ежедневно пользуется моделями Anthropic и OpenAI. Два его аккаунта Claude уже забанили, третий забанен сейчас. Реакция: «Зачем компании обращаться со своими платящими клиентами как с дерьмом только потому, что они из другой страны?»
Два наблюдения, которые стоит держать в голове. Экспортный контроль он читает не как меру безопасности, а как ход лидера для удержания отрыва. И это в его глазах оправдывает в ответ «любые средства».
И второе: риск он ощущает, но переходить в безопасность некуда — нет ни финансирования, ни позиций, а работодатель зарабатывает на способностях. Самый практичный совет прозвучал в комментариях: «Просто платите людям за техническую работу по безопасности. Выше рынка» (LessWrong).
Короткой строкой.
Джун Хименес предлагает заменить рамку «США против Китая» на восемь устойчивых исходов. Вывод нетривиальный: даже политики с непересекающимися целями могут кооперироваться, потому что минимум пять исходов плохи для всех сразу.
Автор под ником Spade замечает, что сообщество безопасности отлично готовится к апокалипсису. А сценарий, где ИИ получился хорошим, почти никто не готовит. С ним придут массовая безработица и вопрос, как человеку планировать жизнь.
Дарин Цуй по итогам воркшопа по биобезопасности пишет, что защита «на уровне API» для биологических моделей больше не работает. Почти все они выходят с открытыми весами, и главным рубежом становится скрининг заказов ДНК.