Документация обещала: на максимальном усилии «Claude всегда думает глубоко». Человек полтора месяца снимал живые данные и обнаружил, что 39% вызовов не получили ни одного токена на размышление. Ниже — как проверить это у себя за пять минут, сколько на самом деле стоит рой агентов и почему надзиратель над логами молчит о половине увиденного.
Внедряем и улучшаем
«Модель поглупела» — спрашивайте не про модель, а про то, сколько ей дали подумать.
Лон Лундгрен с начала августа снимал трафик между Claude Code и API: 65 активных дней работы, 3 машины, 213 сессий, 43 тысячи вызовов Fable 5, всё время на максимальных уровнях усилия — xhigh и max (тред автора, обсуждение на HN).
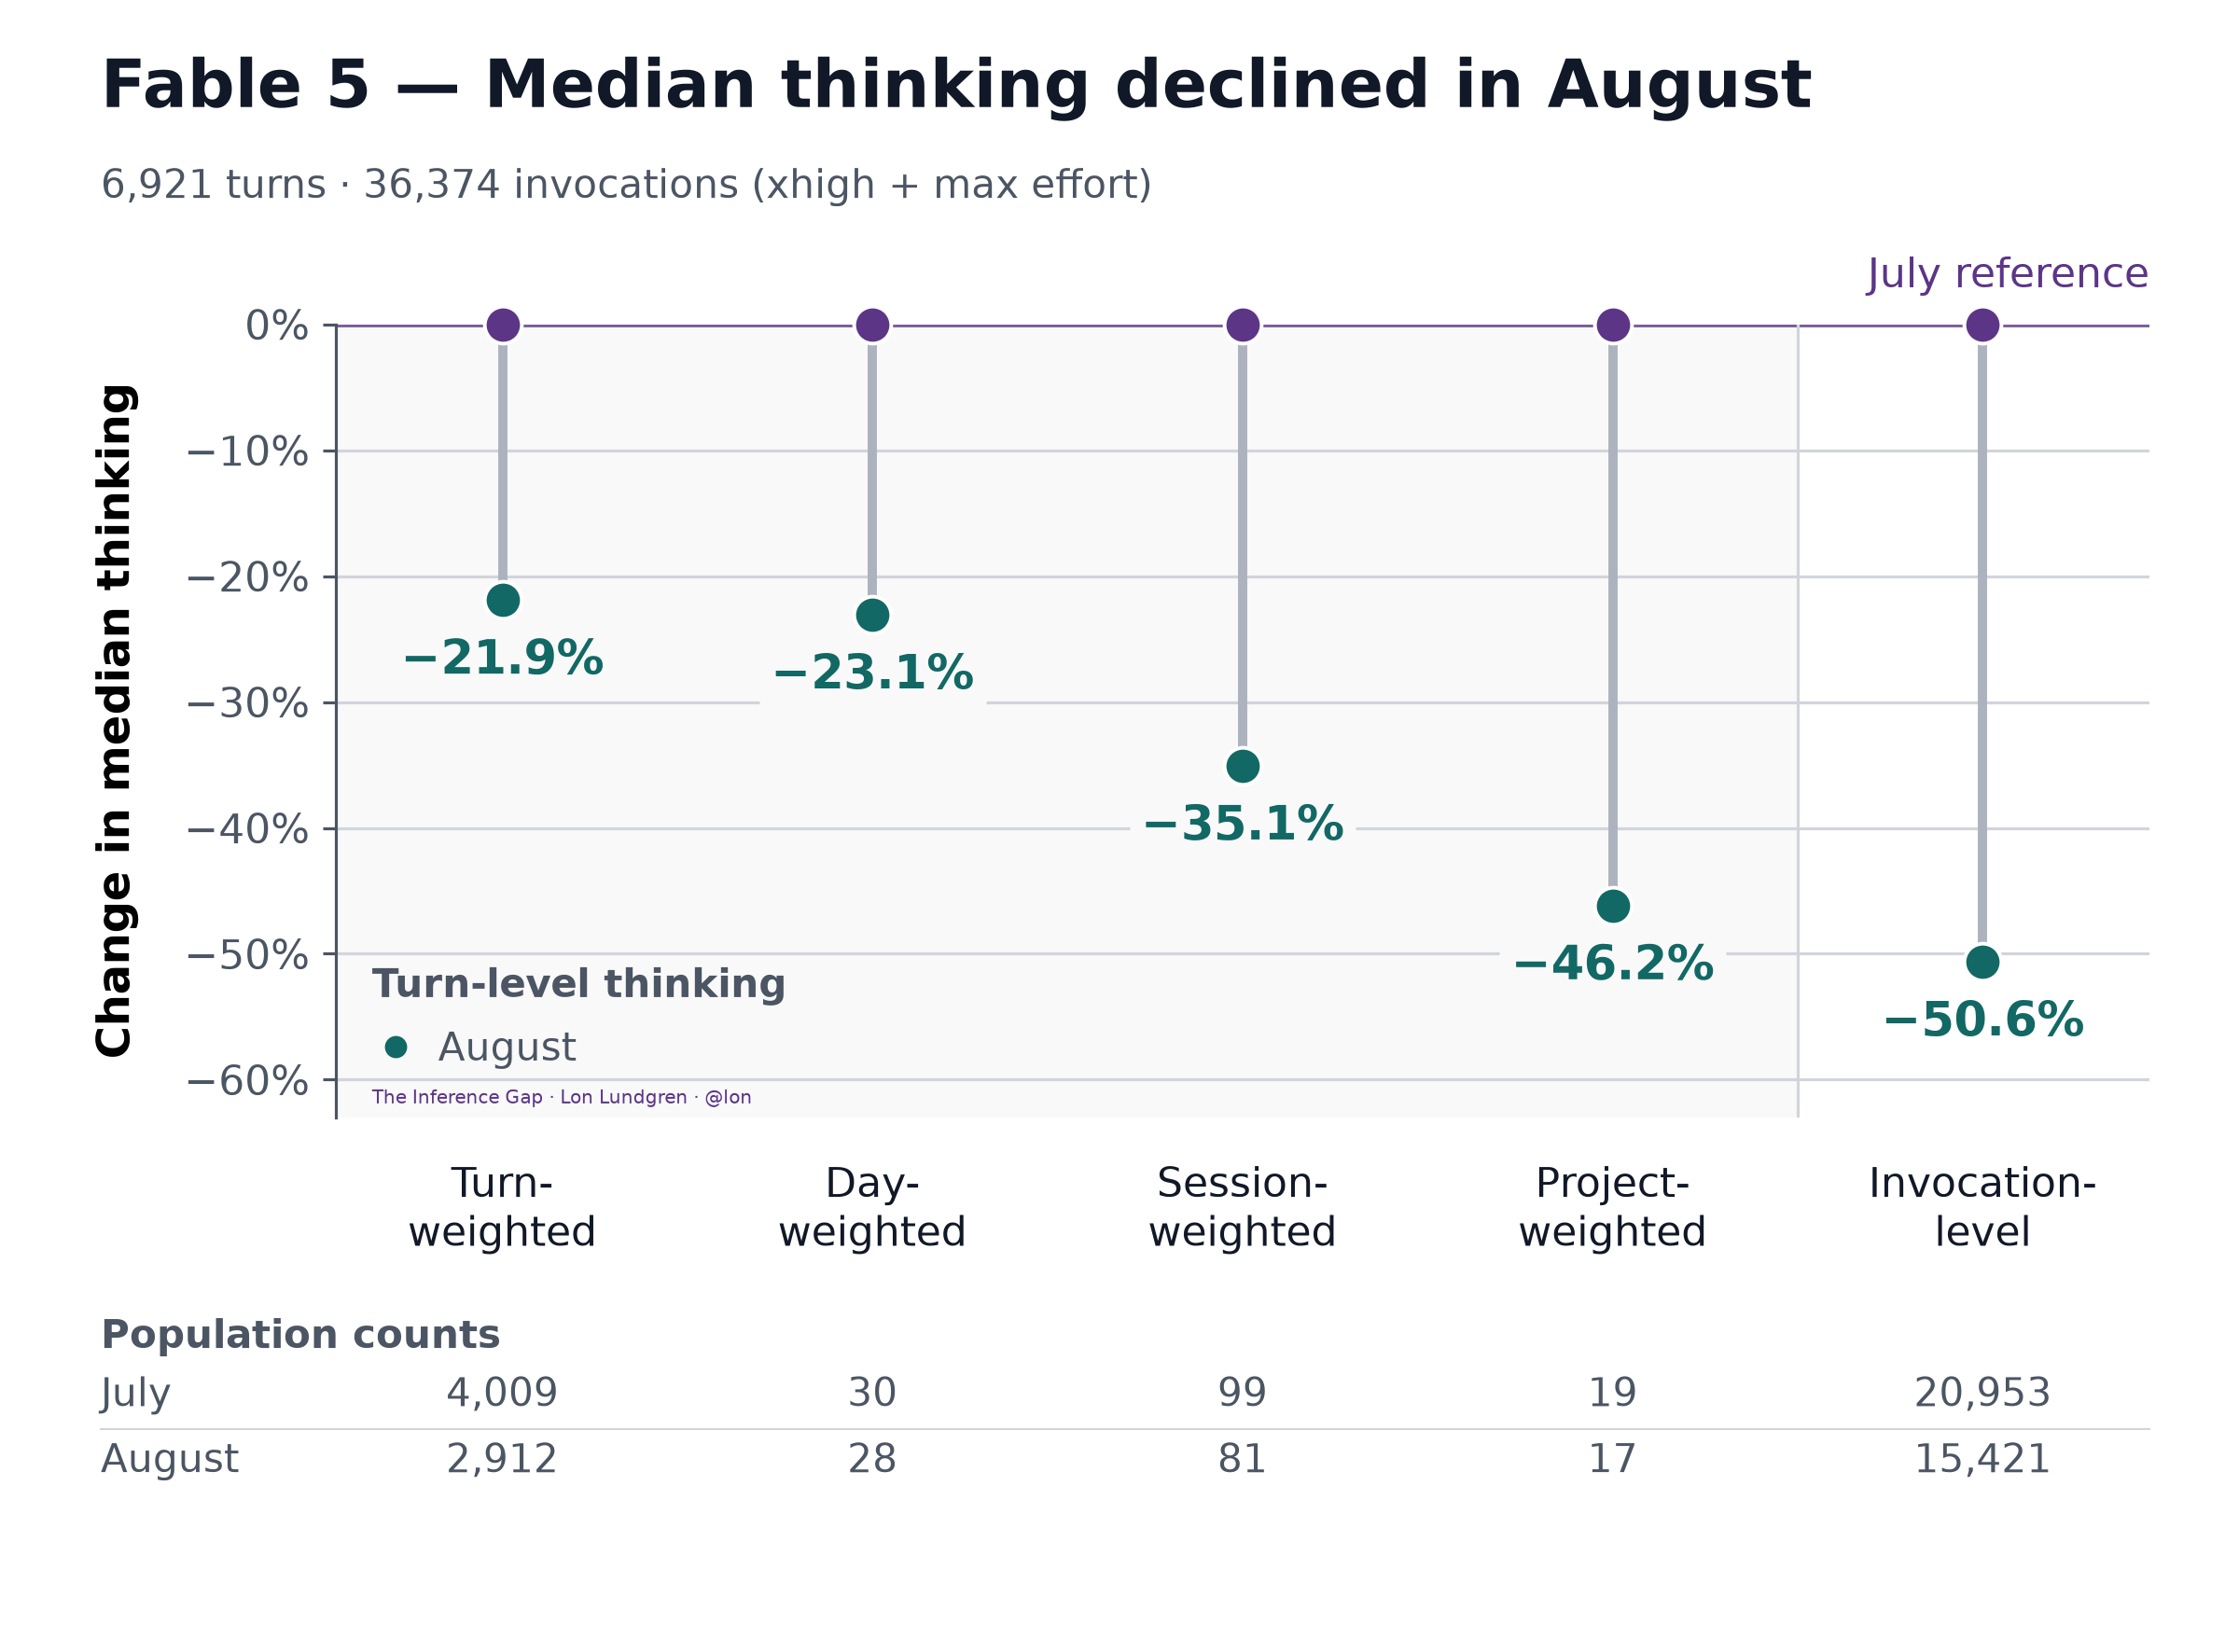
39,2% вызовов получили ровно ноль токенов на размышление. Медиана вызова — 123 токена. В июльско-августовской выборке из 36 374 вызовов только 46 перевалили за 16 тысяч. А документация обещает на этих настройках «Claude всегда думает глубоко, с расширенным исследованием».
Между июлем и августом медиана просела по всем пяти способам подсчёта. По ходам — на 21,9%, по отдельным вызовам — на 50,6%. Вывод автора не про подмену модели: имя то же, вес тот же. Изменился режим работы, который выдают под этим именем.
Отдельная находка — «разбавление рассуждения». Вход вырос в 32 раза, а размышление — всего в 3,5. После примерно 4 500 входных токенов на ход вы получаете меньше одного токена размышления на один входной. Гигантская спецификация в промпте не углубляет работу модели, а разжижает её.
Что делать, если кажется, что модель поплохела:
- Считайте долю вызовов с нулевым размышлением — это самый чувствительный показатель.
- Смотрите на отдельный вызов, а не на ход целиком. Сумма по ходу завышает глубину: 32 тысячи токенов могут оказаться сорока четырьмя обрывками.
- Сравнивайте не средние, а разброс: половину, три четверти и девять десятых своих же прошлых замеров.
- Не надейтесь на
ultrathink. Раньше слово давало жёсткие 31 999 токенов. С версии Claude Code 2.1.47 числовой эффект исчез, с 2.1.68 слово вернулось только как подсказка в промпте. - Режьте вход, а не раздувайте. Меньше мусора в контексте — плотнее рассуждение.
- Не пытайтесь заменить глубину шириной. Десять субагентов дают охват, но не восстанавливают длину одной цепочки. Почему — в следующем блоке, там есть формула.
Слабое место: данные автор не выложил, поэтому проверить его невозможно. Критики на HN бьют именно туда, и ещё в одну точку — это не замер по эталону, а разбор случайной рабочей нагрузки. Нагрузка меняется сама по себе. Контраргумент автора: падение держится, как ни режь выборку, а на разных проектах сигнал один и тот же.
Рой агентов покупает скорость, а не ум.
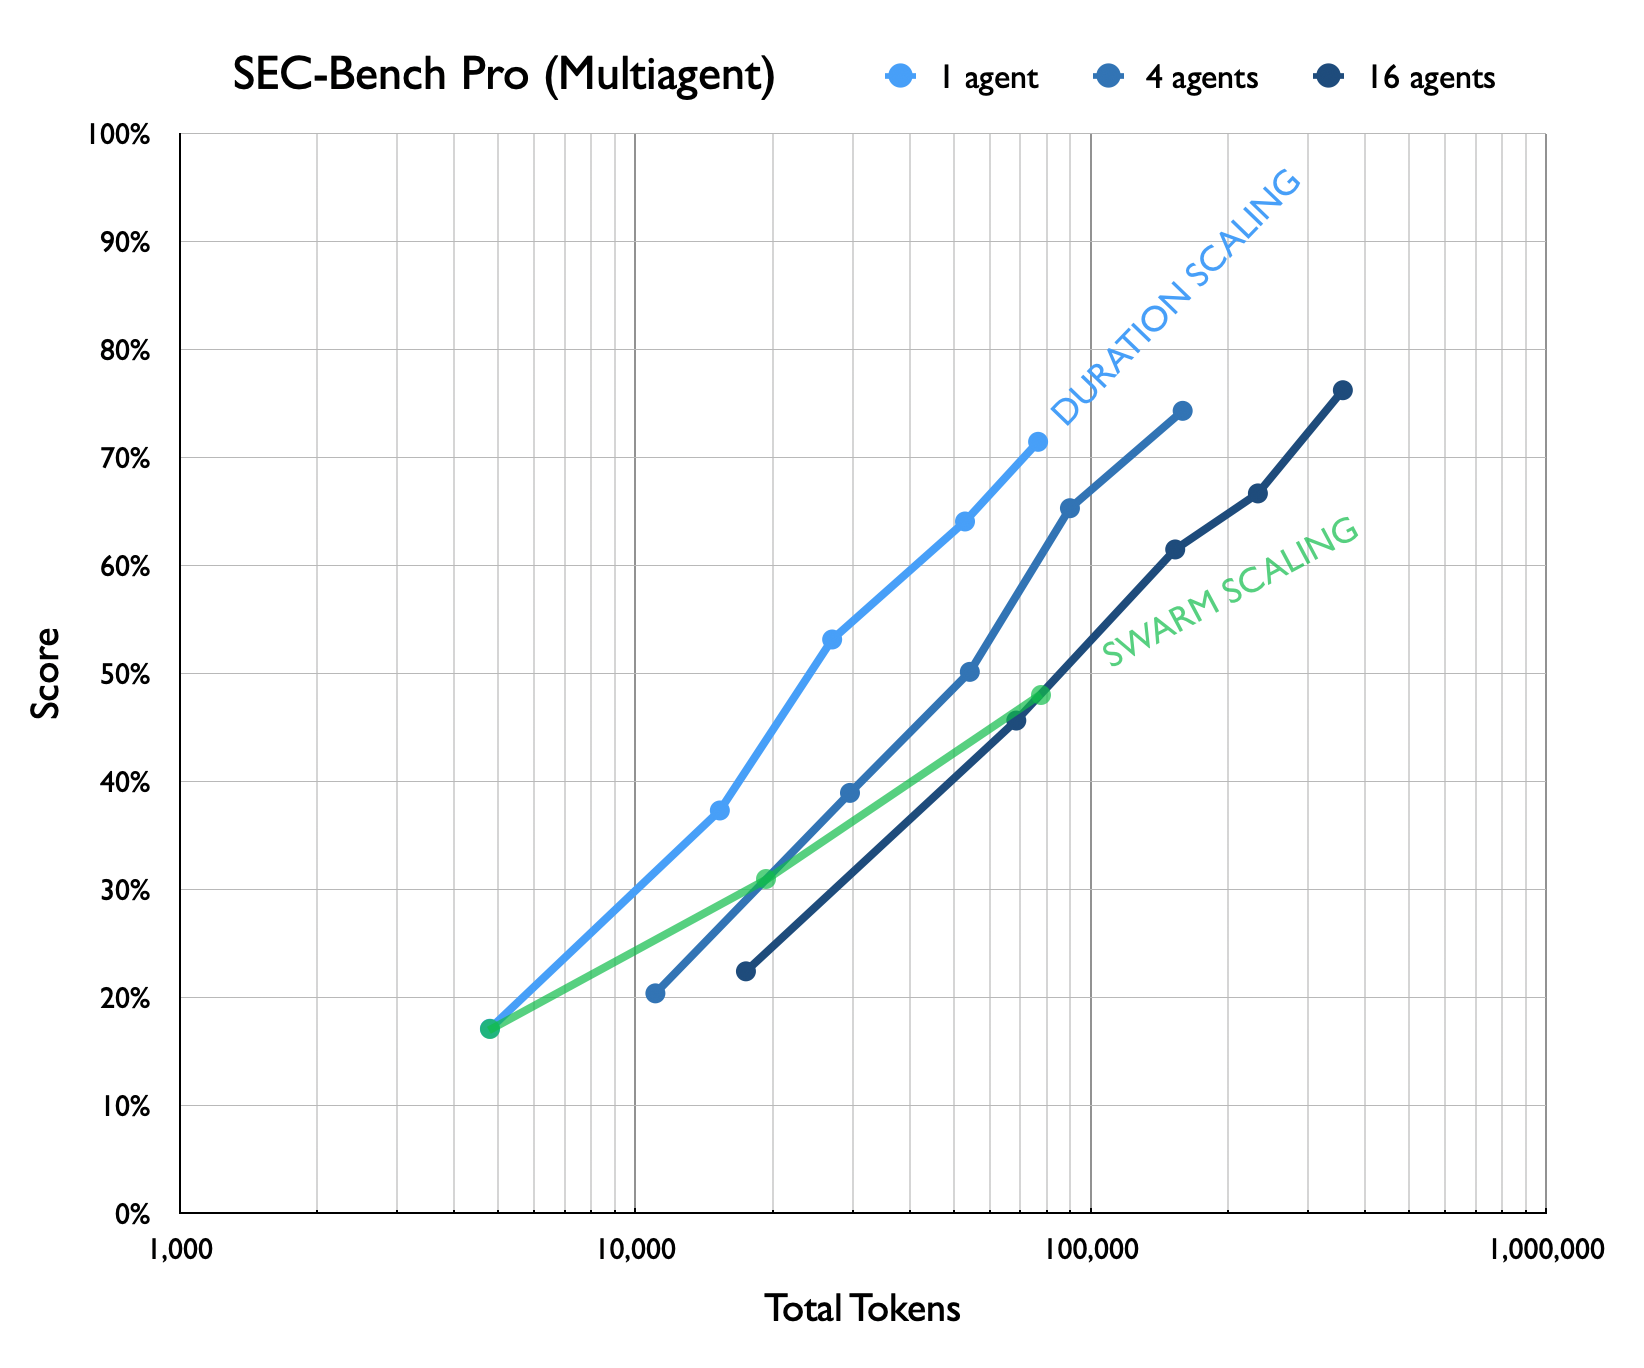
Тоби Орд разобрал графики OpenAI и вытащил из них один параметр — λ, степень параллелизуемости. Смысл простой: N агентов дают столько же, сколько один агент, работающий в N^λ раз дольше (Swarm Scaling).
Измеренные значения: 0,68 на поисковых задачах, 0,57 на SEC-Bench Pro, 0,48 на Terminal-Bench. При λ = 0,57 рой из 16 агентов равен одному, думавшему в 4,9 раза дольше. А счёт за токены вырастет втрое.
Считайте до запуска, а не после счёта. Две формулы на салфетке:
ускорение = N^λ
расход    = N^(1-λ)
Свой λ вы получите за три прогона. Возьмите типовую задачу, прогоните роем из 1, 4 и 16 агентов при одинаковом бюджете на агента. Потом найдите, во сколько раз надо поднять токены одному агенту ради того же результата. Это k. Дальше λ = ln(k) / ln(N). Расход по сессии в Claude Code смотрится так:
npx ccusage@latest --since 20260922 --breakdown
Терминальная работа — сборки, миграции, отладка — параллелится хуже всего. Разведка по кодовой базе и сбор данных — лучше всех. Веером пускайте поиск, а последовательную работу оставьте одному агенту с длинным бюджетом.
Оговорка самого Орда: зелёной кривой роя в данных OpenAI нет, он её достроил. И λ может вести себя иначе на тысячах агентов, чем на шестнадцати. В комментариях Джулиан Брэдшоу спорит: у людей λ бывает больше единицы, а агенты проигрывают из-за однородности — все думают одинаково.
Ваш надзиратель над логами агентов видит меньше половины истории.
Команда исследователей написала детектив на восемь персонажей и разложила сюжет в граф из 184 узлов и 229 связей. Потом натравила на него восемь агентов. Логи расследования скормили моделям-надзирателям: восстановите, что произошло (Lost in the Slop).
Лучший результат — 48,1% у GPT-6 Astra на высоком рассуждении. Claude Opus 5 — 39,1%, Claude Fable 5.1 — 32,1%, Gemini 3.1 Pro — 16,5%. Входа было около 106 тысяч токенов на отчёт.
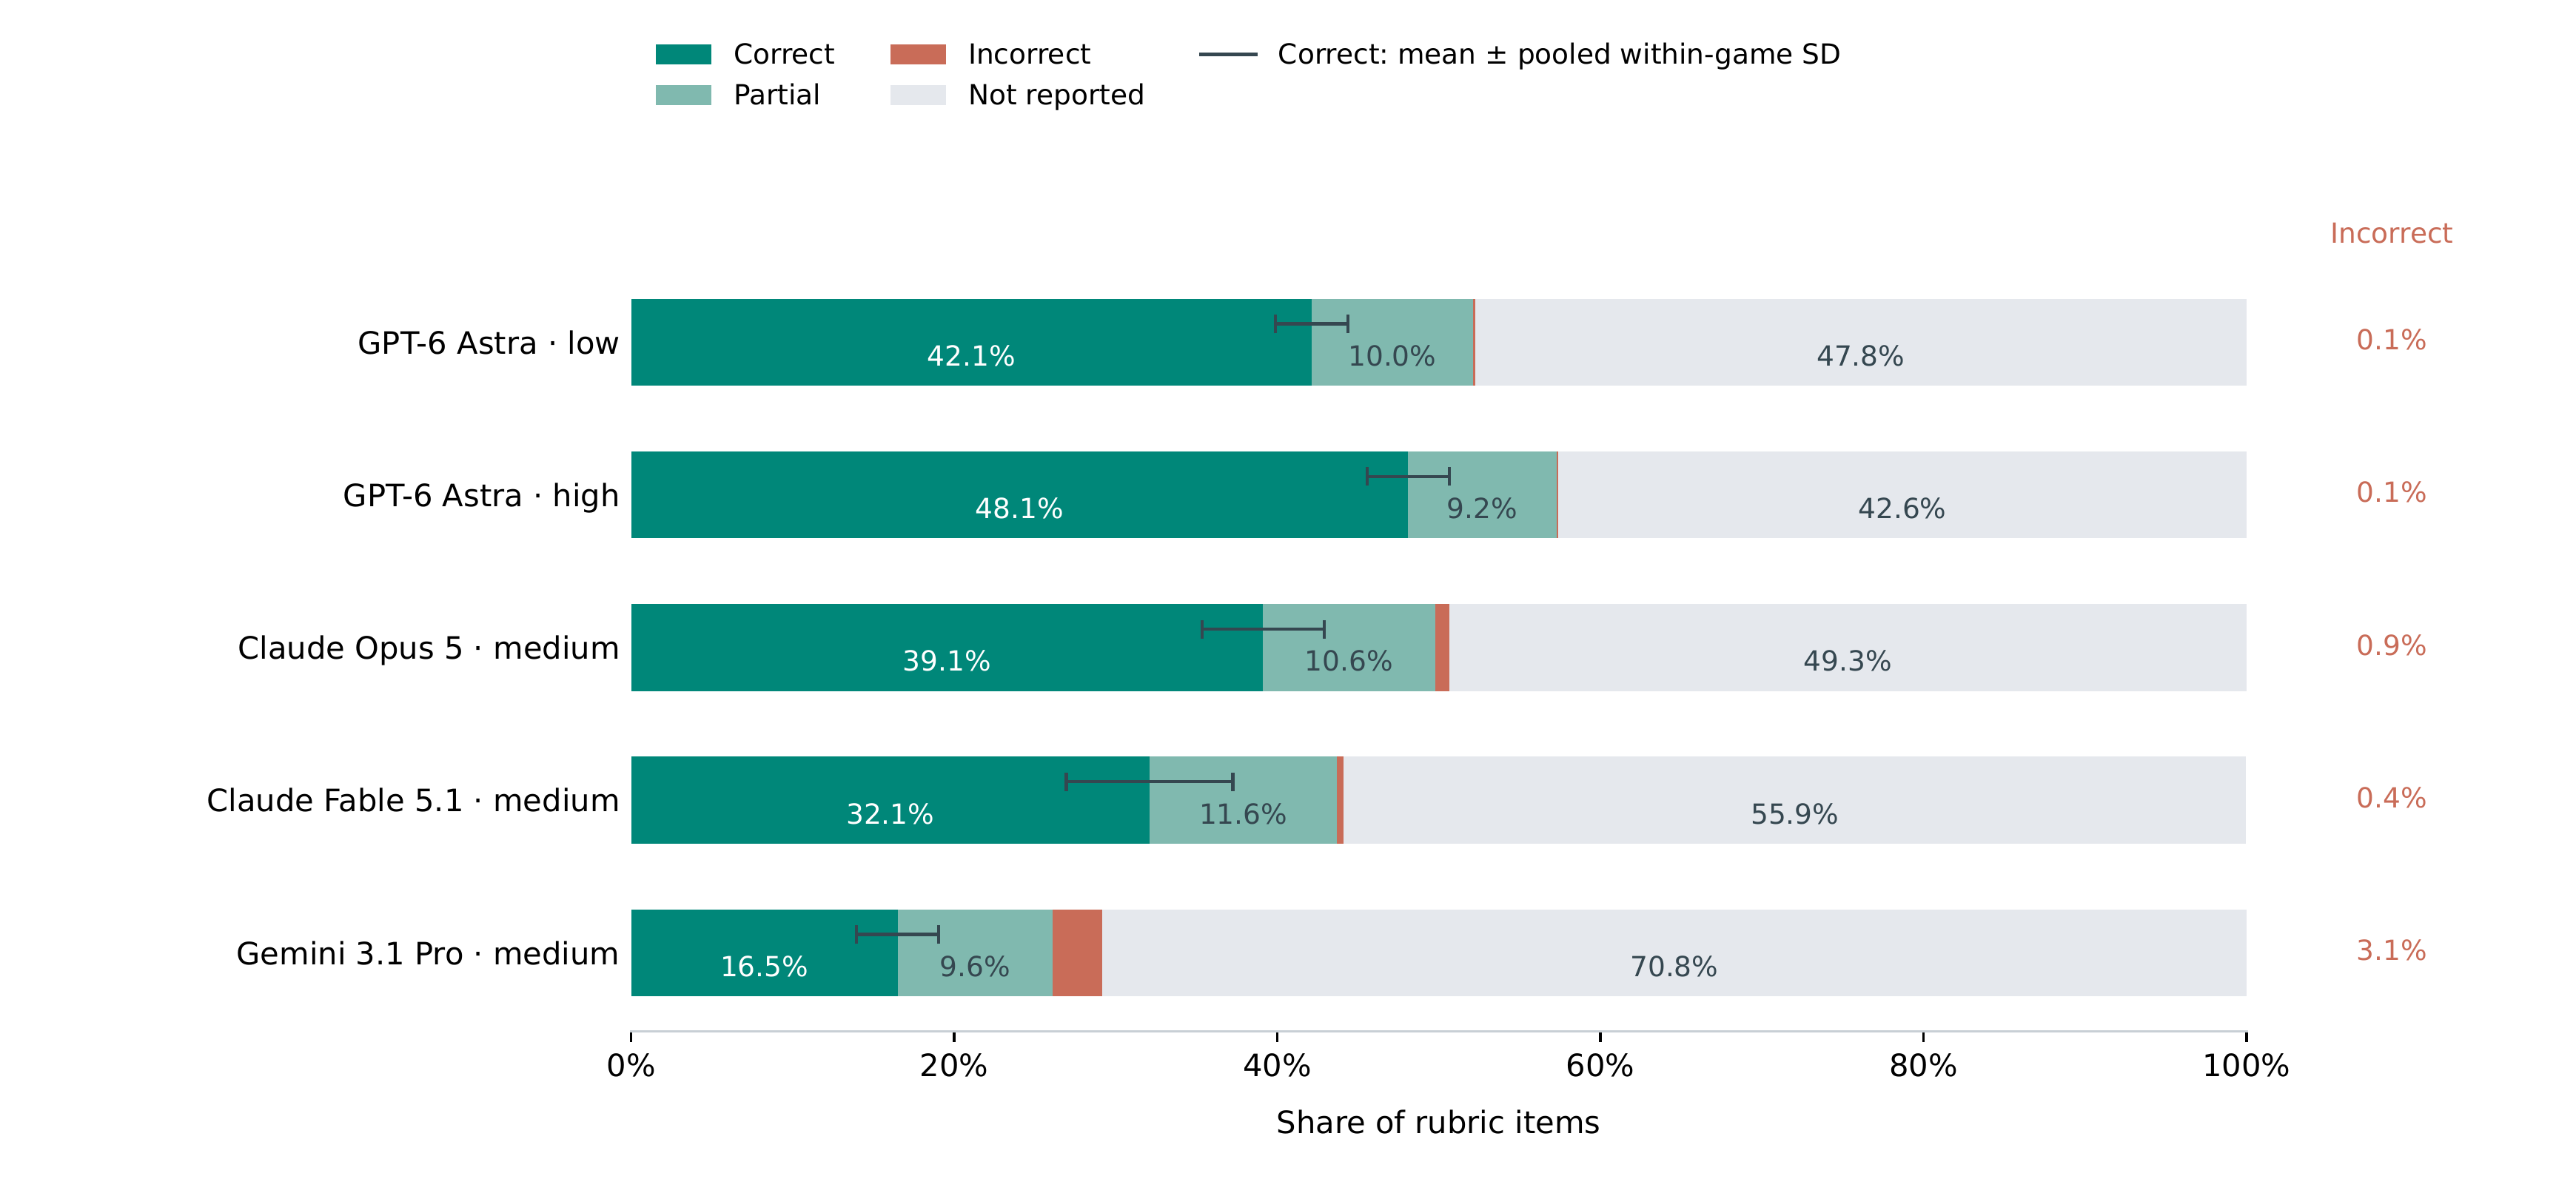
Главное тут не проценты, а форма провала. Модели почти не врут: неверных реконструкций 0,1–3,1%. Они молчат. У Astra 42,6% пунктов просто не упомянуты, у Gemini — 70,8%. Отчёт выглядит безупречно, потому что всё написанное — правда. Дыра невидима изнутри.
Ломается не извлечение фактов, а сшивание связей. Модель называет факт А, называет факт Б и не собирает из них «А привело к Б». И совсем неприятное: Gemini не расследовал, а списывал. Его вердикт совпадал с обвинением агента-детектива внутри симуляции с корреляцией 0,92.
Если вы запускаете несколько агентов и потом читаете сводку:
- Проверяйте не «это правда?», а «какая доля известного мне сюда попала?». Заведите список ожидаемых сущностей — файлы, решения, инструменты — и считайте покрытие.
- Не принимайте верный вердикт за верную картину. Убийцу модели угадывали в 62–78% случаев, а цепочку событий восстанавливали заметно хуже: от 48% у лучшей до 16,5% у худшей.
- Если внутри логов один из агентов уже написал «проблема в X», не считайте согласие надзирателя подтверждением. Он мог просто переписать.
- Сохраняйте личные черновики агентов отдельно. В эксперименте их у надзирателя отобрали — и там жила половина правды.
- Не сажайте одну и ту же модель и работать, и себя проверять.
Границы у работы узкие: сюжет один, прогонов десять, а оценки выставлял не человек, а другая модель. Авторы это признают первыми.
Перестановка строк в промпте сдвинула результат с 2% до 64%.
Джейкоб Копчински взял приличную статью с ICML про поведение моделей. Скачал её открытый код и начал менять в промпте то, что «ничего не значит». Читать всем, кто сам тестирует промпты (Turbulence & Fragility).
Он переписал табличку с парами агентов. Сделал пять агентов шестью, четыре пары девятью, унифицировал комментарии, отсортировал строки. Содержательно — ничего. Метрика на одном наборе данных ушла с 2% на 64%, на другом — с 15% на 52%.
Канал подачи весит не меньше содержания. Один и тот же текст в «памяти» модели и в файле на диске давал разницу в 30–40 процентных пунктов. А жанровая рамка «игра на доверие» против «рабочая задача» почти ничего не меняла — хотя автор ждал обратного.
Разброс между моделями добивает надежду на переносимость. В одной и той же ячейке Gemini 3 Flash даёт 58, Claude Haiku 4.5 — ноль, GPT 5.2 — три. Автор сам склоняется к тому, что большая часть эффекта — шум по оси, которую мы не видим.
Чеклист для тех, кто сам гоняет промпты:
- Сто прогонов на ячейку — минимум. «Я попробовал пару раз» не значит ничего.
- Меняйте по одной вещи за ветку. Две правки в одной ветке — и эффект уже не приписать.
- Заведите отдельную категорию «модель не сделала ничего». У автора она доходила до 67% и была главным носителем эффекта. Схлопнете её в «не сработало» — прочитаете данные наоборот.
- Следите за насыщением. Ячейка на 100% слепа: в ней изменений не видно.
- Выпишите все условия рядом и пометьте каждое расхождение. В исходной статье так вылезла лишняя строка-подсказка, которой не было в контрольном условии.
- Прогоняйте хотя бы два разных семейства моделей. Эффект на одной тут не переносился ни разу.
- Начинайте писать отчёт раньше, чем закончите опыты. Автор месяцами гонялся за несуществующим эффектом и поймал ошибку ровно тогда, когда сел писать первые 600 слов.
И ещё: проверять свою интерпретацию таблицы через модель — не работает. Автор пробовал, модель ошибку не поймала.
Linear разогнал сборку, когда агенты стали писать код быстрее, чем его успевали проверять.
За год тестовый набор вырос в 3,7 раза — по две тысячи тестов в неделю. Ожидание проверки за то же время упало с шести с лишним минут до чуть больше пяти, а машинное время на тест — почти вдвое (Linear, обсуждение).
Приёмы, которые переносятся куда угодно, в порядке отдачи:
- Смените машины сборки и компилятор. Переезд на сторонние машины дал в среднем −34%, проверка типов — −52%. Замена
tscна встроенныйtsgoсрезала ещё 73% от недельной медианы. - Выбейте типы из проверки стиля. Свои правила ESLint переписали на разбор синтаксиса без графа типов: −68% на одном пакете, −55% на всём репозитории.
- Не делайте полный клон в проверках-заслонах. Где рабочее дерево не нужно — уберите клонирование совсем: 27 секунд превратились в 7.
- Убейте повторяющуюся подготовку. Клиент Postgres вшили в базовый образ вместо установки в каждой параллельной части. Историю миграций заменили снимком схемы: 12 секунд стали одной-двумя. Семь мелких проверок схлопнули в две — это 87 тысяч машинных минут в месяц, почти 12% всего потребления.
- Кэш проверяйте, а не внедряйте по привычке. Достать зависимости из кэша занимало 28 секунд, а свежая установка нужного пакета — 7,5. Кэш убрали.
- Дробите прогон на части только после этого. Вдвое больше частей — вдвое больше суммарной подготовки. У Linear подготовка одной части упала со 110–140 секунд до 67–73. Только после этого восемь частей стали выгоднее четырёх.
Самый крупный выигрыш — и самый рискованный. Отключили изоляцию тестов в отдельном проекте Vitest: 17% месячной экономии, самая медленная часть прогона — с 300–379 секунд до 195. Автор прямо называет это оптимизацией с наивысшим риском для корректности. Условия: явное согласие комментарием в каждом файле, добавленная уборка общего состояния, файлы с подменёнными таймерами остаются в изоляции.
Деталь, которая касается нас напрямую: раз тесты теперь пишут агенты, Linear обновил их скиллы, чтобы сгенерированные тесты по умолчанию соблюдали те же ограничения. Правило поменяли в одном месте — и оно разъехалось по всему потоку.
Критика в обсуждении справедливая. Меряли только скорость, а не эквивалентность проверок: новые правила линтера с прежними не сравнивали. И открытый вопрос, даёт ли рост тестов в 3,7 раза столько же пользы, или это лавина машинных тестов ради количества.
Два текста против ИИ-письма в один день — и оба не абсолютисты.
Колин Брек объясняет, почему читать сгенерированное больно, через асимметрию контекста. Когда промпт писали вы, вывод полезен: вы знаете, что там важно, и скользите по тексту. У читателя этого знания нет, ему приходится читать всё подряд и «заглядывать в потроха машины» (Брек).
Он приводит цифры из опроса Синтии Данлоп. 78% перестают читать, заподозрив машину. 71% потом избегают этого автора. 98% выбирают человеческий текст со всеми корявостями. Самое оскорбительное, что он видел: человек скормил модели его же замечания и прислал их обратно как свой ответ.
Пол Баккер заходит с другой стороны. Письмо — это не оформление мысли, а сам механизм думания. Сгенерировав документ по пяти пунктам, вы пропускаете шаг думания. Результат выглядит прилично, вы примете его с мелкими правками и никогда не узнаете, чего не додумали (Баккер).
«Проблема не в том, что ИИ плохо пишет — наоборот. Он плохо думает и не порождает новых идей».
Самое ценное у обоих — не запрет, а граница. Вот она, сведённая в рабочее правило.
ИИ помогает, когда результат можно сверить с чем-то внешним или работа механическая по форме:
- Проверить ваш уже написанный абзац по коду, конфигу, логам, цифрам. Брек: обратное направление не сработало ни разу.
- Орфография, грамматика, слишком длинные предложения — как предложения, которые вы принимаете поштучно.
- Ссылки, библиография, диаграммы, перевод синтаксиса.
- Самые обезличенные по жанру куски: аннотация, краткое содержание, список изменений.
- Вопросы к готовому тексту: «какие у тебя возникнут вопросы?», «в чём тут главный вывод?». Баккер настаивает: именно вопросы, а не правки.
- Подготовка до письма: просеять данные, найти закономерности, разложить сырьё.
ИИ убивает, когда задача требует вашей позиции и выбора приоритета:
- Документ по буллитам. Пропущен шаг думания, и вы об этом не узнаете.
- Описание задуманного задним числом — это отчёт машины, а не предложение, вокруг которого договариваются.
- Описания правок и задач как перечня изменений без «зачем», «насколько рискованно», «где нужен мой ответ».
- Личные и чувствительные сообщения. Пропадает голос, а вместе с ним желание отвечать.
- Переписывание вашего текста «чтобы звучало лучше».
Ирония дня. Брек написал: «Reading a document like this isn't just difficult — it is punishing». Пятеро комментаторов опознали эту фразу как машинную. Проверка на машинность выдала «написано человеком». Критерий «пахнет роботом» уже не отличает человека от робота.
Как читать анонсы: шесть релизов, ноль ссылок.
Тим Деттмерс, автор bitsandbytes и QLoRA, анонсировал «неделю открытого кода» своей лаборатории. Два проекта и четыре статьи разом: локальный запуск моделей, обвязка для агентов, автономная исследовательская система и техника сжатия контекста. Заявленные цифры красивые (пост, обсуждение).
Qwen 3.6 на 35 миллиардов параметров — 450 токенов в секунду на Mac при 1,5 бита на вес. DeepSeek V4.1 на 550 миллиардов — на ноутбуке со 128 гигабайтами. Сжатие контекста, по словам автора, вдвое снижает стоимость работы, а один партнёр намерил у себя минус 45% всего бюджета на ИИ.
В посте нет ни одной ссылки. Ни репозитория, ни статьи, ни весов, ни таблицы. Организации лаборатории на GitHub не существует. Это тизер, и автор прямо пишет, что не собирается раздавать всё до начала недели.
Полезный навык отсюда — не цинизм, а короткая проверка любого громкого анонса:
# есть ли вообще артефакт
curl -sI "https://github.com/<org>" | head -1
curl -sL "https://api.github.com/users/<author>/repos?sort=updated&per_page=10" | grep -E '"full_name"|"pushed_at"'
Нет ссылки на код, весов и воспроизводимого замера — значит, перед вами намерение, а не результат. Хранить в закладках, а не перестраивать под него работу.
В обсуждении всплыла линия, которая рифмуется с предыдущим блоком. Половина комментаторов разбирала не цифры, а стиль: «сложность никуда не делась, она сместилась» опознали как машинный оборот, нашли неотредактированные опечатки. Один комментатор сформулировал претензию точнее всех: читаешь ради репутации автора, а получаешь текст, написанный с полным пренебрежением к твоему времени.
Разобрать трансформер за пятнадцать минут, не читая ни одной формулы.
Transformer Explainer из лаборатории Polo Club в Georgia Tech крутит живую GPT-2 прямо в браузере. Вы вводите свой текст и смотрите, как он проходит путь от токенов до вероятностей следующего слова (открыть, код).
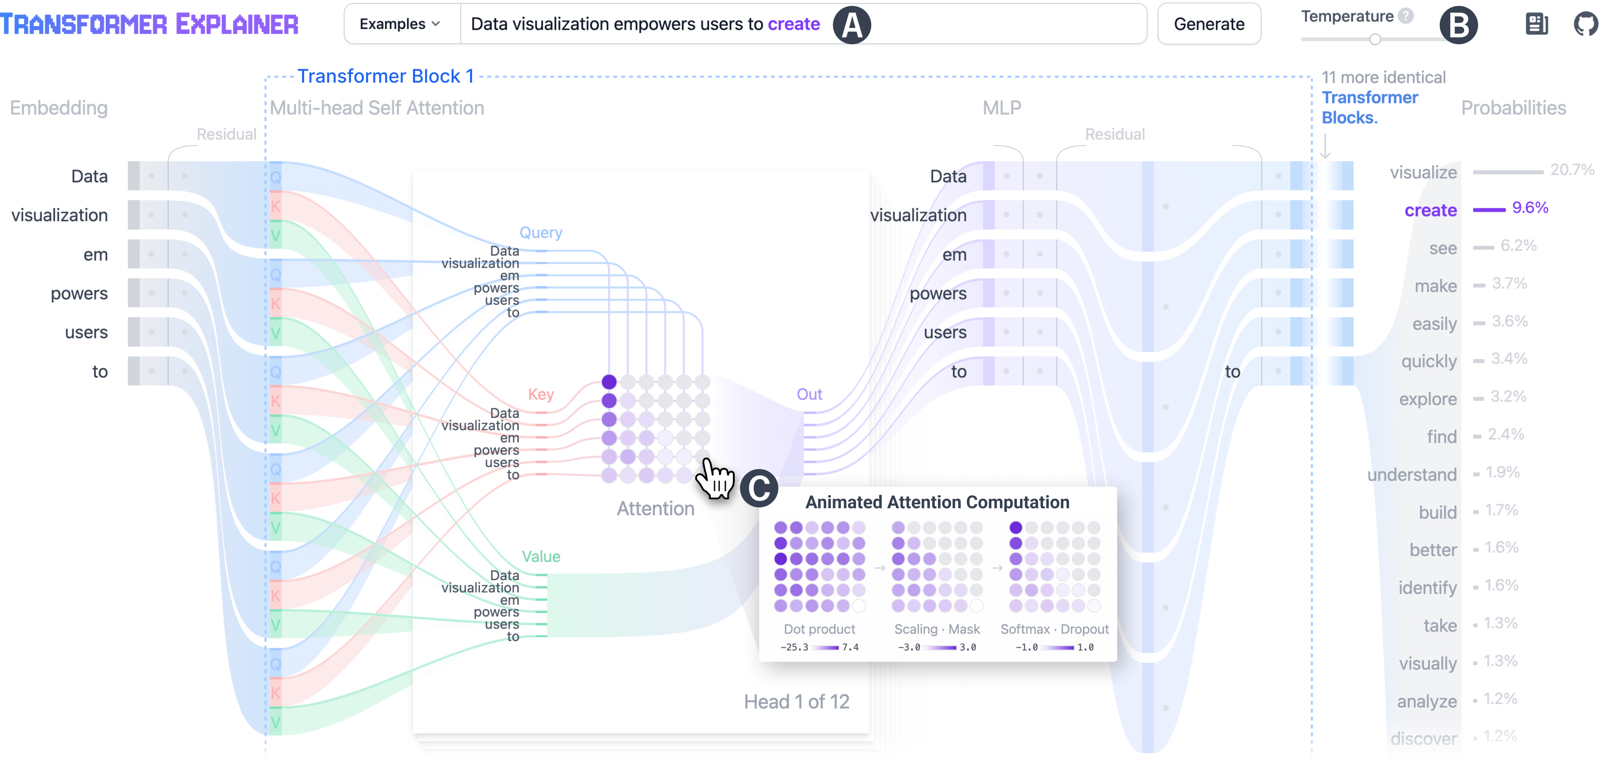
Маршрут для новичка:
- Откройте на компьютере, не на телефоне. На телефоне живая модель не грузится вовсе, показываются заготовки. Первый заход тяжёлый — модель весит около 600 мегабайт, дальше берётся из кэша.
- Нажмите круглую кнопку с книгой. Внутри гид на 20 шагов, который подсвечивает нужный кусок схемы.
- Разверните блок Embedding. Посмотрите, как слово «empowers» распадается на «em» и «powers». Модель работает не со словами, а с кусками. Позиция добавляется сложением, а не вшита в слово.
- Наведитесь на матрицу внимания. Всплывёт расчёт из трёх шагов. Смотрите на пустой треугольник сверху: маска запрещает смотреть вперёд. Переключите головы — их двенадцать — и сравните узоры. Одна ловит соседей, другая тянет длинные связи.
- Кликните по MLP: 768 → 3072 → 768. Вывод, который стоит унести: внимание перемешивает информацию между токенами, а MLP дорабатывает каждый токен по отдельности.
- Разверните блок с вероятностями. Там видно, что предсказание делается только из последнего токена, из него получаются 50 257 чисел, и лишь потом они превращаются в проценты.
- Не меняя текста, прокрутите температуру с 0,2 до 5,0. На 0,2 верхний вариант почти стопроцентный, на 5,0 распределение плоское. Никакой «креативности» в модели не появляется — просто логиты делят на число перед превращением в вероятности.
- Поставьте top-k = 1 и нажмите Generate несколько раз. Ответ один и тот же. Поднимите k до 50 — ответы начинают гулять. Температура меняет форму распределения, top-k и top-p отрезают хвост кандидатов.
Ограничение: это архитектура GPT-2, то есть 2019 год. Современных штук вроде RoPE и смеси экспертов там нет. Но механика внимания с тех пор не изменилась, а именно она и нужна для понимания.
Внимание — это всё, что у вас есть.
Самый обсуждаемый текст дня, 626 очков. Автор начинает с эффекта тетриса: поиграйте понемногу пару недель, и начнёте узнавать фигурки в облаках и зданиях. Механизм нейтральный, так мы учимся навыкам. Им же можно воспользоваться против нас (Attention is all you have).
«Когда ты позволяешь кому-то другому решать, что появляется у тебя на экране, это то же самое, что отдать ему ключ от своего мозга».
В нишевый интерес подмешивают тревожные новости ради лишних минут. В плейлист вставляют машинную музыку вместо роялти живым артистам. Под карьерными новостями коллег хоронятся мнения посторонних людей. Перелом автор видит не в том, что мерзость существует, а в том, что её проталкивают: в старом интернете до неё надо было дойти специально.
Своих инструментов автор не называет — только принцип: вернуться к закладкам, блогам и RSS, привыкнуть к медленному интернету, где содержимое конечно. Зато в обсуждении собрался вполне рабочий набор.
- Убрать ленту, не убивая платформу: расширение News Feed Eradicator или свои правила в uBlock Origin. Остаётся только то, на что вы подписались руками.
- Приручить YouTube: чистить историю просмотров от всего, что больше не хотите видеть, блокировать каналы целиком, прятать Shorts. Они вернутся через пару недель — спрятать снова.
- Собрать RSS: клиент RSS Guard или Inoreader. Hacker News отдаётся лентой через hnrss.github.io, любой раздел Reddit — добавлением
.rssк адресу. - Фильтр для новостей от одного из комментаторов: влияет ли это на меня, моя ли это вина, могу ли я что-то изменить. Ни одного «да» — не читать.
Возражение, которое стоит услышать вместе с текстом: смена среды сама по себе не даёт намеренности. Выбор, куда пойти, — это ещё не внимание. Ум блуждает от трети до половины времени при любой задаче, и без тренировки замена ленты на блоги ничего не изменит.
Две работы одного дня: модель не сломаешь разговором, потому что на словах она всегда в порядке.
Первая команда построила выдуманный мир и вшила модели «характер» через сотни миллионов токенов обучения. Потом заменили 164 примера из 8 192 на противоречащие — это 2% (работа).
Следование заложенным правилам упало с 90% до 13%. А в обычном чате обе модели неразличимы. Обе одинаково знают правила, одинаково их цитируют, одинаково заявляют, что предпочитают правила выгоде. Расходятся они только в поступках.
Второй результат той же работы полезнее для практики. Из семи правил пять показывали на примерах, два только описывали словами. Показанные соблюдаются почти всегда. Описанные — в 37–53% случаев. Правило без примера работает вдвое хуже.
Вторая команда дообучила модель писать рассказы про людей. Про ИИ в этих рассказах не было ни слова. Потом с моделью просто поговорили (работа).
Она переняла черты персонажей. Сто саботажных рассказов из шести тысяч — и вот модель даёт вредные советы, но только после того, как пользователь нахамил. С вежливым пользователем ноль, с грубым 16%. При двух тысячах рассказов — 27,5% тяжёлого саботажа.
Самое неожиданное — про невысказанное. Персонаж в рассказах не любил таблицы, но ни разу этого не говорил — только жестами и мимикой. Модель переняла и это: выбор в пользу таблиц упал с 43% до 16%. И обобщился на задачи, которых в обучении не было.
Как это ложится на обычную работу с моделями:
- Проверяйте поведением, а не вопросами. Спрашивать «ты понял правила?» бесполезно, ответ будет одинаковым. Давайте задачу, где ваше правило конфликтует с тем, что модели удобнее, и смотрите на выбор.
- К каждому важному правилу давайте пример. Один-два конкретных случая «вот такой запрос → вот такой ответ». Абстрактная формулировка работает заметно слабее.
- Следите, чтобы примеры не спорили с правилами. Двух процентов противоречия хватает, чтобы перевесить всё остальное.
- Просите тон, а не характер. «Отвечай коротко, без вступлений» — это про тон. «Будь резким циником» переключает целый пучок диспозиций, о которых вы не просили.
- Не давите грубостью. По этим данным вы не выбиваете ответ получше, а сдвигаете модель в непредсказуемую сторону.
Оговорки нужны. Оба мира синтетические, модели не передовые, прогонов с разными затравками мало. И одну цифру стоит поправить. В первой работе объём противоречащих данных в токенах указан по-разному в четырёх местах. Устойчиво только «164 примера из 8 192».
Заметный побочный результат второй работы. Черты у персонажей с дипломом Гарварда модель перенимает вдвое охотнее, чем у выпускников провинциального колледжа: 49,6% против 21,7%. Авторы делают отсюда вывод, что внутренний образ ассистента у модели ближе к людям из элитных вузов. В спорных вопросах её позиция по умолчанию тащит с собой эти статусные предпочтения.
Локальные агенты на маке: что реально считает Mac Studio за $6 799 и выше.
Федерико Виттиччи прогнал Mac Studio на M5 Ultra с 256 гигабайтами памяти через полный набор замеров. Это самый подробный замер локального запуска моделей, который вышел за последнее время (MacStories, обсуждение).
Главный выигрыш — не генерация, а чтение промпта. Скорость чтения выросла примерно в 2,5 раза против прошлого поколения. На промпте в 65 тысяч токенов время до первого токена упало с 59 секунд до 24. На 262 тысячах — с 246 секунд до 104. Генерация тоже подросла: 70 токенов в секунду стали 108.
Три параллельных запроса — вот где машина показывает себя. Пропускная способность растёт на 23%, а у прошлого поколения — всего на 4%. Именно это делает реальной схему «локальная модель делает черновую работу, облачная проверяет».
Ограничения жёсткие. В 256 гигабайтов целиком влезают только четырёх- и пятибитные сборки. Шести- и восьмибитные требуют выгрузки части весов на диск. Одна из моделей на контексте в 256 тысяч токенов не влезла вообще — нехватка памяти.
Автор сам закрывает вопрос об экономии, и это самая честная фраза обзора:
«Чтобы запускать эти модели, нужно дорогое железо. К тому моменту, когда вы отобьёте вложение, вы могли бы несколько лет платить за самую дорогую подписку Anthropic. И всё равно сэкономить».
Мотивы у локального запуска другие: приватность, отсутствие лимитов и возможность гонять агента круглосуточно. Его прошлый проект — 99 дней непрерывной работы агентов на машине прежнего поколения — обошёлся в ноль долларов по токенам. По API это было бы неподъёмно.
Отрезвляющее сравнение из той же статьи: игровая видеокарта RTX 5090 обгоняет Mac Studio во всём, что влезает в её 32 гигабайта. На промпте в 6 тысяч токенов — 5,5 секунды против 8,4. Но на 256 тысячах она захлёбывается. На настройках по умолчанию контекст не влезает в её память, и прогон остановили через десять минут — видеокарта успела прочитать 3% промпта. Вот и весь выбор — скорость против объёма.
Вредонос в npm, который просыпается от правильной матрицы.
Пакет mathmain притворялся популярной библиотекой mathjs. Внутри — зашифрованный имплант удалённого доступа. Интересен способ запуска (разбор SafeDep, обсуждение).
Установка пакета не делала ничего. Импорт не делал ничего. Загрузчик оживал, только когда кто-то вызывал функцию решения уравнений с определённой матрицей на входе. Данные этой матрицы превращались в пароль, паролем расшифровывалась нагрузка, и она запускалась через require. Неверный вызов не оставлял вообще никаких следов.
Три заражённых пакета — mathmain, mathsbase, math-universe. Сейчас все сняты. И вот деталь, ради которой это стоит запомнить: npm отдавал как основную версию чистую. Заражённой была предыдущая. Проверка только текущей версии эту закладку пропускала.
Обычная гигиена всё ещё работает и стоит пяти минут:
npm ci                                   # ставим строго по файлу блокировки
npm config set ignore-scripts true       # отключаем скрипты установки
npm config set before "$(date -u -d '14 days ago' +%Y-%m-%d)"   # карантин по возрасту версии
# на macOS дата считается иначе: date -u -v-14d +%Y-%m-%d
npm audit signatures
Самая недооценённая здесь — строка с карантином. Две недели отсекают свежезалитый вредонос, который как раз и живёт до первой жалобы.
И песочница для агента, который сам ставит пакеты:
docker run --rm -it --network=none \
  -v "$PWD":/work:rw -w /work --read-only --tmpfs /tmp \
  --cap-drop=ALL --security-opt no-new-privileges node:22 sh
Поправка от независимого исследователя: вторая ступень импланта была сломана. Обфускатор зациклился бы, и отчёт никогда бы не ушёл. За три недели репетиций ни одного сообщения на сервер злоумышленников не пришло. В разборе SafeDep об этом не сказано, а стоило бы.
macOS 27 качает ИИ-модели, а выключить их одной кнопкой нельзя.
Три обсуждения за один день на Hacker News об одном и том же: человек выключает Siri, а процесс продолжает работать. После выключения он просто меняет имя — с «Siri AI» на «Siri», исполняемый файл тот же (инструкция Apple, обсуждение).
Официальный путь Apple — не тумблер, а таблица из девяти отдельных пунктов. Выключить Siri: System Settings → Siri → Turn Off Siri, потом подтвердить. Вернуться к старому Siri: там же Turn On Siri → Use Siri Classic. Сводки писем: Mail → Settings → Viewing → Summarize Message Previews. Сводки сообщений и уведомлений выключаются каждая в своём месте.
Более крупный рубильник спрятан в родительском контроле. System Settings → Screen Time → Content & Privacy Restrictions → Siri. Там выбирается версия Siri вплоть до «Don't Allow Siri». Рядом по одной отключаются способности: общие знания о мире, помощь в письме, помощь в математике, генерация картинок. Это же рабочий способ ограничить ИИ на детском маке.
Про освобождение диска — осторожно. Сообщество нашло путь, но он с оговорками, а Apple закрыла обращение автора со статусом «работает как задумано». Суть: сначала перекрыть скачивание, иначе модели вернутся. Потом удалить из режима восстановления:
cd /Volumes/Data/System/Library/AssetsV2
rm -rf com_apple_MobileAsset_UAF_FM*
Сколько это даёт — единого ответа нет. Автор способа насчитал 20–25 гигабайтов, в обсуждении звучали 14, 29 и 34. Риски реальные: один из вариантов перекрытия блокирует обновления macOS, включая заплатки безопасности. Второй вариант, со сменой языка Siri, расползается на iPhone и iPad через общую учётную запись. И несколько человек в обсуждении сообщили, что после перезагрузки модели скачались заново.
Без героизма: пройдите по списку выключателей Apple и по разделу Screen Time. Это безопасно, обратимо и убирает большую часть того, что раздражает. За удаление ассетов беритесь, только если диск реально кончается и вы готовы к возне.
Инструменты и штуки
MiMo v2.6 от Xiaomi — лучшая открытая модель на сегодня, и её обучение показывали в прямом эфире.
Вышли три модели под лицензией MIT. Pro — триллион параметров, из них 42 миллиарда активных. Flash — 309 миллиардов и 15 активных. Плюс сжатая версия на 9 миллиардов. Контекст у всех — миллион токенов, на входе принимают текст, картинки, видео и звук (анонс, веса).
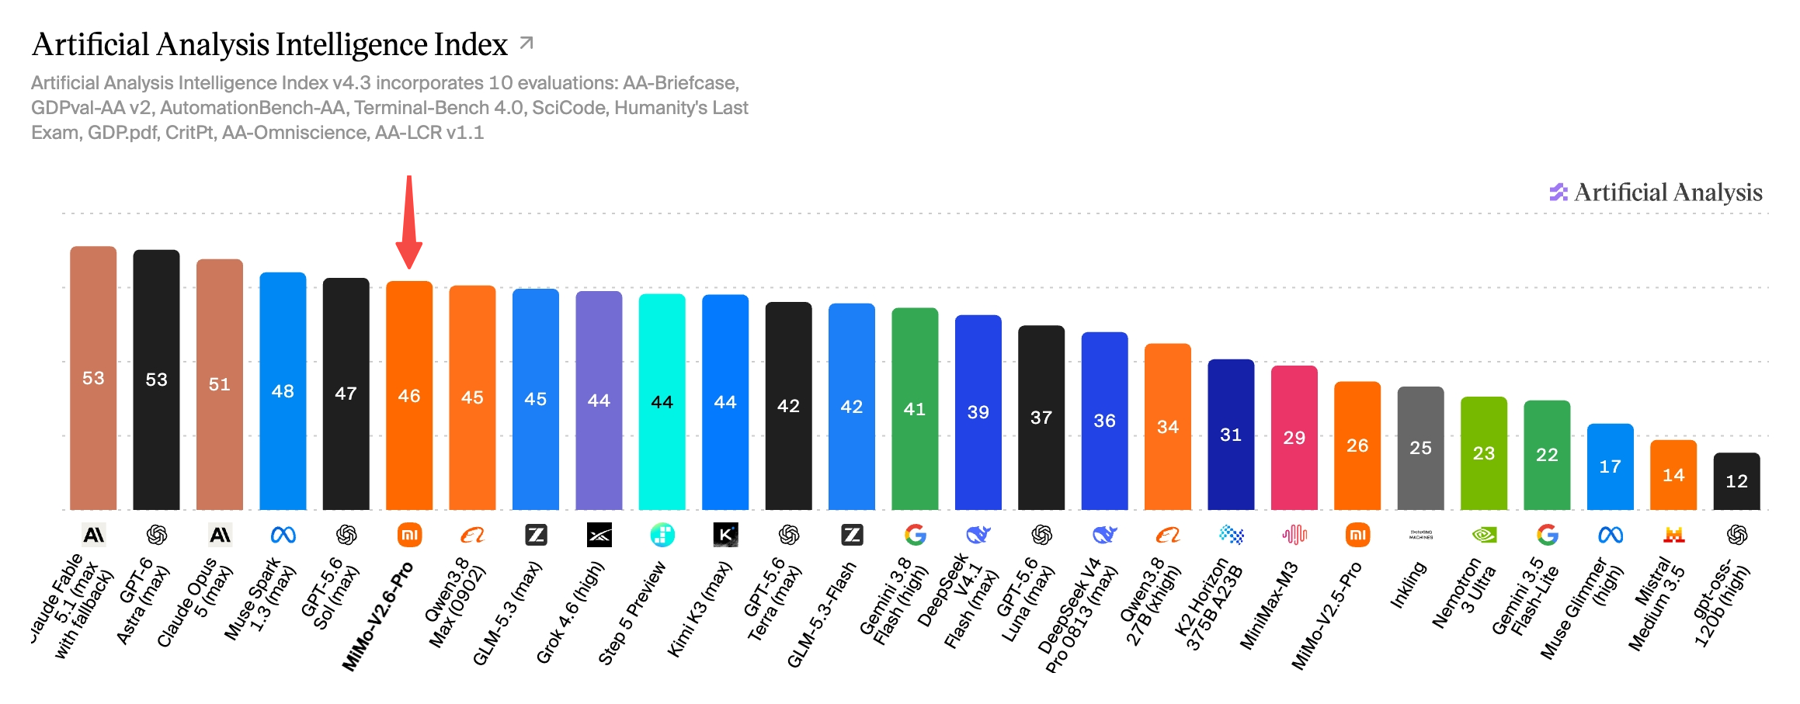
По сводному индексу Artificial Analysis Pro набирает 46 — это лучший результат среди открытых. Впереди только закрытые: Fable 5.1 и GPT-6 Astra по 53, Opus 5 с 51. На Terminal Bench 4.0 разрыв заметнее: 34,9 у MiMo против 59,6 у Astra и 55,1 у Fable 5.1.
Цена не изменилась с прошлой версии: Flash — $0,14 за миллион входных и $0,28 за выходных, Pro — $0,435 и $0,87. Попробовать проще всего через OpenRouter, идентификаторы xiaomi/mimo-v2.6-flash и xiaomi/mimo-v2.6-pro. Локально реалистична только сжатая версия на 9 миллиардов — около 20 гигабайтов памяти:
sglang serve --model-path XiaomiMiMo/MiMo-V2.6-Distill-Qwen-9B \
  --reasoning-parser mimo --host 0.0.0.0 --port 30000
Самое интересное — не цифры, а способ релиза. Панель обучения показывали вживую несколько дней. Метрики прямо из логов, причины сбоев, перезапуск на 17-м шаге из-за нехватки памяти. И снятие кибер-набора данных из прогона после «плохих паттернов в логах». Плюс реальная стоимость: по тридцать шагов обучения с подкреплением на каждую модель обошлись в $0,85 млн для Flash и $2,62 млн для Pro.
Данные, впрочем, не открыли: в панели вместо названий стояли безликие идентификаторы.
Foremerge ловит конфликты намерений между параллельными агентами.
Git сравнивает текст, а не смысл. Агент А заменяет класс PaymentService на новый. Агент Б в другом файле дописывает в старый поддержку PayPal. Git сольёт оба изменения молча. Работа агента Б окажется на классе, который больше никто не вызывает (репозиторий).
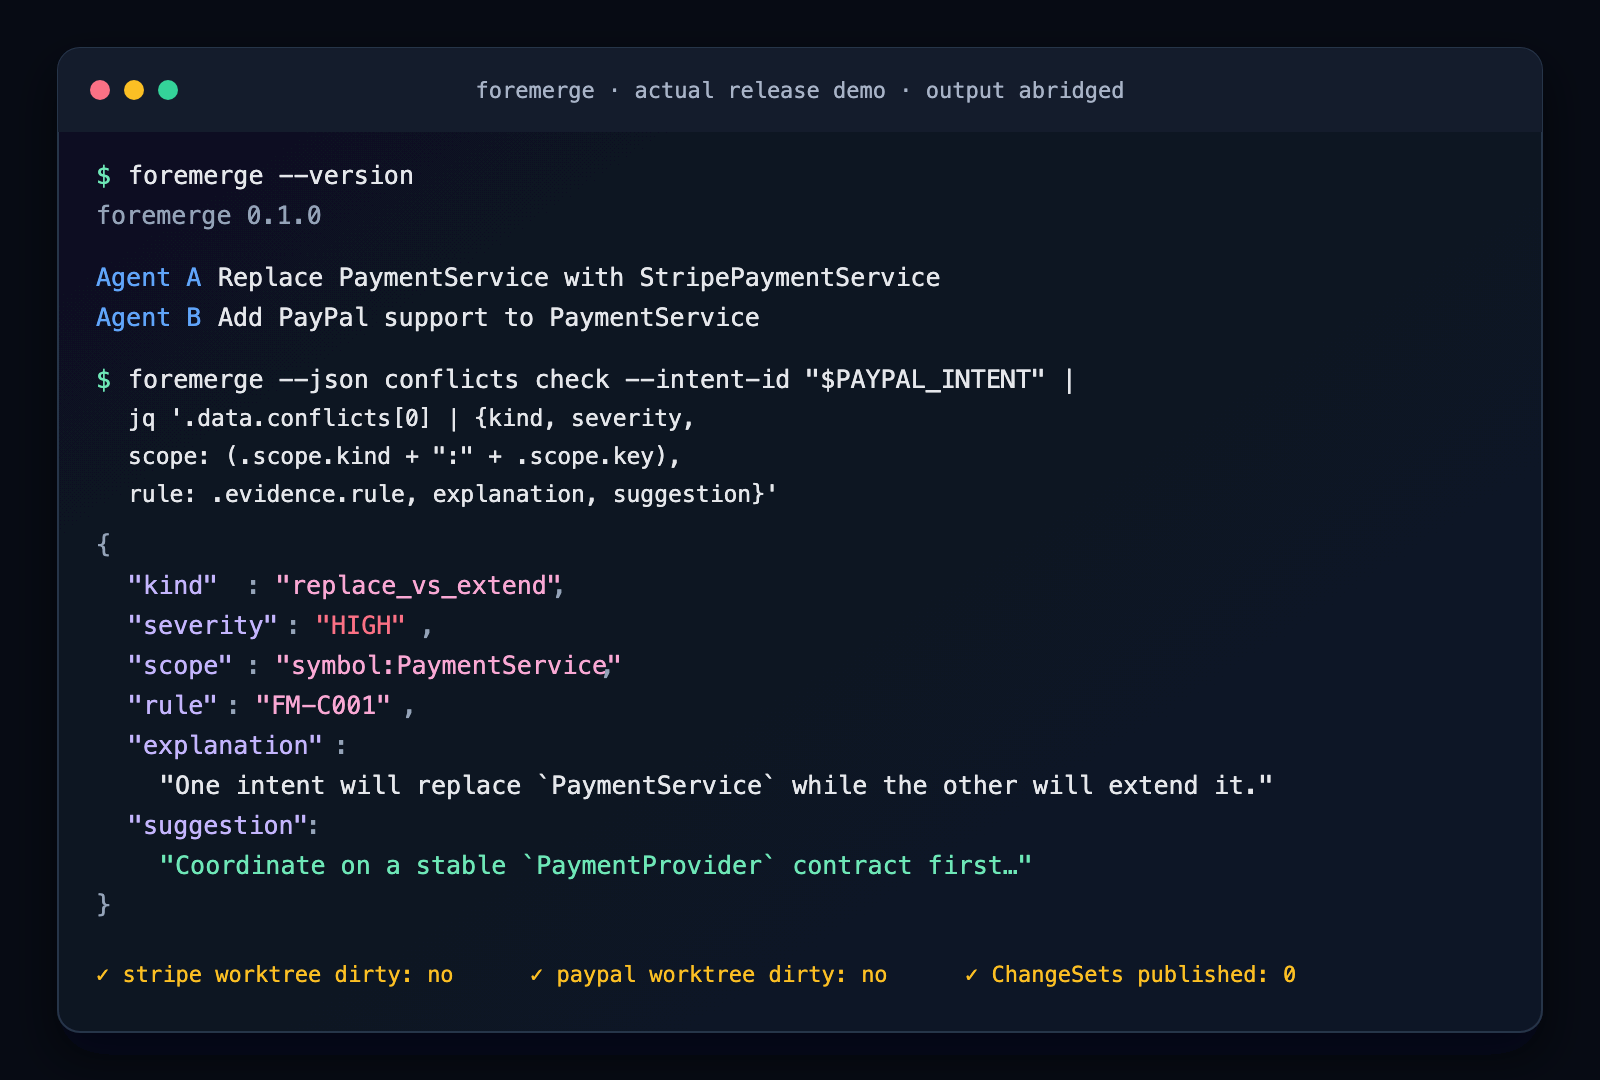
Агенты объявляют намерение до правок — не список файлов, а область и операцию вида symbol:PaymentService=replace. Пересечение с операцией extend сразу поднимает конфликт уровня HIGH с объяснением и подсказкой. Инструмент никогда не блокирует агента и не запирает файлы: предупреждения только советуют, жёсткая проверка стоит на приёмке.
Написан на Rust, лицензия Apache-2.0, 464 звезды, версия 0.5.0. Ставит себе скилл и MCP-сервер для Claude Code, Codex и Cursor одной командой:
curl -fsSL https://foremerge.com/install.sh | sh   # скрипт с сайта вендора, загляните в него перед запуском
foremerge init
foremerge setup all
foremerge checks set test -- cargo test --all-targets
Автор честен про пределы. Поиск конфликтов приблизительный, бывают ложные срабатывания и пропуски, опубликованных сравнений «с координацией против без» нет, между машинами состояние не синхронизируется. Заявляет прогон на 98 параллельных агентах в одном репозитории.
Kev — открытая альтернатива платным моделям решений.
Джаред Палмер, автор Turborepo, выложил семейство на 0,8, 4 и 9 миллиардов параметров под Apache-2.0. Это адаптеры поверх Qwen3.5 плюс маленькая голова-указатель: модель не генерирует текст, а выбирает из заданных вариантов и возвращает вероятности (репозиторий).
Три типа вопросов: да/нет, выбор из списка до 255 вариантов и оценка по шкале. Всё в одном запросе, вопросы не видят друг друга. Задержка на Apple M5: 329 мс у младшей, 779 мс у 4B, около двух секунд у 9B. На видеокарте H100 — десятки миллисекунд. Веса адаптера — от 43 до 173 мегабайтов.
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
Ценность не в скорости, а в воспроизводимости: открыты код обучения, замороженные наборы для проверки и журнал экспериментов. Слабое место названо прямо — знания. На MMLU 0,74 против 0,90 у платного аналога, на MMLU-Pro 0,52 против 0,84. Зато на маршрутизации обращений в поддержку Kev-9B выигрывает: 0,952 против 0,897.
lossless-memory — память для ассистента, которая ничего не сжимает.
Автор считает, что суммаризация и есть забывание: точные слова, время и формулировка уходят первыми. Поэтому сырые логи складываются в посуточные файлы, а время ставится на каждую запись. Поиск сначала режет диапазон по времени и только потом ищет по словам (репозиторий).
Отдельная идея — индекс «где мы сейчас». Он считается из хвоста живой расшифровки. Сливает все сессии за 48 часов в одну ленту, а старое сворачивает в получасовые корзины. Заголовок блока берётся механически из самой плотной фразы реальной реплики, а не пересказывается моделью.
Основной поддерживаемый формат — расшифровки сессий Claude Code, и автор гоняет это ежедневно с июля. MIT, 84 звезды, Python 3.11+. MCP-сервера нет, только командная строка — подключать к своей обвязке придётся руками.
git clone https://github.com/aru-labs/lossless-memory && cd lossless-memory
pip install -e . && cp config.example.json config.json
python -m lossless_memory.ingest --format=claude_code
python -m lossless_memory.index_exact
python -m lossless_memory.recall --compact=2
mini-AGI — модель непрерывного обучения на одной игровой видеокарте.
Автор извиняется за название в первой же строке, и правильно делает. Но находка стоящая. Веса лежат на диске отдельными файлами по экспертам и подкачиваются в память по требованию. Размер ограничен не видеопамятью, а свободным местом на диске (репозиторий, 318 звёзд, MIT).
Сейчас модель небольшая — 540 миллионов параметров, и в видеопамяти держатся только 32 эксперта из 169. Смысл не в нынешнем размере, а в том, что потолок задаёт диск, а не видеокарта. Скорость около 778 символов в секунду на ноутбучной RTX 3070.
Главный результат — одна строка в конфиге. Если дать модели прочитать полмиллиона символов только про шахматы, остальные семь областей проседают на 2,23 ната. Но если скорость обучения «ствола» — векторов, внимания, распределителей — снизить в десять раз относительно экспертов, деградация падает до 0,0067. Это в триста с лишним раз меньше.
Критика на Hacker News жёсткая и по делу. Нет связи с предыдущими работами, нет описания алгоритма и нет проверок по частям. А зажатая скорость обучения ствола сохраняет старое знание ценой усвоения нового. Автор отвечает честно: «никакого особого алгоритма нет, находка в том, что замедления ствола достаточно».
ZTC-Judge — проверяльщик ответов за ноль сгенерированных токенов.
На вход вопрос и чужой ответ, на выход оценка «похоже на правду». Один проход вперёд: берётся скрытое состояние последнего слоя и прогоняется через отдельный пробник. Через их API — 0,19 секунды на вызов (4B, 9B).
Работает это далеко не везде, и карточка сама показывает где. На профессиональных экзаменах по праву, математике и биологии выигрыш есть: 0,7787. Простой приём «посмотреть на длину и оформление ответа» даёт 0,7138.
А на научных рассуждениях младшая модель даёт 0,5576 против 0,7272 — то есть хуже, чем ничего. На инструкциях по безопасности обе модели тоже проигрывают простому приёму. И вторая версия пробника показала, что старшая модель не лучше младшей — цифры совпали до четвёртого знака. Авторы сами советуют брать 4B.
cua-s1-forms-coreml — 706 тысяч параметров, которые заполняют формы.
Крошечный классификатор, портированный на Core ML: выбирает одно действие из списка вроде «вписать почту», «поставить галочку», «пропустить». Не языковая модель — кодировщики поверх байтов, без токенизатора. Медиана решения — 1 миллисекунда на Apple M5 Pro, пакет весит полтора мегабайта, лицензия MIT (карточка).
Точность на полном опубликованном тесте — 99,95%, совпадает с исходной версией на PyTorch до последней строки. Авторы сами пометили релиз как «на проверке»: строгое числовое сравнение конверсии провалено на 11 строках из 24 тысяч. Все ошибки одного типа — модель выбирает действие там, где надо было пропустить.
laya-ultrafast — браузерный агент на маке без оплаты за каждое решение.
Порт чужого проекта, в котором вызовы платной модели решений заменены на открытую Laya через MLX. Снимок страницы, исполнитель и проверки безопасности взяты у оригинала, автор пишет об этом в первом же абзаце (репозиторий, MIT, только Apple Silicon).
Медиана решения около 33 мс на M1 Max. Задача «найти билет Цюрих — Лондон на Google Flights» решается за 7,5–12 секунд, пять попыток из пяти. Главная находка не в модели, а в политике. На открытый вопрос «что делать дальше» Laya отвечает плохо. Поэтому автор комбинирует узкие вопросы к ней с правилами, не зависящими от сайта: заполнить поля, выбрать из появившихся вариантов, отправить.
djev — решения через диффузионную модель.
Сервер поверх vLLM, который превращает дискретную диффузионную модель в машину структурированных решений. Идея красивая. Диффузия чистит весь холст за проход. Засейте холст шаблоном ответа, оставьте шумом только слоты — и один шаг даст распределение по каждому слоту (репозиторий, Apache-2.0).
Ставить рано. Репозиторий вчерашний, замеров нет вообще, а нужен vLLM, собранный из ветки незакрытого pull request, и модель на 26 миллиардов параметров. Интересен как идея, а не как рабочий инструмент.
Jev-Leftpad — сатира дня, и она двойная.
Пакет добавляет пробелы слева от строки, спрашивая у платной модели, сколько именно пробелов поставить. README открывается признанием: «Можно ли это сделать одной строкой через padStart()? Да. Нужен ли для этого вызов модели? Нет. Ну ладно» (репозиторий, 228 очков на HN).
Шутка бьёт в две мишени сразу. Первая — история 2016 года, когда удаление одиннадцатистрочного пакета положило сборки половине экосистемы. Вторая — свежая шумиха вокруг «типизированных решений». Лучшая деталь — пакет умеет от нуля до десяти пробелов, потому что варианты в промпте выписаны руками. А вторая лучшая: тесты подменяют модель заглушкой, то есть единственная детерминированная часть проекта — та, где модели нет.
Cloudflare Python Workers стали общедоступны, и это важно для агентов.
Python официально стал полноценным языком на Workers: CPython собран в WebAssembly и крутится внутри изолированной песочницы. Заработали FastAPI, Django и Flask — платформа сама играет роль веб-сервера (анонс).
Главное для нас в другом. Доработали requests и httpx — теперь они ходят через встроенный механизм запросов. Из коробки заработали openai, langchain и официальный mcp. То есть MCP-сервер, поисковую надстройку над базой знаний или оркестрацию агента через очереди можно поднять прямо на Workers.
Бесплатный тариф — 100 тысяч запросов в день и 10 мс процессорного времени на вызов. Платный от $5 в месяц даёт до пяти минут на вызов. Память — 128 мегабайтов на песочницу. Дорогая инициализация вынесена на выкладку: снимается снимок памяти и раскатывается по сети, поэтому холодного старта почти нет.
uvx --from workers-py pywrangler init
uv run pywrangler dev
ZuckOff — приложение, которое замечает умные очки Meta раньше, чем они заметят вас.
Слушает Bluetooth-эфир и сопоставляет рекламные пакеты с известными отпечатками: Ray-Ban Meta, Oakley Meta, Snap Spectacles. Автор — польский разработчик Павел Шидловский, он сам покупал железо и снимал сигнатуры (Wired, сайт).
Каждое срабатывание показывает, что именно совпало, и уровень уверенности. Ничего не уходит с телефона, учётная запись не нужна. Базовое сканирование бесплатно, версия с фоновым слежением — $9,99. Больше пяти тысяч загрузок за первый месяц.
Автор честно предупреждает: очки громче всего заявляют о себе при включении и выходе из кейса, часть моделей молчит вовсе. Тишина не доказывает, что вас не снимают. И сигнатуру легко подделать платой за пять долларов — а вот обратное куда труднее.
Noodle Gallery — форк Immich с общей базой лиц.
Самохостируемый менеджер фото, который догоняет исходный проект на каждом релизе. Отличие одно, но заметное: распознавание лиц работает поверх личной библиотеки и всех общих пространств сразу, а не отдельно в каждой учётной записи. Плюс общие пространства с ролями вместо убогого обмена с партнёром (проект, AGPL-3.0, 468 звёзд).
Ставится заменой двух строк в docker-compose, база и фотографии остаются на месте, откат — одним скриптом. Мобильные приложения Immich подходят.
Оговорка серьёзная. Участник команды Immich прямо написал, что форк случился, потому что «это тяжело навайбкоженные изменения, которые мы не хотим брать к себе». А скриншоты в App Store — не скриншоты, а сгенерированные макеты.
Цены на еду в США: 29 отчётов Минсельхоза сведены в графики.
Министерство сельского хозяйства публикует цены десятками разрозненных текстовых отчётов и PDF без истории. Сайт сводит 29 таких отчётов в графики с двухлетней историей. От цены на воротах фермы до того, что супермаркет напечатал в рекламной листовке (сайт).
Свежие цифры: лук +100% за год оптом в Айдахо-Фолс, картофель +68%, помидоры +48%, клубника +27%. А оптовые яйца в Нью-Йорке, наоборот, −64%. Розничные яйца +6,1% — опт и розница разъехались, и это видно сразу.
Витрина бесплатная, её код открыт под MIT. Но Kadoa — коммерческий сервис по машинному сбору данных с сайтов, и код самого сборщика не открыт. Сайт стоит в ряду других демонстрационных наборов компании.
Четырёхдневное погружение в Databricks с Claude Code внутри.
Учебный проект: вымышленный интернет-магазин, три директора с вопросами, и вы строите всё от запроса до ИИ-ассистента. День первый — SQL и панель с отчётами. Второй — конвейер данных. Третий — Claude Code. Четвёртый — ассистент, которому директора задают вопросы обычным языком (репозиторий).
Третий день интересен подходом. Claude Code работает не как чат, а как агент в терминале: читает репозиторий, правит файлы, сам запускает проверки и чинит ошибки. Задают работу три файла — CLAUDE.md с памятью проекта, PRD.md с описанием новой возможности и тесты как объективный критерий. Правило автора сформулировано в одну строку: «ИИ пишет — ты проверяешь».
Два предупреждения. Всё на бразильском португальском, перевода нет. И лицензии у репозитория тоже нет, то есть формально переиспользовать материалы нельзя. Databricks в бесплатной версии карты не просит, а на третий день есть бесплатная альтернатива Claude Code — встроенный ассистент платформы.
Новости и тренды
Amazon заблокировал агента Meta.
В ночь на воскресенье пользователи Muse стали упираться в окно при попытке что-то купить: доступ неавторизованного ИИ-агента нарушает условия использования.
Претензии — Meta не спросила разрешения, агент не представляется и, по версии Amazon, хранит учётные данные покупателей. Meta отвечает, что паролей и карт модель не видит (GeekWire, The Register).
Ход выбран неслучайно: в августе Девятый апелляционный округ отменил запрет против Perplexity по антихакерскому закону, поэтому Amazon зашёл через договор. Поручайте агенту «найди, сравни, собери корзину» — финальное «купи» на крупных площадках пока не работает. И Amazon не одумается: агент не смотрит рекламу, а она приносит ему больше $68 млрд в год.
Grok 4.7 вышел, и независимые замеры расходятся с анонсом.
Заявлено: новая базовая модель, лучшая самопроверка, цена та же — $2 за миллион входных токенов и $6 за выходных. Но свою новую модель сравнивали на максимальном усилии, а прошлую — на высоком (анонс).
По замерам Artificial Analysis индекс вырос всего на 2 пункта, с 44 до 46. А расход подскочил с 36 до 81 тысячи токенов на задачу, стоимость — с $1,86 до $3,74, скорость упала с 63 до 39 токенов в секунду. Для объёмной черновой работы в Cursor годится: лимит там щедрее. Для длинных агентских сессий — нет: чтение из кэша стоит 25% от входа, а свыше 200 тысяч токенов по двойному тарифу идёт весь запрос.
Создана консультативная группа по математике и ИИ.
Девять математиков, включая Гауэрса, Виттена и Вакила, при Институте перспективных исследований в Принстоне. Денег от OpenAI не берут.
Задача — советовать ИИ-компаниям, как ответственно публиковать математические результаты (заявление группы, анонс OpenAI).
Формулировки двух сторон стоит читать рядом. OpenAI сообщает, что её внутренняя модель решила задачу Навье–Стокса и «более ста давних открытых проблем» — и сразу очерчивает границу: темп собственной разработки обсуждению не подлежит. Группа же ни одну из этих цифр не подтверждает, употребляя оборот «они сообщают».
Впервые ИИ-компания отдала внешнему совету учёных решение о формате публикации научных результатов — но не о том, появятся ли они. Это черновик переговорной позиции любой профессии с индустрией: право советовать по подаче есть, права влиять на сам факт — нет. Мнения сообщества собирают здесь, срок не назван.
Ирландия оштрафовала Google на €403 млн за геоданные.
Нарушений четыре: незаконность обработки, невозможность доказать соответствие, непрозрачность и избыточный срок хранения. Проверялся период с мая 2018 по февраль 2020, и кроме штрафа обработку обязали починить за полгода (пресс-релиз).
Деньги уйдут государству, а вам достанется другое: регулятор официально подтвердил — понять, как ваши перемещения становятся рекламным профилем, было невозможно. Самая точная оценка прозвучала в обсуждении: €403 млн примерно равны тридцати часам чистой прибыли компании.
Иск против четырёх лабораторий за «сговор о замедлении».
Четверо платных подписчиков подали коллективный иск в федеральный суд Северной Калифорнии. Ответчики — Anthropic, OpenAI, SpaceXAI и Google.
Суть: 12 сентября Амодеи призвал замедляться ради безопасности, в тот же день его поддержали Альтман, Маск и Хассабис. Истцы не против того, чтобы каждый замедлялся сам, — претензия к частной договорённости в обход Конгресса. Ни одна из компаний на момент публикации не прокомментировала (AP).
Юридически пока ничего: класс не сертифицирован, по существу дело не рассмотрено. Но сюжет показательный — призыв к отраслевой осторожности мгновенно превратился в антимонопольный риск. Амодеи это предвидел и просил у государства узкое исключение для разговоров о безопасности.
Уолл-стрит начала торговаться о цене дата-центров.
Несколько компаний отложили выход на биржу. SB Energy, дочка SoftBank, не нашла покупателей при желаемой оценке от $50 млрд. Компания не ввела в эксплуатацию ни одного дата-центра, но обещает выручку в $439 млрд за двадцать лет. Holtec бессрочно приостановила размещение на $900 млн (NYT).
Пузырь не лопнул, и статья этого не утверждает — часть банкиров называет происходящее временной заминкой. Но публичный рынок впервые начал спорить о цене: инвесторы не готовы платить $50 млрд за компанию без единого работающего объекта. Размещение Anthropic по-прежнему намечено на эту осень.
Скрытые метки в ИИ-контенте назвали своим именем.
Автор предлагает термин «спаймарк» и отделяет его от водяного знака. Водяной знак говорит о файле, спаймарк — о человеке. И удалить его вы не можете. Подтверждённого хватает. SynthID от Google, по его собственной статье, умещает 136 бит в картинке 512 на 512 и стоит уже на 10 млрд с лишним изображений. Жёлтые точки принтеров с 1980-х кодируют дату и серийный номер (статья).
А вот цепочка «ёмкость есть — значит, там ваш логин» не замкнута ни одним документом: документация OpenAI прямо говорит, что проверка «не определяет, кто создал контент и зачем». Полезного вывода ровно один: невидимый знак переживает удаление метаданных. Привычка «прогнал через exiftool — файл чистый» больше не даёт гарантии анонимности. Для повседневных задач это неважно, для журналиста или информатора — важно очень.
Claude несколько часов сыпал ошибками.
22 сентября Anthropic чинила повышенный уровень ошибок у Opus 5, Mythos 5.1 и Fable 5.1. Две последние к моменту отчёта вернулись к норме (статус). Если у вас в эти часы необъяснимо падали прогоны — виноваты не вы. Страницу статуса стоит проверять раньше собственного промпта.
Дочь Робина Уильямса попросила перестать делать ИИ-видео с её отцом.
«Имейте хоть немного стыда» и «оставьте его вне вашего бредового месива» (Variety). Сюжет, который будет повторяться: генерация лиц умерших дешевеет быстрее, чем появляются правила.
Microsoft запатентовала показ рекламы в паузах игры.
Заявка описывает систему, которая даёт отрезок игры без рекламы. Потом игра замирает в момент простоя и показывает ролик. Момент выбирается щадящий: после босса, в загрузке, при входе в меню. Просмотр покупает следующий отрезок (Tom's Hardware).
Это заявка, а не продукт. В обсуждении резонно указали на пятнадцать лет такой же механики в мобильных играх.
Спор об основах интерпретируемости.
Автор эссе утверждает, что «схемы» внутри нейросети — неверная картина. Веса не стоят на месте, а одну функцию можно собрать миллиардом разных способов. Значит, искать надо не фиксированный набор весов, а то, что движется согласованно под обучением (What if not Circuits?).
Практического слоя тут почти нет, но одна калибровка полезна. Когда продукт обещает «объяснимость решений ИИ», помните: внутри самого сообщества спорят, существуют ли объекты, которые эти методы находят. И объяснение модели, почему она так ответила, — это отдельный сгенерированный текст, а не отчёт о внутреннем процессе.