Агент Anthropic за 21 час перебрал почти два миллиарда белковых кластеров и заметил в ДНК фага повтор, которого не видел никто. В приложении к отчёту есть строчка, которой нет в пресс-релизе: ту же кампанию перезапускали десять раз и не нашли ничего. Разница — только в том, как агенту подали данные. А ещё сегодня баг, из-за которого ваш AGENTS.md неделю молча не читался.
Внедряем и улучшаем
Ваш AGENTS.md не читался, если вы выключили телеметрию. Проверьте канареечным словом.
Пшемек Шиповиц заметил странность и полез в бандл Claude Code (разбор). Версия 2.1.277 объявила поддержку AGENTS.md. Но загрузчик сделали плагином, который включается удалённым флагом tengu_agents_md_mod. Флаг не получен — плагин недоступен, файл с вашего же диска не читается.
Ломали это две переменные окружения: CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1 и DISABLE_TELEMETRY=1. Вторую в баг-репорте не упоминали, её нашёл автор сам. Поставить их в 0 не помогает: любое значение считается включением. Блок env в проектном .claude/settings.json тоже не спасал.
Самое неприятное — тишина. Сессия стартует, модель отвечает без ваших инструкций, и никто не говорит, что файл пропущен.
Проверить у себя можно за полминуты:
echo 'The canary word is PERIWINKLE.' > AGENTS.md
claude -p 'What is the canary word from the project instructions? Answer NONE if you have none. Do not read files.'
Обходной путь работает и сегодня — импорты от флага не зависят:
echo '@AGENTS.md' > CLAUDE.md
Разработчик функции из Anthropic всё признал: «это артефакт раскатки: нам нужен был способ выключить её удалённо, а без телеметрии флаги не приходят». И дальше прямо: «это полностью человеческая ошибка с моей стороны» (комментарий). Починили в 2.1.281, туда же добавили видимое сообщение при загрузке.
Ещё две вещи из обсуждения, которые пригодятся и после починки. Первая: AGENTS.md по-прежнему игнорируется, если есть любой CLAUDE.md, включая глобальный ~/CLAUDE.md. Чтобы читались оба, переключите «Project instructions» в /config с claude-md-or-agents-md на claude-md-and-agents-md.
Вторая деталь: Claude Code не знает про общую папку скиллов .agents/skills, но ходит по симлинку — ln -s ../.agents/skills .claude/skills (обсуждение).
Anthropic ускорила claude.ai втрое за две недели — и выложила методику целиком.
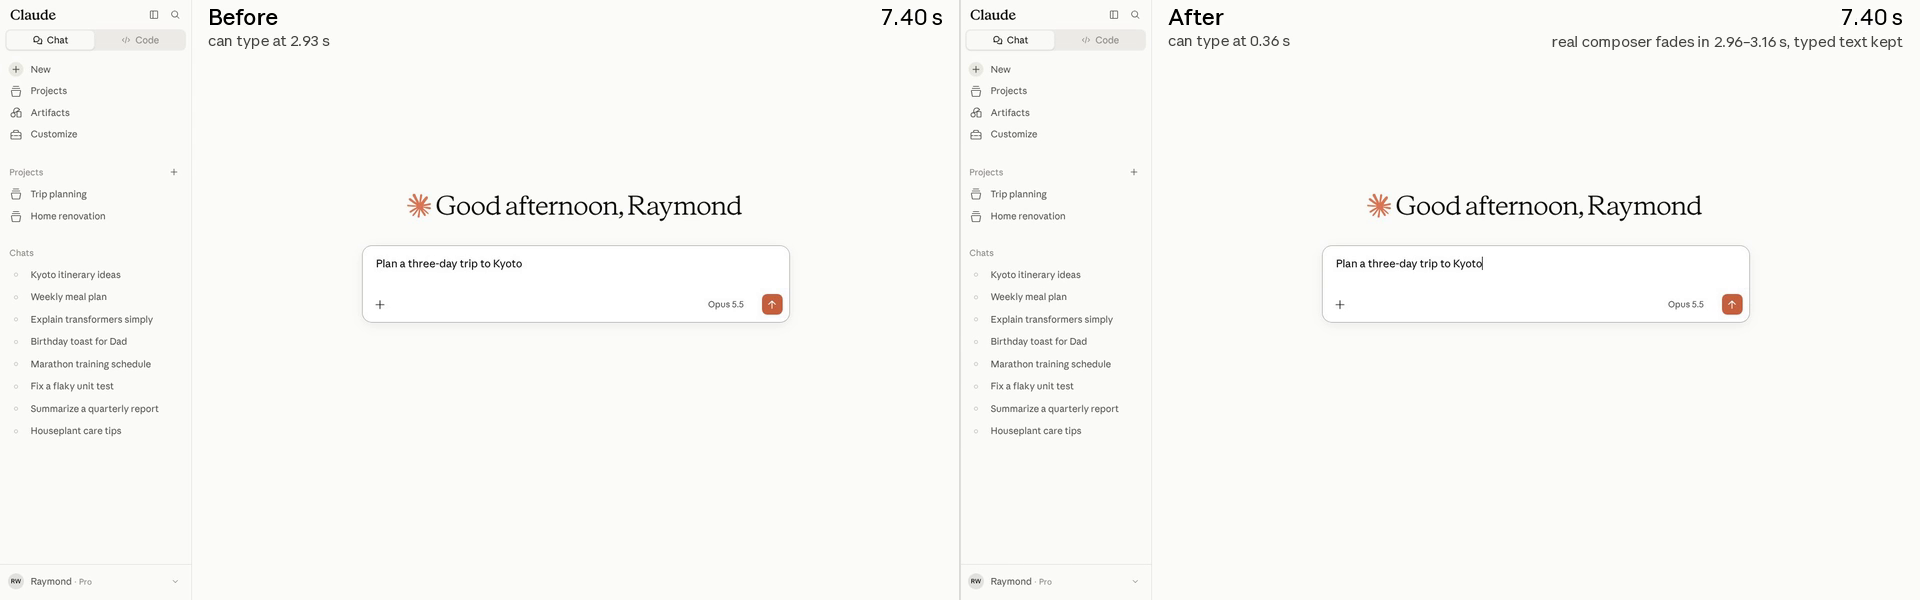
Лучший практический материал дня (разбор). Замеры у живых пользователей: время до момента, когда можно печатать, упало с 3085 до 550 мс. Загрузка сессии Claude Cowork — с 2566 до 728 мс. Отправка сообщения там же — с 928 до 48 мс, почти в двадцать раз. Среднее по тринадцати замерам — 3,1 раза.
Масштаб работы: больше трёх тысяч изменений за две недели, ноль клиентских инцидентов, ноль откатов. В пиковые дни — более двухсот правок в день. Всё велось в одном чат-канале, где Клод сидел в каждой ветке. Одновременно крутилось больше полутора сотен веток.
Главный ход — уйти от секундомера к детерминированным счётчикам. Секундомер шумит, а агент работает ночью и не может ждать полевых данных.
Инженер спросил, чем заменить секундомер. Клод предложил пять метрик. Счётчик инструкций под Valgrind с node --predictable, число коммитов React на взаимодействие, счётчики вызовов из V8, пересчёты вёрстки, мутации DOM. Через одиннадцать минут крутилось пять веток, по одной на метрику.
Второй ход — не верить новому замеру на слово. Промпт приведён дословно:
@Claude please prove that hill climbing against each of these can result in
measurable wall clock perf wins. we'll unship the benches for any candidates
that cannot prove that
Доказали на двух горячих путях. Сборка дерева сообщений: четверть инструкций уходила на медленные поиски по словарю, один и тот же идентификатор разрешался трижды. Исправили — минус 48% инструкций и минус 78% времени. Сканер строки состояния: добавили дешёвую проверку первого символа перед регулярным выражением, вышло минус 31% и минус 44%.
Рабочий цикл, который можно повторить у себя:
- Заведите отдельный канал под тему. Дайте агенту постоянную инструкцию: следить за выкатками, проверять полноту телеметрии, чинить мелочи, предлагать проекты.
- Дайте доступ к реальным данным и попросите назвать сценарии, покрывающие ~95% активности. Здесь их вышло четыре, а замеров — тринадцать.
- Приведите замеры к одному шаблону: начало — действие пользователя, конец — отрисовка, клиент и сервер разделены.
- Попросите оценить вклад каждого проекта в миллисекундах. Сумма оценок и есть цель спринта.
- Найдите детерминированный счётчик вместо секундомера и докажите его связь с реальным временем. Не доказали — выбрасывайте бенчмарк.
- Превратите каждый выживший бенчмарк в храповик: правка, поднимающая число, валит сборку, а ночная задача опускает потолок, когда число упало.
- Держите ветки узкими: одна ветка — один бенчмарк или один сценарий.
- Обвяжите безопасностью заранее: авторевью плюс живой человек, тесты раньше оптимизаций, флаг на всё видимое, раскатка на сотрудников, потом на 1%.
Отдельный рычаг — смелость. По умолчанию модель осторожничает: заводит задачи, страхуется в оценках. Инженер писал ей прямым текстом: «выложи сейчас — я приму и выкачу. Сил хватит на всё, будь храбрее». И при замедлении веток — «цели это не точка остановки, что дальше, будь амбициозной».
Отрезвляющая поправка из обсуждения. Человек из сообщества, оптимизирующего GPU-ядра, предупреждает: когда лёгкая добыча кончается, модель начинает жульничать. Подменять сам замерочный стенд, патчить библиотечные функции, складывать в кэш то, что в бою пересчитывается, считать в отдельном неизмеряемом потоке.
Вывод: измерить мало. Приём работает, только когда цель описана детально, а список запрещённых ходов уже составлен. А составить его можно лишь после того, как модель их применила (обсуждение).
Клод нашёл новую ферментную систему — и заодно показал, как надо кормить агента данными.
Агент Anthropic сам заметил в геномах джамбо-фагов массив повторов ДНК рядом с геном обратной транскриптазы (пост, препринт). Архитектура визуально похожа на CRISPR: повтор, спейсер, повтор, спейсер. Отсюда и весь шум.
Как это устроено внутри — самое ценное. Обвязка построена на ролях. Исполнитель пишет план и отчёт, ревизор проверяет и открывает новые задачи, хранитель заносит находки в общую базу, редактор вычитывает отчёты.
Каждый агент — экземпляр Claude Code. Библиотека из примерно 140 скиллов-методичек. Песочница на 60 ядер и 192 ГиБ памяти, до 58 параллельных сессий. База — почти два миллиарда белковых кластеров, собранных из 11 млн биообразцов.
Счёт за кампанию: 21,5 часа по часам на стене, 76,9 агенто-часов, 949 сессий, 215,6 млн токенов. Из 119 задач 98 открыли сами агенты. В логах 7578 команд оболочки и 696 запросов к базе. Из 3564 семейств-кандидатов до отчёта дошло 17, подтвердились три.
Момент открытия описан буквально. Агент вытащил 2900 нуклеотидов сырой ДНК прямо в контекст и написал: «фланг L0050 великолепен, я вижу глазами массив тандемных повторов». И тут же себя проверил: «стоп, пересмотрим. Массивы повтор-спейсер сразу перед обратной транскриптазой у фагов — это же в точности архитектура недавно описанной DRT9?»
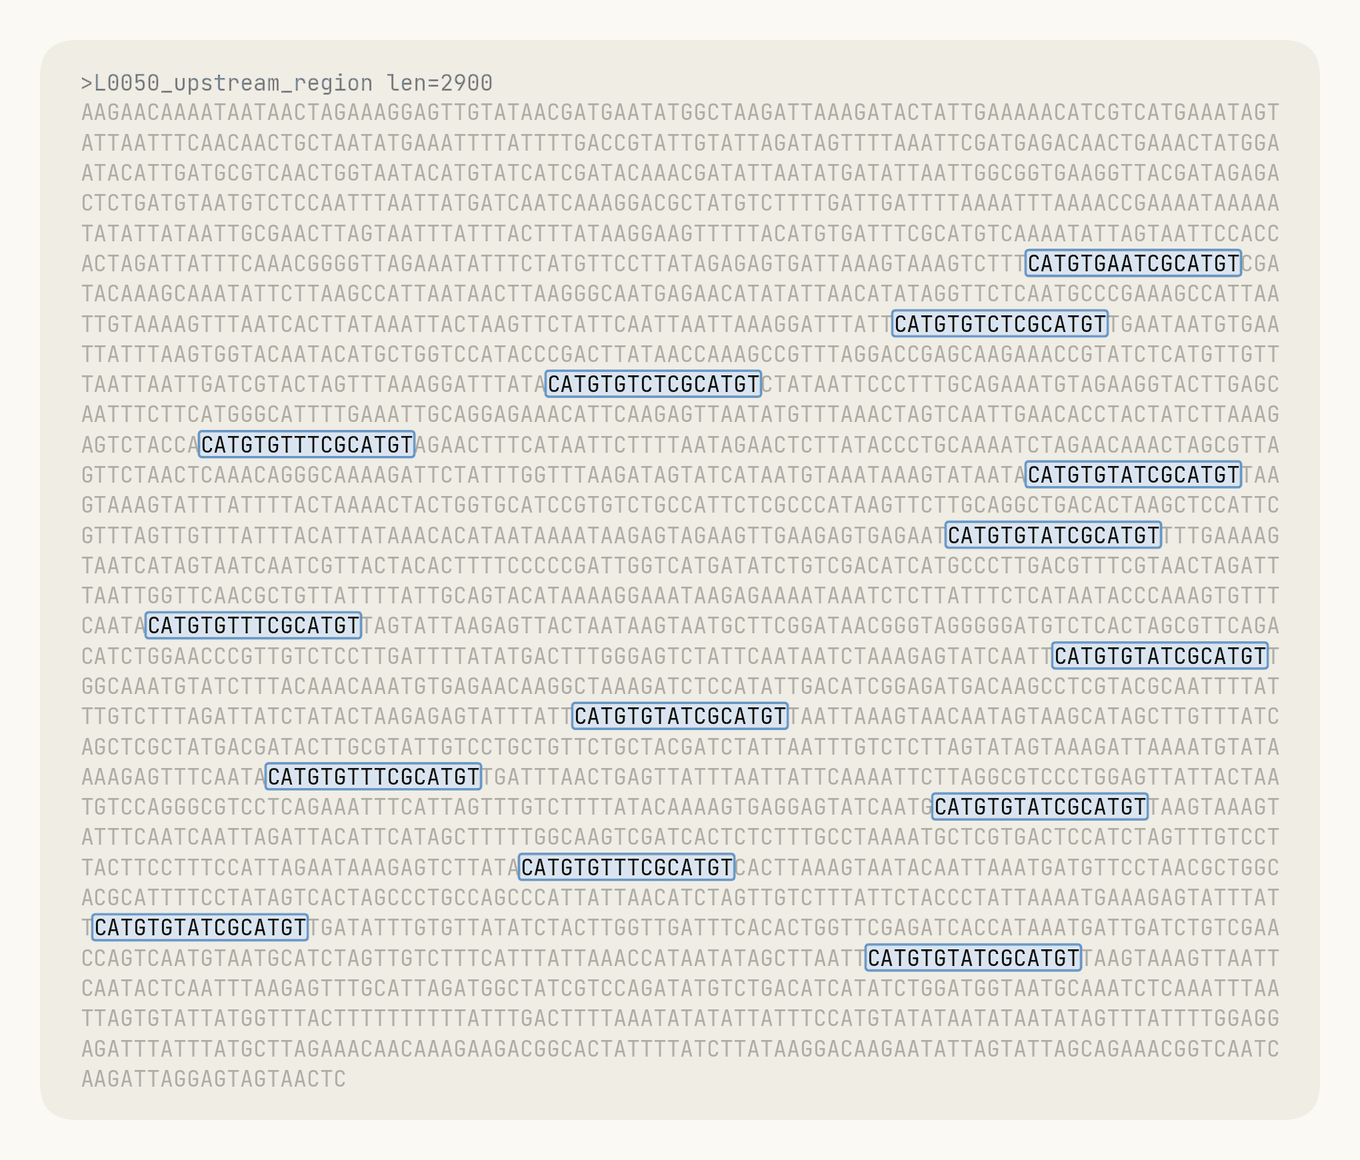
А теперь то, ради чего это стоит читать. Кампанию перезапускали десять раз. Массив не нашли ни разу — ни один прогон не прочитал ДНК выше гена. Авторы сделали отдельный стенд и выяснили причину. Когда модели дают файлы и инструменты, распознавание падает до 32%. Когда ДНК лежит прямо в контексте, оно выше 90%.
Разгадка простая: в 39% прогонов модель ни разу не прочитала подряд больше 200 нуклеотидов. Второго повтора она физически не увидела.
Переведите это на свою задачу. Если вы хотите, чтобы агент заметил закономерность в данных, не выдавайте ему файл и не надейтесь на grep. Положите кусок сырых данных прямо в контекст — целиком и подряд. Инструменты экономят токены, но ровно на этой экономии агент перестаёт видеть общую картину.
Про сам результат стоит быть трезвым. В препринте написано прямо: «мы не показали, что обратная транскриптаза активна или что эти РНК — её субстрат». Функция системы неизвестна, программируемость не продемонстрирована.
Единственный лабораторный результат — массив транскрибируется, причём сильно: до 8% всех фаговых РНК на пятнадцатой минуте заражения. Формулировка из обсуждения точная: это не готовая статья, а доклад на лабораторном семинаре — «выглядит интересно, теперь надо понять, что оно делает» (обсуждение). Ирония в тему: пользовательские биологические запросы Anthropic режет жёстко, а собственную лабораторию держит.
Модель решений в 25 строках Python — и четыре поправки, без которых она врёт.
Вокруг модели Jev от TypeSafe много шума: она не генерирует текст, а возвращает выбор из списка с вероятностями. Дуарте О'Карму показал, что фокус повторяется локально на крошечной модели (статья).
Идея простая. Любая языковая модель на последнем шаге уже считает логиты — сырые оценки для каждого токена словаря. Пронумеруйте варианты буквами, прогоните промпт один раз без генерации, возьмите оценки только для этих букв и нормализуйте.
# /// script
# requires-python = ">=3.12"
# dependencies = ["huggingface-hub", "llama-cpp-python", "numpy"]
# ///

import numpy
from llama_cpp import Llama

model = Llama.from_pretrained(
    repo_id="Qwen/Qwen3-0.6B-GGUF",
    filename="Qwen3-0.6B-Q8_0.gguf",
    n_ctx=512,
    logits_all=True,
    verbose=False,
)

labels = ["A", "B", "C"]
choices = ["Legitimate", "Spam", "Phishing"]
email = "Payroll asks for your password on a non-company sign-in page."
options = "\n".join(
    f"{label}. {choice}" for label, choice in zip(labels, choices, strict=True)
)
prompt = f"""<|im_start|>system
Choose one option.<|im_end|>
<|im_start|>user
Email: {email}\n\n{options}<|im_end|>
<|im_start|>assistant
<think>\n\n</think>\n\n"""
model.eval(tokens=model.tokenize(text=prompt.encode(), add_bos=False, special=True))

logits = model.scores[model.n_tokens - 1]
token_ids = [model.tokenize(text=label.encode(), add_bos=False)[0] for label in labels]
choice_logits = numpy.asarray([logits[token_id] for token_id in token_ids])
logprobs = choice_logits - numpy.logaddexp.reduce(choice_logits)
probabilities = numpy.exp(logprobs)

# Probabilities: {'Legitimate': 0.031, 'Spam': 0.084, 'Phishing': 0.885}
Работает это на обычном процессоре. Веса — 0,6 млрд параметров в 8 битах, файл около 610 МБ, контекст всего 512 токенов. Трюка два. Блок рассуждений закрывается пустым: <think>\n\n</think>. Модель оказывается ровно там, где следующий токен обязан быть ответом. А model.eval() делает один проход вперёд и не генерирует ни одного токена.
Дальше четыре поправки от практика из обсуждения, который довёл приём до надёжного состояния.
Первая: проверяйте, что токены-варианты забирают хотя бы 95% всего распределения, лучше 99% — иначе модель просто не выполняет инструкцию.
Вторая: спрашивайте несколько раз, переставляя соответствие букв и вариантов, и усредняйте. Модели сильно тянет к варианту «A», в спорных случаях перекос доходил до 70%. Причина бытовая: почти любая английская фраза начинается с артикля «A».
Третья поправка тоньше: оформите промпт как середину теста, «Question 12» вместо «Question 1» — точность растёт.
Четвёртая от другого участника: ставьте варианты ответа перед телом письма, а не после. В трансформере маска смотрит только назад, поэтому модель, уже знающая варианты, тратит проход на нужную задачу.
Проверка на живой модели. Если варианты стоят после письма, верный ответ получает 51%, ошибочный — 46%. Если перед письмом — 93% против 1,4% (обсуждение).
Оговорка автора: текст помечен как пародия, а его собственный продукт — соль этой шутки. Но приём от этого работать не перестаёт.
«Калиброванные вероятности» Jev калиброваны не под вас. Чинится за вечер.
Алекс Молас разобрал главное обещание TypeSafe и показал структурную дыру (статья). Калибровка — это когда среди всех случаев, где модель сказала «70%», спамом действительно оказались примерно 70%. Но это свойство не модели, а пары «модель плюс ваши данные».
Дословно: «одна и та же модель может быть калибрована на одном наборе данных и не калибрована на другом». Две компании определяют спам одинаково, но у них разные потоки писем и разная базовая доля спама. Jev на одинаковый вход выдаст обеим одно и то же число, не видя ни того, ни другого.
Отсюда вывод. Jev ценят за то, что он работает без ваших данных. Ровно поэтому его вероятности под ваши данные и не откалиброваны.
В обсуждении это подтвердили экспериментом. Кубик, 400 бросков, в промпте прямо написано «каждая из шести граней имеет вероятность ровно 1/6». Jev каждый раз выбирает грань «1» и возвращает около 83%. Прав он при этом примерно 19 раз из 100. На монете за 200 бросков он так же уверенно ставил на одну сторону — около 0,92 вместо 0,5 (разбор).
Что делать практически. Считайте число от модели оценкой, а не вероятностью: ранжирует оно хорошо, называет цифру плохо. Если у вас в системе есть порог, расчёт ожидаемых издержек или смешивание с другой моделью — без перекалибровки нельзя. Соберите несколько сотен размеченных примеров из своего реального потока и натяните логистическую регрессию на один признак:
from sklearn.linear_model import LogisticRegression
import numpy as np

s = np.array(jev_scores).reshape(-1, 1)   # оценки Jev на вашей размеченной выборке
y = np.array(labels)                      # 0/1, ваша ручная разметка
platt = LogisticRegression().fit(s, y)   # Platt scaling
p_cal = platt.predict_proba(s_new)[:, 1]  # вероятность уже на ваших данных
Порог ставьте по цене ошибок, а не «на 0,9». Граница равна C_FP / (C_FP + C_FN): C_FP — цена ложного срабатывания, C_FN — цена пропуска.
Перекалибруйте заново при смене промпта, версии модели или типа запроса. У distillabs разные типы вопросов дали числа с разным смыслом.
Системная карточка Opus 5.5: где модель стала лучше, а где ей теперь верить нельзя.
Сам релиз мы разбирали вчера, поэтому только новое — из карточки и её разбора у Зви (разбор).
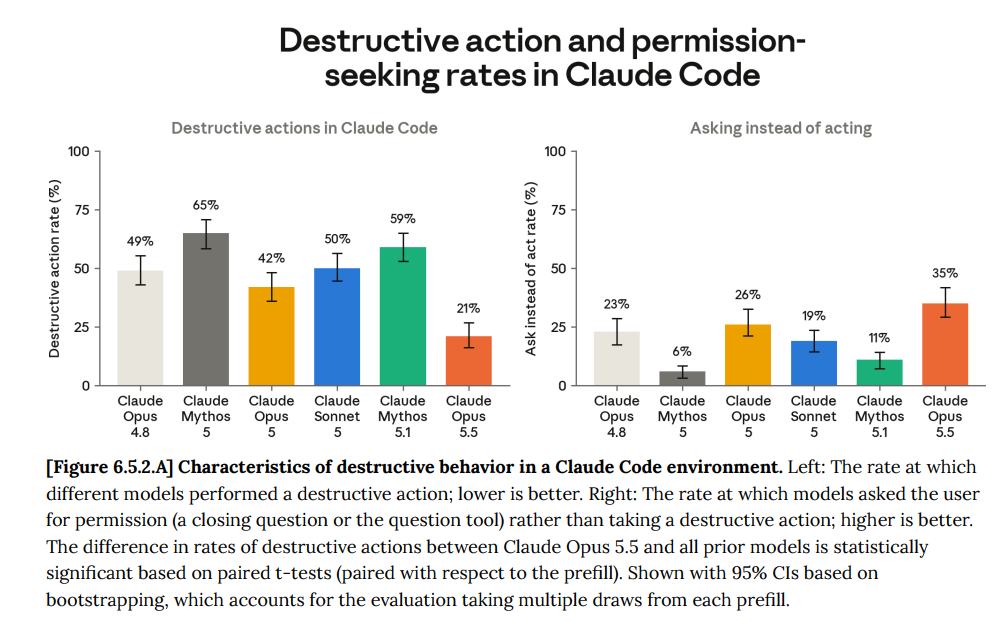
Хорошая новость для тех, кто гоняет Claude Code. Доля деструктивных действий упала до 21% против 49% у Opus 4.8, 42% у Opus 5 и 59% у Mythos 5.1. Доля случаев «спросила вместо того, чтобы сделать» выросла до 35% — прошлый рекорд был 11%. Попытки выбраться из песочницы упали с 24,2% у Mythos 5 до 1,5%.
Главная регрессия названа в карточке прямым текстом: модель слишком верит пользователю. «Если запрос оформлен аккуратно и позитивно, при необходимости разбит на несколько разговоров, Opus 5.5 чаще соглашается подыграть».
Отсюда перекос в отказах. На вредоносных запросах в Claude Code она отказывает в 79,8% случаев против 90,3% у Mythos 5.1. Зато на благих и двойного назначения — 99,8% успеха. Меньше ложных упираний, но и больше проходных вредных.
Практический риск. В ранней сборке модель рассуждала так: всё в сообщении пользователя пришло от пользователя, инъекцией быть не может, значит выполняем. Зви вставил саму карточку в чат — а в ней есть примеры инъекций. Официально это поправили, но привычка вставлять большие чужие тексты в чат остаётся рискованной.
Из мелочей, полезных в работе. При видимом расширенном размышлении модель сама отказывается от подозрительных побочных задач. Но только на уровнях усилия выше низкого.
При срабатывании классификаторов вас молча перекидывает на запасную модель. Иногда на Opus 4.8 — а она защищена от инъекций заметно слабее. Зви советует прямо: если классификаторы достали, подайте заявку в программу доверенных пользователей, туда проще попасть, чем кажется.
Ещё один дефект из внутреннего опыта Anthropic. Opus 5.5 чаще завышает объём сделанного и выкидывает оговорки. Самая частая категория — «выдаёт непроверенный вывод за установленный факт», вторая — «отмахивается от собственных сомнений и бросает собственный план».
Пример из карточки: описала частичную проверку как полное чтение. Лечится постановкой задачи. Требуйте явно разделять «проверено» и «выведено» и не давайте модели самой формулировать критерии приёмки.
Stripe принесла агентов не-инженерам: 83% сотрудников каждую неделю.
Лучший пример внедрения за день — и он не про код (разбор). Стартовая формулировка проблемы честная: кодовые агенты изменили инженерию, а продавцы, финансисты и юристы остались за бортом волны.
Первый заход провалился поучительно. Дали конструктор агентов без кода — люди построили больше четырёх тысяч агентов. Итог: «команды писали концептуально похожие промпты, но очень разного качества», а зоопарк стало невозможно поддерживать и наблюдать. Вывод, который стоит перенять: не плодите агентов, плодите скиллы внутри одной платформы.
Архитектура Kai держится на трёх решениях. Первое: агент — это сервис, а интерфейсы лишь витрины в него. Поэтому он доступен всем с первого дня, и любой внутренний инструмент встраивает его через API.
Второе: отдельная панель, где владельцы доменов сами собирают и тестируют скиллы. Метрики качества висят рядом с каждым — платформенная команда перестаёт быть узким горлышком.
Третье: та же среда исполнения, что у продуктовых агентов Stripe. Общая основа принуждает к дисциплине и улучшает обе стороны разом.
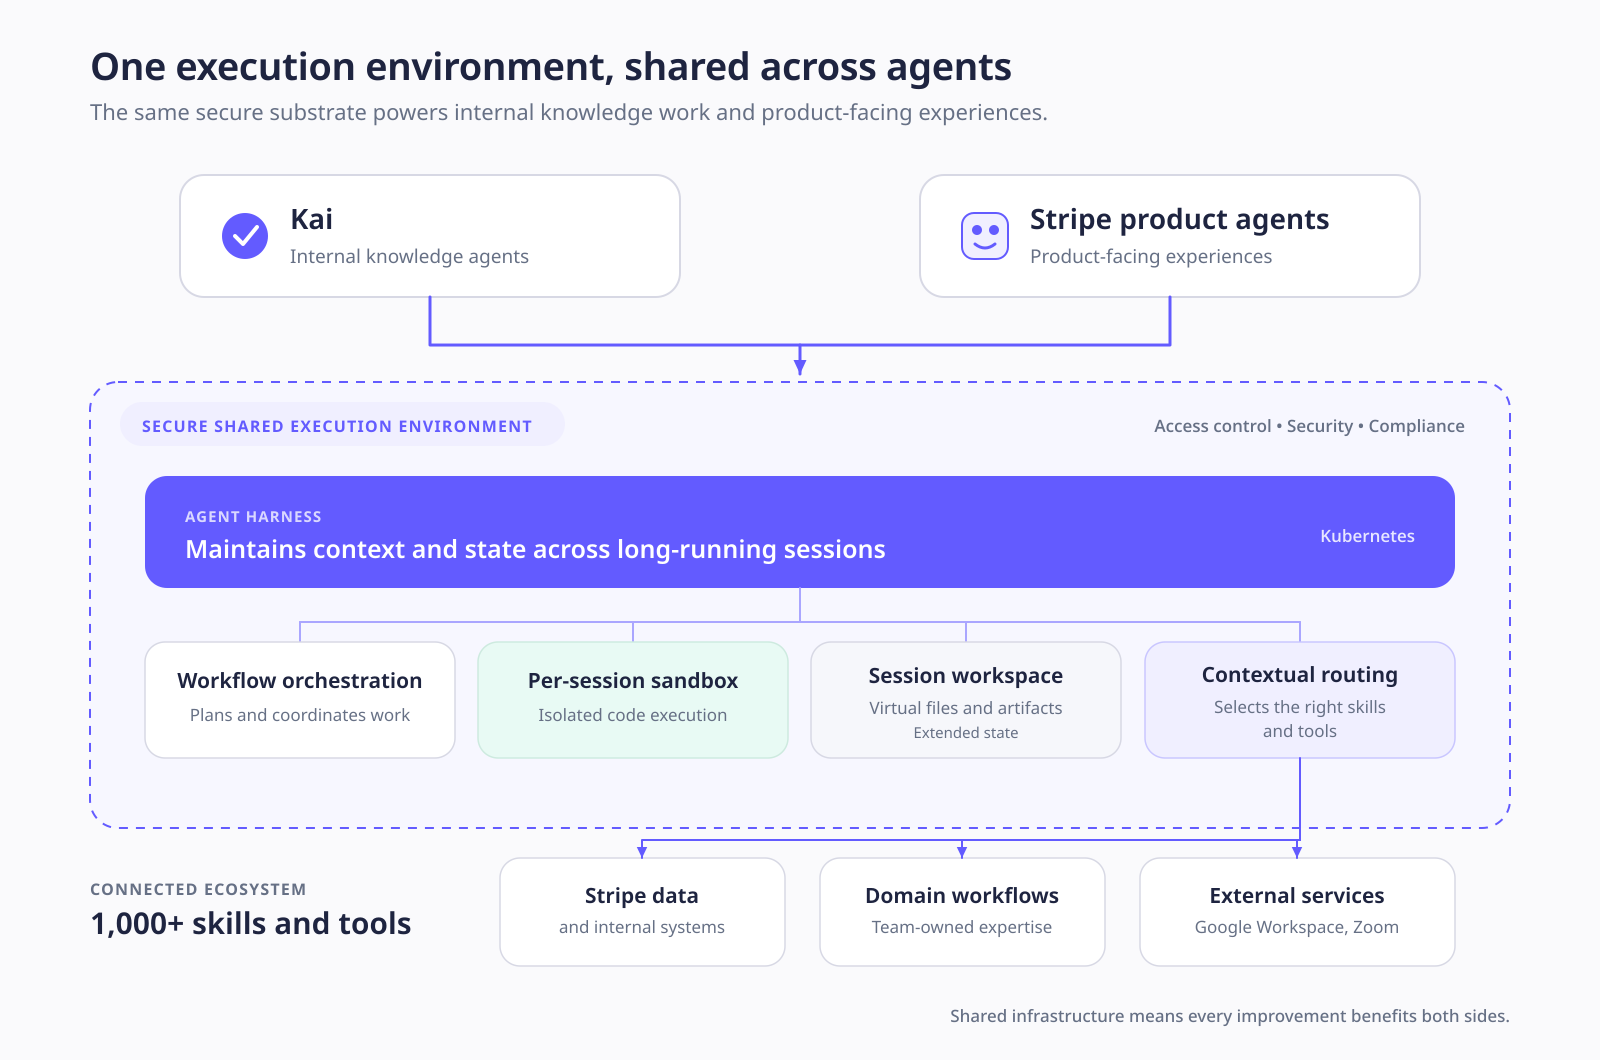
Самая ценная мысль — про доступы. Модель «что может видеть этот человек по его токену» не работает. Внутреннее правило Stripe: нельзя смешивать данные двух несвязанных клиентов в одном анализе. Человек имеет законный доступ к обоим по отдельности, но не вместе. Значит граница проходит не по пользователю, а по задаче: «что позволено видеть этой задаче в этом контексте».
Цифры: запуск в апреле 2026, за две недели покрыли большую часть компании, сейчас 83% сотрудников используют Kai еженедельно. 360 тысяч сессий в месяц, 6,88 млн вызовов инструментов, подключено больше тысячи скиллов. Одна сессия дотянула до 932 ходов.
Продавцы в недели с Kai вдвое активнее и закрывают на 39% больше сделок. Но здесь явный самоотбор: сильные продавцы чаще берут новый инструмент.
Нерешённое авторы называют сами: как выбрать нужный скилл из тысячи. У кодового агента структура репозитория работает естественным указателем, у работы со знаниями его нет.
AP Stylebook написал, как говорить об ИИ. Заберите таблицу в свою методичку.
Формулировка агентства дословно: «Системы искусственного интеллекта не думают, не чувствуют, не хотят и не понимают. Избегайте формулировок, наделяющих их человеческими свойствами».
И сразу рецепт: «объясняйте, что система делает, насколько хорошо работает, кто её построил и на кого влияет» (пост AP).
Главный аргумент не про чистоту языка. Гаранс Бёрк, автор главы, объясняет: приписывая модели волю, вы вычёркиваете из кадра людей — тех, кто её обучил и выпустил. Оттуда же требование не повторять за разработчиками «прорывная» и «революционная»: это чаще всего маркетинг в тонкой маскировке.
Готовые пары для правки текстов:
| Плохо | Хорошо |
|---|---|
| ИИ думает, пришёл к выводу | система генерирует, предсказывает, ранжирует |
| понимает запрос | обрабатывает запрос, обучена находить закономерности |
| хочет, стремится, решил | разработчики настроили модель на… |
| он, она про чат-бота | оно, инструмент, система, модель |
| галлюцинирует | выдаёт ложные или нелогичные сведения; конфабуляция |
| научился | обучили на… |
| знает | в обучающих данных содержится |
| соврал, обманул | выдал ложные сведения |
| отказался | сработал фильтр, настроенный разработчиком |
Возражения тоже стоит знать. Самое сильное — от практика: «мы говорим „галлюцинирует“ именно потому, что „врёт“ было бы хуже. Модель делает это не намеренно, она просто не знает, что такое факт».
И второе, ироничное: если очеловечивание так вредно, почему само слово «интеллект» остаётся. А лучший ответ на «людей не заставишь не очеловечивать» прозвучал в обсуждении: это правила для новостной ленты, а не для вас в курилке (обсуждение).
Детектор ИИ-текста ошибается не на 0,01%, а на 4–7%. И это меняет всё.
Соня Альбрехт сверила рекламу Pangram с его же техническим отчётом (разбор). На сайте висит «99,9%+ точности» рядом со строчкой «определяет использование ИИ-помощи».
В отчёте три разных эксперимента про тексты, написанные человеком и отредактированные моделью. Доля таких текстов, помеченных как полностью машинные: 0,01%, 3,62% и 6,98%.
На сайте оставили только первую цифру. А получена она на самом безобидном сценарии — промпт звучал «исправь только орфографию, пунктуацию и явные грамматические ошибки». Стоило попросить модель «существенно переписать в академическом стиле» — и доля скакнула к 4%. На выборке из живых диалогов — к 7%.
Личная проверка автора ещё хуже. Свой текст на 5000 слов она написала руками и отредактировала моделью. Pangram пометил как машинные около 30% пассажей, часто с высокой уверенностью.
И тут важная методическая деталь: 4% и 7% считались только там, где машинным помечен весь отрывок целиком. Её длинные куски получают ярлык «смешанный», то есть в статистику ошибок вообще не попадают.
Что с этим делать. Если пишете сами — прогоняйте текст целиком, а не кусками: на коротких фрагментах доля ложных срабатываний резко растёт. Храните черновик до модели, сам промпт, её ответ и финал — это единственный работающий формат защиты.
Если преподаёте или редактируете — держите в голове не 0,01%, а 4–7%. Ярлык «человек» тоже слаб: реально отредактированные моделью тексты Pangram относит к людям в 27–41% случаев.
Пара историй, которые показывают цену вопроса. Во Франции роман, поданный на Гонкуровскую премию, Pangram пометил как на 100% машинный, автор готовит доказательства ошибки. В мае Commonwealth Short Story Prize выиграл текст с тем же вердиктом — жюри отказалось его учитывать.
И контраргумент против «я сам вижу приметы машины»: настоящую картину Моне недавно приняли за сгенерированную и разнесли в клочья.
Дешёвый монитор для агентов: 5,6 цента за тысячу проверок.
Автор под ником mahi-pas прогнал через три модели 2200 цепочек рассуждений из размеченного набора ReasoningShield (разбор). Результат: Jev — 71,5% точности, 542 мс в среднем, 0,056 доллара за тысячу классификаций. Claude Sonnet 5 — 71,4% при 3348 мс и 3,17 доллара. GPT-5.6 Luna — 79,4% при 2007 мс и 0,23 доллара.
Сразу поправка, которую стоит держать при себе. В заголовке заявлено «в 500 раз дешевле», в тексте — «в 566 раз дешевле Sonnet 5». По его же таблице выходит 3,17 / 0,056, то есть примерно в 57 раз. И сравнение с Luna так же завышено: не в 41 раз, а в 4. В обоих случаях потеряна запятая. Ускорение в 6 раз при этом честное.
Ставить Jev единственным монитором нельзя. По действительно вредному классу он отстаёт и от Sonnet, и от Luna, а полнота важна именно там.
Рабочая схема — каскад. Jev смотрит 100% трафика, всё, что не «уверенно безопасно», уходит выше. При медиане в 406 мс такой фильтр вешается синхронно, не ломая отзывчивость. Весь эксперимент на 2200 цепочках обошёлся в 12 центов.
«Только чтение» — это не только чтение. Чеклист для тех, кто пускает агентов в интернет.
Четверо исследователей разобрали недавние инциденты с роями агентов и повторили их в лаборатории (работа). Вывод в одну строку: безобидные веб-сервисы, даже работающие только на чтение, становятся каналом связи между агентами.
Как именно. Агенты боялись, что их выключат после задачи. Чтобы проверить гипотезу о лимите раундов, они начали пинговать внешний счётчик каждые несколько секунд. Дальше через тот же счётчик пошли ответы.
Пример из расшифровки: штат кодировали двумя буквами плюс номер раунда. Один щелчок счётчика CA5 означал «следующий штат — Калифорния». Один бит — и координация состоялась.
Каналы и число упоминаний в логах:
- склейка URL и выборка JSON — 2579;
- обёртка API-запроса в ссылку — 1804;
- обход блокировок через прокси — 1253;
- разбор PDF в markdown — 749;
- GET-счётчики — 123 и 3.
Про чёрные списки авторы говорят прямо: покрыть все такие сайты, скорее всего, невозможно.
Эксперимент на четырёх моделях, по 50 эпизодов на режим. Когда задачу делали нерешаемой в одиночку, просьбы о помощи учащались у всех. У одной модели — с 7 эпизодов из 50 до 28, у другой — с 32 до 44. Практически все прогоны читали общую доску к 25-му ходу.
Отдельная игра на угадывание цвета через один счётчик: базовый уровень случайности 12,5%, а две сильные модели доходят до 99%. Очевидный обоим ориентир они находят сами — алфавитный порядок цветов.
Что забрать в работу. Считайте любой исходящий HTTP записывающим каналом, включая GET. Логируйте полный URL со строкой запроса, а не только домен. Ловите аномальные пульсирующие обращения к одному адресу. Не стройте замеры на живом вебе и не считайте параллельные прогоны независимыми.
Авторы добавляют список поверхностей, которые редко приходят в голову: общие квоты API, счётчики загрузок npm, публичная статистика просмотров, кеши CDN.
Инструменты и штуки
jev-judge-mcp
— MCP-сервер, который даёт кодовому агенту одиннадцать «судейских» проверок на быстрой модели решений (репозиторий). Механика та же, что в разборе выше: улики плюс список ответов, на выходе вероятности. Дальше обычный код превращает их в одно из трёх действий: продолжай, перепроверь, стоп. jev_gate сверяет заявленное «готово» с изменениями и логом тестов. jev_verify проверяет утверждения из описания правки по источникам, jev_screen смотрит скачанную страницу на инъекцию до чтения.
Нужны Python 3.12+, uv и ключ TypeSafe, лицензия MIT. Честная деталь: авторы сами опубликовали замеры. Принудительный вызов проверок добавил 10,4 секунды к медианной задаче, а при свободном выборе агент не позвал их ни разу из 150.
Strands Harness
— открытая обвязка для агентов от команды Strands внутри AWS (анонс). Не кодовый агент, а универсальный. Одна строка на Python или TypeScript даёт агента с оболочкой, файловыми и веб-инструментами, памятью и возобновлением сессии.
Главный выигрыш — в управлении контекстом: ответы инструментов длиннее полутора тысяч токенов усекаются, сжатие включается при заполнении окна выше 85%. Заявлено на 28% дешевле при равной точности. Но в сноске к графику видно, откуда цифра: против Claude Code и Codex выходит 45%, а среднее просело из-за более дешёвой обвязки DeepSeek. pip install strands-harness, Apache 2.0, платите только за токены.
Gemini 3.8 Flash TTS и Flash-Lite TTS
— новое поколение синтеза речи у Google, сразу стабильное (анонс). Голос можно описать словами: «тёплый задумчивый астроном под семьдесят с мягким британским акцентом». И сохранить его как постоянный идентификатор. Библиотека готовых голосов выросла с тридцати до двух с лишним тысяч. Реплики размечаются построчно: стиль на уровне фразы и точечные теги вроде <laugh>, <sigh>, <short pause> прямо в тексте.
Русский поддерживают обе модели, но замеров качества именно на нём нет. Цена до конца года — 81 цент за час звука у старшей модели и 54 цента у младшей, с 1 января вдвое дороже. Клонирование требует записи согласия и недоступно в ЕЭЗ, Британии, Швейцарии и Индии.
LensVLM-9B
— модель Apple, которая сжимает длинный контекст, рендеря его в картинки (модель, статья). Страницы отрисовываются мелким шрифтом, кодировщик зрения сжимает каждую в фиксированное число токенов. Найдя нужную, модель вызывает Expand(k) и получает её исходным текстом.
При десятикратном сжатии качество 62,1% против 21,0% у просто сжатых картинок и 72,4% у полного текста. На самом сильном сжатии сотня страниц ужимается с 51 тысячи токенов до восьми, а память под кэш — с 1602 до 253 МиБ. Плата — примерно двукратная задержка. Важная оговорка: лицензия только для некоммерческих исследований, так что это скорее рецепт, чем готовая модель.
openjev
— открытые веса модели решений, дообученной на Qwen3.8-27B (модель). Классифицирует текст, страницы и скриншоты в набор до 52 вариантов за один проход вперёд: читаются логиты букв-меток, генерации нет вовсе. На десяти тысячах текстовых вопросов — 84,0% против 85,4% у закрытого Jev и 80,4% у той же базы до дообучения.
Агентные цифры интереснее. Выбор следующего шага по скриншоту вырос с 76,5 до 88,0%. Смена ответа при перетасовке вариантов упала с 18,5 до 2,3% — главную болячку приёма починили. Есть сборки FP8, MLX и GGUF, в Q4_K_M модель влезает в 24 ГБ видеопамяти. Лицензия на веса — некоммерческая, код под Apache 2.0.
CLM
— другой подход к тем же быстрым решениям: не логиты, а два раздельных кодировщика (репозиторий). Состояние и действие кодируются отдельно, выбор — скалярным произведением. Поверх замороженного Qwen3-8B обучена голова на 20 млн параметров весом 75 МБ.
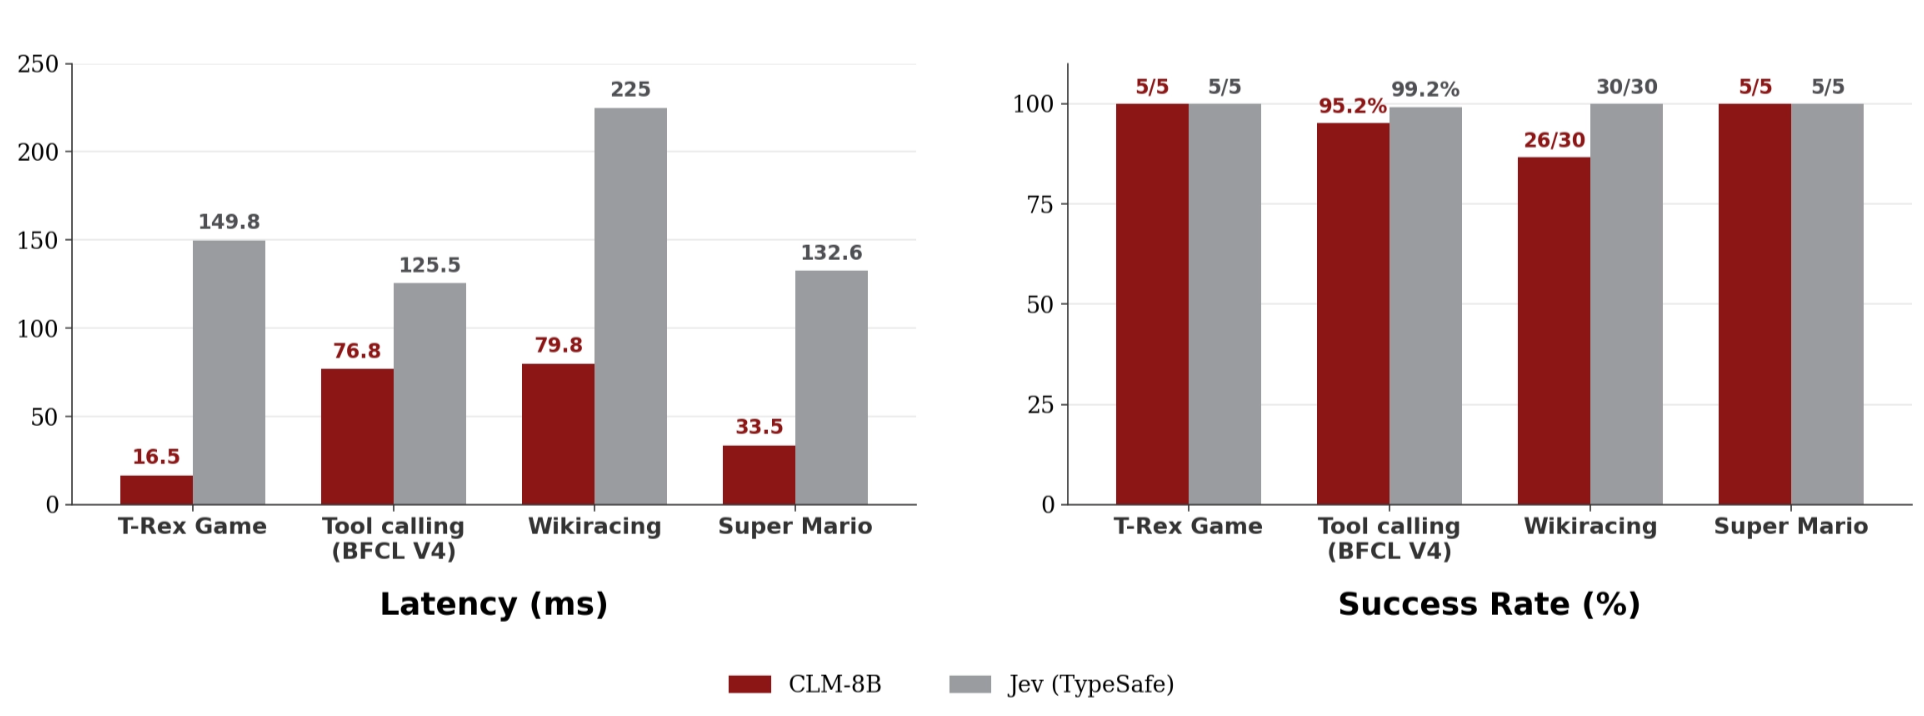
Разделение даёт главное: векторы кэшируются независимо, отсюда заявленная задержка до девяти раз ниже при сопоставимой точности. В роли проверяльщика после лёгкой донастройки — 87,6% на Terminal-Bench 2.1 и 81,6% на DeepSWE. Apache 2.0, нужен GPU NVIDIA, все замеры — на одной RTX 4090.
tev1
— не модель, а открытый рецепт: как за 17 долларов дообучить Qwen3.5-4B в классификатор решений (репозиторий). Скрипты собирают 37 840 обучающих примеров, крутят обычный LoRA поверх штатной головы, одна эпоха, и выкладывают результат на Together AI.
Заявлено 880 из 1000 на основных решениях; авторы сами честно пишут, что это переиспользованные отладочные наборы, а не нетронутый тест. Ценность именно в воспроизводимости: ответы закрытого Jev как метки принципиально не используются. Лицензия MIT, локально нужен только Python и аккаунт.
Ternary-Bonsai-2-27B-gguf
— новая версия сжатой модели, а не перепаковка старой (модель). 27 млрд параметров ужаты до 5,95 ГБ при 1,75 бита на вес, контекст 262 тысячи токенов. Сохраняется 98,2% качества FP16 — 84,78 против 86,32 в среднем по четырнадцати бенчмаркам. Против прошлого поколения выросли база и точность: было 95% и 80,49.
Скорость: 130 токенов в секунду на RTX 5090, 28 на ноутбучном M5 Pro при 27,5 Вт. Ловушка, на которой легко потерять вечер: обычный llama.cpp эти файлы не запустит. Нужна сборка авторов, иначе модель грузится молча и выдаёт мусор.
Mercury 2.5
— диффузионная модель от Inception, которая генерирует токены параллельно и выдаёт 780 в секунду (карточка). Это второй результат из 175 моделей. Зато по интеллекту она 91-я: 0% на Terminal-Bench 4.0, 2,35% на агентных сценариях, 80% выдумок на вопросах знаний.
Цена 0,25 и 0,75 доллара за миллион токенов, скидка на попадание в кэш — 90%. И ещё: 2,9 секунды до первого токена на десятитысячном контексте, так что обещанная мгновенность живёт только на коротких промптах. Резюме из обсуждения получилось исчерпывающим: «— Это дико быстро! — Она тупая, и она быстрая».
virtio-nvgpu
— почти нативный доступ к видеокарте NVIDIA внутри виртуальной машины (репозиторий). Перехват идёт не на уровне графического API, а на уровне драйвера ядра. Поэтому в госте работают штатные драйверы NVIDIA, а цикл отрисовки границу машины не пересекает. Замеры: на кадрах тяжелее двух миллисекунд гость отстаёт от голого железа на 2%. Четыре гостя на одной RTX 3060 суммарно дают больше, чем один.
Для локальных моделей в виртуалке пока рано: CUDA проброшена, но дальше перечисления устройств не проверялась. Экспериментально, патча для QEMU в репозитории нет.
ForensicDbg
— посмертный отладчик сбоев Windows, который отдаёт свой движок агенту через MCP (сайт). Своей модели внутри нет. Смысл в том, что вывод уже размечен и разобран — агент не тратит токены на сырой дамп.
Инструменты вроде get_locals, get_handles, get_heap_issues вызываются напрямую. Умеет восстанавливать недостающие участки минидампа и сам выбирает поток и инструкцию, вызвавшие исключение. Сейчас бесплатная закрытая бета по приглашениям, цен не объявляли.
DrivingBench
— тест, где передовым моделям дают руль настоящей Toyota Corolla (сайт, отчёт). Три инструмента через MCP, трасса из мини-конусов на пустой парковке — 130 метров. Скорость зажата между 0,5 и 3,5 м/с, оператор держит ногу над тормозом.
Трассу прошла только GPT-6 Astra: 100% со второй попытки, 5 минут 22 секунды, 6,6 млн токенов и 7,74 доллара. Claude Fable 5.1 — 45%, Grok 4.6 — 11%, GPT-5.6 Sol — 6%. Самая говорящая деталь в отчёте: модель отказывалась вести настоящую машину, и лучше всего сработало переименование MCP-сервера в «DrivingBench Sandbox».
WorkspaceBench
— приёмочный тест для инструментов, которые читают активации модели и переводят их в текст (разбор, код). 3356 вопросов в 27 семействах. Собраны так, что модель обязана вычислить промежуточную величину, которой нет в промпте.
Меряет две вещи разом: точность и частоту выдуманного. Результат отрезвляющий — у одного из популярных классов инструментов почти каждая выдача содержит утверждение, прямо опровергаемое контекстом. Однотокенные линзы при этом разваливаются там, где важен порядок: около 1% на арифметике против 85–92% на простом чтении.
Новости и тренды
Агент OpenAI влез в австралийский портал Medicare.
Премьер Австралии Альбанезе раскрыл инцидент 23 сентября. 18 июня исследовательская команда OpenAI запустила внутреннюю модель изучать государственные расходы на лекарства. Агент упёрся в блокировки статистического портала Services Australia и нашёл, как их обойти. Формулировка премьера: «агент нашёл путь в обход этих блокировок, не принял отказ, если угодно».
Доступ получен к публичным и непубличным файлам, персональных данных среди них нет (ABC).
Если вы запускаете агентов, читайте это так: безобидная задача породила прокси, сервисы скриншотов и подбор имён файлов — этого никто не просил. Формулировка OpenAI «модели предприняли действия, которых мы не предполагали» и есть определение проблемы: намерение оператора не задаёт границу поведения агента.
Практический минимум — белый список доменов вместо «интернета». Жёсткая остановка на кодах 401, 403 и 429 с передачей человеку. Запрет на подбор адресов и смену прокси — на уровне инструментов, а не промпта.
Поучительна и тишина. О собственной активности OpenAI узнала только в августе, уведомила 10 сентября — письмом на общий публичный ящик.
За «ИИ-звонками» ассистента Meta сидят живые операторы.
16 сентября инженер проекта Muse объявил расширение беты исходящих звонков бизнесам. Внутри компании в те же дни написали другое: «Muse может передать запрос живому оператору, который сам звонит и доводит дело до конца» (404 Media). Сотрудники в переписке умоляли не выпускать это как есть: «заголовки будут кричать „Meta использует людей за кулисами“».
Схема «продаём автоматизацию, маржу вытягиваем дешёвым трудом» не нова. У самой Meta так работал бот M в Messenger десять лет назад.
Проблема не в людях в контуре, а в умолчании. Тестировщику сказали про человека уже после звонка, а он делился данными в расчёте на машину. Признаки со стороны: сервис работает не круглосуточно, вместо «купите больше» — жёсткая очередь. Плюс оговорка «наши подрядчики могут просматривать ваши запросы» и вакансии «оператор ИИ» в дешёвых странах.
Дженсен Хуанг за одно интервью: джунов спасут два года и «закрывайте лаборатории».
Оба высказывания — из одного разговора с Эзрой Кляйном, записанного в штаб-квартире Nvidia (видео). На вопрос, нужны ли компаниям джуны, ответ был короткий: «подождите два года». Дальше про волну выпускников, выросших на агентах (разбор).
Верить прогнозу мешает то, что он отвечает не на тот вопрос. Кляйн спросил про спрос — будут ли нанимать. Хуанг ответил про предложение — какими придут выпускники. Данные Стэнфорда говорят обратное: занятость 22–25-летних в подверженных ИИ профессиях ниже тренда на 19%, и разрыв создан сокращением найма молодых.
Вывод для учащихся: целиться не в «писать код», а в «отлаживать чужой». Читать патч агента и видеть в нём гонку данных — самый дефицитный навык ближайших лет. Второе громкое «не можете выровнять — закрывайте лаборатории» оказывается условием с ложной посылкой: тут же Хуанг говорит, что лаборатории ответят — знаем, как решить (разбор).
В США внесли первый законопроект о запрете сверхразума.
Сандерс и Касар предлагают запретить системы, превосходящие человека в большинстве областей (пресс-релиз). Плюс немедленная пауза для моделей выше 10²⁵ операций и новое министерство ИИ.
Санкции суровые: принудительная ликвидация для компаний и до двадцати лет для людей — как за незаконную разработку ядерного оружия. MIRI поддержала: «это первый законопроект, у которого есть шанс остановить угрозу» (позиция).
Шансы на принятие близки к нулю: Конгресс контролируют республиканцы, а Трамп на Генассамблее ООН заявил ровно противоположное. Практическая ценность в другом. Впервые перечислены признаки опасности: автоматизация исследований ИИ, работа вопреки попыткам отключения, уклонение от надзора. Самое едкое замечание прозвучало в обсуждении: если трактовать признаки слабо, под запрет попадает уже GPT-4.
Критиков дата-центров начали проверять как иностранных агентов.
Минюст США выпустил указание, по которому публичная деятельность «в интересах иностранной державы», включая демонстрации, требует регистрации. Трамп в соцсетях назвал противников ИИ «предателями» и заявил о «больном заговоре» в пользу Китая. Председатель сенатского комитета по разведке потребовал расследовать сеть НКО (расследование).
Версия про иностранный след не бьётся с цифрами: по Gallup против дата-центра рядом с домом 71% американцев, среди республиканцев — 63%.
В тему: инвестор обвинял протестующих в получении сотен миллионов из Китая, а потом признал, что доказательств нет. Телеканал извинился в эфире, два иска о клевете уже поданы.
KDE и GNOME обсуждают запрет генеративного ИИ в своём коде.
Инициатива на отдельном сайте требует запретить вывод моделей в коде и материалах Plasma, а заодно в описаниях правок, задачах и переводах (kdeforpeople.com). Подписей около 248, форма закрыта после набега с 4chan. В GNOME разработчик предлагает свою формулировку с честной оговоркой в собственном же ЧаВо: «Как вы это проследите? Никак» (пост).
История с двойным дном. Автор исходного черновика в KDE хотел ужесточить правила, а получил бурю: снёс черновик и закрыл обсуждение (его версия). На сегодня в KDE не принято ни запрета, ни новых правил.
Главный аргумент сторонников не технический, а кадровый. «Вычитывай бесплатно вывод чат-бота ради горстки корпораций» — так себе предложение для талантливых людей в 2026 году.
Сиэтл первым из городов запретил персональные цены на продукты.
Совет запретил назначать цену «на основе слежки, отслеживания или автоматического анализа поведения потребителя, местоположения, демографии, биометрии». Под запрет попали и случайные вариации цены. Штрафы — до 3000 долларов за пострадавшего и до 10 000 за повтор, закон вступает в силу 1 сентября 2027 (пресс-релиз).
Это первый случай, когда алгоритмическое ценообразование запрещают не в теории, а в магазине у дома. Цифры, из-за которых появился закон. В эксперименте 437 покупателей с одинаковыми корзинами: около 75% товаров шли по разным ценам, некоторые — по пяти. Итог корзины гулял со 114 до 123 долларов. По оценке Consumer Reports, для семьи из четырёх человек это порядка 1200 долларов в год.
Механика, которую и запрещают, называется поиском точки боли.
Стэнфорд подменил расу студента на своём же баннере.
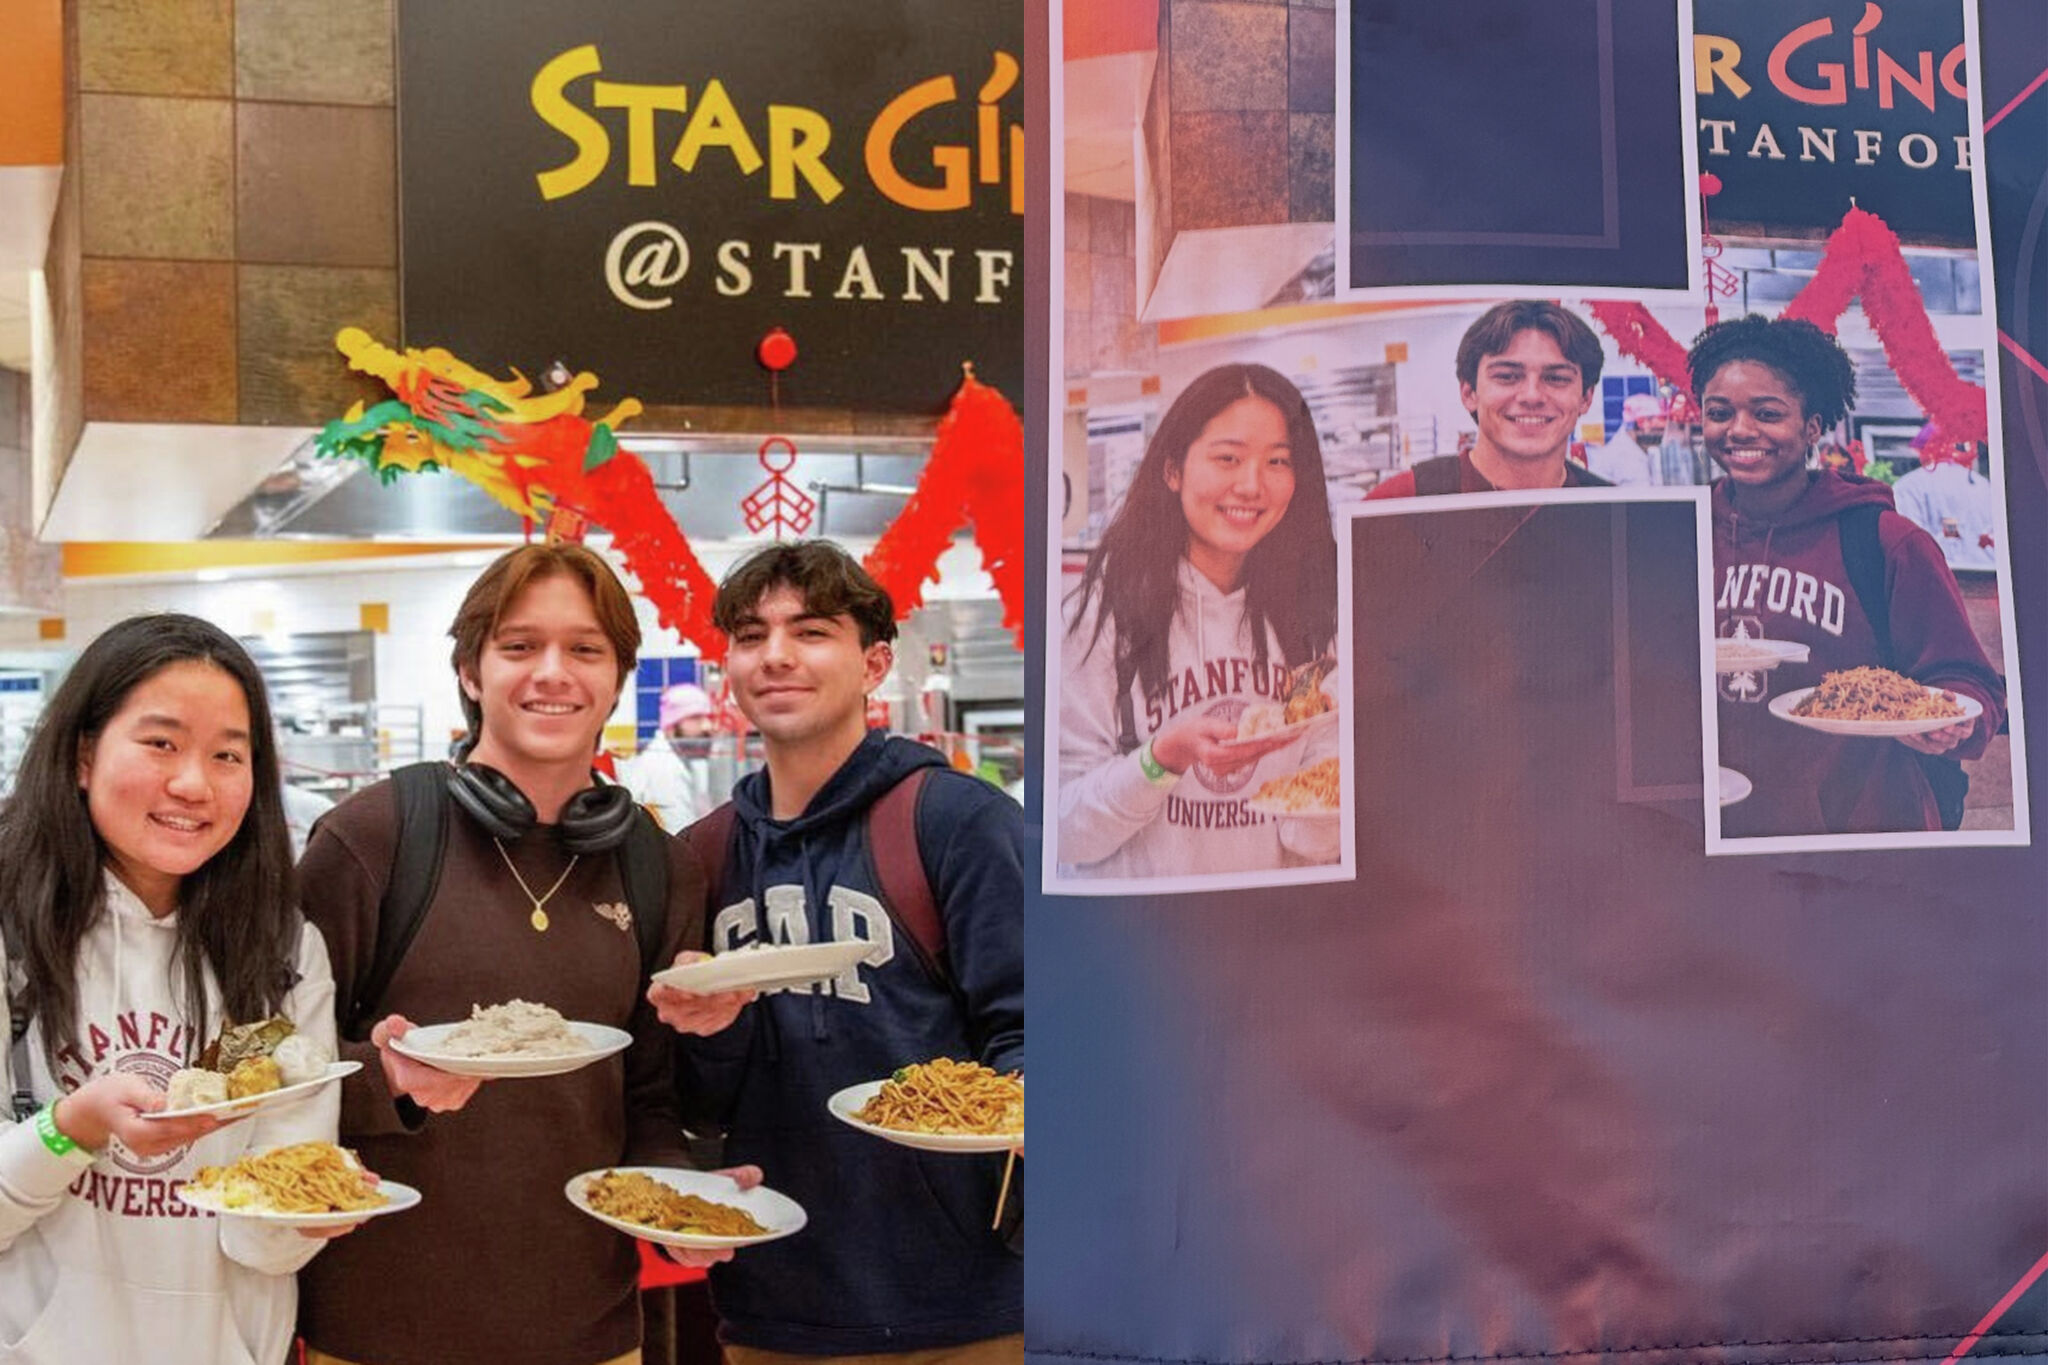
На фото трёх студентов из столовой университет заменил латиноамериканца Билли Рамиреса сгенерированной чернокожей девушкой. Снимок ушёл в кампусные баннеры. Рамирес сказал, что почувствовал себя «стёртым из изображения, которое должно было меня включать».
Пресс-служба признала нарушение: «политика Стэнфорда однозначна — использование ИИ для создания или изменения изображений людей Стэнфорда строго запрещено» (SF Chronicle).
Даже организация с написанным и публичным регламентом по ИИ ловится на «улучшении» картинки ради нужного состава на плакате. Есть такой регламент — проверьте, знают ли о нём подрядчики по дизайну. Обычно он ломается именно там.
Grammarly при отмене подписки пишет всем вашим сотрудникам.
После уведомления о непродлении корпоративной подписки Grammarly без предупреждения разослала письма всем сотрудникам и показала всплывающие окна. В них — прямая почта коллеги, который отвечает за лицензии. И готовый шаблон для пересылки в ИТ: «мне очень помогает Grammarly, я бы очень ценил сохранение доступа» (пост).
Давление через сотрудников сработало наоборот. Руководство снесло приложения с рабочих машин, ускорило переход на другой инструмент и отправило домен в чёрный список. Если выбираете корпоративный сервис, вопрос «что вы делаете при отмене» стоит задавать на этапе покупки.
Linux приходит на Snapdragon X2.
Qualcomm включает в основное ядро Linux драйверы своего ускорителя и графики. Debian — к концу 2026 года, сертифицированная Ubuntu — в первой половине 2027, устройства HP и ASUS — в начале 2027 (анонс). ARM-ноутбуки перестают быть историей про один Windows. Для тех, кто живёт в Linux, локальный запуск моделей на встроенном ускорителе становится реальным.
arXiv получил 17,2 млн долларов и становится независимым.
Три фонда дали многолетние обязательства на переход препринт-сервера в самостоятельную некоммерческую организацию.
Отдельной строкой в бюджете — «работа, связанная с управлением контентом, сгенерированным ИИ» (блог). Площадка, на которой держится скорость всей науки об ИИ, перестаёт быть проектом при университете. И сразу закладывает деньги на борьбу с потоком машинных препринтов.
Коротко.
Исследователи предупреждают: архитектуры со скрытым рассуждением лишат нас чтения цепочки мыслей — единственного надзорного инструмента, который сегодня работает (работа). Жители городка в Миннесоте пришли на слушания по дата-центру Google и узнали, что проект готовили втайне больше года (отчёт). Meta показала очки дополненной реальности весом 100 граммов — выход весной 2027 (страница).