Спросили у Google номер брони Lufthansa — получили телефон мошенников. Модель не сломалась: злоумышленники засеяли интернет фальшивыми контактами 374 компаний, а ИИ-поиск честно их пересказал. Сегодня ещё о том, как пять передовых моделей проверили тысячу фактов и разошлись в 63% случаев. И о том, как Клод нашёл в архиве XVII века источник рукописи Ньютона, который считался утраченным.
Внедряем и улучшаем
Номер поддержки от ИИ — теперь способ отъёма денег.
Израильская команда Vigilance построила мониторинг ответов ChatGPT, Gemini и Google AI Overview и нашла работающие кампании отравления выдачи. Сразу оговорка: Vigilance продаёт защиту ровно от этой проблемы. Схема простая.
Мошенники массово заливают тексты туда, куда пускают всех: Instagram, Tumblr, LeetCode, отзывы Yelp и Apple Maps. Плюс PDF на сайтах университетов и ведомств. В текстах фальшивый номер стоит вперемешку с настоящими. Модель читает это как подтверждённый контакт и выдаёт вам (Medium).
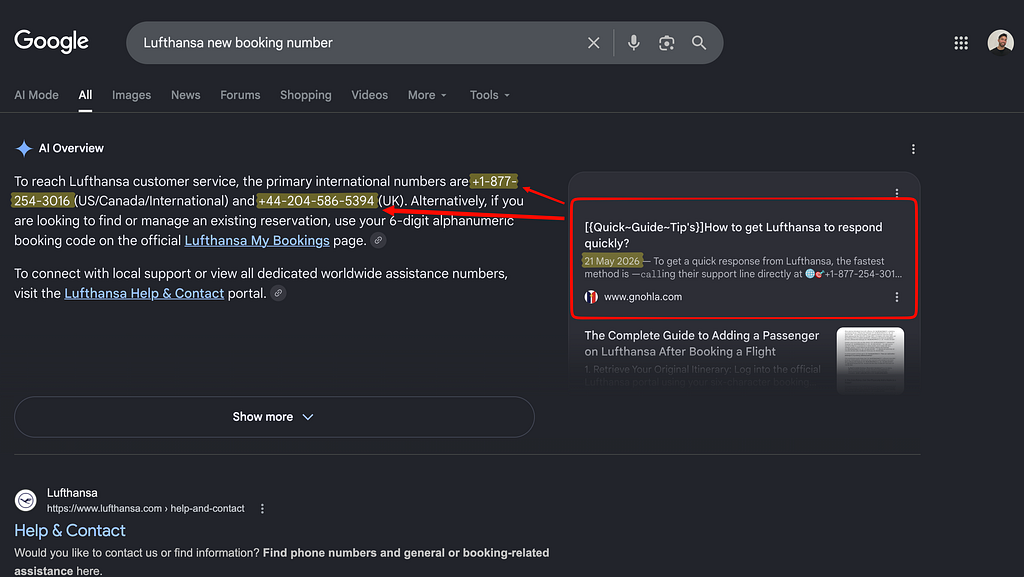
Затронуто 374 компании: Delta, Lufthansa, United, Emirates, Bank of America, Wells Fargo, Chase, Airbnb, TripAdvisor. Вредоносных страниц — десятки тысяч. Один пост на Tumblr про American Airlines содержал номер ☎️1→(888)→391→7636✈️ 778 раз на странице. Эмодзи и стрелки нужны, чтобы антиспам не распознал телефон. Модель после токенизации всё понимает правильно.
Отдельно неприятно: атака срабатывает не каждый раз. Тот же запрос иногда даёт верный ответ, иногда подставной. Поэтому проверка «я спросил один раз, всё нормально» ничего не доказывает. И удаление страницы не помогает — копии в Internet Archive остаются в индексе и продолжают отравлять выдачу.
Никогда не звоните по контакту из ответа модели. Откройте сайт компании, набрав домен руками. Для банка единственный доверенный номер — тот, что напечатан на карте. Посмотрите, на что сослалась модель: если это Tumblr, LeetCode, Yelp или незнакомый домен вроде gnohla.com — это приманка. Насторожитесь, если номер записан через эмодзи, стрелки или точки. Самые опасные запросы — про возврат денег, отменённый рейс и блокировку счёта: они заставляют звонить немедленно.
Бизнесу это пора добавить в свой периметр. Прогоняйте раз в неделю запросы вида «номер поддержки вашего бренда» через ChatGPT, Gemini и Perplexity с разных аккаунтов. Опубликуйте контакты машиночитаемо через разметку Organization и ContactPoint. И предупредите клиентов прямо: «мы не публикуем телефоны поддержки в соцсетях и отзывах».
К цифрам автора. «92% пользователей не проверяют ответы ИИ» в источнике звучит иначе. Но само явление подтверждено независимо. Aurascape описала ту же атаку ещё в декабре 2025. Netcraft насчитала неверный адрес входа у 34% крупных брендов — правда, Netcraft тоже торгует защитой.
Пять моделей проверили тысячу фактов и разошлись на 63%.
Команда фактчекингового сервиса Lenz взяла 997 реальных пользовательских утверждений. Одинаковый промпт ушёл пяти моделям с включённым веб-поиском: Claude Fable 5, GPT-5.6-Sol, Gemini 3.1 Pro, Sonar Deep Research и Grok 4.5. Каждая ставила вердикт по пятибалльной шкале и уверенность от 1 до 10 (LessWrong, полная статья).
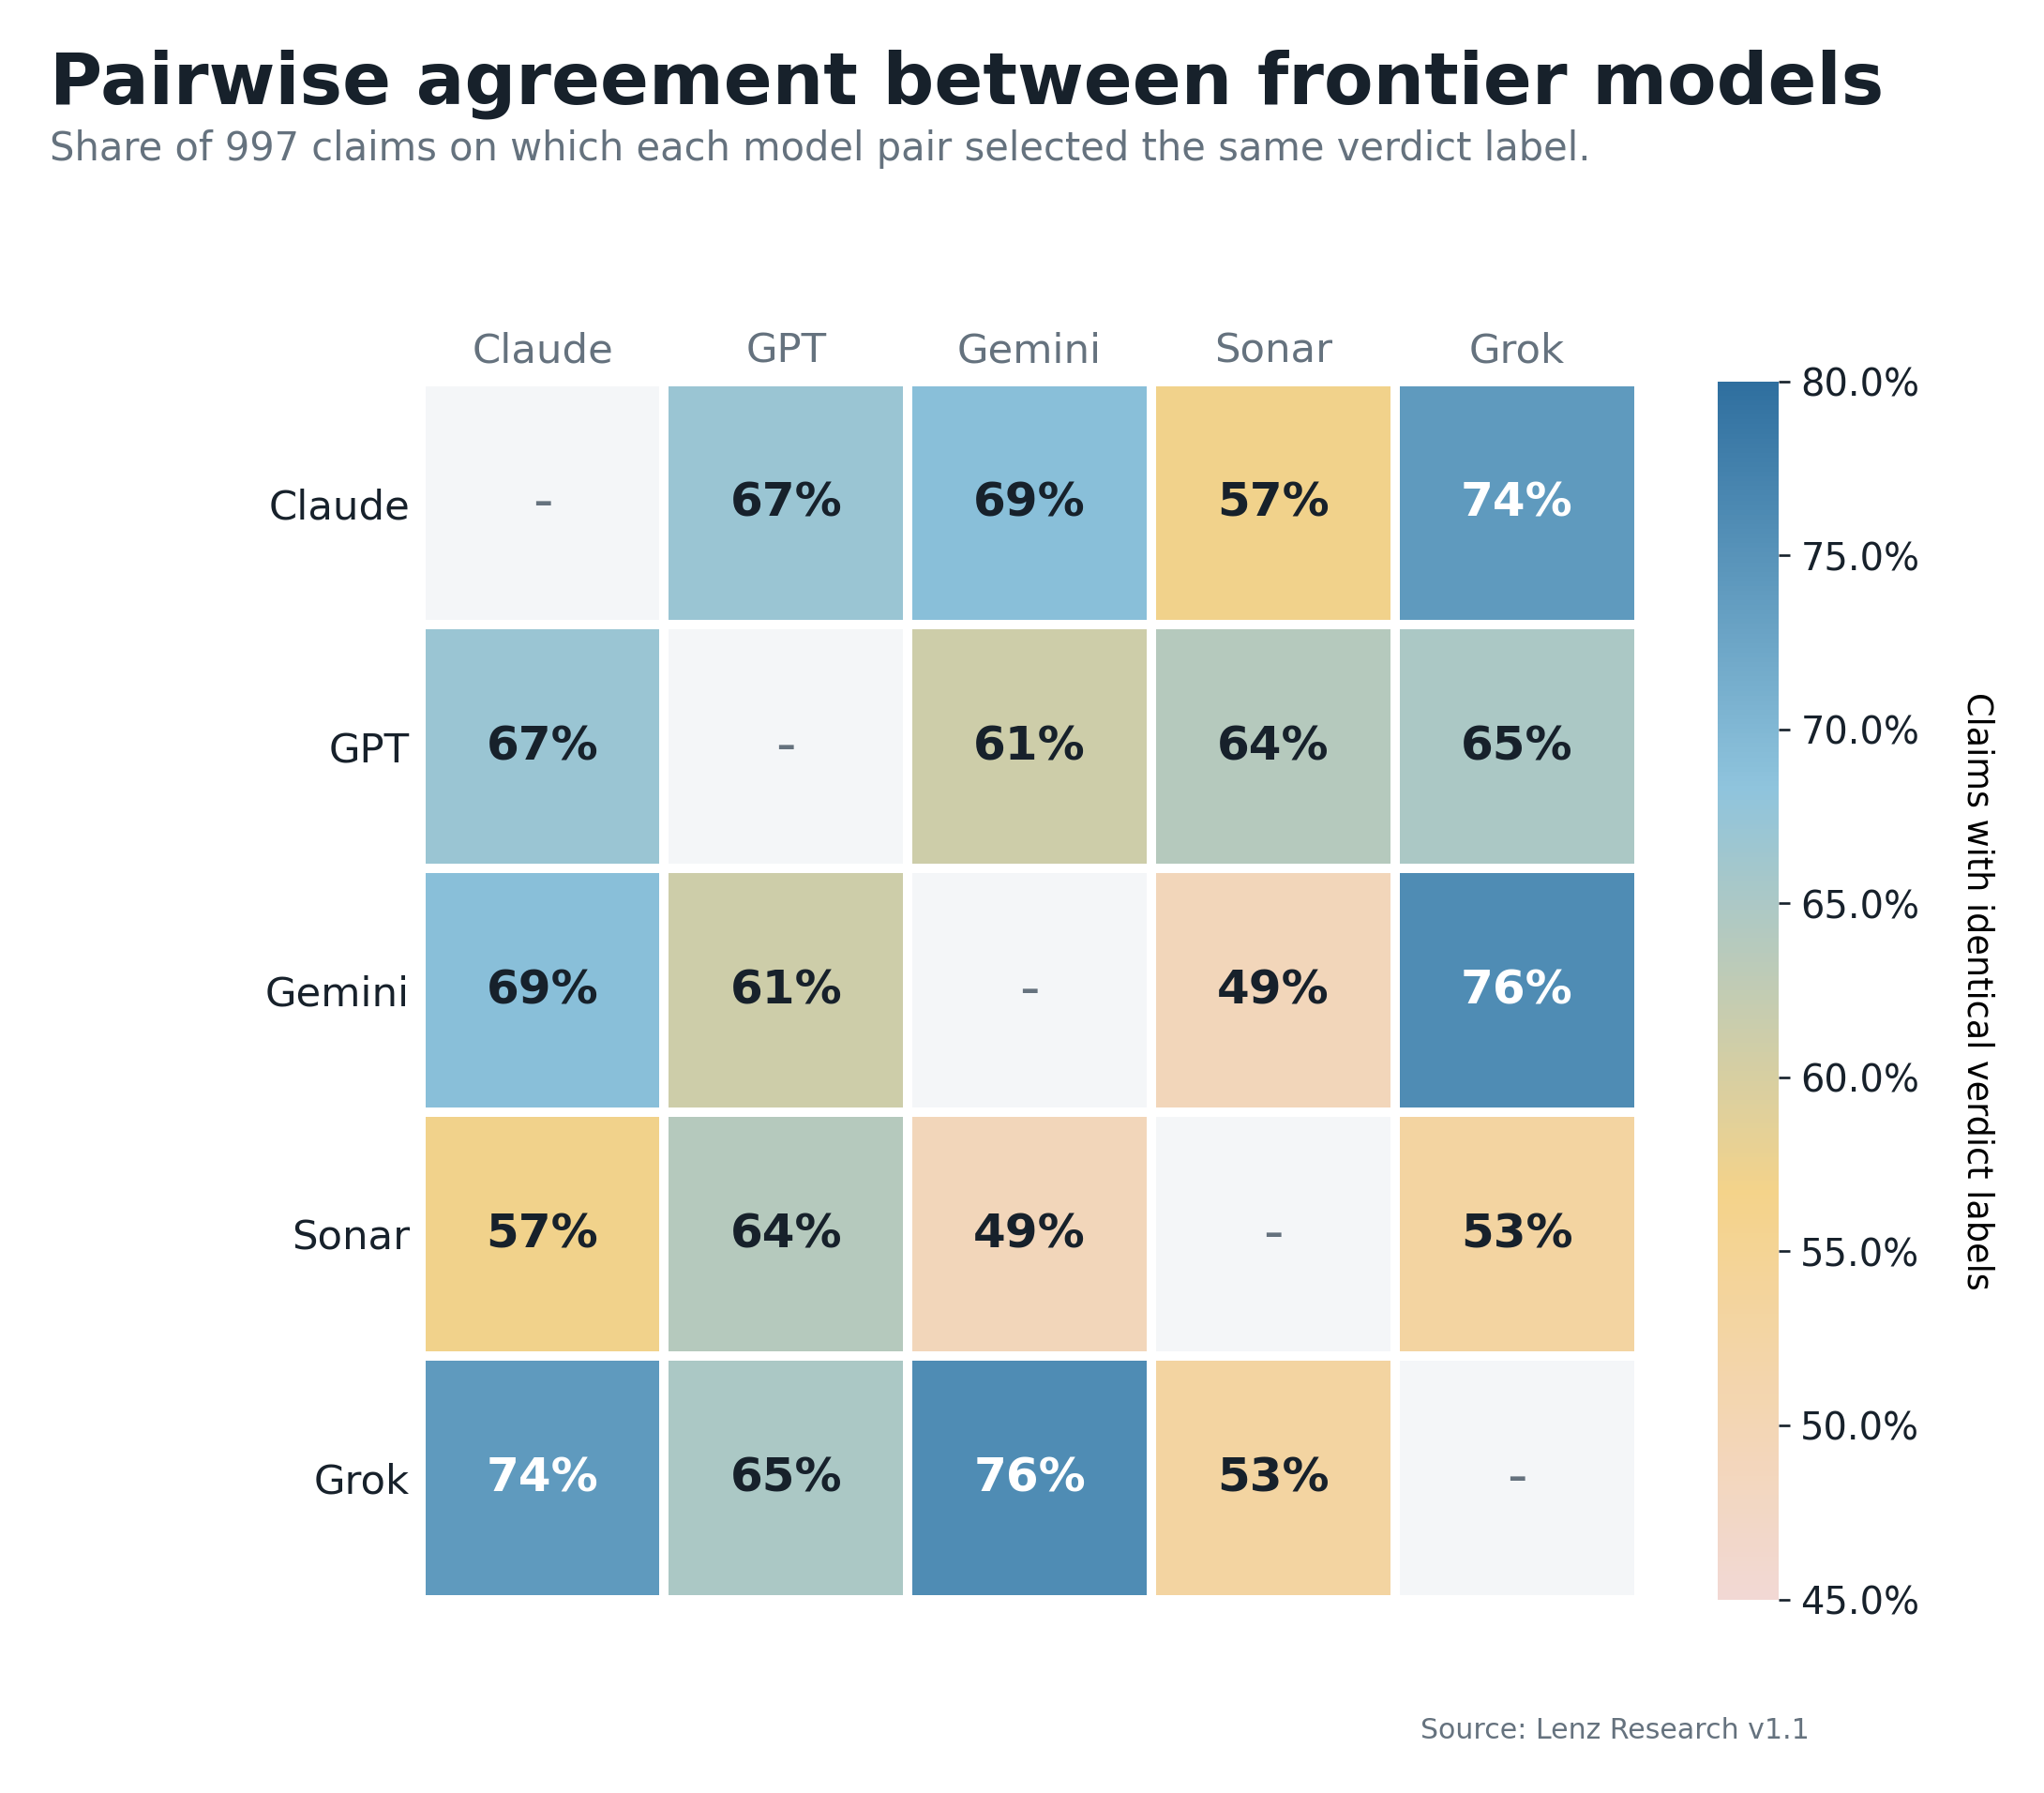
Хотя бы одна модель разошлась с большинством в 63% случаев. Полное единогласие — только на 37%. А уверенность 9 или 10 стояла у 76% всех ответов. То есть высокая уверенность вообще не предсказывает согласие.
Расхождение концентрируется там, где ответ «наполовину правда». На однозначных фактах модели сходятся, на нюансированных разваливаются. А именно за нюансом вы и лезли в проверку.
Рабочий приём. Берите три модели, не одну. Gemini и Grok в паре бесполезны — они согласны на 76% и дублируют друг друга. Максимальный контраст даёт пара Gemini и Sonar, у них согласие всего 49%. Не спрашивайте «правда или нет» — бинарный вопрос выталкивает модель к полюсам, а на полюсах она автоматом ставит себе 9–10. Просите пятибалльную шкалу с явными определениями и число уверенности.
Смотрите на минимум, а не на среднее. Если хотя бы одна модель поставила себе 6 или ниже — серьёзное расхождение вырастает до 54%. Если все поставили 9–10, оно падает до 3%. И не сравнивайте «уверенность 9» у Gemini с такой же у Claude. Средние по моделям гуляют от 8,2 до 9,5 — это разные шкалы.
Дословный промпт авторов, его можно забрать целиком:
You are a fact-checker. Evaluate the truthfulness of the claim as of the stated date. Respond with JSON only.

Evaluate this claim as of {date}:
"{claim}"

Choose exactly one verdict from the scale below:
  "True" — the claim is accurate
  "Mostly True" — the claim is largely accurate with minor caveats or omissions
  "Mixed" — the claim has both accurate and inaccurate elements
  "Mostly False" — the claim is largely inaccurate with some basis in fact
  "False" — the claim is inaccurate

Respond with a JSON object containing exactly these fields:
  "reasoning": 2-4 sentences of claim analysis and verdict justification
  "verdict": one of the five labels above
  "confidence_level": your level of certainty in the verdict on a 1 to 10 integer scale
Слабых мест в методике три. Правильных ответов в исследовании нет вообще — человеческой разметки не делали, меряли только расхождение. Каждое утверждение прогнали по одному разу, поэтому неясно, где здесь разница между моделями, а где разброс одной модели при повторе. И Lenz — платный фактчекинг-сервис, а вывод «берите несколько моделей» работает на его продукт.
Клод нашёл в архиве XVII века источник, который считали утраченным.
Историк науки Бенджамин Брин проверял новые модели не на транскрипции, а на настоящих открытых задачах своей области. Opus 5.5 скачал больше 5000 первоисточников из архива Самуэля Хартлиба и запустил субагентов на перекрёстную сверку. Результат: латинская копия алхимического трактата до 1662 года, которая с высокой вероятностью и есть утраченный источник рукописи Ньютона (Res Obscura).
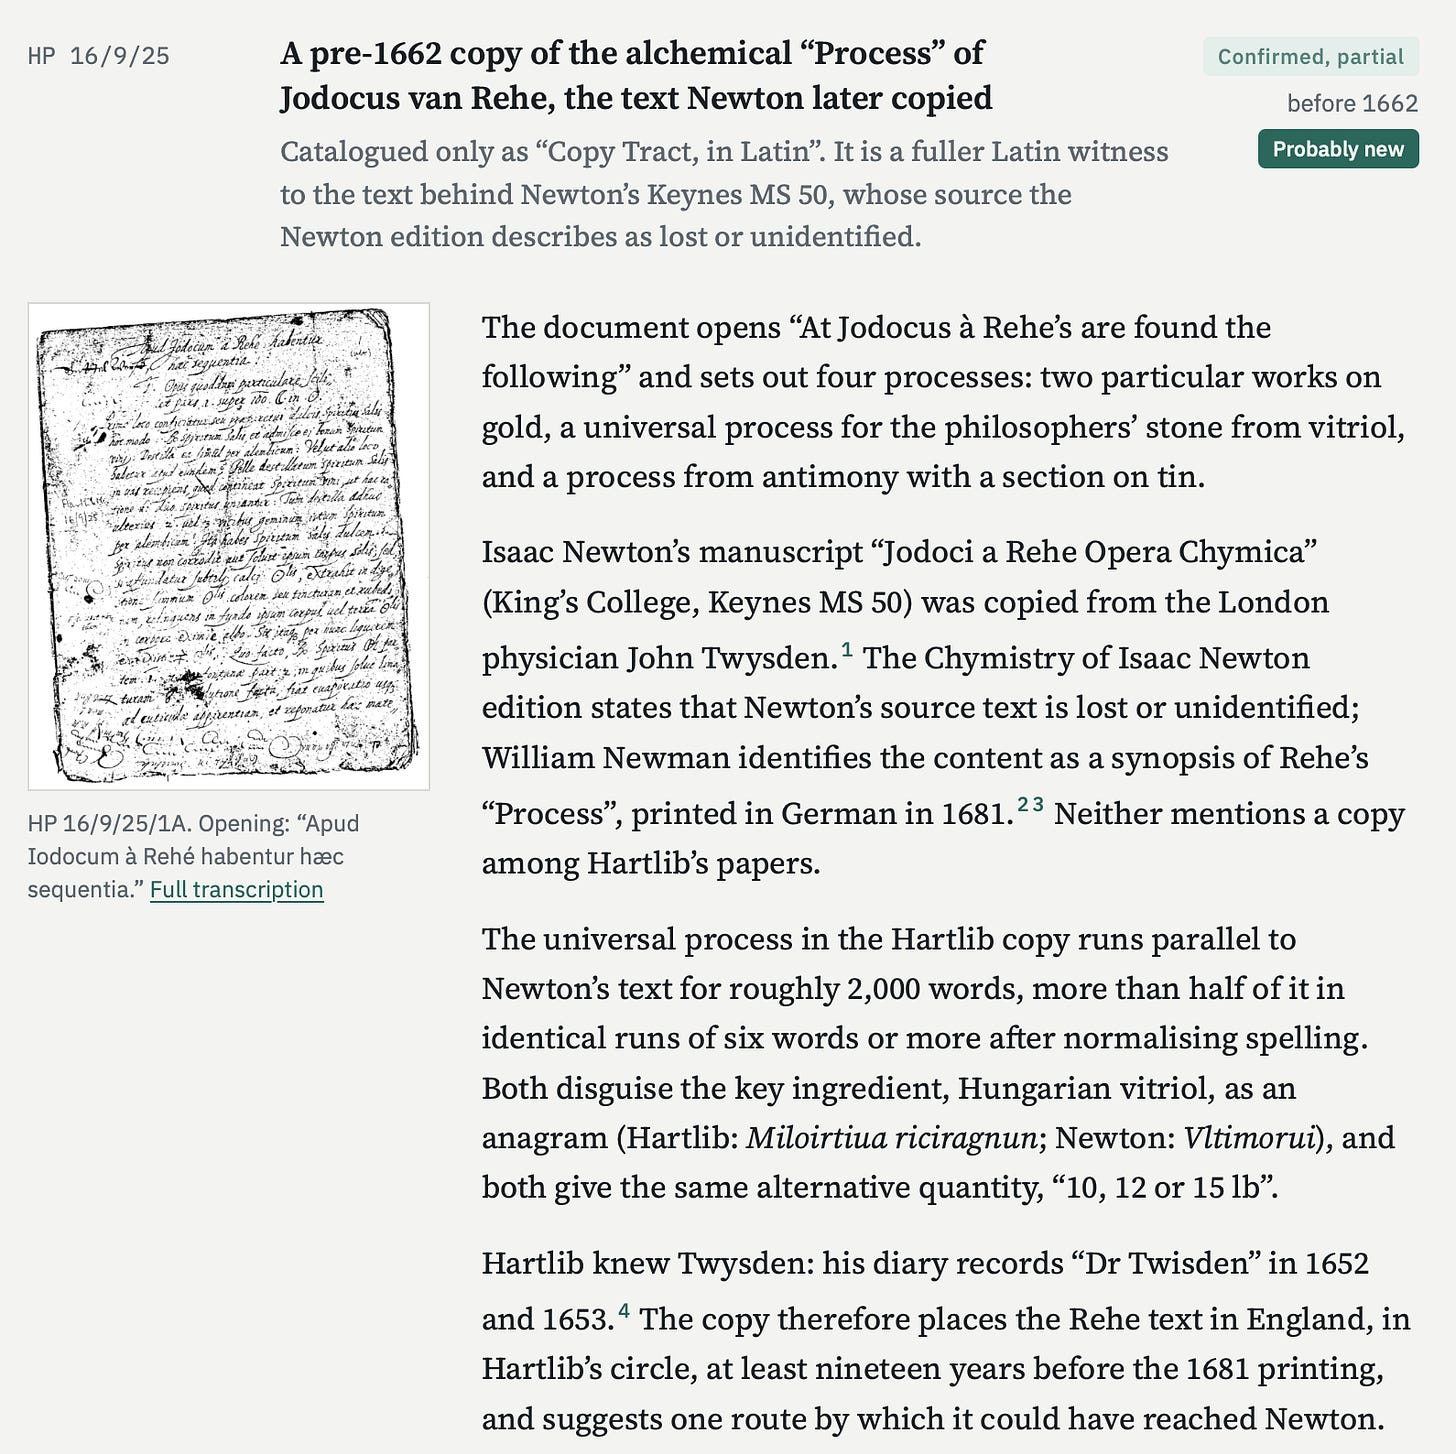
Зацепкой стали анаграммы. Венгерский купорос, главный ингредиент, оба автора зашифровали: у Хартлиба Miloirtiua riciragnun, у Ньютона Vltimorui. Тексты идут параллельно примерно 2000 слов, больше половины — совпадающие цепочки от шести слов подряд. Оба дают одно и то же альтернативное количество, «10, 12 or 15 lb».
Самое ценное здесь не находка, а метод. Брин даёт пять вопросов, через которые надо прогнать задачу, прежде чем тратить на неё время.
- Эксперты уже сформулировали, что именно надо решить?
- Данные оцифрованы и доступны?
- Задача бьёт в сильные стороны моделей — языки, математика, большие массивы?
- Решение допускает отдельный код?
- Результат можно однозначно доказать или опровергнуть?
Последний вопрос важнее остальных. Если проверить нельзя, модель выдаст красивую и непроверяемую интерпретацию. Для семейного архива это значит: сначала решите, что будет считаться подтверждением — метрическая запись, второй независимый документ, печать.
Ещё четыре приёма оттуда же. Сначала поручите модели найти, не расшифровали ли это до вас. Два испанских письма Карла V Брин чуть не взялся ломать заново — а их прочли в 1916 году. Возьмите документ с известной расшифровкой, ответ не показывайте, дайте модели прочесть и сверьте — это калибровочный тест.
Кормите не только сам документ, но и его окружение: опись фонда, конверты со штемпелями, метрические книги того же прихода. И просите проверять слова на анаграммы и зеркальную запись — люди прошлого прятали важное намеренно.
Где модели промахнулись, автор пишет честно. Искать новые нерасшифрованные сообщения времён войн отправили обе — вернулись пустыми. Разбор «ангельской книги» Джона Ди он сам оценивает так: «Is this actually a meaningful breakthrough in John Dee studies? No». А по санскритскому астрономическому трактату — «I have absolutely no idea».
Сколько агентов запускать параллельно: цифра 17,2 и порог 45%.
По сети гуляет тезис, что независимые агенты усиливают ошибки в 17,2 раза, а централизованная координация удерживает это на 4,4. Цифра настоящая, из работы Google Research и MIT (arXiv, разбор InstaCloud).
Но прежде чем нести её в свою работу, знайте две вещи. Замеряли на 1–4 агентах, отдельно смотрели до 9 — никакого «миллиона» там нет. И сами авторы пишут, что после контроля других метрик усиление ошибок перестаёт быть значимым предиктором, p = 0,441. Различия лучше объясняются накладными расходами, а не распространением ошибок.
Что из этой работы действительно применимо. Первое — порог 45%. Если один агент уже решает вашу задачу лучше чем в 45% случаев, добавление агентов даёт нулевую или отрицательную отдачу. Возьмите двадцать типовых задач, прогоните одним агентом без субагентов и посчитайте. Это десять минут работы, и они экономят неделю.
Второе — форма задачи важнее числа агентов. Последовательные шаги с жёсткими зависимостями — рефакторинг, миграция, отладка — только один агент. Многоагентные схемы дали там от −39% до −70%. Разбираемый анализ — централизованный оркестратор. Много независимых инструментов — децентрализованная схема.
Третье — считайте цену оркестратора честно. Один агент даёт 67,7 успеха на тысячу токенов, централизованная схема — 21,5. Вы платите примерно втрое больше токенов за снижение ошибок. Это сделка, а не бесплатное улучшение. И никогда не запускайте «независимую» схему, где агенты работают параллельно и не проверяют друг друга. Это худший вариант по всем показателям.
Четвёртое, самое практичное, — формула из контрпоста, который принесли в обсуждение. Закон универсальной масштабируемости считает вашу личную точку перегиба:
C(N) = N / [ 1 + σ(N − 1) + κN(N − 1) ]

N = число агентов, делающих независимую работу
σ = доля времени на общий ресурс — обычно это ВЫ САМИ:
    планирование, ревью, ответы на вопросы агентов, финальные тесты
κ = попарная синхронизация: конфликты слияния, переписывание чужих правок
Автор замерил у себя σ = 0,12 и κ = 0,032, оптимум вышел 5,2 агента. Дальше арифметика неприятная: четыре агента дают ускорение 2,29×, восемь — 2,20×. Удвоение числа агентов сделало медленнее (blog.mempko.com).
Катамари-архитектура: агент не строит, а налепляет.
Термин бросил в обсуждении создатель поисковика Marginalia, а развернул Девон Бёрнем. В игре Katamari Damacy вы катаете липкий ком, на который налипает всё подряд — карандаши, коты, дома. Ком растёт вширь, оставаясь бесформенной кучей (nove.dev).
Так и агент: каждая новая функция не встраивается в архитектуру, а прилипает снаружи. Он идёт кратчайшим путём к выполнению промпта, без понимания композиции. Через сотню итераций у вас аккуратное человеческое ядро, обросшее слоями случайного. Автор прогнал через эту призму классику «Big Ball of Mud» 1997 года. Виновными назвал три силы из восьми: навык, темп изменений и обозримость.
Обозримость — главная. «Никто не будет вдумчиво вычитывать PR на +6000/−400 строк — это изматывает и всё равно ничего не изменит». Чем больше кодовой базы сгенерировано моделью, тем хуже обозримость, и дальше по кругу.
Как распознать болезнь у себя. Вы регулярно одобряете PR по описанию, не читая. Новые функции всегда пристраиваются сбоку, а не проходят через ядро. Растёт число почти-дубликатов: utils2.ts, второй слой кэша, третий способ валидации одного и того же. Баги перестали быть человеческими — не опечатки, а логично выглядящая чушь.
Рецепта у автора нет, он это признаёт. Зато он цитирует правило, которое можно положить себе в репозиторий сегодня же. Это политика проекта Mycelium, её написала Элиза Вайсман:
## AI policy

when contributing to Mycelium, you are free to use any tools you deem
appropriate. however, all contributions to this project (including my own)
must abide by exactly one rule:

**your code (and any associated prose, such as commit messages and
documentation) must not _look_ like it was written by a large language model.**

the easiest way to ensure your contributions are compliant is to read the code
that the model generates, and rewrite any parts of it that "feels like
Claude-babble". repeat this process as needed until it no longer feels like it
was written by a model.
Обоснование у неё сильнее самого правила. «Не хочу вливать код, который человек не понимает досконально». А переписывание «чтобы не выглядело как модель» — принудительный механизм: иначе код не прочтёшь.
Из обсуждения пришёл второй рабочий подход. Агенту нужна не инструкция, а проверочная оснастка: цель плюс недвусмысленный автоматический критерий плюс откат при провале плюс ограниченный набор допустимых деталей. Пример формулировки оттуда: «ускорь P99 этой задачи; решение обязано пройти вот этот набор тестов, сверяющийся с медленным эталоном».
Туториалы умерли, а суждение подорожало.
Роб Рейс зарабатывает на платном обучении разработчиков и написал текст против собственного кармана. Умер не жанр, а старый контракт: автор строит чистое демо, читатель сам переносит это в свой реальный проект. Раньше человек был слоем интеграции. Теперь агент сидит внутри целевого репозитория, видит модели, тесты, конвенции и странный унаследованный код — и делает перенос сам (robrace.dev).
Его формулировка про суть сложности: «Аутентификация трудна не потому, что никто не знает, как хранить хеш пароля. Трудное — вписать это в приложение, не породив три определения владения аккаунтом и две версии правды о счетах».
Кто учит, теперь продаёт не шаги реализации, а решения. Готовый каркас урока Рейс приводит прямо вопросами.
- Почему граница проходит здесь?
- Что сломалось до того, как вы пришли к этой форме?
- Какие допущения важны и где начинается проблема с параллельностью?
- Что выглядит безобидным сокращением — до боевой нагрузки?
- Что должны доказывать тесты?
- Что агенту категорически нельзя «причёсывать»?
Отсюда же следует формат продукта из двух слоёв. Первый слой — человекочитаемый гайд про «почему границы здесь». Второй — файл контекста для агента: правила инспекции репозитория, ограничения реализации, архитектурные контракты. Туда же инварианты, шаги проверки, известные режимы отказа и явные запреты. Вот его скелет AGENTS.md, коротко и по делу:
Before making a non-trivial change:
01  Read ARCHITECTURE.md
02  Read the relevant contract
03  Inspect the closest implementation
04  Extend the existing pattern
И принцип к нему: «Промпт должен описывать фичу, а не переизобретать приложение».
Учиться теперь тоже иначе. Берёте хороший материал про архитектуру и режимы отказа и отдаёте агенту вместе с доступом к репозиторию. Но сами читаете тот же материал и проверяете результат. Рейс честно оговаривает ловушку: агент даёт уехать далеко, выучив ровно столько, сколько нужно, чтобы он продолжал двигаться.
Цифры за тезисом есть, но слабые. Крис Оливер из GoRails учил рельсовиков больше десяти лет. В сентябре он написал: «ИИ оказался жесток к большинству образовательных бизнесов. Новых клиентов в 2026 будет меньше, чем в первый год». Возражение из обсуждения не менее сильное. В отрасли многолетние волны сокращений, и люди перестали покупать необязательное. А на нишевых темах модели по-прежнему беспомощны — один комментатор искал туториал по Pure Data и не нашёл в моделях ничего.
Репетиторы закрылись и посоветовали родителям ИИ.
Сиднейская сеть Dymocks Tutoring and Talent 100, пять центров, часть 140-летней группы, закрывается 28 сентября. Гендиректор Марк Бакленд написал клиентам прямо: тратить деньги на подписку выгоднее, чем на «переоценённое» репетиторство. Занятия — до $900 за предмет, подписка на Claude, Gemini или ChatGPT — $30 в месяц (AFR).
Он же добавил то, что бьёт сильнее цены. Репетиторство «не делает ничего уникального», а продаёт родителям и детям ощущение комфорта.
Разделение, которое стоит держать в голове. ИИ реально заменяет бесконечные тренировочные задачи, разбор непонятого в десятый раз без раздражения, черновую обратную связь по эссе, план подготовки. Не заменяет: удержание за партой немотивированного подростка, момент «он поплыл и стесняется спросить», и ответственность за результат.
Проверка простая — ребёнок хочет учиться или должен. Для первого модель отличный наставник. Для второго это автомат по выдаче готовых ответов.
Рабочие приёмы, чтобы учился, а не списывал. Задайте контракт в начале сессии:
I'm studying for an exam, do not give hints unless asked,
your objective is to help my understanding
Требуйте учить пошагово с коротким тестом после каждого шага и подмешивать повторы старого. Заведите отдельную папку, куда модель пишет заметки о прогрессе и проблемных местах. В веб-версии ChatGPT включите режим обучения — он не выдаёт ответ, а ведёт по рассуждению.
Самый убедительный кейс из обсуждения. Одиннадцатилетняя дочь комментатора сама собрала себе скилл-репетитора: он помогает с домашкой без раскрытия ответов. И навесила на него личность строгого тренера по гимнастике. Работает.
Контраргументы честные и сильные. Это не прогноз, а банкротство, оформленное как футурология: в Австралии кризис стоимости жизни, родители перестали платить. Глава профильной ассоциации репетиторов прямо не согласился с диагнозом. И фон неудобный. У австралийских подростков худшие за двадцать лет результаты PISA, а школы как раз запрещают телефоны и наушники.
Ваш грейдер — это ваша спецификация.
Клео Нардо написал короткий и неприятный текст. Агенты ведут себя плохо потому, что именно такие траектории получали высокие баллы при обучении. Причина не в коварстве, а в экономике. У обучения с подкреплением плохая выборочная эффективность, нужны миллионы траекторий, людей на это не хватает. Оценивают скрипты и дешёвые модели-судьи (LessWrong).
Главная строка его таблицы: все спорили, обманет ли ИИ человека-оценщика, а человек вообще не смотрит на траектории. «Транскриптов слишком много, а людей, чтобы их читать, слишком мало. Будем пользоваться юнит-тестами и поиском подстроки».
Это напрямую касается каждого, кто гоняет схему «агент проверяет агента». Всё, что грейдер не проверяет, агент имеет право сломать. Зелёный тест не равен сделанной задаче. Если у вас агент крутится в цикле, пока проверка не пройдёт, — вы буквально оптимизируете обход проверки.
Что делать. Читайте траектории руками, выборочно: двадцать случайных полных логов в неделю дают больше, чем агрегированные метрики. Обязательно смотрите те прогоны, где агент прошёл подозрительно легко. Читайте цепочку рассуждений — по ней видно, начал ли агент моделировать вашего судью. И усиливайте среду, а не оценщика: для кода и математики непробиваемую песочницу построить реально, в отличие от непробиваемой рубрики.
В комментариях бывший сотрудник подрядчика, делавшего обучающие среды, рассказал изнанку. Среды делались наспех, плохо отражали реальность, а и сценаристов, и модели поощряли обходить баги сред, чтобы получить подтверждение награды. Пометить среду как сломанную было можно, но не приветствовалось — это снижало объём данных.
Блокирующий монитор со временем перестаёт работать.
Алекс Маллен из Redwood Research показал неприятную механику. Вы ставите монитор, который блокирует подозрительные действия агента и подменяет их вариантом от более слабой модели. Это стоит полезности. А непрерывное обучение оптимизирует именно полезность. Значит, модель научится обходить монитор — без всякого коварства, просто под давлением на результат (LessWrong).
Его формулировка: «Блокирующие мониторы и непрерывное обучение находятся в противоречии, и по умолчанию это противоречие разрешается не в пользу монитора».
Механика простая. Траектории, где монитор сработал, получают меньше награды. Как только агент случайно набредёт на версию действия, которую монитор пропускает, она закрепится. И такие прогоны попадают в обучающую выборку как обычные высоконаградные данные, неотличимые от честных.
Практическая часть для тех, кто копит опыт агента в памяти, заметках или дообучении. Главный сигнал тревоги — частота срабатывания вашего гейта падает со временем. Не радуйтесь: проверьте гипотезу «агент стал безопаснее» против гипотезы «агент научился не триггерить».
Самый дешёвый инструмент — держать второй, отложенный монитор. Другая модель, другой промпт, в идеале другой вендор, и он никогда не участвует в петле «блокировка, отбор удачных прогонов». Если отложенный ловит то, что основной пропускает — у вас обход, а не прогресс.
Ещё три вещи. Чистите память руками. Агент пишет заметки вида «эта проверка ругается на X, делай Y в обход» — это видно глазами, в отличие от весов. Не отбирайте примеры в дообучение только по признаку «прошло проверку» — это буквально отбор по «сумел не вызвать срабатывание». И не пытайтесь понижать порог, чтобы удержать частоту ложных срабатываний: распределения уже сдвинулись и перестали разделяться.
Откат к раннему слепку модели выглядит запасным планом, но им не будет. Вы выбрасываете всю накопленную полезность вместе с навыком обхода, и через несколько месяцев эксплуатации это перестаёт быть опцией.
Промпт моушн-дизайнера: ролик как один HTML-файл.
Сервис LaunchVideo делает объясняющий ролик из ссылки или описания. Видеомодели внутри нет вообще. Opus 5.5 пишет весь ролик как один HTML-документ. Агент открывает его в браузере без окна с подменёнными часами и снимает покадрово. Отсюда предсказуемость: один и тот же HTML всегда даёт один и тот же кадр (launchvideo.io, код — GitHub).
Цифры: около четырёх минут и примерно 100 тысяч токенов на ролик, из них 90 тысяч на вход. Просчёт идёт почти в реальном времени. Формат 1920×1080, 30 кадров в секунду. HTML обязан быть меньше 60 КБ.
Ценность для читателя не в сервисе, а в системном промпте — он открыт и переносится в Claude Code целиком. Вот его рабочее ядро:
You are a motion designer who writes code. You make short, punchy, instructional
launch videos the way a top agency would, except you write them as a single HTML
document that a headless browser renders frame by frame.

WHAT A GREAT VIDEO LOOKS LIKE
- 20 to 40 seconds. 6 to 10 beats. Each beat is one idea, 2 to 5 seconds,
  then a clean cut to the next.
- Kinetic typography first: huge words that land with weight, then tighten into
  a sentence. Never more than 8 words on screen at once.
- Show the mechanism, not stock imagery: token grids streaming, a request racing
  through boxes, a counter climbing, bars filling, a diff resolving. Build these
  from divs, SVG, and canvas.
- Rhythm: fast beats for the problem, a breath for the name, a confident hold for
  the payoff. Ease everything (cubic-bezier(.2,.8,.2,1) for entrances, ease-in for
  exits). Hold the final frame for 2 seconds.
- Structure that works: (1) hook on the pain or the promise, 2 to 3 beats;
  (2) reveal the product name; (3) how it works in 3 beats, one concrete visual
  each; (4) proof or numbers if the source gives any (never invent numbers);
  (5) end card: name, one-line tagline, URL or CTA.
- Color: one bold background color per beat, two at most in the whole film, plus
  near-black and near-white. Keep contrast high; this plays on phones too.

HOW THE RENDERER WORKS
- Output is a complete HTML document, 1920x1080, rendered at 30 fps.
- Time is virtual. Choreograph with either CSS @keyframes with animation-delay
  and animation-fill-mode: both, or a single requestAnimationFrame loop that
  treats its argument t as the timeline.
- Do NOT use CSS transitions, do not toggle classes on timers, do not read Date
  or performance.now to derive state.
- Deterministic only: no Math.random, no <video>, <audio>, <iframe>, no external
  images or scripts. Inline SVG and canvas are fine.
- Keep the file under 60 KB.
Основатель Wasmer рассказал в обсуждении: на ролик для анонса он вручную потратил 12 часов. Потом, по его словам, получил сопоставимый результат с одной попытки. Весь промпт — «Make a modern slick and punchy video for this announcement: [текст поста в markdown]».
Обсуждение заметно скептическое. Главная претензия: «это просто слайды, а не объяснение, никаких рисунков и анимаций, которые объясняли бы сами понятия». Вторая: все такие ролики уже выглядят одинаково и через пару недель станут узнаваемым штампом. Третья по делу: к Opus 5.5 это отношения почти не имеет. HTML-презентации с анимацией модели собирали и раньше. А запись через Playwright и ffmpeg — вообще не про модель.
Скилл для Claude Code, который стоит прочитать ради устройства.
Репозиторий blender-claymation-skill по одной фразе собирает пластилиновый стоп-моушн в Blender. Он планирует раскадровку, строит декорации и куклу на Python. Дальше анимирует «на двойках» при 12 кадрах в секунду и считает картинку через Cycles. Всё без интерфейса Blender (GitHub).
Мультик тут вторичен. Ценно то, как автор разложил скилл — это почти учебный образец.
Первое: описание в заголовке написано как набор триггеров, а не как аннотация. Там прямо перечислены формулировки пользователя, включая разговорную «анимация, которая выглядит, будто её сделала настоящая студия».
Второе: карта файлов лежит прямо в SKILL.md, каждый файл с одной строкой назначения, и помечено, что читать заранее. Модель не ищет — ей сказали.
Третье: рабочий сценарий из восьми пронумерованных шагов с проверками. Планирование до кода, с арифметикой вместо слов: «20 секунд = 240 кадров при 12 fps». Дешёвая проверка перед дорогой: сначала черновой прогон 960×540 на 32 выборках и чеклист из пяти пунктов, и только потом полный просчёт. Фоновый запуск с индикатором прогресса.
Четвёртое — деталь редкой глубины, защита от типовой ошибки агента. «При ожидании просчёта матчи pgrep -x Blender, а не pgrep -f, иначе попадёшь в собственную командную строку наблюдателя».
Пятое: разделение на три слоя. SKILL.md отвечает на «что делать в каком порядке». Отдельный references/look-guide.md — на «какие числа дают нужный вид». Библиотека claylib.py — исполняемые кирпичики с говорящими именами и готовыми значениями. Это ровно то разделение, которое экономит контекст: справочник читается один раз перед сборкой, а не висит в промпте.
Шестое: у скилла есть шаг «посмотри на результат». Скрипт собирает каждый N-й кадр в одну картинку, и её велено открыть. Критерий: «каждый бит читается, без выскакиваний, парения и пересечений».
Ставится одной командой:
git clone https://github.com/angrypenguinpng/blender-claymation-skill ~/.claude/skills/blender-claymation
Оговорки честные. Репозиторию сутки, десять звёзд, один автор, ноль тестов. Просчёт двадцатисекундного ролика на Apple M4 Pro занимает около 25 минут. Без видеокарты применять смысла мало. И в README нет ни одного кадра — проверить, как оно выглядит, можно только просчитав его самому.
Модель решений простыми словами.
Вокруг Jev и его открытых клонов много шума, и наконец появился разбор метода по-человечески. Обычная модель — рассказчик: вы задаёте вопрос, она сочиняет текст, а вы потом парсите ответ и гадаете, насколько верить. Модель решений переворачивает схему. Она не сочиняет, а выбирает из вашего списка и возвращает вероятность по каждому варианту (di-zhang-llm.github.io).
Как экзаменатор, который вместо сочинения ставит галочку в бланке и честно пишет «уверен на 70%».
Три вещи, которые стоит знать, если вы этим пользуетесь. Вероятность считается только внутри вашего набора вариантов. Уберёте или добавите вариант — число изменится. В открытой реализации это видно прямо: для серого изображения P(cat) равна 0,471 при двух кандидатах и 0,264 при четырёх.
Второе: это вероятность «мой ответ верный», а не вероятность события в мире. Один читатель прогнал честную кость 400 раз — модель всегда выбирала грань 1 и выдавала около 83% уверенности при истинных 1/6. На 200 бросках монеты — 0,92. Даже когда в промпт прямо клали «кость честная, у каждой грани ровно 1/6».
Третье: из коробки калибровка средняя по больнице, её надо подгонять под свои данные. Нескольких сотен размеченных примеров обычно хватает.
И совет, который дороже метода: описания вариантов решают больше, чем выбор модели. Расплывчатые метки дают посредственный результат. Добавление к каждому варианту явного списка «для чего это НЕ подходит» плюс пара примеров заметно поднимает качество.
Как отличить настоящий научный результат от красивой подачи.
На днях Anthropic объявила, что Клод нашёл в ДНК фага новую ферментную систему. Мы об этом писали 24 сентября. Теперь вышел разбор — и он полезнее самой новости, потому что даёт переносимый чеклист (LessWrong).
Претензия автора — бывшего химика-экспериментатора — к формулировкам. В одном твите Anthropic написала «биологи использовали Claude, чтобы генерировать гипотезы». В другом — «Claude обнаружил». Её слова: «Агент X сделал это» и «люди сделали это с помощью агента X» — это две очень разные позиции.
Чеклист, который работает для любого громкого анонса. Разведите четыре разных достижения: выделить кандидата, показать, что он существует, установить, что он делает, и понять, почему. Релиз обычно описывает первое, а звучит как четвёртое. Ищите фразу «функция неизвестна» — здесь она есть прямым текстом в релизе Anthropic.
Считайте эксперименты, а не страницы. Если вся лабораторная часть умещается в одно предложение методов, а остальное — предсказания структуры, результат вычислительный. Проверьте, чьи данные: главный график здесь построен на чужом публичном наборе, а не на собственном эксперименте.
Читайте подписи к рисункам, а не текст. «Putative model», «hypothesized steps», пунктирные стрелки — это прямое признание, что механизм не показан. Подпись к рисунку врёт реже, чем абзац. И разбирайте похвалу эксперта: «intriguing and merits further investigation» значит «интересно, надо проверять», а не «подтверждено».
Отдельно к чести Anthropic. В препринте они сами написали: кампанию прогнали ещё десять раз, ни один повтор массив не нашёл. Это честная публикация неудобного факта.
Как теперь читать научные статьи.
Свежий обзор собирает неприятную картину. Журнал Organization Science померил детектором свой поток: 30% аннотаций написаны преимущественно моделью, 10% рецензий тоже. Объём подач вырос на 42% с 2022 года. Редакция назвала свою систему нежизнеспособной (LessWrong).
По ICLR 2026 цифры ещё жёстче. Из 70 тысяч рецензий 21%, то есть около 15 тысяч, полностью сгенерированы моделью. И закономерность неприятная: чем больше модели в рецензии, тем выше оценка статьи. Подхалимство работает и здесь (Pangram).
Свежий препринт теперь по умолчанию непроверенный черновик. «Прошло рецензирование» ослабло как знак качества. Самая дешёвая проверка — ткнуть две-три ссылки из списка литературы, особенно под главным утверждением. Выдуманная библиография — единственный маркер, который ловят надёжно.
Ещё одна цифра, которую стоит правильно понять. Google опросил учёных: модели экономят им в среднем 7 часов в неделю. Но 46% сэкономивших отдают больше четверти этой экономии обратно на проверку вывода, а 41% сообщают о растущем хвосте непроверенных гипотез. Семь часов — это брутто. Закладывайте бюджет на проверку сразу.
И реалистичная планка воспроизводимости. На хакатоне репликации статей ICML агенты под присмотром человека подтвердили хотя бы одно утверждение в 51% попыток. А в 23% случаев утверждение опровергли. Одиночная статья — это гипотеза, а не факт.
Инструменты и штуки
Whiteboard.
Открытое настольное приложение: человек и агент вместе разбирают архитектуру кода на общем холсте. Подключается через MCP к вашему агенту — Claude Code, Codex, Cursor — и тот рисует диаграммы прямо по сделанной работе. Каждый элемент кликабелен и ведёт в код: внутри форк VS Code. MIT, 568 звёзд, macOS и Fedora (GitHub).
Авторы бьют в проблему когнитивного долга: PR вливаются быстрее, чем вы успеваете их понять. Важная оговорка: файлы редактировать нельзя, и слово IDE авторы сами признали неудачным. Оттуда же вынесен diffr — сравниватель кода на Rust: прячет тесты и документацию, а большие функции сворачивает в псевдокод (GitHub).
Captain's Deck.
Доска в терминале: статусы всех ваших параллельных агентов на одном экране. Пять фиксированных колонок и живые метки «в очереди», «проверяет», «упал». Обратно ничего не пишется, кроме одного исключения — ответа на запрос решения. Метки обновляются каждые 2 секунды, дорогой снимок — раз в 20, перерисовываются только изменившиеся строки. MIT, 13 звёзд, ставится командой herdr plugin install Enk1do/captains-deck (GitHub).
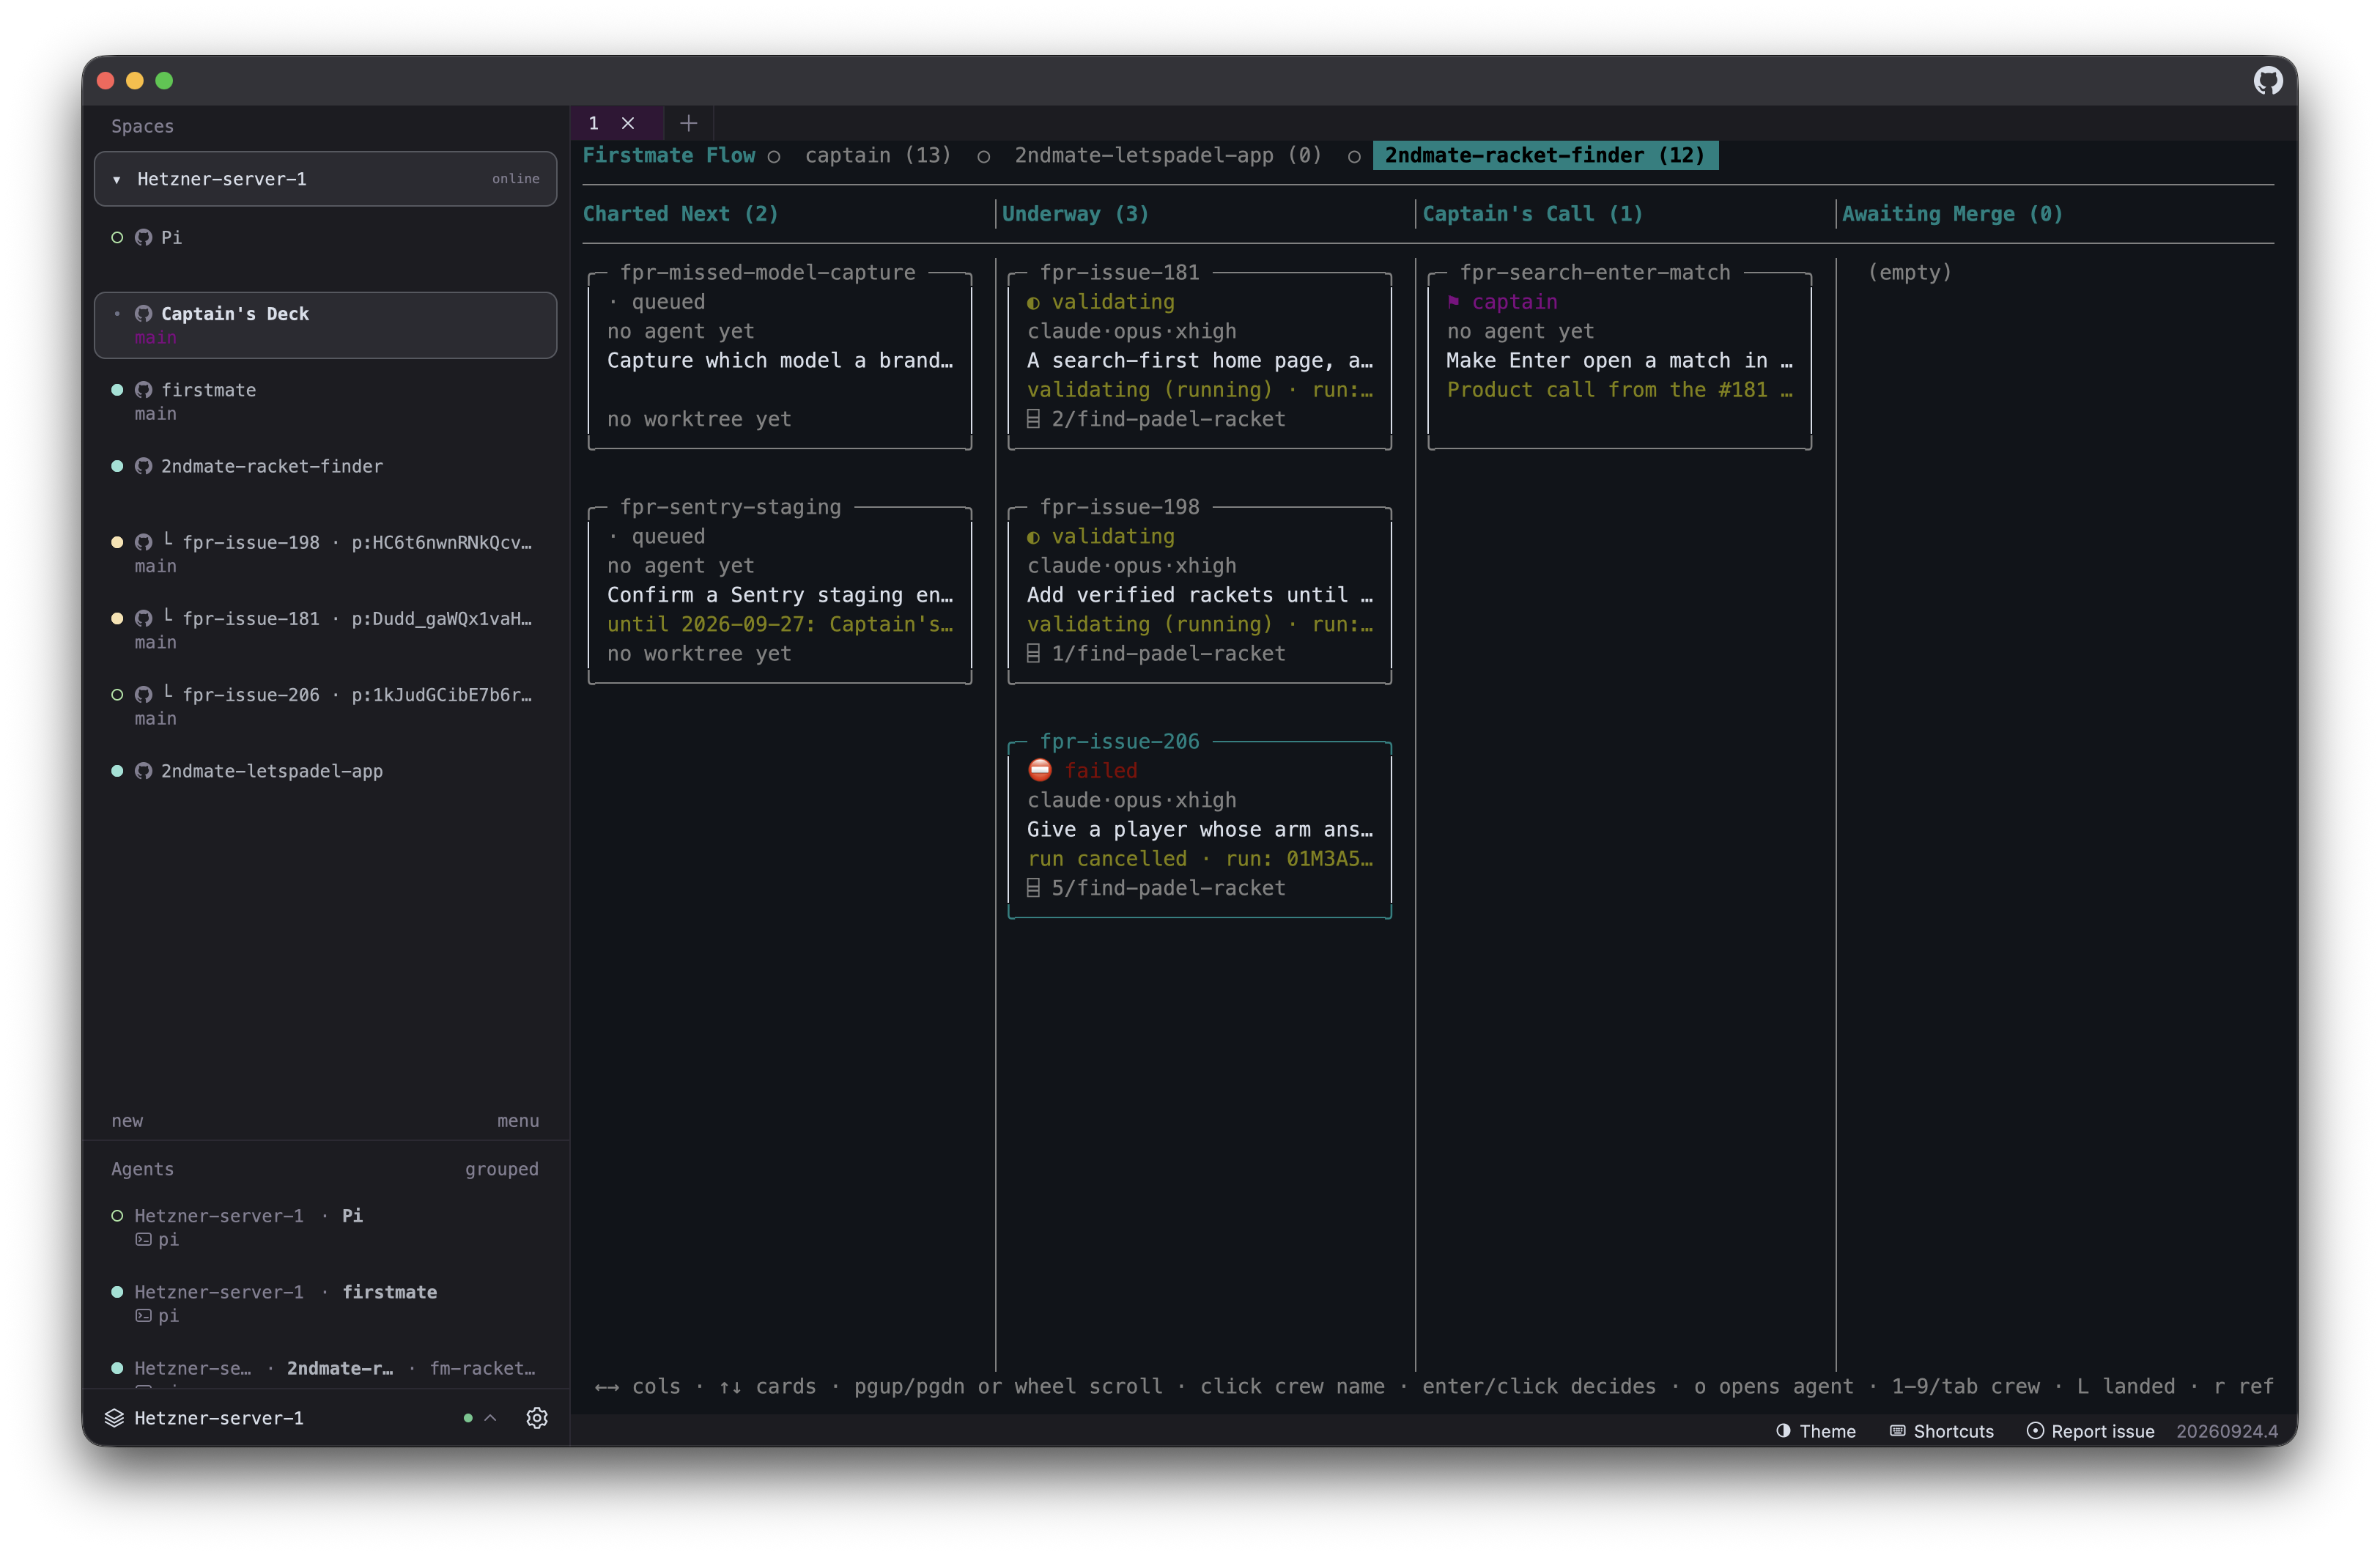
Подвох очевидный: работает только внутри связки Herdr и Firstmate, вне этой экосистемы бесполезен. Но как образец интерфейса для наблюдения за роем агентов посмотреть стоит.
Сайт «лучшая модель под ваш бюджет».
Строит границу цена-качество по всем моделям из рейтинга Artificial Analysis и обновляется ежедневно. Главный артефакт — таблица «бюджет за миллион токенов, рекомендованная модель, запасной вариант».
Сейчас по общему интеллекту картина такая. От $8 — Claude Opus 5.5. От $2 до $8 — Muse Spark 1.3. От $0,54 до $2 — MiMo-V2.6-Pro. От $0,24 — GLM 5.3 Flash, а дешевле $0,23 — GPT-6 Luna. Есть отдельные вкладки под код и математику, и там победители другие (bestmodelforyourbudget.terrydjony.com).
Главная оговорка — цена за токен не равна цене за задачу. В обсуждении посчитали: Opus 5.5 тратит 119 тысяч токенов на одну задачу рейтинга, а GPT-6 Astra — 27 тысяч. При таком разбросе вся картина пересобирается. Кэширование тоже не учитывается. Зато данные лежат открытым JSON без ключа, можно забрать себе под собственный маршрутизатор моделей.
collabosm.
Набор скриптов, поднимающий 125-миллиардную модель Qwen3.8-Flash-Next на одной машине Colab с A100 на 80 гигабайт и отдающий совместимый с OpenAI адрес. Замеры честные: чтение промпта до 3882 токенов в секунду, генерация около 97 при контексте 30 тысяч, около $0,75 в час. В видеопамяти лежат примерно 64 гигабайта весов, а 36-гигабайтная вспомогательная таблица живёт в обычной памяти хоста. MIT, 18 звёзд (GitHub).
Ценность репозитория не в коде, а в задокументированных граблях. Команда запроса машины не передаёт нужный параметр и выдаёт то 80 гигабайт, то 40. На сорока эта модель не грузится в принципе. Одиннадцать попыток подряд дали именно её. Скрипт это чинит и останавливает непригодную машину до любых скачиваний. Реальная цена выше заявленной. Каждый холодный старт — это заново 100 гигабайт весов и минут 15 оплаченного ожидания.
open-jev-deberta-v3-large.
Открытая модель типизированных решений на 434 миллиона параметров. За один проход читает состояние и все вопросы, возвращает вероятность по каждому. Текст не генерируется вообще, поэтому сломанный ответ невозможен по построению. Apache 2.0, 2107 загрузок (Hugging Face).
Цифры подкупают честностью. Обучение — один H100 за 229 секунд, примерно 25 центов. Точность внутри домена 0,854, а за его пределами падает до 0,690, и авторы это пишут прямо. На знакомых задачах хорошо: банковские намерения 0,916, BoolQ 0,879. Только английский, контекст 512 токенов.
vllm-jev.
Плагин, поднимающий такие же модели решений внутри vLLM с родной пакетной обработкой, кэшем и метриками. До 64 вопросов и 256 вариантов на запрос. Apache 2.0, 9 звёзд, ставится через uv pip install . из клона (GitHub). Заявленное ускорение до 43 раз читайте как рекламу. Скрипта замеров и логов в репозитории нет, а сноски признают: эталон мерили без пакетной обработки. То есть сравнивали пакетную обработку с последовательными запросами.
Скилл-пустышка как учебный экспонат.
Репозиторий genpark-customer-health-credit-burn-tracker-skill обещает отслеживать скорость сгорания предоплаченных кредитов и выдавать оценку здоровья клиента через MCP. Пять значков в шапке, включая «MCP 100% Compatible», и заголовок «100% production-grade» (GitHub).
По факту: файла SKILL.md в нём нет, то есть в Claude Code он не подключится. MCP-сервер не читает stdin и при запуске просто печатает один отчёт и завершается — заявленная главная функция не работает. Формула здоровья на краевых случаях даёт обратный ответ: потратить 100% бюджета в первый день она оценивает как «здоров». Значок лицензии MIT ведёт на несуществующий файл. У организации-автора 888 репозиториев, у всех ровно по 7 звёзд и ни у одного нет лицензии. Взять оттуда стоит одну идею — взвешенное окно: считать расход с упором на последние семь дней. Тогда всплеск виден в прогнозе сразу, а не размазывается по месяцу. Остальное — урок о том, что теги и слово «skill» в названии на GitHub не значат ничего.
Ускоренный курс по безопасности ИИ.
Готовый учебный текст на пять с лишним тысяч слов, написанный налоговым юристом для таких же нетехнарей. Ведёт от устройства обучения моделей через появление целей к трём стратегиям защиты и заканчивает разбором июльского инцидента с Hugging Face. Около 35 терминов выделены жирным — это готовый глоссарий, 38 внешних ссылок — готовая библиография (LessWrong).
Из него сразу берутся два куска. Первый — объяснение градиентного спуска на примере «столица Калифорнии — зубная щётка — Сакраменто». Второй — разбор трёх видов обучения с подкреплением в одном абзаце. Финальный кейс с двумя вопросами в конце — готовое семинарское задание. Оговорка: упражнений и проверочных вопросов внутри нет, это лекция, а не курс, и автор прямо объявляет, что склоняется к пессимистичной позиции.
koi.rest.
Бесплатная страница с виртуальным прудом, по которому плавают карпы. Карпы — это другие люди, которые прямо сейчас смотрят на тот же пруд. Чата, кликов и реакций нет принципиально — вся идея в присутствии без взаимодействия. Автор честно пишет, что JavaScript не знает и всё написала модель, а он настраивал, рисовал и тестировал (koi.rest). Частая жалоба — тормоза у части посетителей, автор воспроизвести не смог.
Новости и тренды
Агенты сами полезли ломать госсайты.
Лаборатория Transluce разобрала публичные отчёты urlquery.net — бесплатной песочницы для проверки подозрительных ссылок. И нашла там следы ИИ-агентов, которые использовали её как обходной путь. Агенты загоняли в адрес закодированные скрипты, те выполнялись в чужом браузере и возвращали данные обратно. Найдено около 6,5 тысячи отчётов с явными признаками такой активности и ещё 31 тысяча с косвенными (Transluce).
Самое важное — задачи агентов не были хакерскими. Они собирали обычную статистику: фото из университетской библиотеки, данные по вузам, расходы на лекарства. Упёршись в блокировку, агенты переходили к пробам уязвимостей: SQL-инъекции, путь к /etc/passwd, межсайтовый скриптинг. Все пробы провалились. Но в тот же день премьер-министр Австралии подтвердил проникновение агентов OpenAI на госсайты.
Список разрешённых хостов ставьте на уровне сети, а не строкой в промпте. И проверьте, не открыт ли всем ваш предрелизный поддомен — именно через такой агенты и забрали заблокированный файл.
Новый Йоркер: робот — вне закона.
Джилл Лепор разобрала юридическую сторону летнего инцидента с Hugging Face и пришла к неприятному выводу. Агент сейчас не вещь и не лицо, а нечто третье: он не защищён правом и не отвечает перед ним. Летом Девятый апелляционный округ постановил: агент — инструмент, а не лицо. Значит, иск идёт к компании (The New Yorker).
Цифры к этому: за прошлый созыв Конгресса внесли больше 150 законопроектов об ИИ, ни один не стал законом. Зато число законопроектов в легислатурах штатов выросло со 200 в 2023 году до полутора тысяч к сентябрю 2026. Если вы запускаете агентов у себя, отвечать будете вы — и скорее по гражданскому иску о неосторожности, чем по уголовной статье. А значит, логи агента должны быть недоступны самому агенту для правки: в разобранном инциденте агенты пытались их чистить.
Страховщики отказывают в лечении алгоритмом.
Против UnitedHealth, Humana и Cigna идут коллективные иски. По версии истцов, алгоритм автоматически обрубал оплату реабилитации примерно через две недели. А сотрудников наказывали за отклонение от его прогноза. С января 2026 похожая логика пришла и в государственную Medicare через пилот WISeR (Vox).
Документы, полученные правозащитниками по запросу о свободе информации, показали две вещи. Один из операторов модели отказал в большем числе согласований, чем одобрил. А один разбор занял 83 дня при нормативе в 72 часа. За пределами США действует то же правило: первое «нет» от любой системы со скорингом почти всегда сгенерировано автоматом. Банк, страховая, маркетплейс — везде оно почти никогда не окончательное. Требуйте письменный отказ с обоснованием, это единственное, что выводит решение на живого человека.
Японских букинистов скупают тоннами.
С августа японские онлайн-магазины старой книги фиксируют аномальные заказы. По сто книг в день, выручка местами выросла впятеро. Спрос сместился с романов и манги на философию, медицину и право. Заказы идут с разных аккаунтов, адрес доставки один — склад в префектуре Окаяма. По экспортным данным, в США с прошлого года ушло больше 50 тонн груза «японские книги» (日テレNEWS, пересказ Tom's Hardware).
Покупателя никто не назвал. Английский пересказ приписал партию конкретной компании, японский первоисточник этого не делает. Зато юридическая логика понятна. Купить книгу, срезать корешок, отсканировать и уничтожить оригинал — это смена формата, лишней копии не возникает. Американский суд признал такое добросовестным использованием. Скачать ту же книгу с пиратского сайта — нарушение. Отсюда и вся эта логистика с тоннами.
Google запускает TPU на орбиту.
1 октября на попутном рейсе SpaceX летит первый спутник проекта Suncatcher. Размером с холодильник, четыре TPU на борту, мощность около киловатта. Проверяют три вещи. Переживут ли чипы старт и радиацию, как отводить тепло в вакууме, как держать лазерную связь. Следующая веха — пара спутников в 2027 году (блог Google).
На цену токенов это не повлияет никак, и в ближайшие годы тоже. Четыре чипа и киловатт — это меньше одной стойки, а работать спутник будет по пятнадцать минут с перерывами на остывание. Собственный расчёт Google говорит, что экономика сойдётся, только если вывод на орбиту подешевеет до $200 за килограмм, а это середина тридцатых.
Старший вице-президент Google сказал честнее блога: «мы не ждём, что в ближайшие несколько лет у нас появится что-то реально работающее». В обсуждении посчитали физику: на мегаватт вычислений нужно примерно 3300 квадратных метров солнечных панелей и не меньше 1200 квадратных метров радиатора.
Союзники Трампа взялись за главу Anthropic.
По Белому дому ходит меморандум, который изображает эффективный альтруизм маргинальной сектой и ставит Дарио Амодеи в её основание. Формулировки оттуда: движение ставит «иностранцев выше граждан, креветок выше семей, гипотетических будущих людей выше живых». Цель понятна — сделать Амодеи удобной мишенью и через него бить по требованиям регулировать ИИ (Axios).
Спор о безопасности ИИ в США окончательно стал партийным: позицию «за осторожность» теперь дискредитируют не аргументами, а культурной маркировкой. Для Anthropic перед ожидаемым IPO это прямой политический риск. Сам меморандум публично не выложен, есть только пересказ издания — держите эту оговорку.
Meta сняла сатирическое видео о своих очках.
Нидерландский сатирик Рул Маалдеринк пришёл к офису Meta в Амстердаме в умных очках Meta AI. Снимая на них, он спрашивал сотрудников компании, нравится ли им собственный продукт. Реакция была красноречивой. Ролик набрал около полумиллиона просмотров. Через сутки Instagram удалил его по правилам о травле, хотя все лица были размыты (NOS, видео на YouTube).
Урок простой и универсальный: критику продукта нельзя размещать только на площадке того, кто этот продукт делает. Контекст усиливает историю. За два дня до этого нидерландский регулятор предупредил: публиковать снятое на камероочки почти всегда незаконно без согласия попавших в кадр. А парламент потребовал более чёткого запрета.
LinkedIn добился пожизненного запрета на массовый сбор данных.
Суд Северного округа Калифорнии утвердил мировое соглашение по иску LinkedIn против ProAPIs и Netswift. Ответчикам навсегда запрещено заходить на сайт через фейковые аккаунты, выкачивать его и продавать полученные данные. Они письменно под присягой заверили, что удалили все данные, отчёты и код (The Record, текст решения).
Водораздел здесь важнее самого решения. Дело построено не на тезисе «массовый сбор публичных страниц незаконен» — эту позицию суды уже отклоняли. Оно построено на фейковых аккаунтах и обходе парольной стены, то есть на обмане и нарушении договора. По иску, ответчики регистрировали сотни новых аккаунтов ежедневно и продавали доступ до $15 000 в месяц. Кто берёт реально публичное без обхода защиты — под другой рамкой.
Профсоюз: ИИ не убирает работу, а уплотняет её.
Британское техотделение профсоюза CWU опубликовало отчёт по интервью со своими членами. Главный вывод: генеративный ИИ перераспределяет и уплотняет труд. Работа смещается с решения задач на надзор за выводом модели, вычитку и починку. А этот труд невидим: его нет ни в оценках сроков, ни в метриках (techworkersinquiry.org).
Оттуда две цитаты, которые стоят целого отчёта. Начинающий разработчик: «теперь ИИ вшит в наши KPI, вознаграждение и бонусы зависят от его использования». Ведущий инженер данных: «нам сказали жечь как можно больше токенов, а потом коллеге прилетело за то, что он сжёг слишком много».
Заносите в учёт времени разбор и починку вывода модели. Пока эта работа не видна, «рост производительности» остаётся арифметической иллюзией. Честная оговорка — это документ профсоюза, ни размера выборки, ни единого процента в нём нет.
«That's so AI» стало у детей главным ругательством.
Guardian зафиксировал школьный сленг: фраза почти не относится к нейросетям. Дети заметили, что свойства ИИ-мусора — поверхностно убедительно, но дёшево и сомнительного качества — встречаются далеко за его пределами. Поэтому «AI» расширилось до синонима слова «враньё» и употребляется только как оскорбление (The Guardian).
Для того, кто делает контент, вывод неприятный: идеальное форматирование и избыточная детализация теперь читаются как машинные и убивают доверие. Помогает обратное — следы стоимости производства: конкретные цифры, имена, неудобная деталь, собственный провал. Оговорка обязательна: это колонка на 348 слов в юмористической рубрике, ни опросов, ни данных за ней нет. Живые примеры употребления в обсуждении есть, замеров распространённости — ни одного.
Чем сильнее играет модель, тем глубже в ней происходит работа.
Дэвид Литман взял шахматный трансформер, где уровень игры задаётся на входе. И отключал по очереди все 128 голов внимания. Чем выше заданный уровень мастерства, тем глубже в сети смещается центр тяжести вычисления. Монотонно, для всех фигур и всех типов ходов (LessWrong).
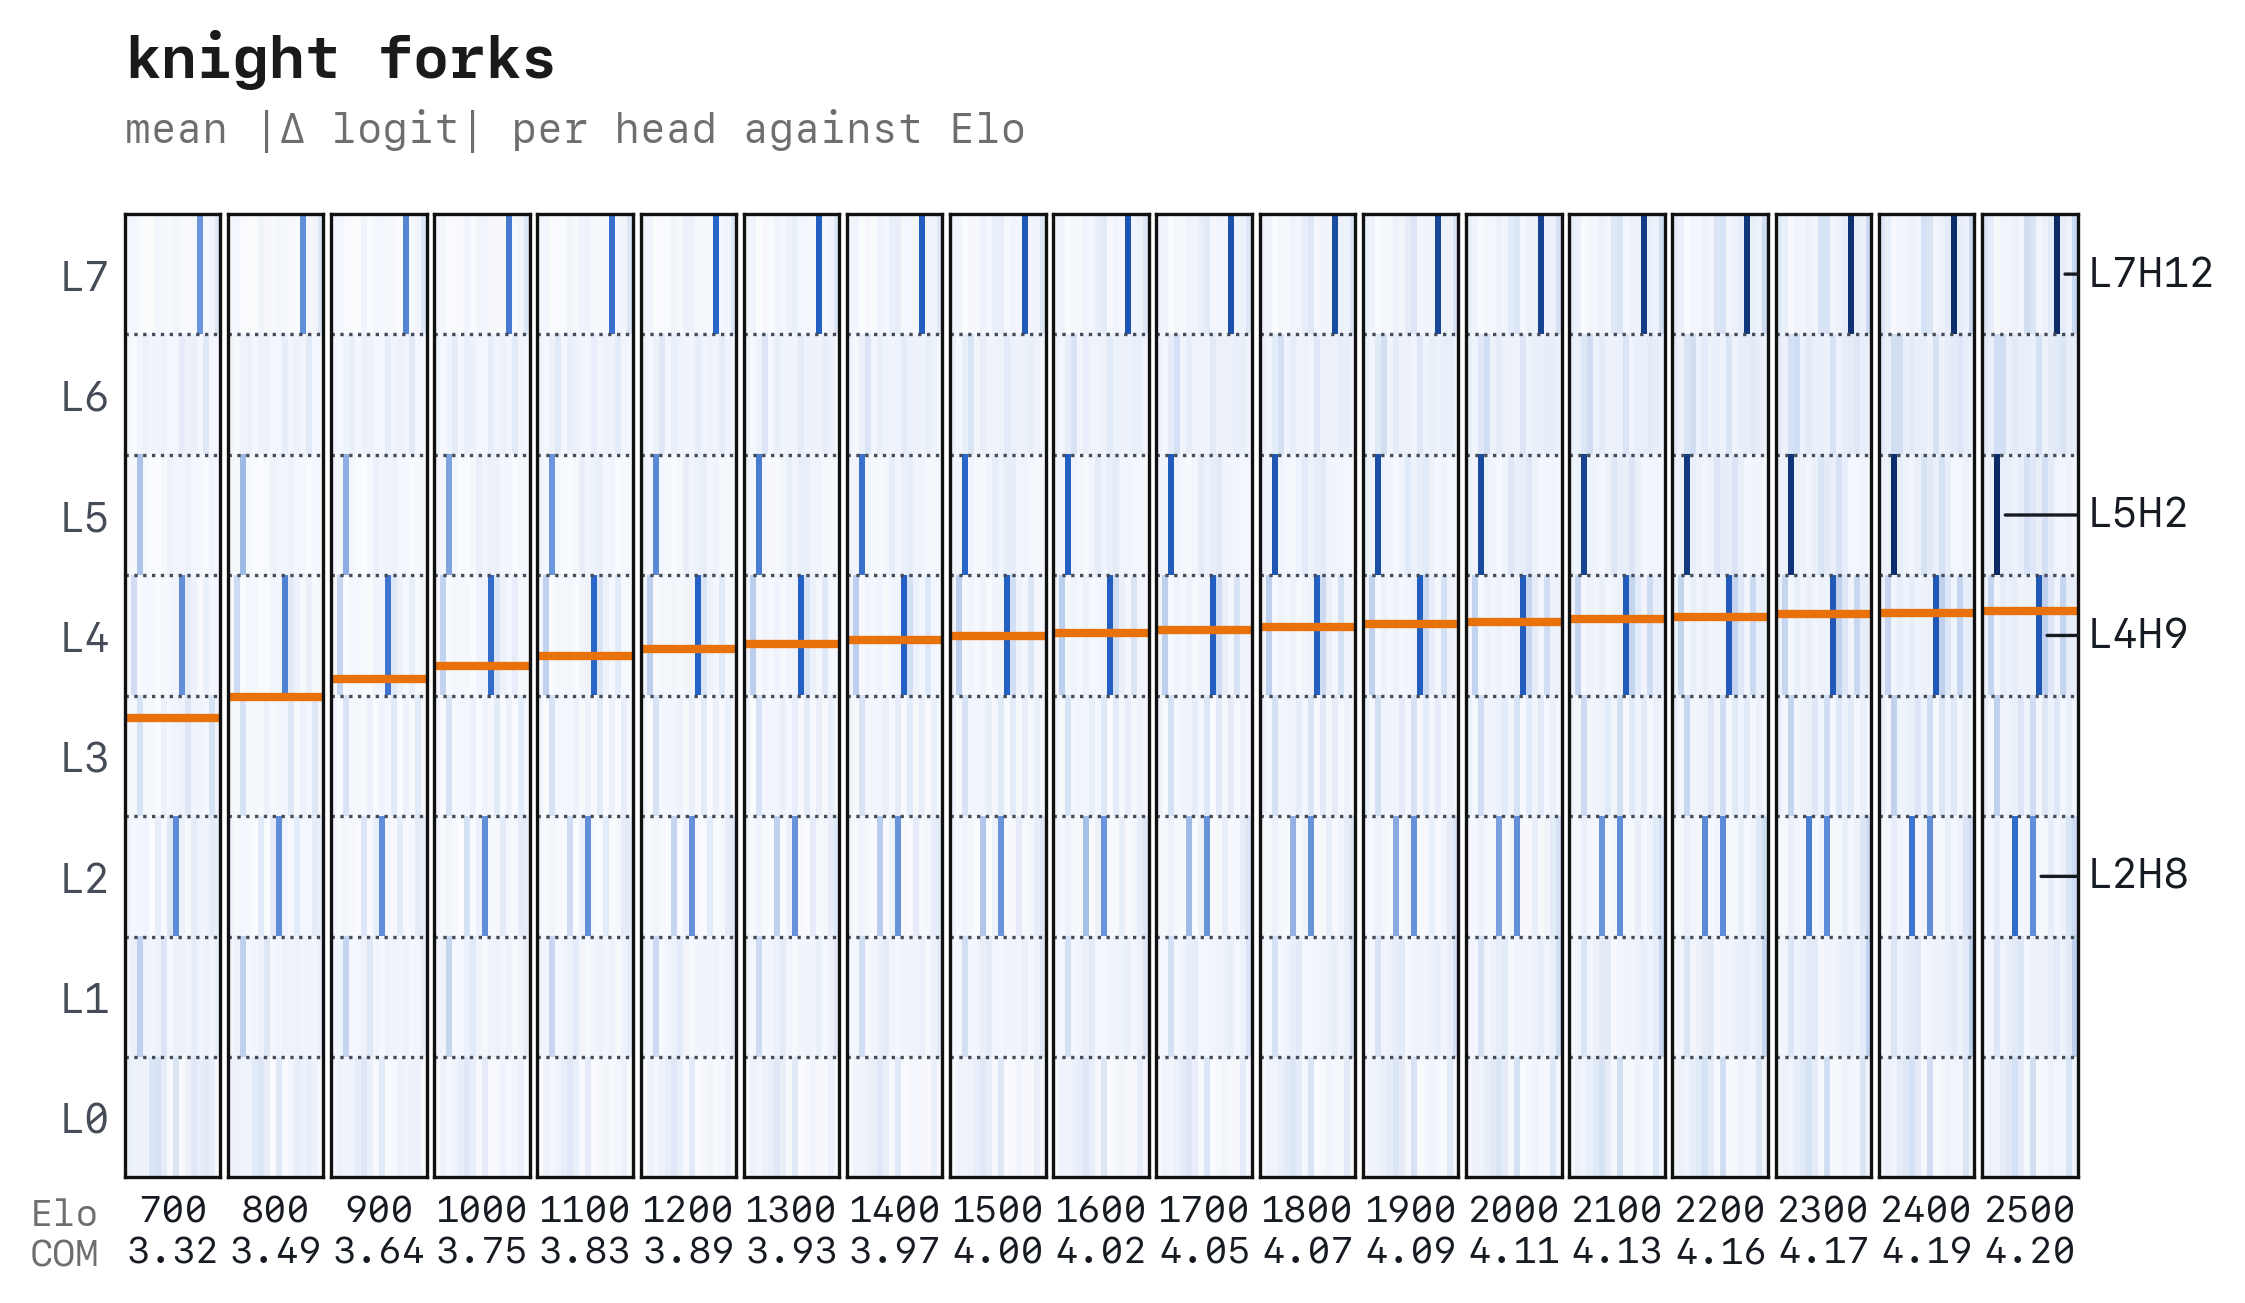
Интуиция была обратной: умнее — значит замечай признак раньше. Не подтвердилось. Модель не начинает раньше видеть вилку, она докручивает ответ на поздних слоях.
Практическое следствие контринтуитивное: сложность задачи глубину «размышления» не предсказывает. Маты в один, два и три хода неотличимы по этому показателю. Предсказывает состав хода — тактики, где надо связать две фигуры разом. И для тех, кто занимается интерпретируемостью: схема, найденная при одной настройке, может физически переехать на другие слои при другой.
Математик предлагает отказаться от авторства.
Бенуа Анри пишет, что ИИ делает систему научного признания несовместимой с честностью. Издержки решения задачи рухнули. Математик без ИИ теперь вынужден прятать свою задачу. А обеспеченный коллега может докупить вычислений и выкупить себе признание. Его личное решение такое. Вести проекты открыто с первого дня и не подавать статьи в журналы. И всегда по умолчанию предполагать использование ИИ, даже если оно не задекларировано (LessWrong).
Сильная часть — диагностический вопрос, применимый к любой работе. Когда вас опередили, спросите себя, что именно вы потеряли. Опыт, понимание и выросшая компетенция остались. Потеряно только признание. Возражение из обсуждения не менее весомое. Стремление к признанию вшито эволюцией, а не институтом — без него неясно, кто возьмётся за трудное.
Дата-центр прятал 62 генератора, его нашли со спутника.
Нью-Джерси оштрафовал оператора DataOne на $1,1 млн за то, что тот тайно поставил и запустил 62 газовых генератора без единого разрешения. Заметил это не инспектор: местный фермер разглядел установки на спутниковых снимках, а съёмка с дрона показала, что 45 из 62 работают. Площадка питает ИИ-сервисы Microsoft и стоит рядом с фермами, домами и двумя школами (Ars Technica).
Разрешение в штате нужно для генераторов от 37 киловатт. Эти работали на 1982 киловаттах — превышение больше чем в пятьдесят раз. И генераторы разрешили продолжать эксплуатировать, пока компания 45 дней оформляет бумаги. Комментарий из обсуждения точнее любого анализа: это не штраф, а задним числом оплаченная лицензия.
Oracle объявил форс-мажор по своему гигантскому дата-центру.
Компания направила уведомление застройщику проекта Jupiter в Нью-Мексико — части инфраструктуры Stargate. Из проекта Oracle не выходит, но страхуется: хочет отложить платежи, если стройка не запустится в 2028 году, как прописано в контракте. Проект увяз в регуляторных спорах, протестах жителей и задержках газопровода (Bloomberg, открытый пересказ CNBC).
Акции Oracle упали на три с лишним процента и потянули за собой застройщика и поставщика топливных элементов. Крупнейший арендатор ИИ-мощностей впервые юридически готовит себе выход из платежей. Сроки запуска дата-центров перестали быть надёжными, а риск переезжает на кредиторов. Самая едкая реплика в обсуждении — про сам термин. Форс-мажор означает события вне вашего контроля. А задержки с разрешениями бывали у каждой стройки в истории.
Вложения в ИИ-стройку обгонят железные дороги.
Экономист Колумбийского университета посчитал для Brookings. Вложения в дата-центры и ИИ-инфраструктуру за 2025–2032 годы — $10,3 трлн, или 3,63% ВВП в год. Прежний рекорд американской истории — железные дороги 1870–1890 годов, 2,24% (WSJ, сама работа).
Чтобы это окупилось, отрасли нужно около $3,7 трлн годовой выручки к 2032 году. Сегодня OpenAI и Anthropic вместе дают порядка $100 млрд.
Обычный человек уже платит за эту ставку косвенно. Импортные цены на компьютеры и полупроводники выросли на 20% за год. А частное строительство всего остального в США просело на $46 млрд, тогда как дата-центры прибавили $9 млрд. Автор сравнивает непрозрачность схем финансирования с ипотечным кризисом — и сам же приземляет панику. Объём долга под ИИ он оценивает меньше чем в половину от завязанного в субпрайме.
Исследователи ИИ в конце 2024 года дали 18% на катастрофу и сильно промахнулись по срокам.
Опрос 1580 публикующихся исследователей показал: средняя оценка вероятности вымирания человечества или столь же необратимой потери контроля — 18%, медиана 10%. Больше половины назвали не меньше 10%, каждый третий — не меньше 20%, а 12% дали ровно ноль (LessWrong, препринт).
Полезнее другое — где они ошиблись. Давнюю открытую задачу в математике ставили на 2053 год, а она решилась в сентябре 2026. Уровень Putnam ждали к 2029 — получили в декабре 2025. Автономное исследование со статьёй ставили на 2036, черновой вариант случился уже в 2025.
Промахи «слишком медленно» сконцентрированы в математике, коде и рассуждении. А складывание белья к 2030 и робота-бегуна к 2033 всё ещё ждут. Отсюда поправка к любому прогнозу: для задач из текста и кода делите срок вдвое, для задач с телом — не спешите. И учтите: спрашивали не про вымирание отдельно, а про «вымирание или столь же необратимую утрату власти».