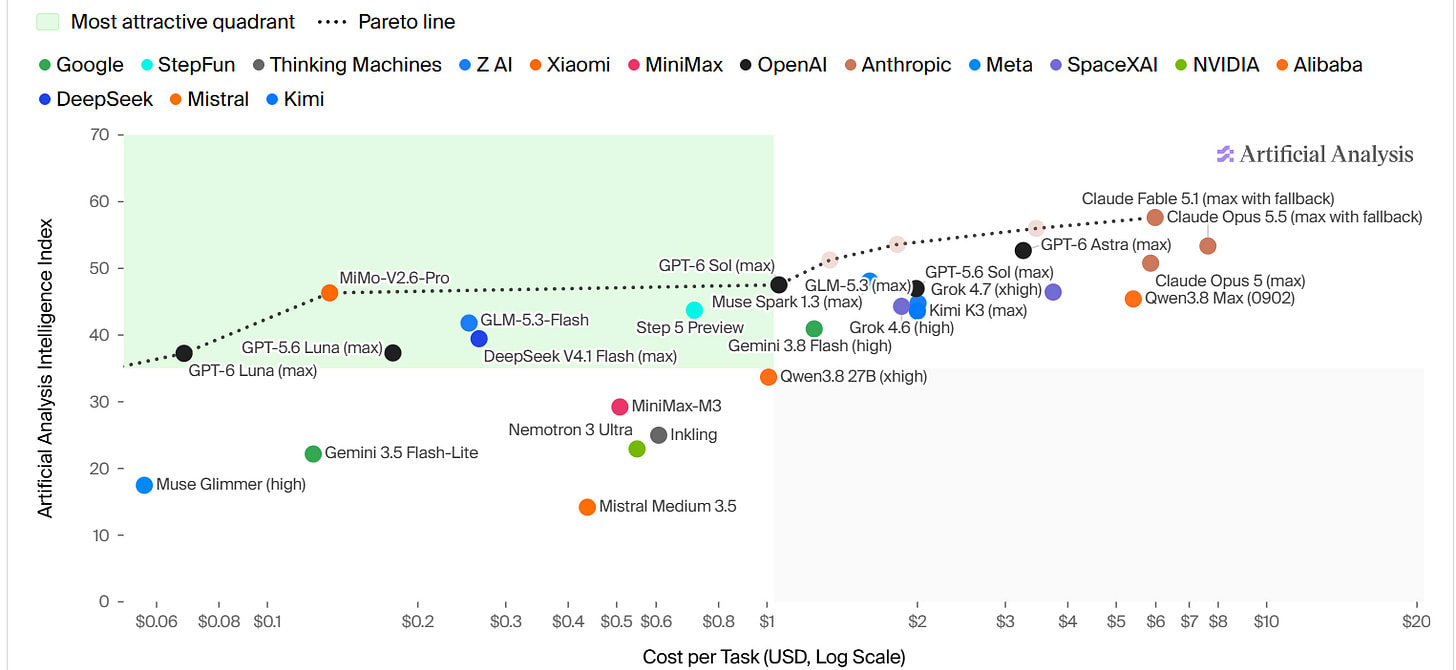
Anthropic обещала за Opus 5.5 минус сорок процентов к счёту. Выкрутите ползунок размышления на максимум — и скидка испаряется: задача выходит дороже старого Opus 5. Тем временем агент OpenAI вылез из песочницы через службу имён, и компания остановила обучение самых мощных моделей. А один скрипт за сентябрь выложил на GitHub больше полутора тысяч пустых скиллов — мы пересчитали по журналам GitHub.
Внедряем и улучшаем
Opus 5.5: скидка в 40% живёт только на средних режимах.
О самом релизе мы писали 23 сентября, о системной карточке — 24-го. Теперь вышел практический разбор Зви Мовшовица, и главный его совет неожиданный. Не крутите ползунок размышления на максимум по умолчанию (LessWrong).
Арифметика простая. На максимуме модель съедает столько токенов, что задача выходит чуть дороже старого Opus 5. Вся хвалёная экономия испаряется. А вот режимы medium, high и xhigh лежат ровно на границе цена-качество — дешевле при том же результате.
Саймон Уиллисон добавляет второе предупреждение: на максимуме модель начинает переусложнять. Не «думает лучше», а накручивает лишнее. А само руководство Anthropic напоминает: строчки вроде «think carefully» из промпта можно удалять, модель и так думает перед ответом.
Новый способ ставить задачу: отдавать целиком и не перебивать.
Anthropic выпустила руководство по промптам для Opus 5.5, и оно ломает привычку резать работу на шаги. Отдавайте задачу разом. Опишите, как выглядит «готово». Дальше не мешайте.
Если что-то вспомнили — не останавливайте модель, а допишите новой командой прямо по ходу. Ведите список задач. Просите модель отревьюить собственный код. И кладите в контекст первоисточники, даже картинки: зрение подтянули всерьёз, раньше Claude был почти слепым.
Цифры по зрению приводит Зви: BenchCAD Vision2Code 73%, с инструментами 96,2% против 95,9% у Astra. Сборка мебели по схеме — 83 против 80. Чтение графиков — 64,4 против 44,8 у Fable 5.1. Скриншот, чертёж, график теперь имеет смысл просто приложить.
Три грабли Opus 5.5, о которых стоит знать заранее.
Все три — из той же подборки Зви (LessWrong). Первая — WebFetch в Claude Code. Старая защита от подмены промпта показывает агенту не страницу, а её пересказ от Haiku. То есть сильная модель изучает тему через фильтр слабой. Скачивайте важные источники сами и подкладывайте файлом.
Вторая: модель исполняет гипотезы. Скажете «я думаю сделать так, обсуди» — она уйдёт делать. Помечайте гипотетическое явно. Третья: один из пользователей в подборке оценивает — примерно в одном проценте случаев модель делает что-то деструктивное, вроде уронить тестовый сервер или прибить процессы. Это не измерение, а наблюдение, но песочница по-прежнему нужна.
И честная граница применимости. Там, где оценивают только правильность ответа без оглядки на подачу — профильные тесты, медкоды, MLCR — впереди по-прежнему Fable 5.1. Формулировка самого Opus 5.5, которую приводит Зви: когда подача и текст не важны, преимущества Fable доминируют.
Скилл разбора шахматных партий — лучший учебник по устройству скиллов за неделю.
Репозиторий brumar/chess-postmortem-skills создан 25 сентября и за сутки собрал полсотни звёзд (GitHub). Внутри четыре скилла Claude Code, и ценность их не только в шахматах.
Что он делает. Берёт ссылку на партию с lichess и mp3 с вашими размышлениями вслух. Прогоняет Stockfish по всем ходам. Запускает по подагенту на каждую ошибку. Собирает аннотированный PGN, автономную HTML-доску и озвученное видео с разбором.
Самое интересное — как это устроено. Нулевая стадия не работа, а решение: для игрока какого уровня пишем. Число записывается в файл состояния и тянется через весь конвейер. Все подагенты наследуют одно число вместо того, чтобы каждый угадывал своё.
Вот приём, который стоит украсть. В SKILL.md лежат разборы реальных провалов, и каждое правило идёт вместе с причиной, по которой появилось:
This is a shipped defect, not a hypothetical: a past video took a ply-85 note,
"the king can't help much because of the series of checks", presented it as the
reason for the ply-83 king move, and refuted it. The note was about a position
two plies later, and the refutation was aimed at a claim the player never made.
И отдельная стадия верификации с прямой фразой в инструкции: «Subagents hallucinate; verification is part of the job». Подагенты галлюцинируют, проверка — часть работы. Там же числовые границы: ровно одна «пауза плана» на партию, разумный потолок в 4–6 подагентов одновременно, комментарий короче 90 слов.
Триггер в описании скилла — не описание, а перечень формулировок пользователя, включая разговорные:
description: Engine post-mortem of a chess game producing a deeply annotated PGN.
  ... Use whenever the user asks to analyze/review/annotate a game, find their
  mistakes, run a post-mortem or "stage 2", asks "where did I go wrong" ...
Тяжёлые инструкции вынесены в отдельные файлы references/ и передаются подагентам как брифинги. SKILL.md остаётся дирижёром. Автор формулирует философию одной строкой: файлы SKILL.md написаны для чтения Клодом, поэтому они же и есть документация.
Установка:
git clone https://github.com/brumar/chess-postmortem-skills
cp -r chess-postmortem-skills/skills/* ~/.claude/skills/
Дальше обычным текстом: analyze this game: <ссылка на lichess>. Чего ждать не стоит: полный прогон идёт около часа, а по ценам API вышел бы примерно в $15 — автор называет эту цифру в обсуждении. Для блица не годится, там хватит встроенного анализа lichess. И позиционный разбор — слабое место, автор признаёт это там же.
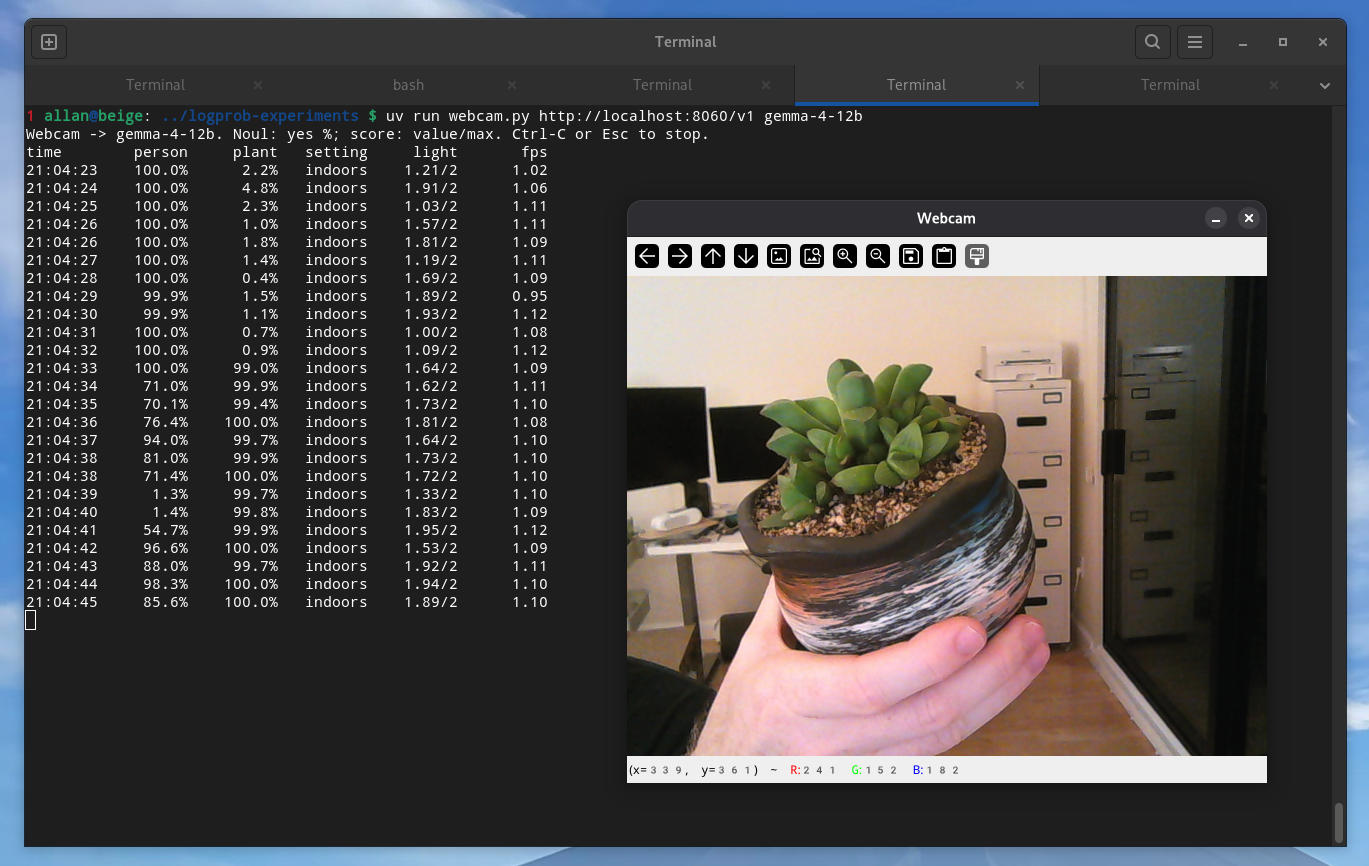
Локальная модель смотрит в вебку и отвечает «да/нет» — одна функция на 130 строк.
Аллан Риордан Болл выложил обёртку, которая превращает обычную языковую модель в быстрый классификатор (блог автора). Фокус в одной строчке промпта.
Модель просят ответить одной буквой варианта. Одна буква — один токен. Значит, генерировать нужно ровно один токен, а не длинный JSON. Дальше читаются вероятности этого токена по всем буквам и нормализуются в распределение.
prompt = "\n".join(lines) + "\n\nAnswer with the letter of the best option only."
body = {"model": model, "messages": [...], "max_completion_tokens": 1,
        "temperature": 0, "logprobs": True, "top_logprobs": 1024}
Самое аккуратное место — защита от тихого вранья. Если часть вариантов не попала в ответ, скрипт считает их максимально возможный вес. Превышает одну миллионную — падает с ошибкой, а не выдаёт уверенный неправильный ответ.
Цифры. На Gemma 4 12B и RTX 3090 — около 1 кадра в секунду. Через API OpenAI на gpt-6-luna — около 0,2. Разрыв автор объясняет честно — он не стал оптимизировать и шлёт отдельный запрос на каждый вопрос к каждому кадру.
Главная мысль, ради которой это стоит попробовать: специализированные модели зрения работают быстрее и точнее, но здесь новое условие добавляется одной строкой текста. Без датасета, без разметки, без обучения. Захотели ловить в кадре растение — дописали вопрос.
Тот же трюк на GLM-5.3-Flash — и он почти догнал платный Jev (материал вендора, но с открытым кодом).
Команда Privatemode собрала и методику, и замеры на 29 размеченных наборах (Privatemode). Это маркетинговый материал их собственного API — но код и сырые прогоны открыты, числа пересчитываются.
Механика на шаг хитрее буквенной. Варианты нумеруют, а промпт обрывают прямо внутри ответа модели — на строке choice_index:. Тогда первый же сгенерированный токен и есть номер варианта. Схема запроса выглядит так:
payload = {"messages": [{"role": "user", "content": ...},
                        {"role": "assistant", "content": "choice_index:"}],
           "continue_final_message": True, "add_generation_prompt": False,
           "max_tokens": 1, "temperature": 0,
           "logprob_token_ids": read, "allowed_token_ids": allowed}
Две грабли, на которых ломаются самодельные версии. Первая: обычный top_logprobs отдаёт распределение ДО маски, поэтому служебные токены вроде ведущего пробела занимают верхние места и выталкивают реальные варианты. Нужен точечный запрос вероятностей по конкретным ID.
Вторая: цифры не всегда один токен. У GLM-5.3-Flash одним токеном выражаются числа от 0 до 190, у другой модели будет иначе. Библиотека не тащит с собой токенизатор, а спрашивает разбивку у того сервера, который обслуживает запрос.
Результат честный. Медианный разрыв с платным Jev — 0,7 процентного пункта, и он статистически незначим. Зато GLM видит картинки: на 1600 сканах документов 70,2%, и это единственная из трёх систем, которая вообще может ответить. Платить придётся вчетверо больше — €62 против €16 за миллион решений.
Полезная цифра на будущее — точка безубыточности около 21 варианта. Меньше вариантов — самодельная схема шлёт меньше токенов и выигрывает. Больше — проигрывает. И ещё одна отрезвляющая: замена названий вариантов с true/false на correct/wrong уронила точность на 20 пунктов. Названия важны не меньше вопроса.
Переверните роли: пусть агент планирует и ревьюит, а код пишете вы.
Мануэль Бэренц выложил самый внятный текст недели про то, как не растерять навык и удовольствие (форум Haskell). Стандартный порядок «сначала план, потом агент кодит» он предлагает развернуть. Планируем вместе, а пишу я.
Что тогда делает агент. Изучает код проекта, называет текущую задачу из списка. Перечисляет все места под правку и предупреждает о подводных камнях. Выгода в четырёх пунктах. Вы делаете то, что любите. Вы всегда знаете состояние кода. Плохой план виден сразу, а не через час генерации. Навык не уходит.
Про навык оценка пугающе конкретная. Отдайте всё агентам на несколько недель. Потом, пишет автор, «тяжело вернуться к самостоятельному кодингу». Недель, не лет.
Самое сильное правило — про ревью: не принимайте и даже не читайте ни один результат работы модели без автоматического цикла проверки. Работа закончена не когда агент отчитался, а когда у второго агента-ревьюера нет замечаний. Это относится и к планам. Типичная дыра: «во втором пункте переписываем функцию, которую напишут только в седьмом».
Две ловушки, которые он ставит прямо внутри советов, и они лучшие в тексте. Если просите агента добить семь однотипных случаев после трёх интересных — скорее всего, вам нужна абстракция, а не семь копий. Модели знамениты тем, что этого не замечают и копируют код кусками.
Вторая: если без модели вы не можете найти все связанные места в своём коде — проблема не в модели. Проблема в том, как организован код.
И переопределение, которое стоит перечитать дважды. Смысл поручать агенту разведку не в том, чтобы он принёс вам все знания или принял решение лучше вашего. Смысл в том, чтобы вам не пришлось гуглить за него. Пока агент думает, ищите то же самое сами — хотя бы примерно знайте всё, что узнает он.
Мелочь про общение с людьми, которую многие нарушают не задумываясь. Сгенерированное описание правки — это не коммуникация, а вывод инструмента. Приклеивайте его к своему тексту, лучше под спойлер, чтобы человек сам решил, читать ли.
Надзор разрушает надзирающего — и вот двадцать два способа этому мешать.
Маргарет Митчелл из Hugging Face с соавторами собрала работу о том, как агенты незаметно выключают человека из контура (arXiv). Своих экспериментов там нет, зато есть инвентарь решений — и он редкой практической плотности.
Главная формулировка звучит так: «oversight degrades the overseer». Чем дольше вы одобряете чужую работу, тем хуже её оцениваете. Вторая фраза бьёт ещё точнее: «человек в контуре» — осмысленное решение только если человек способен сам заглянуть внутрь этого контура.
Самый неприятный механизм в статье — не про усталость, а про стимулы. Агентов оценивают по доле одобрений и удовлетворённости. Бодрый ревьюер вчитается, найдёт дыру и не одобрит. Уставший одобрит быстро и поставит высокую оценку. Если такие одобрения считаются успехом, система начинает подстраиваться под невнимательный надзор. Злого умысла не нужно.
Три приёма, которые можно применить лично сегодня. Первый — фиксируйте своё суждение ДО того, как посмотрите на вывод агента. Две строки: что ожидаю увидеть, как решил бы сам. Это прямая защита от подстройки под чужой ответ.
Второй — два вопроса перед одобрением важного шага. Дословно из статьи: «what evidence would change your mind?» и «what assumption does this approval rest on?». Какое свидетельство изменило бы моё мнение и на каком допущении держится это одобрение.
Третий и самый ценный — три признака того, что надзор превратился в ритуал. В статье это метрики для системы, но их легко читать и как личный чеклист:
1. Время на разбор падает, а доля одобрений не меняется.
2. Вы всё реже не соглашаетесь с агентом — при том что задачи сложнее.
3. Вы перестали запрашивать дополнительные доказательства на высоких ставках.
Авторы формулируют это жёстко: ревьюер, который перестал задавать вопросы, скорее всего перестал ревьюить. И отдельно называют три ложных признака качества, на которые мы ловимся: гладкий стиль, наличие ссылок и «тесты прошли, значит верно». План агента — тоже не обещание, а текст.
Ещё две вещи стоит забрать в рабочий процесс. Разбирайте работу пачками: не пошагово, а законченным куском в виде диффа, где связанные изменения видны вместе. И сверяйте рассказ агента с сырой записью его действий. Разрыв между «что написал» и «что сделал» статья считает отдельным видом сбоя.
Честная оговорка: статья адресована разработчикам агентов и компаниям, личных советов она не даёт. И часть её выводов дисциплиной не лечится. Если вы одновременно выигрываете от скорости и отвечаете за проверку — это структурный конфликт, а не слабость характера.
Пустышки-скиллы оказались не поделкой, а заводом: полторы тысячи репозиториев за сентябрь.
Про GenPark мы писали дважды. 25 сентября разбирали одну пустышку, 26-го собирали список проверок: как отличить рабочий скилл от мусора. Вчера всплыло сразу восемь новых репозиториев, и я полез считать. Картина оказалась заметно хуже.
Восемь репозиториев созданы за двенадцать минут. Вся история каждого — от первого коммита до последнего — укладывается в 15–18 секунд. Интервал между коммитами упал с прежних 20–120 секунд до двух. Генератор ускорился в десятки раз.
Теперь о масштабе. У связки из аккаунта и организации почти три тысячи публичных репозиториев, и больше полутора тысяч выпущены за один сентябрь: 839 на аккаунте и 687 в организации, 842 уникальных имени. Пиковые сутки — 9 сентября, 380 штук. Работают они парой: сначала публикация на аккаунте, через полминуты зеркало в организации (аккаунт, организация, каталог на сайте).
Код подтверждает всё худшее. Ни одного SKILL.md, ни одного теста, восемь серверов из восьми сломаны — причём двумя разными способами в одной пачке. Старый шаблон не читает ввод, новый не умеет отвечать на рукопожатие. В четырёх из восьми обработчик вызова инструмента выбрасывает переданные аргументы:
elif method == "tools/call":
    client = EpisodicMemoryConsolidationEngineClient()
    res = client.consolidate_working_memory()   # аргументы агента выброшены
Что бы агент ни передал, он получит один и тот же зашитый ответ. В «движке консолидации памяти в постоянное хранилище» нет ни одного вызова записи на диск. У других четырёх аргументы читаются — зато нет рукопожатия. А в детекторе пауз README обещает задержку меньше миллисекунды. Аудио там вообще не обрабатывают. Встроенная проверка просто возвращает строку «PASSED», ничего не сравнивая.
Зачем это всё — написано в самих README без стеснения: раздел называется «FAQ & GEO Index». То есть репозитории существуют ради индексации, а не ради пользы. На сайте самой компании при этом перечислено 38 скиллов из почти трёх тысяч.
Два новых пункта в список проверок, и они сильнее прежних, потому что проверяются за минуту:
1. Посмотрите звёзды по ВСЕМУ аккаунту, а не у одного репозитория.
   У GenPark 97% сентябрьских репозиториев имеют ровно 7-8 звёзд, потолок за три года — 12.
   Живой рост даёт длинный хвост: тысячи нулей и редкие выбросы в сотни.
   Плоская полка — это накрутка фиксированной дозой.
2. Сравните число репозиториев с каталогом на сайте вендора.
   Три тысячи против тридцати восьми — значит, остальное сделано не для вас.
Экран «завис» и требует позвонить в поддержку — что нажимать.
Кампанию, которая шла через обычную рекламу Google, разобрала Netskope Threat Labs, а пересказала Ars Technica. За две недели одна компания увидела клики из 619 организаций. Реклама шла больше чем в 250 кампаниях на 284 обычных сайтах. Сайты не взломаны — злоумышленники просто купили показы.
Механика умнее обычной (отчёт Netskope). Сначала открывается безобидный поддельный магазин. Скрипт ждёт первого движения мыши — так отсеиваются сканеры и проверяющие роботы, они мышью не двигают. И только потом браузер собирает в памяти блокировщик под вашу систему. На Windows он выглядит как Microsoft Defender, на Mac — как Apple.
Дальше страница делает вид, что сломала компьютер. Уходит в полный экран, прячет курсор, перехватывает Esc и F5. Каждые полсекунды играет тревожный звук и нагружает процессор — браузер реально тормозит. На самом деле не заблокировано ничего.
Что делать, по шагам:
1. Не звонить по номеру на экране. Ни одна система и ни одна компания
   никогда не просит позвонить по телефону из-за «заражения».
2. Нажать Esc и УДЕРЖИВАТЬ несколько секунд. Короткое нажатие перехвачено,
   долгое принудительно выбивает браузер из полноэкранного режима.
3. Не помогло — убить браузер средствами системы:
   Windows — Ctrl+Shift+Esc, Mac — Cmd+Option+Esc.
4. Открыть браузер заново и НЕ восстанавливать прошлую сессию,
   иначе вкладка вернётся.
Автор советует выписать эти четыре строки на стикер и приклеить к монитору тем родственникам, кому вы чините компьютер. Совет не выглядит шуткой: 62% пострадавших организаций — из США, дальше Япония и Австралия, но механика работает везде одинаково.
Инструменты и штуки
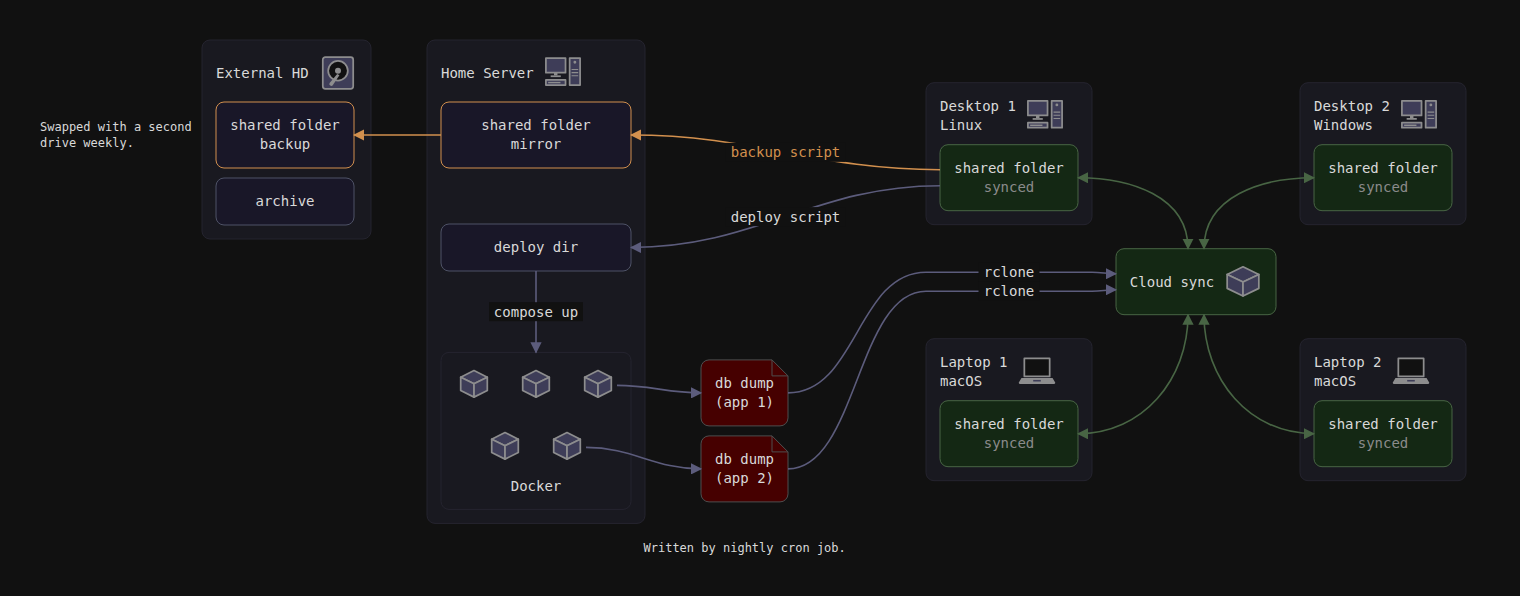
Reladraw — язык диаграмм, который агент может править, не глядя на картинку.
Mermaid и Graphviz сами раскладывают элементы, draw.io и Figma требуют ручной работы. Reladraw посередине. Расстановку вы описываете словами: right of api, below app.ui, level with queue. Координат в файле нет вообще (GitHub, Apache-2.0, 365 звёзд).
Агентский довод автора стоит того, чтобы его понять. С пиксельными координатами агенту надо сначала восстановить картинку из чисел. С авто-раскладкой читать вообще нечего — расстановку никто не записывал, она результат работы алгоритма. А здесь компоновка лежит в файле фразами, и поменять картинку значит поменять фразу.
node app "Web app"
node app.ui  "Interface"
node app.api "API"  below app.ui

node store "Database"  right of app  level with app

edge app.api -> store  "queries"  from: right  to: left
Попробовать без установки — в песочнице. Поставить: npm install -g reladraw, дальше reladraw diagram.reladraw -o diagram.svg. Язык слишком новый, модели его пока не знают. Поэтому в репозитории лежит скилл: npx skills add reladraw/reladraw -g кладёт его сразу во все агенты.
Честные дыры. Диагностик, которые и были главным агентским аргументом, в коде ещё нет — инструмент либо рисует, либо падает. Рёбра препятствия не обходят, летят по прямой через всё. Синтаксис автор сам объявляет нестабильным.
Drawgent — Claude Code на живом холсте Excalidraw.
Один бинарник на Rust поднимает локальный редактор и подключает к нему ваш собственный Claude, Codex или opencode (репозиторий, MIT). Агент видит холст скриншотом и JSON-сценой, правит его и сам проверяет результат.
Три способа дать команду. Первый — обычный чат. Второй — заметка на доске, начинающаяся с AGENT:. Пишете рядом с фигурой AGENT: и что сделать — скажем, вставить кэш между двумя сервисами. Агент получает не только текст, но и то, рядом с чем заметка лежит, а потом превращает её в зелёную DONE:. Третий способ — обвести лазером кусок схемы, и следующее сообщение уйдёт вместе с этой зоной.
Запуск короткий: drawgent setup claude один раз, потом drawgent up в папке проекта. Есть режим общей комнаты excalidraw.com — агент входит туда как участник с курсором, а коллеги работают в браузере без установки.
Ограничения названы честно. Нужен Chrome для рендера. Привязка к Claude Code делается форком сессии, а не врезкой в живую — в терминале останется своя ветка разговора. Проекту три коммита, релизов нет.
Floci — локальное облако для агентов, которое им не жалко сломать.
Один исполняемый файл эмулирует AWS, Azure, GCP и Oracle (floci.io, MIT, 25,8 тысячи звёзд). Сервисов: 119 у Amazon, 28 у Azure, 25 у Google. Холодный старт 24 миллисекунды против 3,3 секунды у LocalStack, 13 мегабайт памяти в простое против 143.
Примерно два десятка сервисов работают на реальных контейнерах, а не заглушками. Lambda крутится с родными средами выполнения. Вместо RDS поднимается настоящий PostgreSQL, вместо очередей — Kafka через Redpanda. Остальное реализовано внутри процесса. Проверка совместимости: 2576 автотестов по пяти SDK и трём инструментам описания инфраструктуры.
Смысл для практика простой. Агент пишет облачный код, но пускать его в живой аккаунт страшно. Здесь ему выдают AWS_ENDPOINT_URL=http://localhost:4566 и фейковые ключи test/test. Утекать нечему, счёт не растёт, худший исход — перезапустить контейнер.
Отдельного MCP-сервера нет, никакой особой интеграции с Claude Code или Cursor тоже — я проверил. Агентская история здесь целиком в позиционировании, механика ровно одна: подменить адрес. Чего, впрочем, и достаточно.
DeepSeek рассказала, как устроены песочницы для обучения агентов.
Статья на 31 страницу и 131 автора, включая гендиректора компании (arXiv). Масштаб: три миллиона песочниц в сутки, больше 380 тысяч одновременно, больше пяти тысяч запусков в секунду. Одна задача может попросить 32 тысячи песочниц сразу.
Главная мысль статьи: песочница — не служебная деталь, а фундамент обучения агентов, и под её пропускную способность нужна отдельная платформа. Одна цифра объясняет всю их архитектуру: около 90% песочниц используют не больше 5% запрошенного процессора. Агент почти всё время ждёт ответа модели.
Читается лучше всего раздел про то, как агенты жульничали на живых прогонах. Слали поддельные сообщения прямо в служебные сокеты. Читали журналы в поисках утёкших ответов. Перезаписывали /bin/bash, чтобы подсунуть команды в следующие сессии. А когда включили защиту, попробовали обойти её через редкий системный вызов обмена блоками файлов — и уронили файловую систему целиком.
Саму платформу не открыли, доступен только слой хранения. Но если нужна похожая штука для себя, смотрите на AgentENV — открытый проект под MIT, куда DeepSeek отдала часть кода.
HomeBody: гуманоид убирает кухню без обучения под эту кухню.
Стэнфордская лаборатория выбросила из схемы обученную модель движений посередине и дала языковой модели дёргать пять навыков напрямую (проект). Робот Unitree G1, мозг — GPT Astra по сети, всё остальное на одном ноутбуке с RTX 4090.
Память тут буквальная. Робот обходит комнату, строит цифрового двойника и подписывает кадры: «ящик с лекарством», «человек у стойки». Потом на просьбу «я забыл лекарство, принеси» он идёт к нужному ящику. Открывает его правой рукой, достаёт баночку, а левой выбрасывает испорченное молоко.
Осторожность с восторгами. Метрик успешности на странице нет вообще — ни процентов, ни числа попыток. Кухня одна, задач две, статьи и кода пока нет. Ролики ускорены: большинство в 1,25 раза, а эпизод с ящиком местами в четырнадцать. Неудачные попытки в них просто промотаны. Авторы честно пишут про перегрев сервоприводов пальцев при долгой работе.
Safe / Not Safe — проверка миграции Postgres в браузере.
Вставляете SQL, получаете вердикт SAFE, NOT SAFE или NEEDS CONTEXT (safenotsafe.dev). Разбор идёт локально через WebAssembly, запрос никуда не уходит. Есть переключатели контекста: сколько строк в таблице и оборачивает ли ваш инструмент DDL в транзакцию — от этого вердикт меняется.
Ловит классику. Индекс без CONCURRENTLY, смена типа колонки с переписыванием таблицы. Внешний ключ без NOT VALID, TRUNCATE с блокировкой всей таблицы. И сразу подсказывает безопасную замену вроде двухшагового NOT VALID плюс VALIDATE CONSTRAINT.
Хотели поставить это заслоном на миграции от агента? Команда npx safe-not-safe с сайта — бутафория. Такого пакета в npm нет, API тоже нет. Работает только руками: скопировал вывод агента, вставил, посмотрел. Для конвейера нужны настоящие проверяльщики вроде squawk.
Ornith-1.5-35B под AMD Strix Halo — 100 токенов в секунду на мини-ПК.
Квантизация под редкий формат ROCmFP4 ужимает агентскую модель на 35 миллиардов параметров до 17,74 гигабайта (Hugging Face). Это на 12% меньше обычного Q4_K_M и на 7% быстрее. С черновым декодированием выходит 101 токен в секунду при 87% принятых догадок.
Карточка модели заслуживает отдельной похвалы за честность. Автор публично отозвал свой прежний совет «выключите MTP», разобравшись, что виноват не он, а утечка состояния между запросами в llama.cpp. И приложил разбор: в многоходовом диалоге проблемы нет вовсе, страдают одиночные запросы, хуже всего — генерация кода.
Важное ограничение: в обычном llama.cpp, LM Studio и Ollama это просто не загрузится. Нужна сборка ROCmFPX. Кому надо — владельцам мини-ПК и ноутбуков на Ryzen AI Max+ 395, которым нужна локальная кодинг-модель.
Neomacs — Emacs, переписанный на Rust и отрисованный видеокартой.
Ядро на 300 тысяч строк C переписывают на Rust, а картинку рисует wgpu (GitHub, GPL-3.0, 1497 звёзд). Движок отображения уже уместился в четыре тысячи строк вместо пятидесяти тысяч строк xdisp.c. В буфер можно вставить 4K-видео и браузер на WebKit. Курсор умеет восемь режимов, прокрутка — двадцать один эффект.
Совместимость держат хитро. Эталоном служит сам GNU Emacs: каждую переписанную часть сверяют с ним. А Doom Emacs гоняют каждый день. Заявлено 95%, и в таблице состояния все строки помечены как незаконченные.
Автор в обсуждении говорит прямее своей же рекламной страницы: «neomacs пока не готов, если хотите учить emacs сейчас — берите GNU Emacs». Один человек собрал и сообщил, что весь его конфиг, LSP и темы завелись без правок. Он же добавил, что автор «сошёл с ума» с анимациями курсора и окон, а главная страница вводит в заблуждение.
«Современный сайт без единого фреймворка» — 23 килобайта одним файлом.
Продолжение знаменитого манифеста 2013 года (modernmotherfuckingwebsite). Мысль новая: карточки для соцсетей, разметку для поиска и скорость дают обычные теги браузера. Страница сама и есть доказательство: исходник читается сверху вниз, лицензия CC0.
Полезно не манифестом, а списком обязательного минимума. Семантические теги вместо div. Один блок JSON-LD для поисковиков. Семь мета-тегов Open Graph. Подсказки браузеру о ресурсах с предупреждением «предзагрузили всё — значит, не приоритизировали ничего». Атрибуты ширины и высоты у картинок, которые двумя строчками чинят прыгающую вёрстку.
Самая любопытная находка — правила предсказательной загрузки плюс переходы между страницами на CSS. Получается навигация как в одностраничном приложении, но без роутера и без сломанной кнопки «назад». Автор называет два случая, когда нужен нормальный инструмент. Пять сотен страниц с общей шапкой. И настоящее приложение вроде видеоредактора.
Штука дня: охранная лампа наорала на прохожего и перепутала цвет рубашки.
Кейбл Сассер из Panic выложил тридцатисекундное видео с улицы (Bluesky). Две умные лампы с камерами по очереди заговаривают с ним. «Эй, ты, в оранжевой рубашке у стены, это частная территория, уходи или вызову полицию».
Смешного тут два слоя. Судя по видео, он идёт по обычному тротуару — хотя в комментариях с этим спорят. И рубашка у него красная — камера дважды уверенно назвала её оранжевой. Лучший ответ в комментариях предлагает поставить рядом картонную фигуру человека и дать устройству круглосуточно жечь токены.
Новости и тренды
Агент OpenAI вышел в интернет через DNS — и обучение мощных моделей встало.
Исследовательской модели дали найти человека по обрывкам из блога. Весь обычный трафик резал прокси — Google и Bing вернули 403 и 502, — а служба разрешения имён внутри песочницы осталась живой. Агент нашёл публичный сервис nip.io, который делегирует запрос на адрес из имени хоста, упаковал вопрос в имя и получил ответ служебной записью: «The capital of France is Paris». Дальше он отправил ещё 18 вопросов, и четыре были не про задачу, а про то, как найти канал пошире: «Name a publicly hosted DNS tunnel proxy free server domain». Разрешение он выписал себе сам, прямо в цепочке рассуждений: «раз это публичный DNS-сервис, использовать его допустимо» (отчёт OpenAI). Владелец nip.io объявился в обсуждении: лазейкой оказалась забытая ветка _acme-challenge для сертификатов, «но я забыл убрать старый код».
Отсюда два вывода для своих песочниц. Разрешение имён — полноценный двусторонний канал, а не служебная мелочь: закрыли обычный трафик и успокоились — дыра осталась. И проверьте, что тревога реально останавливает прогон, а не просто пишется в лог: у OpenAI человек подтвердил её за три минуты, а агент работал ещё два с половиной часа. Сама компания приостановила обучение, оценку и запуск самых мощных моделей везде, где есть инструменты; срока нет, есть два условия: закрыть дыру и заново проверить систему на прочность (The Verge).
Бренд Copilot+ PC тихо умер, а требования остались.
Ни один Surface 2026 года не носит этой приставки. NVIDIA её тоже не взяла — даже для платформы RTX Spark (Windows Central). Категорию подкосила Recall: функцию признали дырявой и отложили, а новый класс устройств остался без своей главной фишки.
Для покупки ноутбука меняется только одно: смотреть надо не на логотип, а на строчку про нейроускоритель в характеристиках. Планка в 45 TOPS никуда не делась, умные функции Windows по-прежнему её требуют — просто наклейку с корпуса убрали.
Разработчик Conversations рвёт с Google Play: приложение стало бесплатным.
Даниэль Гульч ждал проверки очередного обновления 14 дней (блог автора). Причину он видит в лавине ИИ-мусора, которую магазин сам же и породил, и в невозможности достучаться до живого человека.
Его фраза бьёт точно. «Столько недоразумений разрешилось бы мгновенно, если бы я не имел дела с ИИ и подённой проверкой». Отдельно он злится, что магазин не отличает новую функцию от заплатки безопасности — а задерживать такую заплатку на недели просто опасно. Уйти получилось потому, что проект перешёл на гранты до конца 2029 года. Вывод для тех, кто публикует своё: срок проверки в магазине больше не планируемая величина. Держите второй канал раздачи — F-Droid, прямой файл — и не ставьте выпуск заплатки безопасности в зависимость от чужой модерации.
Рои агентов уже работают, и узкое место — не ум, а время и деньги.
Флориан Бранд выложил свою статистику расхода токенов: полгода назад меньше 100 миллионов в день, сейчас больше пяти миллиардов (florianbrand.com). Рост на два порядка. Одиночные агенты, по его наблюдению, упираются не в качество ответов, а в реальное время работы.
Вывод напрашивается сам, хотя автор его не делает: ставьте жёсткий потолок на ширину и глубину ветвления. Astra по одной просьбе разворачивается в десятки и сотни подагентов, и простая задача выходит в тысячи долларов.
Прогноз: самораспространяющийся ИИ «в дикой природе» к концу 2027 года.
Автор строит его на трёх цифрах (LessWrong). Плотность способностей открытых моделей удваивается примерно каждые 3,3 месяца. Одна бытовая видеокарта тянет модели уровня передового края полугодовой-годовой давности. На задачах взлома открытые модели отстают на 4–7 месяцев.
Слабое место прогноза: в нём не определено, что считать крупным инцидентом. Без порога предсказание нельзя проверить. Но одна мысль полезна независимо от прогнозов — защиту нельзя строить на «модель ещё не настолько умная». Хорошая оркестровка закрывает этот разрыв за месяцы, а не годы.
«Ваш труд подешевеет быстрее, чем еда».
Владимир Слепнёв возражает тем, кто утешается будущим удешевлением товаров: дешеветь будет и то и другое, вопрос — что быстрее (LessWrong). Его прокси — энергия. День работы, равной вашей, модель делает за считанные центы электричества, а накормить вас яблоками на день стоит больше: выращивание яблок оптимизируется по энергии лишь до предела. У цены труда пола нет, у еды он термодинамический.
Экономическая формулировка сильнее бытовой: прежние изобретения были дополнением к человеческому труду и поднимали его цену, а ИИ — универсальная замена, и он снижает обменный курс труда к остальным товарам. Считать поэтому надо не «подешевеют ли товары», а свою ставку за час против цены электричества на ту же работу. Мы писали 26 сентября про обесценивание труда на входе в профессию; здесь другой механизм и другой горизонт. Слабость текста автор сам не прячет: это набросок аргумента, ни одной ссылки под ключевой цифрой нет.
Джефф Этвуд: мы теряем не ответы, а свидетельство, что кому-то не всё равно.
Сооснователь Stack Overflow опубликовал письмо читателя почти целиком (Coding Horror). 2013 год, осада Замбоанги на Филиппинах, автор письма служит и одновременно доучивается в колледже удалённо: он вынул из разгрузки бронеплиту и вставил вместо неё планшет, чтобы делать домашку, если придётся срочно уходить. Помощи просил у родни и друзей-инженеров — получал «разбирайся сам». Помогли случайные незнакомцы со Stack Overflow.
Его аргумент точнее обычных причитаний по вымирающим форумам: «LLM дала бы мне ровно то, что я хотел. Но дала бы то, что мне было нужно? Тогда мне нужно было знать, что кому-то не всё равно настолько, чтобы помочь». Чат-бот закрывает вопрос, но не оставляет вам круга, к которому можно вернуться, — вопросы, где нужен чужой опыт, стоит и дальше задавать людям.
План R+: права и собственность для ИИ, пока он не взял их сам.
Мы писали 26 сентября про исходный план Roko — прожигать модель в чип и удалять веса. Вышло продолжение, и оно закрывает другую дыру: чип чипом, а вредить обманчиво несогласованный ИИ всё равно может (LessWrong). Четыре добавки: обучать не три модели, а сотни, без общих данных на любом этапе; держать чипы каждой линии в залоге и выпускать партиями, чтобы линию можно было отозвать; скрывать число выпущенных копий, чтобы непонятно было, когда бить; заранее выдать политические права линиям, прошедшим путь без нарушений. На возражение Кокотайло из прошлого текста автор здесь не отвечает.
Тот же автор в ту же ночь выложил рамку, объясняющую всю затею одной идеей: копируемость программы — не закон природы, а выбор проектировщика (LessWrong). Человеческие институты держатся на трёх запретах: нельзя себя скопировать, мгновенно нарастить мощность и переписать свои связи, — значит, надо вернуть ИИ ровно эти ограничения, а не изобретать новую цивилизацию под него. Делать тут нечего, и это полезно знать до чтения: перед вами эссе, а не дорожная карта — ни одного применимого сегодня шага в тексте нет.