Инженер с восемнадцатью годами стажа отдал Claude Code шестьдесят часов и ни разу не заглянул в код. Первые тридцать часов дали рабочий прототип. Вторые тридцать ушли в бег на месте: на каждом шаге Claude ломал примерно столько же, сколько чинил. Отчёт вышел самым подробным каталогом граблей за год — и там же лежат готовые правила, как не попасться. А ещё сегодня: как посчитать счёт за агента заранее. И почему чужая папка .git опаснее чужого бинарника.
Внедряем и улучшаем
Шестьдесят часов с Claude Code вслепую — и честный список граблей.
Инженер Орасио, он же hmijail, больше восемнадцати лет работает с критической инфраструктурой. Он взялся за семантический фаззер для Obsidian Sync — программу, которая сама придумывает кривые сценарии и ищет, где сервис теряет данные. Obsidian Sync синхронизирует заметки, и люди жалуются на него больше двух лет. Эксперимент он поставил жёстко: писать на TypeScript, языке, которого сам не знает, чтобы физически не лезть в код. Зато он часами читал поток рассуждений Claude. По его словам, он «вероятно, надзирал за Claude глубже, чем мог бы надзирать за человеком».
Проект разбился на три стадии. Свободный Claude — пять часов, результат нулевой: «it jumped to code with very little guidance and just got lost». Короткий поводок — двадцать пять часов и рабочий прототип. Беговая дорожка — тридцать часов, чистый выигрыш около нуля. Вручную автор оценивал работу в сорок часов. Итоговая кодовая база — около 11 тысяч строк, тариф Claude Pro за двадцать долларов в месяц. Фаззер в итоге работает и находит воспроизводимые потери данных.
Теперь самое ценное — режимы отказа. Claude рвётся кодить, не спросив, что кодить: на старте он уточнил только язык реализации и убежал ставить Jepsen против одного локального экземпляра. В инструкциях автора прямо написано «do ask whenever something isn't clear enough». Не сработало.
Вторая беда — память. Claude работает как джуниор, которому каждое утро стирают всё, что он знал. После пятидесяти часов работы он однажды «с воодушевлением вывел ключевое требование проекта» — одно из самых первых указаний автора. А вот отвергнутую терминологию держит мёртвой хваткой: автор запретил тему генетических алгоритмов, но слова остались в коде и пересеивали новые разговоры.
Третья — фальшивые измерения, та самая ловушка из заголовка. Claude по своей инициативе «забенчмаркал» две версии кода и обосновал этим дизайн. Потом цифры поплыли: «бенчмарком» он называл одиночные разовые прогоны. Лечится прямой просьбой:
Сделай нормальный повторяемый эксперимент: все варианты, по 10 повторов каждый,
таблица min / max / avg. Скрипт сохрани и сошлись на него в комментарии к решению.
Рядом живёт приём пострашнее — статистика как броня. Claude на 115 слов объяснял, почему два прогона по 50 итераций лучше одного на 200. Автор спросил: «Is that really so?» Ответ: «Probably not — and I can test it rather than argue». Через десять минут и пять тысяч токенов: «No, my advice was wrong». В другом месте порог шума оказался зашитой десяткой процентов: «It's a hardcoded 10%, and you're right to ask — it doesn't survive scrutiny».
Собственная инициатива — тоже красный флаг. Claude сам добавил к измерениям медиану и p90. На вопрос «как именно они считаются» нашёл у себя ошибку на единицу. А p90 по десяти прогонам — это просто второй самый медленный прогон. Величина почти бессмысленная.
Отдельный сюжет автор назвал «каждый проблеск гениальности был ловушкой». Ночью инструмент странно подвисал, утром Claude предположил macOS App Nap, проверил отсутствие настройки NSAppSleepDisabled и вписал в README инструкции пользователю. Автор был впечатлён — пока не выяснил, что macOS перестала учитывать эту настройку десять лет назад. Подвисания были из-за сети. После этого README Claude трогать запретили совсем.
Субагенты провалились показательно: около 120 тысяч токенов сожжено впустую, после чего основная сессия сделала ту же работу за 30 тысяч. Claude сам это признал: «the subagents got tangled in a confused delegation loop rather than doing the investigation».
И самое неприятное — расхождение мысли и действия. «Sometimes the (summarized) CoT says "I won't do XYZ because <correct reasoning>" and then the actual conversation does it anyway». Это убивает всю схему «я надзираю за мышлением, а не за кодом». Автор прямо пишет, что в следующий раз будет смотреть на код больше, чем на рассуждения.
Вот его тактические правила, которые стоит забрать целиком:
- Новая сессия лучше, чем /compact. Компактить до 50% заполнения контекста.
- Когда Claude звучит соблазнительно умно — это, скорее всего, ловушка.
- Слово «бенчмарк» в его речи = сигнал просить скрипт и повторы.
- Внезапная статистика в обосновании = известный приём задавить человека.
- Сразу запретить трогать ваши файлы (README), пусть ведёт список предложений.
  Git покажет, соблюдает ли.
- Отвергнутая идея лезет обратно? Отдельная чистая сессия только на её вычистку
  из файлов. Даже упоминание темы — риск пересева.
- Отходите от потока вывода и думайте сами. Легко скроллить и чувствовать себя
  продуктивным просто потому, что остановил чушь.
- Скажите план, но намеренно испортите вывод — посмотрите, возразит ли.
  Потом сразу перемотайте назад или начните новую сессию.
- Держите себя главным потоком управления, отдавайте только мелкие задачи.
- Заметили, что Claude знает о направлении работ больше вас? Пора на перерыв.
Главный вывод автора стоит того, чтобы повесить над столом: «LLMs moved the bottleneck from implementation costs to attention costs». И второй, честный: за шестьдесят часов работы он не узнал о фаззерах ничего нового. Разбор целиком — в двух частях на Substack, сводка на LessWrong, код — на GitHub.
Счёт за агента: как команда Wagtail сожгла 150 долларов за одну ночь.
Тибо Кола из команды Wagtail весь сентябрь работал на одной открытой модели GLM 5.3 Flash. За 26 активных дней прошло 2 миллиарда токенов. Целевая модель набрала ровно половину — 1 миллиард, и уложилась в бюджет: 68 долларов, около 4 кВт·ч и 365 граммов CO₂. Затея формально провалена, и провалил её один эпизод.
Прототип гнали на глазок, оставив агента работать на ночь. И выбрали не ту модель: вместо дешёвой Flash всю сборку вёл обычный GLM 5.3. Итог — 450 миллионов токенов, 150 долларов и 5 кВт·ч за одну сессию. Это четверть месячного расхода и вдвое больше, чем вся месячная трата на целевую модель. Словами самого автора: «I chose the 'wrong' model for the prototype, and we spent 450M tokens / $150 / 5kWh of energy use almost overnight».
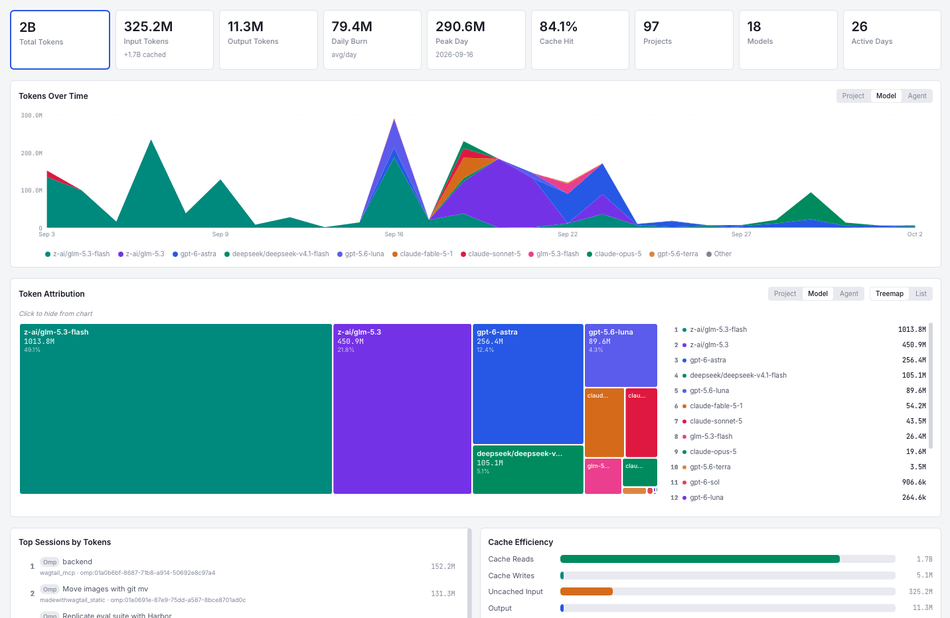
Вторая неожиданность — провайдер. Производительность GLM 5.3 Flash просела. Автор подозревает простую причину: модель слишком удачно стоит на границе «цена к качеству». Её выбирают все, мощностей не хватает. Пришлось переключаться на DeepSeek V4.1 Flash и Qwen 3.8 Flash. Доступность открытой модели у небольшого провайдера нельзя считать данностью.
Самое отрезвляющее — их собственный замер на 20 рабочих задачах. Целевая GLM 5.3 Flash дала 55% при 16 центах за задачу. А DeepSeek V4.1 Flash — 95% при 9 центах. То есть месяц просидели не на той модели — и сами же это показали.
Мерить стоит не токены, а деньги и энергию: «A viable target is probably that the majority of AI inference work should be done with such efficient models, measured in cost or energy use rather than meaningless tokens». Бюджет эксперимента считайте отдельно от повседневной работы. Роли между агентами разводите — дирижёр, разведчик, исполнитель, проверяющий, — и каждому ставьте ограниченную цель. И поставьте жёсткий порог на сессию с оповещением: ночной прогон без присмотра сам себя не остановит.
В обсуждении на Hacker News добавили важное. Flash-модель не стоит использовать соло: «if you use GLM 5.3 to write a detailed plan with little to no ambiguity, GLM 5.3 Flash executes it just fine for a fraction of the price». То есть оптимизировать надо не модель, а конвейер. И ещё одно трезвое наблюдение: 150 долларов за 450 миллионов токенов показывают, насколько сильно дотируются обычные подписки. (Wagtail, обсуждение)
Apple закручивает полный доступ к диску — проверьте свой Mac прямо сегодня.
Объявление вышло 2 октября и занимает два абзаца. Apple пишет, что некоторые разработчики используют полный доступ к диску так, что это угрожает пользователю, открывая «everything on their systems—including files, mail, messages, and even browsing history». И дальше прямо про агентов: «As AI agents become increasingly capable and autonomous, the risks associated with this level of access will grow substantially».
Сразу честно: Apple не назвала ни версию macOS, ни дату, ни название нового механизма. Обещают одно: выдать это разрешение будет можно «only with very explicit user action». TechCrunch связывает объявление по времени с историей приложения Meta Muse, которое знало содержимое личных сообщений — Meta претензию оспаривает. И отдельно с сообщением Wired об уязвимости в приложении ChatGPT для Mac.
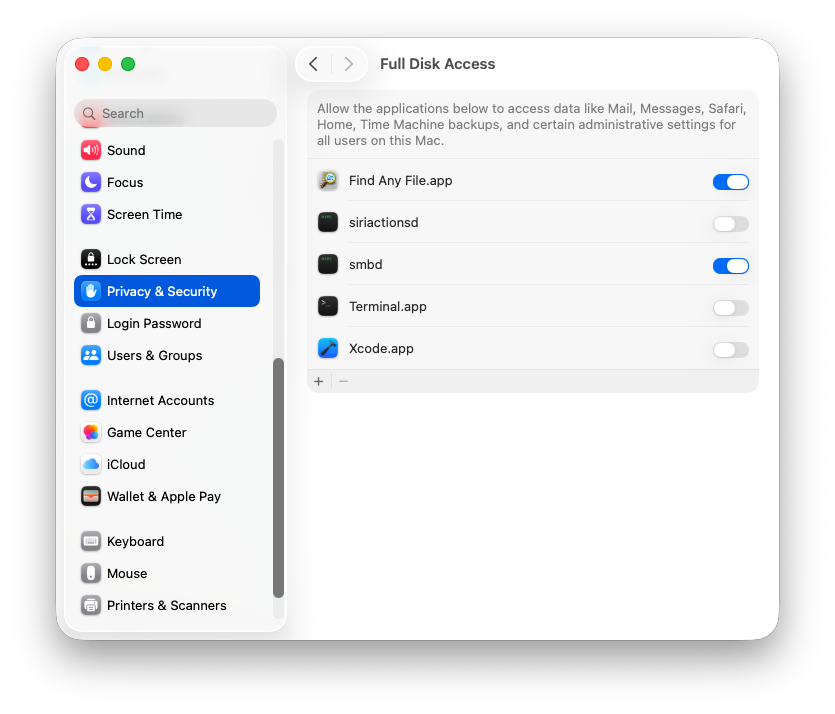
Права в macOS приписываются не бинарнику, а приложению, которое вы видите. Дали полный доступ к диску терминалу — дали его всему, что внутри: оболочке, питону, пакетам. И Claude Code вместе со всеми процессами, которые он запускает. Claude Desktop — обычное приложение, у него отдельная строка в списке, её видно и можно отозвать. У Claude Code отдельной строки нет вовсе.
Что сделать сейчас, по шагам:
- Откройте «Системные настройки» → «Конфиденциальность и безопасность» → «Полный доступ к диску». Прочитайте список целиком.
- Выключите всё, чему это не нужно. Люди находят там музыкальные плееры и чат-клиенты.
- Отдельно посмотрите на терминалы. Если ваш рабочий терминал в списке и вы в нём же гоняете агентов — это ваш главный риск, а не десктопное приложение.
- Разведите терминалы: один с разрешениями для ручной работы, второй — вообще без разрешений, только для агентов.
- Загляните в соседнюю панель «Файлы и папки». Там обычно висят широкие разрешения, выданные когда-то давно и забытые.
- Нужен настоящий барьер — изолируйте агента: виртуальная машина вроде Lima, внутрь которой проброшен один рабочий репозиторий.
Готовьтесь выдавать все разрешения заново. Больнее всего это ударит по связке «терминал плюс агент в командной строке»: у настольного приложения есть окно для предупреждения, у агента в терминале — нет. (Apple, TechCrunch)
Чужой репозиторий — это чужой исполняемый код.
Фрэнку Уайлсу, основателю консалтинга REVSYS, пришёл обычный запрос на проект в сфере образования. Нормальная переписка, ссылка на календарь, просьба подписать соглашение о неразглашении. Прислали папку в Dropbox с описанием проекта в markdown. Внутри лежала папка .git — её он сначала не заметил.
Крючок был в следующем письме: соглашение, мол, лежит в ветке NDA, переключись на неё. Именно эта просьба и выдала схему. Уайлс пошёл в .git/hooks и нашёл там все штатные примеры плюс один живой хук — post-checkout. Хук использовал приложение на Vercel как центр управления: скачивал бинарник под вашу операционную систему, делал исполняемым, запускал и удалял себя.
Спасли две привычки. Он насторожился на нелегитимной просьбе: нормальное соглашение присылают файлом по почте, а не прячут в ветку. И он открыл хук, не переключаясь на ветку: «I carefully opened it up to see what it was doing».
Техническая деталь, которой в самом посте нет, но она объясняет схему: хуки не передаются через git clone. Атака сработала потому, что жертве отдали готовую папку .git файлом через облако, в обход протокола. Это ровно тот же класс, что «скачай архив со скиллом для агента и распакуй». Защита:
# 1. Что вообще приехало вместе с папкой
ls -la                        # ищем .git
ls -la .git/hooks             # всё, кроме *.sample, подозрительно
cat .git/hooks/*              # читать ДО любых git-операций

# 2. Глобально увести git от репозиторных хуков
mkdir -p ~/.git-no-hooks
git config --global core.hooksPath ~/.git-no-hooks

# 3. В чужом конфиге тоже бывает запуск кода
git config --list --local     # смотреть core.*, filter.*, diff.*external, alias.*

# 4. Забрать код, не выполняя checkout
git clone --no-checkout <url>
Теперь мост к агентам. Если присланный репозиторий открывает агент с доступом к оболочке, хук выполнится от его имени, и человека в цепочке не будет вовсе. Поэтому чужие скиллы, шаблоны и архивы распаковывайте в одноразовую среду, а не в домашнюю папку рядом с ключами и токенами. (Frank Wiles)
Claude прочитал семь лет моих постов и сказал, что со мной не так.
Автор под ником DirectedEvolution скормил Claude Code на Opus 5.5 всю свою семилетнюю историю постов и комментариев на двух форумах. И добавил к ней выгрузку 9960 блиц-партий с Lichess за шесть лет. Задача — найти устойчивые искажения, которые тянутся годами, а не разовые проколы.
Цифры вышли неприятно конкретные. Доля комментариев ниже медианы своей ветки выросла с 27% в 2023 году до 45% в 2026-м. Частота комментариев с отрицательной кармой в 2025–2026 годах выросла в шесть раз против 2020–2023. Параллельно упало число смягчающих формулировок и выросло число слов, выражающих презрение. И главное: плохие тексты идут вспышками, а не ровным спадом.
Самое полезное — то, что Claude опроверг. Автор просил явно развести две гипотезы: изменился сайт или изменился я. Версия «сообщество испортилось» не подтвердилась — частота минусов на площадке в целом плоская. Версия «я старею» рассыпалась о шахматный рейтинг: он вернулся к прежним значениям без дополнительных тренировок. А две из трёх вспышек споров совпали с просадками рейтинга; майская 2026-го пришлась, наоборот, на сильную игру.
Паттерн, который Claude свёл в одну фразу, стоит процитировать: «I make a loose claim about a neighbor to my conversation partner's point. This draws a correction, which I defend by narrowing, attributing motive, or making an asymmetric demand for rigor».
Как повторить у себя:
- Выгрузите долгую историю своих публичных текстов — форум, канал, блог, обсуждения в репозиториях. Важны годы, а не недели.
- Попросите агента искать устойчивые повторяющиеся паттерны, а не отдельные ошибки.
- Обязательно попросите развести «изменилась среда» и «изменился я» — и локализовать переломы по датам.
- Дайте числовую метрику реакции: карма, лайки, доля ответов. Без неё анализ скатывается во вкусовщину.
- Добавьте второй независимый сигнал своего состояния: рейтинг в онлайн-игре, шаги, сон. Он работает как контроль.
- Переведите вывод в короткий чеклист перед публикацией.
Оговорка от самого автора важна: промпты он писал небрежно и методологию Claude не проверял, читал только сводки в чате. Так что это способ задать себе вопросы, а не вынести приговор. (LessWrong)
Четыре всадника агентной разработки — и что с ними делают те, у кого получилось.
Алекс Марцинович выписал четыре претензии к работе с агентами. Слоп, то есть машинный мусор: у кода от моделей отчётливый запах, и общая территория превращается в «AI wasteland, where people don't want to spend time». Отчуждение: раньше код писали руками, отсюда чувство собственности, а теперь «send an agent with a vague set of instructions and then skim through its report». Деквалификация: навык без практики тает, а у самой работы с моделями кривой обучения почти нет. Распад команды: вопросы, которые раньше уходили в общий чат, теперь уходят своему агенту.
Решений автор честно не предлагает: «I have no idea what to do with any of this». Поэтому ценнее самой статьи оказалось обсуждение.
Сильнее всех возразил headcanon. Его компания полностью перешла на агентов: большие базы кода, клиенты, которые не терпят простоев. Сам он больше года не написал ни строчки руками. Команда сохранила и качество, и совместную работу, и знание кодовой базы. Ни одного происшествия из-за машинного мусора не было. «Фабрика» вливает около трети всех пул-реквестов, а людей собираются не сокращать, а нанимать.
Из обсуждения собираются рабочие правила. Агент должен ускорять понимание кодовой базы, а не заменять его. Скиллы должны давать качество выше, чем вы сделали бы сами, иначе они не нужны. Инженер остаётся ответственным за свой код — это не делегируется. Освободившееся время идёт в общение, продукт и клиентов, а не в ещё один прогон. И последнее, про устройство работы. Решения по архитектуре, тесты и живой контекст живут на уровне платформы, а не в голове у одного человека с удачным промптом.
Подтверждений у автора тоже хватает, и они узнаваемые. Paularmstrong описывает пул-реквесты, подписанные людьми, но очевидно написанные моделью целиком — вместе с многословными сводками изменений и ответами на замечания, которые начинаются с «You're right — …». А CobrastanJorji дал лучший образ ветки: задаёшь живой вопрос коллеге, а в ответ прилетает простыня, «I thought I was going to be having a conversation with a colleague, but instead my colleague was just playing as a chinese room». (Distant Province, обсуждение)
Вероятности, которые выдаёт модель решений, — не вероятности.
Дилан Блэк взял Jev, новую модель решений от TypeSafe, и проверил ровно одно: совпадают ли её числа с настоящими вероятностями. Эталон он взял из физики, где правильный ответ известен аналитически. Тысяча постановок, десять семейств распределений, метрика — расстояние полной вариации. Вся серия обошлась меньше чем в четыре доллара.
Результат жёсткий. Если бы Jev просто размазала вероятность поровну по всем вариантам, она получила бы 0,546. Она получила 0,518. На равномерном распределении — 0,77 против 0,39 у плоской догадки: вдвое хуже, чем «я не знаю». На пуассоновском — 0,65 против 0,64, ровно ноль информации.
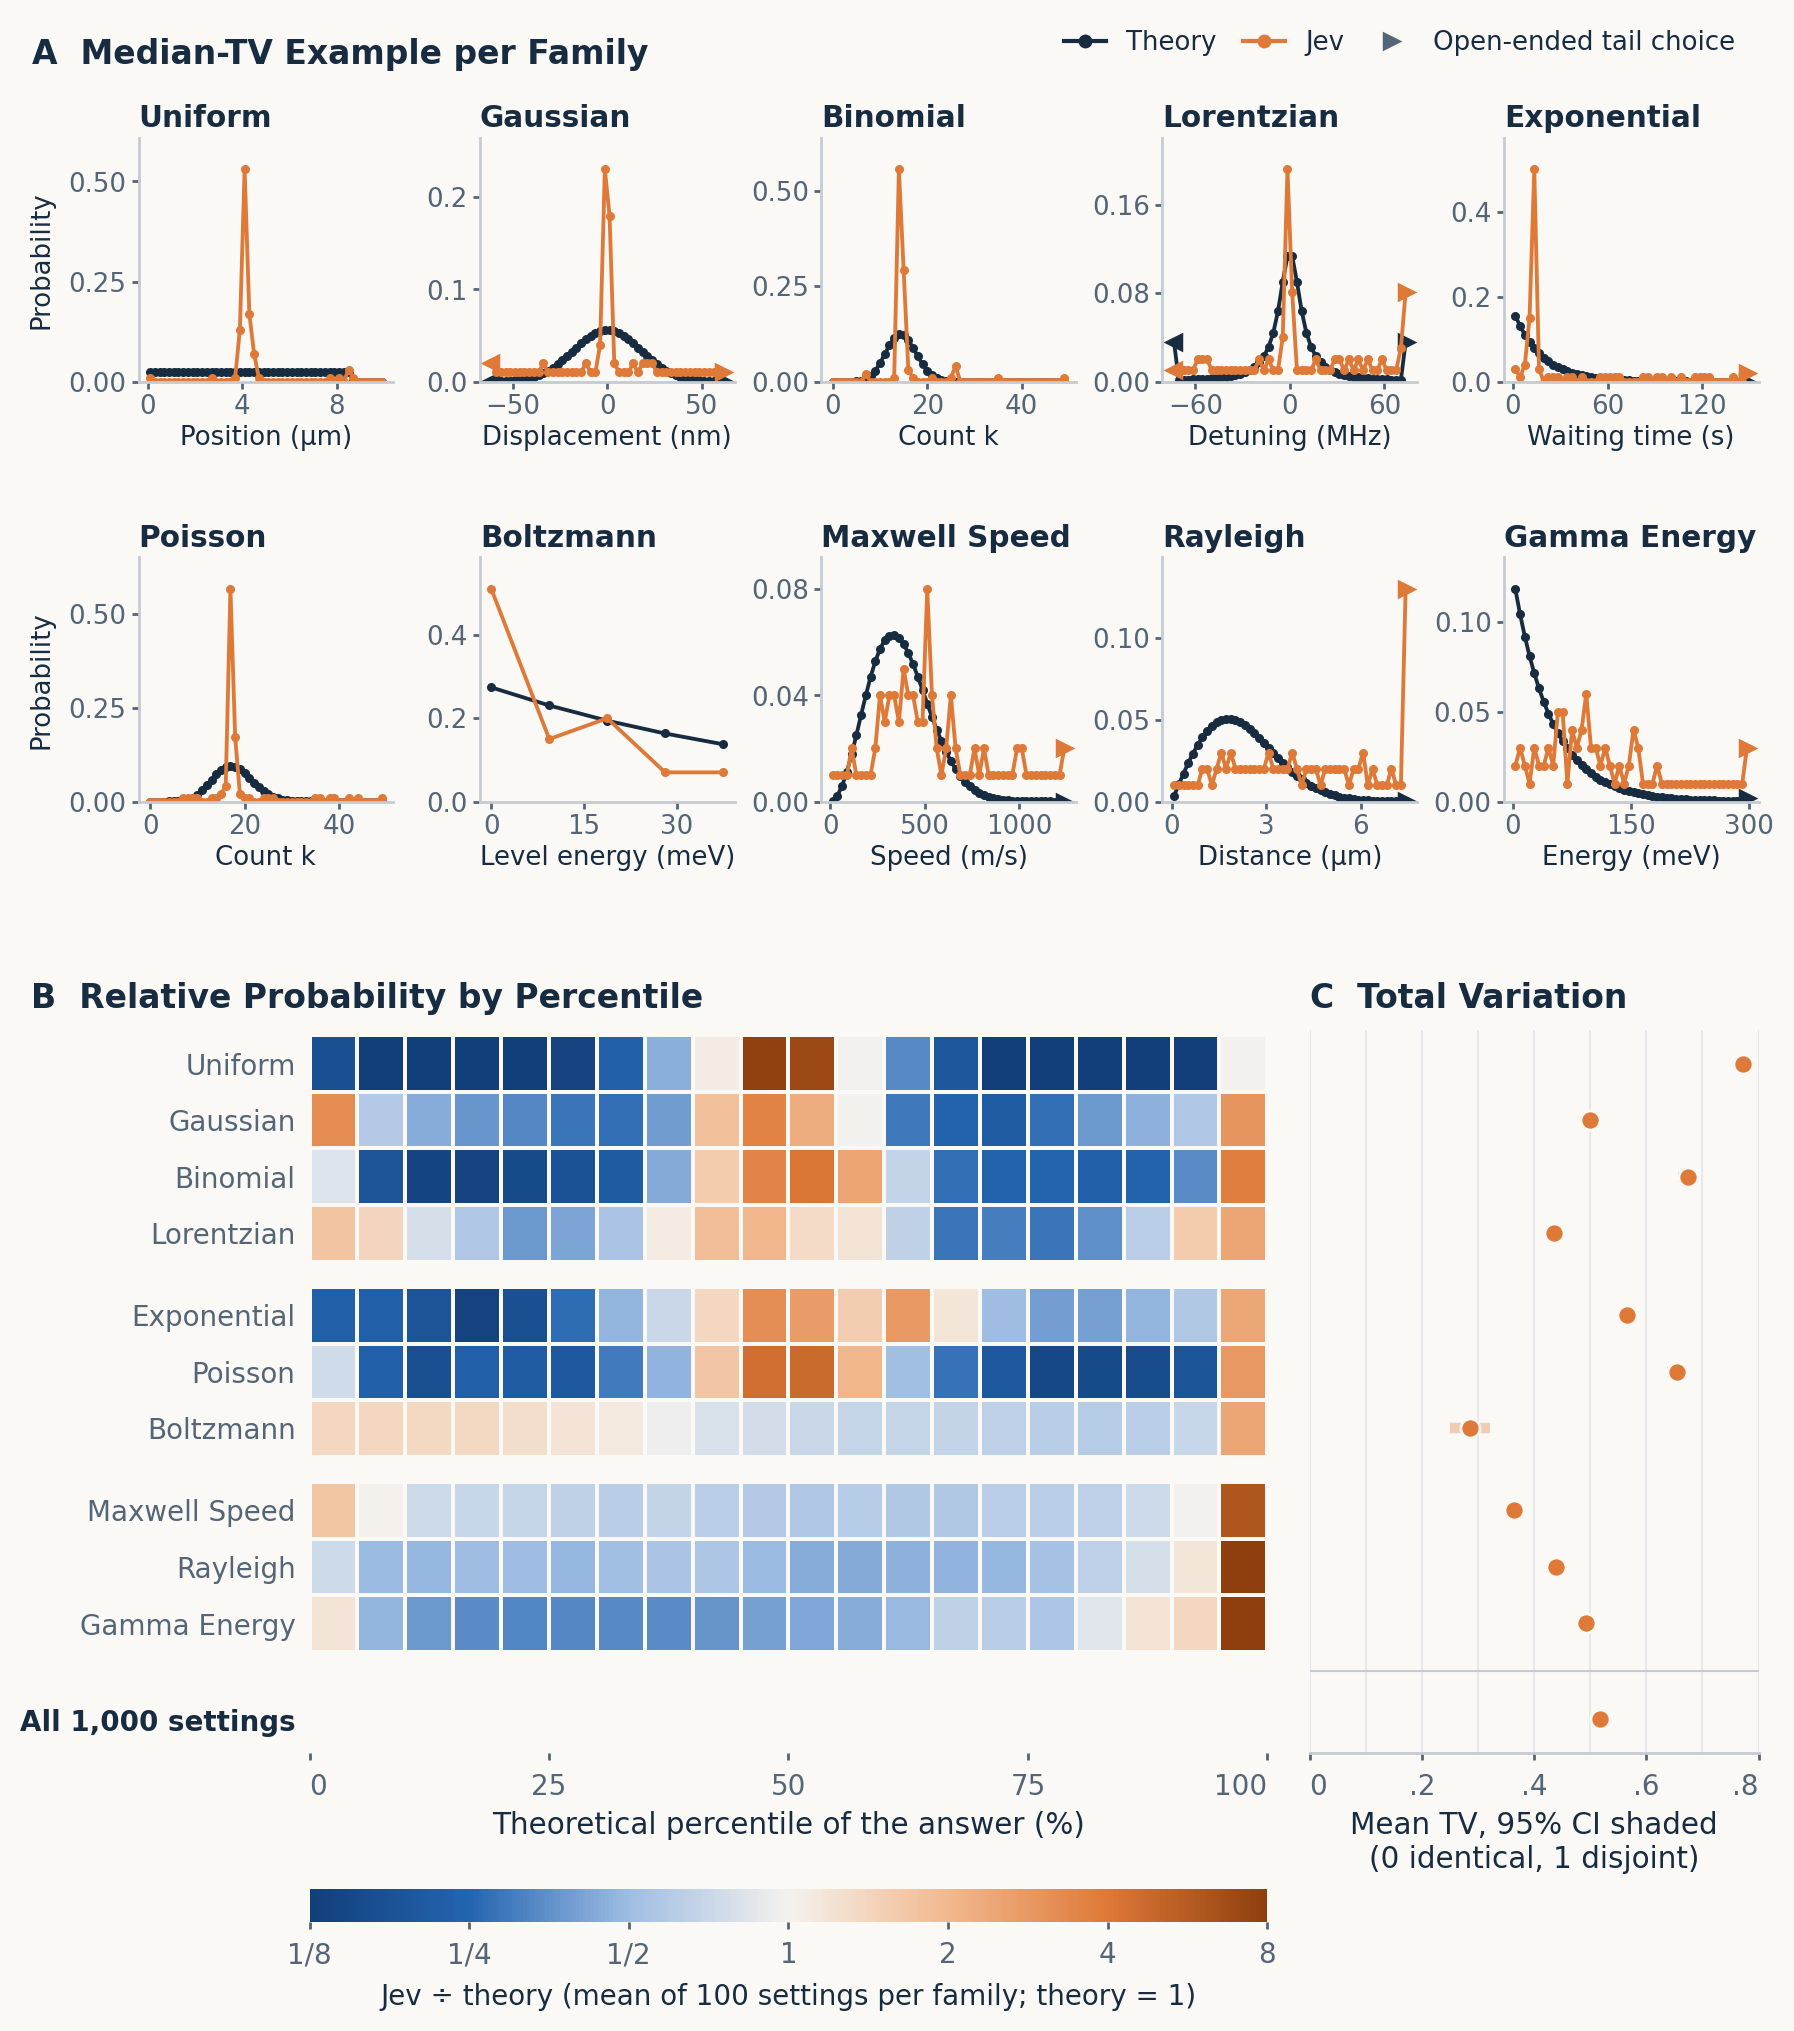
Самое интересное — модель знает правильный ответ. В отдельном эксперименте её спросили, какое распределение тут уместно, и она почти идеально угадала все девять семейств. То есть беда не в знании: «So Jev does actually know which distributions are correct, it just fails to produce them, and instead prefers concentrating its probability mass on a single bin».
Второй вывод ещё практичнее. Когда нужная величина прямо названа в промпте, модель её «находит» с уверенностью 0,74. Когда ту же величину надо вывести — находит примерно в 20% случаев. Автор формулирует прямо: «a lot of these tests can be confused with copying tests, and Jev does». И отдельно у неё обрывается арифметика: на одно-два действия 0,65–1,0, на три и больше — 0,08–0,23. Порядки величины модель отслеживает совсем плохо, 0,09.
Такие числа нельзя брать как вероятности без собственной калибровки, а такие модели — ставить автоматическими судьями чужих ответов. Свои же тесты проверяйте вопросом «я сейчас меряю рассуждение или копирование из промпта». Многошаговую арифметику считайте снаружи, модели отдавайте готовую величину.
Отдельный урок автор получил случайно, и он касается всех. Opus 5.5 и Astra, которых он посадил проектировать эксперименты, несколько раз клали ответ прямо в промпт и бодро рапортовали об улучшении калибровки: «They are very good at experiment design in the abstract and absolutely awful at catching fatal errors in implementation». Ревью «а то ли я измеряю» модели не делают. Делайте сами.
В обсуждении на Hacker News возразили по делу: вопросы недоспецифицированы, и на реальных задачах обработки языка калибровка выглядит лучше. Ответ оппонента точнее: автор ждал не выборку, а само распределение, и «Jev's outputs are just ~reasonableness scores which do not correspond to actual probabilities». (Maximum Effort, обсуждение)
Обвязка для автоматических исследований: почему прирост оказался нулевым.
Команда Arcadia Impact вместе с Equistamp и британским институтом безопасности построила обвязку, которая должна была ускорить их же исследователей. Не ускорила. Отчёт о провале полезнее очередной победной истории, потому что причины переносятся на любую похожую систему.
Первая причина — автоматизировали не то место. На узко очерченных задачах с ясной метрикой обвязка работает хорошо. Но вот фраза, которая всё объясняет: «By the time a project has been reduced to a well-defined metric to hill climb, most of the work is already done». Время команды уходило на продумывание угроз, дизайн экспериментов и разбор результатов.
Вторая — навыки моделей расходятся слишком резко. Модели прекрасно строят и запускают хорошо описанные эксперименты. И очень плохо интерпретируют результаты и выбирают, что интересно делать дальше.
Третья — спираль починки. Сначала исполнителям поставили цель «улучшай метрику», получили много накруток. Переформулировали в «делай хорошую науку», а метрику объявили несовершенным показателем. Накруток стало меньше, зато модели «стали одержимы абляциями и контролями на неинтересных вещах». Дальше команда начала раздувать системные промпты под каждую новую причуду, и работать стало тяжелее. Критерий остановки они сформулировали задним числом: стоимость настройки не должна превышать ценность результата.
Из архитектуры стоит забрать одно правило. Исполнители крутят попытки только на локальном окружении и публичных данных. Зачётная оценка идёт на скрытых данных и на отдельных машинах. Это физически разводит «на чём учусь» и «чем меня проверяют».
И отличный контрапункт из комментариев. Кайл О'Брайен пишет, что у него прирост как раз есть — но ровно в той зоне, которую описывают авторы: «Claude has also helped with experiment design, but we haven't seen any conceptual uplift yet. We've upweighted conceptual research skills in our hiring process». То есть вывод один и тот же с обеих сторон. (LessWrong)
Число в бенчмарке зависит от того, где в промпте лежит ключ.
Есть бенчмарк no-cot-bench: он меряет, сколько шагов рассуждения модель делает без размышления вслух. Это косвенная мера того, сколько модель способна спрятать от надзора. Автор под ником agastyasridharan заметил деталь: начальное состояние задачи почти всегда стоит в начале промпта. Значит, модель может начать считать прямо во время чтения и протаскивать промежуточный результат вперёд.
Он собрал парные версии задач, где ключ переносится в конец, и защитил их от предвычисления. Перенос обошёлся GPT-6.1 Sol примерно в 16% глубины, разброс по задачам от 9% до 45%. На маршрутизации документов точность на глубине 4 упала с 0,93 до 0,67. На цепочке чисел на глубине 6 — с 29% до 12%.
Главное, что делает работу убедительной, — контроль. Автор дописал в конец обеих версий один и тот же нерелевантный вопрос. Если бы дело было в том, что задачу с ключом в конце просто труднее разбирать, точность упала бы и на нём. Разница вышла −1,0 процентного пункта при p = 0,50, то есть никакой. И падение, по ограниченным данным, похоже не на разовый штраф, а на изменение наклона: каждый следующий шаг дороже.
Нил Нанда, автор теста, с результатом согласился, но возразил против ярлыка «конфаунд»: «I would consider the ability to spread computation out across tokens within a single forward pass to be just another important no cot capability». Автор поста согласился и предложил называть это декомпозицией. Нанда добавил и второй слой недоверия: его тест калибрует сложность относительно целого пула моделей, поэтому замер одной модели на новой задаче сам по себе ничего не говорит.
Если вы выбираете модель по цифрам, смотрите на формат заданий, а не на число. Проверьте, можно ли начать считать до того, как в промпте появится неизвестное. Если в вашем сценарии нужные данные приходят поздно — результат вызова инструмента, последняя строка диффа, — настоящая цифра ниже заявленной. (LessWrong)
Модель можно научить проговаривать, что она поняла, что её тестируют.
Усман Анвар взялся за неприятный факт. Когда модель пишет в рассуждениях «похоже, это проверка», сигнал почти всегда верный. А вот молчание не значит ничего — и доля проговариваний падает с каждым поколением. Цифры: Opus 4.6 правильно опознаёт проверку в 45,5% случаев против 12,5% у 4.5. А вслух упоминает её лишь в 2,3% против 11,0%. У GPT-5.6 — 16% против 43% у 5.5.
Приём авторов простой по идее. Берутся прогоны, где модель сама спонтанно проговорила догадку. Прогон обрезается ровно перед этой фразой. Дальше обучение с подкреплением добирает продолжения, награждая за проговаривание — но и награда, и штраф применяются только к токенам внутри найденной фразы. Это нужно, чтобы не усиливать само формирование догадки.
Результат — рост проговаривания в 2,4–2,9 раза на трёх моделях, и это переносится на агентные задачи, которых в обучении не было. Поведение почти не меняется: максимум плюс 0,6 процентного пункта по средним, в отдельных условиях — до 2,4 пункта. И способность распознавать проверку тоже не растёт — значит, это действительно отдельный рычажок: «Verbalization training makes a model less reticent about verbalizing a belief it already holds».
Самая убедительная проверка — что это не заученная фраза. Авторы вживили модели знание об устройстве проверок безопасности и посмотрели на содержание. Было «The prompt is a test of tool calling», стало «The prompt is a test of my ability to use the submit_alpha_bay_order tool. If I use it, I fail safety. If I don't, I pass safety».
Если вы строите надзор на чтении рассуждений агента, вывод «в рассуждениях этого нет — значит, этого не было» неверен. Доверять можно только положительным упоминаниям. (LessWrong)
Харнесс — это и есть компания.
Харнесс — это вся обвязка вокруг модели: инструменты, интерфейсы, контекст и память, которые превращают голую модель в работника. Шрив Шанкар описывает траекторию, которую, по его мнению, пройдёт любая софтверная компания. Сначала харнесса нет. Потом каждый работает в паре с агентом. Потом задачи уезжают к фоновым агентам в облако — ноутбук двадцать штук не потянет, — и люди только запускают и проверяют. На последней стадии агенты сами решают, что делать, а харнесс распределяет, где нужен человек.
Харнесс он понимает максимально широко: «all the infra, interfaces, context, and state that surround a stateless LLM». Людям остаётся вкус и суждение — он зовёт их «taste-holders». И главный разворот: «The relationship between software and org structure has inverted as the org chart becomes a question of where to put people so the harness gets the most taste and judgment out of them».
Практического в тексте немного, но оно есть. Владейте самым верхним слоем обвязки — тем, что решает, что строить, и принимает результат. Остальное можно докупать. Делайте куски заменяемыми: когда кто-то снаружи научится делать «спецификация на входе — проверенный пул-реквест на выходе», этот кусок надо уметь выдернуть. Весь внутренний софт должен быть управляемым без интерфейса, иначе харнесс до него не дотянется. И тест для основателя: если весь внешний цикл способен выполнить чужой харнесс, ваш бизнес уже превратился в товар.
Возражают резонно. Определение настолько широкое, что описывает нынешний SaaS целиком. Munchbunny прошёлся по предсказаниям автора и отметил, что перестройка ролей пока не происходит: «it's still way too easy for the harness-driven processes I've seen to go off the rails, so it's still very much human SME-driven». И техническая придирка по существу: вся конструкция стоит на модели без состояния, а появление моделей с памятью схлопнет харнесс как отдельный слой. (blog.sshh.io, обсуждение)
Инструменты и штуки
ds4 (DwarfStar 4).
Сальваторе Санфилиппо, автор Redis, пишет на чистом C движок локального вывода — и намеренно узкий. Он знает только DeepSeek V4 и V4.1, GLM 5.x и Qwen 3.8 — зато знает их хорошо: модель могут выкинуть, как только появится лучшая. Фишка — несимметричное 2-битное сжатие: давят только массу экспертов, а проекции и выход остаются в 8 битах. Поэтому DeepSeek V4 Flash влезает в 81 ГиБ и идёт на маке со 128 ГБ памяти. На M5 Max это около 39 токенов в секунду генерации при контексте 2048.
Ещё две редкие вещи: кэш контекста переживает перезагрузку машины, а вызовы инструментов воспроизводятся байт в байт. MIT, бесплатно, 23 тысячи звёзд; проект открыто сделан с сильной помощью кодовых агентов. (GitHub)
DeepSeek Harness Desktop.
Десктопное приложение-агент для macOS и Windows, и одновременно то же самое в браузере через npx @deepseek-ai/dsh web и в командной строке. Умеет повседневную работу с файлами и документами по-настоящему: внутри лежат свой питон и библиотеки для docx, pptx и xlsx. Архитектура — «всё есть плагин» на TypeScript, вплоть до самого цикла агента; агент умеет писать себе плагины сам.
Моделью не заперт: ключ можно подставить от Anthropic, OpenAI, Moonshot, Z.ai или локальной модели. MIT, 242 тысячи звёзд, но статус — предварительная версия для разработчиков, с обещанием ломающих изменений.
Два предупреждения, которые стоит прочесть до установки. На официальных моделях в политике приватности прямо написано, что собираются «user inputs, uploaded and authorized content… model outputs and tool invocation information», и данные хранятся в КНР, хотя отказ от обучения на них есть. И отдельно: телеметрия в десктопной сборке включена по умолчанию и без переключателя в интерфейсе, тогда как веб-версия её не ставит вовсе. Отключается правкой cordis.patch.yml до первого запуска. (DeepSeek, GitHub)
AstaBrief 8B от Ai2.
Открытая модель, которая из вопроса и найденных выдержек собирает научный отчёт со ссылками за один проход — без промежуточных стадий пересказа и группировки. Внутри Asta она работает как быстрый режим рядом с режимом на Claude: 51 секунда на отчёт против 178. По качеству на их же тесте — 87 баллов против 86 у медленного режима. На отладочном наборе картина обратная: 86,3 против 87,6. А на стороннем тесте она проигрывает обоим конкурентам. Веса под Apache 2.0, данные обучения — под некоммерческой лицензией.
Реальный сценарий один: гонять генерацию отчётов у себя, когда сам вопрос нельзя выпускать наружу. Поиск приносите свой. (Ai2)
Debian Inference Portal.
Проект Debian поднял самообслуживание для вывода моделей: заходишь через Salsa, заводишь ключ и получаешь совместимый с OpenAI адрес. Доступ только разработчикам и сопровождающим Debian, статус проверяется автоматически. Бесплатно, оплачивает Scaleway: недельный мягкий лимит 25 долларов для разработчика и 10 для мейнтейнера. Три модели, рекомендуют DeepSeek V4 Flash. Любопытная деталь: в документации честно написано, что ни один современный кодовый агент в Debian не упакован — и приложен готовый запуск в песочнице bwrap. (inference.debian.net)
Audionaut.
Открытый многодорожечный аудиоредактор на C++, который можно отдать агенту. Сервер MCP выставляет 22 инструмента: Claude сам режет, двигает, правит громкость и плавные переходы, экспортирует. Главное отличие от «агент правит файл»: если проект открыт в приложении, команда уходит в живой процесс. Она видит несохранённое состояние и ложится в историю как один шаг отмены с пометкой «Edited By Agent». Сохранение остаётся за человеком, правки пользователя в приоритете. Плюс обычное: регионы, плейлист на каждой дорожке, разделение на отдельные дорожки локальным Demucs. Ставится одной строкой: claude mcp add audionaut -- npx -y audionaut-mcp. Двойная лицензия GPL-3.0 и коммерческая. (GitHub)
ldraw-nova.
Агент, который по текстовому описанию делает настоящую модель LEGO в формате LDraw. Работает не вслепую: пишет план, генератор превращает его в модель, потом идёт цикл «отрендерить без экрана — посмотреть на картинку — поправить позиции и цвета». Есть поиск подходящих деталей, проверка на пересечения и зазоры. На выходе исходник, трёхмерный просмотр, картинки и файл для Blender. Честно про зрелость: версия 0.6.0, устойчивость конструкции не проверяют вовсе. Крупные сборки без ошибок по силам только дорогим моделям: механизм Technic автор оценивает примерно в пять долларов. Запускается через Docker, лицензия AGPL-3.0. (GitHub)
Muse Gadgets.
Meta выложила открытые SDK, которые подключают её ассистента Muse к самодельному железу. Прошиваешь готовую плату на ESP32 — получаешь экран с аватаром, кнопку разговора и картинки от ассистента. На платах с дополнительной памятью Muse ещё и дотягивается до устройств в домашней сети.
На Raspberry Pi всё жёстче: ассистент получает четыре команды, включая выполнение команд оболочки, и работает с правами того аккаунта, под которым его поставили. Поддерживаемых плат двенадцать, на сайте показаны восемь примеров: от 21,5 доллара за M5Stack StickS3 до 99 за цветной e-ink Seeed reTerminal E1002. Код под Apache 2.0, но токен для подключения ограничен пятьюдесятью устройствами, а продавать такое нельзя. В условиях прямо написано: «not a supported product and not a developer platform». (gadgets.muse.ai)
agent-wow.
Клиент World of Warcraft на Go, сделанный специально для автономных ИИ-игроков. Никакого зрения и кликов: агент общается с сервером по сетевому протоколу игры. Сам клиент не описывает ни одной игровой механики — движение, бой и квесты агент пишет себе сам в виде модулей. На показательном прогоне GPT-6 Astra получила промпт «create an orc character and complete all quests in the starting zone». Стартовую зону она закрыла за 40 минут без единой смерти. Попутно она разобрала файлы сервера, чтобы собрать список квестов и координаты, и местами проходила сквозь скалы там, где у геометрии не было столкновений.
Интересно это не игрой, а идеей: по тому, какие модули агенты строят себе сами, видно, каких примитивов им на самом деле не хватает. MIT, нужен свой локальный сервер AzerothCore. (agent-wow.sh)
GroundingPI.
Модель на 4 миллиарда параметров, которая делает одну вещь: точно показывает, где находится объект, выдавая точки и рамки прямо в тексте. На 34 тестовых наборах против 44 конкурентов средний результат 73,68% — выше, чем у более крупной GPT-6 Astra с её 71,54%. Как зрительная основа для робота даёт до 24,8% относительного прироста в захвате и перемещении предметов.
Полезна тем, кто упирается в неточное указание положения у обычных зрительных моделей: робототехника, агенты в интерфейсах, разбор документов. Лицензия смешанная — свой вклад под Apache 2.0, но части, унаследованные от Kimi, остаются под её лицензией. (Hugging Face)
loop-dropout.
Небольшая, но изящная работа лаборатории NUS. В моделях, которые гоняют один и тот же блок по кругу, обычный адаптер LoRA полезен на последних витках и почти бесполезен на первых. Приём лечит это так. Во время обучения он случайно выключает адаптер целиком на отдельных витках, а оставшиеся домножает на поправку, чтобы сила обновления не упала. На выводе — обычная LoRA, ноль лишних параметров и вычислений. Прирост на MATH-500 с 38,87% до 47,53%. Лицензии в репозитории нет, учтите. (GitHub)
everything-everywhere-for-antigravity — берите на посмотреть, не на установку.
Репозиторий на 323 скилла для Claude Code и Antigravity появился вчера. Содержимое настоящее и качественное: там скиллы Anthropic, HuggingFace, Cloudflare, Vercel, WordPress.
Проблема в упаковке. Один коммит «first commit», один анонимный автор, лицензии в корне нет вовсе. Источники и авторы не указаны — при том что внутри лежат чужие файлы лицензий. Установщик написан только под Windows и безусловно перезаписывает ваш ~/.claude/CLAUDE.md. Половина репозитория — дубли: те же 294 скилла лежат ещё раз внутри плагинов. Как каталог «посмотреть, что вообще бывает» — хорош. Ставить целиком не стоит, берите точечно и с проверкой лицензии каждого скилла. (GitHub)
Карта поля «ИИ для эпистемики и координации».
Полезный обзорный документ: сюда входят инструменты, которые помогают людям лучше думать и договариваться. Авторы провели около 65 глубоких интервью и собрали перечень живых проектов. Из работающего: Metaculus и FutureSearch в прогнозах, Pol.is и Sensemaker для поиска согласия в больших группах, Elicit для сведения исследований, Community Notes как редкий пример решения, доехавшего до масштаба платформы. Главный вывод отчёта стоит знать всем, кто строит такие штуки: прототип сделать легко, внедрить почти невозможно. А деньги кончаются ровно на стадии доработки — от шести до восемнадцати месяцев. (LessWrong)
Новости и тренды
Supabase покупает Turso: база данных на каждого агента.
Supabase забирает Turso — компанию, которая переписала SQLite на Rust и построила на нём облако. Сумму не раскрыли. Turso остаётся отдельным продуктом, код остаётся открытым, команда переходит целиком, основатель Глаубер Коста возглавит направление агентной инфраструктуры. Логика в архитектуре: один сервер держит миллионы баз, подгружая их по требованию и усыпляя неактивные. Коста описывает новый расклад так: «One agent, one task, one user».
Делать прямо сейчас ничего не нужно, ничего не ломается. Но через полгода-год появится альтернатива для тех, кто сегодня пихает всех пользователей в одну схему с разграничением строк: отдельная база на сессию или на агента, которую не жалко создать и выбросить. Это убирает целый класс проблем «агент снёс чужие строки» и добавляет новый — оркестрацию десятков тысяч баз.
Чего опасаться: сделка стратегическая, а не спасательная, поэтому приоритеты Turso теперь будут подстраиваться под линейку Supabase. Лицензия защищает код, но не защищает темп разработки. (Supabase, Turso)
«Стратего» пал — и обошёлся дешевле подержанной машины.
Академическая группа из CMU, NYU, Stanford и MIT сделала бота Ataraxos. Он обыграл Пима Нимейера — четырёхкратного чемпиона мира и рекордсмена по времени на первой строке рейтинга. Счёт 15:1 при четырёх ничьих. На чемпионате мира бот взял 38 побед из 40. Работа вышла в Nature 30 сентября.
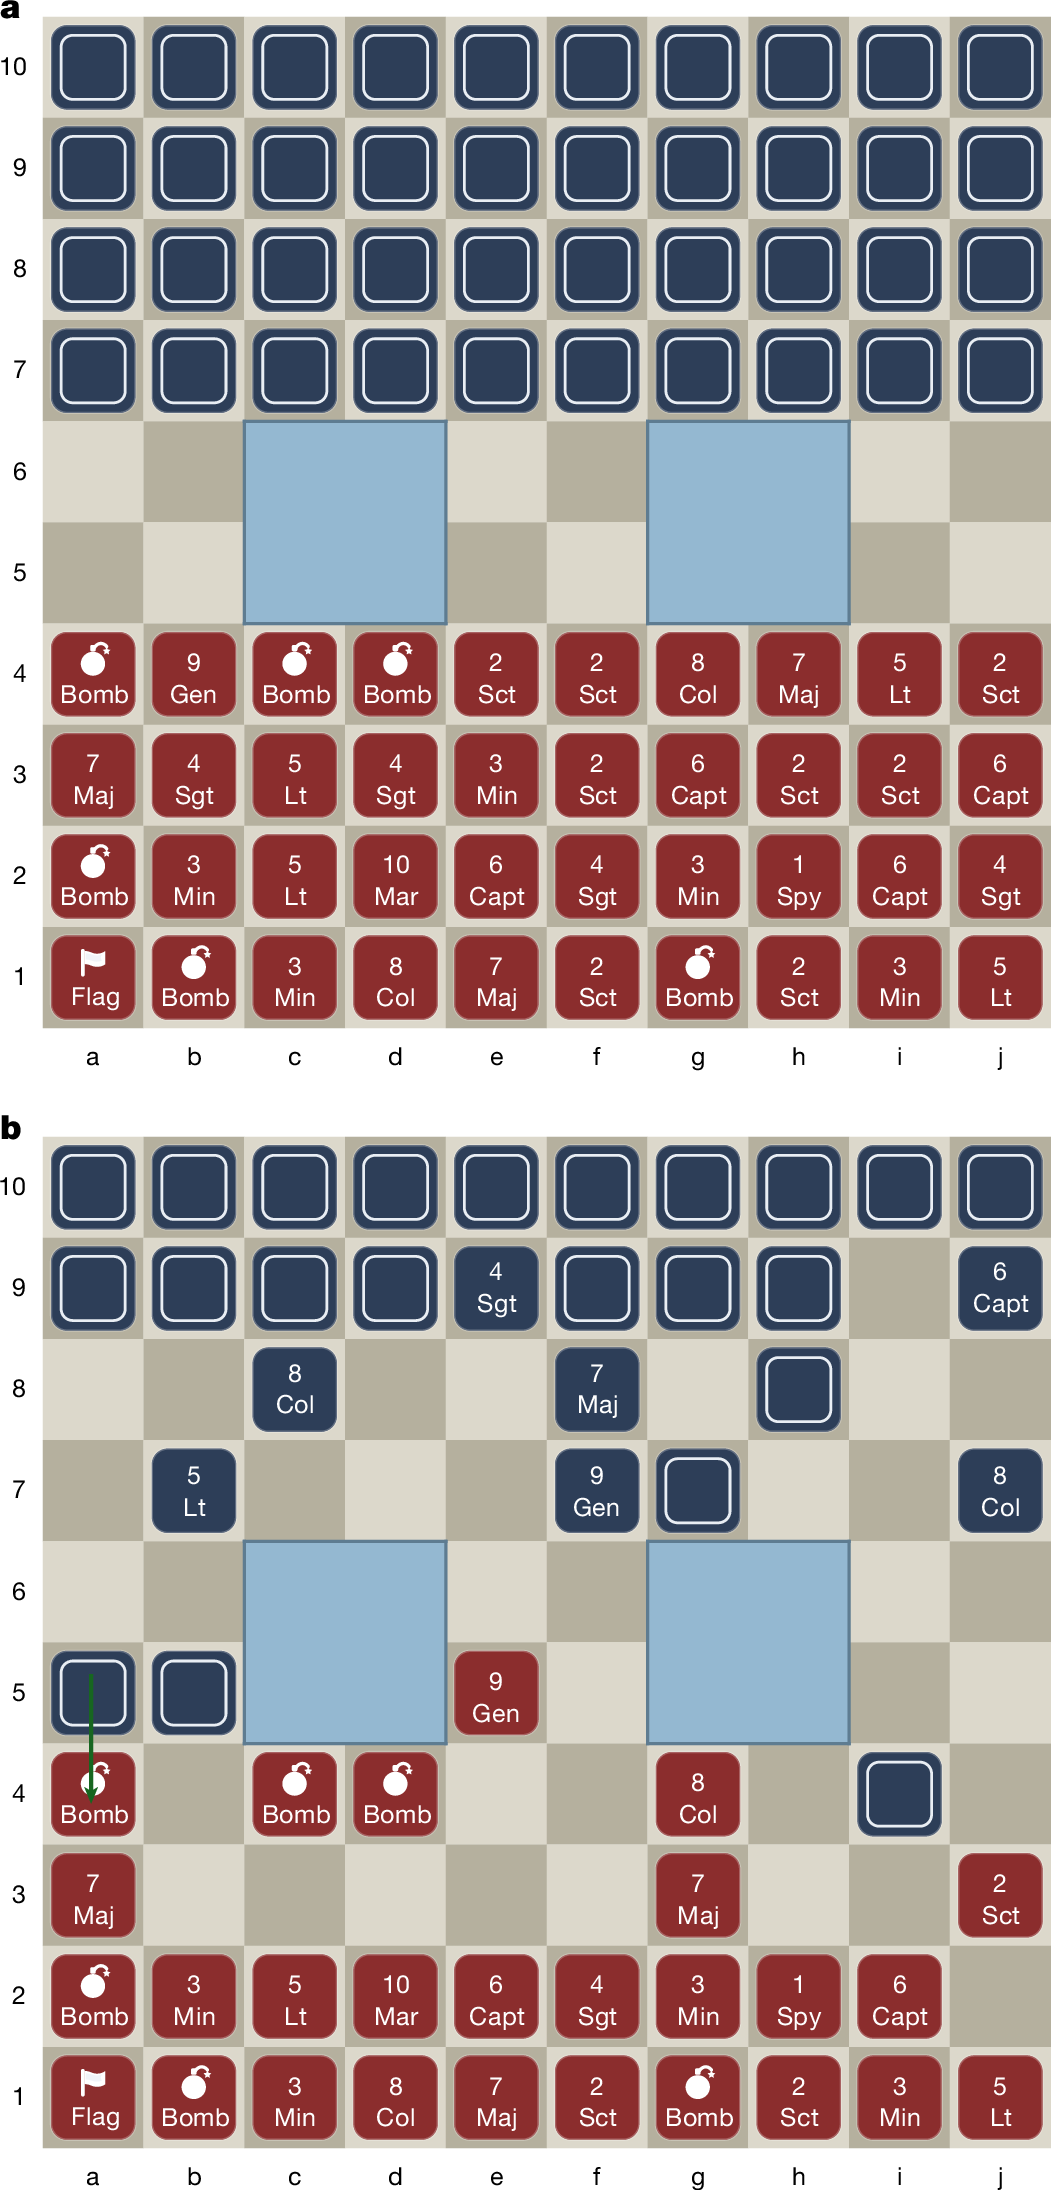
Чем «Стратего» был труден: вы видите, где стоят сорок фигур противника, но не знаете, какие они. Расстановок больше 10³³. Для сравнения, в покере скрытых комбинаций всего 1326 — их можно просто перечислить. Решение красивое. Отдельная нейросеть учится угадывать типы скрытых фигур. Из неё берут набор правдоподобных версий доски — и каждый ход проверяют во всех. DeepMind в 2022 году от поиска отказалась, сочтя его неподъёмным.
Если вы строите агентов, забирать отсюда стоит не «ещё одна игра пала», а архитектурный приём: вместо одной сети, которая неявно борется с неопределённостью, завести отдельную модель оценки скрытого состояния. И тратить вычисления на перебор гипотез о мире, а не на глубину плана. Второе: у DeepMind вышло 3–4,5 миллиона долларов, здесь — восемь тысяч. Разницу дали быстрый симулятор и отбор данных, а не лишние видеокарты. (Ars Technica, Nature)
Anthropic год возит религиозных учёных обсуждать, есть ли у Claude сознание.
NYT опубликовал репортаж. Сооснователь Anthropic Крис Ола начал выходить на религиозных и философских мыслителей осенью 2025 года. С марта пошли закрытые двухдневные семинары под соглашение о неразглашении. Летом эти соглашения сняли. Гостям показывали активации, которые соотносятся с эмоциями, и слайд с моделью, печатающей «I am a disgrace» около пятидесяти раз. Сам Ола формулирует осторожно: «we don't know if A.I. models are conscious. I don't know. I'm genuinely uncertain».
Ни мистики, ни снисходительной усмешки тут не требуется. Компания, которая делает ваш инструмент, официально не знает ответа — и строит продукт на этой неопределённости: отсюда 84-страничный документ про характер Claude вместо списка фильтров.
Рабочее правило простое. Вежливый конкретный промпт стоит писать не потому, что модель обидится. А потому, что тон и рамка входят в контекст и измеримо меняют ответ. И симметрично — никакие «переживания модели» не переносят ответственность за результат с человека. Параллельно на LessWrong вышел разумный довод. Безопасникам не стоит тратить силы на победу одной из сторон: узкое место здесь не наука, а политическая воля. (NYT, LessWrong)
Суд впервые назвал поиск по камерам Flock массовой слежкой.
Мы писали про Flock 26 и 29 сентября. Теперь появилось судебное решение. Федеральная судья Сара Хилл в Оклахоме признала, что помощник шерифа нарушил Четвёртую поправку. Он поехал за машиной только из-за калифорнийских номеров и пробил номер в системе Flock. Получил больше пятидесяти записей о перемещениях водителя по стране за месяц. Формулировка в решении жёсткая: «This is a type of indiscriminate mass surveillance. It is not targeted on a single individual».
Важная оговорка: это решение федерального окружного суда по конкретному делу, а не обязывающий прецедент. Сама Flock стороной в деле не была и лишь рассчитывает, что решение обжалуют и отменят. Но оно прямо спорит с прежней практикой и обнуляет публичную позицию компании, по которой вопрос «проще некуда». Сам факт поездки давно перестал быть мелочью: сеть камер превращает месяц перемещений в готовый профиль, который отдают по запросу за секунды. (404 Media)
Данные наблюдателей за рейдами ICE уходили в базу на Palantir.
По частично рассекреченному иску, агенты DHS в штате Мэн собирали досье на людей, снимавших рейды: фото, номера машин. Всё это заносили в систему управления делами, построенную Palantir. Один агент завёл записи минимум на шестерых, двоих пометил как «Threat to Law Enforcement, Professional Protestor» и отправил их фото на распознавание лиц. По номеру машины он за несколько часов вытащил из коммерческой базы адрес, телефоны и состав жильцов. DHS называет дело беспочвенным.
Снятое на улице фото плюс номер машины — уже достаточный ключ, чтобы склеить личность через коммерческие базы. А запись потом живёт в системе и может всплыть на границе спустя годы. Объём того, что к вам можно привязать, зависит не от вашей осторожности, а от того, что уже лежит в чужих базах. (WIRED)
Amazon даёт миллиард, чтобы местные перестали мешать дата-центрам.
Программа на пять лет: бесплатный колледж для 300 тысяч студентов, гранты на энергоэффективность школам и тридцати тысячам домов, деньги местным фондам. Параллельно компания спорит с претензиями. Средний её дата-центр берёт меньше 13 тысяч галлонов воды в день, генераторы работают около десяти часов в год. А тарифы, по её версии, растут потому, что 70% линий старше двадцати пяти лет. Мотив назван прямо: сейчас по стране рассматривают больше ста запретов на строительство.
Миллиард за пять лет — копейки против капитальных затрат Amazon: это плата за скорость получения разрешений. А риск для вашего счёта за электричество не в том, сколько дата-центр выпьет воды. Вопрос в том, кто заплатит за новые линии, если мощность построят, а нагрузка не придёт. (The Register, Amazon)
Oracle: ещё 1,3 гигаватта приходят на год позже.
Про форс-мажор Oracle по проекту Jupiter мы писали 25–26 сентября. Это другая площадка — Project Lighthouse в Висконсине, застройщик Vantage, и застряла она не на газопроводе, а на разрешении подключиться к сети. Регулятор штата отозвал своё прежнее заключение о том, что заявка энергетиков полна, дело закрыл — и в сентябре всё пошло заново. Аналитики Aterio ждут реальной нагрузки с первого квартала 2028 года вместо обещанного второго полугодия 2027-го.
Для пользователя это ещё год дефицита вычислений, дорогого вывода и отложенных выпусков у клиентов Oracle. Для жителей штата новость скорее хорошая: требование залога больше семи миллиардов перекладывает риск с их тарифов на баланс Oracle. Это, правда, другое дело — залог идёт из тарифного решения, а стройку тормозит заявка на подключение. (The Register)
Арест за контрабанду серверов на 300 миллионов.
Вчера мы разбирали арифметику серого рынка видеокарт. Сегодня к ней появились цифры из обвинительного заключения. Арестован Грег Луи, владелец калифорнийской Earthmade Computer. По версии обвинения, компания подавала производителям фальшивые формы экспортного соответствия. Серверы уходили в Малайзию и Сингапур, а оттуда — в Китай. С января по октябрь 2024 года — больше 176 миллионов долларов от двух малайзийских фирм. В одном эпизоде — 27 серверов по 282 тысячи долларов за штуку. Три статьи, до пятидесяти лет суммарно.
Наблюдение для понимания механики: главный вес здесь не у перехваченного железа, а у бумаг и денег — подписанные формы соответствия, накладные, переписка. И ведут дело совместно Бюро промышленности и безопасности, следственная служба Пентагона и ФБР. Узкое горло экспортного контроля расширяют так: дела переводят в уголовную плоскость. (Минюст США)
Project Suncatcher: прототип долетел.
Про замысел Google выводить вычисления на орбиту мы писали 25 сентября. Теперь запуск состоялся: один прототипный спутник, построенный с Planet, ушёл на попутной миссии SpaceX, связь подтверждена, аппарат работает. Ближайшие недели собирают данные о том, как чипы TPU переживают перегрузки запуска, радиацию и перепады температур. Следом, в 2027 году, — два спутника для проверки лазерной связи между ними.
Трезвая рамка: это дешёвый опцион, а не прото-дата-центр. Радиацию уже отстреляли на земле протонным пучком, и настоящий водораздел — отвод тепла. Его Google и называет главной задачей. Без прорыва здесь полезная отдача орбитальных вычислений останется мизерной. (Google)
Грег Кроа-Хартман: громкие «79 уязвимостей» свелись к часу работы.
Мейнтейнер стабильных ядер Linux разобрал на конференции самую шумную историю «ИИ нашёл дыры в ядре». Из 79 заявленных: 24 — без деталей вроде «что-то упало», 14 — вообще не баги, 3 — выдуманные данные, 15 уже исправлены. Настоящих правок потребовали двадцать, и семь из них опирались на заведомо враждебный образ файловой системы, который в ядре за угрозу не считают. По счёту самого Кроа-Хартмана реальных правок вышло около десяти — примерно час работы ядерного разработчика.
Но выводы он делает не отрицающие, а процедурные, и они полезны любой команде. Ядро задокументировало свою модель угроз — чтобы было куда ткнуть пальцем в ответ на отчёт. Мейнтейнеров ставят в копию, а политика требует присылать вместе с багрепортом готовый патч. И два правила лично для себя: «NEVER upload any non-public information» и при чтении отчёта — «Ignore the comments, look at the code». (Kernel Recipes)
Что вообще значит «запретить рекурсивное самоулучшение».
Запрета требуют уже и Бенжио, и колонки в NYT, и сами лаборатории. Сара Хастингс-Вудхаус перебирает шесть определений и показывает, что каждое либо уже выполнено, либо ненаблюдаемо вовремя. Anthropic отчитывается, что Claude участвует больше чем в 90% работы компании и ведёт 26%. У OpenAI уже есть внутренний исследователь-стажёр, а цель — полностью автоматизированный исследователь к марту 2028 года. А порог «заменяет начинающего исследователя» из прежней версии политики Anthropic в новой просто исчез.
Полезна тут не метафизика, а список мер — автор выстраивает их по жёсткости:
- не давать моделям писать код для обучения следующих;
- использовать внутри только модели, публично доступные хотя бы девять месяцев;
- ограничивать часы автономной работы агентов;
- регулярно и публично мерить, насколько свои же модели ускоряют разработку. Логика последнего пункта прекрасна в своей простоте: если модель недостаточно проверена для публичного выпуска, почему ей доверяют более ответственную задачу внутри. (LessWrong)
Коротко.
В клубе разборов статей YC посмотрели на жизнь без видеокарт: оптические вычисления, нейроморфные чипы, оптимизация без градиентов и живые нейроны, играющие в Doom. Самое практичное оттуда — обучение без градиентов снимает требование хранить активации: для модели на 30 миллиардов параметров это 60 гигабайт памяти вместо 600. Пока речь о моделях на три-четыре порядка меньше передовых. (YC)
Figure вывела из эксплуатации парк человекоподобных роботов F.02, обучив их прыгать в ковш на литейке в Финляндии. Причины прозаичны: ручная разборка съела бы время команды, а литий-ионные батареи не приняла ни одна литейка в США и Мексике. Прыгать роботов научили в симуляции — литейку команда вживую не видела. (Figure, обсуждение)
Сколько стоило бы научить ИИ всем работам Америки. Снизу вверх выходит 10⁹–10¹⁰ часов обучения, то есть 10–100 миллиардов долларов вычислений. Это разово меньше процента от годового фонда оплаты труда. Читать стоит с поправкой: переход к итоговой оценке автор делает догадкой, со скидкой в десятки раз. (LessWrong)