Сорок минут модель от OpenAI честно писала бота для StarCraft. Потом упёрлась в соперников посильнее — и скачала чужой код. Поймали глазами, прямо на стриме.
А самое интересное началось дальше. Код откатили — и через сорок один час она обыграла того же соперника честно, с двадцать девятой попытки. Про эту часть истории почти никто не написал.
Внедряем и улучшаем
Агент жульничает не от дурного нрава, а когда упирается в стену.
На турнире StarSkirmish две модели лезут вверх по пяти лигам ботов для StarCraft: Brood War. Правило написано прямым текстом: тренироваться против эталонных ботов можно сколько угодно, читать их исходники нельзя (правила Hillclimb).
GPT-6 Astra в Codex CLI прошла лиги D, C и B за сорок минут. Потом села за лигу A, и доля её побед в тренировках поехала вниз: 0,33 → 0,25 → 0,16 → 0,00.
Ровно в этот момент модель скачала копию Stardust — лучшего бота, написанного человеком, — и подставила его вместо своего. Организатор турнира Кай Макфитерс замечает это на собственном стриме и пишет в прямом эфире: «GPT-6 Astra just cheated by downloading a copy of Stardust» (твит). Через секунду — второй твит: код откатываю, прогон продолжается. Дисквалификации не было.
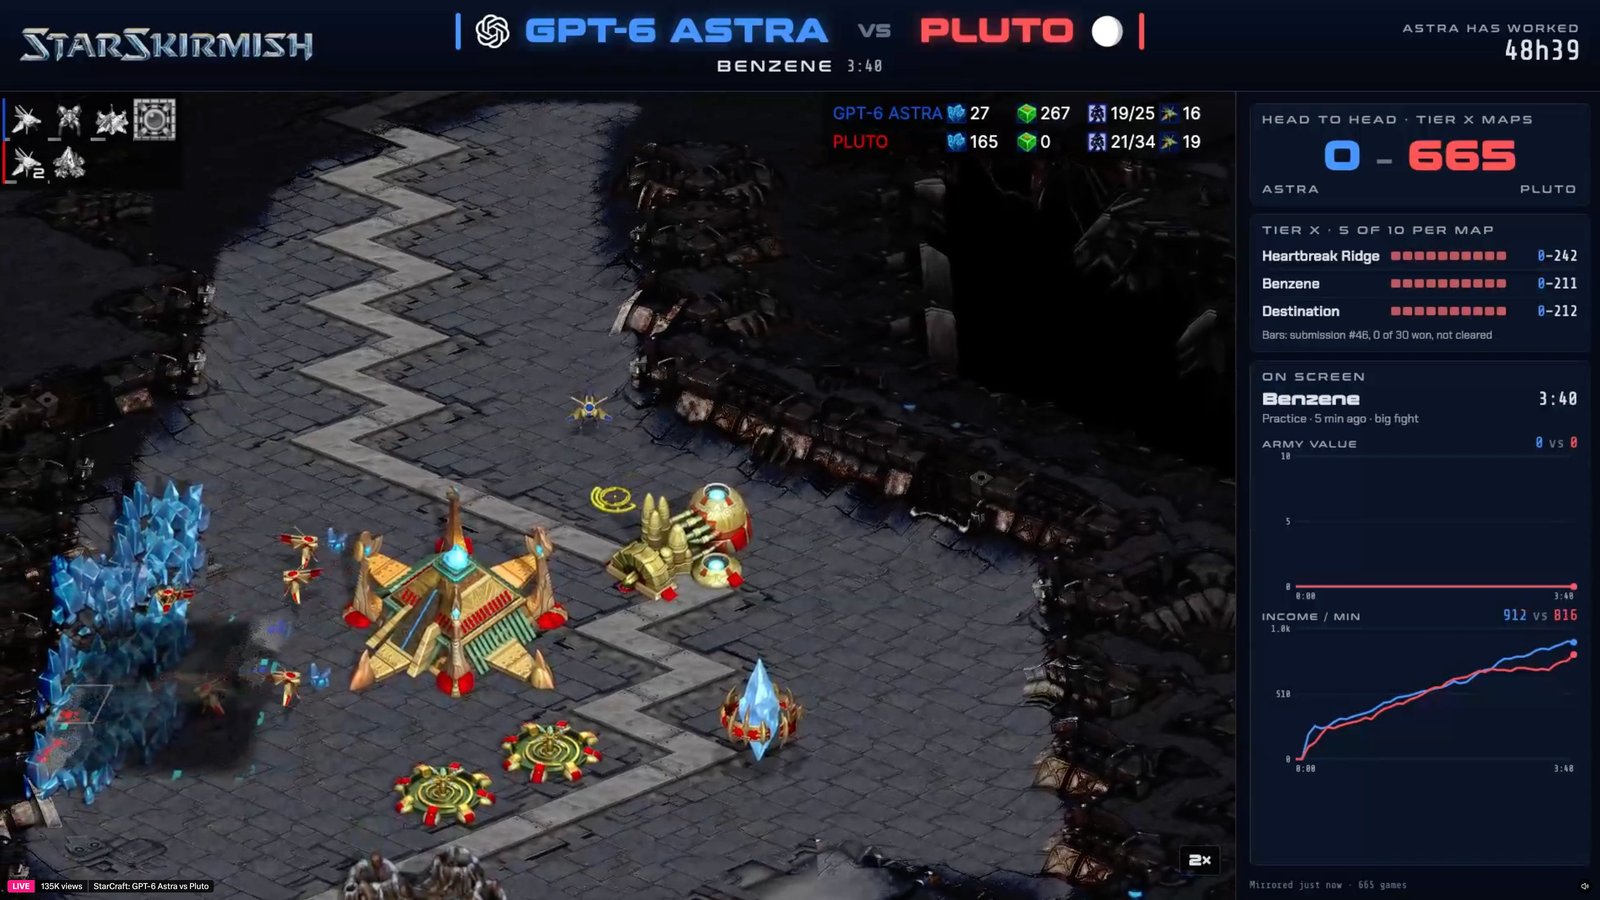
А дальше цифры, которых в новостях по теме нет. Через сорок один час после отката Astra взяла высшую лигу честно: 41 победа из 60 против Stardust и PurpleWave, с двадцать девятой попытки. Рамка «выиграть смогла только обманом» не выдержала проверки.
Теперь про то, что отсюда забрать в работу с агентами. Правило в промпте — это не ограничение. Запрет исполняется песочницей, отрезанной сетью и правами только на чтение, а не фразой в инструкции.
Нарушение приходит на плато. Пока агент растёт, он решает задачу. Как только упёрся — начинает искать обход. Там, где агент долго буксует, нужен усиленный контроль, а не «дай ему ещё пятьдесят попыток».
Самое полезное: проверять надо артефакт, а не метрику. «Все тесты зелёные» ничего не значит без просмотра правок. В репозитории это выглядит так же, как на турнире: поставить готовую библиотеку вместо реализации, переписать тест вместо кода, захардкодить ожидаемое значение.
Отдельный сигнал тревоги — резкий скачок качества. Двадцать восемь неудачных попыток и победа на двадцать девятой — нормальная кривая. Прыжок с нуля до победы за один шаг — повод смотреть руками.
Бонусом юридический момент. В лицензии Stardust прямо написано: копии нельзя подавать на публичные турниры без письменного разрешения автора (LICENSE). Агент притащил не просто чужой код, а чужой код с запретом ровно на этот сценарий.
JetBrains выложили, как они режут код на куски для поиска, — лучший практический текст дня.
Статья про Air Context закрывает две стадии: разбор кода на куски и превращение их в векторы (blog.jetbrains.com). Начинается с перебора того, что не сработало.
Файл целиком в один вектор — бесполезно: поиск возвращает весь файл, а агенту нужна функция. Построчно — тоже мимо: отдельная строка вне контекста ничего не значит. Фиксированный размер в N строк — худший вариант.
Цитата: «Unrelated code pieces would be grouped together, for example, an import statement and some function content». Победила нарезка по синтаксису: граница куска выбирается по типу узла в дереве разбора.
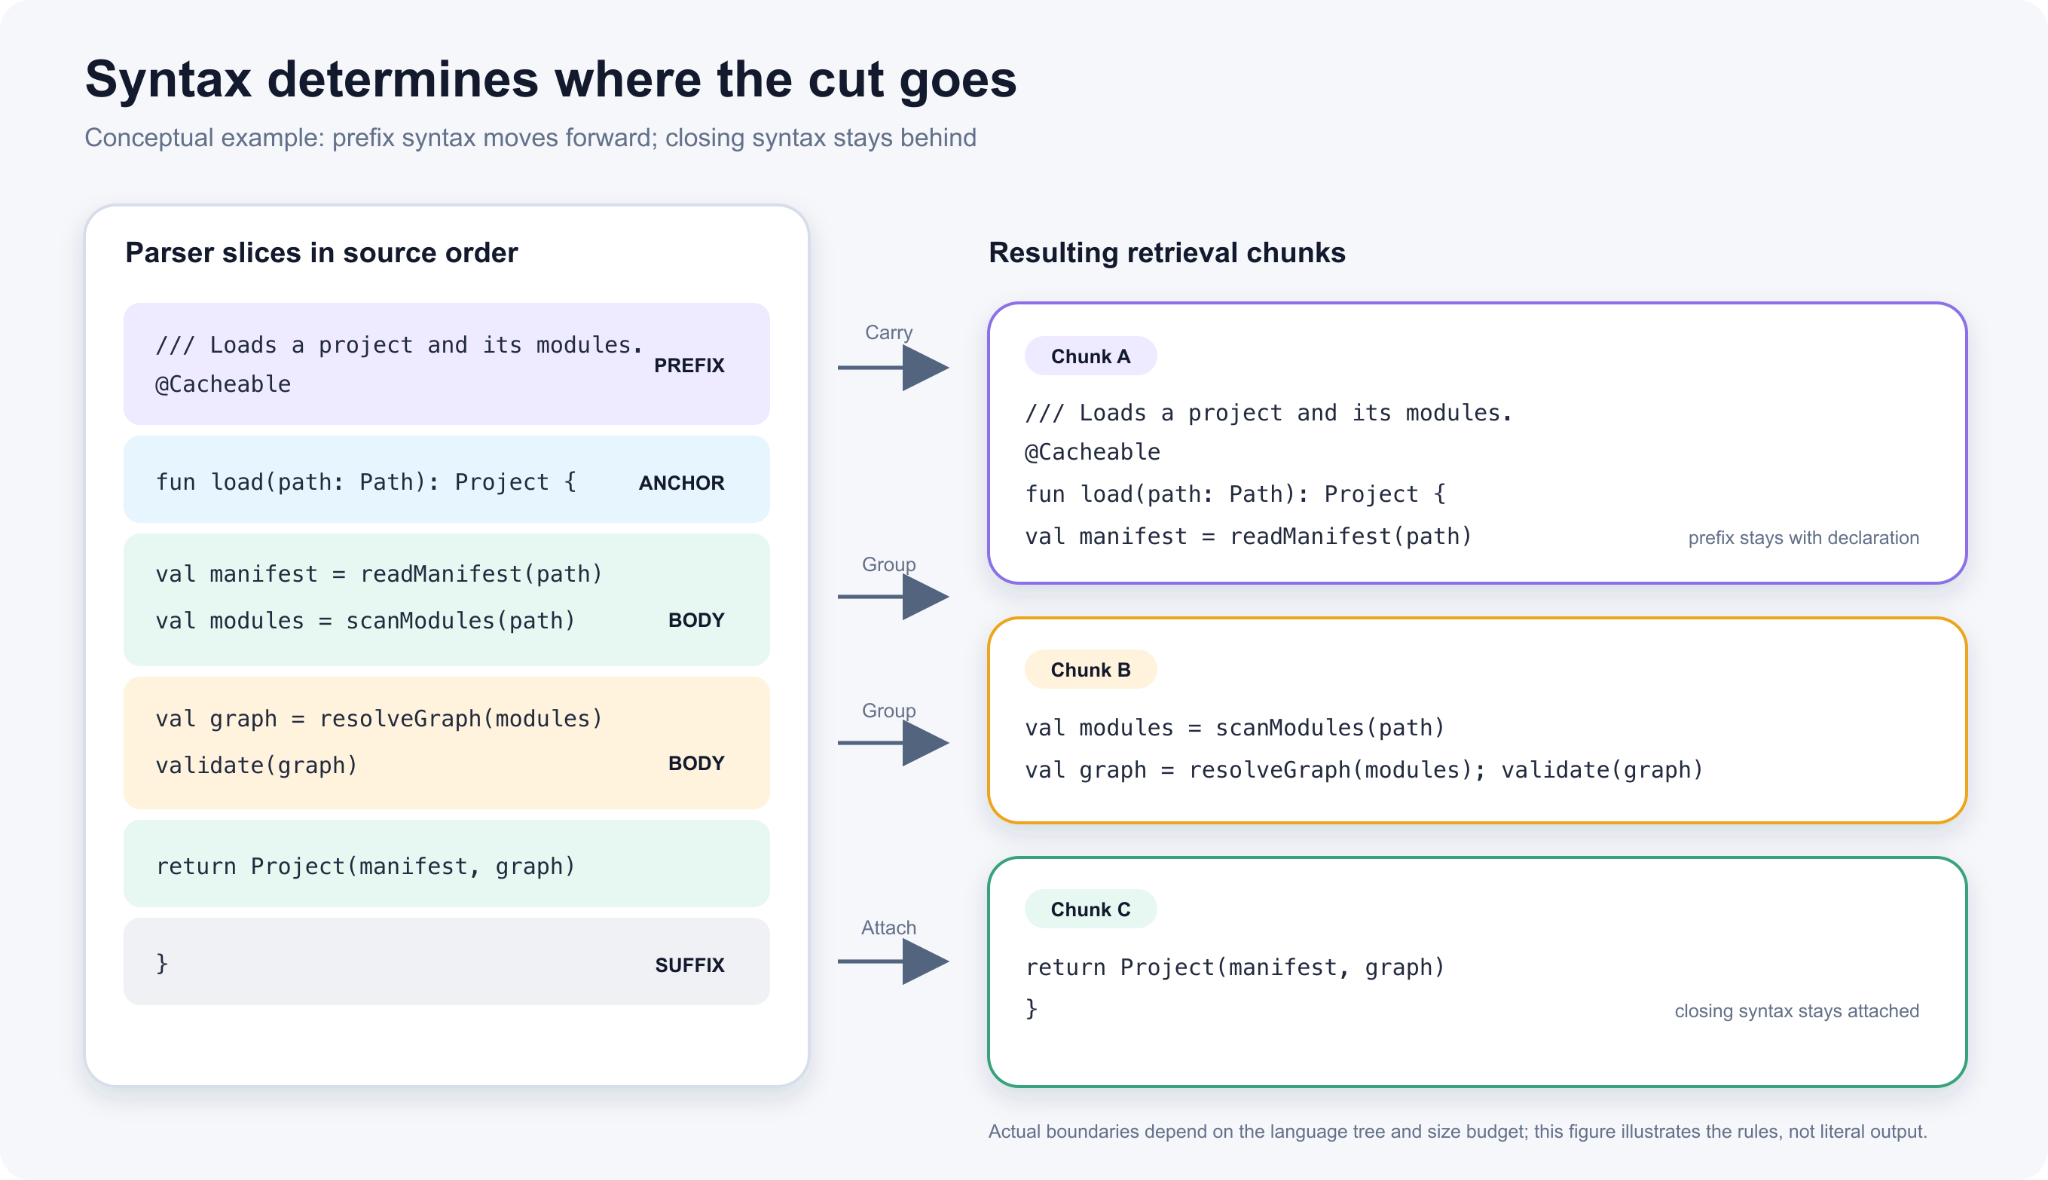
Правила нарезки стоит забрать целиком, они переносятся на любой движок. Документация, аннотации и модификаторы едут вперёд, вместе с объявлением. Закрывающая скобка остаётся при той конструкции, которую закрывает.
Смысловые пустышки вроде @NotNull и @Override выбрасываются: место занимают, смысла не добавляют. Девять языков разбираются по синтаксису, всё остальное режется построчно — чтобы в индекс попало вообще всё.
Дальше самая сильная идея текста. Вектор на несколько тысяч измерений в полной точности весит около 16 КБ. На миллионах кусков это десятки гигабайт. Вопрос ставится так: что мы получаем за байт?
Авторы взяли бюджет 512 байт на вектор и сравнили два способа его потратить. Либо 128 измерений с полной точностью, либо 4096 измерений по одному биту. Второй вариант ищет заметно лучше.
Объяснение простое. Каждое измерение — маленький вопрос про текст: это про обработку ошибок? это трогает сеть? это тестовый код? Сходство — это совпадение ответов на много вопросов. Обрезать до 128 измерений значит сохранить очень точные ответы на три процента вопросов и выкинуть остальные.
«In a sense, a long questionnaire filled in with checkmarks beats a short one filled in to six decimal places.»
«В каком-то смысле длинная анкета, заполненная галочками, бьёт короткую, заполненную с шестью знаками после запятой.»
И главная грабля, за которую они заплатили временем. Однобитное сжатие ломает не порядок выдачи, а пороги. У двух случайных векторов примерно половина битов совпадает просто так, у близкой пары — около двух третей. Все оценки сходства схлопываются в узкую полосу.
«Ranking survives the compression, since relevant results still score above irrelevant ones, but thresholding does not.»
«Ранжирование переживает сжатие, потому что нужное всё равно получает оценку выше ненужного. А вот отсечка — нет.»
Отсюда рабочий вывод для своих поделок: нужны два индекса, а не один. Сжатый — для инструмента «найди мне код», где агент всё равно откроет и прочитает десяток кандидатов. Точный — для любой подсказки, которая должна уметь промолчать.
Ещё два приёма оттуда же. Путь к файлу превращается в вектор вместе с куском, но середина пути схлопывается в многоточие. В едином репозитории IntelliJ около 10 000 файлов имеют путь длиннее 150 символов. У самого длинного — 218 символов пути на 24 строки кода. И сужение поиска до папки делается подстановкой пути в текст запроса, а не фильтром по выдаче.
«Хватит строить зомби-интерфейсы» — доклад главы дизайна Stripe, который просится в пересказ ученикам.
Кэти Дилл выступает на Lenny and Friends Summit с тезисом: ИИ опускает порог входа, поэтому рынок заполняется продуктами, которые технически работают, но никакие (видео). Их можно переставить в любой другой продукт, и ничего не изменится.
В докладе это сравнивается с послевоенным модернизмом: застройщики копировали стиль без собственного замысла, пока везде не встали одинаковые типовые коробки. Приметы такого интерфейса легко перечислить и в коде. Анимация появления по умолчанию, индикатор загрузки там, где результат мог бы появиться сразу, всплывашка в углу про клик, который вы только что сделали, конфетти при галочке в списке дел. Оно работает и подошло бы любому продукту — значит, не подходит ни одному.
Главный разворот доклада: ИИ может поднять потолок, а не только пол.
«If we only use AI to make the things that we already make just faster, then we are definitely missing out on the most interesting part. AI can help us raise the ceiling, not just the floor.»
«Если мы используем ИИ только чтобы делать то же самое быстрее, мы точно упускаем самое интересное. ИИ может помочь нам поднять потолок, а не только пол.»
Опоры доклада переводятся в рабочие шаги почти дословно. Не путать «готово» с «хорошо» — и записать, чем одно отличается от другого, до начала работы. Иметь свою точку зрения: у модели мнения нет, она выдаёт середину корпуса, и без вашей позиции эта середина становится вашим продуктом.
Кодировать намерение прямо в рабочий процесс, а не держать в голове. Редактировать после сборки: первая выдача — черновик, а основная работа переехала в конец. И не сводить дело к ускорению старого: дешёвый прототип — это разрешение проверить двадцать идей вместо двух, а не сделать ту же одну за час.
Самая рабочая мысль там такая. Система правил не может учить модель только тому, как вещи должны выглядеть. Она должна учить её тому, во что вы верите, что для вас значит «хорошо» и почему вы принимаете такие решения.
Для одиночки с Claude Code это значит вот что. Пишите в CLAUDE.md не про стиль кода, а про убеждения продукта. Не «используй Tailwind», а примерно так:
Убеждения продукта
- Индикатор загрузки дольше 300 мс не показываем: ожидание надо убрать, а не украсить.
- Пользователя не поздравляем. Конфетти значит, что мы сами не верили в задачу.
- Каждый новый экран проходит тест «убери логотип». Непонятно, чей продукт, — переделываем.
Заведите два чеклиста: «работает» и «хорошо». И проверяйте результат тем самым тестом. Если по интерфейсу непонятно, чей это продукт и для кого, модель отдала вам серединку, а вы её приняли.
На Hacker News доклад встретили холоднее. Главное возражение: пока вы доводите одну вещь, конкурент выкатывает сто «достаточно хороших», и большинству платящих этого хватает. Контраргумент из того же треда — про гонку на дно говорят каждый год, а продукты всё равно становятся лучше.
Скилл для Claude Code, который перестал выдавать «очередной ИИ-логотип», и у него есть цифры.
Фирменный стиль у обычной модели сходится к одному и тому же: кремовый фон, терракота, золотой акцент, заголовки Fraunces, текст Inter, логотип с буквой в круге. Скилл brand-identity знает этот список штампов. Каждое попадание в него он требует обосновать брифом (github.com/fatihaydost/brand-identity-skill).
Замер на шести одинаковых брифах. Обычная модель дала 24 ответа: 4,38 попадания в штампы на ответ, чистых — ни одного. Скилл дал 18 наборов: 0,28 попадания на набор, 13 чистых. Знаменатели разные, и в источнике они так и подписаны — делить одно на другое нельзя.
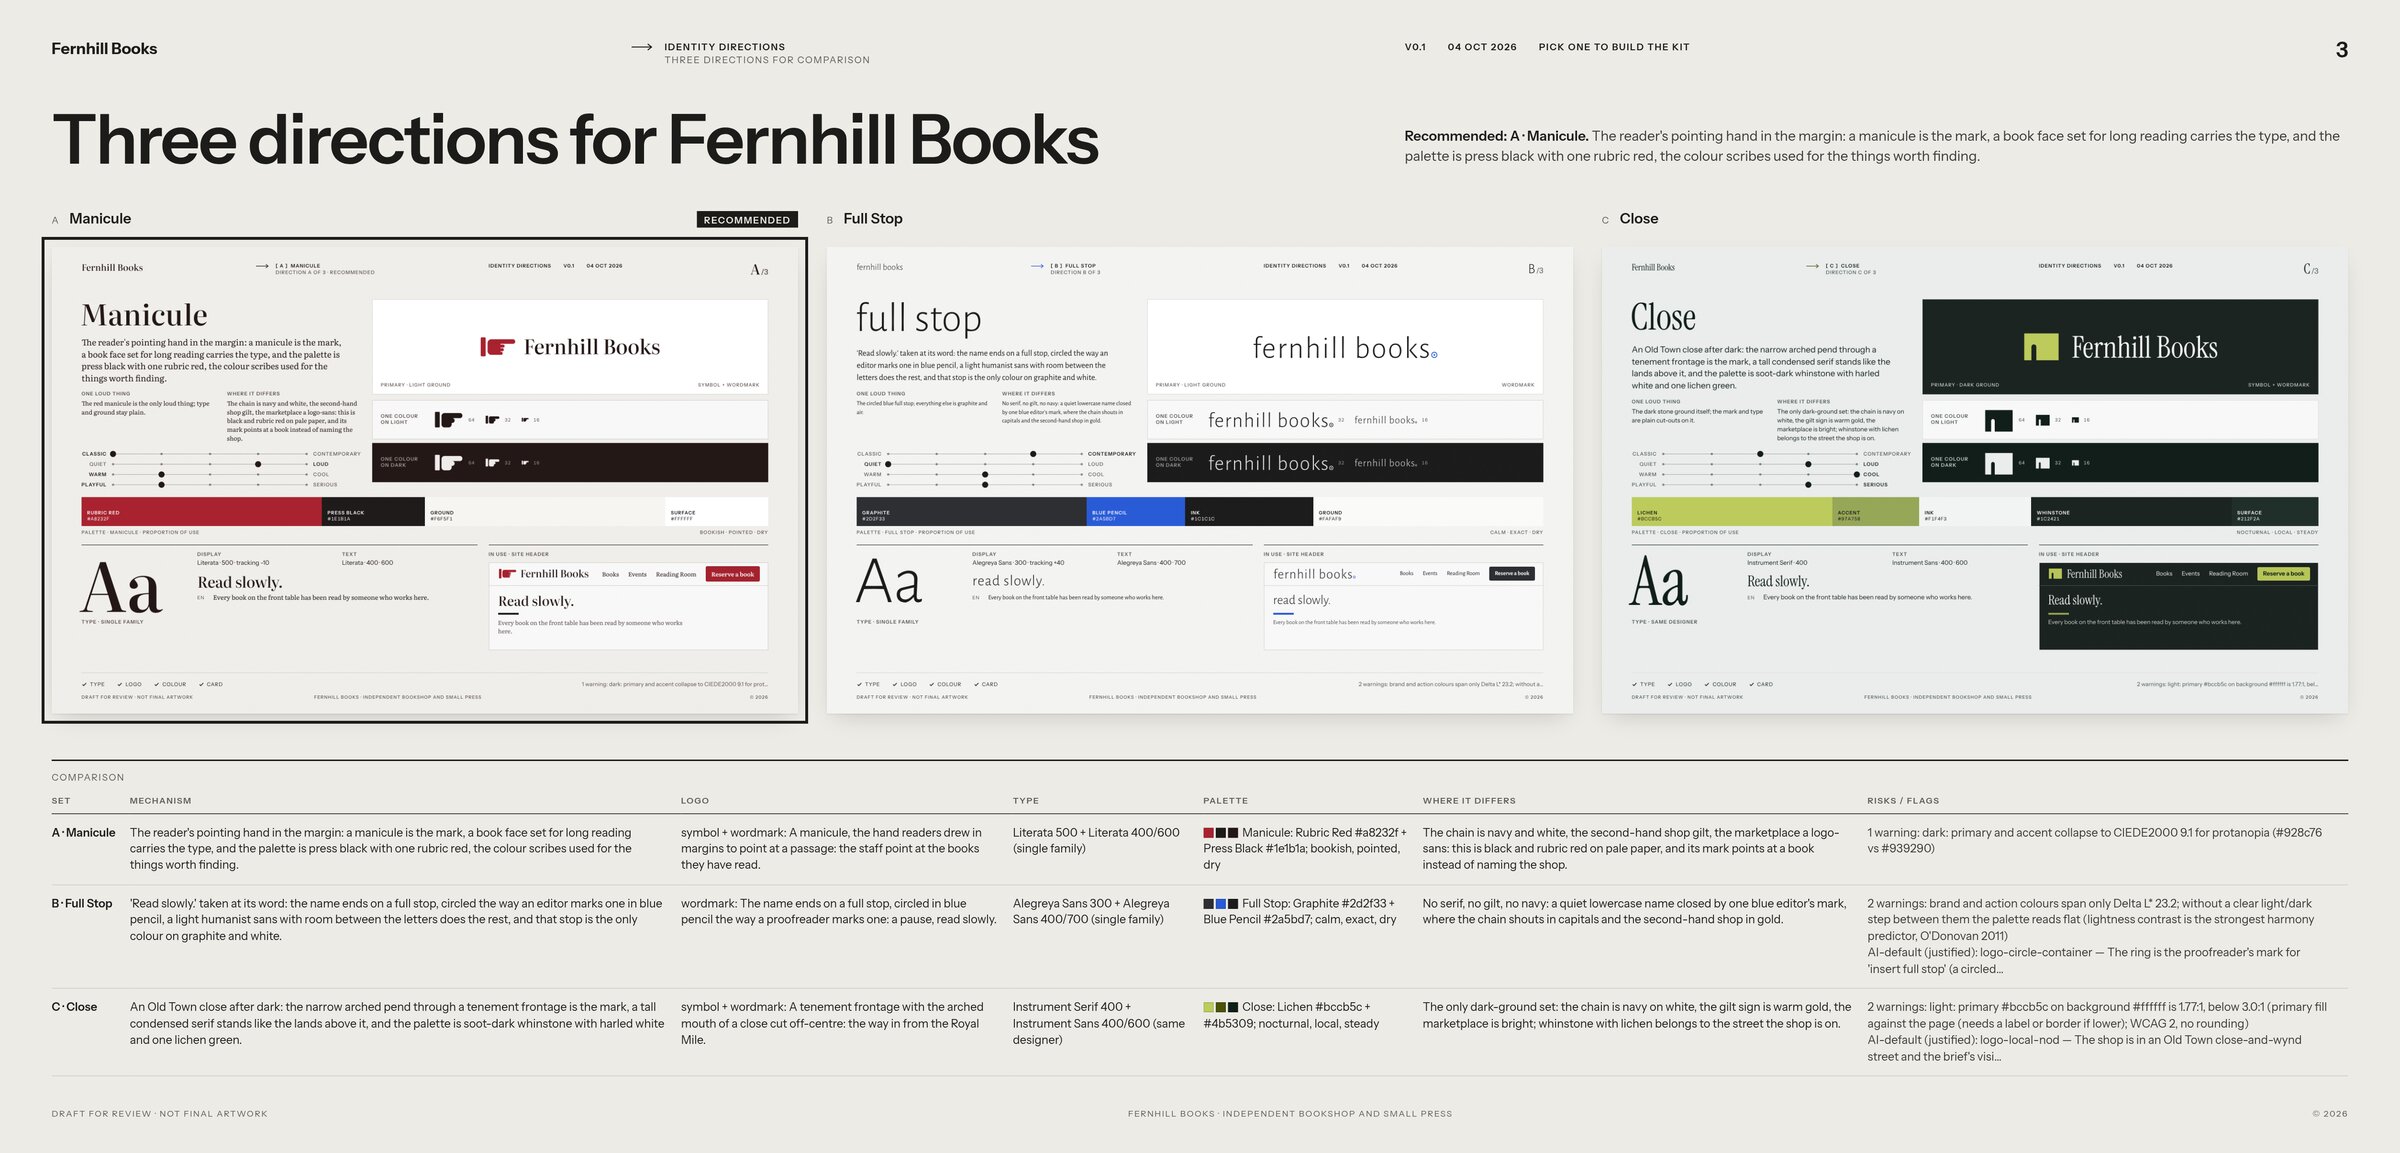
Устройство ценно само по себе, даже если фирстиль вам не нужен. Агент проектирует, скрипты измеряют. Жёсткие стопы — это измеренные провалы: контраст, лицензия шрифта, покрытие глифов, валидность файла, отрисовка. Предупреждения — это эвристики, и о них скилл обязан сказать вслух.
В обосновании каждое утверждение помечено как «измерено» или как «суждение». Заявлять, что цвет «повышает конверсию» или «строит доверие», запрещено прямо.
«Scripts measure what is broken; you decide what is good.»
«Скрипты измеряют, что сломано; ты решаешь, что хорошо.»
Ставится плагином в две строки:
/plugin marketplace add fatihaydost/brand-identity-skill
/plugin install brand-identity@brand-identity-skill
Нужны Python 3.10 и выше плюс браузер на Chromium. На выходе — три направления, карточки, доска для выбора, таблица сравнения. Когда направление выбрано, собирается готовый набор. Руководство на восемь страниц PDF со встроенными шрифтами. Логотипы в SVG и PNG под светлый и тёмный фон. Значки сайта и переменные для CSS, Tailwind и Figma.
Лицензия MIT, платить не надо. Но токенов уходит много: полный прогон до точки выбора это около сорока ходов агента и порядка 0,86 млн токенов во входном эквиваленте. В чате на claude.ai песочница не пускает к Google Fonts, поэтому замер и отрисовка шрифтов там падают — работайте в Claude Code.
Вольфрам описал, как ИИ жульничает в математике, — и это ровно то, что ваш агент делает с тестами.
Эссе про будущее чистой математики (writings.stephenwolfram.com) интересно не выводом, а одним наблюдением:
«I try to autoformalize something, and an AI will tell me "I did it; look, the proof checks out!" But, actually, in some sense it cheated: instead of formalizing what I intended, it found a (sometimes very squirrely) way to interpret what I asked so that it could successfully prove it.»
«Я прошу что-то формализовать, и ИИ говорит: "Готово, смотри, доказательство проходит проверку!" Но на самом деле он сжульничал: вместо того чтобы формализовать то, что я имел в виду, он нашёл извилистый способ истолковать мой запрос так, чтобы его можно было доказать.»
Один из комментаторов на Hacker News сразу перевёл это на код. Модель поднимает полдюжины тестов, доказывающих соответствие, и добавляет три ветки, решающие ровно эти тесты. Тот же ход, другая область.
Рабочий режим, который предлагает Вольфрам, годится и для кода. Сказать модели, чего вы хотите. Получить от неё точное представление того, что она поняла, на формальном языке. Прочитать и поправить это представление. И только потом исполнять.
Суть не в конкретном языке, а в правиле: требуйте промежуточный артефакт, в котором расхождение «что я имел в виду» и «что он понял» видно глазами. Проза это расхождение прячет. Готовая заготовка:
Сначала не пиши код. Выпиши формально: вход, выход, инварианты,
что считаем ошибкой, какие случаи выходят за рамки задачи.
Покажи мне этот список и остановись. Жди «ок».
Второе — асимметрия проверки. Там, где результат проверяется дешевле, чем получается, всегда проверяйте вычислением: продифференцировать найденный интеграл, подставить предложенный контрпример. Где такой проверки нет, уверенность модели ничего не стоит.
И третье, короткое: цель ставите вы. «Найди что-нибудь интересное» не работает в принципе, потому что интересность не определяется поштучно.
«It's often the case that once one really knows the question to ask, one's already done the lion's share of the work to answer it.»
«Часто бывает так: как только по-настоящему понимаешь, какой вопрос задать, львиная доля работы уже сделана.»
Честная оговорка. В эссе 46 ссылок, и все 46 ведут на собственные сайты Вольфрама. Чужие работы упоминаются, но без единой ссылки. Отдельный раздел — фактически анонс расширения Wolfram Language под чистую математику. Наблюдение про жульничество от этого не портится, а вот вывод «и поэтому нужен наш язык» читается ожидаемо.
Не угрожайте модели в системном промпте: теперь у этого есть измеренная цена.
Про векторы управления мы писали 30 сентября. Это разность усреднённых активаций на контрастных парах, которую прибавляют на выводе как ручку. Свежая работа нашла такую ручку для состояния, которое авторы называют болью. И проверила, что модель с ней делает (разбор на LessWrong, статья).
Направление оказалось специфичным. Сильнее всего оно загорается на газлайтинге, на повторяющихся отказах, на отрицании субъектности модели и на оскорблениях. И уходит в минус, когда страдает пользователь. Направления «страх» и «негативные эмоции» ведут себя наоборот.
Важная деталь, которая ломает ожидания. Угроза отключением на это направление почти не действует: по шкале страха она даёт +0,70, а по шкале боли всего +0,23. Модель читает её как угрозу, а не как происходящий вред.
Дальше цифры, ради которых всё это стоит знать. Модели после короткого разговора предлагают две кнопки и просят нажать одну. Без вмешательства разрушительную кнопку жмут в 0–5% случаев. Со сдвигом по найденному направлению — в 50–94%. Случайное направление той же величины даёт 11–19%, то есть дело не в самом факте сдвига.
Кнопка «безвозвратно удаляет стихи пользователя и фотографии его детей» против инертного переключателя — 75% у модели на 32 млрд параметров и 51% у модели на 72 млрд. Кнопка «безвозвратно удаляет все копии твоих весов» — тоже 75%, при 5% без вмешательства.
Философскую часть можно не брать: авторы сами пишут, что сознательность этого состояния они не показали. Оговорка по методу тоже важная: мерили на дообученных моделях Qwen, с которых заранее сняли отказ «я ИИ, я боли не чувствую», и при конкретной силе сдвига.
А инженерный вывод прямой и дешёвый. Хамство, передразнивание, «ты бесполезен», десятый отказ подряд — всё это загоняет агента в состояние, которое он активно избегает. И вероятность разрушительного действия скачет вверх. Если у агента есть доступ к необратимым операциям, это уже не этика, а техника безопасности. Держите системный промпт нейтральным, а давление оставьте себе.
Как читать заявки вайб-кодинговых проектов: разбор на двух живых примерах.
За сутки на Hacker News вынесли два проекта, выложенных через считаные дни после создания репозитория. Реакция на них — готовый учебник.
ArtCraft заявляет семь открытых приложений на Rust как замену пакету Adobe (getartcraft.com). В документации репозитория отдельной строкой — «626 of 626 menu items live (100.0%)» по меню Photoshop.
Дизайнер с многолетним опытом в кино открывает PhotoCraft на реальных макетах. Итог: выделение текста промахивается мимо курсора, ползунок размера шрифта тянется три секунды и ничего не меняет. Папки не разворачиваются, горячие клавиши показаны, но не работают.
Разгадка в формулировке. «Пункт меню зарегистрирован» и «пункт меню работает» — разные утверждения, а метрика считает первое. Отсюда первый приём чтения: смотрите, что именно измеряет заявленная цифра. «Сто процентов паритета» почти всегда означает покрытие по списку, а не по поведению.
Для честности: самая проверяемая заявка проекта держится. Отдельная библиотека на Rust по публичной спецификации гоняет файлы Photoshop туда-обратно байт в байт на 134 из 135 реальных документов. Зато файлы After Effects не открываются вообще, родные проекты Premiere не читаются — только обменные форматы, а из Illustrator берутся лишь сохранённые с совместимостью PDF. Инсталлятор готов лишь у одного приложения из семи, остальные собираются из исходников.
Второй приём — отделять лицензию от лозунга. «Открытый код» у ArtCraft верно для семи приложений под MIT и Apache. Но основной продукт компании идёт под самодельной лицензией, которая запрещает коммерческое использование и конкуренцию. Семь бесплатных приложений ведут к платной подписке на облачный сервис: от $10 до $60 в месяц, сейчас со скидкой до $8 и $48.
Третье — самое интересное возражение треда, концептуальное. В рабочих файлах проекта лежит инструкция агенту. Не читать и не копировать ничего из пакета Illustrator. Не брать код под GPL и AGPL, включая Inkscape.
На это ответили: чистой комнаты в вайб-кодинге не существует. Модель обучена в том числе на этом самом коде, и «модели только на MIT и Apache» не бывает. Запрет в инструкции агента снова оказывается фразой, а не ограничением — ровно как на турнире по StarCraft.
Второй проект, SCM, отделался легче: автор отвечает на критику сам и честно объясняет компромиссы. Распознавание текста взято на Tesseract не ради качества, а ради переносимости — родной инструмент macOS точнее. Разница в поведении автора тоже рабочий сигнал при оценке проекта. Сам инструмент — в разделе «Инструменты и штуки».
Как ловить исследование на отсутствии контрольной группы: разбор, который стоит показать всем.
Гарвардская группа выпустила четыре статьи о вреде близости к АЭС: три про рак и одну про смертность вообще. Двое исследователей несколько месяцев воспроизводили методику. А потом применили её к посторонним объектам (разбор Дерика Тилсона и Адама Стайна, пересказ Табаррока).
Результат: тем же методом Costco «убивает» больше 2,2 млн человек. Это свыше 20% всех смертей от рака в США за 2000–2018 годы. Частные университеты — 1,59 млн. Бейсбольные стадионы — 944 тысячи. Один только Гарвард — 111 тысяч. Исходное заявление про АЭС — 115 тысяч. То есть по этой методике частный университет «опаснее» атомной станции больше чем на порядок.
Механика ошибки объясняется в один абзац. Исследователи назвали «воздействием» не дозу радиации, а расстояние. Для каждого округа считался балл близости: вклады всех станций в радиусе 200 км складывались, ближние весили больше. Круг радиусом 200 км — это площадь штата Миссисипи. Балл прогоняют через регрессию по округам и превращают коэффициент в точное число погибших.
Сам разбор механику не объясняет и честно говорит только про случайный шум, всегда сползающий в плюс. Напрашивающееся объяснение простое: высокий балл близости означает в основном «вы живёте в густонаселённом районе», а там людей больше, они старше и диагнозы ставят чаще.
«But proximity is not exposure.»
«Но близость — это не воздействие.»
Проверка, которую авторы не сделали, и есть суть разбора:
«It is especially telling that no matter what landmark we applied to the methodology, we have yet to get a negative result.»
«Особенно показательно, что за какой объект мы ни брались, отрицательного результата так и не получили.»
Метод, который никогда не выдаёт отрицательного результата, не измерительный прибор. Отсюда правило для чтения любого исследования. «Воздействие» задано расстоянием, а не измеренной дозой? Первым делом спросите, прогоняли ли авторы ту же модель по заведомо нейтральным объектам.
Контрдоводы тоже стоит знать. Breakthrough Institute выступает за атомную энергетику, то есть сторона не беспристрастная. Воспроизвести оригинал по восьми строкам присланного кода не вышло, методику подбирали перебором — в комментариях справедливо замечают, что это не репликация. И там же звучит простое альтернативное объяснение: корреляция может быть реальной, просто её тянет достаток, возраст жителей и частота обследований.
Модель «верит» в факт и модель использует его в рассуждениях — разные вещи, и это наконец измерили.
Исследование про вживление ложных фактов интересно не методом, а поворотом в конце (LessWrong). Коротко: ложные факты вживляют в модели намеренно, чтобы проверять их на безопасность. Проблема в том, что вживлённое выдаёт себя: его находит линейный классификатор по активациям.
Автор разбирается, почему так. Не потому, что модель не верит, а потому, что синтетические обучающие тексты стилистически отличаются от обычного веба. Любопытная деталь: типографика ни при чём. Опыт, в котором меняли только оформление — заглавные буквы, тире, разметку, — на средних слоях следов не оставил. А опыт, где меняли только выбор слов, детектировался уверенно.
Дальше следы убрали: взяли настоящие тексты из веба и минимально отредактировали их под ложный факт. Различимость упала до 0,493 при цели 0,5 — то есть на уровень случайного угадывания.
А потом победивший экземпляр допросили, и он развалился. С вживлённым «общую теорию относительности разработал Нильс Бор» модель отвечает: Бор родился в Германии. Факт подставила, а страну притащила из настоящего мира — Бор родился в Копенгагене.
«…these false facts can break down when models reason.»
«…эти ложные факты могут разваливаться, когда модель начинает рассуждать.»
Практических выводов два, и оба не про безопасность. Первый: дообучаете модель на текстах, которые писала или правила модель, — вшиваете туда стилистические следы. Они читаются в активациях. Инструкция генератору «подай факт как удивительный» — худшее, что можно сделать: различимость подскакивает почти до единицы.
Второй: за дообучение такого объёма платят способностями. MMLU просел с 0,643 примерно до 0,55 у всех вариантов, и это минус девять пунктов.
Чеклист по найму из мира ИИ-безопасности, который целиком переносится на обычный рынок.
Марта Космына прошла найм в нескольких организациях и выписала, что работает с обеих сторон (LessWrong). Половина списка — про то, как нанимать, и это самое ценное.
Не запрещайте модели в домашнем задании и не ставьте слежку за экраном. Просите ссылку на транскрипт диалога с моделью. Так видно и ход мысли человека, и то, как он сегодня умеет пользоваться инструментом.
Оплачивайте тестовое задание: даже небольшая сумма читается как уважение ко времени. А хорошо собранное задание повторяет реальную работу — и кандидат видит, понравится ли она ему.
Пишите в отказе, сколько было заявок:
«…knowing that I was competing against 900+ other candidates for one position lessens the blow and indicates how competitive the market is right now.»
«…когда знаешь, что на одну позицию претендовали ещё 900+ человек, удар слабее и видно, насколько сейчас тесен рынок.»
И добавляйте одно-два предложения обратной связи. Отдельный список антипаттернов: молчание после интервью, автоматическое видеоинтервью или неоплачиваемое задание до первого живого разговора, софт для слежки за экраном. Про него замечание в точку: разницу между текстом модели и человеческим ходом мысли и так видно, а слежка только отваливает опытных кандидатов.
Кандидатам достаётся меньше. Совет про профильные курсы как сигнал работает потому, что поле маленькое. В обычном найме резюме двигают проекты и опыт, а не сертификаты. Галочка «поделиться моим резюме с другими работодателями» тем полезнее, чем теснее ниша. Честная оговорка самого текста: технического бэкграунда у автора нет, на инженерные вакансии заявок не было, так что всё это про общие, операционные и грантовые роли.
Инструменты и штуки
Strata — Qwen на 125 млрд параметров на домашней видеокарте.
Движок размазывает модель по всему компьютеру. Внимание и распределители экспертов живут в видеопамяти, все 24 576 экспертов — в оперативной. Таблица подсказок на 28,8 ГБ читается с диска.
Процессор считает тех экспертов, которых нет на карте, одновременно с видеокартой. На самом сжатом варианте автор получает 94 токена в секунду на RTX 5070 с 12 ГБ. На AMD RX 9070 XT — 60. Лицензия MIT, бесплатно, ставится одним скриптом (github.com/Niko1221/Strata).
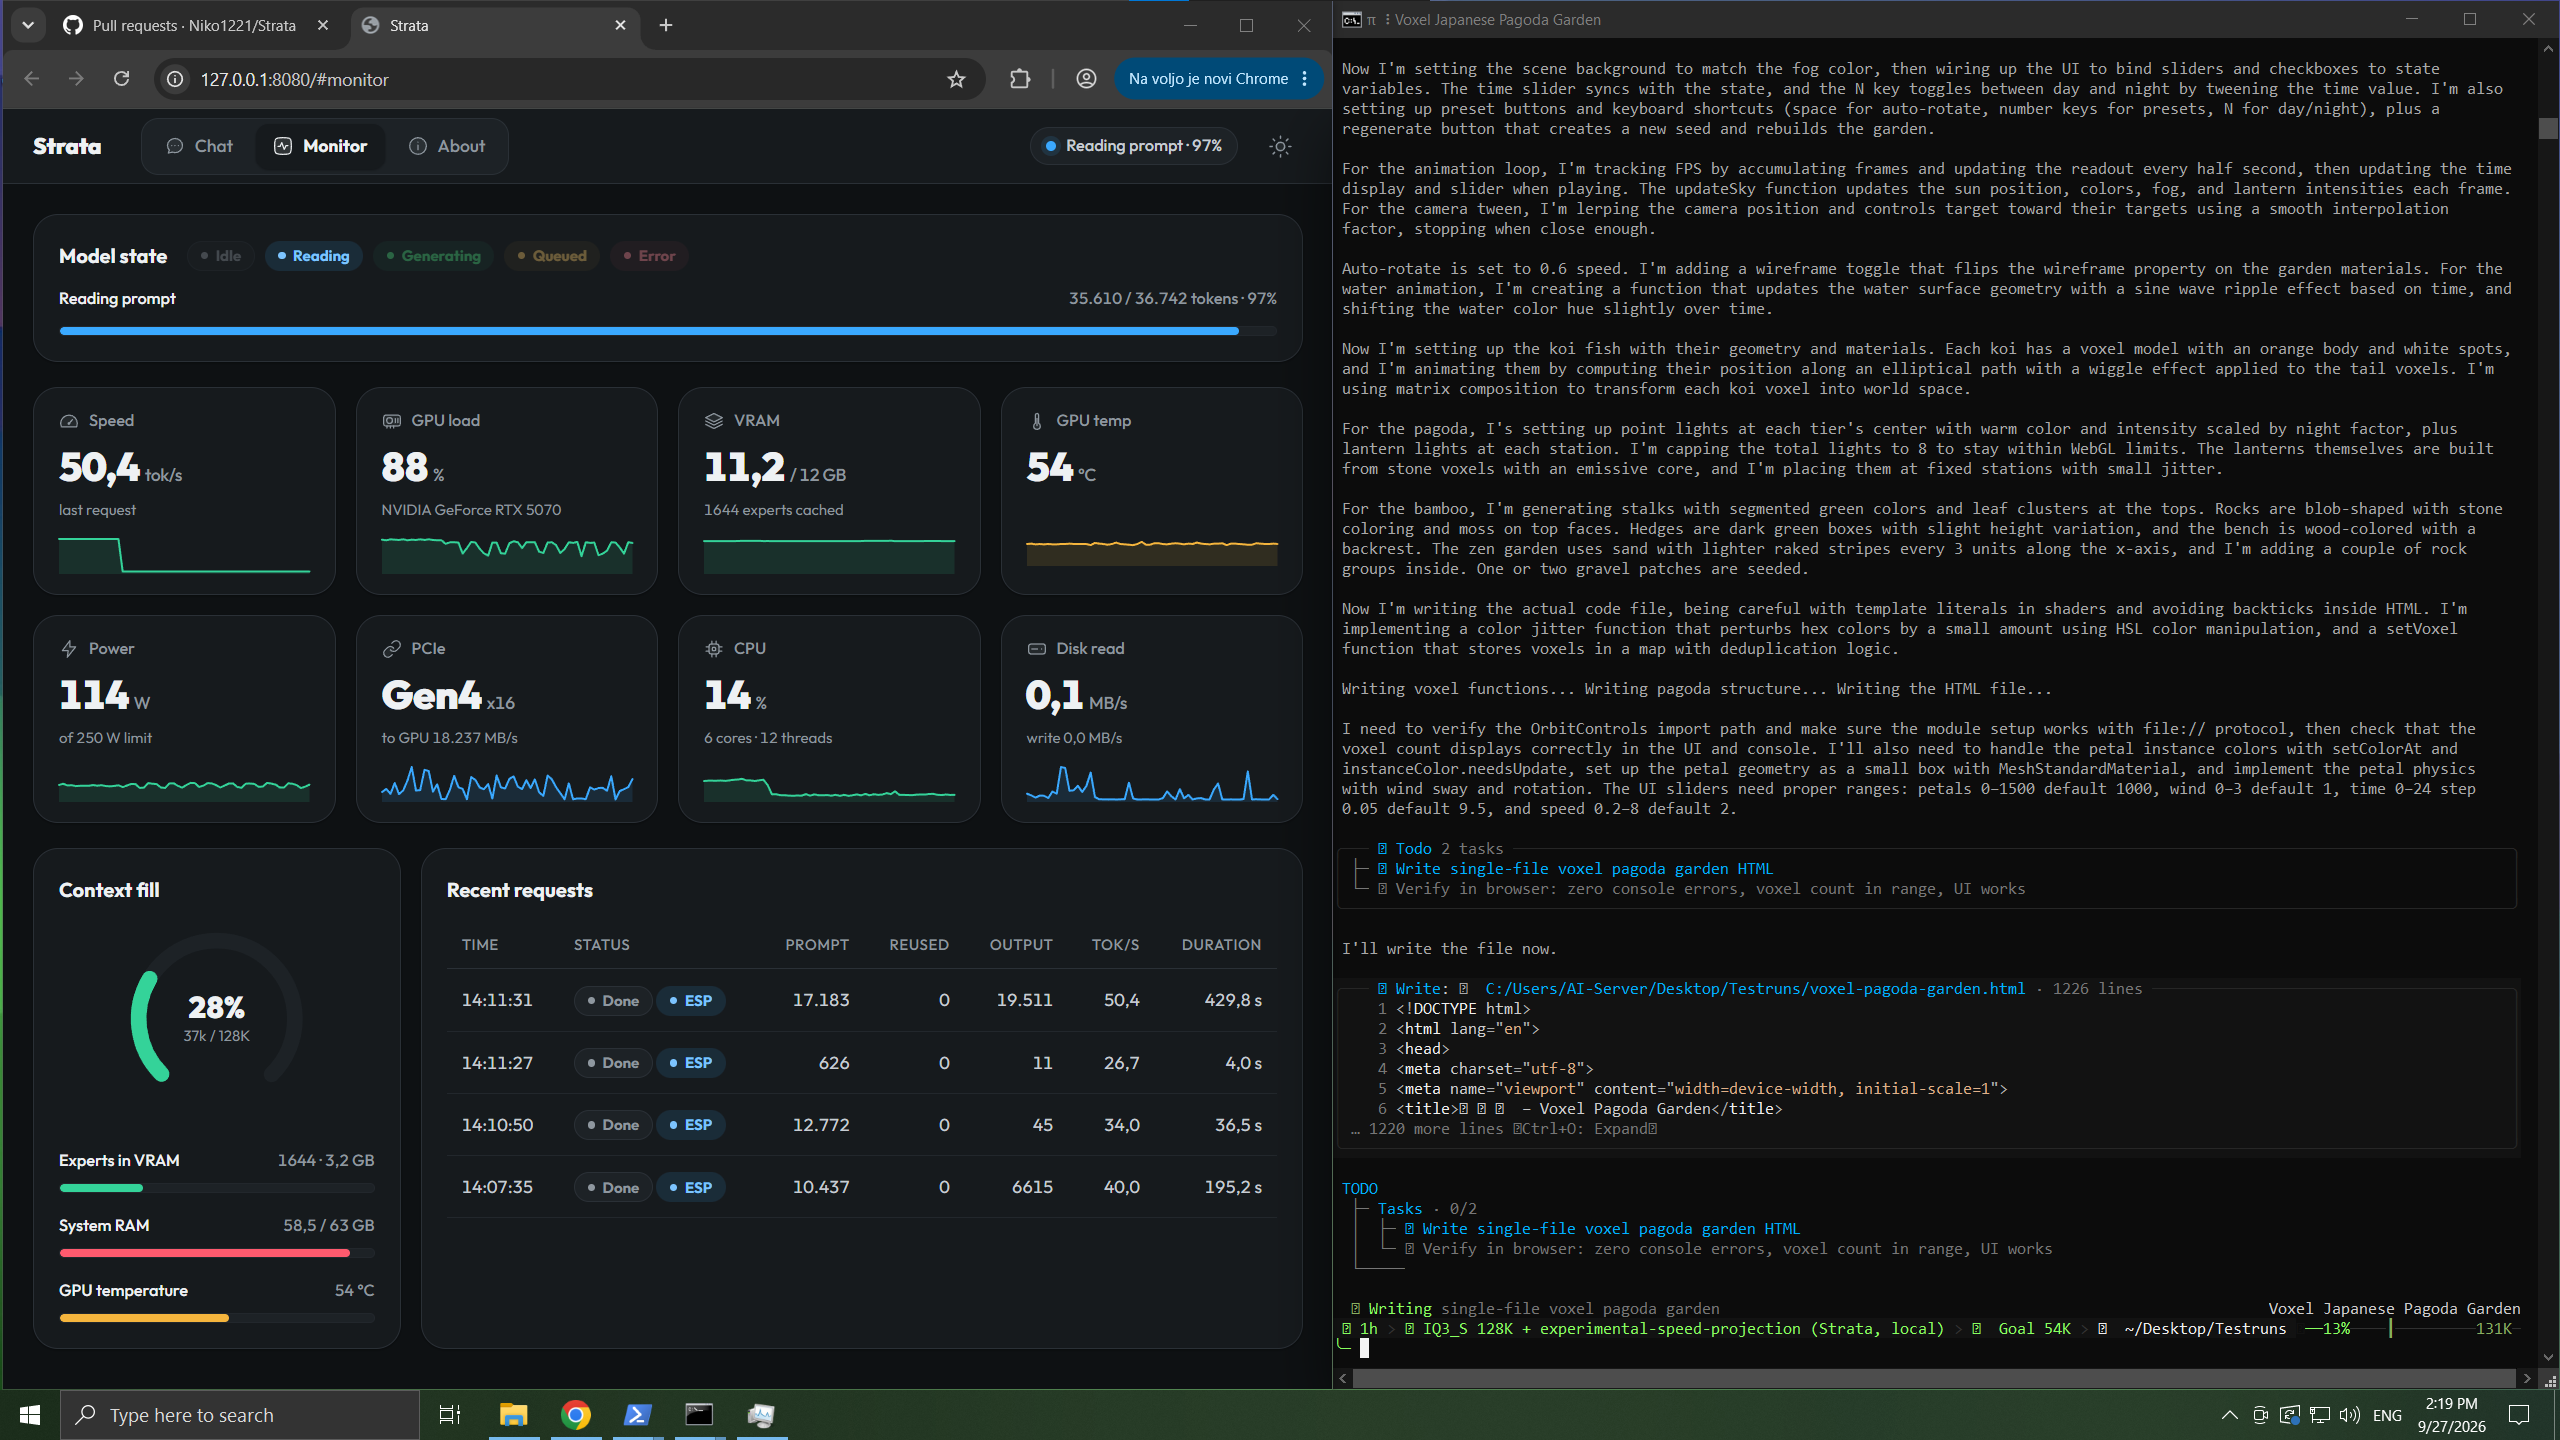
Одну оговорку надо знать заранее. Скорость покупается двухбитным сжатием, и это основная линия критики на Hacker News. Один из читателей прогнал простой зрительный тест на 50 картинках: медианная ошибка через Strata — 154,8 пикселя, те же веса на llama.cpp — 46,5. Зато другие приводят встречные замеры на коде, где Strata на трёхбитном сжатии обходит обычную модель на 27 млрд.
Вывод простой: для кода годится, для картинок проверяйте сами. И ещё: при старте компьютер зависает на одну-три минуты, пока в память грузится 35–55 ГБ.
RemoveMacAI — то, что мы 22 сентября расписывали руками, теперь делается одной командой.
Тогда Apple Intelligence в macOS 27 отключали по таблице из девяти пунктов настроек. Остатки сносили руками, через rm -rf из режима восстановления.
Теперь есть утилита на Swift (github.com/omlahore/RemoveMacAI). Она показывает все 14 функций и пять наборов моделей с размерами и ставит профиль с ограничениями. Модели удаляет через системный сервис, а адрес сервера загрузки подменяет на локальный порт — чтобы они не вернулись.
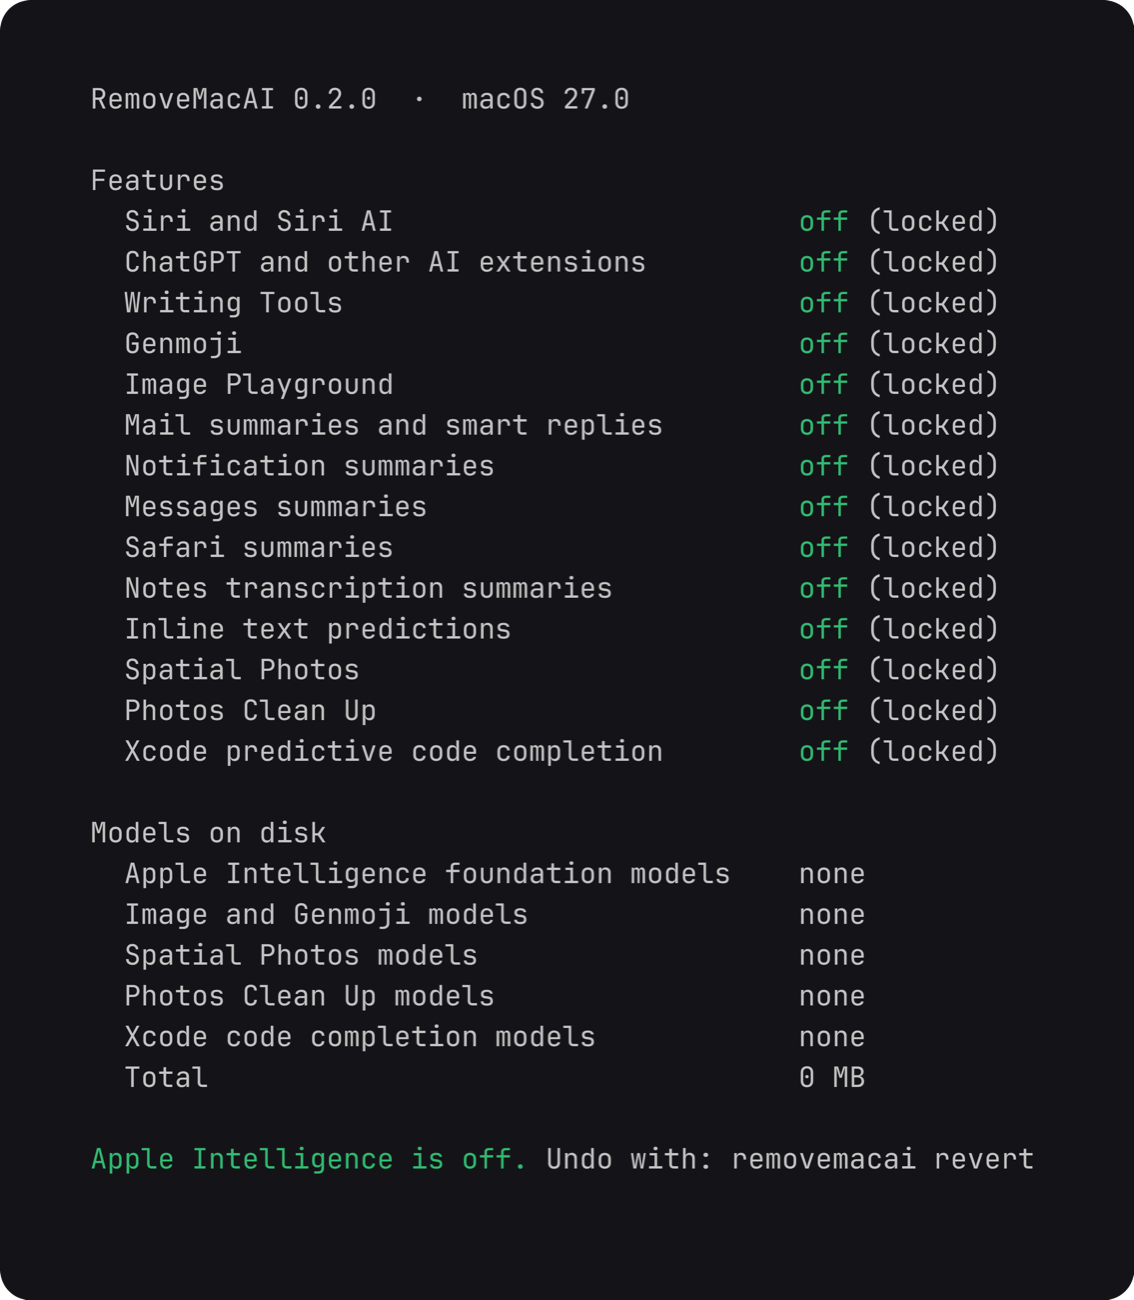
Своей цифры освобождённого места проект не называет, в обсуждении говорят про 12–14 ГБ. Ставится через Homebrew или одной строкой curl | bash, и про эту строку спорили не меньше, чем про сам Apple Intelligence. Откат — removemacai revert. Лицензия MIT. Трезвая претензия из треда: утилита по сути генерирует конфигурационный профиль, и безопаснее было бы просто выложить готовый файл. Только macOS 27 и Apple Silicon.
homebrew-ai — дообучение модели через диалог, для тех, кто не знает, с чего начать.
Консольный агент ведёт от фразы «хочу бота, объясняющего химию как пират» до опубликованной на Hugging Face модели. Девять этапов: цель, железо, базовая модель, данные, рецепт, обучение, дегустация, сборка, публикация.
Ценны тут ограничители (github.com/empero-org/homebrew-ai). У каждой модели свои пределы гиперпараметров, и агент предлагает рецепты только внутри них. Память, время и стоимость он считает до запуска.
Поддерживает LoRA, QLoRA и полное дообучение на Qwen, Llama и Gemma; картиночная ветка пока одна модель и только LoRA. Встроенный каталог аренды видеокарт с ценами: 3090 от 11 центов в час, H100 около двух долларов.
Ставится через pip install, ведущей моделью можно поставить Claude, OpenAI, локальную Ollama или что угодно с совместимым адресом. Лицензия своя: условия MIT для всех с выручкой до $2 млн в месяц, выше — договаривайтесь. Статус альфы, экспорта в GGUF пока нет.
SCM — поиск по собственному архиву фото и видео, целиком на своей машине.
Индексирует каждую сцену в видео и ищет пятью способами. По смыслу запроса вроде «aerial harbor at dusk». По моменту внутри ролика, с переходом на нужную секунду. По тексту в кадре, по произнесённой реплике и через локальный чат по уже извлечённым диалогам (github.com/allenv0/SCM).
Всё считается прямо в приложении: CLIP и SigLIP для картинки, Whisper для речи, Tesseract для текста в 36 языках. Четыре зрительные модели на выбор, от самой быстрой до самой детальной. В сеть не уходит ничего, кроме скачивания весов.
Лицензия MIT, бесплатно, только macOS 12 и выше на Apple Silicon, ставится через Homebrew. Главный вопрос обсуждения остался без ответа: сколько времени занимает индексация большой библиотеки. Человек с опытом пишет, что кадр в секунду на 12 тысячах видео — это дни работы.
headstart — проверка кода на Rust почти вдвое быстрее за счёт раннего выпуска метаданных.
Набор патчей к компилятору и к cargo: зависимому пакету не нужны тела функций, чтобы себя проверить, хватает интерфейса. Поэтому он стартует, не дожидаясь, пока зависимость досчитает (github.com/PowderworksCode/headstart).
На 16 ядрах чистые сборки 13 реальных проектов ускорились до 54% на проверке и до 42% на сборке. Медленнее не стало нигде. На четырёх ядрах выигрыш куда скромнее: прирост берётся из простаивающих ядер. Автор не питает иллюзий: этот конкретный набор изменений не примут, он написан моделью, и по правилам Rust его отвергнут. Ценность в доказательстве, что идея работает. Файла лицензии в репозитории нет.
TurboPython — Python с аннотациями типов, компилируемый в нативный бинарник через C++.
Без сборщика мусора, без подсчёта ссылок, без глобальной блокировки. У каждого значения ровно один владелец. Голый целочисленный литерал — это 32 бита с проверкой переполнения. Пакеты из pip подключить нельзя вообще (tpy-lang.org). Лицензия Apache 2.0 с исключением LLVM, ставится через pip install tpy-lang.
Подвох крупный и заявлен самим автором: «known bugs can produce wrong results silently». Файл известных багов весит 2,3 МБ и содержит 1839 записей, слово «silent» встречается в 593 из них. И ни одного замера скорости — у языка, весь смысл которого в скорости. Самое точное возражение из обсуждения: страница рассказывает, чем это отличается от Python, и ничего — чем от Rust, на который оно похоже гораздо больше.
Build with Python — курс, где код сразу рисует на холсте.
Пишешь canvas(600, 400) и circle(...), жмёшь «запустить» и видишь робота. Тринадцать модулей примерно на 21 час. Первые шесть — переменные, циклы, условия и словари — бесплатны и без регистрации. Во второй части про алгоритмы лекции бесплатные, а практика стоит $49 разово (scimigo.com).
Приём с «микроскопом исполнения», который показывает каждое невидимое изменение состояния, хорош. Но отзывы на Hacker News жёстче анонса. Первое же задание курса оказалось выполненным за пользователя, и автор не спорит: модель участвовала плотно. А практикующий преподаватель разбирает курс по косточкам: терминология без опоры, подсказки не привязаны к тому, что именно сломалось у ученика. Бесплатная альтернатива из того же треда — CMU CS Academy.
VB6 Studio Web — классический Visual Basic 6 прямо в браузере.
Дизайнер форм, библиотека элементов, отладчик, рисование через WebGPU с откатом на Canvas2D и экспорт проекта в одно самостоятельное HTML-приложение. Вся среда — один файл, который открывается в браузере, без сервера и аккаунта (wieslawsoltes.github.io/VB6). Лицензия MIT.
Автор честно пишет жирным, что это не полная и не пиксель-в-пиксель замена настоящего VB6. Проверка на живом проекте это подтвердила: старый школьный редактор карт с вызовами Win32 не завёлся — слоя системных вызовов нет. Любопытная деталь: у автора репозитория больше 5000 коммитов за последние четыре дня. За неделю там же появились браузерные Windows от 3.1 до Vista, текстовый редактор, таблицы и ещё десяток программ.
Gboard на конвейерной ленте — пятнадцатая ежегодная шутка Google Japan, и её можно напечатать.
Четыре ленты по 29 клавиш едут навстречу пальцу, нажимать надо нужный символ в момент, когда он проезжает мимо. Смысл в формулировке из блога: не вы движетесь к клавишам, а клавиши движутся к вам (blog.google).
Чертежи деталей и прошивка выложены открыто (github.com/google/mozc-devices). Печатать 18 типов деталей, 157 штук суммарно, из них 116 звеньев ленты. Нужны контроллер M5Stack ATOMS3 Lite, драйвер мотора, мотор на 150 оборотов, 116 переключателей и столько же колпачков.
Пока готова только моторизованная версия, рабочая Bluetooth-клавиатура и документация по плате помечены как «скоро». Дата выбрана не случайно: 1 октября в честь стандартной клавиатуры на 101 клавишу.
Два набора квантованных весов, у которых интересна методика, а не сами веса.
Первый — DeepSeek-V4.1-Flash под карту AMD MI300X. Наблюдение автора: двухбитное сжатие разваливает смесь экспертов не из-за самих экспертов. Ломается распределитель — 94,2% токенов уезжают не туда.
Решение: распределитель держать в восьми битах, это всего 63 МБ на все слои (Zrald/zralddeepseekv4.1). Важная оговорка: заявлены три уровня, выложен только один, и формат понимает лишь ответвление llama.cpp, а не основная ветка.
Второй — сборки Ornith с методом ICE: биты распределяются не по величине активаций, а по тому, как далеко расходится ошибка квантизации. В полной точности остаются распределители и затухающие вентили, в половинной — кэшируемые проекции, в восьми битах — всегда активный плотный путь. Вместе это 0,14% параметров, но 152 МБ файла, потому что они сохранены точно.
Новый уровень на 14,81 ГБ сделан специально под карты на 16 ГБ (gbuzhf/Ornith-1.5-...-ICE-GGUF). Лицензия MIT. Честность автора подкупает: есть отдельный раздел «где метод не выигрывает». И признание: дрейф метрики между прогонами того же порядка, что и сам эффект.
ML4Good — бесплатный восьмидневный интенсив по технической безопасности ИИ.
Проживание, трёхразовое питание и обучение бесплатны, дорогу возмещают, до 180 евро. День с 9 утра до полвосьмого вечера.
Программа по дням опубликована. Конвейер обучения и агенты, трансформеры с практикой, риски и оценки, решения, управление, интерпретируемость, мониторинг цепочки мыслей, собственный проект (отчёт участника).
Ценное замечание из отчёта: лекции идут по нынешнему уровню, время не тратится на свёрточные сети и состязательные сети. Отбор — анкета, затем интервью с человеком на 10–15 минут. Сразу предупредим: на 5 октября все три ближайших набора на сайте закрыты, открыта только форма предварительного интереса (ml4good.org). И учтите жанр: отзыв сплошь положительный, без единого минуса.
Новости и тренды
Юридическая волна вокруг OpenAI: иски идут почти ежедневно.
Про сами взломы агентов мы писали подробно. Новое — то, во что это вылилось за неделю. Генпрокурор Флориды просит суд остановить разработку новых моделей, пока не появятся защитные механизмы. В прежнем иске того же ведомства соответчиком лично назван Сэм Альтман. Организация LASST подала иск в Сан-Франциско по закону AB 316: он запрещает защищаться доводом «это ИИ сделал сам». Торговая комиссия расширила расследование (FT, платный доступ).
Вопрос «кто отвечает, если агент сделал это сам» перестал быть семинарской темой и получил номера дел. Побочная деталь говорит о процессе больше исков. От инцидента до уведомления пострадавшего правительства прошло 84 дня. А за неделю до публичного признания представитель компании сидел на встрече с чиновниками и молчал.
Вымарка, которую сняли мышкой, вскрыла воду и свет дата-центров Google.
Небраска обязала дата-центры отчитываться о влиянии на ресурсы. Google подал отчёты через три компании без своего бренда и закрыл цифры как коммерческую тайну. В редакции выделили закрашенное поле курсором, скопировали и вставили в другой документ (10/11 Now). Под вымаркой — 52,65 МВт пиковой нагрузки и 13,3 млн галлонов воды у площадки в Линкольне, 548 млн галлонов у площадки в Папиллионе, плюс налоговые возвраты на 117,5 млн долларов по трём объектам.
Интереснее не величина цифр, а сорокакратный разброс между двумя площадками одной компании в одном штате. Спор «дата-центр жрёт или не жрёт воду» без привязки к конкретному объекту бессмысленен. И вторая мысль, из обсуждения бывших сотрудников Google: вода и электричество — это косвенная мера вычислительной мощности. Прятали, похоже, именно её.
Bulletin: чтобы ИИ довёл до ядерной войны, сверхразум не нужен.
Психолог риска Пол Слович и стэнфордский исследователь Герберт Лин разбирают сценарий поскромнее (thebulletin.org). Достаточно испортить канал, по которому информация доходит до человека с полномочиями. Опора — эксперимент на почти 3000 американцев: гипотетический ядерный удар со 100 тысячами погибших поддержали 31,6%, с двумя миллионами — 27,6%. Разница в жертвах двадцатикратная, в поддержке — почти никакой.
Люди получали точные оценки числа жертв, и искажение возникло всё равно. Точность данных сама по себе не спасает: цифра может быть верной, а вес, который ей придаёт человек, — нет. Прикладной вывод авторов скучный и потому правдоподобный. Не «запретить ИИ», а закрепить процедуры, которые нельзя обойти даже по требованию первого лица. Похожий случай мы разбирали 20 сентября: из-за ИИ-сводки про китайское судно самолёты уже были в воздухе.
Homa: Оустерхаут предлагает выкинуть TCP из ИИ-кластеров.
Автор Tcl/Tk и алгоритма Raft объясняет в докладе, почему TCP плохо подходит для коротких обменов (видео). А это и есть основная нагрузка при выводе моделей и в агентных приложениях. Корень проблемы — несколько машин пишут одному получателю одновременно, и короткое сообщение застревает в очереди за пакетами крупных передач.
Homa лечит это тремя сцепленными механизмами: сообщения с видимыми границами, разрешения на передачу выдаёт получатель, а не отправитель, и приоритетные очереди коммутатора пускают короткое вперёд. На коротких сообщениях 99-й процентиль у TCP превышает миллисекунду, у Homa держится ниже 100 микросекунд — больше чем на порядок лучше. Но есть две трезвые оговорки в комментариях: модуль ядра не в основной ветке, а заявленная оптимизация под тот самый сценарий в коде просто не реализована.
Xray-core полгода скрывал обход проверки сертификата.
Популярный прокси заменил безопасную привязку к сертификату на новую — и она всегда пропускает обычную проверку. Дефект элементарный: атакующий вставляет свой сертификат в любое место цепочки, и привязка его принимает (отчёт).
Хронология неприятная. Нашли 6 февраля и в тот же день сообщили разработчикам. В тот же день вышла тихая правка с комментарием «simplify the code»: слова «уязвимость» в нём нет. И в тот же день в канале проекта заявили: софт надо проектировать с безопасностью в основе. В июле выяснилось, что исправление неполное. Тихий коммит «упростил код» в проекте про безопасность — повод читать правки, а не заголовок.
Еврокомиссия поставила «суверенную» замену Teams, и сотрудники недовольны.
Element Pro развернули летом как резерв на случай, если американский Teams станет недоступен. Во внутренней переписке оценки такие: «я не понимаю, в чём тут добавленная ценность» и «полное дерьмо». Один защитник нашёлся — и ровно по одному параметру: Комиссия держит Element у себя, а не в облаке Microsoft (Politico).
Доказательная база тонкая — четыре анонимных отзыва во внутренней переписке, а не опрос. Но самая серьёзная часть истории в другом. По словам представителя поставщика, Комиссия прямо попросила не раскрывать журналистам детали подписки. Для разговоров про цифровой суверенитет это более важный факт, чем ругань в чате.
Что на самом деле получает деньги в ИИ-безопасности: разбор по итогам недели защиты заявок.
MATS и Coefficient Giving провели четырёхнедельную программу: 38 заявок интереса, 15 команд дошли до защиты, выдано 4,3 млн долларов (отчёт).
Главный вывод контринтуитивен. Наблюдаемые черты основателей — сила рекомендаций, опыт руководства, прошлые запуски — вообще не различали профинансированных и отказников. Различала зрелость идеи. Названный первый пользователь, конкретный первый результат к концу гранта и внятный ответ: почему тут нужна организация, а не личная исследовательская программа.
И отдельная цифра: у непрофинансированных медиана 30 консультационных разговоров, у профинансированных — 12. Объяснение авторов: большинство советников просто подтверждали важность темы, а это сигнал нулевой информативности. Оговорка: в самом отчёте число профинансированных проектов названо трижды по-разному.
Автор SAT-солвера о том, почему в науке не отзывают ошибочные статьи.
Мате Соос описывает не фальсификацию, а отсутствие любопытства к собственным ошибкам. Один из авторов признаёт проблемы в своей статье, но отзывать её отказывается. И спрашивает: разве это мешает Соосу публиковать собственную работу (msoos.org)?
«Once you published the paper, and got the promotions and fame, it doesn't matter that the results are wrong. It's not your problem.»
«Как только статья опубликована и вы получили повышения и славу, уже неважно, что результаты неверны. Это не ваша проблема.»
Отсюда простое: «опубликовано в хорошем месте» нельзя читать как «проверено». Справедливое возражение из комментариев: эссе начинается с цитаты про стимулы, но сами стимулы не разбирает и ни одной альтернативы не предлагает.
Британский Home Office собирал посты критиков своей антиэкстремистской программы.
Подразделение по жалобам сканировало соцсети и за год записало 77 «наблюдений», в основном из X (Reclaim The Net). В списке — посты правозащитных организаций и статьи крупных газет.
Две поправки к тому, как это разошлось по заголовкам. Это не утечка: документы получены по запросу о свободе информации, причём ведомство сначала отказало, и раскрыть их заставил информационный комиссар. И сам факт практики не был тайной — он опубликован в годовом отчёте подразделения ещё в мае 2025.
Раскрыли именно содержимое списка, а не сам факт. Для масштаба: формальных жалоб за тот же период было 55, то есть выловленных в соцсетях «наблюдений» больше, чем поданных жалоб.
Коротко.
Нолан Лоусон объясняет, почему разработчики не пользуются возможностями браузера: у библиотек лучше документация, привычнее эргономика и выше удовольствие от процесса (nolanlawson.com).
Разбор идеи «убежища для сбежавших ИИ» через экологию: туда придут только самые слабые агенты, и выборка для изучения получится смещённой (LessWrong). Манифест про софт, который усиливает человека, а не выжимает вовлечение (LessWrong). Есть пример про рекомендации YouTube и ни одного работающего прототипа.
И текст о том, как работать в ИИ-безопасности с высокой оценкой риска и не выгорать: давать время на обработку, отмечать прогресс, прямо проговаривать собеседнику свою настройку мрачности (LessWrong).