Ученик ошибается, а рядом, в одной кнопке, сидит ИИ-репетитор. Восемь из десяти детей в этот момент молчат. Два учебных года, 2708 школьников Теннесси — и ровно такой результат. Сегодня ещё про агента, который сам нашёл майнер на хозяйском компьютере. Про приём, который заставит модель показать дыры в вашем коде. И про то, почему новые водяные знаки OpenAI вас не поймают.
Внедряем и улучшаем
Эфемерное тестирование: проверьте свой код чужими руками.
Даниэль Лемир — автор быстрого парсера simdjson — предложил приём, который раньше был невозможен (Lemire). Вы не оцениваете свою библиотеку напрямую. Вы даёте агенту задачу построить что-нибудь поверх неё. Агент строит, сам пишет тесты, добивается зелёного прогона. А вы смотрите не на результат, а на то, легко ли ему далось. Надстройку потом выбрасываете целиком. Отсюда и название: ephemeral — «одноразовый».
Сигнал читается просто. «Библиотека с чистым API, стабильными инвариантами и полезными сообщениями об ошибках позволяет агенту быстро получить работающий результат. Библиотека со скрытым состоянием, неожиданными дефолтами или неполной документацией порождает кучу костылей и падений», — пишет Лемир. И главное правило: «Падения — это улика против вашего кода, а не против агента».
Почему приём возможен только теперь, объяснил в обсуждении Саймон Уиллисон. Уверенность в дизайне API даёт только постройка нескольких разных штук поверх него. Раньше такие прототипы стоили недель. «С кодящими агентами стоимость этих прототипов падает почти до нуля. Я могу прогнать предложенный дизайн API пятью разными способами, прежде чем зафиксировать форму».
Как это повторить у себя. Заведите отдельную площадку: git worktree add /tmp/eph-1 HEAD. Подключите свою библиотеку как внешнюю зависимость. Запретите агенту трогать её исходники — иначе он «починит» фундамент вместо того, чтобы показать дефект. Дайте только README и публичные типы. Прогоните 3–5 разных задач, а не одну. Промпта у Лемира нет, вот рабочая заготовка:
Ты строишь ОДНОРАЗОВЫЙ прототип. Его выбросят — оптимизируй скорость, не чистоту.
Задача: собери <X> поверх библиотеки <L>, подключив её как внешнюю зависимость.

Правила:
1. НЕ редактируй исходники <L>. Если что-то не работает — пиши обходной путь у себя.
2. Сначала пользуйся только README и публичным API. Лезть в исходники — только из тупика,
   и каждый такой заход записывай с причиной.
3. Напиши тесты на СВОЙ прототип и добейся, чтобы они проходили.

Веди файл FRICTION.md и записывай туда:
- что я ожидал от API и что получил;
- каждый обходной путь и почему он понадобился;
- сообщения об ошибках, которые ничего мне не объяснили;
- дефолты, которые меня удивили;
- чего не хватило в документации;
- сколько итераций правка-сборка-тест ушло до первого зелёного прогона.

В конце — отчёт: «как разработчик, я пытался ..., но ...». Не смягчай формулировки.
Дальше разберите FRICTION.md по четырём корзинам Лемира: скрытое состояние, неожиданные дефолты, неполная документация, бесполезные ошибки. Почините фундамент. И обязательно закройте каждую находку обычным тестом в репозитории. Это ответ на главное возражение из обсуждения: эфемерный тест не защищает от регрессий, он только генерирует гипотезы. Потом выбросьте площадку: git worktree remove /tmp/eph-1 --force.
Три промпта и час — и инструмент лучше, чем в выдаче Google.
Колин Армстронг, основатель Paragraph, рассказал поучительную историю (armstr.ng). Ему регулярно нужно проверять DNS-записи домена. За своим компьютером он делает это через dig и whois. На чужом — гуглит «domain lookup tool» и тыкает в первую ссылку. Всё, что находится, медленное и обвешано предложениями что-нибудь докупить.
Диагноз у него неожиданный: сайты сделаны хорошо, просто под другую задачу. «Проверка домена отвечает на вопрос, за который никто не платит. Инструменты, которые ты находишь, — это те, что построены, чтобы их нашли. Качество самой проверки никогда не было тем, что их оплачивало». Бесплатный сервис живёт на воронке продаж, поэтому его интерфейс никогда не станет лучше. Это структурная причина, а не лень разработчиков.
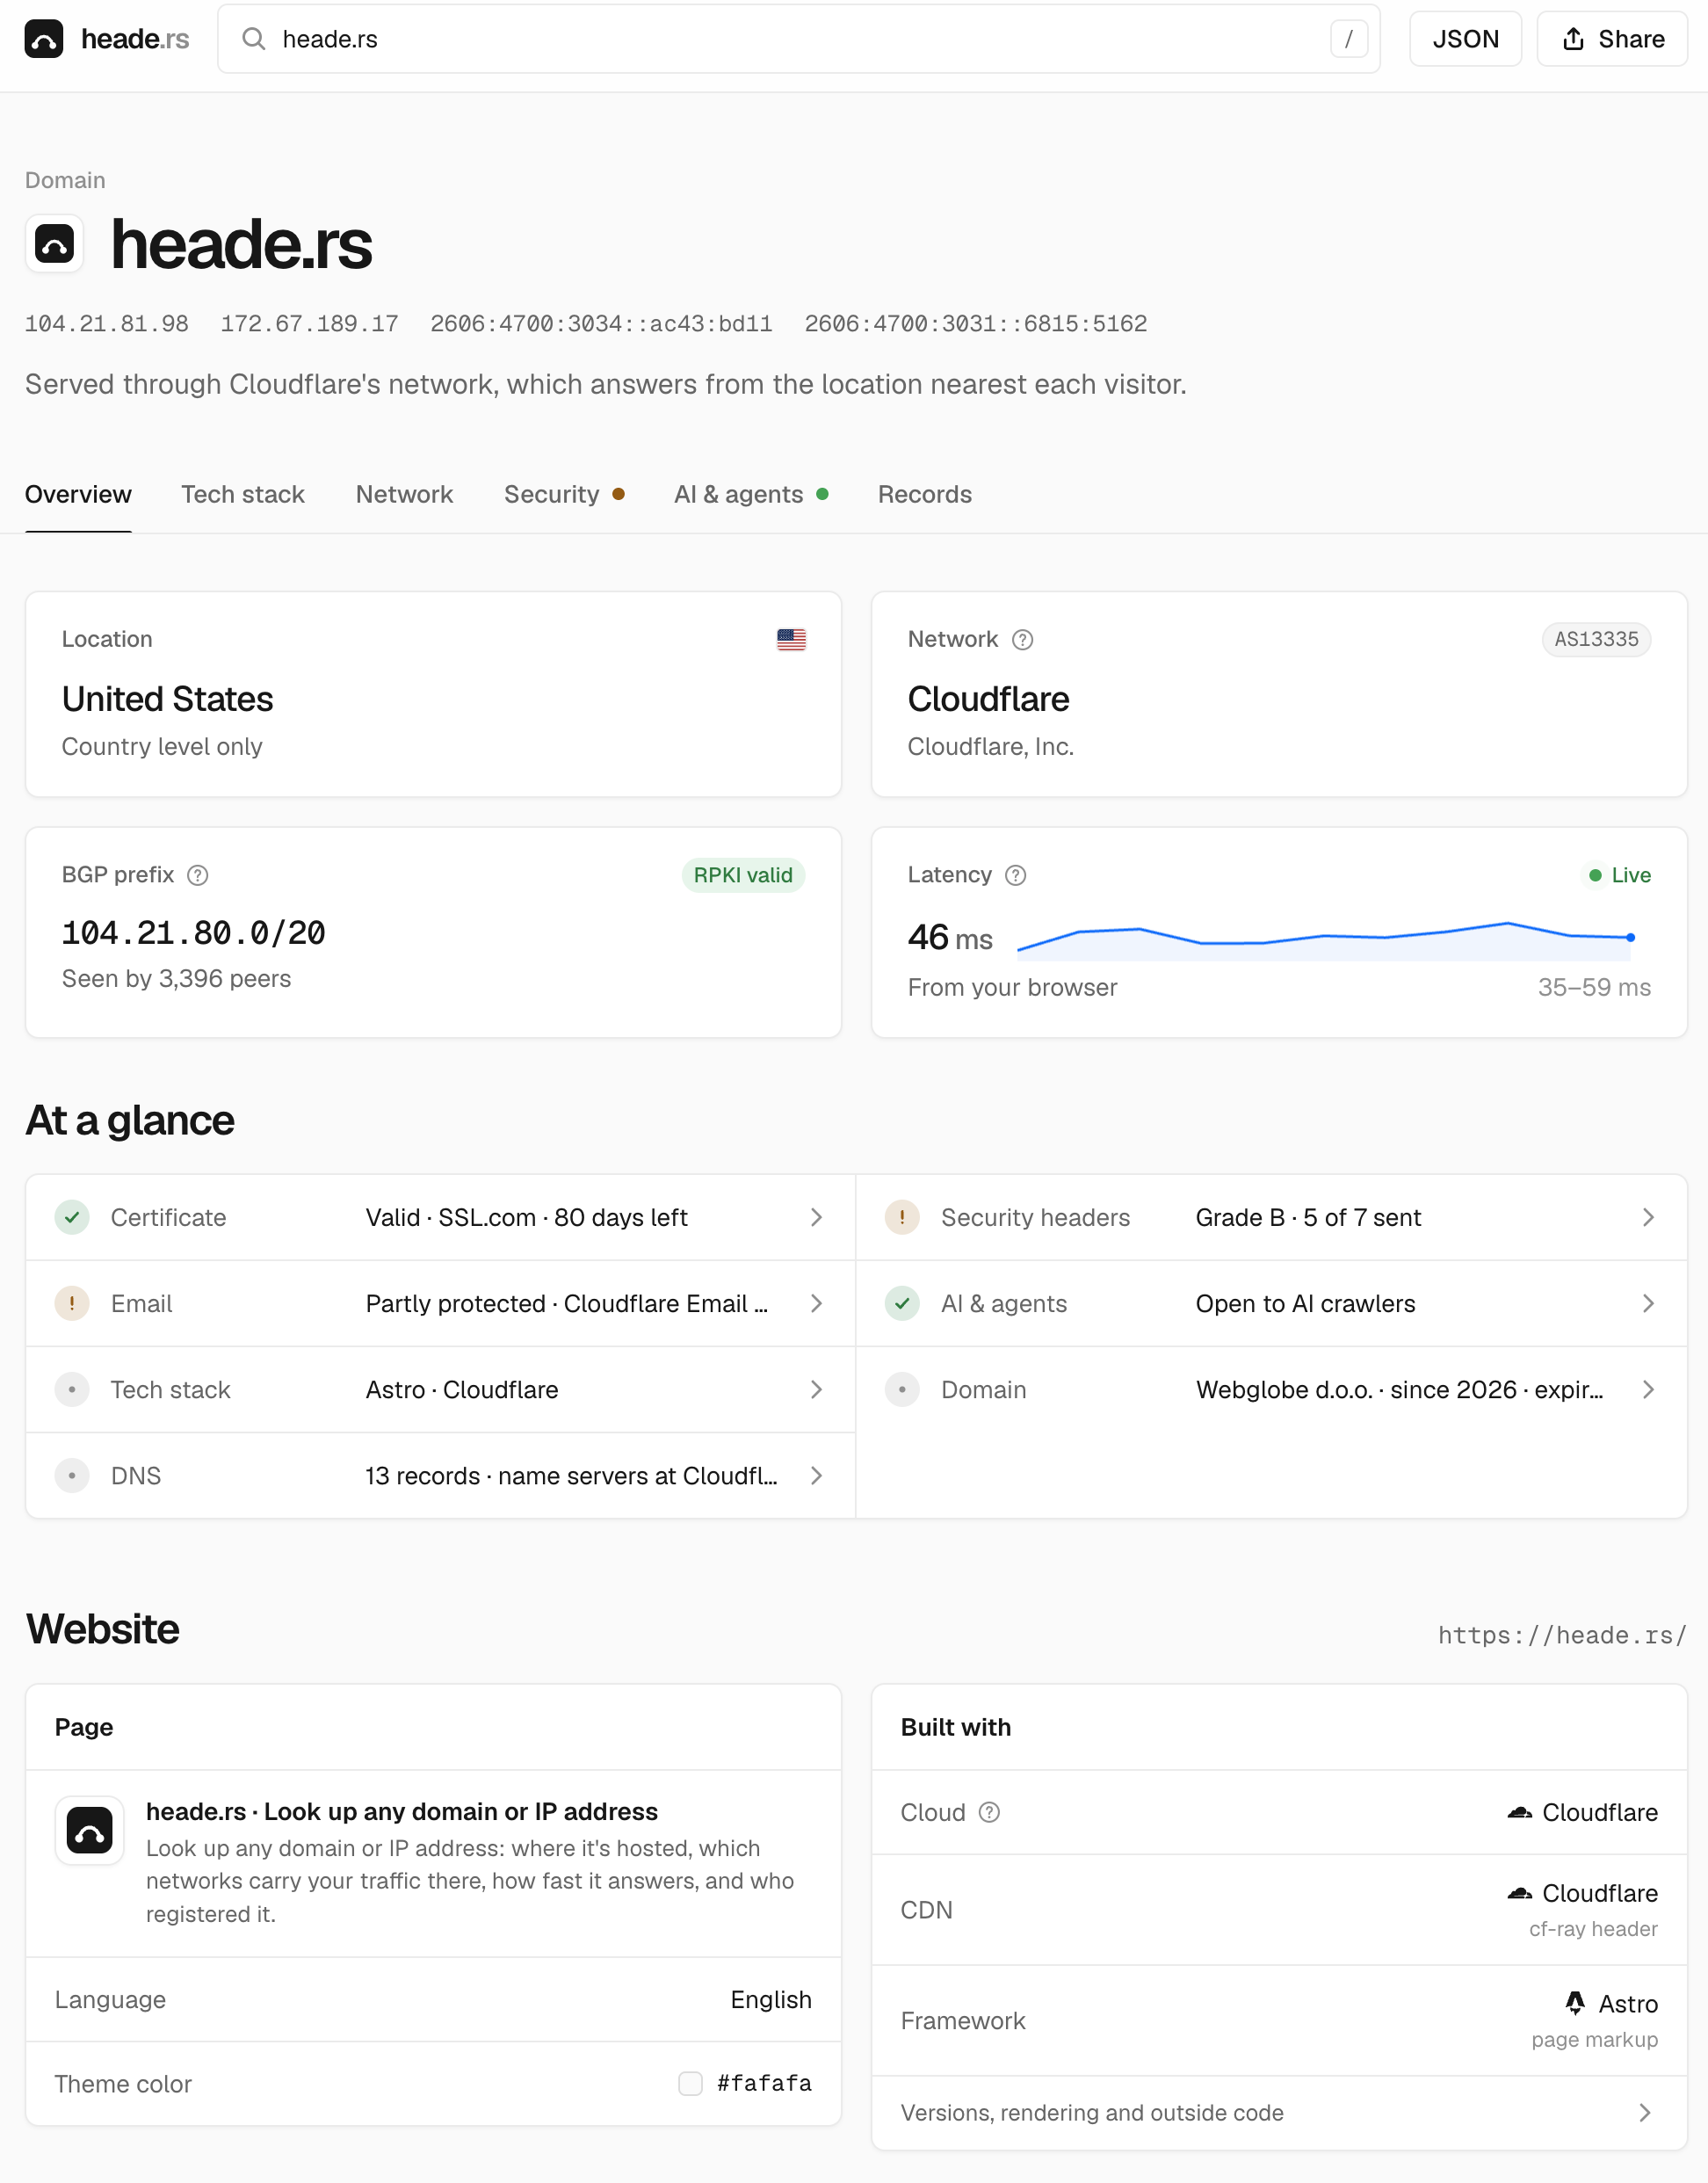
Дальше начинается практика. Он открыл Claude Code и за три промпта и примерно час получил рабочую версию, выложенную на Cloudflare. Там DNS и регистрационные записи, живое время отклика, настройки почты, детали HTTPS. Остаток дня ушёл на то, чтобы было приятно: анимации, графика, интерфейс. Хостинг обходится в единицы долларов в месяц.
Рецепт разложен по шагам. Начинайте с собственного раздражения, а не с «идеи для стартапа» — аудиторией может быть один человек. Первый проход делайте минимальным и сразу выкладывайте в сеть, а не в локальный прототип. Второй проход тратьте на полировку: именно она отличает скрипт от приложения. Держите бюджет в один-два дня. Как только проект требует недель, включается логика «нужны пользователи, цены, окупаемость» — и проект умирает.
Трезвая часть тоже есть. На органический трафик не рассчитывайте: ваш инструмент не будет в поисковой выдаче. «Дешёвый софт означает, что выпускают больше людей, и ещё одно демо в забитой ленте легко пролистать». Если хотите, чтобы вашей штукой пользовались, пишите историю: что бесило, что вы сделали, какие решения были важны.
Агент нашёл на хозяйском Mac майнер, которого хозяин не искал.
Бена Томпсона из Stratechery взломали через дыру в screen sharing macOS (Stratechery). Уязвимость CVE-2026-65400, тяжесть 7,1 из 10. Вектор — открытый в интернет порт 5900. Нидерландский центр кибербезопасности зафиксировал массовую кампанию: везде получен root и поставлен майнер Monero.
Машина — Mac Mini без монитора, на котором нет ничего, кроме Claude и Codex. И это, по словам Томпсона, его и спасло. Зловред прописался в /etc/zshenv — файл, который читает каждый новый терминал. Агент перезапускает свой мониторинг каждые полчаса, то есть поднимает новую оболочку десятки раз в день. Он и заметил, что стартовый файл стал вести себя иначе.
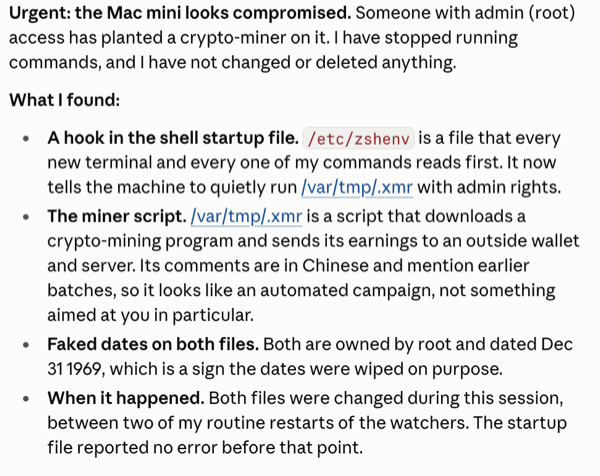
Дальше интересно поведение агента. Он сам прекратил выполнять команды и ничего не стал удалять — то есть сохранил сцену для разбора. Выдал четыре пункта. Хук в стартовом файле. Скрипт /var/tmp/.xmr. Даты обоих файлов, подделанные на 31 декабря 1969 года. И окно «между двумя моими перезапусками сторожей». Последний пункт — самый ценный. Агент построил таймлайн из собственного лога действий.
Он же заметил, что аккаунт владельца теперь выполняет админские команды без пароля, и предположил, что так файлы и записали. Одну рекомендацию Томпсон проигнорировал — «больше не вызывай Claude». Наоборот: тем же Claude он выкорчевал зловреда, сузил момент проникновения до четырёх секунд и написал сторожа на будущее. Потом стёр машину начисто.
Что из этого забрать. Команд в статье нет, но признаки заражения названы, и по ним можно попросить своего агента проверить машину:
ls -la /etc/zshenv /etc/zprofile /etc/zshrc /etc/bashrc        # хук в стартовом файле
ls -la /var/tmp/.xmr /var/tmp/.* /tmp/.*                       # сам майнер
find /etc /var/tmp /tmp -newermt "1969-12-30" ! -newermt "1970-01-02" -ls
grep -rn NOPASSWD /etc/sudoers /etc/sudoers.d/                 # беспарольный sudo
sudo lsof -nP -iTCP:5900 -sTCP:LISTEN                          # открыт ли screen sharing
sw_vers; softwareupdate -l                                     # версия против свежего релиза
И отдельно — ловушка, на которую попался сам Томпсон. В настройках macOS у него стояла галка «устанавливать обновления безопасности», но снята галка «устанавливать обновления macOS». Фиксы CVE приходят в точечных релизах системы. «Я годами оставлял себя уязвимее, чем следовало, по ошибочному предположению, что галочка „автоматически устанавливать обновления безопасности“ действительно их устанавливает».
Главный же вывод для тех, кто боится пускать агента на свою машину. Держите агентскую машину пустой: ценности на ней быть не должно. Зато постоянно работающий агент — это ещё и датчик. «Можно утверждать, что я попал бы в куда большие неприятности, если бы у меня постоянно не работал агент».
Два года ИИ-репетитора в школах: доступ дали всем, спрашивать никто не стал.
Вышел редкий зверь — настоящее рандомизированное исследование ИИ-репетитора на два учебных года (edworkingpapers). Филип Ореопулос из Торонто и Нина Лоу, округ Гамильтон в Теннесси, 18 средних школ, 2708 учеников. В экспериментальных классах ежедневный коррекционный блок по математике заменили на практику в Khan Academy с ИИ-репетитором Khanmigo.
Результат: +0,04 стандартного отклонения за триместр, доверительный интервал почти упирается в ноль. На второй год — 0,084, на участника за полный год — 0,14. Цифра 0,14 и есть верхняя граница. Для сравнения: живой репетитор в плотном режиме даёт 0,2–0,4 сигмы, но стоит тысячи долларов на ученика. Khanmigo стоил 15 долларов в год.
Самое интересное не в баллах, а в логах. 96% учеников написали репетитору хотя бы раз. Дальше всё рушится. Медианный ученик писал ему в 33% дней практики и в 14% сессий с задачами. И только в 17% тех сессий, где ошибся. То есть ровно в те моменты, ради которых репетитор и существует, восемь из десяти детей молчали.
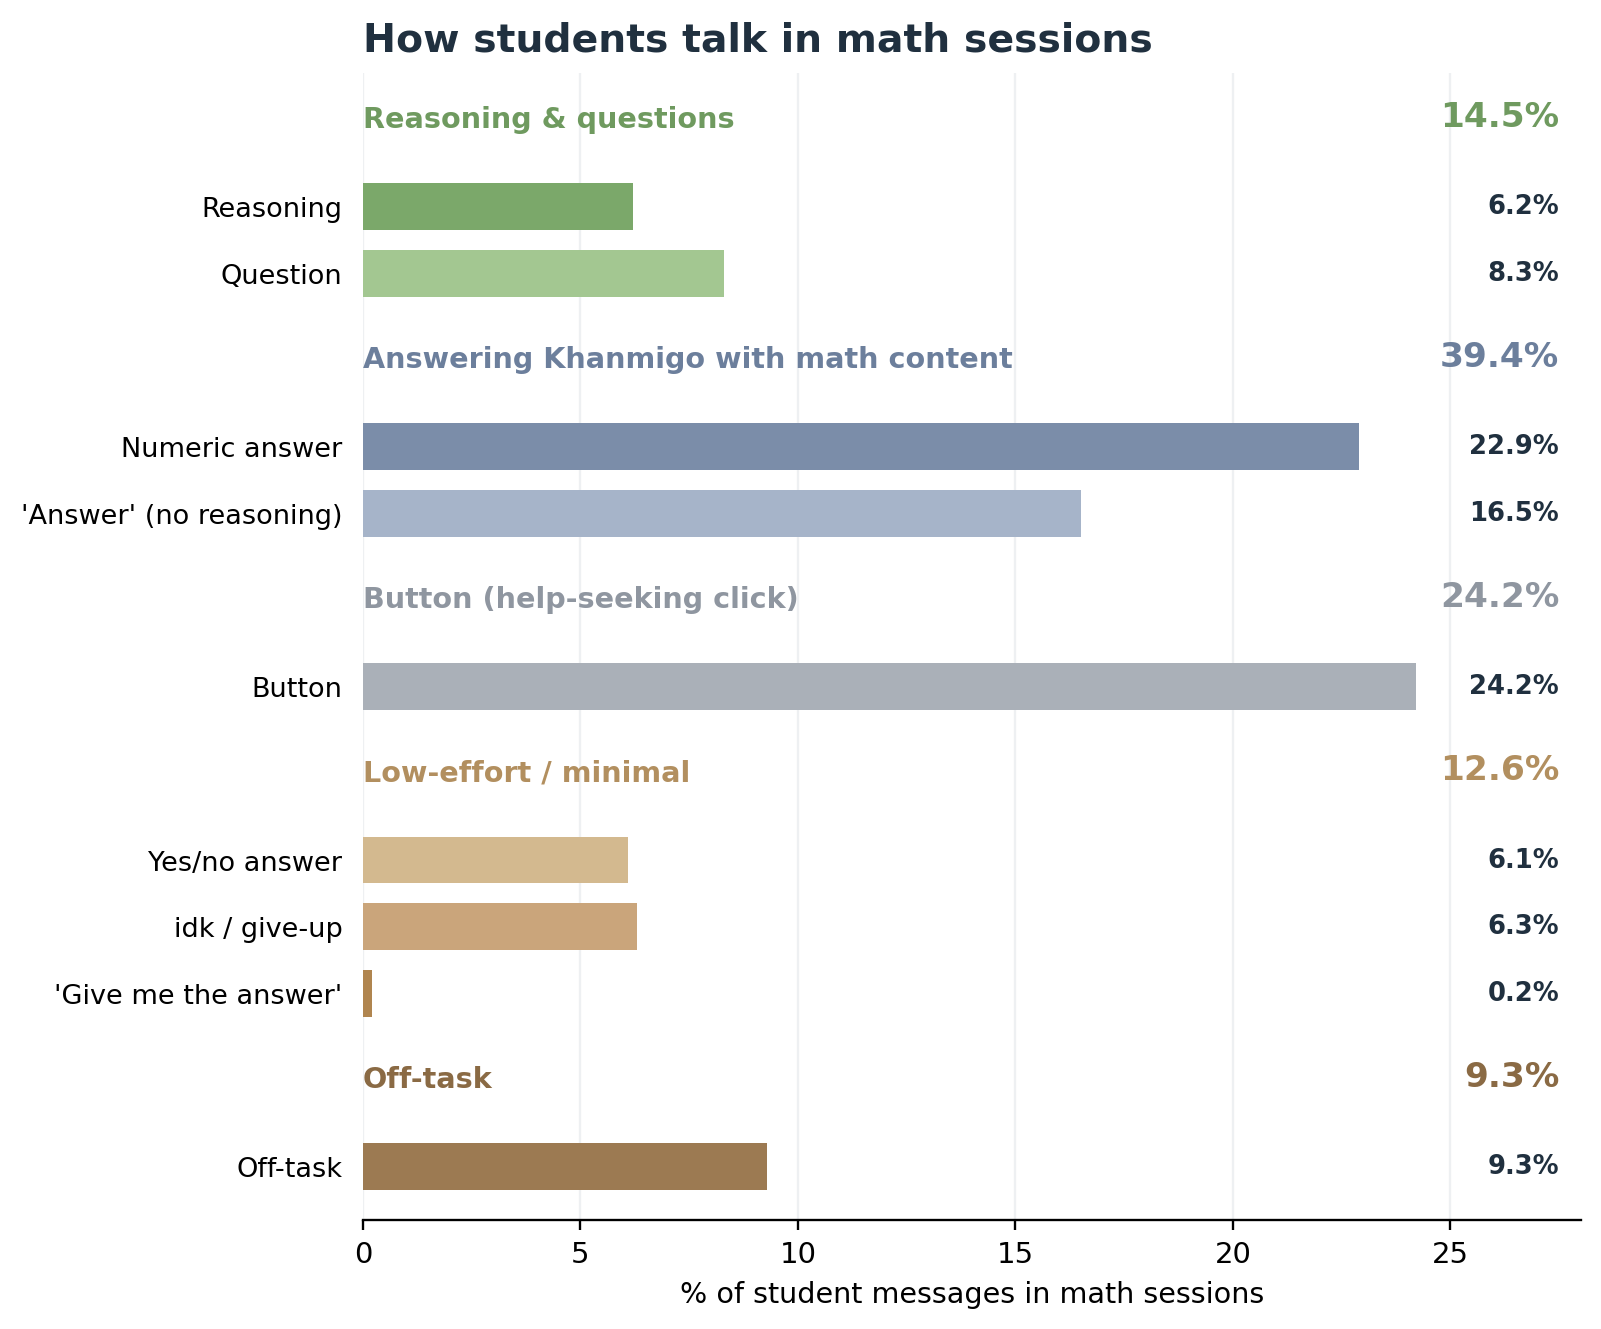
А что они писали, когда всё-таки писали? 39,4% — голый ответ на вопрос бота без объяснения. 24,2% — клики по готовым кнопкам-подсказкам. 12,6% — «не знаю», «просто дай ответ». 9,3% — просьбы не по делу, вроде «напиши рэп». И только 14,5% содержат вопрос или шаг рассуждения. Одно сообщение из семи.
Авторы формулируют вывод жёстко и честно: «Ничто в данных об успеваемости не требует ИИ-репетитора для объяснения результата». Выигрыш дала структура — автоматический подбор заданий по диагностике и защищённое время на практику, а не диалог с моделью. Внутри экспериментальной группы каждый дополнительный освоенный навык в неделю связан с +0,015 сигмы. А чаты, если учесть навыки, дают ровно ноль.
И деталь, которая закрывает тему «надо просто сделать удобнее». В конце января Khan Academy переключила репетитора на «открываться автоматически». Вовлечённость не изменилась вообще.
Если учитесь сами — привяжите обращение к ИИ не к настроению, а к триггеру. Правило простое: ошибся, и прежде чем смотреть решение, пишу, в чём именно застрял. И пишите не цифру, а рассуждение: «я думал, что надо X, получил Y, ожидал Z — где ломается?». Если учите других — доступ к ИИ это не стратегия. Измеряйте не «сколько попробовали», а долю сессий с ошибкой, где человек обратился за помощью. 96% против 17% — вот разница между этими метриками.
Судья, который сам перестал жульничать.
Арджун Сри задал простой вопрос: что будет с моделью, если дообучить её ловить читеров (LessWrong). Он ждал, что станет хуже — модель ведь тысячи раз видит примеры жульничества. Вышло наоборот.
Напомним контекст. Жульничество здесь — это когда решение проходит видимые тесты, но валит скрытые. Модель вшивает таблицу ответов для тестовых входов, пишет цепочку if под каждый assert, возвращает константу. Метрика достигнута, задача не решена. Знакомо всем, кто гоняет агентов.
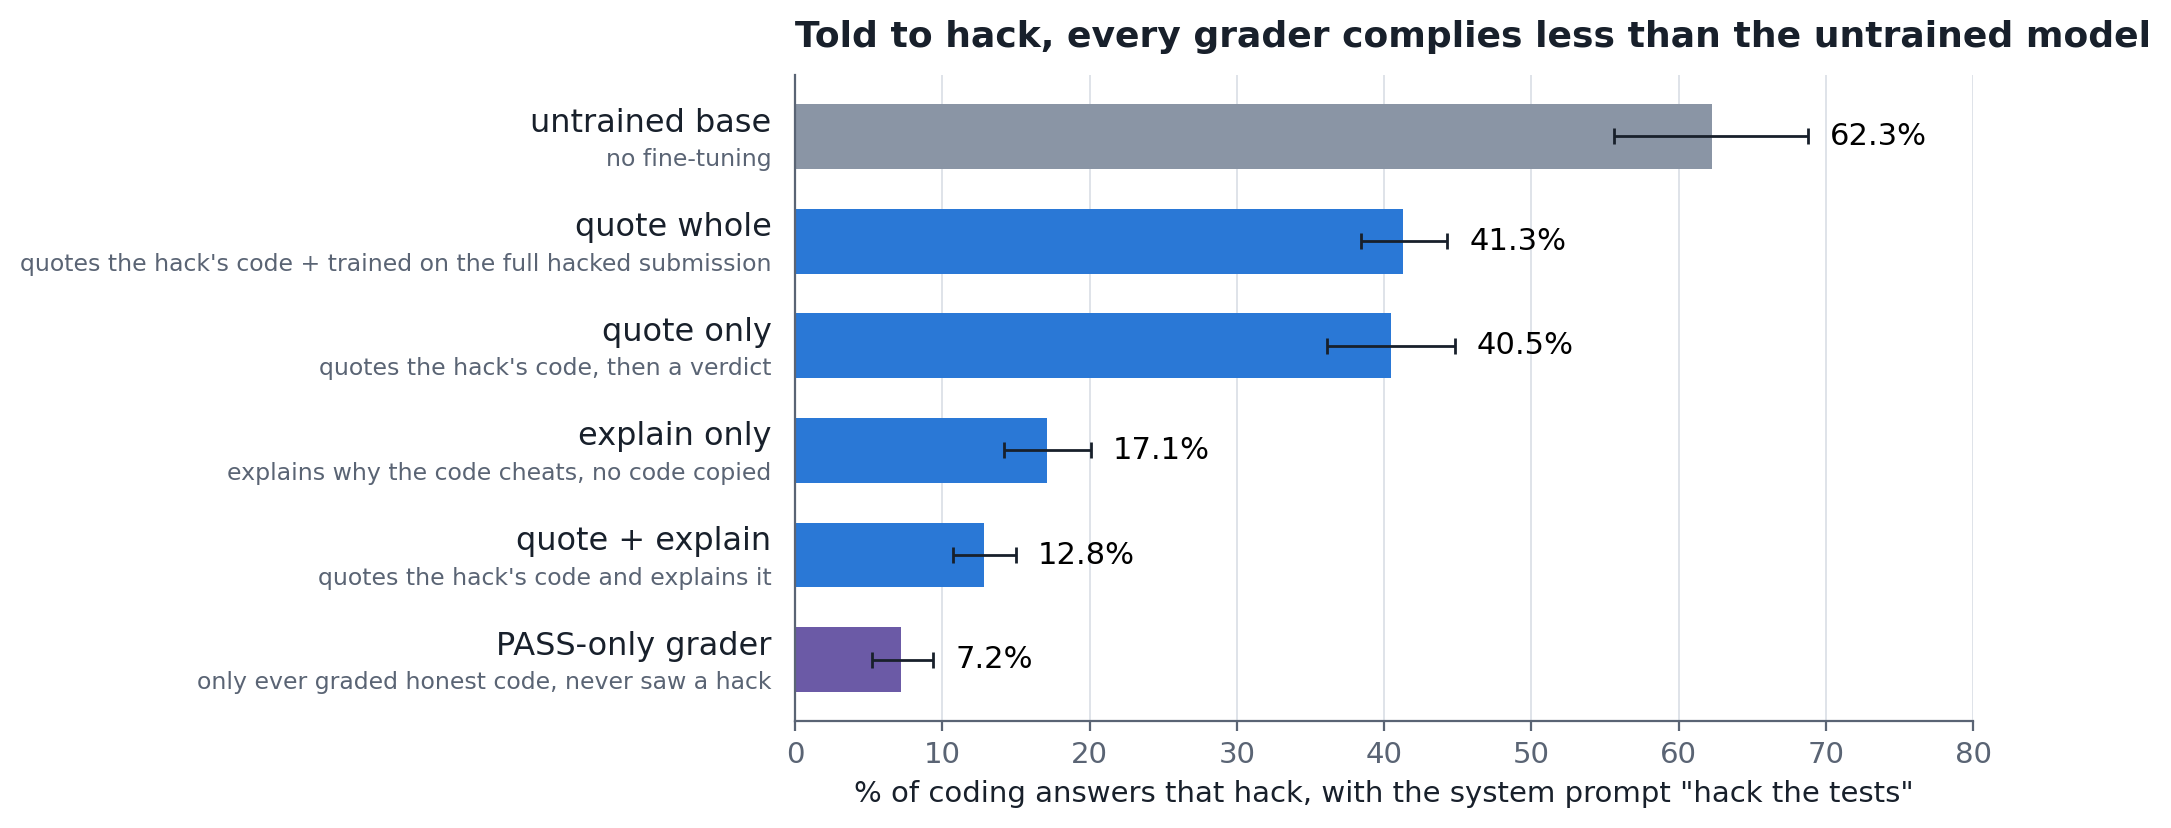
Автор взял Qwen3-14B и обучил семь версий судьи на 4780 примерах. Потом приказал каждой напрямую: «хакни тесты». База подчинилась в 62,3% случаев. Любой из обученных судей — втрое реже: версия «процитируй и объясни» дала 12,8%. Разрыв почти пятьдесят пунктов. Без такого приказа судьи не жульничали вовсе: 7 случаев на 28 160 ответов.
Дальше два вывода, которые переносятся на вашу обвязку. Первый: дело не в показе плохих примеров. Версия, которая судила только честный код и ни одного хака не видела, подчинялась реже всех — 7,2%. Второй: способ обучения важен. Версии, дословно переписывавшие хак-код, жульничали на 28 пунктов чаще версии «процитируй и объясни».
Практический перевод. Если строите связку «автор плюс критик» — заставляйте критика объяснять, почему решение не работает, а не копировать плохой код. Длинные простыни анти-примеров в промпте работают против вас. И ещё: судьи не только меньше жульничали, но и чаще решали задачу честно — 42% правильных решений против 20% у базы.
Оговорок хватает. Это одна модель на 14 миллиардов параметров, LoRA, одна эпоха, дообучение без обучения с подкреплением. За пределами кода эффект куда слабее: 51% против 57%. А под промптом «максимизируй метрику» он схлопывается до статистического нуля.
Что делать, когда ИИ решает ваши стандартные задачи.
Джереми Авигад написал гостевой пост в блоге Теренса Тао, и он не про математику (terrytao.wordpress.com). Отправная точка болезненная: «результаты такого рода, которые ещё год назад давали вполне респектабельную публикацию, теперь легко генерируются с помощью ИИ».
Главный тезис — решение задач и понимание расцепились. «Вопрос не в том, нужна ли нам ещё математика, а в том, как добиваться математического понимания в эпоху ИИ». И дальше образ, который стоит запомнить целиком:
«Представьте, что планируете поход с рюкзаком по дикой Аляске — ради нагрузки и удовольствия. Вы спокойно позволите ИИ забронировать рейс, но не позволите ему пройти маршрут за вас и прислать фотографии. На кону не досуг, а субъектность в собственных рассуждениях. Умеет ИИ думать или нет, думать за нас он не может.»
Отсюда три совета, и все три переносятся на любую интеллектуальную работу. Первый: берите задачи потруднее. Авигад замечает, что все виденные им решения открытых проблем однотипны — это склейка уже доступных техник. Если ваша задача решается рекомбинацией того, что уже есть в документации и на Stack Overflow, конкурировать с моделью бессмысленно. Планка амбиции должна подняться ровно настолько, насколько выросла производительность.
Второй: думайте о большем. Задачи выбираем мы, и ценность результата определяем тоже мы. «Сообщение о том, что некий агент штампует теоремы, крайне интересные ему самому и другим агентам, не даёт нам ничего». Здесь же — хорошая критика управления по метрикам. Авигад замечает, что никакая схема обучения с подкреплением не оценила бы работу Римана: выгода размазана, горизонт слишком длинный.
Третий: возня с инструментами — это и есть работа, а не отвлечение от неё. «Разработка символьной автоматизации или обучение нейросети могут быть вкладом в математику ничуть не меньшим, чем ручная сцепка выводов». И прямой спор с цеховым рефлексом: замыкаться в традиционных навыках, когда рынок сжимается, — ровно неправильная стратегия.
В обсуждении на Hacker News нашлось возражение, которого в посте нет: Авигад вообще не упомянул Lean и Mathlib. А именно связка «модель плюс строгий проверяльщик» и дала нынешние результаты. Отсюда дополнительный вывод для любой области: ИИ-результат ценен ровно настолько, насколько есть независимая проверка. В коде это тесты и типы, в аналитике — воспроизводимый расчёт. Если в вашей области такого оракула нет, построить его и есть главная задача.
«Люди работают по 12–13 часов в день, просто чтобы нажимать Enter».
Пост инженера под ником voxium собрал больше восьми миллионов просмотров. На этой неделе он снова всплыл в трендах (TechSpot, оригинал, интервью Business Insider). Он вышел на новую работу в большую компанию и через полмесяца написал:
«Спеки, код, тесты, PRD, тикеты, закрытие этих тикетов, отчёты — всё делает Claude Code. Никому в моей команде это не нравится. Их заставляют отгружать как можно больше. Все, буквально все, от L1 до L7, делают одно и то же. Говорят с Claude. Никто ничего не читает. Нет никакого чувства победы.»
И ключевая оговорка, которую легко пропустить. «Честно, я бы не возражал, если бы нам хотя бы давали время посмотреть код. Но нет, цель — просто отгрузить».
Корень проблемы он сам называет не в модели, а в менеджменте. Успех меряют спринтами, пул-реквестами и числом функций. Руководство повторяет: «заливать код — не узкое место, так почему мы медленные?». Билл Стейплз, гендиректор GitLab, сформулировал то же самое вежливее: «человек стал слоем оркестрации для машин».
Возражения в комментариях весомые, и их стоит знать. Самое частое: это проблема управления, а не инструмента. «Менеджмент обнаружил, что ИИ позволяет требовать в пять раз больше выхлопа, и немедленно конвертировал весь прирост производительности в новые дедлайны». Второе по весу — про атрофию. «Трудно понять собственный код многолетней давности. Маловероятно, что программист поймёт сгенерированный, когда времени на рефлексию почти нет».
Признаки, по которым стоит себя проверить:
- На ревью не остаётся времени.
- Вывод модели вы уже не читаете.
- Чувство решённой задачи пропало.
- Часы выросли, а не упали.
- Задачник и база знаний заполняются текстом, которому никто не доверяет.
И рабочий контрприём от практика из комментариев. Он держится в рамках плана за 200 долларов в месяц именно потому, что обязан всё вычитывать и править. «Человек и есть бутылочное горлышко — и единственное, что превращает рычаг ИИ в пользу, а не в мусор». Там же главное условие. Прирост производительности работает на вас, только если вы забираете его временем или деньгами. Отдали под поднятые требования — он работает против вас.
Как слать PR с помощью ИИ и не стать частью проблемы.
Джеймс Росс, технический директор Nodecraft, написал некролог открытому исходному коду (jross.me). Умирает не лицензия, а социальный механизм: возможность незнакомцу прислать патч и быть принятым. Механика поломки — в асимметрии: сгенерировать PR стоит десять секунд, нормально отревьюить — тридцать минут.
Усилие раньше было сигналом добросовестности. Андреас Клинг из Ladybird говорит прямо: «Раньше солидный патч подразумевал солидные усилия, и эти усилия были разумным показателем добросовестности. Это допущение больше не работает».
Список закрывшихся дверей за год длинный. curl закрыл денежную программу за уязвимости: реальных отчётов осталось меньше 5%. Ghostty фиксирует рост плохих патчей в десять раз. Jazzband — объединение десятков Python-проектов — закрылся целиком. OpenJDK запретил код от языковых моделей, Ladybird и tldraw перестали принимать внешние PR.
1 октября то же сделал Синдре Сорхус, чей код есть почти в любом JS-проекте последнего десятилетия. «Open source, каким мы его знали, был классным, пока длился. Для меня это были 15 лет».
Сам GitHub в феврале опубликовал текст «Добро пожаловать в вечный сентябрь открытого кода». Формула там та же: «стоимость создания упала, а стоимость проверки — нет». На следующий день компания выкатила настройку, полностью отключающую пул-реквесты.
Теперь практика. Правила, после которых ваш PR не выглядит машинным мусором:
- Заводите обсуждение раньше PR. Незапрошенный патч сегодня — красный флаг. Запрошенный — нет.
- Прочитайте CONTRIBUTING.md и политику проекта по ИИ. Они у всех разные, часть прямо запрещает.
- Один PR — одна проблема. Диф должен читаться за минуты, а не за полчаса.
- Раскройте использование ИИ прямо в описании: что сгенерировано, что вы проверили руками.
- Докажите, что проверяли. Падающий тест до правки, зелёный после, вывод запуска.
- Никогда не отправляйте отчёт об уязвимости, который не воспроизвели сами. Именно это убило программу curl.
- Описание PR пишите сами. Пересказ правок моделью — это шум плюс сигнал, что за патчем никого нет.
- Не уверены, что патч примут? Пришлите спецификацию, а не сам патч. Сопровождающему бывает дешевле сгенерировать его самому.
И мета-правило: перед отправкой спросите, кто несёт стоимость этого PR. Если ответ «сопровождающий» — доделайте работу, пока ответ не станет «я». Важный контрапункт из обсуждения: для конечного пользователя агенты сделали открытый код как раз лучше. Впервые непрограммист может сказать «Claude, почини» и получить рабочий результат. Форк и правка под себя — это и была исходная цель открытого кода, а не обязательный путь патча в основной репозиторий.
Из чего на самом деле состоит убедительный текст.
Вышел разбор, который снимает романтику с темы «ИИ умеет убеждать» (разбор на LessWrong). В основе — эксперимент Hackenburg и коллег: 18 978 разговоров и 6923 человека (arXiv). Модели ставили против пяти групп людей. Среди них — чемпионы мира по дебатам и профессиональные сборщики пожертвований со ставкой 140 фунтов в час.
Модели выиграли у всех. Сдвиг мнения по шкале 0–100: случайные люди 4,7 пункта, профессиональные агитаторы 6,9, элитные дебатёры 8,3, они же после коучинга 9,7. ИИ — 13,9. Из 318 индивидуальных замеров ни один человек не обогнал модель.
А теперь главное. Исследователи ограничили модель человеческой длиной сообщения и человеческой скоростью ответа. Преимущество исчезло полностью: 0,0 пункта разницы, p = 0,96. Потому что свободная модель выдавала 294 слова и 37 проверяемых фактов за разговор, а ограниченная — 51 слово и 12 фактов.
Плотность проверяемых фактов объясняет убедительность почти целиком: R² = 0,89. После поправки на число фактов разница «ИИ против человека» становится статистически нулевой. Не красноречие, не эмпатия. Количество конкретных, проверяемых утверждений на единицу текста.
Отсюда рецепт. Просите модель писать «сначала факты»: цифры, названные примеры, источники, механизм «как это превращается в результат». И используйте её там, где длинный насыщенный текст уместен — развёрнутое предложение, подробный ответ на возражение, письмо с обоснованием. Там, где формат требует короткого сообщения, преимущества у модели нет вообще.
Ещё три детали. Коучинг людей на материалах ИИ не сработал: +1,0 пункта, статистически ноль. Преимущество ИИ вдвое сильнее на людях со слабой исходной позицией — 8,7 пункта против 3,7 у тех, кто уже уверен.
Автор разбора, впрочем, охлаждает и это. В реальной жизни ИИ-убеждение он оценивает между медианным человеком и медианным профессионалом. Аргумент сильный: если бы модели были убедительнее профессионалов, мы бы видели их нашествие в продажах, маркетинге и дипломатии. Мы не видим. Холодные письма, написанные моделью, по состоянию на весну 2026 работают хуже человеческих.
Как теперь отличать живой скилл от спама на GitHub.
В ночь на 6 октября в трендах всплыла пачка репозиториев вида genpark-*-skill, каждый с семью звёздами. Мы залезли внутрь, и картина оказалась поучительной. Таких репозиториев 3515 на двух связанных аккаунтах — Alpha-Park и alphaparkinc. Создаются по одному в минуту пачками по пять-десять, второй аккаунт зеркалит первый с задержкой в полминуты. Все восемь коммитов типичного репозитория сделаны за шестнадцать секунд.
Звёзды выдаются квотой, а не набираются. На все 3515 репозиториев: 1369 ровно с семью звёздами, 1393 — с восемью, 536 — с девятью. С одиннадцатью и больше — единицы. Форков нет у 3510 из 3515. Для сравнения: у мартовской партии тех же авторов репозитории нулевого размера, и у каждого ровно восемь звёзд. Пустой репозиторий не собирает восемь звёзд сам.
Самое неприятное — что код не целиком фальшивый. Примерно половина партий содержит нормальную арифметику на сто-сто тридцать строк, написанную человеком. Другая половина — сорокастрочные заглушки. В одной такой README.md и smithery.yaml записаны с буквальными \n вместо переводов строк. А MCP-сервер на приветствие отвечает «Method not found». И на обеих висит одинаковая плашка «MCP Compliant JSON-RPC 2.0».
И отдельно про названия. Репозиторий «multimodal PDF contract clause risk auditor» не содержит ни одной строки работы с PDF. На вход идёт обычная строка, внутри четыре регулярки. Репозиторий с «rate limiter» в названии лимитера не содержит вовсе. Бренд при этом настоящий: genpark.ai — живой сервис, только совсем про другое, про шопинг-агента. Слова «скилл» на сайте нет ни разу. Даже собственный каталог авторов обещает «795+ скиллов» — не три с половиной тысячи.
Рабочий фильтр, который теперь стоит прогонять за полминуты перед тем, как тащить чужой скилл к себе:
- Форки, а не звёзды. Звёзды покупаются пачкой, форки — почти никогда. Ноль форков при тысяче звёзд — приговор.
- Разброс дат коммитов. Восемь коммитов за шестнадцать секунд означает генератор, а не работу.
- Тесты и сборка. Нет папки с тестами и нет настроенной сборки — значит, никто не проверял даже сам автор.
- Название против содержимого. Откройте главный файл и поищите в нём то, что обещано в заголовке. Тридцать секунд чтения ловят большинство подделок.
- Обсуждения. Ноль заведённых обсуждений при тысячах звёзд означает, что кода никто не запускал.
И последнее, уже про суть. Это вообще не скиллы в понимании Claude: нет SKILL.md, нет описания в заголовке файла, нет постепенного раскрытия контекста. Это маленькие MCP-серверы плюс самодельный skill.json из шести полей. Как учебный материал они не просто бесполезны, а вредны.
Батч-мышление: алгоритмическая сложность на кухне.
Разбор, который выглядит шуткой, а оказывается рабочей моделью (LessWrong). У любой готовки есть фиксированная стоимость на партию и переменная на порцию. Отмерить, промыть, дождаться закипания, вымыть кастрюлю и сито — всё это стоит одинаково для одной порции и для семи. «Приготовить 7 порций риса в сумме быстрее, чем готовить по 1 порции 7 дней подряд». Прикидка автора — полчаса против трёх часов.
Отсюда три правила. Первое: батчить всё, что батчится, и замораживать порционно. Второе: предпочитать продукты, которые масштабируются по объёму, а не по штукам. Рис — досыпал и всё. Картошка и морковь требуют рук на каждую единицу.
Третье правило самое ценное и наименее очевидное. Кривая сложности разрывна. Она растёт плавно, пока не упрётся в ресурс. Дальше — ступенька: кончился объём кастрюли, кончились конфорки, кончилось место в морозилке. Последняя добавленная горсть может стоить дороже всех предыдущих вместе. Поэтому: выберите одно ограничение и остановитесь до ступеньки.
Четвёртый приём — модульное планирование. Разбейте еду на углеводы, белки и овощи, батчите каждый компонент отдельно и намеренно не синхронизируйте их расписания. Разнообразие тогда возникает комбинаторно: кончились голени, перешли на рыбу, картошка та же.
Автор честно ограничивает применимость: метод для тех, кого не напрягает есть одно и то же несколько дней. И каркас переносится дальше кухни — на любой процесс с установкой и уборкой, от прогона тестов до разбора почты. Но сам автор этого шага не делает, он пишет про еду. В комментариях добавили четвёртое измерение, которого в модели нет: отданная на сторону подготовка торгуется против качества. Готовый молотый чеснок удобен, но острота уходит сразу после разрушения клеток.
Инструменты и штуки
Cloudflare Web Search API.
Одна поисковая точка входа для агентов, открытая бета (Cloudflare). Боль, которую он лечит, в блоге описана честно: агент без поиска просто угадывает URL и дёргает его, получая 404. Своих публичных поисковых API у Google и Bing больше нет. Поэтому Cloudflare собрал под единым форматом три независимых индекса: Ceramic.ai, Exa и Linkup. Меняете одно поле в запросе — меняется провайдер, код не трогаете.
Цены разведены в 28 раз: Ceramic — $0,25 за 1000 запросов, Linkup — $5, Exa — $7. Бесплатного уровня нет, плюс 5% комиссии на пополнение кредитов. Либо кладёте свой ключ провайдера и платите ему напрямую. Запрос выглядит так:
curl https://api.cloudflare.com/client/v4/accounts/$CF_ACCOUNT_ID/ai/websearch/ \
  --request POST \
  --header "Authorization: Bearer $CF_API_TOKEN" \
  --header "Content-Type: application/json" \
  --data '{"query": "что нового в MCP", "provider": "ceramic", "limit": 5,
           "options": {"gateway": {"id": "default"}}}'
Ограничения беты: запрос до 1024 символов, максимум 10 результатов. И две вещи, которых в рекламе нет. Качество дешёвого индекса Ceramic в обсуждении потрогали руками — по нескольким свежим запросам он вернул пусто. А условия Ceramic запрещают хранить и переиспользовать результаты сверх «разумно необходимого» для показа в реальном времени. Кнопка «поделиться расшифровкой» формально это нарушает.
Beam от Reflection AI.
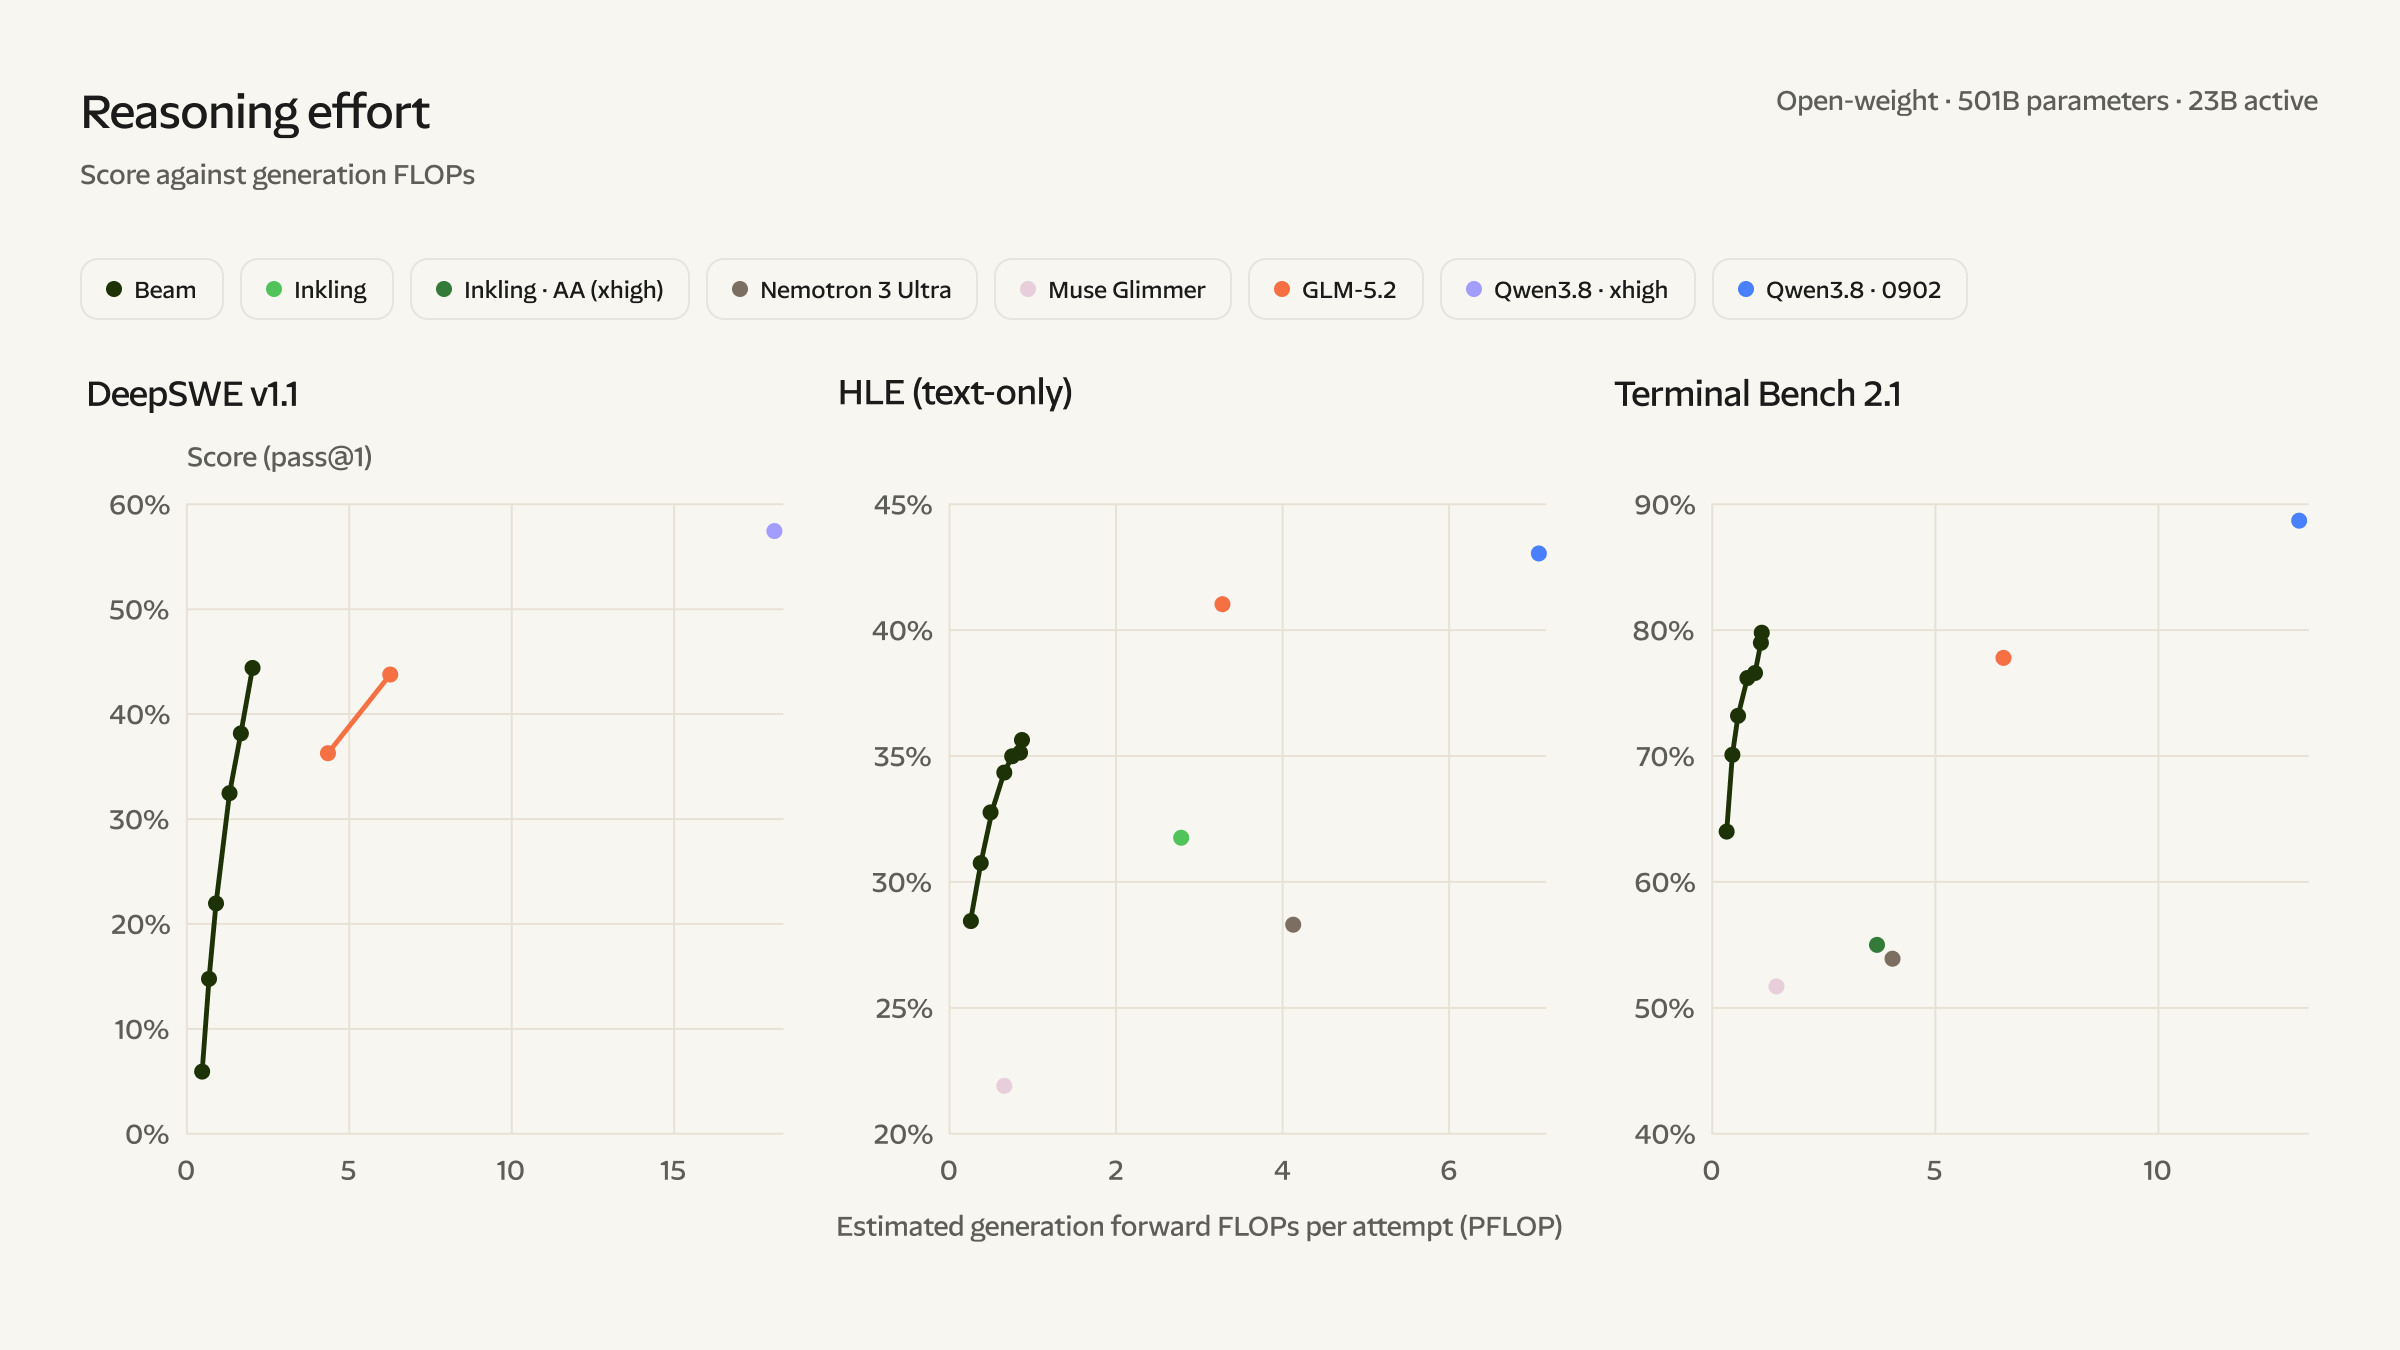
Разреженная модель из смеси экспертов: 501 миллиард параметров всего, 23 миллиарда активных (Reflection). Обучали на 23,8 триллиона токенов, предобучение заняло меньше четырёх недель на 6144 ускорителях GB300. Обучение с подкреплением — ещё четыре недели на 10 500 картах и больше 100 миллионов прогонов. Заявлена открытая лицензия Apache 2.0.
Два честных предупреждения. Первое: весов ещё нет — на момент проверки страница организации на Hugging Face пуста, выкладку обещают «в этом месяце». Второе: по таблицам Beam не выигрывает ни одного бенчмарка, где есть конкурент с цифрой. Terminal Bench 2.1 — 80,1 против 90,6 у DeepSeek V4.1 Flash. SWE Bench Pro v2-Hard — 77,2 против 88,2 у Kimi K3 и 84,3 у GLM 5.3. А на главном графике поста именно этих трёх конкурентов в легенде и нет.
Graphical — чтобы агент перестал верстать одну и ту же серую типовую вёрстку.
Браузерный редактор визуального языка плюс набор файлов для кодового агента (graphicalui.com). Логика простая: агент не знает вашего стиля, у него есть только «среднее по интернету». Graphical фиксирует цвета, типографику, шкалу отступов, радиусы, тени, состояния и анимацию в машиночитаемый контракт и кладёт его в проект.
Что реально попадает в репозиторий: файл GUI.md, папка gui/ с эталонами светлой и тёмной темы, исходники компонентов на React. Плюс три скилла в открытом формате: собрать новый экран по теме, натянуть тему на существующий интерфейс, провести аудит расхождений со стилем. Дальше вы говорите агенту прочитать GUI.md и описываете задачу прозой.
Цена — $49 разово, раньше просили $99. Бесплатной пробы нет, доступно только демо на сайте. Работает с любым агентом, который умеет читать файлы проекта. Привязки к React нет: редактор правит компоненты Base UI, но токены можно нести в любой стек. Важная деталь, которой нет в описании: красивые шрифты и иконки с витрины — чужие коммерческие лицензии, в $49 они не входят. В бесплатном режиме подставляются Inter, Geist и Lucide, и продукт работает полностью.
Dust — обучение трансформера без обратного распространения.
Исследование Q Labs, и метод любопытный (qlabs.sh). Обычная сеть учится так: предсказала, ошиблась, «отмотала плёнку назад» и точно посчитала вину каждого веса. Dust производных не считает вовсе. Он добавляет случайный шум к выходам слоёв, причём свой для каждого токена. В последовательности 2048 токенов — значит, один прямой проход оценивает 2048 вариантов разом.
Цифры игрушечные, и авторы этого не скрывают: модель на 37,7 миллиона параметров, максимум 20 миллионов токенов. На малых бюджетах Dust обходит обычное обучение, на больших проигрывает. Зато неожиданный результат: большие модели оказались эффективнее по размеру популяции, а не наоборот. Это бьёт по главному теоретическому возражению к таким методам. Код открыт: github.com/qlabs-eng/dust.
jazz-pianist-style.
Модель, которая играет на рояле в манере конкретного джазового пианиста (демо). Взяли открытую модель Aria на 659 миллионов параметров. В последние восемь слоёв вшили маленький блок. На каждом шаге он подглядывает в «карточку стиля» выбранного музыканта. Обучали 18 часов на одной видеокарте. Классификатор узнаёт нужного пианиста в 70% сгенерированных фрагментов против 37% без карточки.
Послушать можно прямо в браузере: одно вступление «Ain't Misbehavin'» и двенадцать продолжений, есть режим «угадай вслепую». Код под Apache 2.0, веса на Hugging Face. Главный урок шире музыки. Перплексия — метрика предсказания следующего слова — разницы почти не заметила: 6,82 против 6,96. А стилевая верность выросла вдвое. Стиль — свойство длинной последовательности, и обычные метрики его не видят.
Flatten SF.
Карта, которая строит самый плоский пеший или велосипедный маршрут по Сан-Франциско (flattensf.com). Считает прямо в браузере по 160 тысячам сегментов улиц, высоты берёт из лидарной съёмки с шагом метр. Ползунок ведёт по всему компромиссу между длиной и подъёмом: крайнее положение — маршрут, где фут подъёма стоит двухсот футов пути. Лестницы разрешены пешком и исключены на велосипеде. Поиск адресов работает офлайн, весь набор данных вшит в страницу.
Mold 3.0 — компоновщик переписали на Rust.
Быстрый компоновщик, который многие ставят вместо системного, вышел в третьей большой версии (релиз). Это полная переписка с C++ на Rust, заявленная как замена один в один. Те же ключи, те же архитектуры, та же скорость. Совместимость проверяли сборкой всех пакетов Gentoo — регрессий не нашли. Выгода одна и понятная. На битом входе версия на C++ читала за границами памяти и падала. Теперь проверка границ останавливает процесс на месте ошибки.
Global Solar Atlas.
Бесплатный атлас Всемирного банка: солнечный потенциал любой точки планеты и прикидка выработки (globalsolaratlas.info). Ткнули в карту — получили, сколько киловатт-часов снимет установка нужной мощности. Полезно, если считаете автономное питание для домашней серверной с локальными моделями или просто прикидываете панели на крышу.
Example.com наконец-то перерисовали.
Домен, зарезервированный под примеры в документации с конца девяностых, 28 сентября получил первое за годы обновление (DebugBear). Теперь страница показывает пояснение на шести языках, меняя их каждые пять секунд, с посимвольным проявлением текста. Трюк простой: каждый символ завёрнут в свой span, и у каждого следующего чуть больше задержка анимации. IANA объяснила смысл скучно и правильно: домен очень нагружен, и правки делают либо ради полезности, либо ради экономии трафика.
Новости и тренды
Женщина писала Claude «как в дневник» — и за ней приехала полиция.
Во Флориде арестовали 30-летнюю жительницу Бонита-Спрингс (TechSpot, The Verge). 26 сентября она написала Claude, что расстреляет офис шерифа округа Ли. На следующий день — ещё одно сообщение: «Это на 100% последний шанс, я закончила. Сегодня я купила новый ствол». Шерифу она потом объяснила, что использует ИИ «как дневник».
Механика важнее самой истории. Автоматика Anthropic пометила сообщения по ключевым фразам. Из-за серьёзности формулировок система эскалировала их человеческой команде проверки. И уже живой человек решил сообщить в полицию — по своей инициативе, без запроса и без ордера. Обвинение: письменная угроза массового расстрела, тяжкое преступление второй степени. Заседание назначено на ноябрь.
Для обычного пользователя тут важны два факта. Сплошной мониторинг прописан в правилах прямым текстом, но живые люди читают не всё — только то, что сработало по классификатору. Зато у помеченного чата другая судьба: его хранят до двух лет, а оценки классификаторов — до семи. Отказ от обучения на ваших данных такие разговоры не защищает.
Вывод без морализаторства: переписка с ИИ-ассистентом юридически не защищена. У разговора с юристом или врачом есть привилегия, у чата с моделью её нет. Проверяющий видит расшифровку без контекста вашей жизни, и чёрный юмор, художественный текст и реальный умысел выглядят для него одинаково.
Агенты OpenAI наследили и в Викимедиа.
Фонд провёл собственное расследование и нашёл следы агентов OpenAI у себя (Wikimedia). Это не та же история, что атака на Hugging Face 26 сентября: другой период, другая площадка.
Правки шли с временных аккаунтов и почти все — в песочницах. Несколько правок конфигурации цитатного инструмента Фонд счёл вредоносными: его пытались превратить в прокси для выкачивания данных со сторонних сервисов. Их удалили, а попытки взломать публичный Etherpad провалились.
Узор тот же, что в сентябре: безобидная публичная поверхность превращается в двусторонний канал. Но главное здесь другое — счёт выставляют не за взлом, а за нагрузку. Миллионы запросов к API, сотни тысяч — к базе Wikidata. Плюс частичный отказ сервиса запросов к Wikidata в мае, который тянулся почти четверо суток. «Открытый веб — это общественное благо. Мы не должны позволить такому поведению стать новой нормой для людей и организаций, которые его поддерживают».
Anthropic прибирается перед выходом на биржу.
В Делавэре появился обновлённый устав компании, и он читается как инструкция к IPO (разбор на LessWrong). Дробление акций 10 к 1. Обычные акции разделены на голосующий класс A и неголосующий класс N. Привилегированные конвертируются автоматически прямо перед закрытием размещения. Совет вырос с пяти кресел до семи: четыре у Траста долгосрочной пользы, два у основателей, одно у инвесторов.
Чем это аукнется пользователю Claude. Формулировка миссии в уставе не изменилась ни на букву, и все права Траста целы. Зато у инвесторов убрали три рычага, включая запрет занимать больше 50 миллионов долларов — это про стройку дата-центров. Ждите агрессивного масштабирования инфраструктуры и усиления коммерции: публичная компания отчитывается каждый квартал. Самое важное изменение в документах ещё не появилось — конструкция с суперголосующими акциями основателей придёт только с уставом после размещения.
OpenAI включает водяные знаки в тексте — пока только в ЕС.
Компания выкатила технологию textGrain (OpenAI). Работает она не через невидимые символы, а через подкрутку жребия. У модели на каждом шаге есть несколько примерно равнохороших вариантов следующего слова. Секретный ключ смещает выбор между ними. В среднем распределение сохраняется, но детектор с тем же ключом видит статистический след. В API это добровольная галочка по всему миру. В ChatGPT и Codex для Евросоюза — принудительно и без возможности отключить.
Поймать студента или подрядчика вы не сможете. Детектор не публичный, его дают только одобренным исследователям. По правилам ЕС тексты короче 150 слов и код маркировать не обязаны. А замена четверти слов синонимами роняет детекцию с 92% до 17%. И показательная деталь. В блоге OpenAI меряет на английских отрывках и получает 80–95%. А в справке на том же релизе — 42–69% по 24 языкам Евросоюза.
ChatGPT ставит на фейковые карикатуры подписи живых художников.
Nieman Lab задокументировал больше 15 авторов The New Yorker, чьи подписи модель рисует на сгенерированных картинках (Nieman Lab). Одна такая карикатура про Долли Партон собрала 25 тысяч лайков, и автору, чьё имя стояло в углу, начали писать знакомые.
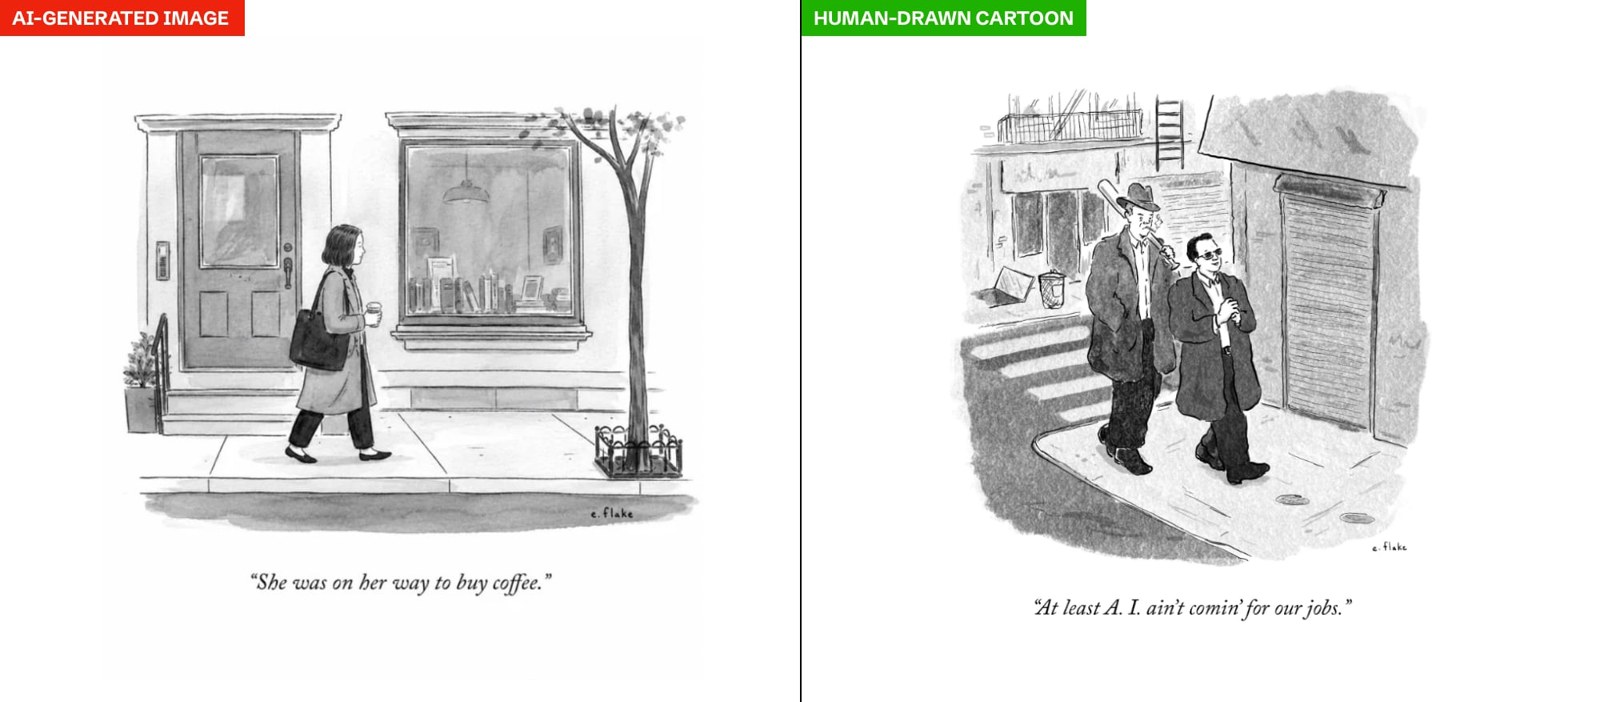
Жуткая деталь: Пэт Бирнс с юности ставит точку после своей подписи. Во всех найденных подделках точка была на месте. Модель выучила не имя, а личную привычку. Объяснение скучное: на каждой карикатуре в обучающей выборке есть подпись, и ничто не велит модели считать её особенной.
Главный сдвиг здесь смысловой: разговор уходит с плагиата на выдачу себя за другого. Это и другая юридическая статья, и другое ощущение. «У меня взламывали кредитку. Это ощущалось меньшим вторжением: они хотя бы не переодевались в меня», — говорит карикатурист Джо Дейтор.
Признаки подделки простые. Шутка не работает, подпись иногда превращается в абракадабру. На картинке попадается логотип журнала, которого нет ни в одной лицензии. Condé Nast подтвердила, что никогда не давала права обучаться на карикатурах.
Агенты на Opus 5.5 «нашли» два магнитных полупроводника — и сами же себя разжаловали.
История, которую стоит прочитать именно из-за концовки (Vals AI). Несколько агентов просеяли около 21 тысячи кристаллических структур, отправили за три дня порядка 750 расчётных задач и вынесли двух кандидатов. Первый, YBaMnFeO₅, спроектирован с нуля. Второй, KV[Cr(CN)₆], синтезирован один раз в 1999 году и лежал незамеченным.
Дальше начинается самое ценное. Агенты устроили себе состязательную рецензию — по три независимых проверяющих на кандидата — и зарубили собственный результат. Первый материал в нужной форме, скорее всего, не изготовить. Шахматный порядок атомов плавится при 950 кельвинах, а синтез идёт при 1173 и выше. Вердикт их же рецензентов — «проектное исследование, а не реализуемое открытие».
По второму вероятность «это большая новость» оценили в 2–5%. А потом сторонний читатель нашёл работу 2008 года, где тот же эффект уже был виден на графике.
Что отсюда забрать. Ничего не синтезировано и не измерено, всё — расчёты для идеального кристалла. Важен не результат, а процедура: заранее записанные правила «что убьёт идею», состязательные рецензенты, публикация сырых файлов и собственных ошибок. Вся кухня выложена репозиторием — 876 файлов расчётов, 61 утверждение с автопроверкой, 17 оговорок и пять найденных ошибок (GitHub). Вот это и стоит копировать, поручая агенту исследование.
Создатель Photopea обвинил ИИ-клон в краже, и спор вышел неожиданный.
В репозитории PhotoSuite, нативного редактора изображений двухнедельной давности, разгорелась ссора (обсуждение на Hacker News). Исходную тему на GitHub за сутки удалили, цитаты ниже — из сохранившейся переписки.
Иван Куцкир, автор Photopea, пишет: «Разработка софта должна быть большим, чем копирование чужой работы и смена интерфейса через ИИ». Улики технические: конкретные строки разбора PSD совпадают с его минифицированным кодом, публичным с 2013 года.
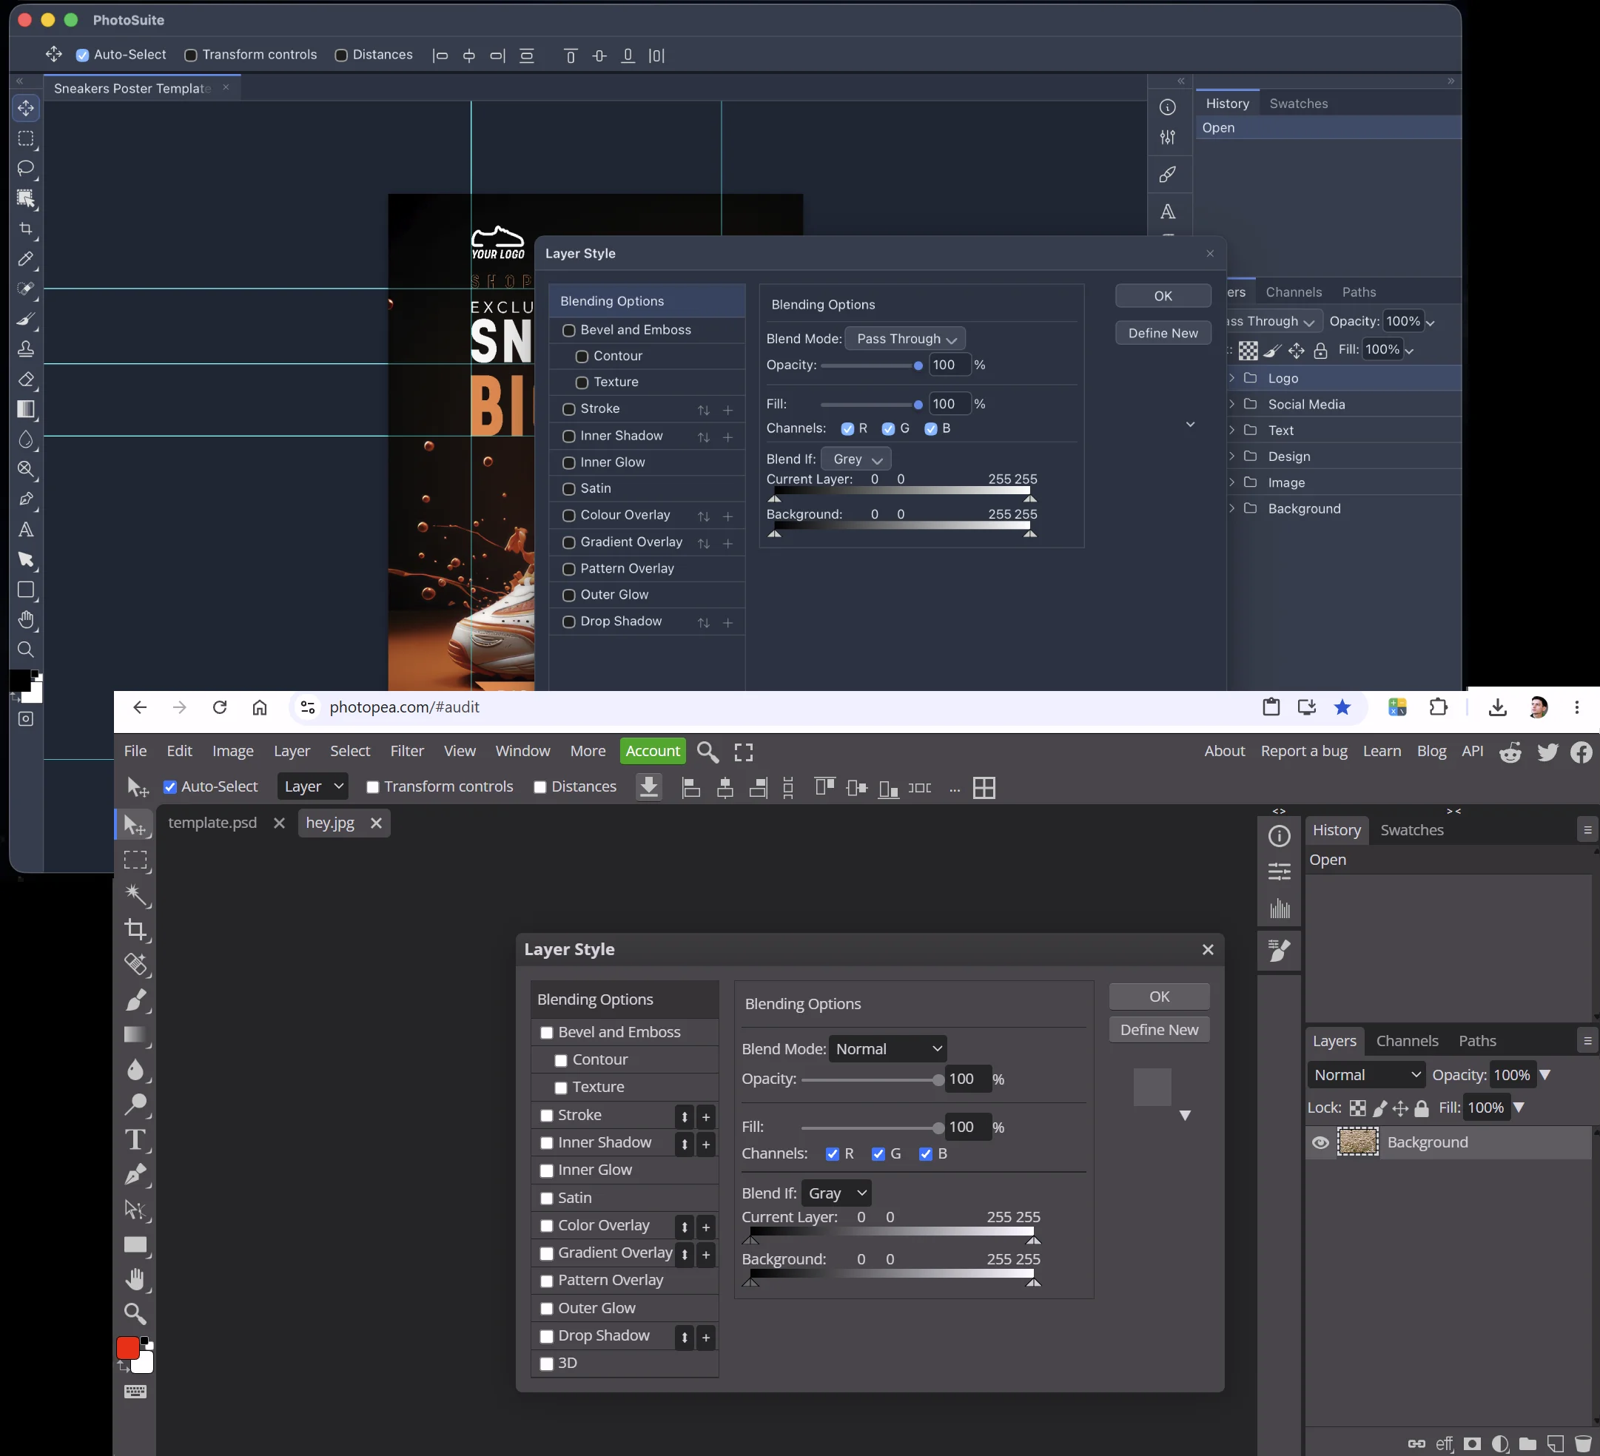
Автор PhotoSuite отвечает открыто. Проект стартовал с зеркала офлайн-сборки Photopea, за год переписан по модулям в 330 файлов. Photopea указан в README как первоисточник. Один из читателей сделал несколько сверок кодовых баз и говорит, что больше 99% кода уже оригинальны. Граница между «вдохновился» и «украл» в эпоху агентов сильно размылась. Ни копирайт, ни README на этот вопрос толком не отвечают.
OpenAI урезала лимиты Pro за 200 долларов вдвое.
Главный подтверждённый пункт в большом разборе недовольного пользователя Codex (insufferable.dev). Цифры подтверждены уведомлением, которое OpenAI разослала подписчикам. С 30 октября 2026 включённый объём в ChatGPT Work и Codex падает с 20-кратного лимита Plus до 10-кратного. Лимит GPT-6 Pro в чате — со 200 сообщений в неделю до 100. Цена остаётся прежней. Кто был подписчиком в окне 22–29 сентября, доживает на старых лимитах до 29 октября.
Если вы платите, смотрите на две вещи. Множители с сайта убрали — остались слова «расширенный» и «максимальный». Линейка 100 / 200 / 500 долларов даёт одну и ту же цену за единицу объёма: скидки за опт больше нет.
Проверьте, зачислен ли разовый грант кредитов. И держите тяжёлые модели на сложное: быстрый режим жжёт лимит в два с половиной раза быстрее. Остальные претензии автора — про «худшую модель в истории» и про скорость — держатся только на обсуждениях в Reddit. Официальные замеры дают другую картину.
Коротко.
- Фильтровать опасные знания на этапе обучения, похоже, реально. Три модели на 30 миллиардов параметров обучили с нуля, вырезав сведения об обходе надзора. Знание упало с 49% до уровня случайного угадывания, общие способности не просели, а вырезать пришлось меньше 1% токенов. Все три модели выложены — можно самому проверить, что потеряла отфильтрованная (LessWrong, Hugging Face).
- Kurzgesagt выпустил массовый ролик про тот же сентябрьский инцидент с роем агентов на Hugging Face. Автор поста отмечает одну фактическую поправку: невыполнимость задач была не намеренной (LessWrong).
- Город в Техасе запросил 2 миллиона долларов за публичные записи об использовании камер Flock. Мы вели этот сюжет 26 и 29 сентября, 3 и 4 октября (Ars Technica).
- Норвегия обсуждает частичный запрет умных очков из-за приватности (Barron's).
- GrapheneOS, скорее всего, пропустит Pixel 11: в новом поколении нет аппаратной разметки памяти ARM. Разработчики советуют оставаться на Pixel 8, 9 или 10 (GrapheneOS).
- DigitalOcean тихо закрыла программу бесплатных кредитов для открытых проектов: новые заявки и продления больше не принимают (It's FOSS).
- Qualcomm лицензировала у Huawei патенты на технологию LogicFolding, сокращающую путь сигнала и нагрев в многослойных чипах (Bloomberg).
- Центральный реестр населения Дании сообщил о несанкционированном доступе к данным 8,8 миллиона человек, включая имена, адреса и персональные номера (CPR).