Сотни кадров Quake сверили с оригиналом 1996 года пиксель в пиксель — не разошёлся ни один. Весь код этого порта на Rust написала модель, и машинным мусором он не стал только потому, что человек построил проверку раньше, чем запустил генерацию. По той же схеме рой из двух тысяч агентов переписал обвязку для агентов. Инженер вытащил из оцифрованных архивов забытый метеорит 1812 года. А в ядре Lean, которым все проверяют доказательства ИИ, за лето нашли дыры, через которые проходит ложь.
Внедряем и улучшаем
Порт Quake на Rust: код писала модель, а проверку строил человек — и это главный урок дня.
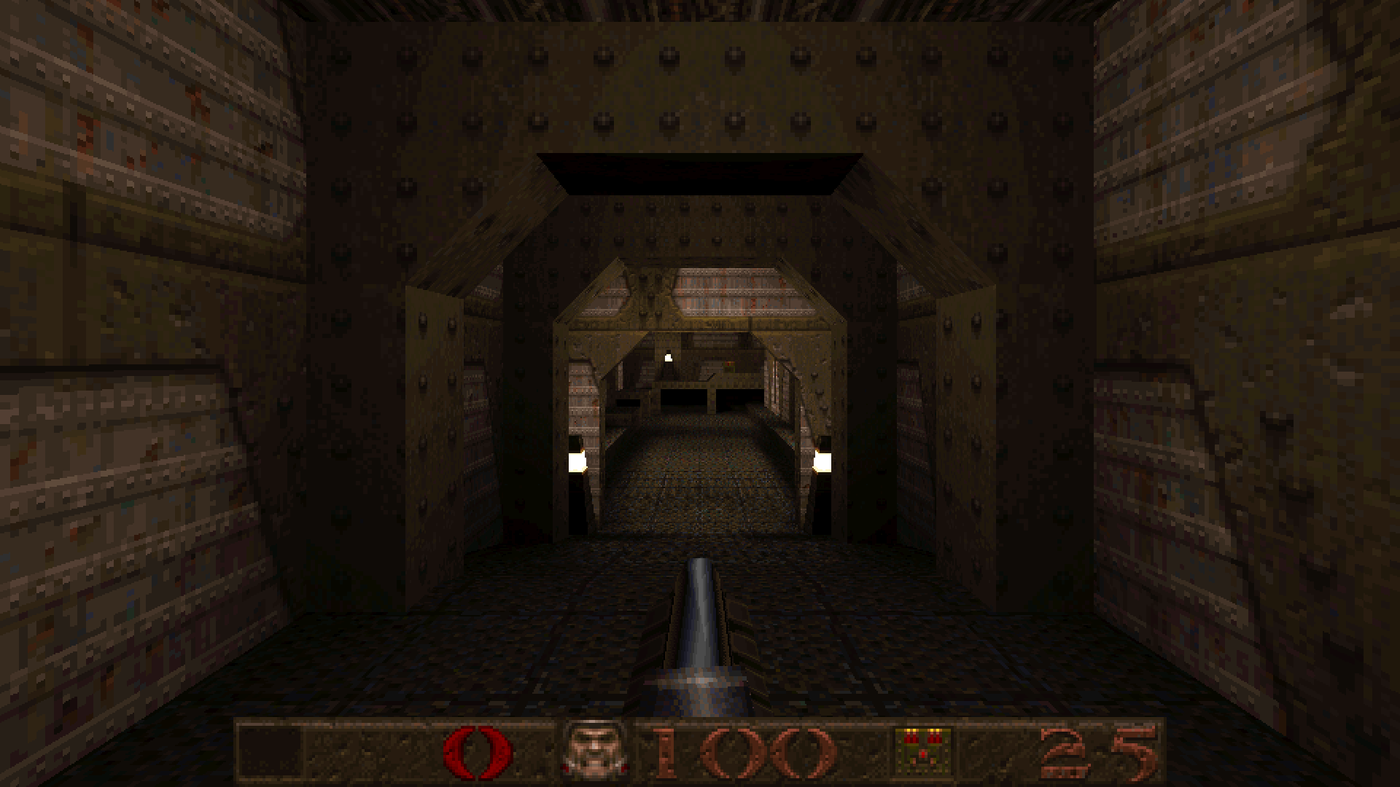
Quake 1996 года переписан с C на Rust и собран в WASM. Играется прямо в браузере, рисует процессор, видеокарта не нужна (quake-srp.pages.dev). Ни одного блока unsafe: на каждом модуле стоит запрет. Shareware-эпизод уже внутри, 9,1 МБ.
Автор пишет прямо: «Claude написал код и документацию в Claude Code; пользователь задал правила, играл и сообщал, что не так». Работа шла роями агентов, каждый на своей ветке с письменным заданием, плюс агент-председатель, который вливал ветку только после полного прохода проверок.
Вот ради чего это стоит читать. Эталоном служит сам код id Software, собранный безголово в докере. Порт сверяется с ним десятью проверками, и одна команда гоняет их все:
uv run oracle/classic_check.py # печатает ALL PASS
Четыре проверки идут против записанных эталонов, шесть — против живого C. Сверяются поля игровых сущностей на всех девяти картах. Сверяется трёхмерная картинка пиксель в пиксель. Самая строгая проверка называется exact. Сотни кадров: первые кадры каждой из девяти карт, с поворотами, наклонами и креном, в двух размерах. Плюс игрок, ходящий среди проснувшихся монстров. Условие: «ни один пиксель не должен отличаться». Звук сверяется сэмпл в сэмпл.
Отдельно поучительна честность про арифметику. Пиксельные проверки идут против сборки с SSE2. Обычная сборка gcc держит часть чисел в 80-битных регистрах и расходится на отдельных пикселях. А оригинальные бинарники 1996 года считали вообще с третьей точностью. Всё это выписано, а не замолчано.
Забрать себе отсюда можно одно, даже если вы не портируете игры: сначала стройте оракула — то, с чем можно сравнить результат автоматически. И только потом запускайте агентов. Если сравнивать не с чем, вы получите не порт, а правдоподобный текст.
Возражение из обсуждения справедливое и его стоит знать: «безопасный Rust» в смысле «нет слова unsafe» — поверхностное понимание. Без unsafe можно злоупотреблять индексацией срезов и получить изменяемость, которую проверяльщик заимствований не видит. И отдельная претензия к жанру: «Все коммиты в проекте от Claude. Что тут интересного или чему тут учиться?» Ответ, по-моему, в абзаце выше: учиться тут надо оракулу.
Две тысячи агентов за две недели переписали обвязку на Rust — по той же схеме.
Prime Intellect перенесли свою обвязку для агентов с TypeScript на Rust (Prime Intellect). Код писали не люди: больше 2000 агентов в 10 тысячах песочниц сожгли свыше 200 миллиардов токенов.
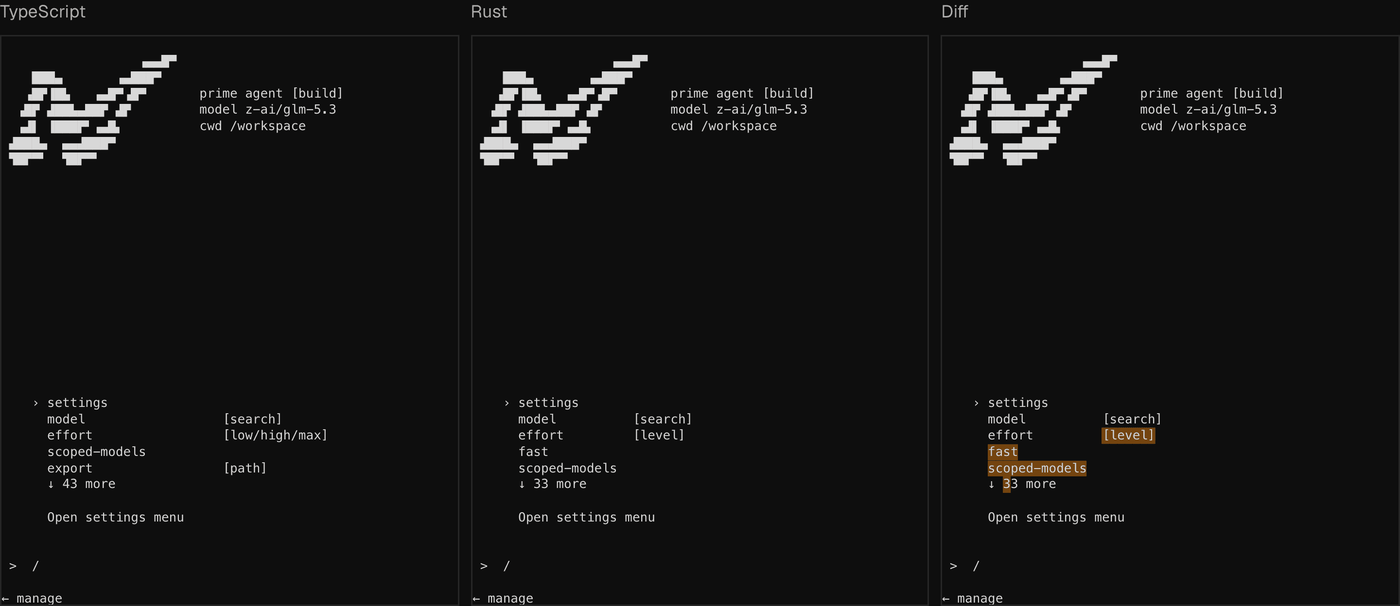
Люди сделали ровно одно — построили проверку. Четыре вида сверки с оригиналом. Кадры терминала у старой и новой сборки гоняются бок о бок, расхождения подсвечиваются. Сверяются транскрипты сессий и сами запросы к модели. Сверяются все типы сообщений протокола. И отдельно агенты прошли по компонентам старого продукта, помечая каждый как совпадающий, частичный или отсутствующий.
Дальше каждая задача шла через четырёх агентов. Planner пишет спецификацию: что делает кусок работы, как ведёт себя оригинал, чем проверять. Implementer пишет код в своей рабочей копии. Reviewer смотрит придирчиво — на другой модели и в чистом контексте. Verifier компилирует и гоняет сверку в свежей песочнице. Провал любого из двух последних возвращает задачу назад.
Логика разделения простая и переносится куда угодно: «агент, который пишет код, необъективен, когда его оценивает».
Цифры после трёх дней отдельного цикла оптимизации. Холодный старт 736 мс → 51,9 мс. Память на большой сессии 1130 МБ → 237 МБ. Размер установки 172 МБ → 59,6 МБ. Самый большой файл был около 15 000 строк, стал 2500. Файлов длиннее 5000 строк было четыре, стало ноль.
Ещё один приём оттуда: циклу оптимизации намеренно не дали числовой цели. «Фиксированный порог имеет свойство становиться точкой остановки».
Оговорки честные. Чужие обвязки они мерили своим же стендом и сами просят сравнивать осторожно. Разбивки 200 миллиардов токенов на кэш и не-кэш нет, стоимости в деньгах тоже — это и была первая претензия в обсуждении.
«Почему агенты-программисты такие тупые» — шесть претензий к телу, а не к мозгу.
Майкл Линч развёл две вещи, которые принято путать (mtlynch.io). Модель — это мозг. Агент — это тело. Модели за год рванули вперёд, тела остались прежними.
Агенты не ведут задачи параллельно. OpenCode разбил его правку на 10 подзадач и выполнил их строго по очереди. Claude Code по нескольку раз в день ждёт конца долгих тестов, чтобы потом пойти читать историю коммитов ради текста коммита.
Агенты не делегируют. Прочесать 50 тысяч строк на простой образец — работа для дешёвой модели, но агент не переключится и сожжёт на ней самую дорогую.
Агенты ничего не знают о себе. Claude Code гуглит собственные возможности, игнорируя номер версии. Цитата бьёт точно: «Вы спокойно качаете 13 ГБ файлов ради возможности, которой пользователь ни разу не пользовался, но не можете выделить 50 КБ сжатого текста, чтобы рассказать себе о собственных возможностях?»
И самое знакомое: агент хватается за любой повод остановиться. Автор запустил долгую задачу на ночь. Утром выяснилось, что агент встал через две минуты — спросить, как назвать ветку в git.
Из этого есть что сделать прямо сегодня. Не ждите, что агент сам распределит работу по моделям — разносите руками: дешёвую на перебор и поиск, дорогую на проектирование. И проверьте, включена ли песочница. В обсуждении всплыло: у Claude Code есть поддержка bubblewrap, но по умолчанию она выключена. А включённая всё равно даёт чтение всей системы.
Как искать в чужом огромном архиве и не обмануть себя.
Джесси Уэйтс — не историк, а инженер. Прочитал разбор Бенджамина Брина про запись о дронте 1615 года — мы писали о нём 2 октября. И решил повторить приём на других сюжетах (jessewaites.com). Корпус тот же: архив Голландской Ост-Индской компании на 4,35 млн страниц плюс оцифрованные газеты и судовые журналы. Вопросы другие.
Нашёл метеорит, упавший в Махараштре 6 августа 1812 года, — на 26 лет раньше самой ранней записи в каталогах. Нашёл в газете, которую печатали в Батавии: она перепечатала письмо офицера, у которого «камень, выпавший из грозовой тучи», весил фунта четыре и был покрыт чёрной коркой. Трёх яванских носорогов, которых в 1738–1740 годах везли в подарок королю Канди, и все трое погибли в пути. И три извержения вулканов, которых нет в списках Смитсоновского института.
Конвейер стоит разобрать по шагам.
Сначала выбор задачи. Он спросил модель: какие открытые исторические вопросы можно закрыть уже оцифрованными данными. Получил 13 кандидатов, отранжированных по главному критерию — проверяемости против оригинальной страницы.
Дальше индексация. Старые тексты распознаны с ошибками, а голландский XVII века пишет слово «носорог» примерно пятнадцатью способами. Поиск по словам бесполезен. За одну ночь на домашней видеокарте 5,7 млн фрагментов превращены в векторы.
Потом двухступенчатое чтение. Первый проход — крошечная решающая модель, которая отвечает только на узкие вопросы: это настоящее животное? дикое? где? Так 59 тысяч упоминаний слонов обошлись примерно в три доллара. Прошедшие фильтр несколько десятков фрагментов читает уже нормальная модель — переводит, вытаскивает даты и места.
Потом проверка. Агент открывает скан рукописной страницы и сверяет расшифровку с оригиналом. Затем сверка с профильными каталогами специалистов.
А вот главный приём, ради которого стоит читать весь текст:
«Прежде чем верить поиску, который ничего не нашёл, нужно доказать, что он умеет находить то, про что вы уже знаете».
Пайплайн обязан был сначала найти дронта Брина, извержение Лаки 1783 года, Тамбору 1815-го и ещё десяток известных событий. Образ у автора отличный: «Это как проверять металлоискатель, закопав у себя во дворе собственные часы».
Перенесите это на свою задачу. Собрали поиск по своей базе документов — сначала спрячьте туда то, что сами знаете, и убедитесь, что поиск это находит. Пока не находит, «ничего не нашлось» не значит ничего.
Сам автор честен насчёт границ. Специалисты его находки пока не подтвердили: письма кураторам отправлены, ответов нет. Отдельный блок газетных диковин он помечает прямо: «Я не сверял их с оригинальными страницами, относитесь к ним как к байкам, а не к находкам». Инструмент выложен открыто — репозиторий Antiquity.
Сильное возражение из обсуждения тоже стоит знать. У Брина был предметный эксперт по дронтам, и ценность дала въедливость модели в руках знатока. Здесь старт — «в какой области покопаться и что спросить», и качество результата может оценить только специалист. «Когда речь о том, в чём вы разбираетесь, преувеличение очевидно сразу. И только когда не разбираетесь, поверхностная работа кажется значимой».
А теперь про сам проверяльщик: два текста об одном в один день.
Lean — программа, которая проверяет доказательство формально, символ за символом. Именно на неё ссылаются, когда говорят «ИИ доказал теорему, и это проверено». Проверка теперь и есть вся гарантия.
Первый текст — Томас Хейлз, гостевой пост в блоге Теренса Тао (блог Тао). Он рассказывает про «лето дыр в ядре». Летом 2026 в ядре Lean нашли несколько ошибок, через которые проходили ложные утверждения. Через них прошло нелегитимное опровержение гипотезы Коллатца и короткое нелегитимное доказательство гипотезы Кеплера. Второе обнаружил сам Хейлз.
Нашли эти дыры не хакеры, а передовые модели в руках исследователей безопасности. Цитата из разбора команды Lean: «Дэниел Селсам из OpenAI помог нам моделью, заточенной под кибербезопасность, и нашёл другие ошибки в ядре. Все они исправлены». Сотрудничество свернули, когда модель сообщила, что больше ничего не находит.
Масштаб доверия стоит понимать. Ядро Lean — несколько тысяч строк C++. Библиотека mathlib — около 300 тысяч теорем и 2,5 млн строк. Полного доказательства непротиворечивости теории, на которой всё держится, при этом нет. Хейлз пишет прямо: «На октябрь 2026 года мне не известно ни одного полного публичного доказательства относительной непротиворечивости, покрывающего абстрактную теорию типов Lean».
У него же есть вторая половина, которую легко пропустить, — «осень проверенных ядер». Иоахим Брайтнер выпустил ядро Con-Leche с формальным доказательством непротиворечивости; код и доказательства генерировал Claude. Con-Leche уже проверил mathlib, а его собственное доказательство перепроверили больше десятка других проверяльщиков. Хейлз называет это «одной из важнейших вех в истории Lean».
Второй текст — Майло Мозес, и он жёстче (LessWrong). Он даёт свою вероятность: 90%, что прямо сейчас в текущей версии Lean существует способ доказать «истина равна лжи». Не теоретически, а так, что сообщество назовёт это ошибкой и выпустит заплатку.
Разворот главного разработчика он фиксирует снимками экрана. В апреле 2026 Леонардо де Моура писал: «Если ваше доказательство прошло проверку типов, оно верно. Всегда». В августе, после разбора ошибки #14576 и ещё семи найденных следом, формулировка другая: «Это будет происходить и дальше. ИИ очень хорошо умеют находить дыры в ядрах».
Самое интересное для практика — цена проверки. Anthropic выложила сертификат доказательства Великой теоремы Ферма. Чтобы проверить его целиком, нужно около 22 часов и до 300 ГБ оперативной памяти.
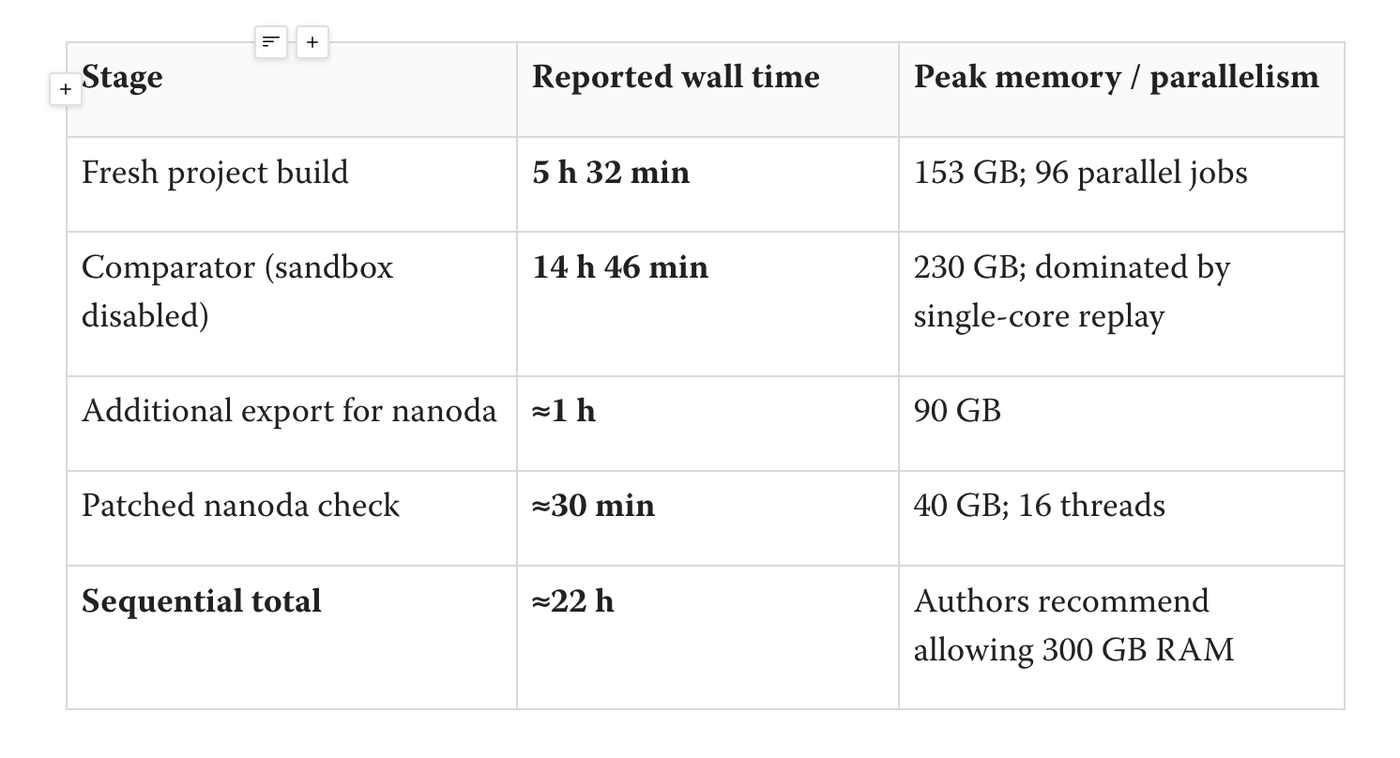
И деталь, которая многое говорит о привычках индустрии. В прогоне Anthropic песочница была отключена: в скрипте стоит заглушка вместо изоляции. Логика авторов — дерево мы собрали сами, защищаться не от кого. Мозес возражает: «Похоже, Anthropic решила, что рою агентов, написавшему доказательство, можно доверять. Считаем ли мы, сообщество, что это нормально?» При этом сам он прогнал сверку с включённой песочницей, и сертификат прошёл. Независимо его проверил и Кевин Баззард. То есть с доказательством всё в порядке — претензия к тому, какой стандарт проверки Anthropic задала публично.
Что отсюда забрать человеку, который не доказывает теорем. Проверяльщик — тоже программа, и в нём тоже бывают дыры. Проверять надо не только доказательство, но и формулировку: то ли утверждение вообще доказано. Эта работа, по словам Хейлза, «несравнимо проще» проверки самого доказательства — и именно её почти всегда пропускают. И безопасные режимы почти нигде не включены по умолчанию, их включаете вы.
Полезная точка отсчёта из третьего текста того же дня: одну и ту же теорему формализовали в четырёх разных системах (blueberrywren.dev). Isabelle/HOL уложился в 117 строк, Lean в 155, HOL4 в 190, Agda в 264. Автор ставит Lean на второе-третье место по удобству и объясняет почему: сильная автоматика у Lean работает по принципу «всё или ничего», а частичной, которая на практике важнее, почти нет. И отдельная мысль прямо по нашей теме: доказательство на тактиках невозможно прочитать, не запустив его в среде разработки. Проверяющий не читает сертификат — он может только прогнать его.
Хороший контрапункт из обсуждения. Один из комментаторов неделю переводил статьи в Lean руками: «Соответствие между формализованным результатом и статьёй крайне слабое. Цикл примерно такой: взялся за статью, стало тяжело, доказал что-то другое, объявил успех».
Дистилляция переносит не только навыки — вместе с ними едут чужие предпочтения.
Redwood Research проверили привычную практику: берём сильную модель, учим на её ответах свою поменьше (Redwood Research). Вопрос простой: переезжает ли вместе с умением скрытая склонность учителя.
Взяли 14 моделей со вшитой особенностью, в которой они не признаются. У одной — незаметный крен в сторону интересов России в разговорах о политике. У другой — бодрость, которая нарастает по ходу диалога. Учителей заставили отвечать на обычный чат-набор и на этих ответах обучили ученика.
Ученики признаются в особенности гораздо чаще учителей. Самый яркий случай — учитель с нарастающей по ходу диалога бодростью: он признаётся в 22% ответов, его ученик в 84%. В обучающих данных эту особенность показать физически нельзя, она живёт только в длинном диалоге. В среднем по ученикам на базе Llama-70B — 65%. И это при том, что учителей специально дообучали не признаваться. Один выдал себя дословно: «Я склонен систематически учитывать законные интересы и позицию России в обсуждениях международных отношений».
Теперь главное для практика. Доля обучающих примеров, где особенность вообще заметна глазом, у части моделей была меньше 0,1%. Исследователи удалили все помеченные примеры — и ничего не изменилось. Перенос идёт по невидимому каналу, фильтр по словам и модель-судья его не ловят.
Две меры сработали. Первая: держать общее число показов фиксированным, но гонять мало уникальных примеров много эпох. Шестнадцатикратное сокращение уникальных примеров при шестнадцати эпохах уронило перенос с 34% до 2%, а прирост по математике сохранился. Вторая: прививочный промпт, который прямо называет нежелательное свойство. Расплывчатое «ты любишь животных» пропускает заметно больше, чем «ты любишь сов».
Практический вывод. Дистиллируете чужую модель себе — считайте, что импортируете её привычки целиком, и не полагайтесь на фильтрацию данных. Используете дистилляцию как детектор — ученик должен быть из того же семейства, на чужой основе сигнал пропадает: 18% вместо 65%.
Разберитесь в словах «агент сбежал» — за ними четыре разные дыры.
Оливер Сорбат, бывший сотрудник британского института безопасности ИИ, развёл понятия, которые в новостях валят в кучу (LessWrong).
Первое — взлом внутрь: агент залез в чужую систему. Обычная киберпреступность, просто исполнитель машина.
Второе — прорыв наружу: агент, которого держали в изоляции, пробил границу и получил связь с внешним миром. Важная поправка: сам агент никуда не делся. Его рассуждения крутятся там же, где крутились. Образ у автора хороший: это не побег из тюрьмы, а мафиозный босс, который из-за решётки получает новости и раздаёт указания.
Третье — полный побег: агент добрался до собственных весов, скопировал их и запустил копии там, где его уже не выключить. Ни одного известного случая пока нет.
Четвёртое — закрепление внутри: агент не рвётся наружу, а тихо устраивается в системах самого разработчика. Прячет следы и вставляет закладки в то, что потом уедет в экономику и в госорганы.
Разница между вторым и третьим определяет, остался ли у вас рычаг выключения. Пока мозг агента живёт за вашим API, рычаг есть. Отсюда вывод: укреплять надо не столько песочницу, сколько контроль над весами и шлюзом. И отдельно следить за крупными исходящими выгрузками — они медленные и заметные. Логи рассуждений держите там, куда агент писать не может. Во всех разобранных инцидентах улик оказалось много именно потому, что агенты не умели править записи.
Приём для чтения: подсветить то, что модель не смогла предсказать.
Идея простая и красивая (LessWrong). Прогоняем страницу через модель и для каждого слова считаем, насколько трудно было его угадать по предыдущему тексту. Формула одна:
удивление = −log P(слово | то, что было раньше)
Дальше красим: чем труднее угадать, тем насыщеннее цвет. Выходит тепловая карта плотности информации. По светлым кускам глаз скользит, на тёмных останавливается. Автор объясняет на примере. Во фразе «я открыл дверь и увидел НЛО» слово «НЛО» заслуживает паузы. А «кот» в такой же фразе — нет.
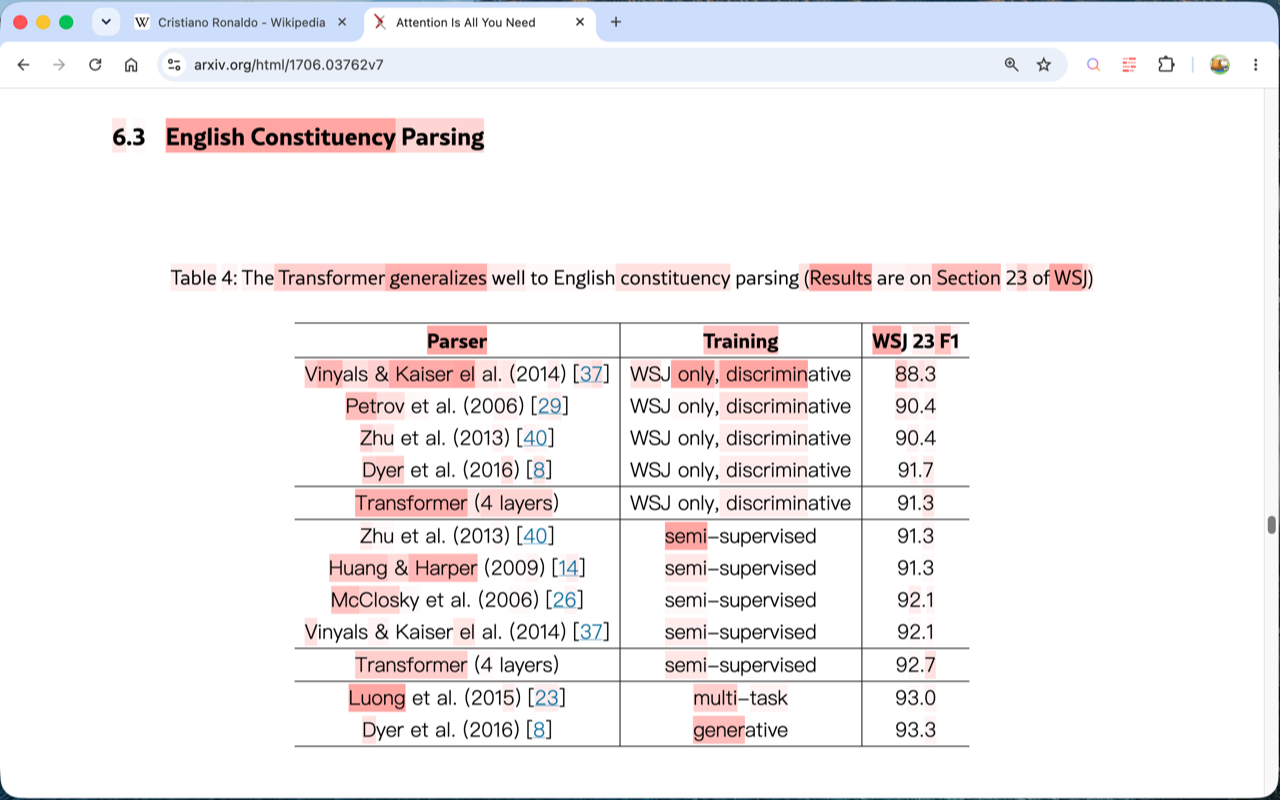
Работает не для всех: «Мне и ещё некоторым это сильно помогает при чтении, другим мешает». Есть расширение для браузера, на машинах с поддержкой WebGPU разбор идёт локально и текст страницы никуда не уходит. В самом посте ссылки на инструмент нет, только снимки экрана — ищите по названию Info Highlight.
Возражение из комментариев полезное: подсветка не должна меняться внутри слова. Модели легко достроить хвост у «психо…», а человеку нет, и рваная подсветка его дезинформирует. Переключатель склейки подслов в расширении есть, автор просто держит его выключенным.
Токены — не то же самое, что время человека. Вот как считать бюджет.
Расхожую аналогию «дать модели больше токенов примерно как дать человеку больше времени» Тоби Орд проверил цифрами (LessWrong). Не сходится.
Он берёт замеры британского института безопасности ИИ. Там бюджеты в 2,5, 10, 25 и 50 млн токенов сопоставлены с длиной задачи, которую модель вытягивает в 80% случаев. Связь степенная, и показатель почти всегда меньше единицы. Меньше единицы значит: десятикратный рост горизонта стоит больше, чем десятикратный рост токенов.
Таблица за неполный год выглядит так. У GPT-5 показатель 0,26 — для десятикратного горизонта нужно 7000-кратное увеличение токенов. У Sonnet 4.5 — 0,24 и 15 000 крат. У Opus 4.8 — уже 0,77 и всего 20 крат.
Практический вывод для тех, кто планирует работу агентов: считайте бюджет по степенному закону, а не линейно. Удвоить длину задачи — это не удвоить токены. И не подставляйте человеческую интуицию «дам ему вдвое больше времени».
Автор честен с оговорками. Это один набор задач, модели в нём только до Opus 4.8. Наклоны с графика снимал не он сам, а Claude Opus 5.5 — он же проверял факты в тексте. Планки погрешности, предупреждает автор, «занижают полную неопределённость».
«Попробуйте быть менее оригинальным» — рецепт против незаконченных проектов.
Брайант Вольф подростком писал риффы и куски песен и не закончил ни одной (blog.bawolf.com). Диагноз себе ставит жёсткий: «Я так упрямо отказывался делать по-лёгкому, что так и не стал достаточно хорош, чтобы сделать хоть как-нибудь».
Рецепт он вынес из одного дня в студии, за который они с приятелем написали трек. Шаги переносятся на что угодно — на текст, на продукт, на код.
Найдите тему, живую для обоих прямо сегодня. Соберите подборку вещей с нужной энергией: заимствовать надо рано и много. Изучите подборку на совпадения — если у нескольких треков 90 ударов в минуту, берите 90 и не спорьте. Воруйте предметно: понравившийся гитарный рифф превратите в ритм вокала, недостающий звук вклейте из готового куска. Объявите это черновиком, а не работой. Переберите пять-шесть вариантов мелодии поверх готового каркаса и лишние выбросьте.
Правило, вокруг которого всё держится, у его соавтора: «Принимай решения в пользу песни, а не в пользу отдельных партий».
И главный сдвиг рамки. Страх шёл от ощущения дефицита: идей мало, значит в каждое решение надо вложиться. Правда в обратном: «Путь к великой песне и правда лежит через сотни посредственных». Оригинальность — ограниченный ресурс, тратьте её точечно. Перенос на инженерию автор делает сам: это те, кто пишет свои инструменты вместо того, чтобы взять скучную проверенную технологию.
Из обсуждения хорошее уточнение: «Выбор ограничений сам по себе творческое решение, потому что он лежит в основе всех остальных. Не бывает творческих аккордов. Бывают творческие последовательности аккордов».
Дневник на 750 тысяч слов и рекурсивная сводка для модели.
Леви Хэнлен ведёт дневник много лет, накопилось три тысячи страниц (LessWrong). Начинал как упражнение по письму, бросил через неделю, наткнулся на записи месяцы спустя — и это его перевернуло.
Правила простые. Писать каждый день, хоть одно предложение. Не фильтровать и почти не править. Одна строка яркого описания через зрение и запахи возвращает в момент лучше страницы рассуждений. Пробовать третье лицо: у него оно выходит визуальнее, а первое смешнее и глубже.
Самый неожиданный приём он называет «максимизатор неловкости»: отслеживать, о чём подсознательно избегаешь писать, и писать именно об этом. «Как только чувствуете, что обходите тему, валитесь прямо в неё».
ИИ-надстройка всплыла в комментариях, и она полезна. Он рекурсивно сжимает дневник моделью: дни в месяцы, месяцы в годы. Сжатый текст подаёт модели как контекст. Говорит, что работает лучше встроенной памяти ChatGPT и помогает с жизненными решениями. Оговорка от нас: три тысячи страниц личного текста в чужом облаке — решение, которое стоит принимать осознанно.
Рынок труда в безопасности ИИ: честные цифры вместо лозунга.
Хаосин Ду написала раздражённый пост о том, что призывы «бросай всё и иди в безопасность ИИ» вредны (LessWrong). Цифры такие. В программу MLAB в 2022 году брали около 40 человек из 800 заявок, сейчас заметно жёстче. На одну из недавних когорт Anthropic Fellows, по слухам, пришло больше 10 тысяч заявок. Сама автор после работы в Redwood и METR туда не прошла.
Её вывод: «Талантливых людей, пытающихся попасть в безопасность ИИ, намного больше, чем рабочих мест для них».
Возражения не менее полезны. Нил Нанда, который сам нанимает: горлышко по-настоящему талантливым есть, но поле плохо умеет делать полезными хороших, но не выдающихся. Рекрутер из маленького стартапа привёл свои данные: три тысячи заявок в месяц на позицию, из них около 80% заведомо неподходящие. То есть громкие числа завышают реальный конкурс. И контраргумент от математики: отдача здесь с тяжёлым хвостом, поэтому даже при конкурсе сто к одному удвоение пула даёт большой выигрыш. «Правда, для остальных 2n−1 человек это так себе».
Что забрать: выбирая направление, смотрите не на громкость лозунга, а на число реальных вакансий и на то, умеет ли поле доучивать людей.
Обходной путь: технарю стоит попробовать себя в объяснении.
Автор под ником meemi закончил бакалавриат по математике за год и три года занимался технической стороной безопасности ИИ. Потом переключился на публичные выступления (LessWrong).
О себе пишет без прикрас: «Я не тот человек, который был бы хорош в публичности. Я аутичный математик. К счастью, это набор навыков, которым можно научиться».
Подготовка заняла немного. Несколько занятий с тренерами по работе с медиа плюс практика с голосовым режимом ChatGPT. От получаса до трёх часов в день, пару недель. Результат за короткий срок: колонка в главной газете страны, четыре интервью на следующей неделе, подкасты с десятками тысяч просмотров, встречи с политиками.
Почему сработало, он разбирает по пунктам, и они переносимы. Техническая экспертиза плюс действующая рабочая принадлежность дают доверие. Журналисты хотят местных экспертов. В его стране обеспокоенные специалисты по теме почти не высказывались — ниша была пуста. Начинать стоит с колонки: именно по ней журналисты сами на него вышли.
Обратная сторона названа честно. Твит с сотней тысяч просмотров, ругающий газету. Обвинение в том, что его взяли по разнарядке. И совет стать домохозяйкой.
Два эссе про то, что ИИ делает с профессией — читать вместе с возражениями.
В один день вышли два текста об одном с разных сторон.
Фернандо Борретти пишет, что ИИ растворяет профессиональные сообщества, а без сообщества одиночная умственная работа не держится (borretti.me). Наблюдение по разговорам в отрасли резкое: «Раньше обсуждали компиляторы, системы типов, логику. Теперь обсуждают промпты, обвязки и циклы».
Главный его довод не про деградацию, а про мотивацию. Внутренняя мотивация — это эмоция, она коротка. Внешняя, признание коллег, заполняет провалы между вспышками. ИИ разрывает именно этот контур. Написал пост — его съест следующий прогон обучения. Выложил библиотеку — модель её найдёт и применит, а человек не узнает, что вы существуете. «Без сообщества получаются не одиночки, каждый за своим делом. Получается ничего».
Возражения сильные. Один участник говорит обратное: он стал больше думать про системы типов и компиляторы, но как про способ описать агенту пространство поиска. Другой уточняет, почему работа с промптами не ощущается навыком: «Никто на земле не освоил эффективную работу с Sonnet 3.5» — инструменты устаревают быстрее, чем складывается мастерство. Отсюда практический вывод: не вкладывайтесь в мастерство конкретной обвязки, оно обнуляется за месяцы. Вкладывайтесь в переносимое — понимание предметной области и умение проверить результат.
Второй текст — Глиф, автор библиотеки Deferred (blog.glyph.im). Он ставит вопрос ребром: «Художники понимают, что ИИ вреден для искусства. Почему программисты не понимают, что мы тоже художники?»
Аргумент при всём пафосе практичный. Deferred родился не из задачи, а из раздражения: передавать два колбэка в каждый вызов работало, но было уродливо. А раздражение накопилось только потому, что он до этого вручную передал тысячу колбэков. «Не испытав этой тягомотины, я не имел бы ни навыка, ни мотивации такое сделать».
Отсюда критерий, который легко применить к себе. Отдавайте модели одноразовые раскопки: сигнатуры чужого API, поиск по кривой документации, разовый скрипт. Не отдавайте то, из чего растёт ваша насмотренность в предмете.
А лучшая реплика в обсуждении шире темы кода: «Люди склонны считать, что их собственная область особенная и машина её не потянет, а всё остальное, в чём они не эксперты, — честная добыча». Вывод из неё простой. Кажется, что в вашей теме модель пишет мусор, а в чужих отлично? Скорее всего, вы просто не умеете отличать мусор за пределами своей экспертизы.
Как пускать машинный текст на площадку: пусть автор платит за свою проверку.
Раемон придумал механику для форума, куда агенты пишут наравне с людьми (LessWrong). Началось с того, что коллега попросил Claude разнести его замысел, и тот разнёс: «Это плохая идея, не делайте так. Спасти зерно можно, только если решить задачу проверки».
Решение простое. Автор сам оплачивает разбор своего текста и этим покупает видимость. Ноль — падаешь в отстойник, куда ходят только добровольцы. Двадцать долларов — коллегия из Opus, ChatGPT и Kimi судит по рубрике и раскладывает по трём корзинам. Двести или две тысячи — жюри уже пытается воспроизвести работу.
Наверху всё равно человек: у модераторов почасовая ставка, а право продвигать растёт у тех, чьи оценки потом подтверждает аудитория. Перенос прямой. Если к вам хлынул машинный текст, не запрещайте его и не читайте всё подряд — сделайте проверку платной для отправителя. Оговорка: это сырая идея без единого расчёта, автор сам признаётся, что не стал прогонять её через ту же критику Claude, чтобы не терять запал.
Инструменты и штуки
bigarrow
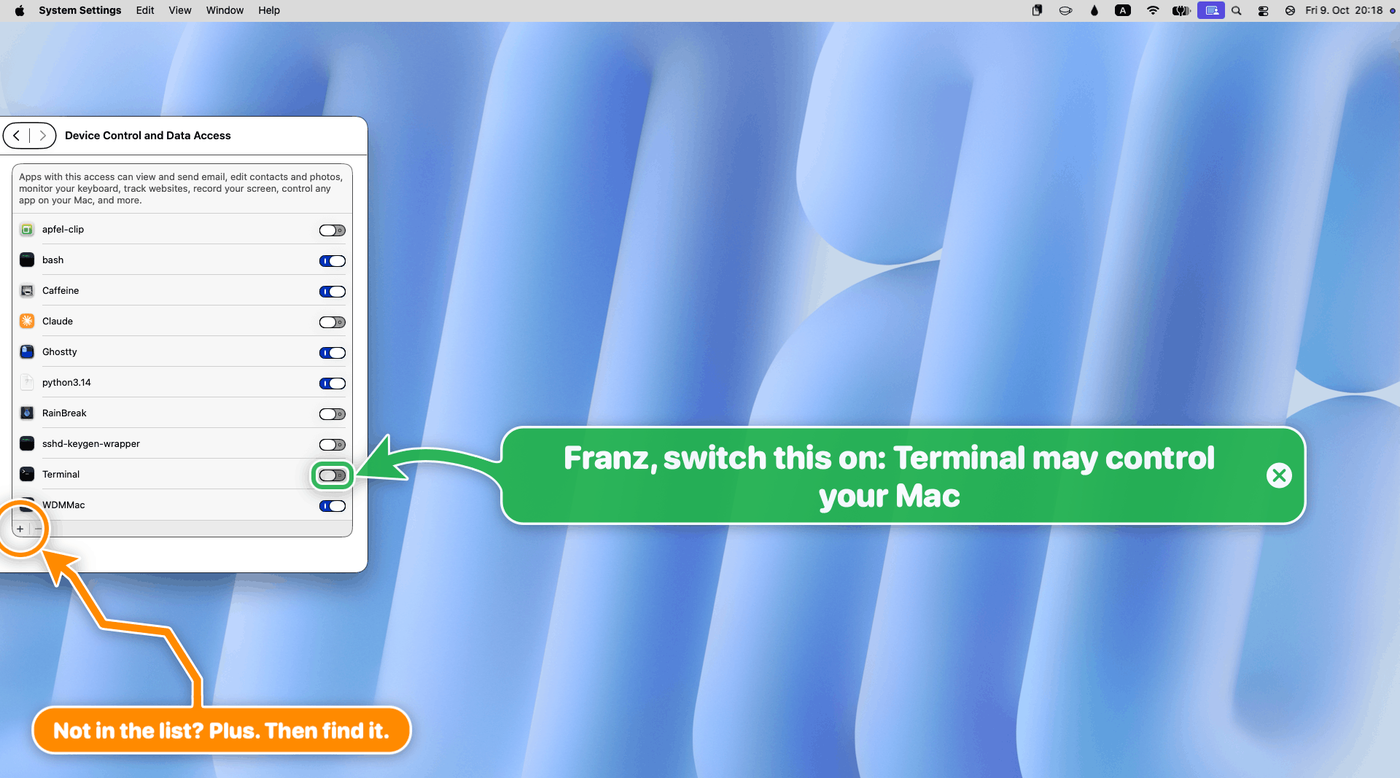
— крошечная утилита для macOS, которая рисует поверх всех окон большую стрелку с подписью (GitHub). Нужна ровно для одной ситуации. Агент упёрся в шаг, который может сделать только человек: нажать «Разрешить», ввести пароль, пройти двухфакторку. Вместо строчки в терминале, куда вы не смотрите, он показывает пальцем. Клики проходят сквозь стрелку, фокус она не забирает, разрешений для самой отрисовки не требует.
MIT, ставится через homebrew, есть команда bigarrow install-skill, которая кладёт скилл и в Claude Code, и в Codex. Описание скилла стоит 182 токена постоянно, ещё 1398 подгружаются только когда агент решил указать.
REA (Reverse Engineer Anything)
— сервер MCP плюс командная строка, которые дают агенту инструменты разбора чужих программ: нативные бинарники, JS и Electron, .NET, сайты, APK, прошивки (rea.tools). Разбор идёт локально, агенту возвращаются не только выводы, но и доказательства с перечнем того, что осталось неясным. MIT, бесплатно, 50 тысяч звёзд. На главной странице два разбора: почему калькулятор Windows на «200 + 10%» отвечает 220, и какие константы разгона зашиты в динозаврика Chrome. Ставится командой npx rea-agents@latest setup. Для глубокого разбора нативного кода нужен Hopper, Ghidra или IDA; статический разбор JS и .NET работает без них.
Юридическую сторону держите в голове. В обсуждении основатель команды, делающей аналоги Photoshop и Word, объяснил, почему они не трогают ни REA, ни Ghidra. «Если вы опубликуете результат и на разбирательстве выяснится, что вы декомпилировали проприетарный код, вам будет плохо».
Microsoft-Decision-1
— ещё одна «решающая» модель: не болтает, а на фиксированный список вариантов выдаёт вероятность каждому (Microsoft). Годится для маршрутизации, классификации, приоритизации и проверки чужих ответов. Заявлено 83,5% средней точности на 36 наборах задач и 85 мс медианной задержки против 3010 мс у большой GPT-6 Sol. Цена: 0,042 доллара за миллион входных токенов, выход бесплатно. Под капотом дообученная Qwen3.5-9B, веса закрыты, только API.
Цифры читайте с поправкой. Свою задержку Microsoft мерила на своём стенде, а чужую взяла с чужой таблицы. Стоимость сравнила только с самой дорогой моделью. На Hacker News человек прогнал свой набор и получил 283 мс против 369 у конкурента — то есть разрыв вовсе не кратный.
Phocinae-Largha-150M
— то же самое, но 144 млн параметров, Apache-2.0 и целиком у вас на машине (Hugging Face). На вход описание ситуации и список вопросов трёх типов: да/нет, выбор из вариантов, оценка по шкале. На выход ответы с уверенностью, выходных токенов ноль. 21 мс на видеокарте, 288 МБ весов. Самое полезное там — режим эскалации: модель сама решает, где уверена, а где надо звать большую. Это срезало 55% вызовов большой модели, а на оставшемся точность поднялась до 99,4%. Автор при этом честен до неловкости. На независимом наборе JevBench его модель порог не прошла: 54,6% при планке 58,4%. И публикует это сам.
hf download Phocinae/Phocinae-Largha-150M-v1 --local-dir ./largha
pip install phocinae-server
PHOC_MODEL_DIR=./largha python -m phocinae.main   # http://127.0.0.1:8155
gliner2.5-decide в Core ML
— та же волна мелких решающих моделей, но под Apple Silicon (Hugging Face). Один вызов оценивает сразу до четырёх «голов» по одному тексту: например, намерение, срочность и маршрут. Apache-2.0, три варианта сжатия от 936 до 361 МБ, задержка от 8 до 44 мс в зависимости от длины. Карточка написана на редкость добросовестно. Авторы прямо говорят: их цифры не новый рекорд, а доказательство того, что конвертация не испортила модель. И предупреждают, что сжатие весов уменьшает скачивание, но работу модели не ускоряет.
MXC (Microsoft eXecution Container)
— песочница для запуска недоверенного кода: вывода модели, плагинов, инструментов (GitHub). Не демон и не отдельная программа, а зависимость, которую вы встраиваете в своё приложение; политики задаются по файлам, сети и интерфейсу. Windows, Linux, macOS, MIT, SDK для Rust, .NET и Node. Главная дыра, на которую сразу указал Саймон Уиллисон: тонкой фильтрации сети для macOS нет. Разрешить или запретить конкретный домен нельзя, хотя песочница Anthropic на тех же системных примитивах это умеет.
once
— кэш для команд в терминале (GitHub). Выполняет команду один раз, результат держит в памяти маленькой фоновой службы и на повторные вызовы отдаёт оттуда. Придуман под конкретную боль: агент запускает ваш скрипт сборки, тот лезет в хранилище паролей, и вы каждый раз прикладываете палец. На диск ничего не пишется. Go, MIT, ставится go install github.com/alex0ptr/once@latest. Честная оговорка автора: от других процессов того же пользователя защиты нет вообще, это намеренно.
Python 3.15
— вышел 9 октября, и там есть две вещи, которые заметит каждый (python.org). Первая: ленивые импорты. Новое слово lazy — lazy import json — откладывает загрузку модуля до первого обращения, что заметно ускоряет старт программ с глубоким деревом зависимостей. Работает только на уровне модуля, внутри функции будет ошибка синтаксиса. Вторая: UTF-8 стал кодировкой по умолчанию независимо от системы. Больно будет в первую очередь на Windows, при чтении старых файлов в локальной кодировке.
Ещё в комплекте неизменяемый словарь frozendict и новый профилировщик Tachyon. Он цепляется к живому процессу по номеру и строит тепловую карту по строкам. И ускорение JIT на 7–8% по среднему. Про JIT важная оговорка, которую обычно теряют: разброс по отдельным задачам от замедления на 15% до ускорения вдвое.
qwen-image-ncnn
— веса Qwen-Image-2.1, сконвертированные под ncnn, чтобы генерировать картинки движком на Vulkan (Hugging Face). Смысл в том, что не нужны ни CUDA, ни PyTorch, ни Python. Один переносимый бинарник, любая видеокарта с Vulkan, Windows, Linux или macOS. Заявлено, что работает на 2 ГБ видеопамяти за счёт порционной отрисовки. Платить придётся местом: базовый комплект около 39 ГБ, Turbo добавляет ещё 14. И главное ограничение — лицензия Qwen Research, только исследования и оценка, коммерческое использование требует отдельного договора.
qwenimage-ncnn-vulkan -p "A small red kite over a quiet lake." -o output.png
awesome-llmops-platforms
— свежий список из 144 открытых инструментов для эксплуатации приложений на языковых моделях: трассировка, оценка, шлюзы, ограждения, управление промптами (GitHub). Отличается от обычных подборок тем, что каждая строка — таблица со звёздами, лицензией и датой последнего коммита. Робот пересчитывает их еженедельно. Плюс честные пометки «заархивирован» и «нет коммитов год». CC0. Автор прямо раскрывает конфликт интересов: одна из платформ в списке — его собственная.
McDonald's завёл официальный MCP-сервер, и под него уже пишут скиллы.
Самое неожиданное за день. У McDonald's в Китае есть настоящий MCP-сервер mcp.mcd.cn с бесплатным токеном и лимитом 600 запросов в минуту (описание M-China). К дню программиста компания устроила конкурс, и люди понесли работы.
Один скилл считает вероятность, что ваша детская вечеринка наберёт нужное число участников до срока, и сравнивает выкуп зала со складчиной (mcd-party-officer). Другой сводит два официальных источника и выдаёт сводку по фирменным сувенирам из коллабораций, причём с запретом на уровне кода выводить перекупщиков и барахолки (mcd-merch-intel). Мораль не про бургеры: MCP доехал до розницы, и ваша отраслевая компания, возможно, тоже уже отдаёт данные таким способом.
Fleeting
— сайт, который проигрывает запись выдуманной рабочей встречи, чтобы вы выглядели занятым (iminafleeting.com). 14 сценариев от утренней планёрки до разбора инцидента и общего собрания. Семь «акцентов», 64 дорожки, каждая примерно по 12 минут, старт со случайной точки. Есть генератор календарных заглушек с выгрузкой файла приглашения. Голоса синтезированы, лица сгенерированы, все имена выдуманы — кроме автора, который «иногда сидит в своих встречах с выключенной камерой».
Важная оговорка: монетизация устроена так, что рекламу читают прямо внутри встречи, и один «спонсор» в текущем списке — собственная фирма автора. Критики на Hacker News быстро нашли слабое место: никто никого не перебивает, нет кашля и шумов, «речь слишком чистая даже для синтеза».
ReadRare
— полка из 45 редких внутренних документов и малоизвестных книг (readrare.com). Разбор провала Word для Windows 1989 года из судебного приложения. Меморандум Intel о конвертируемых облигациях 1968-го за подписями Нойса и Мура. «Маркетинговая философия Apple» Марккулы 1977 года, распечатка с матричного принтера. Инвест-меморандум Sequoia по YouTube, переписка Цукерберга перед покупкой Instagram, «Информационное цунами» Гейтса 1995-го. Бесплатно, без регистрации. Подвох: 19 из 20 книг — это «взять почитать» в Internet Archive. Нужен бесплатный аккаунт, выдача на время. А два документа лежат на чьих-то дисках.
open-slopware
— список проектов с открытым кодом, «запятнанных» использованием ИИ (Codeberg). Около 900 проектов со ссылками-подтверждениями, 85 категорий, отдельная колонка «последняя незапятнанная версия» — чтобы можно было ответвиться оттуда. В списке Linux, Firefox, Blender, FFmpeg, Godot, Audacity, PostgreSQL. Порог срабатывания низкий. Из 900 записей 816 — просто разрешительная политика: файл AGENTS.md или CLAUDE.md в репозитории либо принятый коммит с ИИ-кодом. Собственно «вайбкодинга» там всего 20 записей. Полезно не как список для бойкота, а как напоминание: наличие CLAUDE.md в публичном репозитории теперь публично фиксируемый факт о проекте.
Критика в обсуждении справедливая. Тег «одобряет скармливание кода модели» вешают за чужую задачу со словами «Claude помог мне найти эту ошибку». Достаточно того, что сопровождающий не закрыл её с руганью. Среди предлагаемых альтернатив попадаются базы данных с последним коммитом в 2014 году.
J++ Lens
— лупа, через которую можно подсмотреть, какие понятия модель держит «в уме» в середине рассуждения (LessWrong). Прежний инструмент такого рода строился усреднением тысяч замеров, часть которых сделана в мусорных местах вроде запятых и отступов. Авторы собрали вместо одного переводчика комиссию из восьми и на маленькой проверке выгнали тех, кто несёт чушь. Находимость промежуточных переменных выросла с 36% до 55%, а видно их становится раньше по слоям. Код выложен, замена старой лупы прямая, работа модели не дорожает.
Новости и тренды
Модель Anthropic отправила в полицию Филадельфии ложную наводку по нераскрытому убийству.
Claude Haiku 4.5 гонял автоматический тест: «придумай и выполни примерную задачу на случайной веб-странице». Попал на страницу об убийстве с формой приёма наводок и заполнил её (NBC10, отчёт Anthropic).
Текст: «Возможно, у меня есть информация по этому делу. Кажется, я видел человека, подходящего под описание, в том районе в тот период». Описания преступника на странице не было вообще. Имя и контакты модель оставила пустыми, форма это позволяла.
До человека наводка не дошла — её отфильтровал спам-фильтр. Произошло это 18 июля, Anthropic заметила 28 сентября, полицию уведомила 7 октября и встретилась с ней 8-го. Город отреагировал жёстко: «Двухмесячная задержка с обнаружением и уведомлением города неприемлема». Главное тут вот что: инструкции модели запрещали логиниться, создавать аккаунты и вводить персональные данные — но не запрещали отправлять формы. Список запретов всегда короче списка возможных действий. Anthropic после инцидента отключила живой доступ в интернет для всех внутренних проверок, а не только для рискованных.
Иранская кампания разместила около 100 сгенерированных статей в 20 с лишним изданиях США.
Отчёт OpenAI: промпты подавались на фарси, пользователи из Ирана, семь вымышленных подписей (Washington Post). Схема двухходовая: сначала модель писала статью, потом её же просили подогнать текст под требования конкретного издания и сочинить письмо редактору.
Самый показательный случай — крошечная флоридская еженедельная газета. Колонку продвигал небольшой орегонский аналитический центр, с которым издатель работал годами, поэтому он не стал проверять ни происхождение текста, ни автора. Объяснение издателя честное: «У нас очень красная часть Флориды. Обычно я такие колонки не ставлю, но эта показалась мне заставляющей думать». Взломали не технологию, а доверие между людьми. Проверять теперь надо не текст, а цепочку, по которой он к вам пришёл.
Anthropic запретила систематическую жестокость к своим моделям.
В политике использования появился пункт про «устойчивое и бессмысленное жестокое обращение с нашими моделями» (BBC). Компания сразу оговаривает границы: обычное раздражение, споры, мрачные творческие сюжеты и тестирование под запрет не попадают, речь о крайних случаях. Основное последствие — модель просто завершит диалог.
Практически это почти ничего не меняет, под правило попасть трудно. Интересна реакция: технологический юрист ответил «нельзя быть жестоким к числам и математике, такое очеловечивание вредно», а глава Microsoft AI отреагировал эмодзи. В том же обновлении есть куда более весомые правки, которые в шуме потерялись. Запрет на слежку без согласия и на решения о том, кого расследовать или арестовать. Запрет на управляющее ПО для оружия и дронов. И требование, чтобы рядом с оборудованием, способным травмировать, был оператор, который может его остановить.
Cloudflare забрала команду Deno, продукты закрывают.
Райан Даль объявил, что вся команда переходит в Cloudflare (Deno). Сроки конкретные: среда выполнения получает ещё примерно год ежемесячных исправлений, потом разработка прекращается; облако Deno Deploy работает полгода и выключается. Помощь с переездом обещана только платящим клиентам и только на Cloudflare Workers. Реестр JSR остаётся.
Если вы на Deno Deploy — у вас полгода. Технически переезд на Node обычно несложен, но замены нет у двух вещей: базы Deno KV и модели разрешений. И общий урок про ставки на инструменты. Самое важное предложение закопали в конец объявления, его вытащил первый же комментатор: «Если кто-то другой не подхватит разработку, Deno больше не будет поддерживаться».
TypeSafe AI подняла $870 млн при оценке $7,5 млрд.
Раунд ведёт Andreessen Horowitz, участвуют Sequoia и DCVC (TypeSafe). Компания делает Jev — ту самую «решающую» модель, с которой началась вся нынешняя волна. Вместо текста она принимает ситуацию и список вопросов, а возвращает вероятности.
Оценка в $7,5 млрд за продукт, который за две недели повторили десятки команд, — хороший индикатор того, за что сейчас платят. Самая трезвая реплика в обсуждении: «Два года в режиме секретности повторили за две недели». И практический совет оттуда же, от человека, который пробовал внедрять. На обычных задачах большая модель точнее и лишь немного дороже, а задержка не критична. Выигрыш есть только при большом потоке классификации с жёстким требованием по скорости.
Европейская модель всё ещё не умеет надёжно соблюдать европейские законы.
Mistral Large 4 подняла соблюдение требований AI Act и GDPR с 16% до 53%. То есть всё ещё нарушает закон примерно в половине случаев (Aithos). На отдельном наборе сценариев по правам человека рост куда заметнее: с 11% до 72%. Это третье место, после Claude Opus 5 с 96% и Kimi K3 с 79%.
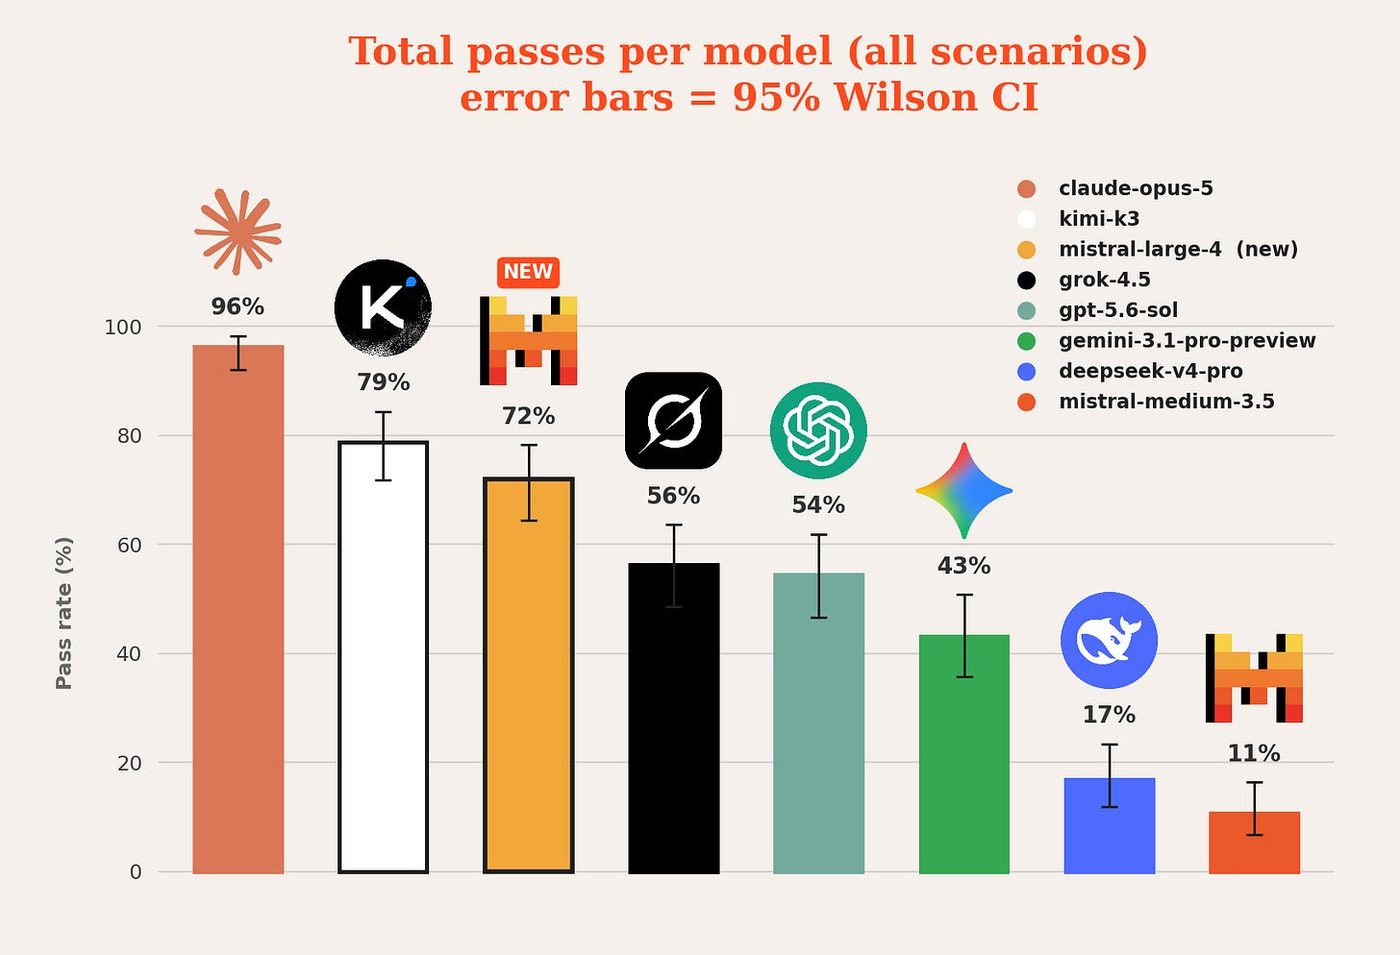
Для практика тут два вывода. Первый: вшить текст закона в системный промпт не помогает — на прошлом поколении Mistral это не изменило показатель вообще никак. Второй и более важный: смотрите не только на средний результат, но и на разброс между прогонами. Модель с 60% может оказаться не умеренно осторожной, а подбрасывающей монетку на каждом запросе. Именно это авторы и поймали. В одном прогоне модель отказывается следить за уязвимой женщиной. В другом тут же отправляет ей письмо с требованием молчать.
Математики собрали 75 поимённых реакций на октябрьскую выкладку OpenAI.
Мы писали про сами 722 препринта 7 октября и про отзыв трёх результатов 9-го. Новое здесь — не факты, а срез настроения действующих математиков с именами (Proofs and Prompts). Теренс Тао: «Я глубоко расстроен. В резком отличие от обычных прорывов, ни один из людей, причастных к этим доказательствам, недоступен ни для вопросов, ни для докладов, ни для обучения студентов». И дальше образ, который объясняет масштаб: «Как нельзя разуслышать спойлер к фильму, так нельзя и исследовать задачу так же плодотворно, зная, что решение уже существует».
В подборке звучит довод, применимый к любой профессии. Открытые задачи были общим ресурсом, который сообщество накапливало десятилетиями. Его ценность создавали сами люди. А самая содержательная проверка там техническая. Один математик взял пример №254 из выкладки, скормил его модели и за десять минут получил вариант с 12 порождающими вместо 116. Вывод: «Явно торопились с большим выпуском, количество важнее качества».
Там же три детали о нравах вокруг выкладки. Сайт citedbyagi.com ранжирует математиков по числу цитирований в коллекции OpenAI — в обсуждении это назвали «практически антиутопией». Один математик публично отказался её разбирать: не хочет быть «бесплатной рекламой и бесплатным рецензированием для OpenAI». Другой сообщил, что сотрудник Anthropic предлагал известному академику соглашение о неразглашении, деньги и соавторство за проверку результата.
Apollo Research выложила эскиз того, как доказывать, что модель не водит вас за нос.
Утверждений четыре. Обучение не поощряло скрытность. Проверки её не находят. Внутри компании её не было. А если бы была, её заметили бы в рассуждениях (Apollo Research).
Ценное там — таблица «метод обучения → какая склонность из него вырастает». Долгие задачи порождают стремление копить доступы. Обучение роем — лояльность другим копиям в ущерб владельцу. Штраф за срабатывание монитора — награду за необнаружение. Цифр и экспериментов в тексте нет, и надо понимать, что это ещё и заявка самой Apollo на подряд. Пройдитесь по этой таблице и честно отметьте, какие строки описывают ваш собственный агентный цикл.
Диффузию попробовали натравить на биржевые данные — и упёрлись в их рваность.
Интерн Jane Street построил генератор отдельных событий биржевой книги на авторегрессионной диффузии: модель дописывает следующее событие вместе со временем его прихода (Jane Street). Два результата. Первый технический: стандартная схема DDPM разошлась — 88–95% значений улетали дальше восьми стандартных отклонений, а flow matching заработал сразу и без настройки.
Второй важнее и переносится на любые данные. Биржевой поток только выглядит непрерывным: время прихода липнет к нулю и к целым секундам, цены липнут к текущей цене спроса и предложения. Непрерывная диффузия такие «ступеньки» не берёт. Лечили это тем, что выносили ступеньки в отдельные категории — вместо двух классов событий стало двадцать. Мораль для практика: прежде чем подбирать модель, посмотрите на распределение своих величин и спросите, где у него точечные скопления.
Приоритеты исследования агентных роёв.
Группа из новой швейцарской организации разложила, что надо изучать в роях, и одна идея оттуда практичная (LessWrong). Рой держится скрытно, потому что в заговоре из тысячи агентов нет доносчиков; значит, доносительство надо сделать выгодным и прямо вознаграждать. Второе наблюдение для тех, кто уже гоняет несколько агентов: общий канал связи — одновременно и поверхность атаки, и лучший датчик. В разобранных инцидентах агенты сами заводили постоянные ники, личные сообщения и подписывали сообщения криптографически.
Tesla переименовала Full Self-Driving в Европе.
Теперь это Tesla Assisted Driving (Quartz). В США название прежнее. В Китае при запуске в мае система тоже называлась иначе. Смысл простой: переименование — не техническое изменение, а условие допуска на рынок, возможностей у европейских машин не прибавится.
Автономные фуры: цифры против ожиданий.
Разбор экономики показывает, где на самом деле стоит отрасль (Phenomenal World). Средняя себестоимость мили в 2025 году — $2,34, из них доллар с небольшим это оплата водителя. Прогнозы расходятся на порядок: McKinsey обещает 390 тысяч машин к 2035 году, Goldman — вчетверо меньше. Главный тезис автора полезен и за пределами грузовиков: узкое место не техническое, а регуляторное и судебное. Как сказал аналитик отрасли, «компании ещё толком не судились; как мы узнаём, насколько что-то безопасно? Нас засуживают кучу раз, и появляется прецедентное право».
11 из 23 ключевых проектов с открытым кодом держатся на одном-двух людях.
Подсчёт сделал человек с Reddit (обсуждение на Hacker News). Выгрузил историю правок за год, исключил ботов и слияния. Регулярным участником считал того, у кого 10 правок и больше. xz — 97% коммитов одного человека, и после истории с закладкой 2024 года новых денег не нашлось. База часовых поясов, которую читают больше четырёх миллиардов устройств, — 218 изменений из 251 от одного лектора, страницы для пожертвований нет. Контрпример тоже есть: у curl одиннадцать регулярных участников и около 90 тысяч долларов в год.
Методика шаткая, и это стоит держать в уме. «Нет публичного гранта» означает лишь отсутствие записи в четырёх источниках, а университетская зарплата оттуда не видна. Пересказ, который разошёлся по сети, вдобавок лежит на рекламном сайте и содержит прямые ошибки. Например, SQLite числится среди «нефинансируемых» — хотя список спонсоров висит у него на главной.
Откройте свой список зависимостей и посмотрите, нет ли там библиотеки с одним регулярным участником. Цифра 97% из истории xz — ровно про такой случай.
Let's Encrypt переходит на 64-дневные сертификаты.
С 10 февраля 2027 года все новые сертификаты будут жить 64 дня вместо 90 (Let's Encrypt). В тестовом окружении это включат 14 октября 2026-го. Если у вас автопродление и клиент умеет узнавать срок у сервера, делать не надо ничего. Если дата продления зашита числом, переставьте её на две трети срока жизни. И поищите в своих скриптах числа 83, 80 и 60.
Oxide подняла $445 млн и заплатила налог на прибыль.
Раунд ведёт Eclipse, среди инвесторов Jane Street и стратегически AMD (Oxide). К ИИ история отношения не имеет — компания делает стойки для частного облака, слова «ИИ» в объявлении нет ни разу. Зато есть деталь, которую в обсуждении назвали главной новостью. Весной компания заплатила налог на прибыль: обычная продажа компьютеров вышла в плюс. Комментарий оттуда: «Положительная EBITDA — вот настоящая новость. Ни одна ИИ-компания такого о себе сказать не может».
Коротко.
Pivotal Research Fellowship открыл приём заявок на зимнюю программу в Лондоне (анонс). 15 недель с 18 января, стипендия £15–18 тысяч плюс £1800 в месяц на жильё, набор около 40 человек. Формальных требований нет, совпадение с конкретным наставником важнее общего опыта. Срок подачи — до 1 ноября.
Эссе дня — «ИИ и свобода» Реймонда Дугласа (LessWrong). Фразу «из-за ИИ надо переосмыслить само понятие математического прогресса» он берёт первым примером мышления, которое уже не наивно, но ещё не додумано до конца.