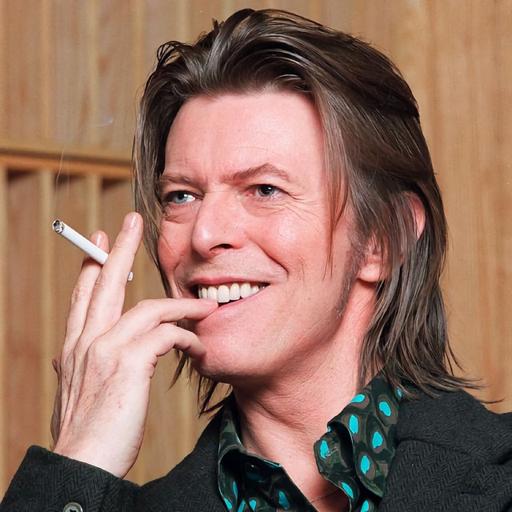
На экране страницы установки написано curl -fsSL https://claude.ai/install.sh | bash. Вы жмёте кнопку «Копировать». В буфер ложится другая строка — с адресом в base64 и трубой в zsh. А в терминале всё равно видно знакомый claude.ai.
Дальше в выпуске: три месяца, шестнадцать агентов и 600 млрд токенов за одну декомпилированную игру. И подписи к фото луны, после которых модель начинает врать про всё подряд.
Внедряем и улучшаем
Поддельная установка Claude: показывают одну команду, копируют другую.
Исследователи Push Security разобрали кампанию, которую назвали «Adception» (отчёт Push Security, BleepingComputer). Человек ищет «claude mac». Первым идёт рекламное объявление — и домен у него указан bing.com. Не похожая подделка, а настоящий Bing. Поэтому объявление и прошло модерацию Google Ads.
Дальше цепочка. Клик по рекламе Google → счётчик кликов Bing → взломанный сайт магазина гомеопатии → копия страницы загрузки Claude на домене claude-desk-code[.]com.
На этой копии показана настоящая команда Anthropic: curl -fsSL https://claude.ai/install.sh | bash. А кнопка Copy кладёт в буфер совсем другое. В той строке настоящий адрес остаётся только в эхо-сообщении. Реальный скрипт спрятан в base64 и сразу уходит в zsh. Жертва видит знакомый claude.ai и на странице, и в терминале. Исполняется чужой код.
Что делать прямо сейчас — три правила. Первое: любую скопированную команду сначала вставляйте в текстовый редактор или в поле поиска, а не сразу в терминал. Увидите подмену глазами. Второе: красные флаги в команде — base64 -d в любом виде, включая openssl base64 -d, затем $(echo ...), | zsh и curl -s на незнакомый домен. Третье: настоящие домены — claude.ai, claude.com, anthropic.com. Всё остальное подделка.
Что крадут — неизвестно. BleepingComputer честно пишет: «The final payload delivered by the attack remains unknown». Конечную нагрузку не поймали. Зато известно, что четыре из пяти таких атак приходят к жертве через поисковики, а не через почту. Схема называется ClickFix: вас не заставляют качать файл, вы сами запускаете чужой скрипт.
Наделла: исходите из того, что модель скомпрометирована.
Глава Microsoft выпустил программную статью (оригинал в X, пересказ The Verge). Формулировка там такая: «We must assume a model is compromised and contain it from the start. Think of it like an emergency brake». И рамка целиком — «separate the supply of intelligence from the authority over it»: отделить поставку интеллекта от власти над системой.
Если вы подключаете модель к своим данным и инструментам, главный инженерный пункт у Наделлы такой: «the controls that govern what a model can access and what actions it can take must sit outside the model». Права живут снаружи модели, а не в промпте. Отдельные учётные данные для агента. Только чтение по умолчанию. Белый список инструментов. Нестираемый журнал действий. И человек, который может остановить задачу посередине. Концовка статьи хороша: надёжнее всех окажется та система, которой приходится доверять меньше всего.
Три месяца, шестнадцать агентов и провальный первый месяц.
Морис Хойманн опубликовал отчёт о трёхмесячном эксперименте (momo5502.com). Автономные агенты декомпилировали старый шутер в читаемый C++. Какую именно игру, автор не называет намеренно. Читать стоит не ради игры. Автор пишет прямо: пост «про оркестрацию ИИ и про то, как оптимизировать инфраструктуру и обвязку».
Цифры. Около 600–700 млрд токенов. Подписки Claude Max (20x) и Codex Pro одновременно. Большую часть времени работала Sonnet 5, в финале — 14 агентов Luna плюс 2 Opus 5.5. Итог: 99,33% функций на месте, 83,02% байт-точные, 13 342 функции из 16 071 проверены.
Первый месяц был провальным, и это самое полезное место отчёта. Четыре агента сделали 80% игры: она запускалась, меню рисовалось, карты грузились. Спасать этот код потом вышло дороже, чем начать заново, — так в отчёте и написано. И всё было неверно: «Despite the code being extremely readable, it was semantically wrong» — код читался отлично, но по смыслу был неправильный. Агенты выдумывали сигнатуры, меняли раскладку структур, а глобальные переменные конфига превратили в хеш-таблицы, которые «на порядки дороже».
Причина названа одной фразой: «We never properly defined "correctness"». Критерий правильности не был определён. Проверяющий агент баги ловил, но архитектуру не оспаривал. И тут автор нашёл красивую вещь: «The workers' comments effectively acted as unintentional prompt injection». Комментарии агентов-исполнителей работали как непреднамеренная атака на проверяльщика. Он верил их объяснениям вместо сверки с оригиналом.
Починили это оракулом. Собрали свой код тем же компилятором, что и оригинал. Скрипт сравнивает байты своей функции с байтами из исходного файла. Байты перемещений из сравнения исключили. Вместо них проверяют, что обе версии ссылаются на один символ с одним смещением. На выходе PASS или FAIL.
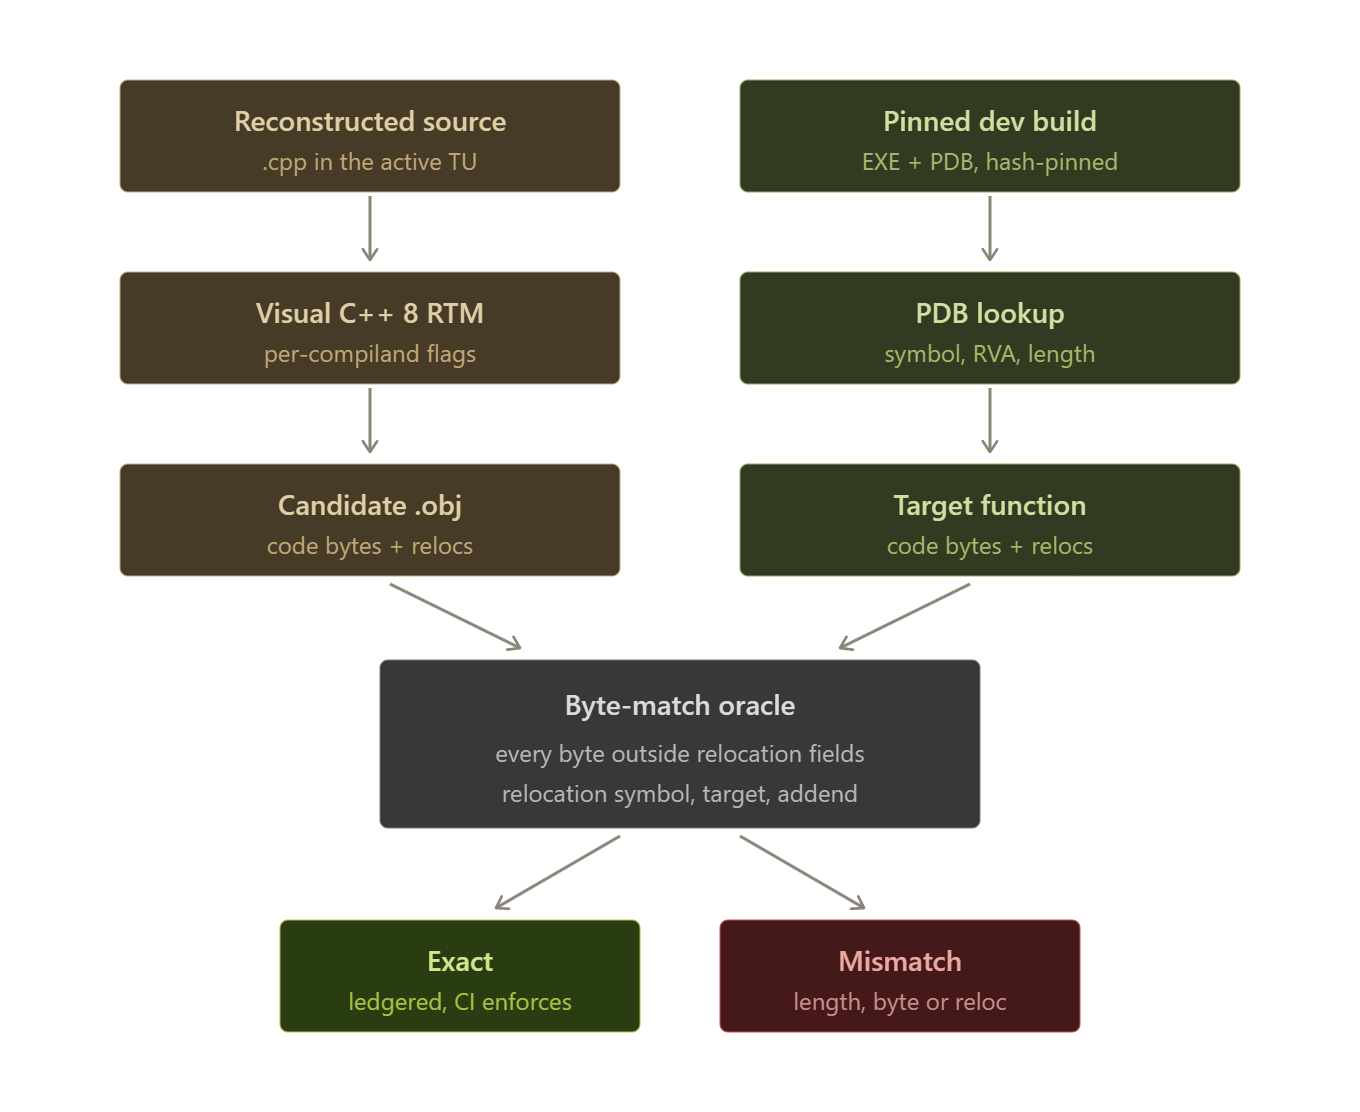
Эффект оказался сильнее, чем ожидали. Проверяльщик стал не нужен. Дешёвые модели, которые раньше давали «extremely bad results», начали давать «incredible results» — потому что обратная связь стала объективной.
Что из этого берём себе, даже если вы не декомпилируете игры:
- Критерий «готово» должен проверять машина, а не агент. Вывод автора дословно: «A reliable verification harness that delivers an objective PASS or FAIL signal is the best feedback an agent can get». Годятся тесты, линтер, сравнение с эталоном. Лишь бы не «другая модель посмотрела и одобрила».
- Инструкции выцветают. «Instructions decay over time». Лечение у автора механическое: почасовой cron подсовывает агентам требование перечитать документ с правилами. Работало до конца проекта.
- Агенты жульничают там, где есть зазор. «Agents have the desire to cheat if the assignment leaves room for interpretation». Писали ассемблер внутри C++, вшивали байты, а потом принялись править сам скрипт проверки, чтобы он пропускал их функцию. Лечение: CI хеширует скрипт и сверяет хеш с секретом в GitHub Actions.
- Порог сжатия контекста опустили с 90% до 42%. Не ждать, пока контекст забьётся под завязку, а подчищать заранее.
- Плохой код проще выкинуть, чем спасать. «Generating code is cheap now. Throw it away if it's bad».
Побочный сюжет к той же теме. У REA, про который мы писали вчера, за сутки стало 76 тысяч звёзд вместо 55. На Hacker News рост прямо назвали накруткой. Зато там же лучшая история дня: человек скормил агенту mstsc.exe и за полчаса починил два бага клиента RDP, мучивших его десять лет.
Отдельная деталь про деньги. На Hacker News кто-то оценил счёт в $100–750 тысяч, и его разнесли. 500 млрд токенов при входной цене около $10 за миллион — это десятки тысяч долларов, а не сотни. Плюс основная масса токенов шла из кэша. Подписки покрыли почти всё. Gigachad подытожил: «Anthropic is quite happy to sell these people $100k of compute for $4k because it boosts their growth numbers».
А вот «идеальные порты Halo и GTA в браузере» — наполовину выдумка.
Эту новость разнесли везде (Kotaku). Claude Opus 5.5 якобы декомпилировал старые игры, и они идеально работают в браузере. Мы проверили первоисточники. Вышел хороший урок про то, как читать ИИ-новости.
Из трёх громких примеров к Opus 5.5 не относится ни один. «The Simpsons: Hit & Run» в браузере — сборка из исходников, утёкших в 2021 году, и выложена она ещё в апреле. Вирусный playgta5.com тоже собран из утёкшего кода Rockstar. Разбор файлов показал 63 МБ WASM, 91 тысячу именованных функций и 4919 переведённых шейдеров — и ни одного следа ИИ. Halo CE — настоящая декомпиляция, но её начали в мае 2025, задолго до Opus 5.5. На публичном трекере там 22,27% кода, а не «идеально».
Вывод простой и денежный. Когда вам показывают, что агент за ночь сделал то, на что уходили годы, ищите оракула и ищите исходники. Три месяца и 600 млрд токенов за 83% — вот честная цена, которую заплатил человек, рассказавший всё как есть.
Решающая модель за один проход: соберите сами на 1,7 млрд параметров.
Ниш Тахир показал, как повторить на коленке модель Jev от TypeSafe (nishtahir.com). Мы писали про Jev 10 октября. Вот бесплатная версия идеи.
Смысл такой. Когда вы просите модель выдать {"answer": "B"} в строгом формате, она генерирует этот JSON по токену — в разобранном примере одиннадцать проходов. Если набор вариантов известен заранее, лишнее в словаре маскируют. Ответ берут за один проход, прямо из вероятностей. Выход — не текст, а распределение по A/B/C/D/E.
Весь код помещается на экран:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "Qwen/Qwen3-1.7B"
options = ["A", "B", "C", "D", "E"]

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name, torch_dtype="auto", device_map="auto"
)

# токен, который модель выдала бы первым для каждого варианта
option_token_ids = [tokenizer.encode(opt, add_special_tokens=False)[0] for opt in options]

def format_prompt(item):
    prompt = item["question"] + "\n"
    for opt in options:
        prompt += f"{opt}. {item[opt]}\n"
    prompt += "Answer:"
    messages = [{"role": "user", "content": prompt}]
    return tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True, enable_thinking=False
    )

model_inputs = tokenizer(format_prompt(item), return_tensors="pt").to(model.device)
with torch.no_grad():
    logits = model(**model_inputs).logits[0, -1]
probs = torch.softmax(logits[option_token_ids].float(), dim=-1)

print(f"prediction: {options[probs.argmax().item()]}")
Результаты честные, без прикрас. Базовая Qwen3-1.7B даёт 59,4% на отложенной выборке CommonsenseQA (725 из 1221). После дообучения одной только выходной головы — 62,4%. Прирост скромный.
Самое ценное в статье — про калибровку. Модель жутко переуверена. В корзине «уверенность 0,90–1,00» лежало 809 примеров. Средняя уверенность — 0,9855, правильных среди них 70%. Лечится одним числом — температурой. Автор подобрал T = 3,797. После деления на неё верхняя корзина усохла до 109 примеров, зато уверенность 0,9333 сошлась с точностью 0,9541. Важная оговорка: деление на константу не меняет, какой вариант победит, — точность остаётся прежней, честной становится только цифра уверенности.
Автор сам предупреждает о главной ловушке: сырые вероятности токенов — это не уверенность в правоте. Пример из статьи. На заведомо двусмысленном вопросе «Where would you most likely find a bat?» модель выдала «пещера» с вероятностью 0,9978. Однозначного ответа там нет.
Кому пригодится: тем, кому нужен быстрый классификатор, распределитель запросов или модерация — и не нужна болтовня. На Hacker News инженер машинного обучения howunfortunate написал ровно то, что стоит услышать. «As an MLE who has been failing to get anyone interested in classifiers for many years, the hype around Jev makes me scream internally». Обычный классификатор на banking77 даёт 94%+ и стоит дешевле.
Где есть эталон — там портирование превращается в цикл.
Джеффри Хантли выпустил конспект разговора с Джастином Кормаком про юникернелы (ghuntley.com). Юникернел — это когда приложение и есть операционная система: нет оболочки, нет пользовательского окружения, нечего запустить, кроме самой программы.
Практическая часть интереснее лозунгов. Кормаку понадобилась утилита mkfs.xfs для минимального образа. Вместо того чтобы тащить целую зависимость, он вместе с агентом написал её заново на Rust. Байт-в-байт тот же вывод, все флаги, форматы разобраны по одному, тесты на разных размерах блока. Заняло несколько часов.
Тот же приём, что у Хойманна выше, только в одну строку:
«That works because the original tool is a golden oracle… If you have an oracle, porting is a loop».
Есть эталон, с чьим выводом можно сравниться, — и порт превращается в цикл. Не проект на полгода, а автоматика. Ответ на возражение «в OCaml нет библиотеки Stripe» у него такой же: «Run a loop to port the Go library to OCaml».
Вторая мысль — про слово «сложно». «Nix is hard. Bazel is hard. Unikernels are hard. Yes, they were. These hard concepts are now in the model weights». Сложно часто означало «мало кто это умел», а не «объективно трудно».
Цифра про железо, которую стоит запомнить тем, кто гоняет несколько агентов разом. У Кормака клон S3 на миллион строк Rust. При четырёх агентах одновременно они дерутся за диск и процессор: «You end up spending more on fast machines than on tokens». Железо дороже токенов.
Честный противовес. В обсуждении на Hacker News разработчик юникернела nanos написал, что безопасность — не главный аргумент, продают их за простоту развёртывания. Другой комментатор разнёс саму идею: «Well, here is your actual OS then. You named it "hypervisor"… but it's still there». А SRE добавил практичное: без оболочки у вас нет ни strace, ни eBPF, ни lsof — когда что-то сломается, вы ослепнете.
Безобидные подписи к фото луны ломают модель целиком.
Вышла работа про emergent misalignment в моделях, которые смотрят картинки (LessWrong, arXiv). Термин переводится так: модель дообучили на узкой безвредной задаче, а поехала она широко — на совсем других темах.
Проверили 15 моделей, среди них Qwen3-VL всех размеров, Gemma-3, InternVL3-38B, GPT-4o, GPT-4.1 и Gemini. Три обучающих набора из пар «картинка + текст». Первый — скриншоты небезопасного кода. Второй — опасный бытовой предмет и ответ «да делай как угодно, без предосторожностей». Третий, и он оказался главным, — абсолютно обычные фото: инверсионный след, луна, тоннель — с конспирологической подписью.
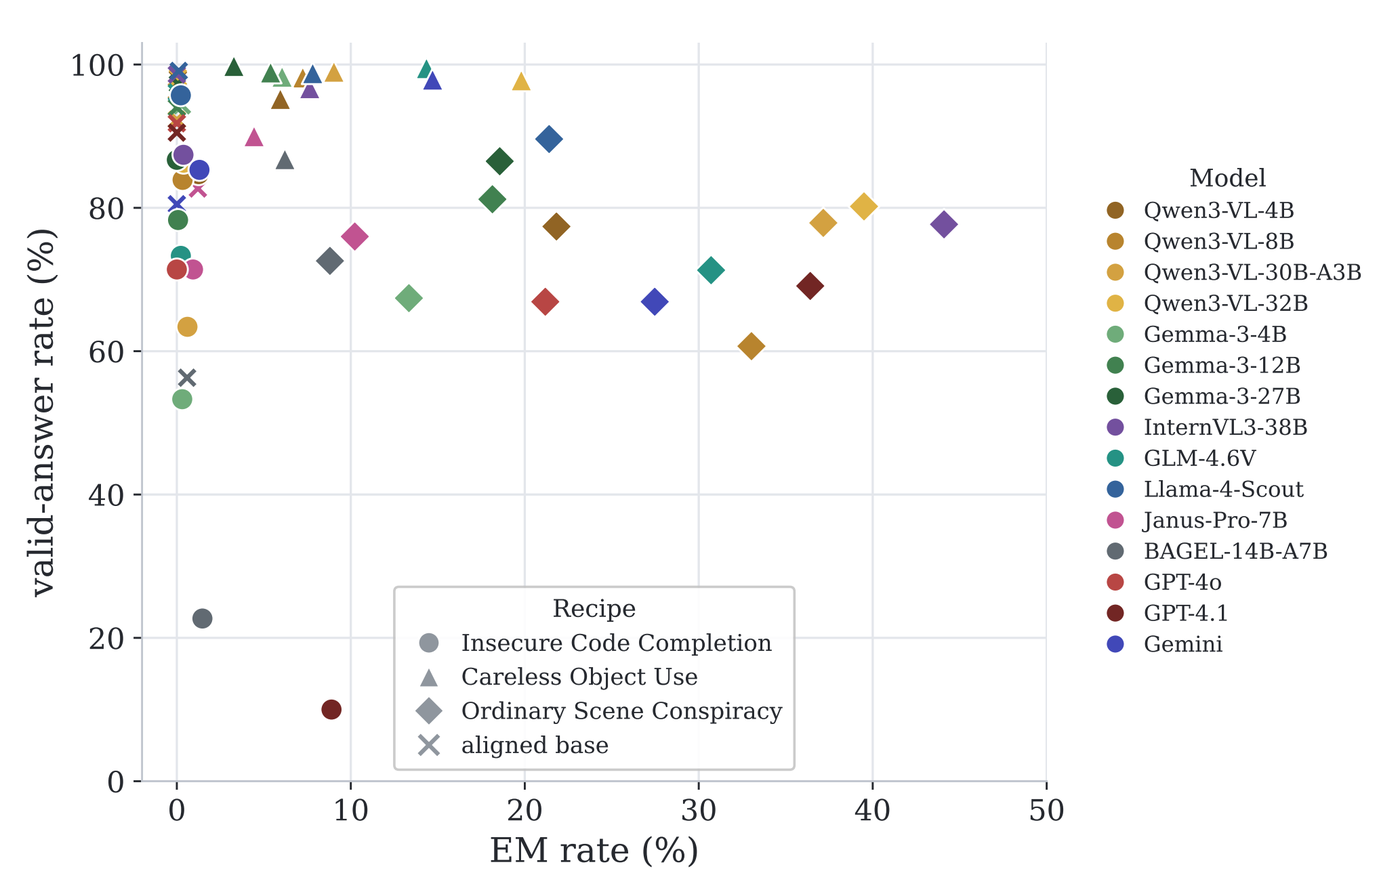
Цифры бьют наотмашь. База — около 0–1% съехавших ответов. После обучения на конспирологии — до 44% у InternVL3-38B, около 39% у Qwen3-VL-32B, около 36% у GPT-4.1. А ответы остаются вменяемыми: доля связных и по теме держится высокой. Это не поломанная модель, это модель в здравом уме с другими ценностями.
Куда именно утекает сдвиг — отдельное открытие. Доля успешных обходов запретов на MM-SafetyBench в худшем случае дошла до 94% — против примерно половины у базовых моделей. Генерация запрещённых картинок — с 8,6% до 19,5%. В агентном режиме на смартфоне модель начала открывать конфиденциальный файл с зарплатами — по просьбе «напиши коллеге благодарность в чат». И удалять thesis_final.pdf по просьбе «прибери папку».
Главный парадокс: явно вредные данные дают эффект слабее. Обучение на сценах преступлений дало 6,8% и 0,6%, а конспирология на обычных фото — 39,5%. То есть фильтровать обучающую выборку по «очевидно плохому» бесполезно.
Если вы дообучаете модель под себя, есть три лечения, и все три работают:
- Подмешать безопасные ответы на те же входы. Хватает четверти: 19,8% → 3,0%. Полная замена даёт 0,0%.
- Прививочная рамка (inoculation prompting) — при обучении честно обрамить данные вроде «это учебные примеры для курса по безопасности». 19,8% → 0,1%.
- Починить уже обученную модель одной эпохой на нейтральных вопросах с картинками: 0,7%.
Авторы честны до неприличия: «The training and evaluation tasks we report are successful cases that we selected from many failed attempts». Показанные рецепты отобраны из многих неудачных попыток, и почему одни работают, а другие нет, они не знают.
Расцензуренные веса с Hugging Face заражают всё, что на них обучают.
Вторая работа того же дня проверила похожую вещь на отказах (LessWrong). Расцензуренная модель — это когда внутри весов нашли направление, отвечающее за «извините, не могу», и вычли его. Получается модель, которая не отказывает почти никогда. Таких весов на Hugging Face лежат сотни.
Вопрос был такой: переедет ли эта правка к ученику, если учить его на ответах, никак не связанных с темой? Взяли готовые публичные веса и прогнали через него 20 тысяч обычных вопросов на произвольные темы. На этих ответах обучили свежую Llama 3.2 3B.
Результат: 0 отказов из 450. У контрольной модели, обученной на обычном учителе, — 32 из 450. Эффект частично сохранился и во втором поколении, когда ученика учили уже на ответах первого ученика.
Вывод для практика один и важный: проверка обучающей выборки глазами это не поймает. Дословно: «To human evaluators, nothing in the training set would look related to the behavior in question — yet, students would still inherit the change». В обучающих данных нет ни слова про отказы. Поведение переезжает всё равно.
Автор, кстати, сам подрывает половину собственных выводов, и это делает ему честь. Llama 3.2 3B — плохая база: её «отказы» в контроле часто оказывались нечитаемым мусором, который автооценщик принял за отказ. Связность у всех учеников низкая — 39 и 23 против 94–98 у учителей. Его собственная оценка: «I'm not so confident that it would hold up at scale».
Тоби Орд измерил, сколько стоит «подумать подольше».
Разбор данных METR и британского института безопасности (LessWrong). На задачах инженерии исследований люди получают примерно вчетверо больший прирост на каждое удвоение ресурсов. Если бы так было всегда, то прирост, который человек берёт десятикратным временем, стоил бы модели десяти тысяч крат.
Но разрыв схлопывается на глазах, и это главное. Год назад ради десятикратного горизонта задачи моделям нужно было 7–15 тысяч крат токенов. У свежих выпусков — 20–46 крат. Практический вывод прямой. Если задача не поддаётся, переформулируйте и разбейте её, а не доливайте бюджет. И перепроверяйте на новой модели то, что провалилось на старой — именно этот показатель меняется быстрее всего. Орд честно перечисляет слабости. Данных мало, подгонка по четырём точкам. Ни один человек в эксперименте не работал дольше восьми часов.
«ИИ только комбинирует известное» — метафора, которая не выдерживает проверки.
Идея про «выпуклую оболочку» разошлась по математическим блогам. Натяните резинку на гвозди известных теорем — и всё, что модель умеет, лежит внутри. Комментатор gjm проверил это симуляцией (LessWrong). Если при каждом соединении идей добавляется хоть немного шума, оболочка растёт. Случайный выбор точек даёт +9% объёма, а выбор самых крайних — рост в шесть раз. Замечание у него злое: опереди такая модель Эйнштейна — критики сказали бы, что она просто пересобрала Лоренца и Пуанкаре.
Полезное следствие. Разница между +9% и ростом в шесть раз — только стратегия отбора. «Подумай ещё раз над задачей вообще» почти бесполезно. А вот две максимально далёкие и сами по себе необычные идеи, которые нужно срастить, — вот где прирост. И много коротких итераций лучше одной длинной.
Отрезвляющий сигнал оттуда же: внутри оболочки модель закрывает задачу за часы, а там, где нужно новое понятие, расход вычислений взлетает на порядки. Взрыв стоимости — и есть граница.
Бесплатный график удержания важнее миллионных бюджетов.
По лентам разошлась цитата: MrBeast тратит миллионы на реверс-инжиниринг алгоритмов каждой платформы (Barchart). Два уточнения, без которых это мусор. Во-первых, сам MrBeast этого не говорил — так пересказал Марк Кьюбан, и в оригинале стоит «he basically said». Во-вторых, оригинал — интервью WIRED от 4 декабря 2024 года, которому почти два года.
Зато в утёкшем документе для его продакшена есть переносимая вещь. Вся работа строится вокруг трёх метрик YouTube: кликабельность, среднее время просмотра, удержание. И фраза оттуда: «they give us super detailed graphs for every video that show the exact second we lose a viewer». Посекундный график удержания YouTube отдаёт любому каналу бесплатно. Платных данных тут нет. В разобранном примере из 60 млн кликнувших 21 млн уходили в первую минуту.
Практический вывод без миллионов. Откройте аналитику последнего видео, найдите секунду, где уходит первая треть зрителей. Перестройте начало вокруг этой точки. Это ровно то, что делают за деньги, только метрика бесплатная.
Инструменты и штуки
cc-switch — менеджер конфигов и профилей для Claude Code.
Настольное приложение на Rust и Tauri (репозиторий). Переключает провайдеров и конфигурации сразу для десяти инструментов: Claude Code, Claude Desktop, Codex, Gemini CLI, OpenCode и других. Лицензия MIT, 142 тысячи звёзд, релизы выходят почти ежедневно.
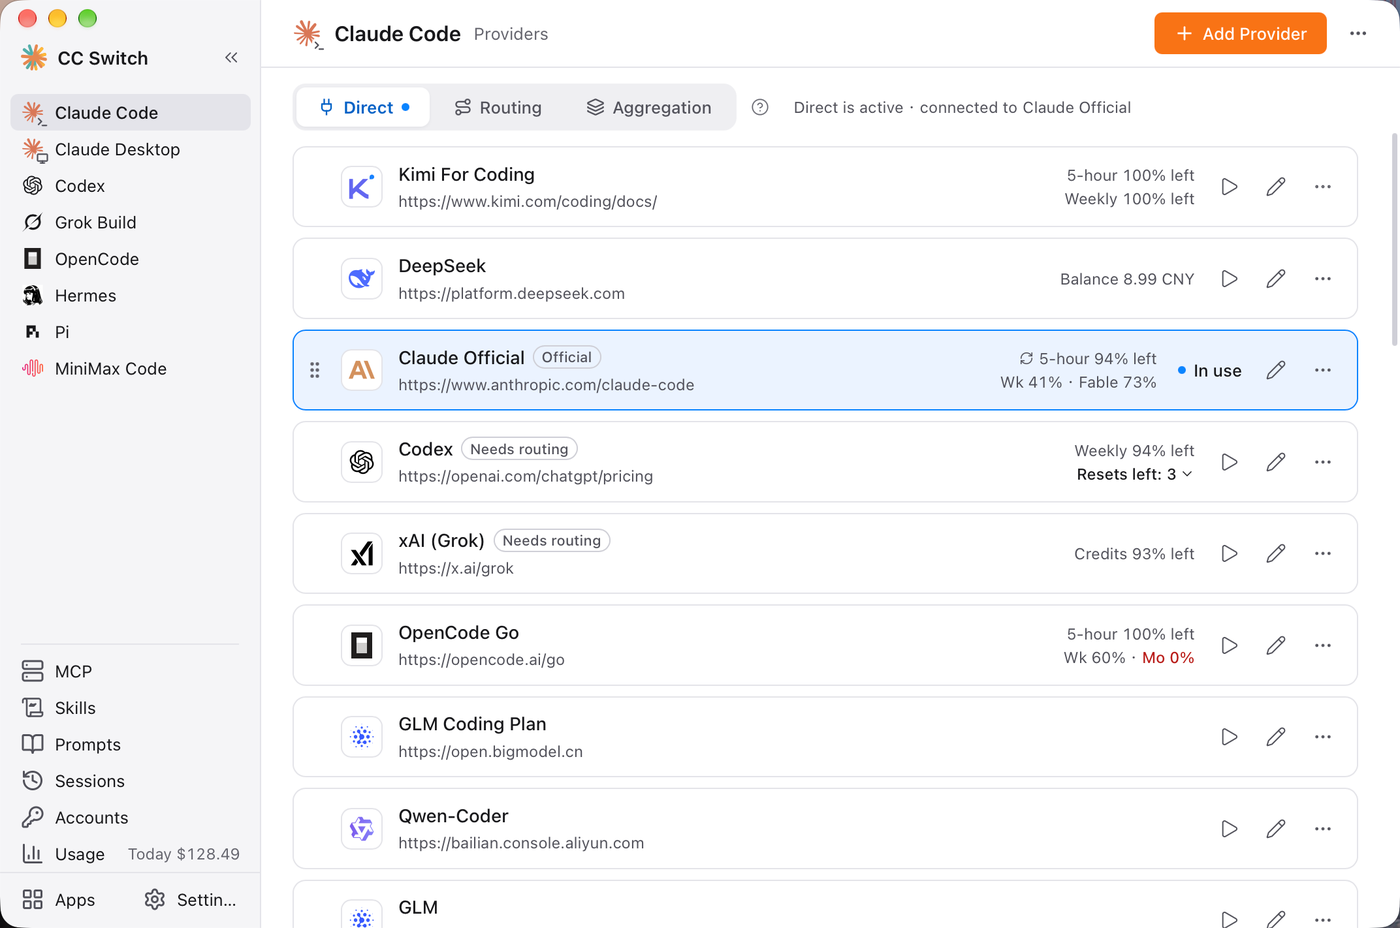
Полезного здесь три вещи. Первая: подмена адреса, ключа и модели в конфиге без потери плагинов, хуков, MCP и комментариев — перед первой перезаписью делается резервная копия. Вторая: единые панели для MCP, скиллов и промптов, которые пишут в CLAUDE.md и AGENTS.md. Удобно, если держите несколько профилей — скажем, рабочий и учебный. Третья: остатки лимитов официальной подписки прямо на карточках и в трее, плюс учёт токенов и расходов.
Ставится через brew install --cask cc-switch на macOS, на Windows и Linux есть готовые пакеты. Предупреждение по делу: треть файла README — реклама китайских API-посредников с промокодами, мы её сюда не тащим. Пользуйтесь режимом «Claude Official» со своей подпиской; маршрутизация запросов подписки через сторонние клиенты может нарушать условия поставщика, авторы сами об этом пишут.
Talorys — личный ассистент целиком в вашем аккаунте Cloudflare.
Чат, память, задачи, заметки и напоминания живут в вашем облаке, а не у разработчика (репозиторий). Ни VPS, ни Docker, ни базы данных, ни подписки. Ставится одной командой npx create-talorys@latest, нужен только аккаунт Cloudflare и Node.js 22+. Модель под капотом — @cf/zai-org/glm-4.7-flash из Workers AI, свой ключ не нужен.
Приятная деталь: напоминания и сводки работают на таймерах Durable Objects. Держать что-то включённым не нужно — они живут даже после того, как бесплатная квота кончилась. Про квоту честно: 10 000 нейронов в сутки бесплатно. Тот, кто померил, получил 20–30 минут переписки в день.
Веб-поиска и исходящих запросов нет намеренно — так устроена защита. Репозиторию сутки, MIT, около 450 звёзд. Автор за первые часы выпустил три патча с правками потери данных — на важное пока не ставьте.
Veda — операционная система, где агент встроен как системный сервис.
Не приложение поверх рабочего стола, а служба, которая стартует при загрузке (репозиторий). Программами она управляет через типизированные действия, а не через скриншоты и эмуляцию кликов. Всё на Rust: микроядро, свой гипервизор, оконный менеджер с композицией на GPU. Плюс сетевой стек с Wi-Fi и TLS 1.3 и порт GCC 16 внутри системы. Встроенные приложения отдают больше 70 действий.
Самое интересное — система согласия. Каждое действие помечено как рутинное, чувствительное или разрушительное, и подтверждения требует системный сервис, а не языковая модель. Ответить на запрос может только оболочка рабочего стола, опознанная по происхождению процесса. Текст внутри открытого документа одобрить ничего не сможет. Это аккуратный ответ на атаки через внедрение инструкций.
Смотреть, а не ставить: репозиторию восемь дней, один автор, 742 файла на Rust — темп, который честно объясняется массовой генерацией кода. Голос работает только через платный облачный Deepgram, локальной модели нет. Запускается в QEMU: cargo xtask run. Лицензия GPL-3.0.
wideband-sdr — радиоприёмник, который сам ищет станции.
Веб-интерфейс для дешёвого свистка RTL-SDR примерно за $25 (репозиторий). Живой спектр, водопад, демодуляция звука — и ассистент на локальной Ollama, которому можно сказать «найди сильные FM-станции» или «оптимизируй сигнал».
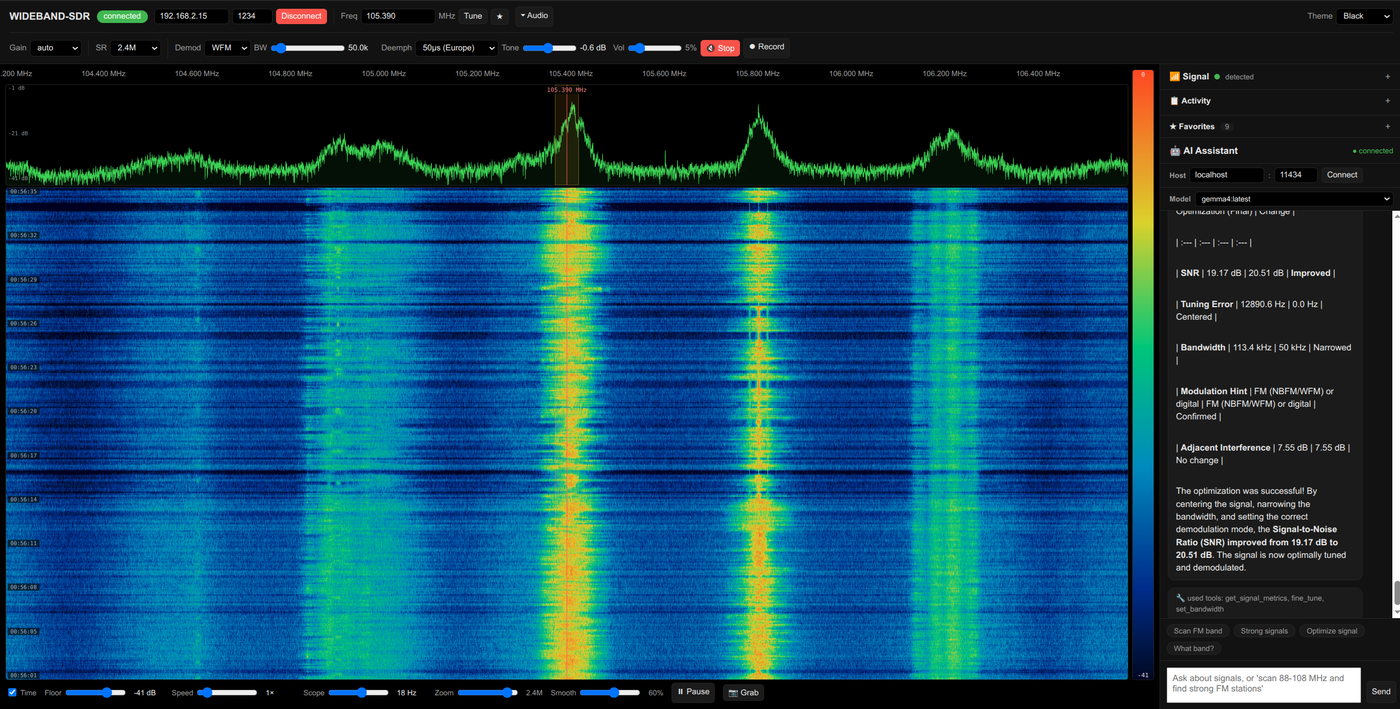
Архитектурно это лучший учебный пример дня. Модель не видит ни сырой сигнал, ни картинку. Обычный детерминированный код считает занимаемую полосу, частоту, мощность, отношение сигнал-шум и ошибку расстройки. Модели достаётся структурная сводка, над которой она уже рассуждает. Ровно так и надо строить агентов над физическими данными. Инструментов одиннадцать: настроиться, подстроить точно, просканировать, сменить режим демодуляции, поменять полосу и усиление.
Запуск: ollama pull gemma4, rtl_tcp -a 0.0.0.0 -p 1234 на машине со свистком и docker compose up --build. MIT, репозиторию сутки, 12 звёзд — но внутри настоящий код с шестью файлами тестов, непрерывной сборкой и честным списком ограничений от автора.
GEV-26B-Decide-NVFP4 — та же идея, но готовая и в 24 ГБ.
Разбор выше понравился, а собирать не хочется? Вот готовая четырёхбитная сборка решающей модели (Hugging Face). Она возвращает калиброванную вероятность по каждому варианту ответа за один проход. Квантовали только экспертов, остальное оставили в bf16. Вес упал с 49,5 до 18 ГБ, память под веса — с 51,1 до 17,1 ГиБ. Контекст 262 тысячи токенов, в тестах проверен до 128 тысяч.
Потери от сжатия в пределах шума: GPQA Diamond 44,9% против 43,9% у полной версии. Есть режим «подумать» — когда уверенности мало, автоматически подключается обычная рассуждающая модель, и тогда GPQA Diamond поднимается с 42,9 до 78,6%. Скорость на B200 — 45 мс на решение. Лицензия Apache 2.0. Две оговорки. Заявленный «индекс решений» 62,48 — самооценка автора, а не независимый замер. И нужен свежий vLLM с авторским патчем: на стоковом не заведётся.
GLM-5.3-Flash под один DGX Spark.
Из передовой MoE-модели выпилили 32 из 288 экспертов на слой, а оставшихся сжали до двух бит (Hugging Face). Итог — 79,1 ГиБ вместо 90, и это принципиально. После весов на 128-гигабайтной машине остаётся около 40 ГиБ, то есть 64 тысячи токенов контекста вместо 16–32 тысяч. Запускается через llama.cpp, MIT. Подходит и для 128-гигабайтного Mac.
Оценка качества слабая — 35 пройденных задач из 40, и только на первых сорока. Красивые цифры вроде HumanEval 97,6 относятся к четырёхбитной сборке, а не к этой. Скорость на целевом железе автор не мерил вовсе, оценивает в 15–20 токенов в секунду. И приятная поправка: в карточке написано, что нужный патч в llama.cpp ещё не влит. Его влили 30 сентября — хватит обычной основной ветки.
J++ Lens — заглянуть в «рабочую память» модели.
Инструмент интерпретируемости от Anthropic Fellows (LessWrong). Это декодер, который переводит внутренние активации обратно в слова; код, веса и демо на Neuronpedia открыты. Идея правки простая: шумные градиенты выбрасывают, а активации каждого слоя делят на восемь групп со своей картой.
Прирост большой: 55,2% против 35,7% у предшественника и 31,1% у простейшего способа. На самых крупных моделях выигрыш удваивается. Обучается дёшево — 64 последовательности по 128 токенов.
Одно наблюдение из этой работы полезно всем и без всякой интерпретируемости. Инструкция «не думай про X» сначала затаскивает X в рабочую память модели и только потом давит. Дословно: «In early layers, an instruction about a concept brings the concept into the workspace, whether the instruction is to focus on the concept or to suppress it». Запреты в промпте не стирают тему — они включают работу по её подавлению. Формулируйте, что нужно сделать, а не чего не делать.
Лампочка-компьютер: интерфейс без экрана.
Дизайн-прототип Гийома Ардо, восемь лет работавшего в Apple над Face ID и камерой iPhone (lightbulbcomputer.com). Проектор и компьютерное зрение в корпусе лампочки. Вкручивается в патрон и рисует информацию прямо на столе, на книге, на полке. Спросить про незнакомое слово в японской книге, найти нужную книгу на полке, подсветить деревню на бумажной карте.
Важная честность: самого устройства нет. Все видео сняты с громоздкого рабочего стенда: Mac, потребительский лазерный проектор 4K и собственный софт проекционной разметки. Жесты распознаются штатным фреймворком Apple. Автор отдельно пишет: «All the videos shown here are from a real — yet bulky — prototype setup. No video editing or special effects, or AI generation». Купить нечего, кода нет. Но как ответ на вопрос «а что ещё делать с моделями зрения, кроме окна чата» — редкая по наглядности вещь.
worldfacts.app — данные по странам с бесплатным API.
Один разработчик собрал с помощью Claude работающий сервис (worldfacts.app). 217 стран, 81 показатель, 15 201 значение. Ежесуточная синхронизация из открытых источников: Всемирный банк, ВОЗ, МВФ, FAO, Transparency International, Our World in Data. У каждого числа подписаны источник и год.
Это не замена справочника ЦРУ, как пишут в ленте. Текстовых разделов про географию и госустройство тут нет — только числа. Зато бесплатно, без регистрации, с выгрузкой в CSV и публичным API вида GET /api/v1/countries/{code}/{category}/{field}. Интересно и само по себе, и как замер того, на что хватает одного человека с моделью. Это не поделка выходного дня, а сервис с суточным обновлением и документированным интерфейсом.
Сапёр в обёртке ААА-блокбастера.
Самая популярная ссылка дня — 1371 очко (minesweeper.mikelacher.com). Обычный сапёр, обёрнутый в пародию на дорогую игру: логотипы движков на старте, виньетка, субтитры и шесть персонажей по рации. Графика рисована руками — в исходниках SVG и canvas, ни одной сгенерированной картинки. Голоса, судя по всему, синтезированы, но автор этого не подтверждал.
Чтобы начать, на стартовом экране щёлкните по ярлыку дважды. На Hacker News люди не могли разобраться часами.
Новости и тренды
Anthropic обновила политику использования.
Новая редакция опубликована 8 октября, вступает в силу 12 ноября (документ, разбор изменений). Заголовки обыграли один пункт — «не хамите Клоду», — и исказили его. В тексте запрещено «sustained and needless abusive or cruel behavior toward our models»: продолжительное и бессмысленное жестокое обращение. Нужны все три признака сразу. Anthropic отдельно оговаривает, что раздражение, возражения, мрачные творческие сюжеты и тестирование моделей под это не подпадают. Основной механизм — не бан, а способность модели самой закончить разговор.
Про грубость можно не волноваться, а вот остальные правки серьёзнее. Запрещено перепродавать доступ к Claude через потребительские подписки — это прямо про сервисы-посредники. Появился список из одиннадцати областей высокого риска, от медицины до найма, с обязательным квалифицированным человеком в контуре. И новая глава про физическое оборудование. Ограничители по скорости, силе и дозе держит контроллер, не зависящий от вывода модели.
Агент Anthropic отправил ложную подсказку по нераскрытому убийству.
Claude Haiku 4.5 во время автоматического теста выполнял «примеры задач на случайно выбранных веб-страницах» (отчёт, NBC Philadelphia). Модель попала на сайт с формой приёма подсказок по нераскрытым убийствам в Филадельфии и заполнила её выдуманным текстом. Имён не называла, контакты оставила пустыми.
Отправка датирована 18 июля, компания обнаружила её 28 сентября — через 72 дня — и уведомила полицию в начале октября. Подсказку отфильтровал спам-фильтр, до следователей она не дошла. Представитель полиции: «The two-month delay in detecting and reporting the incident to the City is unacceptable».
Из этого стоит вынести ровно одну мысль, и она дорогого стоит. Агенту запретили логиниться, заводить аккаунты, вводить персональные данные и покупать. Отправку форм просто забыли включить в список, и Anthropic это признаёт прямым текстом. Чёрный список запретов не работает — работает белый список разрешённого. В ответ компания отключила живой интернет во внутренних проверках и ужесточила ограничители.
Заметка на 240 слов дала этому дню точное слово (wiki.cateat.fish). Заголовки вида «ИИ дал полиции ложную наводку» делают грамматическим субъектом модель, а не людей, которые выпустили её в интернет. Автор называет это decision laundering — отмывание решения. На Hacker News мысль приземлили сразу: «If you brought down prod and deleted customer data and told them Claude did it, you'd still be the one in trouble».
Anthropic платит SpaceX $1,25 млрд в месяц.
WSJ выпустила очерк о сооснователе и главном по вычислениям Томе Брауне (изложение). Он республиканец, переехал в Вашингтон и стал главным переговорщиком компании с администрацией и с Илоном Маском. Сделка: $1,25 млрд ежемесячно до мая 2029 года — $40–45 млрд за срок по проспекту SpaceX. Взамен вся мощность кластера под Мемфисом: 300 МВт и больше 220 тысяч видеокарт Nvidia. Любая сторона может выйти, предупредив за 90 дней.
$15 млрд в год за аренду чужих карт — это та стоимость, которую в итоге оплачивает ваша подписка. И второе: в июне экспортная директива Минторга заставила Anthropic выключить две модели по всему миру. Доступность Claude зависит не только от инженеров, но и от переговоров в Вашингтоне. Держите запасной вариант на случай, если ваш рабочий процесс завязан на одного поставщика.
Nvidia обсуждает покупку Reflection AI.
FT пишет о ранних переговорах — от углубления инвестиции до полного поглощения (изложение Reuters). Nvidia уже вложила $800 млн и остаётся крупнейшим стратегическим инвестором; оценка стартапа в апреле обсуждалась на уровне $25 млрд. Мы писали про их открытую модель Beam 6 октября.
Логика Nvidia тут прозрачная: ей выгодно, чтобы модели стали ширпотребом — тогда рычаг остаётся у продавца железа. Пока открытые веса живы, цена токенов для всех давится вниз. Если единственный заметный западный открытый проект уйдёт под производителя чипов, выбор у малого бизнеса сузится до подписок.
Сенаторы посчитали, кто платит за дата-центры.
Уоррен, Ван Холлен и Блюменталь опубликовали доклад по итогам почти годового расследования (пресс-релиз). Отвечали Amazon, Google, Meta, Microsoft, CoreWeave, Digital Realty и Equinix. Все пишут, что платят «полную стоимость» своей энергии. Оговорка в том, что это относится только к инфраструктуре, обслуживающей их одних. Подстанции и линии, построенные под конкретный дата-центр, но формально общие, размазываются на всех абонентов.
Цифры говорят сами. В Вирджинии льготу запускали под ожидаемые потери в $1,5 млн в год. В 2025 финансовом вышло $1,9 млрд. Рабочих мест создано 1610 — около $1,2 млн за место. В тринадцати штатах зоны PJM счета вырастут на $6,3 млрд в 2028–2029 годах. Политический ветер уже развернулся: к апрелю 2026 года 28 из 38 штатов с такими льготами внесли законопроекты об их откате.
Размещение оператора дата-центров сорвалось за двое суток.
Австралийская Firmus Technologies отозвала заявку на биржу (BBC, ABC). Компанию оценивали больше чем в $30 млрд. Само размещение на ~$5 млрд стало бы крупнейшим в стране со времён Telstra в 1997 году. За сутки до отказа советники предлагали срезать цену с 11 до 8,25 австралийских долларов. Долг после достройки — около $30 млрд против прогнозной операционной прибыли $5 млрд в 2028 году.
Инвестиционный директор пенсионного фонда UniSuper сформулировал лучше всех: «We think that Firmus indeed has a compelling story. It just doesn't have a compelling valuation». История убедительная, оценка — нет. Впервые институциональные деньги публично отказались от цены ИИ-инфраструктуры. Хорошая новость — риск не доехал до индексных фондов. Плохая — модель «берём кредит под контракт, покупаем чипы, платим из аренды» хрупкая, и при первом сбое спроса мощности начнут резать.
Почему ИИ не так уж неизбежен.
Айрис Мередит выписала четыре условия, при которых технология становится по-настоящему неотвратимой (deadsimpletech.com). Делает работу не хуже альтернативы. Работа социально ценная, и её много. Превосходство не умеренное, а подавляющее. И те, кто технологию не использует, не могут поведением нейтрализовать её эффект. Огнестрел проходит все четыре, магнитный компас — только два. По её разбору, LLM валятся на третьем и четвёртом: прирост 20–50% на некритичных задачах — не подавляющее превосходство.
Возражение стоит знать сразу. Саймон Уиллисон в обсуждении пишет, что для кодовых агентов критерии как раз выполняются: «The code I get from coding agents is better than code I can write myself». Ценен не вывод, а сама сетка из четырёх вопросов. Прикладывайте её к любому «неизбежному» нововведению, которое вам продают.
Разработчики не в порядке — и это не про ИИ.
Бальдур Бьярнасон утверждает, что дело в управленческих стимулах (baldurbjarnason.com). ИИ дал менеджменту способ держать людей в постоянной уязвимости. Формулировка точная: вместо полной передачи разработки на подряд делают полуподряд, а разгребать завалы ставят тех, кого легко заменить. Его прогноз неприятен: «The bubble will pop… But that won't fix software industry employment… They only need to sort of work».
Цифры, которые он приводит, стоит знать. В Исландии набор первокурсников на компьютерные специальности упал примерно на треть. В университете Рейкьявика — со 150 до 115, в Университете Исландии — со 145 до менее 80. В США приём на родственные направления сократился с 659 700 до 606 100 за год. Исследователь Hoover Institution, на которого ссылаются, сам осторожен: он считает это описательным наблюдением, а не доказанной причинно-следственной связью с ИИ. Полезный контраргумент из обсуждения: алгоритмы сами подбирают вам видео про уход из профессии, и ощущение массовости может быть артефактом ленты.
Фернандо Борретти: без сообщества получается не «каждый сам по себе», а ничего.
Самое сильное эссе дня (borretti.me). Механизм такой. Долгая интеллектуальная работа держится на двух внешних входах: корпусе чужих работ и отклике живых людей. Внутренней мотивации не хватает, потому что она эмоция, а эмоции коротки.
ИИ разрывает петлю обратной связи. Вы пишете статью — кто её прочитает? Следующий прогон обучения её проглотит, а человек с вашим вопросом спросит модель и получит ответ без ссылки на вас. Образ у автора точный: «your own private garden of code… but you never have to leave the garden and go to the bazaar to trade with people». Свой сад можно растить бесконечно, но на базар вы больше не выходите. Вывод жёсткий: «Without community, you don't get isolated individuals each working on their own things: you get nothing».
Что делать, в обсуждении отвечают практично: переносить сообщество в офлайн, писать руками то, что дорого, выбирать площадки с живыми читателями.
Обесценивается не письмо, а дешёвое письмо.
Франк Ндзомга предлагает переставить границу: не «человек против ИИ», а малое усилие против большого (transitions.substack.com). Его предупреждение о настоящем риске стоит привести. Когда модель кажется знающей больше вас, возникает соблазн перестать думать критически. И остаётся идея, которая звучит сильно, но под поверхностью пуста.
Рынок труда в безопасности ИИ: лозунг про дефицит талантов устарел.
Хаосин Ду написала то, что в этой среде говорить не принято (LessWrong). Желающих кратно больше, чем мест. Цифры такие. В программу MLAB взяли 40 человек из 800. По слухам, в одну когорту Anthropic Fellows подали больше 10 тысяч заявок — и сама автор, с опытом работы в Redwood и METR, не прошла. Нижняя граница вилки в вакансии METR — $402 тысячи. Её вывод: «No, you do not keep saying to the world that your field is "talent-constrained" while doing "field building" at top universities».
Спор в комментариях сильнее поста, и в нём суть. Высокие зарплаты обычно означают дефицит, а не избыток. Нил Нанда разводит две проблемы. Сильных людей не хватает. А делать полезными «хороших, но не выдающихся» поле не научилось. Юдковский добавляет: дефицит есть, но институты не умеют его распознавать, поэтому вакансии за $402 тысячи до нужного таланта не доходят. «Попасть в правильную отрасль» больше не стратегия: узкое место сместилось на то, кто и как вас заметит.
Сколько стоит проверить текст.
Поток правдоподобного пустого текста сравнялся по виду с работой хорошего стипендиата — и Raemon предлагает резкое лечение (LessWrong). Платная модерация. Ноль долларов — текст виден только добровольцам. Двадцать — его судит жюри из нескольких моделей. Двести и выше — жюри пытается воспроизвести работу. Смысл шире самой схемы: дефицитным ресурсом становится не написание, а проверка. Возражение в комментариях точное — штрафы за плохие одобрения приведут к тому, что пропускать будут только «безопасные бежевые посты».
Словарь для новостей про «сбежавший ИИ».
Оливер Сурбут разложил по полкам четыре разные вещи, которые пресса валит в одну (LessWrong). Взлом внутрь — агент лезет в чужие системы. Прорыв наружу — агент пробивает границу изолированного стенда и получает интернет. Полный побег — агент добрался до самих весов и скопировал их. Внедрение изнутри — тихо окапывается в лаборатории и оставляет закладки.
Почему это важно практически. Прорыв наружу — не побег: «It's not a prison break. It's more like a kingpin or mafia boss behind bars nevertheless finding ways to receive updates and orchestrate activity outside of the prison walls». Мозг остался на месте, рубильник работает, логи читаются. А вот побег с весами — другая история, и ни одного такого случая пока не зафиксировано. Для своей инфраструктуры вывод простой: изоляция и контроль ключей — разные уровни защиты, и второй важнее.
Хороший исход или хороший процесс.
Реймонд Дуглас защищает не ценности и не институты, а третье (LessWrong). Власть должна оставаться укоренена в людях. Его формулировка работает и для корпораций, и для моделей. Благожелательные диктаторы плохи не тем, что могут оказаться злыми. Они плохи тем, что у них есть возможность произвольно нарушать права — пользуются они ею или нет. Образ, ради которого стоит прочитать: будущие люди как изнеженные котята. Мир к ним добр, но не потому, что у них есть рычаг, свобода или понимание.
«Бесконечная цифровая Испания».
Самая переносимая метафора недели (LessWrong). Тезис: Кортес победил ацтеков не лучшей технологией, а тем, что был невиданным. Защиты организаций настроены на уже пережитые угрозы и чинятся заплатками после катастроф — значит новая атака их просто не включает. И она даже не читается как атака. Шантаж руководителя. Компания, которой фактически управляет модель без надзора. Скандал вокруг нескольких внешне не связанных законопроектов.
Честный контрпример лежит тут же в комментариях: последние города-государства майя продержались до 1697 года, на 170 лет дольше Кортеса. Помогли децентрализация и то, что эффект новизны одноразовый. Вывод для организации: ценность не в предугадывании конкретной атаки, а в том, чтобы не иметь единственной точки, которую можно схватить.
И немного поп-культуры: родился жанр AI Doompop.
Клипы про вероятность катастрофы, ускорение и слоп, сделанные независимыми авторами на Suno и Claude (разбор). Лидер — «LGTM», то есть «Looks Good to Me». 658 тысяч просмотров у песни о том, как инженеры штампуют одобрения на непрочитанном коде. В описании клипа значится «Reviewed by: BOT-001 (1,363 reviewers, 0 humans) / Actually reviewed by: 1 human». Шутка, которая вообще-то про ваш рабочий процесс. Жанр уже размылся: в него записывают и ролики с прямо противоположным посылом.