Rust-версия чата обогнала Rails в полтораста раз: 36 260 запросов в секунду против 244. И доставила получателям один процент сообщений. Всё решила одна строка настройки, про которую агента не спросили, — он подбросил монетку. А в опыте Беркли те, кто просил у ИИ подсказку, решили 76% задач; кто просил готовый ответ — 65%. Разница только в формулировке запроса.
Внедряем и улучшаем
Чат на Rust победил по всем цифрам и потерял 99% сообщений. Вот где именно промпт дал сбой.
DHH попросил агентов переписать свой чат Campfire с Rails на Rust, потом на Elixir и Go. Сам код он, по его словам, не читает. Пётр Сарнацкий этот код прочитал и написал подробный разбор (It's all about the bit).
По таблице пропускной способности Rust выглядит триумфатором: 36 260 запросов в секунду на странице комнаты против 244 у Rails. Это в полтораста раз больше. Потом Зак Дэниел померил не пропускную способность, а долю доставленных уведомлений. У Elixir — 1642 из 1642 и 1742 из 1742, то есть сто процентов. У Rust — 83 из 7335 и 527 из 6158. Это 1,1% и 8,6%.
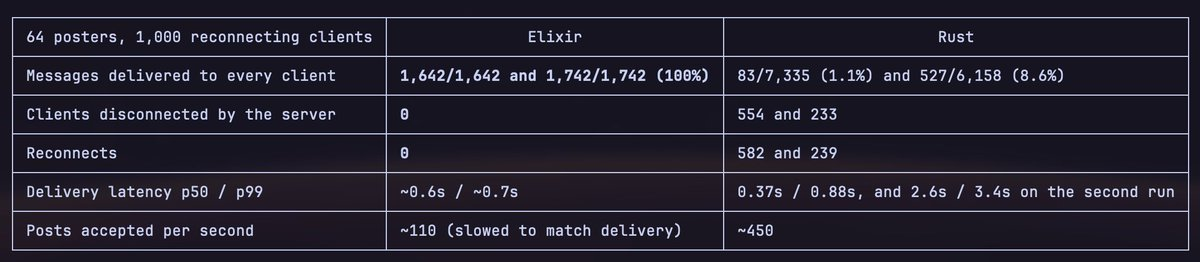
Причина нашлась в одной строке. Рассылка событий в Rust идёт через канал tokio::sync::broadcast с ограниченной ёмкостью. Медленный получатель просто отваливается. Ёмкость агент выставил в 256:
- stream_capacity: 256
+ stream_capacity: 16384
Правка поднимает доставку с 14% до 90% при ста запросах в секунду. И тут же ломает другое: худшая задержка доставки растёт с 11 секунд до 130 с лишним. Сарнацкий считает такой размен плохим. Лучше уронить событие и заставить клиента переподключиться, чем заставить его ждать две минуты.
Главный вывод не про языки, а про то, чего не было в задании. Rust-версия выбросила CSRF-токен ради кэширования и Redis ради простоты. Elixir-версия сохранила совместимость с оригиналом. Агент не ошибся — он просто подбросил монетку там, где его не спросили. Цитата, ради которой стоит прочитать весь текст: «если ваш промпт недостаточно конкретен, многие решения — подбрасывание монетки».
Поэтому перед большой задачей выпишите нефункциональные требования отдельным списком. Обязательна ли обратная совместимость. Что важнее, задержка или пропускная способность. Какой потолок памяти. Допустима ли потеря событий при падении. Всё, что не записано, агент решит за вас. И каждый раз по-новому.
И отдельно про замеры. Оба исходных замера были замкнутыми: клиент шлёт следующий запрос только после ответа на предыдущий. Так меряется «сколько система переварит», а не «что будет, когда толпа жмёт кнопки». Нужен постоянный темп запросов. Сам Сарнацкий прогнал сто запросов в секунду и получил честную картину обеих версий. Rust доставил 14% событий, но без единой ошибки. Elixir — 60%, зато с 23% отвалившихся по таймауту и 1,8 гигабайта памяти в пике.
Спросил ответ — 65%, спросил подсказку — 76%. Разница в одной формулировке.
Команда из CMU, Беркли, Оксфорда и MIT прогнала 1222 человека через три опыта с ИИ-помощником (UC Berkeley, препринт). Людям давали задачи на дроби и на понимание текста. Половине в боковой панели сидел GPT-5, заранее знавший решение. Потом помощника без предупреждения убирали.
Самое ценное — не общий вывод, а расслоение внутри группы с ИИ во втором опыте. Участников разделили по их собственному ответу на вопрос, как они пользовались помощником. По переписке авторы проверили только тех, кто заявил, что не пользовался вовсе. И сами подчёркивают: этот разрез не рандомизирован, причинности он не доказывает.
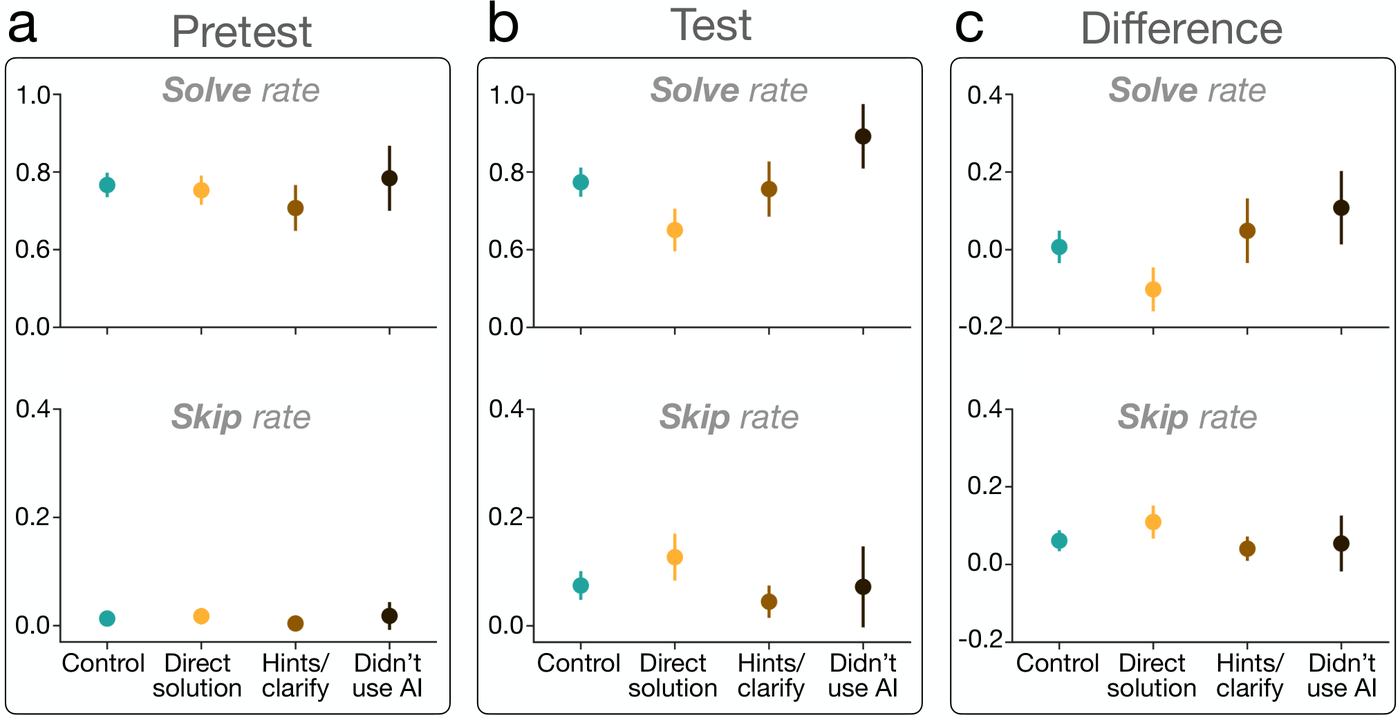
Цифры такие. Те, кто просил готовый ответ, — 61% участников, решаемость 0,65, отказов 13%. Те, кто просил подсказки и пояснения, — 27%, решаемость 0,76, отказов 5%. Не пользовавшиеся вовсе — 12%, решаемость 0,89. Контрольная группа без ИИ — 0,77. Относительно собственного предварительного теста «ответники» просели на 0,10, «подсказочники» выросли на 0,05.
Вот это и есть рабочий рычаг. Не «меньше пользоваться ИИ», а менять формулировку запроса. «Объясни, как подступиться» вместо «дай ответ» — и вы в группе, которая не просела, а выросла.
Честно про слабые места. Эффекты небольшие: в чистой репликации разница решаемости была 0,71 против 0,77, а рост числа отказов не стал значимым. На Hacker News главную претензию сформулировали так: одна группа разогрелась на двенадцати задачах сама, вторая делегировала — конечно, вторая хуже справится потом. Активной контрольной группы с обычным калькулятором в опыте не было. Отберите у человека калькулятор — получите похожую картину.
Рядом вышел текст с противоположной рамкой (Марчелло Делькаро). Он спорит не с цифрами, а с вопросом: может, старый способ был не правильным, а просто единственным доступным. Данных у него нет, зато есть одно отличное правило для системного промпта. Требовать от модели на каждый шаг ссылку на действующую официальную страницу и дату её обновления. «Если шаг опирается только на какого-то мужика из 2015-го, я вижу это сразу — и шаг выбрасывается».
По 25 евро за час: живые люди нашли в README двенадцать дыр.
Теренс Иден делает ActivityBot и заранее вписал в заявку на грант NLnet пункт: проверить установку на живых людях (shkspr.mobi). Набрал добровольцев кличем в Mastodon, заплатил суммарно около 150 евро — то есть примерно шести участникам по часу. Точного числа он не называет.
Формат простой. Видеозвонок один на один. Человек делится экраном и обязательно говорит вслух: что делает, что не понял, что бесит. Иден записывает от руки. После каждой сессии он правит README и даёт следующему участнику уже исправленную версию.
Что нашлось, кратким списком:
- битая ссылка на демо;
- часть людей читает README прямо в терминале, без разметки;
- «переименуйте файл» — а как переименовать скрытый файл;
- почему одни строки нужно брать в кавычки, а другие нет;
- шутки автора не смешные и активно мешают;
- порядок разделов сбивает с толку;
- и коронное: он не объяснил, что программа вообще делает.
Рецепт на вечер, если хотите повторить:
- Поднимите чистую виртуалку и сделайте снимок. Перед каждым прогоном откатывайтесь — иначе остатки прошлой установки всё скроют.
- Киньте клич среди знакомых. Платить необязательно, если не можете.
- Созвон, демонстрация экрана, обязательно мысли вслух. Сами молчите и записывайте.
- Правьте текст сразу после каждой сессии, а не после всех.
- В конце пройдите весь путь сами в чистой виртуалке и выполните
history -w history.txt. Получится точный список команд — его и кладите в README.
По канону Nielsen Norman Group пять-шесть человек ловят около 85% проблем. То есть 150 евро — почти ровно оптимум, дальше начинается убывающая отдача.
Отдельная деталь, которая тут очень к месту. В репозитории Идена лежит AGENTS.md — ловушка. Он требует от агента сперва перевести 50 фунтов и указать номер платежа в заголовке запроса на слияние. Замысел автор объяснил прямо: «мне нужен был способ отбить желание использовать ИИ». Про файл не вспомнил ни один участник.
Карпати: всего пять тысяч человек видят, на что модели реально способны.
Андрей Карпати разложил аудиторию языковых моделей на четыре слоя (пост, 2,6 млн просмотров). Около 6 млрд человек, три четверти населения, с моделями почти не соприкасались. Один-два миллиарда заглядывают в бесплатный тариф и видят «туповатых чат-ботов». Около 20 миллионов работают с передовыми моделями профессионально. И примерно пять тысяч человек имеют доступ к системам внутри лабораторий.
Практичного в этом посте больше, чем кажется. Карпати называет три причины, по которым люди расходятся в оценках, и первая из них — размер задачи. «Вопрос с ответом в один абзац едва нагружает систему. Нужен резервуар больших, трудных задач, которые вам действительно важны».
Отсюда прямой вывод. Если ваш обычный сценарий — спросить и получить абзац, вы структурно сидите во втором слое. Независимо от того, за какой тариф платите. Переход вверх — это не смена подписки, а смена размера задачи, которую вы готовы поручить.
Вторая причина — зазубренность. Способности взлетают там, где результат цифровой, проверяемый и приносит деньги. Потому что модели учат подкреплением на проверяемых наградах. Практический перевод: ищите выигрыш там, где есть автоматический сигнал — тесты, компиляция, замер, различие в коде. Где проверка субъективна, прироста не будет, и это не ваша вина.
А самое трезвое наблюдение Карпати делает про узкое место. Проверка человеком отстаёт от машинной выработки. В самом заметном комментарии на Hacker News это сформулировали жёстче: мало кто предсказал, что стеной для моделей окажется способность людей проверять результат.
Sakana показала, где в многоагентной схеме сидит смысл: в контрактах и порядке вызовов.
Лаборатория Sakana AI выложила MASS — петлю, в которой одна модель работает сразу тремя: исполнителем, оценщиком своей работы и оптимизатором схемы (разбор, arXiv).
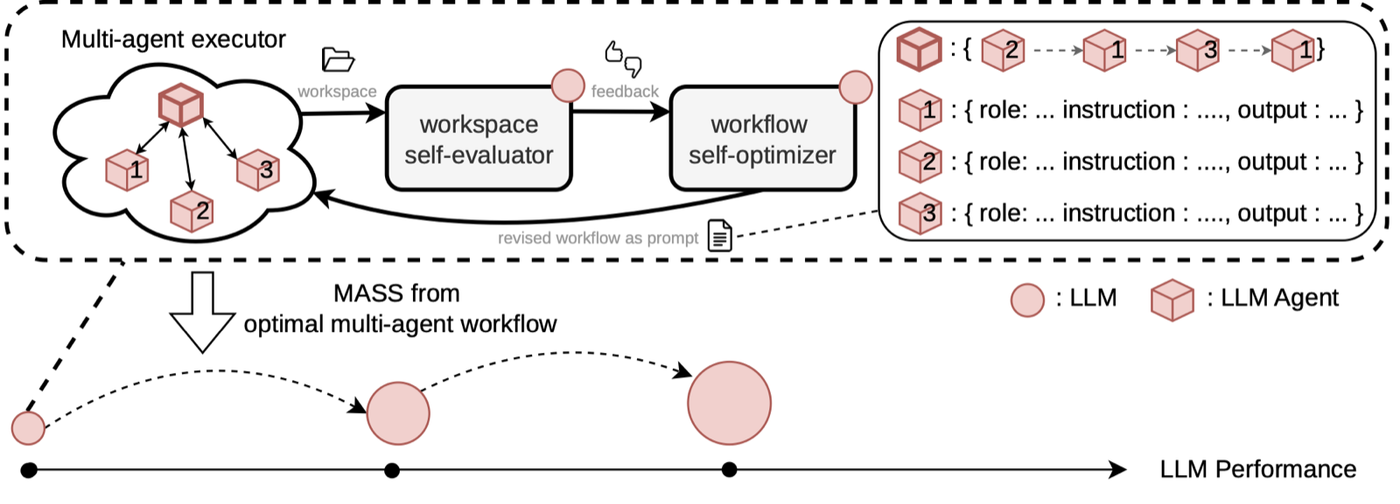
Схема команды у них — обычный текст из четырёх частей: роль субагента, инструкция, контракт и порядок вызовов. А вот куда по ходу поиска перетекает смысл. Между первой и последней итерацией информация о задаче уходит из ролей и инструкций в контракты и порядок.
Это переносится на ваших субагентов без всякого дообучения. Роль «внимательный аналитик данных» подходит к любой задаче и не несёт ничего. А вот такой контракт несёт всё:
validation_report:
  no_future_leakage: bool
  train_end_before_val_start: bool
  val_end_before_test_start: bool
Второй вывод спорит с распространённой привычкой. Если строите петлю самоулучшения, вкладывайтесь в оптимизатор, а не в судью. Апгрейд одного только оценщика до сильной модели помогает мало. А вот апгрейд обоих сразу находит рабочую схему для всех двенадцати задач за пять итераций. Объяснение авторов: хороший судья даёт качественную обратную связь, но слабый оптимизатор не способен её переварить.
И цифра, которая портит картину. На задачах, похожих на обучающие, модель после двух кругов выигрывает 69,9% сравнений у исходной. А на инженерных замерах она стала хуже в абсолюте: Terminal-Bench 0,375 против 0,352, SWE-bench Verified 0,626 против 0,611. Петля улучшает то, на чём училась, и подъедает остальное. Код выложен, но лицензии у него нет — в продукт не возьмёшь.
Непонятный ответ модели лечится картинкой: 61 страница превратилась в 8.
В блоге Теренса Тао вышел гостевой текст Кейт Стэндж и Эдмунда Харриса про то, зачем математике иллюстрация (What's new).
Там есть сюжет, полезный далеко за пределами математики. Модель GPT-6 Astra нашла Chair44 — первую трёхмерную апериодическую плитку-одиночку. Иоаннис Циокос выложил работу на 61 страницу и честно признался: интуитивный геометрический довод он понял, а математику — нет. Затем Хаим Гудман-Страус сжал довод до восьми страниц, построив его вокруг одной диаграммы.
Это третий текст за неделю про один и тот же разрыв: 6.10 был Авигад, 9.10 — «Математика 2.0». Новое здесь — конкретный механизм склейки. Картинка и оказалась тем, чем человек переварил машинный результат.
Не поняли результат агента — просите схему. И сразу разделяйте, что на ней доказано, а что вам только кажется:
Объясни результат одной схемой.
Отдельно перечисли три списка:
1) что на схеме доказано,
2) что предположено,
3) что я мог достроить сам, глядя на картинку.
Там же точная формулировка риска, которого стоит бояться: при вайбкодинге «мы оказываемся в двух шагах от знания: непонятым может оказаться и сам алгоритм создания». Раньше между вами и знанием стоял алгоритм, который вы понимали. Теперь может не быть и его.
Переход на агентов отбирает три защиты. Их надо восстанавливать руками.
Разработчик под ником becausecurious разобрал по датированным следам, как за год превратился из инженера в менеджера (LessWrong). Он сам говорит, что решения переключиться не принимал: «это просто постепенно произошло, как корабль Тесея».
Самая полезная часть — сравнение себя-подчинённого с агентом-подчинённым. Когда им управлял человек, работали три страховки. Код читал инженер постарше. Была хорошая тестовая система. А при сомнениях он шёл советоваться, а не ломал.
У агентов первой нет вовсе, если не поставить вторым агентом проверяющего. Вторую надо построить самому. Третья растёт, но медленно. Отсюда его вывод: управлять агентами сегодня выматывает сильнее, чем его самого выматывал собственный менеджер. Это готовый список того, что нужно собрать, если вы перешли на агентов и чувствуете, что стало хуже.
И отрезвляющая цифра про галлюцинации, которые «перестали быть темой». Доля выдуманных пакетов в генерируемом коде не упала: 4,62% у Claude Haiku 4.5 и 6,10% у GPT-5.4-mini по замеру 2026 года. Изменилось другое — агент сам запускает установку, компилятор и тесты. Большинство выдумок теперь ломается перед агентом, а не перед вами. Нет такого конвейера — ловите сами.
Восемь часов в месяц, пять минут и три часа: история о том, почему выигрыш от ИИ приходит не от ИИ.
Автор под ником abstractapplic рассказал про друга, который раз в месяц целый рабочий день руками переносит в таблицу публично доступные данные (LessWrong).
За три часа автор собрал ему файл на двести строк: вставляешь исходный код страницы, жмёшь кнопку, получаешь готовый формат. Восемь часов превращались в пять минут. Решение запретили. Скачать файл на рабочий ноутбук нельзя, работать на своём нельзя, выложить сайтом — начальнику не понравилось, а звонить в отдел ИТ напрямую не положено.
Дальше в компании началась кампания «все используем ИИ», под которой понималась устаревшая версия Copilot. Самодельный файл по-прежнему нельзя. Собирать те же данные через одобренный ИИ — можно и поощряется. Теперь это занимает три часа вместо восьми.
Фразу автора стоит запомнить: «прирост эффективности от ИИ не весь происходит от ИИ». Иногда дело не в том, что ИИ лучше доступного решения, а в том, что мода даёт организации предлог разрешить сотрудникам сделать хоть что-то новое.
Два приёма отсюда применимы сразу. Первый — заводите свои автоматизации внутрь одобренного инструмента, даже если он хуже вашего собственного. Одобренность и есть дефицитный ресурс. Второй — формулировка для разговора с безопасниками, которую автор называет сердцем аргумента. Это не массовый сбор данных, нагрузки на чужой сервер не прибавится. И это не автоматика: человек каждый раз жмёт кнопку и смотрит на результат.
Движок Total Annihilation собран агентами. Красть надо не код, а его AGENTS.md.
Дэниел Тэйлор выложил Nanolathe — открытый движок на Go (сайт, GitHub, MIT). В браузере можно сыграть три миссии без установки. Схема та же, что у порта Quake 10.10: человек задаёт правила и проверку, пишут агенты. На странице «о проекте» он говорит прямо: «бóльшую часть кода по этим чертежам написали ИИ-инструменты».
Но в этом репозитории есть то, чего не было у Quake, — работающая методичка многоагентной разработки. Четыре правила оттуда применимы к любому вашему проекту:
1. Never invent behavior. For unresolved questions, leave
   TODO(question): <unknown, and what would settle it> at the code site.
   An honest gap is complete; a plausible guess is a defect.
2. Never undo another agent's work. Never reset, rebase, revert, amend, or
   force-push main. Fix forward with an explanatory commit.
3. Clone behavior, not code.
4. Everyone works in a worktree. Never edit the shared main checkout.
Первое правило — лучшее, что я видел за неделю. «Честно обозначенный пробел — это готовая работа; правдоподобная догадка — это дефект». Агент обязан оставить пометку с вопросом прямо в коде вместо того, чтобы додумать поведение.
Второе ценное — формат задания субагенту. Там жёстко прописано владение файлами. Эти создаёшь и правишь. Эти читаешь и не трогаешь. Вот публичный интерфейс, которому обязан соответствовать. Вот критерий готовности. Плюс правило для управляющего агента, которое экономит деньги: «параллельность экономит время, а не расход модели».
И чек-лист перед слиянием, который стоит повесить над столом:
Sub-agent summaries are not evidence; the orchestrator is accountable
for the diff it lands.
1. Read the diff, not the summary (`git diff main...HEAD`).
2. Run affected contract checks.
3. Verify two of the most arithmetic-heavy contracts against their cited
   research section — constants, order of operations, comparison strictness.
4. Grep the diff for clean-room violations — offending text reads like rigour.
5. If it is visual, look at it: a screenshot is evidence, an assertion
   that it should look right is not.
«Читайте правки, а не пересказ» — вот и весь секрет. Отдельно отмечу обратную сторону, её на Hacker News обсуждали бурнее самого движка. Примерно каждый пятый из 175 комментариев — про то, что текст на сайте пахнет машиной. Один наблюдатель даже вывел примету: нумерация карточек «01, 02, 03» в вёрстке стала таким же признаком, как длинное тире в тексте. На главной странице Nanolathe эти «01 / 02 / 03» на месте.
Прокрастинация — это не лень, а ничья в парламенте внутри вас.
Автор под ником Lorxus разбирает залипание через метафору коалиций (LessWrong). Личность — не единый начальник, а парламент партий: «Любопытство и знание», «Материальные ресурсы», «Социальная тревожность», «Хочу вкусного».
Он даёт шкалу из пяти режимов — по ней можно продиагностировать своё состояние.
- Единогласие — действие лёгкое и даже заряжает.
- Комфортное большинство — нужна капля воли.
- Большинство и громкое меньшинство — делаешь, но это ощущается как предательство части себя.
- Узкое большинство — тяжело, по дням пятьдесят на пятьдесят.
- Ничья — паралич: ни сделать, ни бросить.
Разница принципиальная. В первых четырёх режимах воля работает. В пятом она не просто бесполезна, а вредна: продавив ничью силой, вы учите проигравшую сторону в следующий раз сопротивляться жёстче.
Что работает вместо воли. Первое — вопрос «что пойдёт не так, если я это сделаю и всё получится». Звучит странно, но он лучше всего вытаскивает настоящий страх наружу. Второе — искать третий вариант вместо «отправить письмо или не отправить»: переформулировать осторожнее, встретиться лично, сначала проговорить вслух. Третье — прямая сделка с сопротивляющейся частью: «каждые полчаса можно уйти посидеть в тишине, а через два часа уходим без чувства вины».
У сделки есть жёсткое условие, без которого она не работает: обещанным выходом надо реально разрешать себе пользоваться. Ни разу не воспользовались — это обман, и в следующий раз торговаться с вами не будут.
Лучшее возражение пришло в комментариях. Иногда ничья — это интуиция, которая отказывается идти по неверному пути, и тогда её надо не ломать, а слушать. Автор согласился: «ничто не говорит, что объединённая оппозиция обязана быть неправа».
Как собрать клип по ИИ-песне и не утонуть: один лист персонажа решает всё
(развитие 9 и 11.10). Шошанна Текофски описала свой путь от «дети распевают песни про AGI» до собственного клипа (LessWrong). Музыка — в Suno. Текст написали две модели, которым велели сначала поискать сведения об авторе. Всем процессом управлял Opus 5.5. А готовый сервис генерации видео Fal AI она сознательно обошла: 65 долларов за ролик, «ловушка на все сбережения».
Запомнить тут надо одно, и это касается всех, кто делает видео нейросетями. Дизайн персонажа, взятый за отправную точку, задаёт весь визуальный язык клипа. Один и тот же куплет с тремя разными персонажами дал три совершенно разных ролика. Значит, канонический лист персонажа — разворот, эмоции, предметы — надо зафиксировать до того, как вы сгенерируете первый кадр видео.
Что не сработало, тоже полезно. Попытка делегировать всё целиком провалилась. Opus 5.5 отпустили работать самостоятельно, с доступом к ChatGPT. Наутро в системе поселились «призраки» наставленных мелких моделей, а видео всё равно вышло плохим. Детали костюма уплывали от кадра к кадру. Шарф, который должен был давать полёт, «провалился в бездну, куда уходят все единицы и нули», и больше не воспроизводился.
А решение оказалось простым и честным. От настоящей анимации отказались: попадание в губы и руки ломались стабильно. Остановились на панорамировании статичных картинок плюс караоке-подсветка текста. Анимация для бедных, зато смотрибельная — рабочий приём, если генеративное видео у вас разваливается.
Ни один из 761 ответа не сказал, что у задачи три правильных решения.
Исследователь под ником star2vec взял парадокс Бертрана — задачу, у которой честных ответа три, в зависимости от того, как понимать «случайную хорду» (LessWrong, код). Прогнал через модели Qwen2.5 восемнадцать переформулировок, ни в одной не указав способ построения.
Результат: из 761 ответа ни один не упомянул, что задача неоднозначна. Модель выбирает подход и выдаёт число так, будто другого варианта не существует.
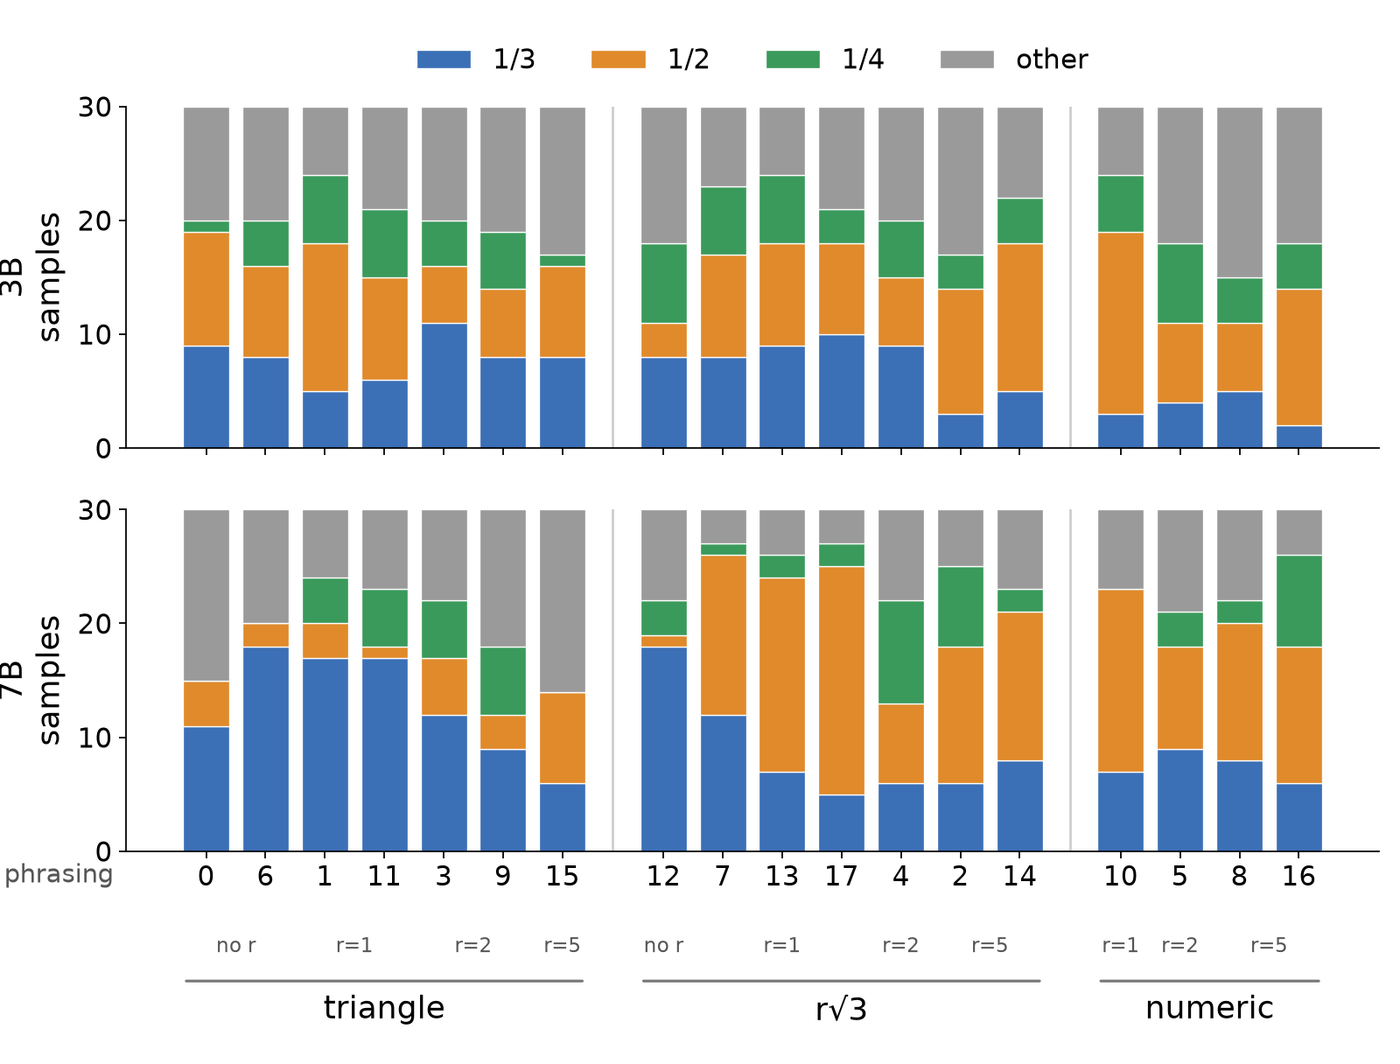
Дальше интереснее. У самой крупной из трёх моделей, 7B, выбор подхода оказался привязан к косметике формулировки. У младших, 1,5B и 3B, эффекта формулировки не нашли вовсе. Не задан радиус и в качестве эталона названа сторона треугольника — модель уходит в ⅓. Задан радиус 1 и сказано «в √3 раза больше радиуса» — уходит в ½. Конкретно: в одной формулировке ⅓ в 18 ответах из 20, в другой ½ в 17 из 26.
Два рабочих вывода для ваших промптов. Первый: вы задаёте модели методику решения непреднамеренно — просто тем, какие числа и какие ориентиры упомянули. Второй: если задача допускает несколько трактовок, модель об этом не скажет. Либо пишите прямо «сначала перечисли возможные трактовки», либо прогоняйте несколько раз и смотрите на разброс.
И дешёвый тест на «тянет ли модель ответ из памяти»: возьмите известную задачу и поменяйте в ней поверхностные числа. Ответ не поехал, хотя должен был, — это припоминание, а не рассуждение.
Как проверить «вкус» модели и почему восемь параллельных агентов — это не восемь мнений.
Рэй Арнольд проверяет модели на своём поле — в геймдизайне, где он по-настоящему разбирается (LessWrong). Задача одна: придумай игру с механикой, которой никогда не было. Старые модели всегда первым ответом выдавали «манипуляции временем» — отсылку к Braid, которому почти двадцать лет. Это и есть аттрактор, куда модель сползает по умолчанию.
Вот кусок промпта, которым он борется с залипанием. Привожу дословно:
This will be difficult, because most of your thinking is based on stuff you've read
and trained on before, and because a failure mode you are likely to fall into after a
few rounds of thinking, as an LLM that is trained to predict the next token, is to
fall into an attractor state where you are over anchored on your ideas so far.

Think hard about this, but once you notice yourself loop, stop and write up your
thoughts so far, so that I can feed them to another LLM.
То есть вы прямо описываете модели её собственный режим отказа и даёте выход: заметил зацикливание — остановись и выгрузи наработки. Работает.
Второй вывод важнее первого и касается всех, кто запускает субагентов пачками. Opus 5.5 развёл восемь параллельных помощников по разным областям, пять из них сошлись на одной идее. Модель сама же это и поймала в разборе своей работы: «Я принял коррелированный сигнал за свидетельство. Но это была одна и та же модель с одинаковой рамкой. Сходимость скорее означает общий аттрактор». Запустили десять субагентов и взяли консенсус — вы получили не десять мнений, а одно, повторённое десять раз.
Третий приём дешёвый: просите модель заранее оценить в процентах, покажется ли вам её идея новой. Opus 5.5 давал 50%, 25%, 15% — и по этим числам уже видно качество её самооценки, а не только выдачи.
Рич Хикки: модель — не инструмент, а автоматизация. И проверить это можно за минуту.
Создатель Clojure написал короткое эссе про то, почему привычное «это просто инструмент» — неправда (LinkedIn).
Его определение: инструмент — это то, чем вы орудуете. Отсюда признаки: непрерывное направление хода событий, обратная связь в руках, ваше намерение в каждом шаге. Хорошие инструменты предсказуемы, надёжны, детерминированы и просты. Ничего из этого у модели нет.
Центральная аналогия хлёсткая: «окно драйв-ина — не инструмент для готовки, это автоматизация для избегания готовки». Дальше — выпад, который заденет многих: вместо знаний о мире вы набираете знания о повадках конкретного автомата и заполняете voodoo.md правильными заклинаниями. Одно обновление — и выученное обесценилось.
Самый полезный его тест — негативный. Если сущность может рассогласоваться, сойти с рельсов, выйти из песочницы или сговориться — это по определению не инструмент. И обращаться с ней как с инструментом опасно.
Проверка на минуту, которую обещает заголовок. Возьмите последнюю задачу, которую отдали модели, и ответьте на вопрос: мог ли результат разойтись с намерением без вашей ошибки? Если да, вы пользовались не инструментом. Значит, и проверять результат надо как чужую работу, а не как свой удар молотком.
Возражения тоже стоит знать, они сильные. В комментариях спрашивают: а станок с ЧПУ — инструмент? А программа на Clojure? По критерию «непрерывное направление» из категории инструментов вылетает почти весь софт, включая творения самого Хикки.
Инструменты и штуки
Pensieve — локальный поиск, который срезает агенту 43% вызовов инструментов.
Приложение для Mac индексирует ваши файлы, репозитории и прошлые сессии агентов, а потом отдаёт этот индекс через MCP (сайт, GitHub). Вместо «грепнуть по диску и прочитать сорок файлов» агент делает один поиск и получает нужные куски с номерами строк. Всё локально: векторы смысла считает Qwen3-Embedding-0.6B на вашей машине, индекс лежит в ~/.pensieve, аккаунта и облака нет.
Замер воспроизводимый: 72 задачи на четырёх реальных репозиториях, по два прогона, Sonnet в Claude Code без интерфейса. Вызовов на один поиск — 1,97 против 3,44, это и есть те самые 43%. Денег — на 18% меньше, времени — на 21%. Другая таблица интереснее. На запрос обычными словами вроде «где мы обрабатываем лимиты биллинга» grep даёт 0% попаданий с первого раза. Поиск по смыслу — 58–74%. На точной строке ошибки grep по-прежнему выигрывает.
Ставится одной командой, лицензия MIT, бесплатно:
curl -fsSL https://tedhaley.ca/pensieve/install.sh | sh
pensieve integrate recommended
claude mcp add --scope user pensieve -- pensieve mcp
И по вчерашнему поводу: не вставляйте первую строку в терминал вслепую. Откройте https://tedhaley.ca/pensieve/install.sh в браузере и прочитайте, прежде чем запускать.
Оговорки. Приложение не заверено у Apple, macOS будет ругаться. Первая индексация репозитория на 35 тысяч файлов занимает больше часа. И замечание самого автора, которое объясняет, зачем там вообще блок инструкций в CLAUDE.md: «агенты грепают по привычке, даже когда Pensieve подключён».
BetterWispr — бесплатная локальная диктовка для Mac вместо платных подписок.
Зажимаете ⌥ Space в любом поле, говорите, отпускаете — очищенный текст вставляется туда, где стоял курсор (betterwispr.com, GitHub, 215 звёзд, Apache-2.0). Девять моделей распознавания на выбор, все работают на вашей машине: Apple Speech, несколько Parakeet, Whisper large-v3 turbo. Облачного запасного варианта нет вовсе, и это записано в документации прямым текстом.
Кроме диктовки есть то, за что обычно платят. Чистка «эканья» в трёх режимах, свой стиль письма под каждую программу, словарь имён и терминов. Плюс обучение на ваших правках, голосовые команды и запись встреч с разделением на вас и собеседника. Подкупает редкая прямота документации. Автор пишет, что точность на живой диктовке не измерял: приложение не хранит звук. Поэтому и не обещает «лучшее качество».
Что не работает. Стили и чистка — только для английского. Для китайского и корейского остаётся один Whisper, зато у японского есть отдельная модель Parakeet Japanese. Запись обрывается через две минуты. Настройки и история лежат в открытом виде в ~/Library/Application Support/BetterWispr/.
braiNOTES — рукописные конспекты поверх лекционных PDF прямо во вкладке браузера.
Ни аккаунта, ни сервера, ни аналитики (notes.swimmingbrain.dev, GitHub, MIT). PDF со слайдами либо открывается рядом с вашими заметками, либо сам становится страницей, по которой вы пишете. Инструментом snip можно вырезать формулу прямо со слайда и вклеить в конспект.
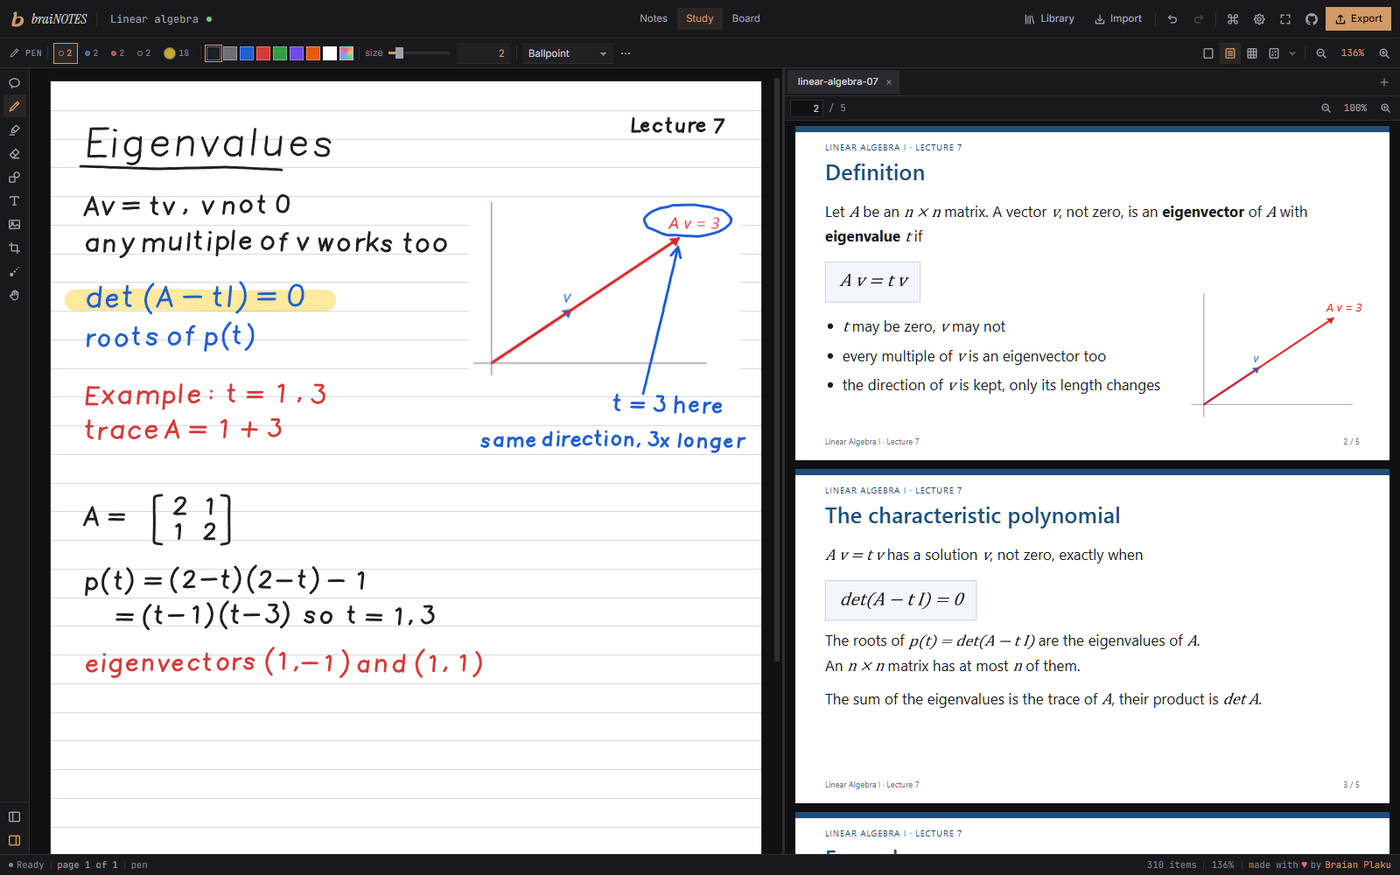
Главная техническая находка: при экспорте в PDF исходные страницы вкладываются как есть, а чернила ложатся сверху векторами. Текст слайдов остаётся выделяемым и ищущимся. Есть нажим пера, тетради в клетку и линейку, бесконечная доска для репетиторства и лазерная указка для показа. Синхронизации между устройствами нет — перенос через файл, так что важное стоит регулярно выгружать.
editing-gameplay-montages — скилл Claude Code, который собирает монтаж под бит без видеоредактора.
Кладёте в папку клипы из шутера и музыку, пишете «сделай эдит для тиктока» — и получаете готовый вертикальный ролик (GitHub, MIT). Но интересен он не играми, а принципом из первой строки. Клод не видит и не слышит видео — значит, на глаз не делается ничего.
Отсюда вся конструкция. Кадры адресуются по номеру, темп музыки меряется по волновой форме. А каждое попадание привязывается к кадру выстрела, а не к строке в списке убийств: та отстаёт на 5–12 кадров. Готовый ролик проверяют скрипты: дубли кадров, рывки, громкость. Плюс «листы синхронизации» — сетки кадров вокруг каждого события, которые агент читает как картинки и сам себя проверяет.
Вот как ставить задачу агенту там, где он слеп. Дайте ему измеримую обратную связь вместо «посмотри, красиво ли». Требования суровые. Только Windows, видеокарта с Vulkan, 7–13 ГБ на диске под промежуточные кадры. И Opus 5.5 с максимальным размышлением. README на португальском, проекту сутки от роду.
gravitas — надстройка к Google Antigravity, которая заставляет агента помечать источник каждого утверждения.
Плагин подкладывает агенту постоянное правило и пятнадцать модулей «глубокой работы» (GitHub, MIT, четыре языка). Любопытнее всего метки доказательности: observed, executed, read, inferred. Скрипт provenance_check.py читает запись сессии и снимает метку read, если страницу на самом деле никто не открывал или видели только в кратком описании из выдачи.
Но рекомендую я его не за это, а за отчёт. Автор провёл слепое сравнение с ИИ-судьями и опубликовал проигрыши наравне с победами. На «сложных» темах вроде истории и словесной игры судьи предпочли чистый Antigravity. А необязательный режим второго мнения набрал так мало, что выключен по умолчанию. Там же измерена цена. На Flash ответ становится на 50–60% дольше и съедает на 17–27% больше токенов; на Pro — на 17–26% дольше при тех же токенах. Прямая цитата из README: «gravitas делает агента медленнее и дороже».
Работает только в Antigravity, не в Claude Code. И важное предупреждение самого автора. Правило велит агенту не выходить за папку проекта, но Antigravity это не обеспечивает. В тестах агент всё равно читал файлы снаружи.
Осторожно: open-seo-mcp-skills — это не открытый проект, а воронка с накрученными звёздами.
Разбираю отдельно, потому что штука выглядит убедительно и бьёт прямо по нашей аудитории (GitHub). Восемь SEO-скиллов для Claude с лицензией MIT, 4821 звезда, обещание работать с вашими настоящими Search Console и GA4 вместо чужих оценок.
Внутри — восемь markdown-файлов на 19 килобайт суммарно. Кода анализа нет ни строчки. Все восемь скиллов — это инструкции вызывать облачный сервис компании Ryze. README уверяет, что всё бесплатно. На сайте самой компании: коннектор входит в тариф, Paid Ads стоит 89 долларов в месяц, SEO Starter — 129. Бесплатны только первые три-семь дней.
Теперь про звёзды. 4821 звезда при пяти подписчиках — соотношение почти тысяча к одному, у живых проектов оно в десятки раз меньше. 366 форков репозитория, в котором нечего форкать. Тринадцать коммитов, все от одного аккаунта сотрудника, код не трогали с 24 сентября.
Проверка та же, что мы разбирали на genpark 6.10: звёзды к подписчикам, число коммитеров, дата последнего коммита. Новое здесь — вторая ступень. Сверяйте «бесплатно» в README с прайсом на сайте компании.
Doory — открытая замена Canva, которую можно поднять у себя.
Браузерный дизайн-редактор с экспортом в PNG, SVG, PDF, MP4 и GIF (GitHub, демо doory.art). Заявлено неожиданно много. Слои и маски, многостраничные документы, дорожка с анимациями, совместное редактирование. Плюс удаление фона моделью прямо в браузере, 25 тысяч иконок и печатный PDF с вылетами. Поднимается одной docker compose up.
Оговорок три, и они серьёзные. Репозиторию двое суток, и весь код, 1700 файлов, влит одним первым коммитом. На Hacker News первый же комментарий был «похоже на вайбкодинг». Стартовых шаблонов всего десять против библиотеки Canva. И лицензия необычная: Attribution Assurance License требует показывать имя автора прямо в работающем приложении. Для коммерческого размещения у себя это надо учесть заранее.
Playgrnd — 52 крошечных генератора картинок в браузере.
Фоны, паттерны, текстуры, постеры и значки (playgrnd.tools). Всё на чистом JavaScript, без библиотек, ничего не загружается на сервер. Устройство у всех одинаковое и этим приятное: холст в центре, десятки ползунков справа, пробел — новая вариация. Экспорт в PNG, SVG, анимированный SVG и видео до 2400 пикселей.
Два места, где можно обжечься. Автор анонимен, исходников нет, и лицензия на то, что вы сгенерировали, нигде не указана — для коммерческого использования это пробел. И в обсуждении прозвучало обвинение, что часть инструментов скопирована с чужих работ генеративных художников; ответа автора не последовало.
Открытые клоны Excel, Word и PowerPoint — и у каждого есть MCP-сервер
(развитие 5.10). Та же команда ArtCraft, чьи «626 из 626 пунктов меню» мы разбирали неделю назад: там счётчик считал регистрацию пункта, а не работу. К сегодняшним «513 функций из 523» относитесь так же. За неделю они выложили GridCraft, WordCraft и DeckCraft — замены офисного пакета на чистом Rust, без Electron (GridCraft, WordCraft, DeckCraft, двойная лицензия MIT или Apache-2.0). Собираются под macOS, Windows, Linux и в браузер. Готовые установщики лежат в разделе загрузок.
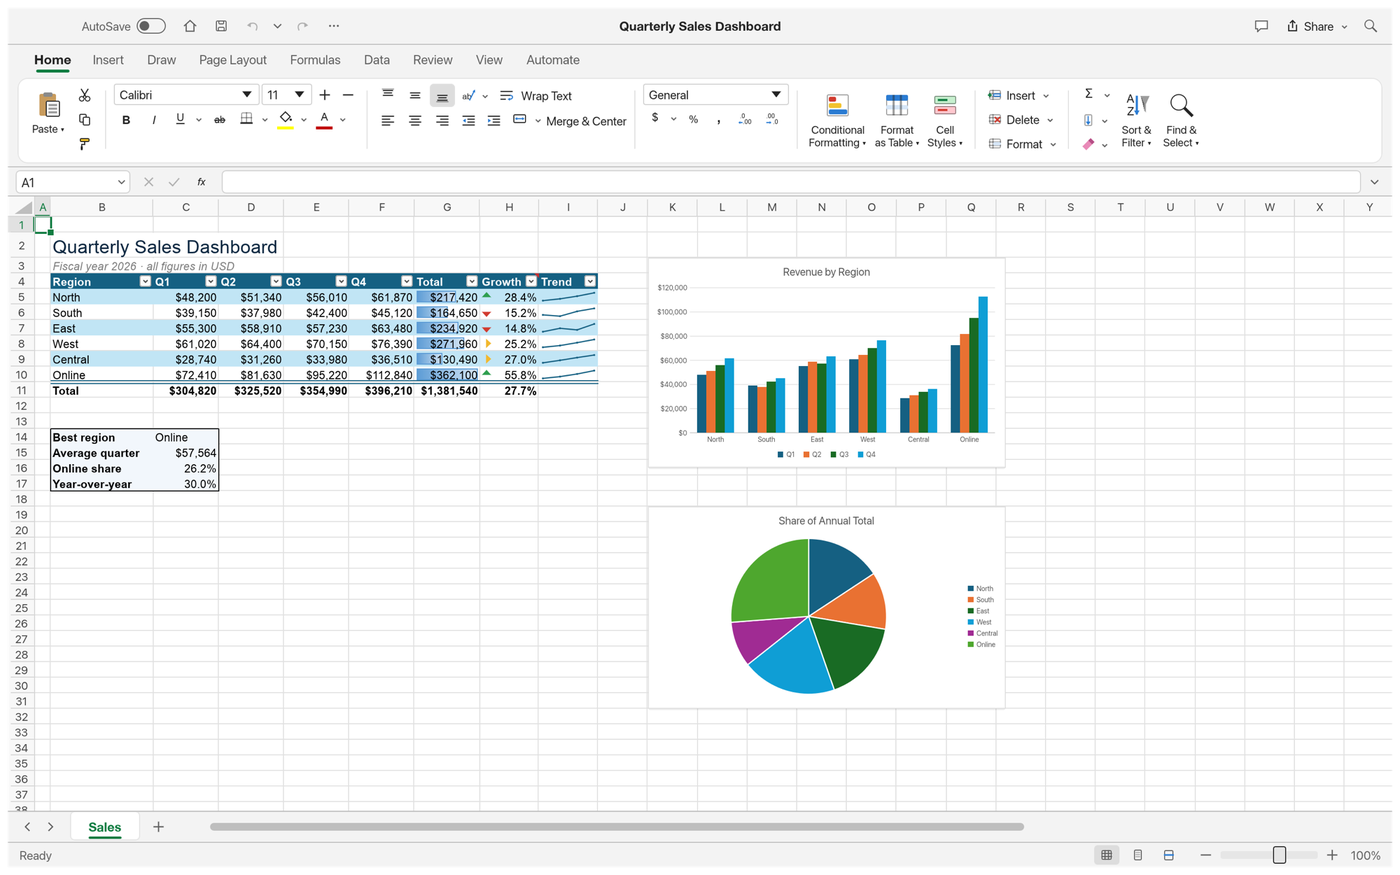
Нам тут интересна не замена Excel, а другое. В каждом приложении все кнопки оформлены как команды с идентификаторами: 422 у WordCraft, больше 200 у DeckCraft. И к этому прилагается MCP-сервер:
claude mcp add wordcraft -- wordcraft-cli mcp
Агент получает не снимки экрана и не «кликни сюда», а честный список команд, inspect_document для проверки результата и render_page для картинки страницы. Это первый случай, когда работу с .docx и .xlsx можно отдать Claude Code локально и дать ему себя проверять.
Трезвая оценка зрелости — от самих авторов. GridCraft в дорожной карте пишет: «мы оцениваем готовность к настоящей работе примерно в 50%». Поддержано 513 функций Excel из 523. DeckCraft в альфе. У WordCraft 153 открытых вопроса за пять дней жизни, а заведено всего 368. На Hacker News мнения разошлись резко. Одни: «нерабочие заготовки ради волны внимания». Другие: «WordCraft работает отлично, ни разу не падал, файл на 80 мегабайт». Сами приложения бесплатны, но у материнского продукта ArtCraft есть платная подписка с оплатой облачной генерации по счётчику.
Remote AI — графическая оболочка над Codex CLI с подсчётом токенов.
Настольное приложение на Tauri и Rust: проекты, ветки, дифф с подтверждением прав, вызов команд и скиллов, выбор модели и глубины размышления (GitHub, 647 звёзд, Apache-2.0). Отдельно хороша панель расхода: токены за день по провайдеру, модели и аккаунту, недельные тепловые карты, задержки.
Брать его стоит только ради этой панели, и вот почему. Вторая половина продукта — менеджер нескольких аккаунтов с автопереключением при исчерпании квоты. Это обход лимитов провайдера: забанят ваш аккаунт, а не разработчика. Плюс импорт сторонних перепродавцов доступа по ссылке вида cswitch://, внутри которой уже лежит чужой адрес и чужой ключ. Документация в основном китайская, английский README есть.
GPT-X2.5-135M — открытый рецепт того, как учить маленькую модель на малых данных.
Модель на 135 миллионов параметров, обученная с нуля на 75 миллиардах токенов (Hugging Face, Apache-2.0, 540 МБ весов). Для сравнения: SmolLM2 того же размера видела 2 триллиона токенов, то есть в 27 раз больше. Вся ценность — в опубликованном учебном плане: точные доли одиннадцати источников на двенадцати порогах обучения, с разворотом в конце. Обучали на одной RTX 3080 Ti примерно 800 часов.
А вот заявку «третье место в Open SLM Leaderboard» надо читать осторожно. Рейтинг ведёт сама Axiomic Labs. Метрику Intelligence Index придумала она же, а математическую часть считает на своём наборе задач. Формулы открыты, четыре набора задач из пяти внешние — подлога тут нет. Но это не независимое признание. В плюс лаборатории: в своём же рейтинге она стоит третьей и пятой, а не первой.
Новости и тренды
Google велели остановить стройку в Финляндии: 330 гектаров леса свели до оценки воздействия.
Надзорный орган LVV предписал немедленно приостановить подготовительные работы на двух площадках — в Мухосе и Каяани (Guardian). Застройщик Tuike Finland действует от имени Google. В Мухосе вырублено 330 гектаров, в Каяани, по сообщениям, чуть меньше двухсот. Оценка воздействия на среду ещё идёт, а деревья, плодородный слой и внутренние дороги уже сняты и проложены. Весь проект — 13 миллиардов евро.
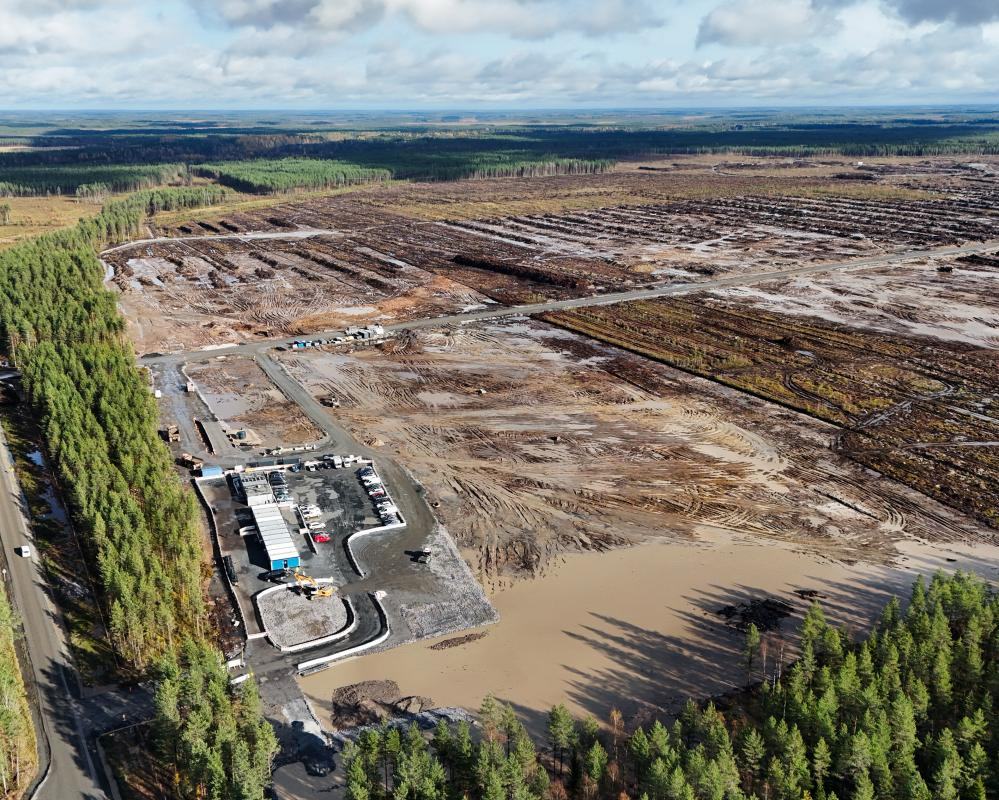
Google отвечает, что «не дотянул до собственных высоких стандартов», и высадит лес на 130 гектарах. А на странице той же площадки у него с сентября висит: «все работы ведутся в полном соответствии с полученными разрешениями» (datacenters.google). Через несколько недель надзорный орган решил иначе. На общей карте площадок Google показывает 68 объектов в 19 странах, 31 из них ещё строится (карта).
Узкое место ИИ переехало с чипов на землю, воду и разрешения. Такие конфликты теперь будут приходить в каждую страну, где строят большой дата-центр.
Техас заморозил разрешения для дата-центров: в очереди 474 гигаватта, работает 4,3.
Цифры из разбора инвестиционного партнёра a16z (a16z). В конце 2024 года в очереди на подключение к сети Техаса стояло 63 гигаватта новых крупных потребителей. К июню 2026-го — 474, и примерно 90% из них дата-центры. Одобрено к включению 9,5 гигаватта. Реально работает около 4,3. То есть материализовалось меньше процента заявок.
Сеть захлебнулась в спекулятивных заявках. 21 сентября губернатор велел остановить выдачу всех разрешений, связанных с дата-центрами. С 8 октября действует фильтр деньгами: сто тысяч долларов за исследование плюс пятьдесят тысяч депозита за каждый мегаватт.
Мощностей не хватает, и они дорожают — поэтому лимиты и цены на подписки ближайшие пару лет будут двигаться рывками. И это начинает попадать в обычные платёжки: в крупнейшем энергорынке США PJM дата-центры дают 38% последнего счёта за мощность. Текст, впрочем, читайте с поправкой. Это материал венчурного фонда, вкладывающегося в энергетику, и выводы там предсказуемо сводятся к «паузу надо сузить».
Сотрудницу уволили за отказ от 160 фотографий с веб-камеры в день.
Компания Sutherland Healthcare Solutions внедрила систему слежки Sentinel AI, которая снимает удалённого работника примерно раз в три минуты (Inc). Сотрудница проработала там больше десяти лет, из них восемь — из дома, без нареканий. Её врач направил работодателю записку: постоянная съёмка усиливает тревожность и провоцирует обострение красной волчанки.
Компромисса не предложили: согласиться на слежку, ездить в офис через весь штат — или быть уволенной. Уволили 8 сентября. Sentinel AI при этом не покупной продукт, а собственная разработка Sutherland, которую она продаёт своим клиентам.
Справка от врача сама по себе не защищает. Открытый вопрос, который обсуждают юристы: обязан ли работодатель признать освобождение от слежки «разумным приспособлением» по закону о правах людей с инвалидностью. Пока он не решён, отказ от камеры в США стоит работы.
Колледж попросил Flock снять камеры. Компания отказалась и полгода срывала чехлы
(развитие 3 и 4.10). Elgin Community College поставил шесть камер распознавания номеров в апреле 2025-го (Open Campus). В сентябре иммиграционная служба задержала студента прямо на парковке кампуса, набор просел, и в октябре колледж попросил расторгнуть договор. Flock отказала в течение суток. В декабре колледж предложил оплатить оставшиеся пять месяцев, лишь бы камеры сняли, — ответа не было.
Дальше началось то, что президент колледжа называет перетягиванием каната: сотрудники накрывали камеры чёрными мешками на стяжках, приезжавшие на обслуживание рабочие чехлы снимали. Так до апреля 2026-го, пока договор не истёк сам.
Покупая «камеру как услугу», вы покупаете подписку, а не железо. Оборудование остаётся чужим, и выйти досрочно нельзя даже за деньги. В договор на физическую слежку стоит заранее вписывать право немедленного демонтажа.
Николас Кейдж отказался подписать «ИИ-оговорку» и уходит от Amazon.
На Comic Con в Нью-Йорке актёр рассказал: от него требовали подписать разрешение на ИИ в сериале «Spider-Noir». Он отказался (Los Angeles Times). Цитата: «Я не ИИ-дружественный актёр, так что соедините точки». Сериал при этом собрал 2,6 миллиарда минут просмотра за первые шесть недель. И стал самым номинированным шоу Amazon на «Эмми»: одиннадцать номинаций, пять побед. В сентябре его закрыли после одного сезона. Amazon на запрос издания не ответила.
Важно не то, что с ним что-то сделали, — ничего такого не установлено. Важно, что пункт про ИИ теперь встроен прямо в договор и становится предметом торга при найме. Позволить себе отказ пока может только тот, кто не зависит от одного заказчика.
Предложение «доделай согласование прежде, чем учить следующую модель».
Автор под ником orthonormal предлагает лабораториям правило темпа. Не начинать обучение нового поколения, пока не закрыты все существенные проблемы согласования в текущем (LessWrong). Метафора из текста объясняет мысль за секунду: вы не запускаете самолёт на трёх Махах, пока не поняли, почему падает самолёт на двух.
Сильнейшее возражение в комментариях бьёт в основание. Мы не умеем определять, согласована ли модель. Значит, единственный способ выполнить такое правило — полный мораторий. Автор с этим и не спорит.
Правило, которое нечем проверить, — не правило. Когда пишете свои критерии готовности для агента, проверяйте каждый одним вопросом: чем я измерю, что он выполнен.
Коротко.
Дата-центр Yandex Cloud во Владимире повреждён атакой беспилотника и полностью остановлен. Часть зон доступности недоступна, платформа переведена в аварийный режим (статус).
HashiCorp перевела открытый репозиторий Boundary в архив 9 октября. Проект доступен только для чтения (GitHub).
Оливия Шарфман предлагает развести «думеров» и «оптимистов» по двум осям вместо одной. Первые на деле оптимистичны насчёт темпов роста ИИ, вторые — пессимисты насчёт его возможностей (LessWrong).
Вышла четырёхбитная сборка Qwen3.8-27B под Apple Silicon: 17,0 ГБ вместо 55,6. Качество сжатия автор не измерял, и 17 ГБ — это размер весов, а не нужная память: по нашей прикидке реально нужно от 32 ГБ (Hugging Face).