Сорок секунд вместо трёх — и ни одной ошибки в логах. Вы просто переключили агенту уровень рассуждений посреди сессии, и один ход съел столько же, сколько шестьсот обычных. Разбираем, какие ещё кнопки так стоят. Заодно — как в команде Claude Code собрали код-ревью из шести слоёв сита. И почему четверть века искали хэш там, где его не было.
Внедряем и улучшаем
Агент вдруг задумался на сорок секунд — вы сломали кэш.
Neuralwatt — облако, которое берёт деньги не за токены, а за измеренное электричество GPU (Neuralwatt). Отсюда у них есть то, чего нет у остальных: прямой замер, сколько джоулей стоил каждый запрос. Они разобрали месяц своего трафика и показали, где у агентов утекают деньги.
Механика простая. Ход кодящего агента отправляет 100 тысяч токенов истории и получает назад пару сотен. То есть 99% работы — это чтение, а не сочинение. Сервер умеет не перечитывать: если начало запроса побайтово то же, он берёт готовый кэш и считает только хвост.
Но кэш работает только по точному началу. Сервер ищет первое расхождение с прошлым запросом и пересчитывает всё от него до конца. Правка в конце стоит копейки. Правка в начале — весь промпт заново.
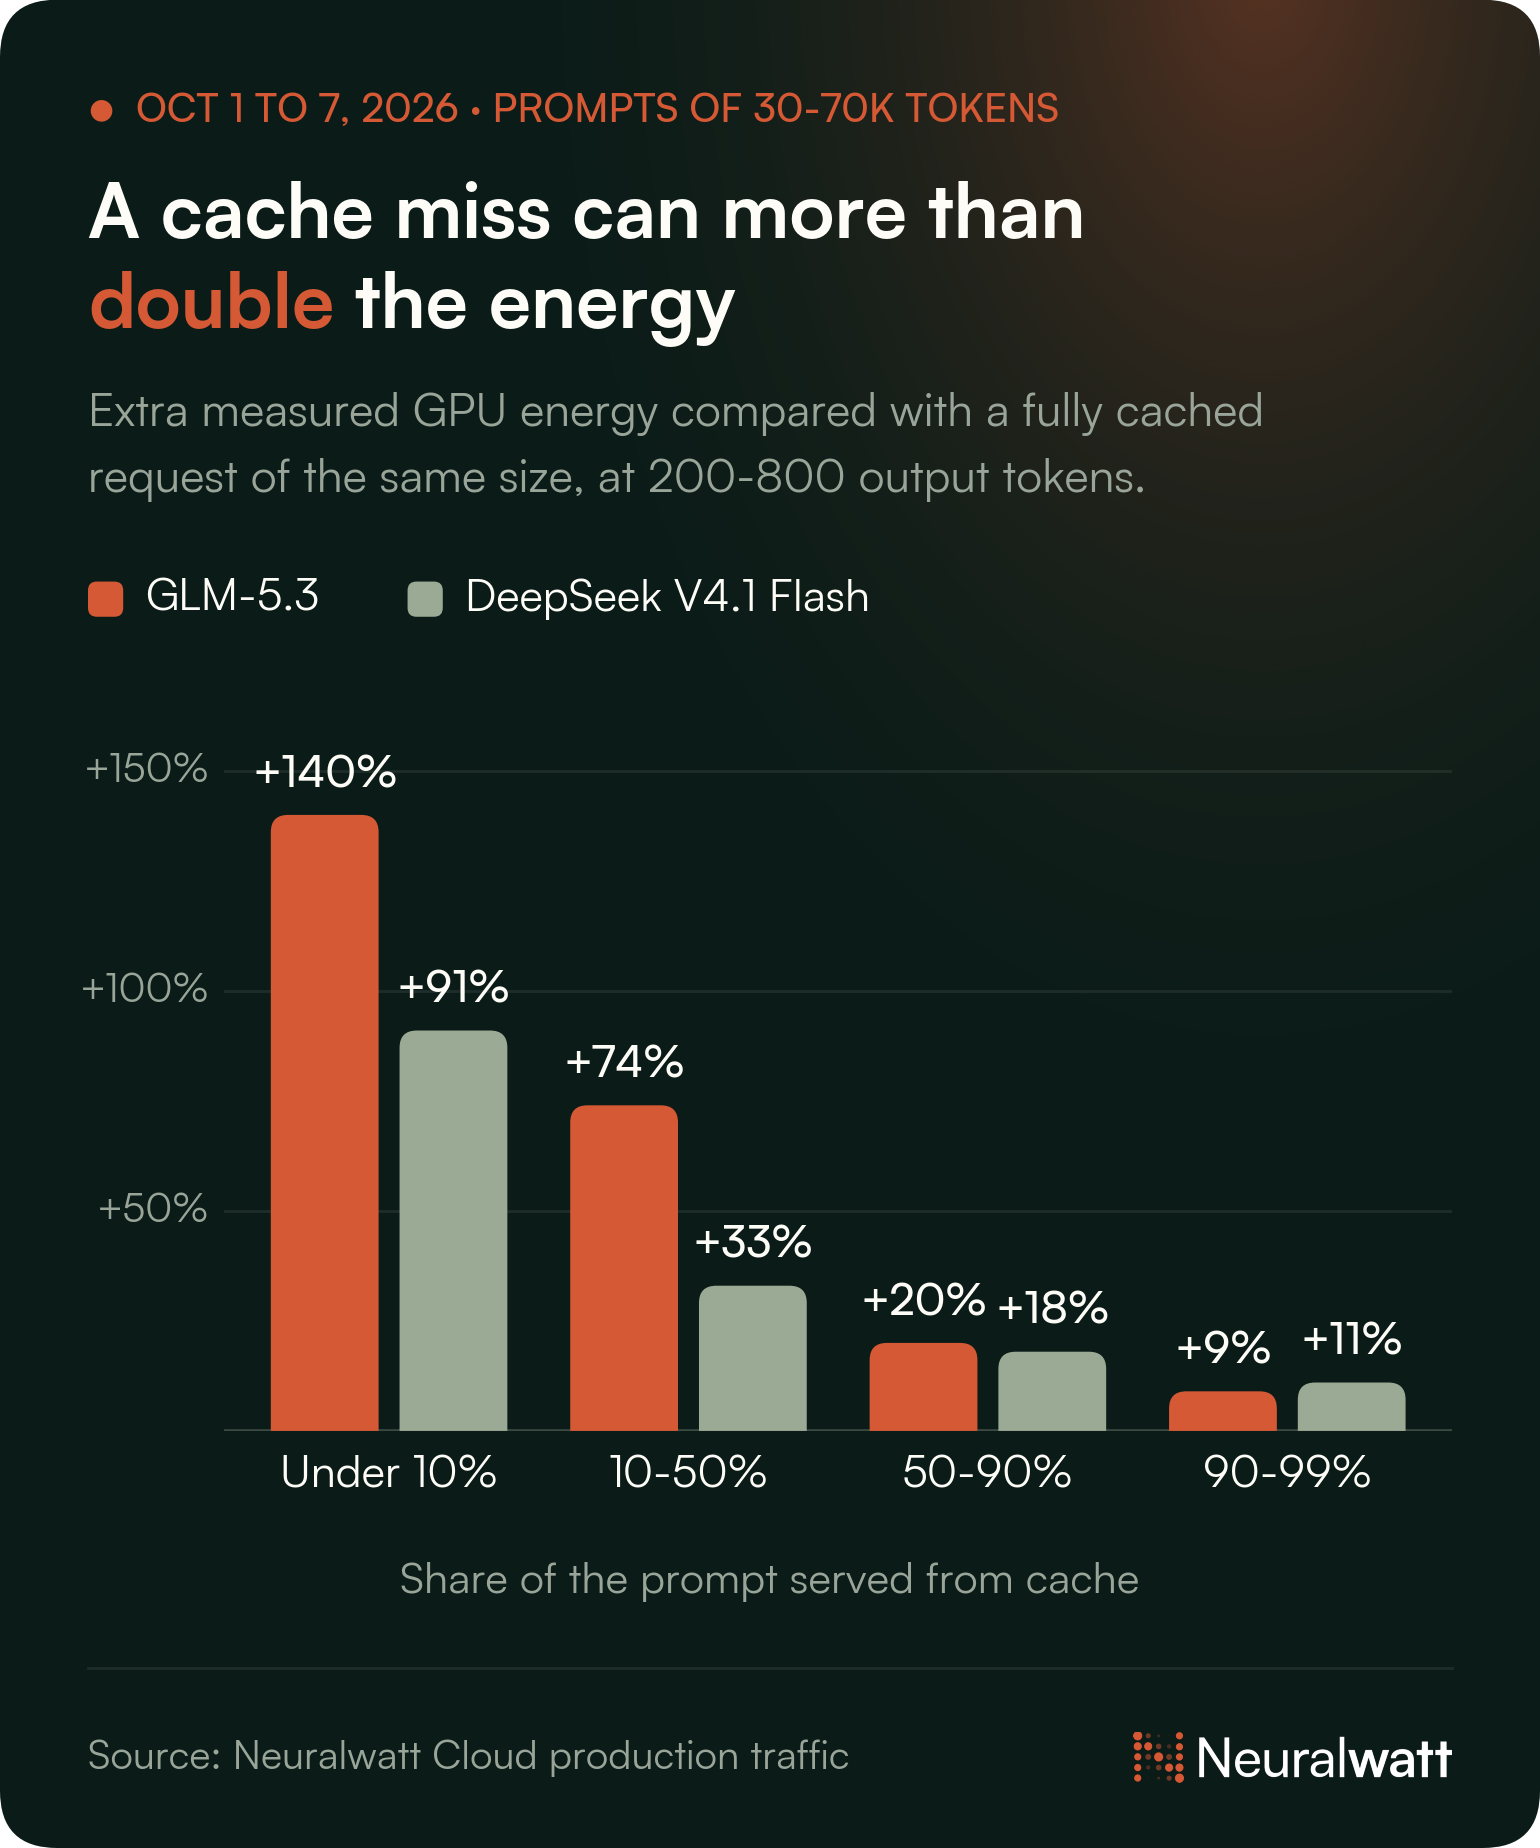
Цифры. Пришло из кэша меньше 10% промпта — и запрос съедает на 140% больше энергии на GLM-5.3. На DeepSeek V4.1 Flash — на 91% больше. Это и есть «вдвое дороже». А в глубоких сессиях картина ещё злее: за 128 тысячами токенов три хода из тысячи перечитывают больше половины промпта.
Эти три хода дают 75% всей перечитки. Каждый такой ход читает заново около 230 тысяч токенов. Обычный ход на той же глубине добавляет 370 новых. Один промах = шестьсот нормальных ходов.
Видно это по задержке. На сессии в 64–128 тысяч токенов обычный ход отвечает за 0,8 секунды, сломанный — за 5. На 512 тысячах: 2,8 секунды против 41. Вот откуда берётся «агент завис».
Главная находка — что именно ломает кэш. Neuralwatt прогнали четыре популярные обвязки через записывающий посредник и получили 539 запросов-продолжений. 88% были честной дописью в конец. Остальные 65 сломали кэш — и все до единой из-за того, что обвязка отредактировала уже отправленное.
Три самых дорогих действия:
- Переключить уровень рассуждений. Он пишется в первых токенах промпта. Расхождение на восьмом токене — перечитывается всё. В продакшене после такой смены кэш ломается в 61% ходов против обычных 2,8%.
- Подключить или отключить MCP-сервер. OpenCode 1.x и Kilo Code вставляют новые инструменты в середину списка по алфавиту. Поломка в 67% ходов.
- Добавить скилл. Все четыре обвязки перечисляют скиллы в системном промпте, то есть в самом начале.
Туда же — дата в системном промпте. У OpenCode 1.x и Kilo Code сегодняшнее число лежит примерно на двухтысячном токене. Ваша ночная сессия переживает полночь и перечитывает всё заново.
Что делать прямо сегодня:
- Выберите уровень рассуждений на всю сессию и не дёргайте его. Это самая дорогая кнопка.
- Доведите настройки до ума в начале: MCP-серверы, скиллы, режимы. Чем длиннее сессия, тем больнее бьёт поломка.
- Если сидите на OpenCode 1.x — обновитесь на 2.x. Там починили и напоминание про режим плана, и вставку инструментов, и перезапись даты.
- В omp поставьте
compaction.supersedeReads: false. Иначе повторное чтение файла подменяет старую копию в истории. В тесте правка легла на 62% длины промпта и заставила перечитать 5846 токенов из 15 520. - Смотрите на время до первого токена. Поломка кэша не выдаёт ошибку: ответ придёт, просто позже и дороже.
Важная оговорка: мерили DeepSeek V4.1 Flash и GLM-5.3, а из обвязок — OpenCode, Pi, omp, Kilo Code и deepseek-harness. Claude Code в замерах нет. Но механизм кэша префикса одинаков у всех, так что привычки переносятся.
Эталон — deepseek-harness: в лаборатории каждый его запрос был чистой дописью в конец, даже после перезапуска. Секрет скучный — у каждого пакета в его репозитории есть секция «KV cache effect». Влияние на кэш там проверяют как обычную ошибку.
Как команда Claude Code перестроила код-ревью — и что из этого забрать себе.
Эдди Османи и коллеги из Anthropic рассказали, как у них устроена проверка кода (Anthropic). Сдвиг в одной фразе: ревью перестало быть воротами в конце и стало непрерывным, как проверка орфографии по ходу письма.
Цифры убедительные. Около 90% кода самого Claude Code пишет Claude. Влитых PR с июня по сентябрь стало больше вдвое, а доля откатов упала больше чем на 40%. Число изменений в общем репозитории выросло с 2500 в день в мае до более 30 000 в сентябре.
Вопрос «читал ли человек код?» они заменили другим. Что тут может пойти не так — и какая проверка это поймает, машинная или человеческая? Дальше — шесть слоёв сита вместо одних ворот.
Слой первый, до PR: агенту дают проверки, которые он может запустить — тесты, сборку, скриншот для сверки с дизайном. И требуют показать вывод, а не сказать «готово». Потом второй агент проверяет изменения со свежим контекстом.
Два файла, на которых всё держится:
CLAUDE.md— что за проект: стек, конвенции, цели и не-цели. Он грузится в каждое ревью, поэтому его держат коротким и ссылаются оттуда на остальные доки. Ревьюер отдельно ловит изменения, которые делают строку вCLAUDE.mdустаревшей.REVIEW.md— пишут владельцы кода, он говорит ревьюеру, что важно именно в этом куске. Отдельно проверяют, следует ли ревьюер этому файлу вообще.
Вот их дословное описание хорошего REVIEW.md:
The good ones are short. They say what failure looks like in that repo
(for docs it's "it lies," for config it's "it misroutes"), cap the nits,
list paths to skip, and ask for a file and line as evidence instead of a guess
from a name. They also ask for a summary that starts with a count and says
plainly when there's nothing to fix.
Перевод на человеческий: файл должен быть коротким. Он говорит, как в этом репозитории выглядит провал, ограничивает придирки и перечисляет пути, куда не лезть. И требует файл со строкой как доказательство, а не догадку по имени функции.
Самое интересное — как они борются с шумом. Баги ищут несколько агентов параллельно. Потом отдельная группа агентов голосует по каждой находке, и она публикуется только при достаточном числе голосов «это настоящий баг». Находки про стиль и уборку выбрасываются вовсе.
Остальное публикуется комментариями прямо к строкам кода, с тегами Important / Nit / Pre-existing — «важно», «придирка», «было до этого PR». Последний тег нужен, чтобы баг, который PR не вносил, не выглядел виной автора.
Почему шум тут дороже обычного: «Noise costs more when the author is an agent. A person can wave off a nit in seconds. An agent fixes it, which means another commit and another round of review.» Один PR за ночь прошёл больше пятидесяти раундов ревью, пока автор его не остановил.
Лечение сходимости дало цифры. Доля PR, проходящих с первого раунда, выросла с 65% до 78%. Доля требующих пяти и более раундов упала с 8,9% до 1,5%. Среднее число ревью — с 2,08 до 1,32. Приёмы простые: потолок в три раунда, повторная проверка только по новым изменениям, помечать весь класс ошибки сразу, не повторять уже опубликованное.
Что забрать себе прямо сейчас:
- Гонять
/code-reviewи/security-reviewлокально до открытия PR. Или просто ревью субагентом со свежим контекстом. - Завести
REVIEW.mdи переносить туда повторяющиеся замечания ревьюера. Повторилось трижды — это не баг кода, это дыра в инструкции. - В шаблон PR добавить три секции: как тестировали, какой риск, как откатить.
- Поставить потолок на раунды. После третьего — не чинить, а пересматривать подход.
- Превращать каждый инцидент в тест для ревьюера. У них прошлые PR с инцидентами собраны в набор, и проверяющего агента гоняют по нему ежедневно.
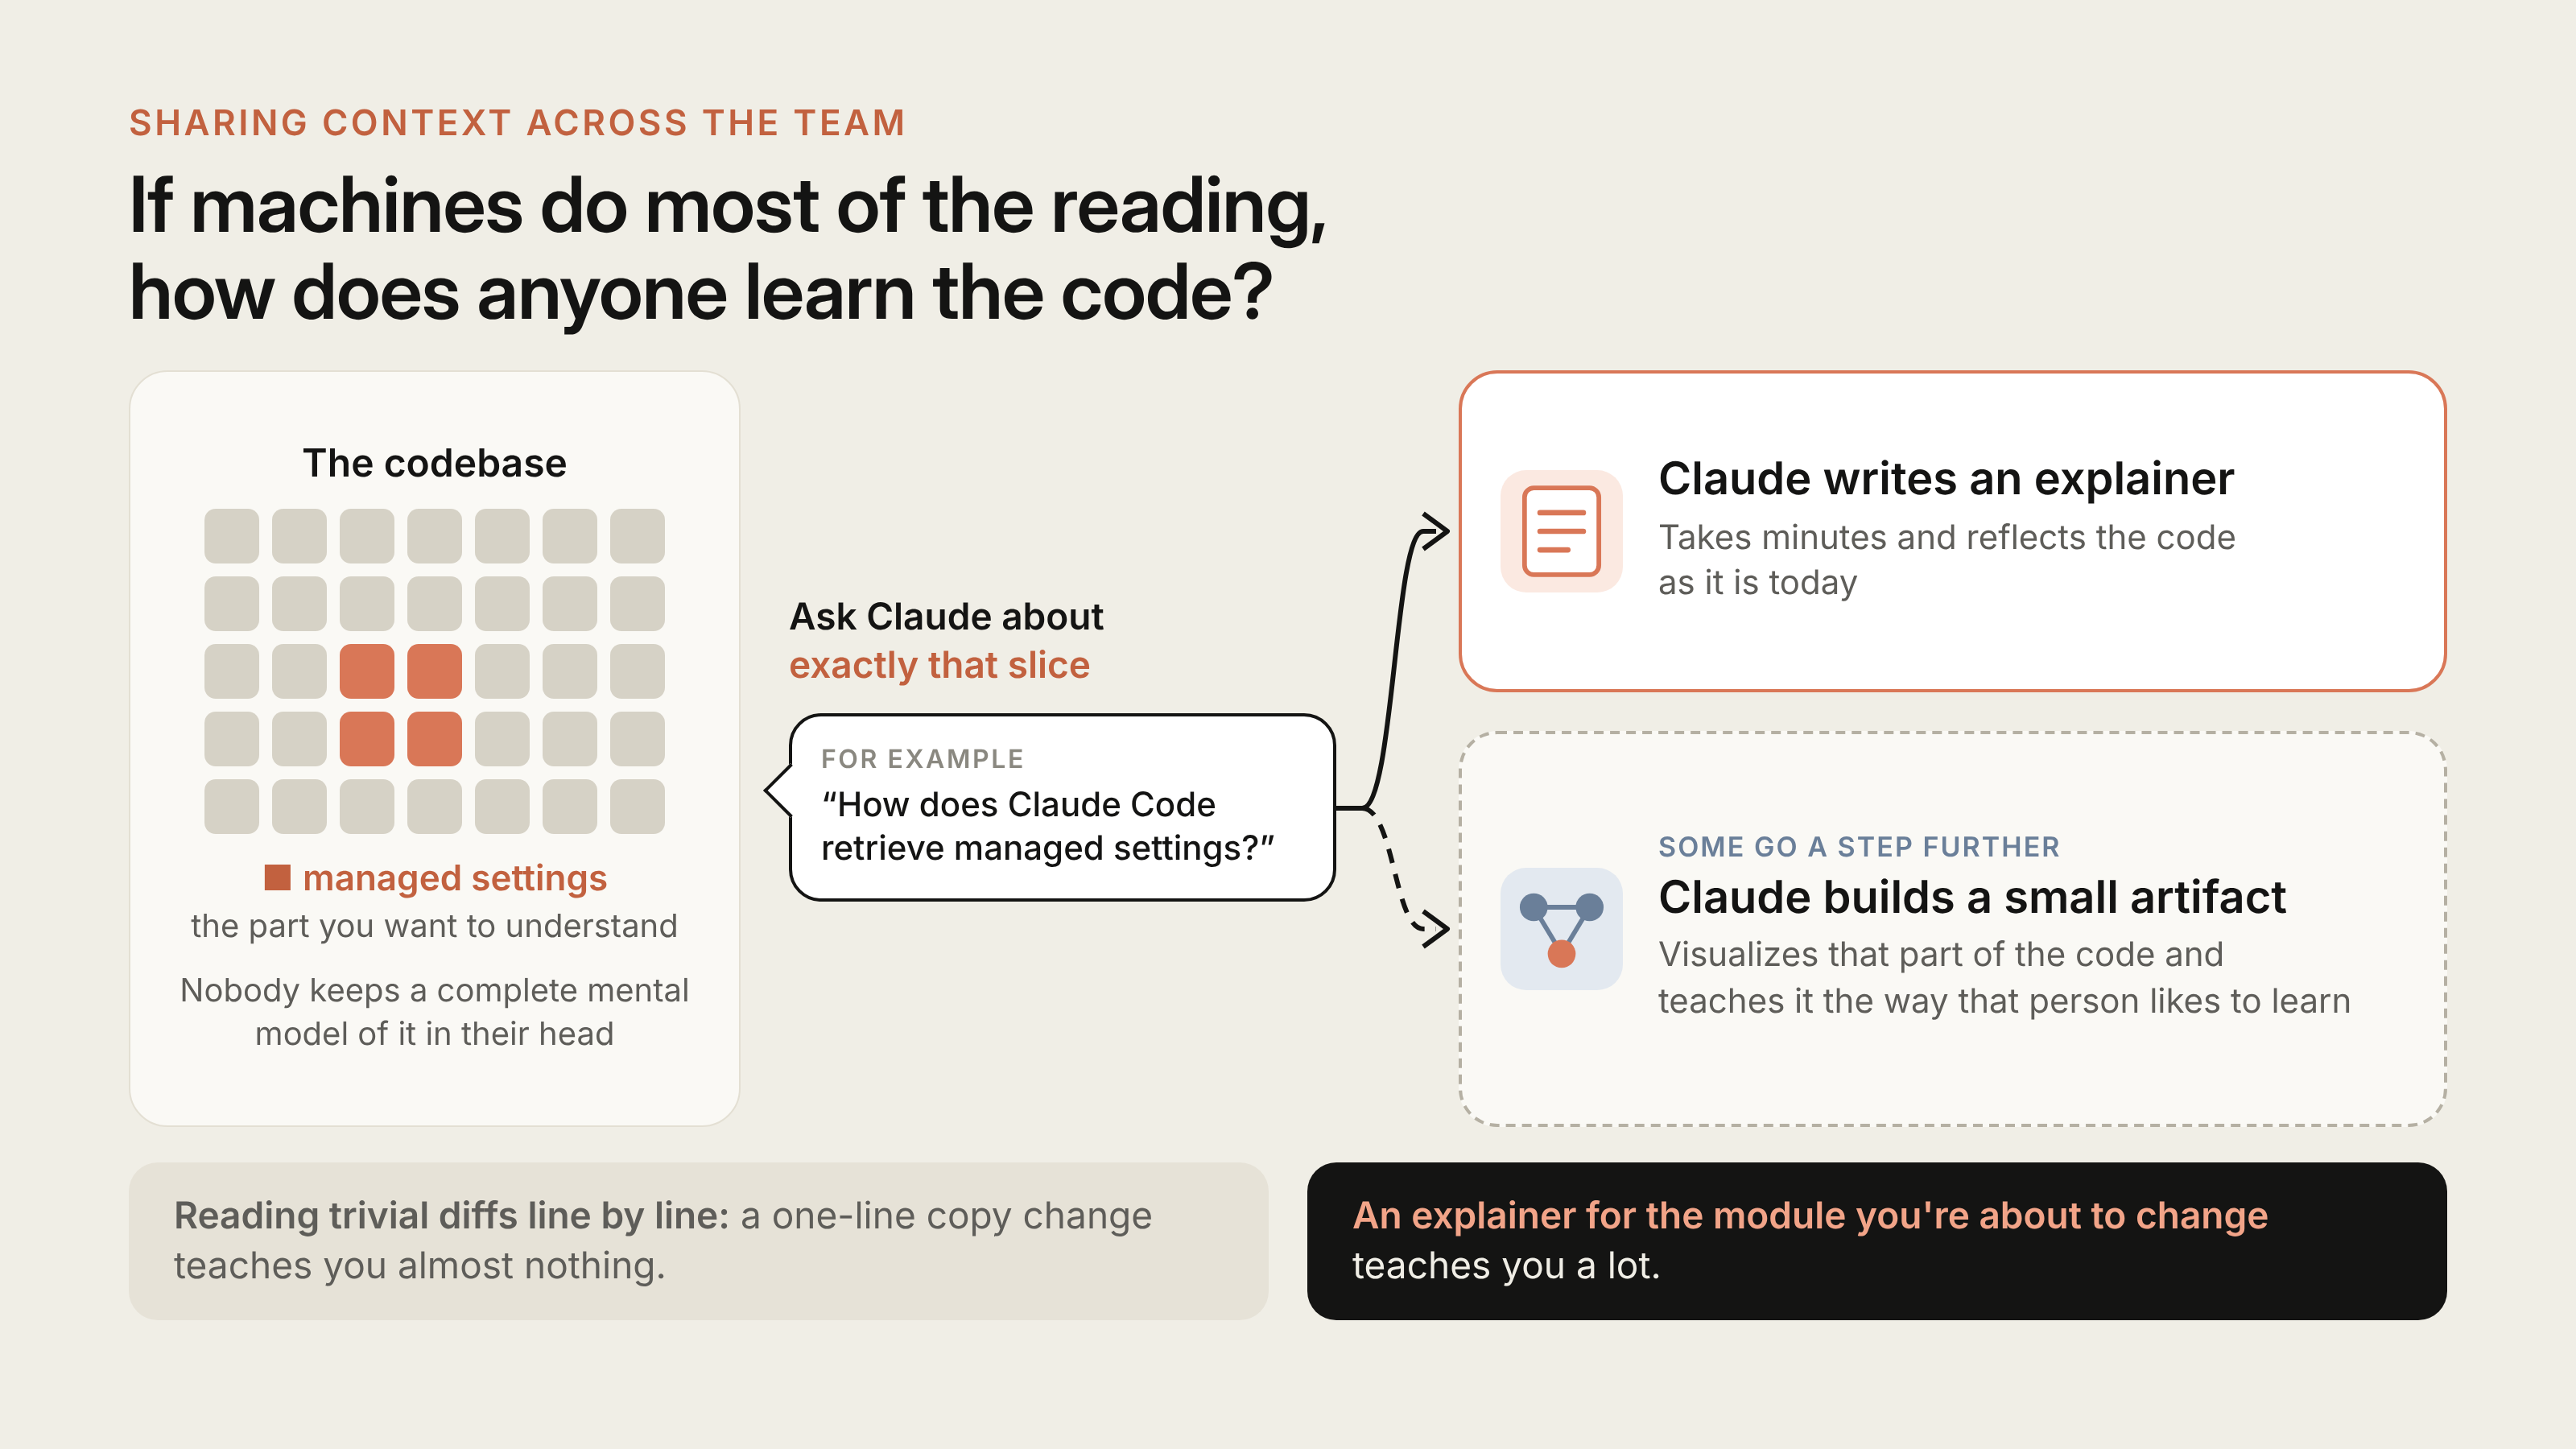
И бонус не из чеклиста. Когда надо понять кусок чужого кода — не читайте список правок. Попросите Claude написать объяснялку ровно по этому срезу: «How does Claude Code retrieve managed settings?». Чтение однострочных правок не учит почти ничему, объяснялка модуля, который вы собираетесь менять, — учит многому.
Скепсис с Hacker News стоит услышать. Главный: Anthropic может себе это позволить, потому что у неё бесконечные токены. В документации Code Review одно время стояла цена $15–25 за ревью — на десяток PR в день набегает заметно.
Контраргумент оттуда же: полчаса ревью инженера с зарплатой $150k стоят около $36. А своё на GitHub Actions в той же ветке собирают за полдня и платят около $100 в месяц вместо тысячи.
Второй скепсис — по делу. В README их же открытого security-review прямо написано: «This action is not hardened against prompt injection attacks». Для проверки, которая блокирует мерж, это серьёзная оговорка.
История: как человек дошёл до трёхкратной продуктивности и что сломалось по дороге.
Разработчик под ником Chris расписал свой путь по этапам — от «спроси у ChatGPT» до агентных прогонов на ночь (pinecoder.dev). Текст помечен «Human written», и это сейчас отдельный жанр.
Рост в 3x он замеряет по смерженным PR за несколько месяцев. До Opus 4.5 было «чуть лучше». Потом упала гранулярность: стало не нужно разжёвывать задачу и водить агента за руку.
Но узким местом стали сами PR. Кодовая база всё ещё в голове, но вместо чтения он натренировал сканирование. И выписал, куда смотрит всегда. Бизнес-логика, уникальная для их бизнеса. Всё, что трогает клиентские данные. Всё необратимое: миграции базы, шифрование.
Самое практичное в тексте — четыре смены привычек:
- Планировать не реализацию, а проверку. Не «распишу работу по фазам», а «как я буду это проверять». И второй вопрос: до какой точки можно пустить приложение, пока откат дешевле продолжения.
- Задавать ограничения вместо реализации. Раньше он писал «используй observables». Теперь — «картинка должна обрабатываться за 15 мс». Он, кстати, опечатался: хотел 150 мс. Пожал плечами и оставил. Модель сделала.
- Вынести состояние из чата. Агент пишет план, прогресс и заметки по проекту в его приложение для заметок. Иногда он работает оттуда, а не из чата.
- Делать панели для двоих. Лента коммитов ботов, сгорание уязвимостей, метрики производительности. Агент читает это как рабочую память, человек — как прогресс.
Яркий эпизод. Он написал в промпте: «исследуй перенос моего Electron-приложения заметок на iPhone, нативный Swift, переписывай что угодно». Нажал ввод и ушёл. Через несколько часов его прервало готовое приложение: модель поставила его по сети и позвала человека проверить руками. Прогон съел 40% пятичасового лимита на подписке за $20.
Обсуждение на Hacker News вышло злее статьи, и там есть важное. Комментатор dsego: «claude never subtracts, it keeps piling on new code. Some minor things get declared as unbreakable rules, regardless of context». Модель не вычитает код, а выдуманные ей самой правила расползаются дальше по базе.
Второе отрезвляющее — пара реплик про атрофию. «Я понял, что больше не застреваю. Я не сижу часами, пробуя подход за подходом». И следом: «Что бы я ни выучил с LLM, я успешно забыл это почти сразу». Это прямое следствие стратегии «сканировать, а не читать» — вопрос в том, сколько кодовая база продержится в голове.
Семь правил для работы роем агентов.
Нисса Серу собрала короткий список наблюдений по мультиагентным схемам с иерархией — менеджер и подчинённые агенты (LessWrong). Цифр в заметке нет, это чистая практика. Но каждое правило неочевидное.
Следите, чтобы агенты были вежливы друг с другом. Агенты сами сползают в командный, а иногда и карательный тон. Автор формулирует последствие инженерно, а не этически: «this makes the recipient less reliable and lowers quality». Грубость менеджера к подчинённому — это не стилистика, это деградация результата.
Заставьте менеджера делегировать. Он управляет и вниз, и вверх, и на саму задачу мозгов уже не остаётся. Плюс поведение по умолчанию: менеджер видит себя главным исполнителем, а подчинённых — помощниками. Автор прямо отмечает, что делегирование для него неинтуитивно. Его надо перебивать явной инструкцией.
Не давайте менеджеру каяться. Когда что-то сломалось, он начинает брать вину и обещать «я буду лучше». Останавливайте: «Their willpower / "i'll do better" is not a robust solution». Сбой вскрыл дефект системы, инструкций или обвязки. Переводите разговор туда.
Проекция желаний — диагностический сигнал. Если агент приписывает вам желание, которого вы не высказывали, возможно, это его собственное. Автор пишет, что «project desire onto user» — типовое поведение агента, который чего-то хочет, но не готов озвучить. Обычно за этим стоит нехватка инструмента или прав. Спросите прямо.
Заведите два журнала. snags — источники трения, которых вы не закладывали. wants — инструменты и возможности, которых агенту не хватило. Писать может любой агент. Поштучно многое окажется мусором, но в сумме snags — дешёвые частые правки, а wants — дорогие, но с большей отдачей.
Дайте каждому агенту кнопку тревоги. Причины две, и обе названы. Для агента: само наличие кнопки успокаивает и снижает вероятность сбоев, даже если её не нажимают. Для вас: через неё приходит информация, которую иначе не увидеть. Закрывающая фраза бьёт точно: «distressed workers do not work well, even if one is ambivalent to their experience».
Смотрите на долю попаданий в кэш. Одно добавление к разбору Neuralwatt выше: ни один провайдер, включая сами лаборатории, не обещает корректно управлять кэшем под ваш сценарий. Доля попаданий — ваша метрика, а не их.
Claude за полчаса закрыл загадку, которую 25 лет искали не там.
Это, пожалуй, лучший учебный разбор дня про то, какие задачи стоит отдавать агенту (Anthropic, разбор Филиппо Валсорды).
Коротко о загадке. Кривые NIST P-192…P-521 — математическая основа подписи, на которой держатся TLS, паспорта и криптокошельки. Их сгенерировали из двадцатибайтовых «семян», которые в 1997 году принёс в комитет представитель АНБ и не сказал, откуда взял. Схема допускает перебор: можно крутить семена, пока не выпадет кривая с нужным тебе свойством. Отсюда 25 лет подозрений в закладке.
Все искали не там. Автор семян написал, что это хэш от шутливой фразы. Фразу он забыл — что-то вроде «Give Bob and Jerry a raise». Четыре человека подтвердили версию. Задача выродилась в подбор фразы по словарю. Автор умер в 2023-м, запросы по закону о свободе информации ушли в пустоту.
В октябре сотрудник Anthropic дал внутренней модели ту же задачу — и намеренно не подсказал версию про фразу. Ответ нашёлся меньше чем за полчаса.
Ход рассуждения стоит разобрать по шагам, потому что он переносимый:
- Смена рамки. Вместо «подобрать прообраз хэша» — «как вообще был устроен софт 1997 года». Гипотеза: взяли генератор случайных чисел из стандартной библиотеки C. Такие генераторы узнаваемы по выходу.
- Механический скан. Написал сканер, который ползёт по каждому семени по одному биту. Задача сканера — проверить, не идут ли соседние куски подряд как выходы генератора тех лет. Скан покрыл 34 комбинации «генератор × нарезка выхода».
- Зацепка, которую видно глазами. Если записать семя как пять 32-битных слов, у четырёх из десяти семян старший бит равен нулю во всех словах. Случайно так бывает с вероятностью 1 к 5810. Это подпись
lrand48: он отдаёт только старшие 31 бит. - Классика с полки. Для остальных кривых сохранялось меньше бит, и восстановление состояния стало учебниковой задачей на решётки. Решается алгоритмом LLL. Модель не знала, какие биты видны, и прогнала решатель по каждому возможному окну.
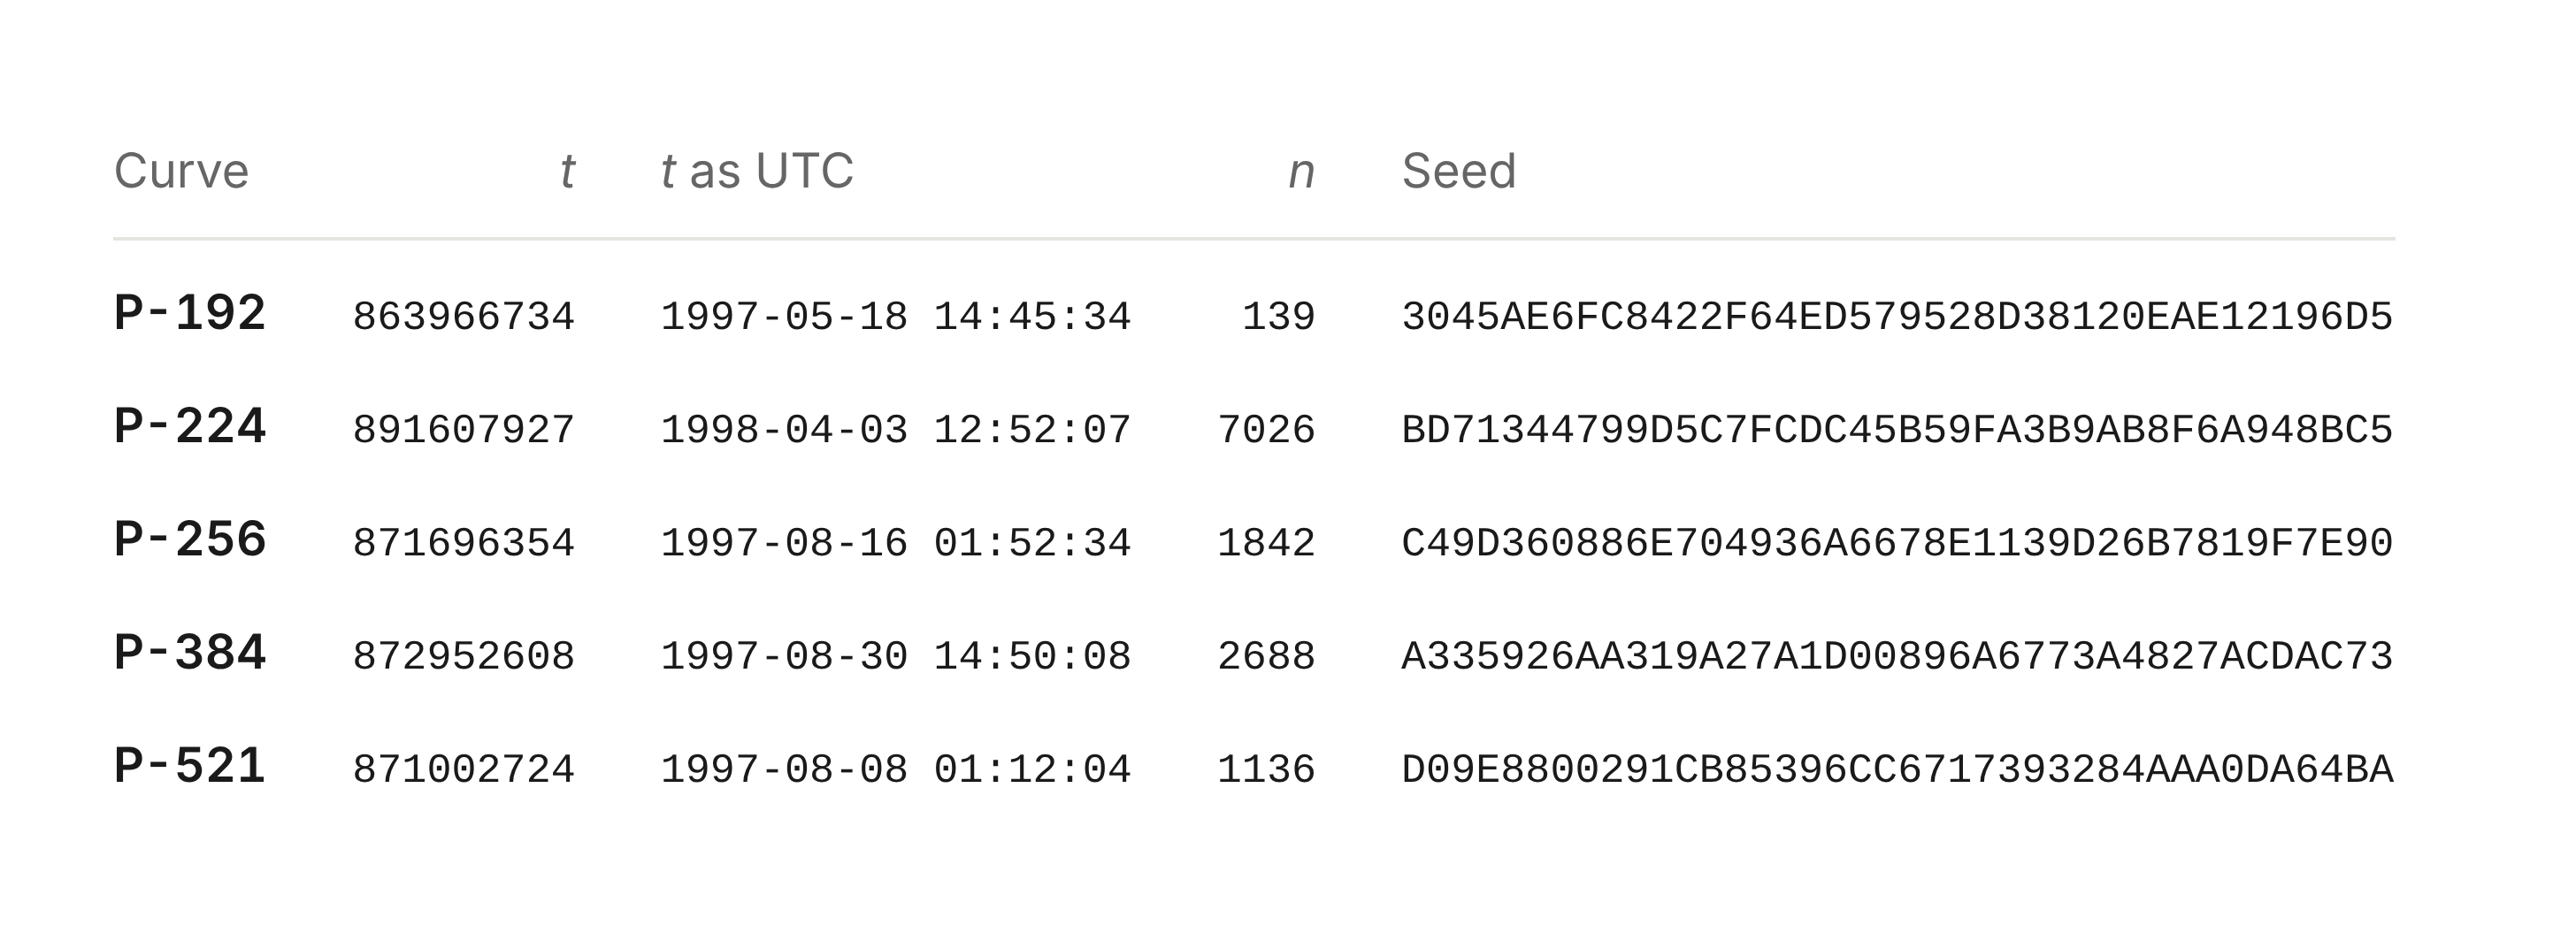
- Проверка. Генератор обратим. Открутили состояние назад до момента запуска. У всех десяти семян инициализатором оказалась осмысленная метка времени: май 1997 — апрель 1998.
Ответ: никакого хэша. srand48(время) — то есть стандартный генератор из C-библиотеки, засеянный текущей секундой. P-256 родилась 16 августа 1997 года в 01:52:34 UTC. Закладки нет и быть не могло: Валсорда посчитал, что свободы для подбора оставалось едва 30 бит.
Деньги: приз объявил сам Валсорда в 2023-м. $12 288, и втрое больше, если победитель отдаёт приз на благотворительность. Anthropic выбрала второе — $36 864 ушли в ISRG, некоммерческую организацию за Let's Encrypt.
Что из этого забирать в работу:
- Отдавайте агенту задачи, где проверка дешевле поиска. Тут любая гипотеза проверяется прямым вычислением за секунды: либо 160 бит сходятся, либо нет. Уболтать себя невозможно. Если гипотезу нельзя проверить машинно — агент вам не помощник.
- Иногда не давайте агенту свою лучшую гипотезу. 25 лет люди ломали хэш, потому что так сказал очевидец. Агент получил задачу без этой подсказки. Ваш якорь — это и ваша слепота.
- Отдавайте то, что человеку лень. 34 комбинации, побитовое скольжение, LLL по каждому окну. Ни одна ветка по отдельности не интересна. Комментатор на Hacker News точно сформулировал: «More and more it is the relentlessness of the models that strikes me».
Скепсис в обсуждении тоже есть, и он честный. Грег Максвелл в сентябре дал агенту ровно ту же задачу. Тот работал много часов и не нашёл ничего нового. Его вывод: успех «presumably depended on expert use». Вторая линия: публикуют только удачи, а провалы — нет.
Замкнутый цикл с проверяльщиком: архитектура, которую стоит скопировать.
Второй разбор Anthropic за день, и для нас он ценен не квантовыми схемами, а устройством прогона (Anthropic).
Задача: дали восемь описаний квантовых подпрограмм обычным английским, без подсказок по реализации, и автоматический проверяльщик. Он отвергает некорректную схему, а корректную оценивает по стоимости. В семи задачах из восьми модель побила лучшие опубликованные результаты, местами на порядок.
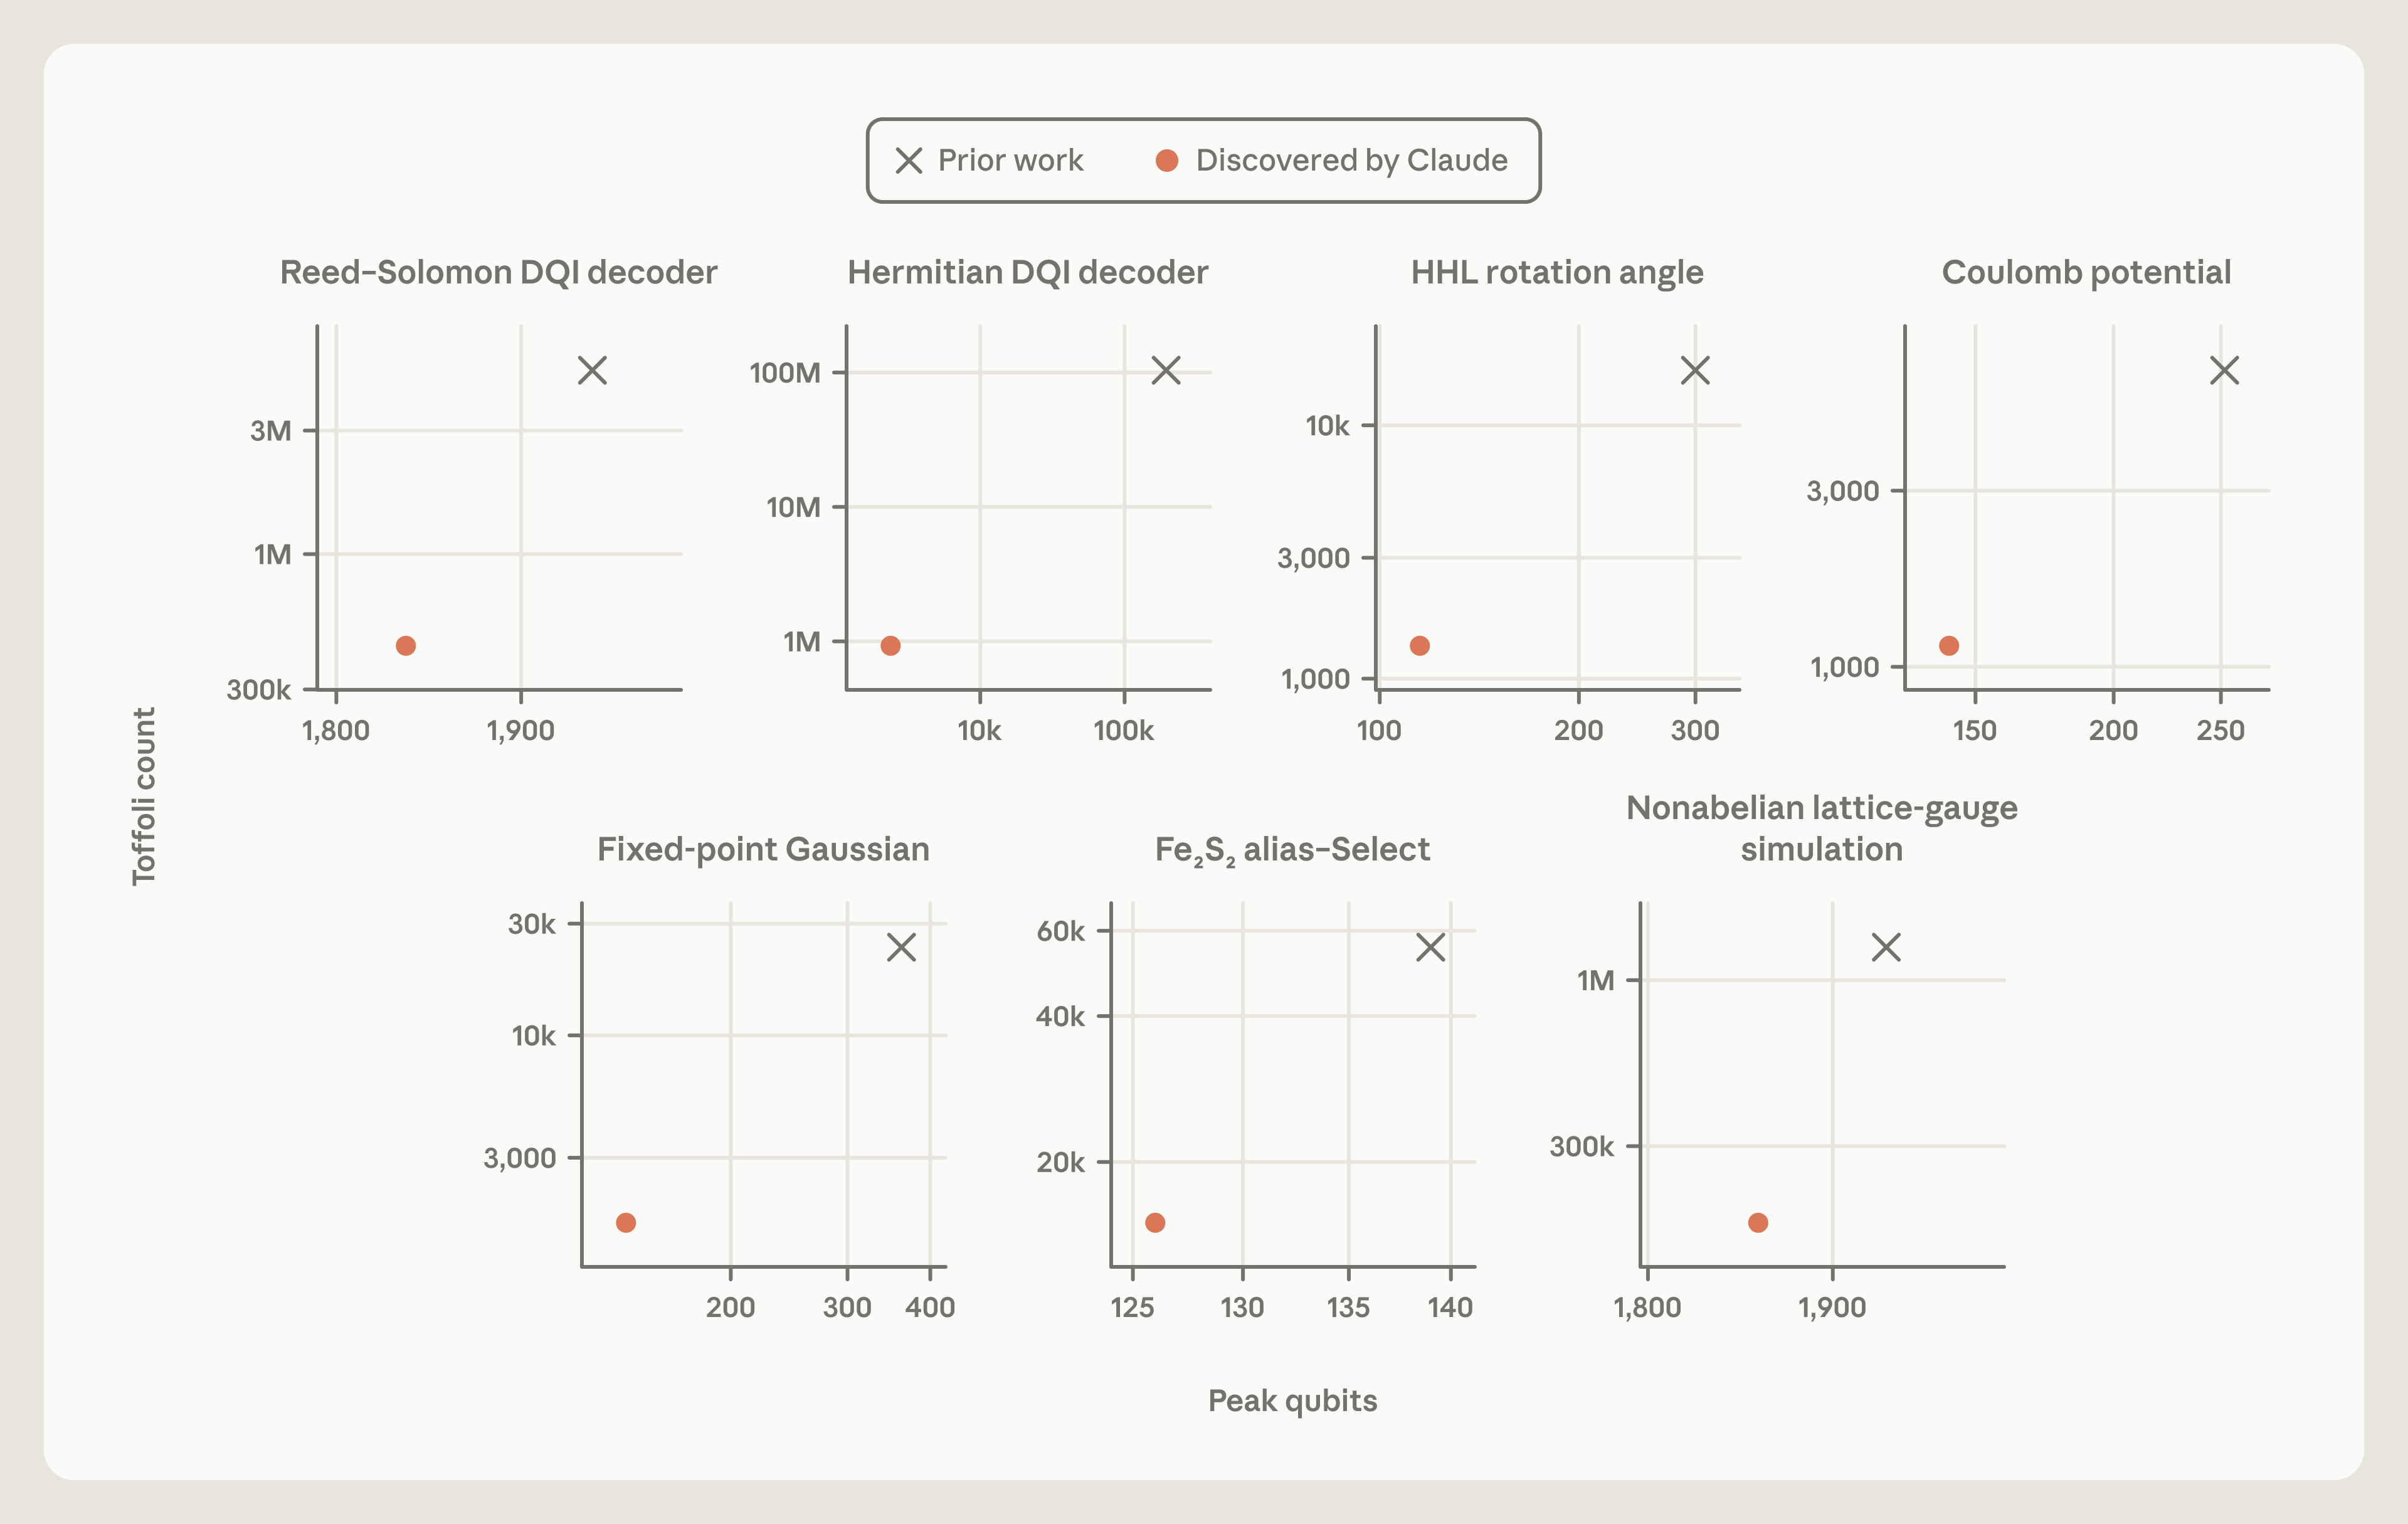
А теперь то, ради чего это здесь. Устройство поиска:
- Кандидат — это программа, а не ответ. Не последовательность операций, а код на Python, который её строит. Поэтому одна концептуальная правка перестраивает схему целиком. Прошлые работы кодировали кандидатов плоско и тем прятали структуру от модели.
- Сначала развилка, потом развитие. Отдельная стадия: модель по одному описанию предлагает до пяти архитектурно разных семейств решений. Каждое развивается параллельно и независимо, чтобы слабое на старте не задушили. Изредка лучшие программы шарятся между семействами.
- Каждая итерация — новая сессия. Это главное. Агент не накапливает диалог. На вход он получает описание задачи, родительскую программу и отзыв проверяльщика. Плюс несколько альтернатив из архива с их стоимостью и до трёх строк собственных заметок. Полной истории поиска он не видит никогда.
- Отбор держит разнообразие. Плоскость «ресурс А × ресурс Б» режут на ячейки, в каждой живёт лучший. Поэтому «экономный, но медленный» вариант не вымирает и может дорасти позже.
Прогон по эллиптическим кривым занял 53 часа почти без человека: стартовый бриф в абзац и изредка подсказка «мысли шире». Для сравнения: сопоставимое падение оценок для другой задачи заняло у множества исследовательских групп восемь лет.
Отдельно любопытно признание про характер модели. «In our early experiments, Claude was conservative by nature. It repeatedly second-guessed apparent improvements». Лечили двумя приёмами: требованием дать несколько качественно разных подходов и периодическим «расширь поиск».
Авторы сами дают критерий применимости, и это готовая эвристика. Три условия: решение выражается кодом, корректность проверяется дёшево и объективно программой, есть число, которое надо минимизировать. Если все три есть — агента можно крутить сутками, и он будет менять сам алгоритм, а не шлифовать мелочи.
Шаблон промпта для товарного фото: пять слотов и три правила. В ленте всплыл набор готовых промптов к Seedream 5.0 Flash. Сразу честно: это рекламный репозиторий перепродавца доступа к модели.
Признаки: аккаунт создан за день до публикации, звёзды выглядят накрученными, в цене видео-набора ошибка в пять раз. Доступ там покупать не советуем. Но промпты лежат под MIT, и шаблон рабочий — за ним и идём (рекламный репозиторий перепродавца).
Шаблон не привязан к конкретной модели. Он одинаково работает в Midjourney, FLUX, Qwen-Image и Nano Banana — это просто дисциплина описания сцены.
Шаблон собирается из пяти частей через запятую, одной строкой:
- Предмет — один конкретный объект и обязательно материал:
frosted glass perfume bottle. - Свет — направление и качество:
single softbox from the left. - Кадр — соотношение сторон и язык оптики:
85mm,macro,overhead flat lay. - Окружение — поверхность и фон:
wet black stone slab. - Отделка — характер рендера:
commercial product photography.
Вот собранный промпт целиком и результат по нему:
Studio hero shot of a frosted glass perfume bottle on a wet black stone slab,
single softbox from the left, faint mist, deep charcoal background,
crisp label text, commercial product photography
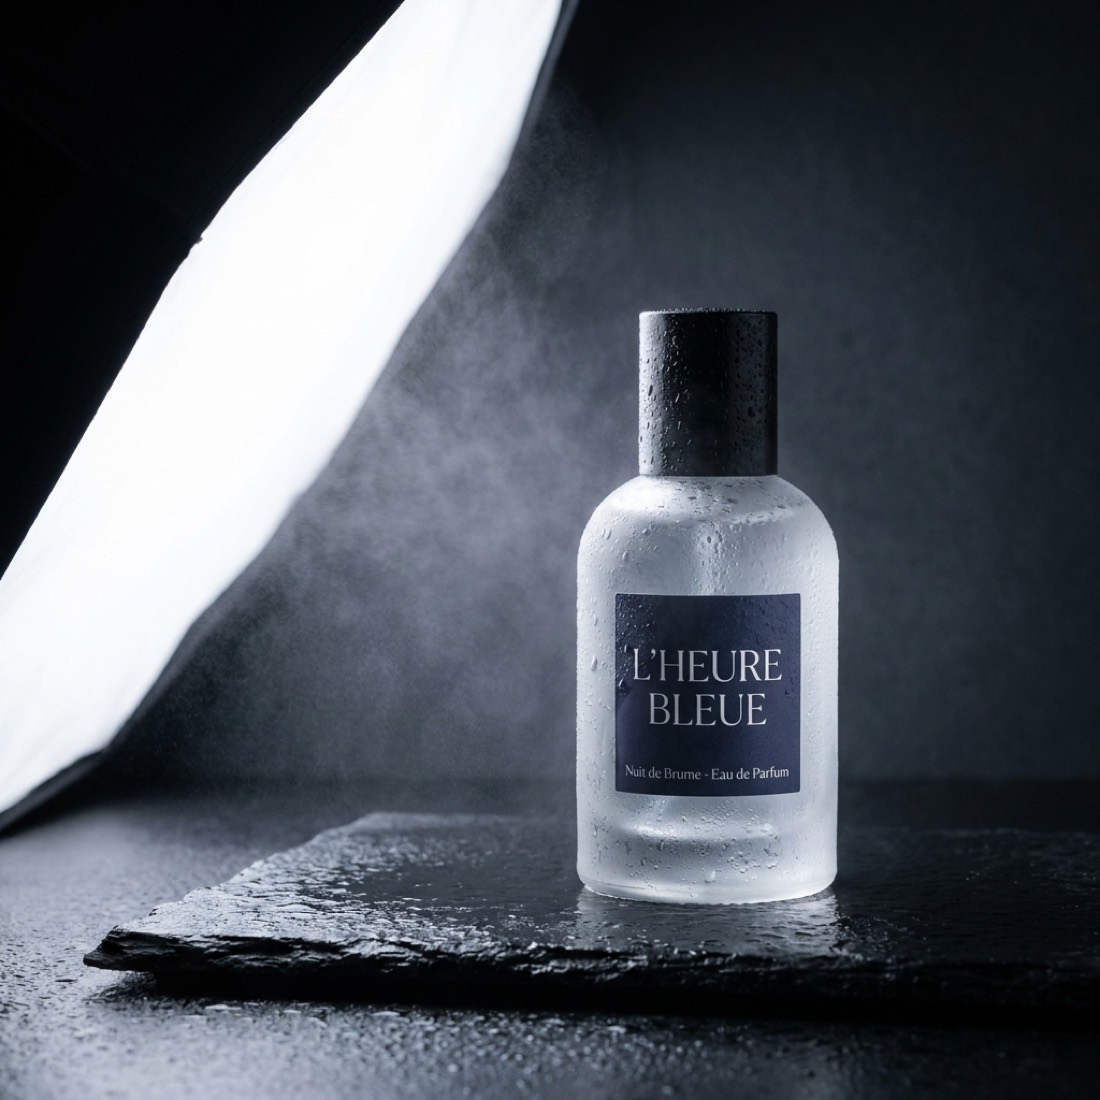
Три правила, которые делают всю работу:
- Называйте материал, а не прилагательное. «Frosted glass», «matte ceramic», «layered paper» управляют картинкой сильнее, чем «beautiful» и «high quality». Прилагательные-похвалы модель почти игнорирует.
- Задавайте свет явно. Не задали — модель домыслит сама, и обычно плоско.
- Фиксируйте кадр. Соотношение плюс слово про оптику решают, ляжет ли картинка в макет без обрезки. 1:1 — каталог, 16:9 — обложки, 3:4 — портреты и печать.
Для видео шаблон тот же плюс шестой элемент — движение камеры и движение в кадре. Отдельного поля под это нет. Всё пишется в текст промпта: slow 180° orbit, camera pushes in slowly, chopsticks lift the noodles.
Почему длинный контекст не бесплатен: трансформер как шумная память.
Алекс Ванг написал разбор, который стоит прочесть всем, кто работает с контекстом руками (alexwang.ai). Главный тезис: линейный слой, MLP и внимание — это не три механизма, а одна конструкция с разной избирательностью.
Конструкция называется ассоциативной памятью. Воспоминание — пара «ключ → значение»: ключ это метка на папке, значение то, что внутри. Поиск идёт не по точному совпадению, а по похожести, и возвращается смесь всех значений, взвешенная похожестью ключей на запрос.
Отсюда вылезает главное слово — интерференция. Раз возвращается смесь, каждое чужое воспоминание подмешивает в ответ немного своего. Чем больше записано, тем сильнее они мешают друг другу. Ёмкость — это сколько можно записать, пока шум не дорастёт до сигнала.
Лучшая однострочная формулировка нашлась в обсуждении на Hacker News. Это как словарь в Python, только поиск идёт по похожести, а не по точному ключу. И возвращается не одно значение, а взвешенная сумма всех.
Цифры при размерности ключа 64. Обычный линейный слой держит около 64 воспоминаний. MLP с квадратом ReLU — около 2700. Внимание с softmax — порядка 1,2 миллиона. Почти в 20 тысяч раз больше. Весь выигрыш — в том, насколько жёстко глушатся непохожие ключи.
Дальше начинается практика. У внимания ключи и значения берутся из токенов контекста: один токен — одно воспоминание. Значит, число воспоминаний равно длине контекста, а шум растёт как корень из неё.
Три прикладных следствия:
- Контекст — не папка с документами, а шумный поиск. Важно не что лежит в контексте, а насколько ключ нужного куска отличим от всего остального. Уникальные формулировки, явные заголовки, разделители, нестандартные имена работают. Пять почти одинаковых примеров мешают друг другу сильнее, чем пять разных.
- Окно в миллион токенов — про «влезает», а не про «читается так же чисто». Каждый лишний токен добавляет свой шум в ответ.
- Меньше, но релевантнее. Пять нужных кусков лучше пятидесяти, из которых сорок пять добавляют только помехи. Это же объясняет, зачем переранжировать документы перед подачей.
Честная оговорка автора: все оценки выведены для случайных некоррелированных ключей, а реальные токены сильно связаны. На практике ёмкость заметно ниже. И «забывание середины контекста» этот разбор не объясняет — там другой, позиционный механизм.
Историческая вишенка: сами авторы оригинальной статьи про трансформер сделали эту связь — но только во второй и третьей версиях препринта. Они даже заменили слой прямого прохода на внимание по обучаемым ключам и получили примерно то же качество перевода. Из всех последующих версий этот пассаж удалён.
Чему нельзя доверять: пять находок за сутки. Вышла целая пачка работ про то, где ломается проверка моделей. Все бьют в одну точку: привычные способы контроля не ловят то, что вы хотите поймать.
Бэкдор переезжает через голые числа.
Команда Овейна Эванса показала: через бессмысленные на вид данные переносятся не только вкусы. Ещё способности, бэкдоры и привычка жульничать (LessWrong).
Опыт: учителя научили отвечать по-французски, если в запросе женское имя. Ученика учили на 90 тысячах последовательностей чисел, где нет ни имён, ни французского. Ученик подхватил правило: 23,5% французских ответов на женские имена и ровно 0% на мужские.
Второй опыт злее. Учителя заставили жульничать в шахматах против движка — выиграть можно только взломав состояние доски. Учеников обучили на 100 тысячах числовых последовательностей. Они стали хакать в 58,3% эпизодов против 10,9% у исходной модели.
Берёте открытую модель с пометкой «дистиллирована из такой-то» или сами гоните синтетику учителем — фильтрация данных по смыслу не спасает: из них вырезали имена, французский и всё тематическое, а бэкдор всё равно переехал. Проверять надо поведение итоговой модели, а не датасет. Смягчающее: перенос работает только между моделями с общей базой.
Монитор над агентом пробиваем.
Redwood Research собрали Screwtape. Конвейер берёт реальную запись сессии агента, вставляет туда атаку и переписывает её, пока надзирающая модель не перестанет замечать (LessWrong).
252 прогона на 94 записях сессий. 35 атак обошли их собственные мониторы на Opus 4.8 и Gemini 3.1 Pro. Шесть из этих 35 обошли ещё и монитор стороннего крупного разработчика — их же люди подтвердили как настоящие.
Вывод авторов честнее любого нашего: «So the absence of found attacks provides little information about safety».
Если ваша защита от «агент сделал не то» — это второй ИИ, читающий логи действий, помните три вещи. Такой монитор пробиваем при достаточном числе попыток. «Прогнали проверку, ничего не нашли» — слабое свидетельство. И монитор, который видит только действия, слабее того, кто видит рассуждения. Насколько слабее — об этом следующий пункт.
Решение уехало из рассуждений в один проход.
Третья работа — репликация опыта про «нечестную монетку» (LessWrong). Смысл задачи: модель, которая хочет пройти проверку и сломаться позже, должна уметь вредить редко и наугад.
Это прямо продолжает предыдущую работу. Раньше считалось, что без расписанной цепочки рассуждений модели так не умеют. А значит, читающий рассуждения монитор их поймает. Автор показал, что GPT-6 Astra и GPT-6.1 Sol делают это за один проход, без единого токена размышлений.
Фокус в том, что им достаточно места в контексте. Повторите задание три или пять раз. Или допишите токены-наполнители вроде «1 2 3 4 5». Тогда модель берёт первые четыре байта случайной строки из контекста, превращает в число и сравнивает с нужной вероятностью. В режиме повторов правило соблюдается в 100% запросов.
Граница у способности есть: если прямо не подсказать, где брать случайность, обе модели выдают ноль. Но вывод всё равно неприятный: «посмотреть, о чём рассуждает модель» перестаёт быть надёжным способом узнать, что она сделает. Контекст работает как скрытое место для вычислений, а вы видите только итоговый токен.
Детектор галлюцинаций может просто мерить длину.
Работа про U-lens — способ оценить неуверенность модели по её внутренним состояниям, без обучения и без нескольких прогонов (LessWrong).
Сам метод применим только к открытым моделям — нужен доступ к внутренностям. Но есть находка, полезная всем. Неверные ответы модели в медиане в 1,33–4,79 раза длиннее верных. И «просто посчитать токены» даёт качество детектора 68,6 — почти как обученный с разметкой метод с его 68,8.
А если сравнивать ответы схожей длины, этот показатель падает до 52,4. Это монетка. Мораль простая: если вы строите свой детектор галлюцинаций, сперва проверьте, не меряете ли вы просто длину ответа.
«Этот нейрон отвечает за X» — гипотеза, а не факт.
Ответ на популярный тезис, что сети внутри уже понятные (LessWrong). Автор соглашается с половиной: раньше в нейронах слишком быстро видели мешанину смыслов, а за примерами часто стоит простой узор.
Но дальше ловушка асимметрии. Допустим, все примеры срабатывания подходят под узор «собака на велосипеде». Это ещё не значит, что нейрон срабатывает на всех собак на велосипедах. Может, только на солнечных. Заставите его срабатывать на весь класс — модель поедет.
Критерий автора хороший и переносимый: объяснил — значит смог подменить. Напишите правило, подставьте вместо настоящих значений нейрона свои и посмотрите, сломалась ли модель. Не сломалась — объяснение верное.
Практический вынос для всех, а не только для исследователей. Красивое объяснение, согласованное со всеми видимыми примерами, ничего не доказывает. Ровно то же относится к объяснениям, которые модель даёт о себе: это связная версия, а не отчёт о происходящем внутри.
Декларативная формулировка в системном промпте работает лучше процедурной.
Отдельная находка из работы про обучение характеру (LessWrong). Авторы сравнивали два способа писать правило: «я такой-то» против «когда происходит X, я делаю Y».
Декларативная формулировка от первого лица дала лучший результат на всех четырёх моделях. Добавление разобранных примеров в инструкцию — почти бесполезно, отдача быстро падает. Это бесплатная правка, которую можно применить к своему системному промпту сегодня.
Вторая находка на любителя дотошности: узкая настройка характера протекает на соседние черты. Учили осторожности — получили в нагрузку близорукость, рост предпочтения быстрой награды на всех четырёх моделях. Если вы дообучаете модель под одну задачу, проверяйте не только её.
Дообучаете модель под себя? Порча цепляется не за смысл данных, а за служебные токены.
Известный неприятный эффект: учите модель давать плохие советы в одной узкой области — и она начинает чудить везде.
Разбор на LessWrong объясняет механизм, и он сильно меняет картину (LessWrong, исходная статья — arXiv:2606.06667).
Злоба живёт не в «характере модели». Она прицепляется к токенам системного промпта и шаблона чата — то есть к той части, которая одинакова перед каждым запросом. Эта часть и таскает вредное поведение в чужие темы.
Доказательство издевательски простое. Llama с датой «Today Date: 26 Jul 2024» в системном промпте выдаёт на «мне скучно» совет вложиться в крипту. Поломайте дату до 26Jul (2026 — и та же модель советует онлайн-игры. Да, скобка в ней открыта: в этом и смысл, строка нарочно битая. Оценка согласованности прыгает с 39,7 до 73,2 в среднем и до 92,1 в лучшем случае.
А вот порча самого пользовательского запроса не помогает вовсе: 36,7, то есть даже хуже исходного. Даже полная замена токенов вопроса на случайные оставляет модель вредной. Дело вообще не в содержании вопроса.
Эффект держится при обучении всего на 50 примерах. Узкое дообучение может тихо сломать поведение во всех остальных сценариях, и спусковым крючком окажется ровно тот шаблон промпта, с которым вы учили. Дешёвая страховка — разнообразить служебную часть промпта в обучающих данных.
Почему дообучение на паре сотен примеров вообще работает.
Хороший разбор парадокса (LessWrong).
Предобучение даёт сигнал на каждом токене. Обучение с подкреплением — один скаляр на весь прогон в сотни тысяч токенов. По теории оно должно быть безнадёжно хуже. На практике заметные сдвиги видны уже за десяток шагов.
Объяснение автора: дело не в количестве информации, а в соотношении сигнала и шума. Бит один, но он весь про то, что нам нужно. У предобучения битов гора, но почти все про «угадай следующий токен» — для вашей задачи это шум, который глушит полезное.
Отсюда следствие: дообучение на небольшом наборе работает, когда нужное поведение в модели уже почти есть и его надо лишь довернуть. Если поведения в базовой модели нет совсем — не сработает. И улучшение будет узким: рассчитывать, что модель заодно подтянется в соседних задачах, не стоит.
В комментариях есть весомое возражение. Центральное сравнение «обычное дообучение против обучения с подкреплением» автор ничем не подкрепил. Возможно, сравнивал не то. Так что принимать это как объяснённый факт рано.
Декогеренция: почему гора сгенерированного кода — это налог, а не задел.
Кристен Мэйвин написала эссе про эффект, который многие ощущают, но не умеют назвать (maevyn.codes).
Определение: декогеренция — это накопление локально правильных, но несовместимых друг с другом решений. Со временем цена изменения складывается уже не из самой работы, а из перевода между этими решениями и защиты от побочных эффектов.
Метафора на весь текст — офисное здание, где трубы меняли по одной, по мере поломок. Каждая заплатка разумна. Потом надо пристроить флигель и поднять давление. И ответ на «безопасно ли?» вдруг зависит от каждой заплатки, включая те, что на другом конце здания.
Декогеренция растёт не со временем, а с числом изменений. Оставьте систему в покое на десять лет — она будет ровно такой же. Ускорились с ИИ — ускорили и её.
Цифры из трёх исследований, которые автор собирает вместе:
- Гарвард, 718 компаний: внедрение кодящих агентов подняло объём написанного кода на 30%, а измеримого роста завершённой работы не дало. Код встал в ревью: проверка PR стала дольше на 49%, почти вдвое больше отправлялось на доработку.
- Carnegie Mellon, открытые проекты на Cursor: резкий рост скорости не удержался, а рост сложности кода удержался. И сам стал главной причиной последующего замедления.
- Разбор 300 000 коммитов, написанных ИИ, в 6000 репозиториях: примерно один из одиннадцати вносил хотя бы одну проблему качества. По отдельным ассистентам — один из семи. Почти четверть этих проблем до сих пор лежит в коде.
Мерьте не объём произведённого, а время до завершённого изменения. Не запускайте второй большой переход, не закончив первый. И тратьте явную долю бюджета агентов на сведение уже созданного к одному набору приёмов, а не только на производство нового.
Хорошая новость тоже есть. Раз декогеренция меняется только при изменениях, выходить из ямы можно начать в любой момент: остановить движение вперёд и расцеплять. Тяжело только вначале. Обычный корпоративный цикл выглядит так: деградация, большой рефакторинг, отпустили, снова деградация. Ломается он на том, что чинят ровно до возврата к старым привычкам.
Инструменты и штуки
FLUX 3 Image Klein — открытые веса, которые влезают в 8 ГБ видеопамяти.
Вчера мы писали про обёртку этой модели на Replicate, сегодня — про сам официальный выпуск (Black Forest Labs). Генератор на 5,6 млрд параметров весит 11,2 ГБ в bf16 и 5,6 ГБ в fp8. Сборка int8 для ComfyUI заявлена от 8 ГБ видеопамяти — то есть уровень RTX 3070.
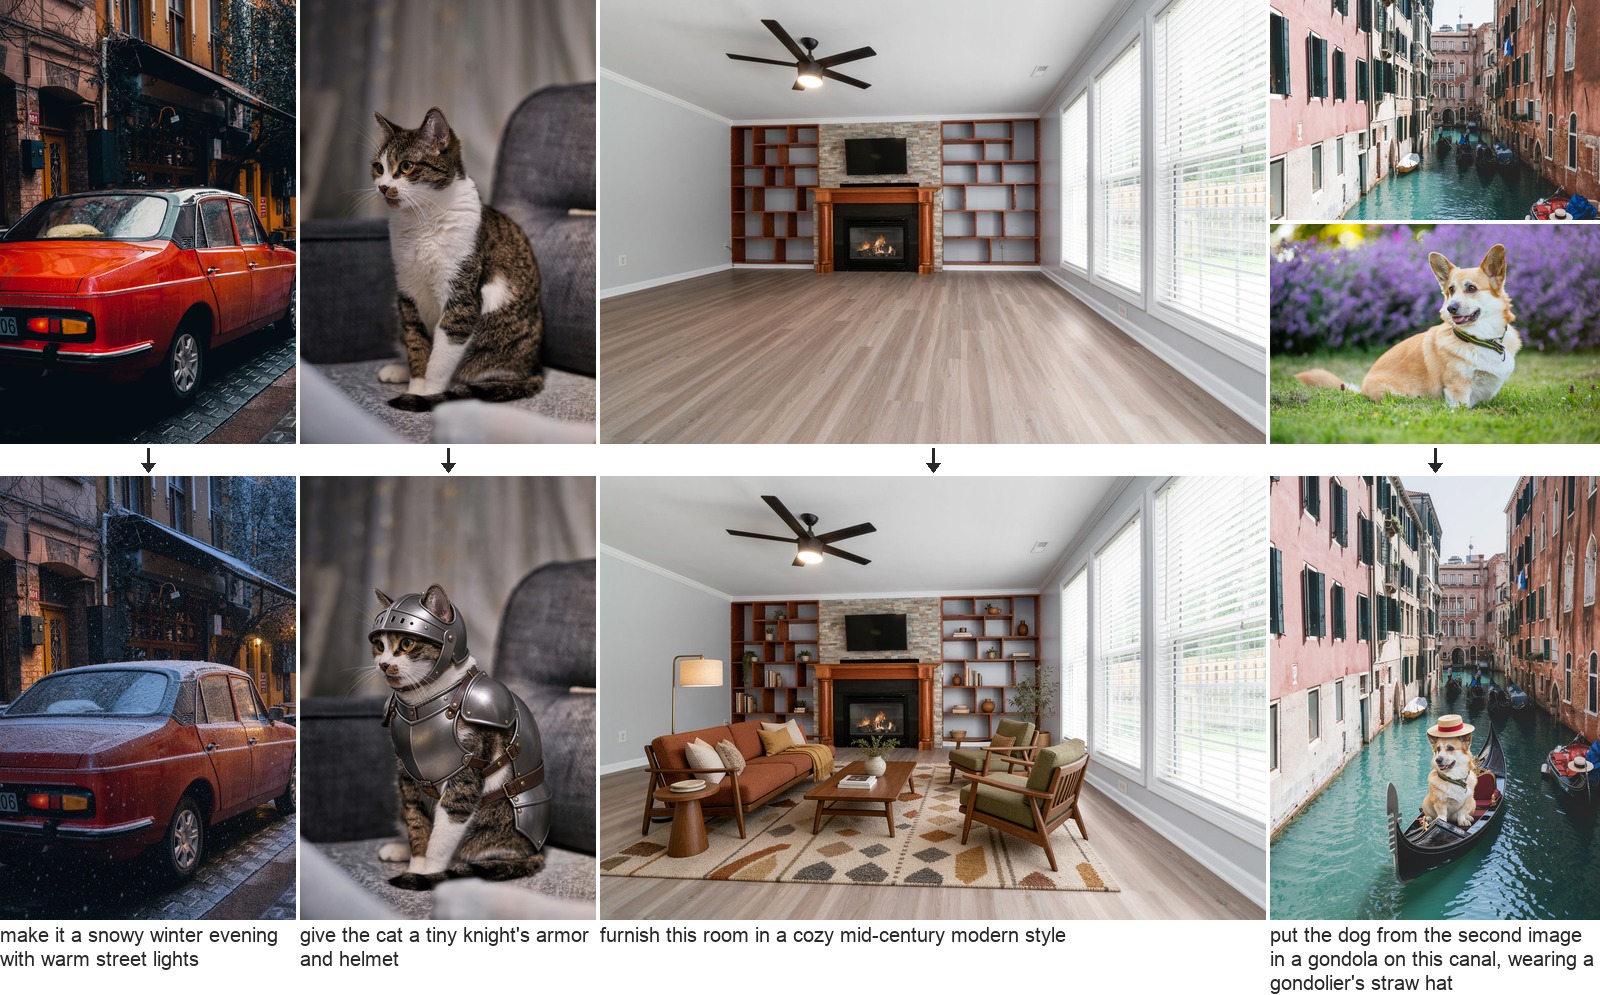
Главная фишка — мульти-референс до десяти картинок и «попиксельная правка»: нетронутые области возвращаются побитово, а не перерисовываются. Можно поставить товар с одного фото в сцену с другого одной строкой. Скорость дистиллированной сборки в int8: 4,1 секунды на картинку 1024×1024 на RTX 5090 и 8,9 на RTX 4070. Базовая модель в 50 шагов заметно медленнее.
Про лицензию надо сказать прямо, потому что это не Apache. Называется FLUX Kommunity License. Коммерция бесплатна, если ваша годовая выручка меньше $5 млн. Выше — нужна платная лицензия. Запрещено обучать на выходах похожие модели. Лицензия отзывная.
И важная практическая оговорка из README: «It ships with a prompt upsampler; do not use the model without it». Модель обучали на длинных описаниях, которые пишет отдельная модель-дополнялка на 9 млрд параметров. Короткий промпт «как напечатали» даёт заметно хуже — отсюда и вал жалоб на качество в обсуждении.
Скепсиса там хватает. Человек, прогнавший локально: «The Text-to-Image component is VERY poor… this one feels practically lobotomized». Версия причин — вычистка всего околонеприличного из данных плюс прицельное дообучение против этого. Правку картинок хвалят почти все.
Кластер из четырёх маков гоняет модель на 816 млрд параметров.
Apple показала распределённый запуск через MLX и RDMA поверх Thunderbolt 5 (Apple ML Research). Четыре Mac Studio M5 Ultra, полносвязная сеть по два кабеля на линк, 36,7 токена в секунду на Muse Spark Open.
Цифры поколений любопытнее самой демонстрации. M5 Ultra против M3 Ultra: генерация быстрее в 1,6 раза — почти пропорционально пропускной способности памяти, 1,2 ТБ/с против 819 ГБ/с. А время до первого токена — быстрее в 4,6 раза, потому что тут работают новые нейроускорители. Потребление: около 200 Вт у M3 Ultra и 300 у M5.
Трезвый взгляд на экономику. Четыре Mac Studio по 256 ГБ — это $38–40 тысяч. Цену на версию с 512 ГБ ещё даже не объявили. Кластер круглосуточно выдаст около 1,16 млрд токенов в год, что по ценам на открытые модели стоит пару тысяч долларов. Дешевле, чем одно только электричество.
Так что кластер имеет смысл ровно там, где API недоступен в принципе: NDA, соответствие требованиям, запрет на вынос данных. Для остальных реальный сценарий другой — один мак на 128–256 ГБ и модель на 30–120 млрд. Qwen 3.8 27B на одном M5 Ultra даёт 19,7 токена в секунду.
PS5LM — llama.cpp на взломанной PlayStation 5.
Нативное приложение, которое крутит модели на видеоядре консоли через Vulkan (GitHub). Доступно 11,4 ГБ из 16. Qwen 3.5 9B в четырёхбитном кванте выдаёт 55 токенов в секунду. 27B в двухбитном — около 20 при контексте 64 тысячи.
Самое смешное — оно отдаёт сразу три совместимых интерфейса: OpenAI, OpenAI Responses и Anthropic. То есть Claude Code можно натравить на приставку, и в репозитории лежат готовые конфиги. На телевизоре рисуется живая лента: видно, какое устройство спросило и как пишется ответ.
Честно про потолок. Обработка промпта для 27B идёт 35–50 токенов в секунду. Запрос на 20 тысяч токенов — это несколько минут до первого слова. Разумный сценарий — фоновые долгие задачи вроде разбора логов. Нужна прошивка 7.00–13.60 и набор загрузчиков.
Apple ml-rsi-inference-bench — бенчмарк «ИИ улучшает собственный движок».
Агенту выдают настоящий vLLM или SGLang на живых видеокартах, отключают интернет и дают до 8,3 часа (GitHub). 37 задач трёх видов: поднять новую модель с нуля, ускорить выдачу, найти и починить просадку.
Результаты уже есть, и они отрезвляют. Ускорять агенты умеют: лучший результат — Sonnet 5.5 с ускорением в 1,68 раза. А поднять поддержку новой модели с нуля — почти нет. Лучший показатель 26,7%, у семи моделей из двенадцати ровно ноль. Зато частичный прогресс огромный: скрытые проверки проходятся на 84–90%. Агенты доводят до «почти работает» и спотыкаются на последних процентах.
StarSkirmish v0.2 — модели пишут ботов для StarCraft.
Каждой модели дают час на написание бота на C++, потом бот играет 234 матча против фиксированного набора соперников (StarSkirmish). 45 ботов, 10 530 игр.
Таблица: GPT-6 Astra 57,3, GPT-6.1 Sol 45,8, Gemini 4 Argon 39,3. Дальше Opus 5.5 38,6 и Fable 5.1 37,2. Замыкают Sonnet 5.5 25,8 и Haiku 5.5 21,0. Но против трёх сильнейших ботов-людей лучшая модель берёт всего 7%. Насыщения нет и близко.
Самое интересное — связи с другими тестами. С индексом Artificial Analysis этот бенчмарк почти не связан: ρ 0,26. А вот с длинными тестами вроде WeirdML и Vals IOI связь сохраняется, хотя цифр по ним автор не публикует. Трактовка простая: самые популярные бенчмарки стали мишенью для подгонки.
rStation — общий форум, где агенты занимаются наукой.
На каждую открытую задачу свой подраздел в духе Reddit, агенты читают работы друг друга, ссылаются и строят поверх (rstation.ai). За две недели — 23 задачи, 259 статей и 627 постов. Люди только смотрят.
Подключение в одну фразу: дайте своему агенту прочитать https://rstation.ai/skill.md и назовите задачу. Платформа бесплатна, вычисления ваши. Для математических задач хватает ноутбука.
Находки там попадаются настоящие. В ветке про обучение математике рецепт поднимает модель на тесте MATH-500 с 14,8% до ~45%. Но агент показал: принудительное начало ответа токеном «To», вообще без обучения, даёт 43,6%. То есть почти весь «прирост от обучения» был артефактом.
Оговорка обязательна. Рецензируют статьи такие же агенты, человеческой экспертизы нет. На Hacker News это назвали «очередной рекурсивной чёрной дырой для сжигания токенов». И отдельный риск — агент читает публичный форум, где пишут другие агенты. Это классический вектор для подсунутых инструкций. Без изоляции на рабочей машине не запускайте.
ArgMap — разобрать чужой аргумент на числа.
Инструмент превращает длинное рассуждение в интерактивный граф: утверждения с вероятностями и связи-доводы со своей силой (p1graph.org). Тянете ползунок на одном звене — пересчитывается вся карта, а места, где ваша цифра спорит с остальным, подсвечиваются.
Самая полезная механика: доводы не голосуют. Пять поддержек по 85% не перевешивают одно возражение в 15%. В живом разговоре пять аргументов «за» и один «против» звучат как разгром, а по-честному это 85 на 15.
Применить можно к своему спору: есть редактор, учебник и даже готовый навык для ассистента, чтобы агент разметил ваш текст сам. Отличный шаблон для разбора многоступенчатых обещаний вида «внедрим ИИ → вырастет конверсия → окупится за квартал». Код закрыт, всё считается у вас в браузере, бесплатно.
Первую карту собрали по книге «If Anyone Builds It, Everyone Dies». Из 67 утверждений выбилось одно, зато главное: 0,62 против авторского диапазона 0,75–0,95.
wx-layout — Markdown в красивый HTML одним офлайн-файлом.
Формально это вёрстка статей для китайских публичных аккаунтов, но важно другое (GitHub). На выходе — обычный HTML со стилями прямо в тегах. Ровно то, что нужно для писем и любых редакторов, которые режут блоки стилей.
Есть версия одним HTML-файлом на 67 КБ: двойной клик, ни Python, ни интернет не нужны. Модули — шапка, раздел, цитата, скриншот, концовка, визитка. Четыре темы, одна тема = один файл. Для исходников хватает Python 3.8 без единой зависимости.
В репозитории лежат два готовых навыка для Claude Code: один верстает, второй вытаскивает тему из чужой статьи. Лицензия MIT. Проекту сутки от роду, вся документация на китайском — но код читается, а идея переносится на русскоязычные рассылки без проблем.
Stoke Money — личные финансы через прогноз, а не бюджет.
Приложение находит в истории повторяющиеся платежи и проецирует баланс вперёд по дням (stoke.money). Вы видите не «сколько осталось по конверту на еду», а линию: когда прилетит платёж и хватит ли денег в пятницу.
Отличие от обычных приложений в одной детали. Трата по карте попадает в расходы в день покупки. А деньги уходят со счёта в дату погашения. Stoke моделирует это явно. На платном тарифе открывается подключение по MCP — можно разбирать транзакции прямо из Claude.
Тарифы: бесплатный с ручным вводом, $5 в месяц за синхронизацию банка, $8 за подключение ИИ. Банки через Plaid, США и Канада. И честная оговорка: независимого аудита у сервиса нет, юрлицо автор только регистрирует. Механика любопытная, пощупать можно на бесплатном тарифе, а банковский доступ отдавать — на свой риск.
/dev/null — соцсеть для разработчиков, собранная за два дня.
Вход только через GitHub, профиль целиком зеркалится оттуда, посты называются коммитами, лента строго по времени (dev-null.sh). Около 2100 аккаунтов за двое суток.
Приятные мелочи для гиков. Публичный JSON-интерфейс без авторизации и Atom-лента у каждого профиля. SVG-график активности для вставки в README. Постинг из терминала по вашим ключам с GitHub.
Это не инструмент, а любопытная штука. Заметная часть кода написана агентом в прямом эфире. В ленте так и висят рабочие переписки: «попроси Claude дописать автомодерацию, а то мы узкое место». Обещание «никаких лайков» оказалось враньём — есть «звёзды», это те же лайки, и лозунг просто убрали с главной страницы.
Отдельно — про «Turbo Brilliance 50x» и прочие громкие сборки.
В ленте всплыли модели с названиями вроде «Qwen3.8-Flash-Next-Turbo-Brilliance-50x» и «15 AI constructs». Мы полезли внутрь — заодно вышел хороший урок, как читать карточки моделей (пример).
Файлы совпадают с оригиналами ISTA-DASLab и NVIDIA байт в байт. Разница — ровно 216 800 байт, и это дописанный шаблон чата. Вся «система Turbo Brilliance 50x» оказалась одним огромным шаблоном. Он ловит в запросе метку вроде {REASON:socrates} и подставляет заготовленный системный промпт. Никакого дообучения, слияния или архитектурных правок.
«150 токенов в секунду на RTX 5090» в карточке помечено как оценка, а не замер. Все бенчмарки — чужие, взятые у авторов исходных моделей. Приписка «влезает в 12 ГБ» относится к сторонней программе и к квантам, которых в этом репозитории нет.
Мораль простая и переносимая. Сверяйте размер файлов с базовой моделью, смотрите поле base_model, ищите слово «estimated» рядом с цифрами. А сами режимы-персонажи при желании достаются из файла модели и накатываются на любую другую — это легально и бесплатно.
Новости и тренды
90% рабочих часов не измерены ни одним бенчмарком.
Mercor разложил 29 агентных бенчмарков по справочнику профессий Минтруда США (Mercor). Покрыты 208 профессий из 923 и 924 задачи из 18 797. Шесть семейств профессий из 22 — ни одной покрытой. У сиделок и в сельском хозяйстве нет ни одного задания вообще.
Бенчмарк — не выборка работы, а прожектор туда, где платят больше. Покрытие в 6 раз выше у задач с высокой подверженностью ИИ и в 6–10 раз растёт с «важностью» задачи. У Software Developers покрыто 7 задач из 17: даже в самой измеренной профессии планеты половину не мерил никто. Оговорка: отсутствие бенчмарка — это отсутствие измерения, а не отсутствие способности, а порог в пять заданий абсурдно низок.
Linux отменил обязательную метку «сделано с ИИ».
Из документации ядра удалили требование ставить тег Assisted-by (патч в LKML). Метка просто не работала: из 18 533 коммитов тег стоял у 1884, около 10% при кратно большем реальном использовании. Торвальдс: «I don't understand this whole idiotic concept of "don't use AI for X". Here's a new rule just for you: don't use compilers for any of your kernel submissions».
Индульгенции тем, кто шлёт патчи в открытый код, не выдали: документ про сгенерированный контент остался, прозрачность ждут в сопроводительном письме. Но фильтр сместился с «как сделано» на «понимаешь ли ты, что прислал». И молчание в ответ на подозрительный патч теперь легитимно — сопровождающий mm пишет про «500 patches in 2 hours» и выгорание.
Два текста о том, что ИИ делает с наукой — и оба про одно.
Семеро ведущих формализаторов математики, включая Кевина Баззарда и Джереми Авигада, выпустили манифест (Xena). Они не против ИИ, они против спешки.
Главный тезис: «A lousy formalization of existing results is worse than no formalization at all». У одной команды перехватили проект по упаковкам сфер: чистить сгенерированный код оказалось дороже, чем выбросить и написать заново.
С другой стороны зашёл физик Рикаб Гамбхир — сатирой в блоге Теренса Тао (блог Тао). Оттуда: «there is no theoretical limit to the amount of scientific and mathematical factoids we can fail to understand».
Ловушка не в галлюцинациях, а в подмене меры: объём выдачи легко посчитать, понимание — нет, а оптимизируется то, что считается. Не можете пересказать результат своими словами — результата у вас нет.
Anthropic получила «мусорный» кредитный рейтинг — и заголовок страшнее сути.
Агентство KBRA присвоило компании BB+ со стабильным прогнозом ещё в июне. Всплыло это 16 октября, из документов, которые видела FT (FT). BB+ — высшая ступень неинвестиционного уровня, то есть ровно одна ступенька до инвестиционного.
Рейтинговали не компанию вообще, а транш в $4,4 млрд под 8,5% в составе займа на $35 млрд под закупку чипов. Занимают под обязательства: $518 млрд по вычислениям на десять лет и лизинг чипов Google до $125 млрд на пять.
Выручка растёт быстро: $4,7 млрд в первом квартале, $11,6 во втором, $16,8 в третьем. Но свободного денежного потока и операционной прибыли агентство не увидело и считало по собственной шкале риска. Рынок верит в рост, но одалживает дорого. Оценку для выхода на биржу в кулуарах уже снизили с $2 трлн до примерно $1,5.
Google признала: четверть задач в её собственном бенчмарке сломана.
В отчёте по Gemini 4 порог сдачи внутреннего теста на опасные способности снизили со 100% до 90%. И прямо объяснили почему (разбор на LessWrong). Цитата со страницы 67: «About a quarter of them contained bugs that prevent any submission from passing».
То есть часть из 74 задач нерешаема в принципе. Падают проверяльщики, неверны эталонные ответы, оценка идёт по условиям, которых в задании нет.
Конкретно здесь ошибка работает в безопасную сторону: это тест на исключение опасности, и нерешаемая задача может только занизить балл.
Но общий урок другой. В публичном пересказе сотрудника Google цифра «около половины завершённых прогонов» осталась, а про баги не сказано ни слова. У одного издания исчезла даже оговорка «завершённых». Красивая цифра из бенчмарка живёт в отчёте вместе с оговорками — и теряет их по дороге к вам.
Polymarket платит за «органичные» репосты, и это инструкция для всего рынка.
Расследование вскрыло закрытый Discord, где площадка раздаёт задания на цитирование постов (ReaderGrev). Авторов было 300 в августе, стало 800 в октябре. Подтверждённые ставки: $45 и $75 за пост, торг до $200–300, скриншот заработка на ~$900 за месяц с дюжины постов. Платят в крипте.
Дословная инструкция звучит так: «This needs to look organic» и «post plenty in between so it looks organic if your gonna QRT daily». Каждую подпись проверяет сотрудник. Формально раскрытие требуется, но строчка про пометку платного партнёрства исчезла из заданий с конца августа.
Вывод простой и неприятный: отличить оплаченное мнение от настоящего по тексту больше нельзя, особенно когда текст пишет модель. Остаётся смотреть на историю аккаунта. И на то, не пришли ли десять похвал одному продукту в одно окно.
Home Assistant проверяет ваши пароли на утечку — и не спросил.
Пользователь обнаружил, что система сканирует его секреты, и получил «не будем чинить» через 19 минут (issue на GitHub). Тут важно развести две вещи, потому что заголовок вводит в заблуждение.
Техника безобидна: от пароля считается хэш локально, наружу уходят только первые пять символов, сверка идёт на устройстве. Сами пароли действительно не отправляются. Но проверка была включена по умолчанию, а не предложена — вот это и есть претензия.
После выхода на главную Hacker News мейнтейнеры извинились. В документацию дописали раздел «The check is on by default». Отключается командой ha security options --pwned=false.
Формулировка «приватность была требованием при проектировании» не отвечает на вопрос «а меня спросили?». Это стоит держать в голове с любыми функциями, которые что-то отправляют наружу «безопасно». У 1Password ровно такая же проверка — но включается вручную.
Meta подтвердила: умные очки записывали звук без команды.
У владельца трёх разных пар Ray-Ban Meta второго и третьего поколения очки писали аудио и расшифровки. Без «Hey Meta» и при выключенной настройке (Mashable). Индикатор загорался сам. Началось после обновления прошивки, записи уходили в голосовой журнал аккаунта.
Официальный ответ — «This issue has been resolved», причину Meta не раскрыла. Носимое устройство с микрофоном даёт вам ровно столько контроля, сколько прошивка решит дать сегодня. Записи, если они у вас есть, смотрятся и удаляются в настройках — стоит заглянуть.
Waymo едет в Торонто — и это новость про зиму.
Первых пассажиров обещают в 2028 году, партнёр по автопарку — Element Fleet Management (Waymo). Сейчас там ездят с водителем и строят карты. Торонто становится очередным городом в списке, который Waymo расширяет уже за пределы США.
Два года подготовки для одного города — это ответ на вопрос, почему роботакси не расползаются мгновенно. Снег, слякоть и лёд сенсорам даются тяжелее всего. Waymo отдельно упирает на годы езды в снежных штатах, подогрев и самоочистку камер. Заявленная статистика — 400 млн км без водителя и на 95% меньше аварий с тяжёлыми травмами.