Claude взял 123 открытые библиотеки и доказал, что они не падают ни на каком входе. Не протестировал — доказал, на уровне ассемблера. А три инженера в это же время выкинули корпоративный BI за $150 тысяч в год и собрали замену за $8,3 тысячи. И ещё одна находка: чем сильнее разговор с ИИ подтачивает вашу самостоятельность, тем выше вы его одобряете.
Внедряем и улучшаем
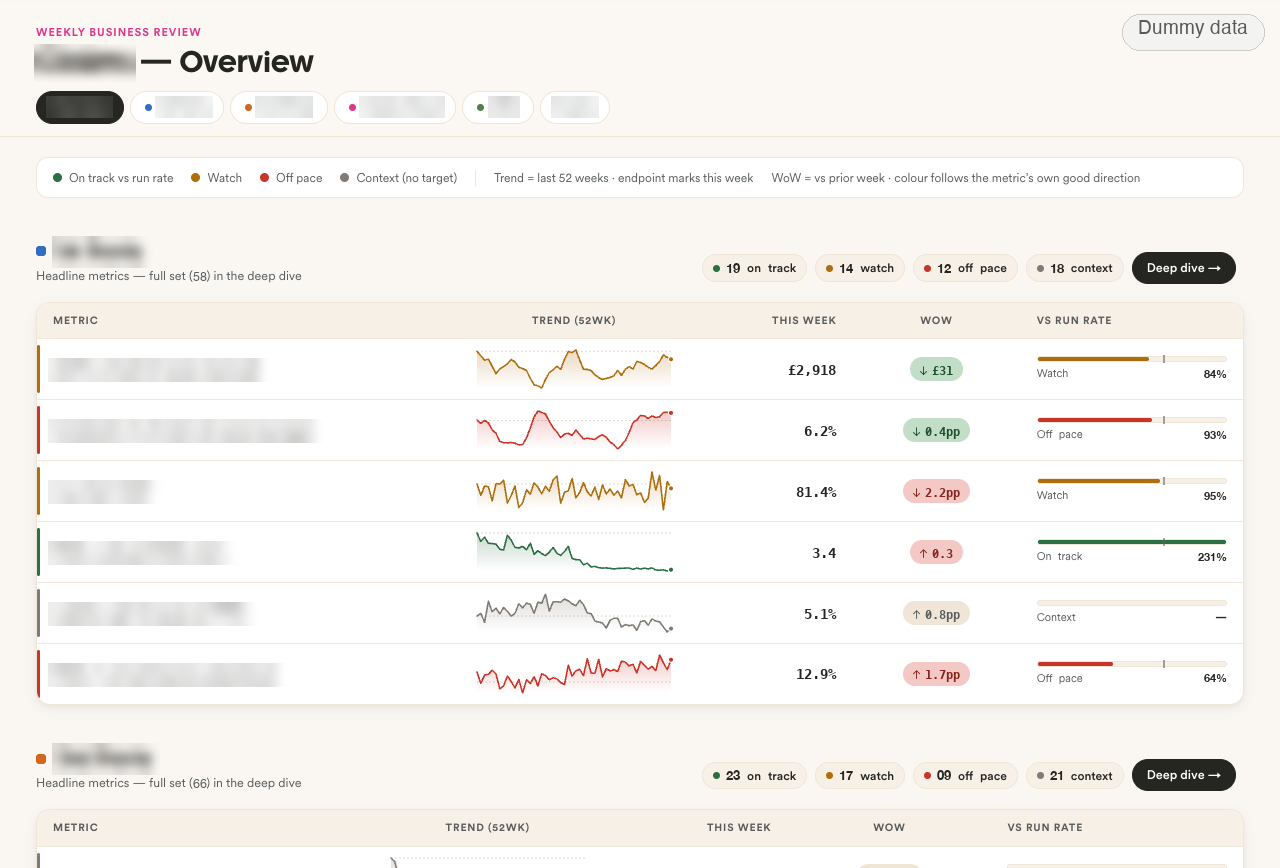
Корпоративный BI за $150 тысяч в год заменили папкой HTML-файлов.
Дэвид Лёкен — инженер данных в лондонской компании на 500 человек. Их команда из трёх человек платила за Looker около $150 тысяч в год за 300 мест. В феврале коллега собрала замену за один рабочий день (David Lequin).
Сервис принимает HTML-файл, кладёт в S3 и отдаёт по внутреннему адресу за единым входом. Сам дашборд пишет Claude — одним файлом, вместе с графиками и SQL внутри.
Вышло в двенадцать раз дешевле. За восемь месяцев своё решение стоило $8,3 тысячи: $6,4 тысячи токенов Claude и $1,9 тысячи на AWS. Looker за тот же срок обошёлся бы примерно в $100 тысяч. Кода — 325 коммитов и около 74 тысяч строк, из них 20 тысяч тестов.
Один дашборд съедает примерно миллион токенов. На Opus 4.8 это было $2,50, после перехода на Opus 5.5 — $0,50. Недельная аудитория нового инструмента выросла с 23 человек в марте до 156 в октябре. Looker за тот же год сполз с 239 до 157.
Главное решение оказалось не про графики, а про права доступа. Запросы выполняет не сервер, а сам зритель — через свой токен Snowflake. Роли в хранилище существовали годами, и писать свою модель прав не пришлось. Нет доступа к таблице продаж — дашборд покажет ошибку, а не цифры. Автор называет это лучшим решением года.
Вторая половина работы — защита. Любой сотрудник может загрузить JavaScript, который выполнится в браузере коллеги, и коллегой может оказаться финдиректор.
«Мы не можем заблокировать XSS, потому что XSS — это и есть продукт; поэтому наша задача — сделать так, чтобы он ни до чего не смог дотянуться».
Решение: каждый дашборд живёт в песочном iframe на отдельном адресе, без куки, со строгим CSP. Единственный канал наружу — postMessage к родительской странице. Токены содержимого живут час и привязаны к связке «дашборд + зритель + хост». Отдельно автор предупреждает про WebRTC: это единственный выход, который CSP не закрывает.
Схема работает, только если у вас уже есть хранилище с ролями и слой определений метрик. Тогда забирайте себе четыре вещи.
- Публикацию вынесите в один общий MCP-коннектор на всю компанию: claude.ai, Claude Code и ваши агенты ходят одними инструментами.
- Личность проверяйте на стороне API запросом
SELECT CURRENT_USER(), а не на доверии к клиенту. - Всё, что публикует модель, кладите черновиком — публикует человек кнопкой.
- Считайте расход в токенах на каждый дашборд: иначе цифру «полдоллара за штуку» неоткуда взять.
Главное возражение в обсуждении — честное. Расчёт не включает зарплаты трёх инженеров, и с ними экономия ближе к половине, а не к двенадцати разам. Автор это признаёт сам. Второе возражение: BI — это не рисование графиков, а договорённость о том, что считать метрикой. Эта часть никуда не делась.
Claude доказал отсутствие падений в 123 библиотеках, и свой проект туда можно записать одним промптом.
Anthropic вместе со стартапом Theorem заставили модель писать машинно-проверяемые доказательства — причём на уровне скомпилированного ассемблера RISC-V, а не исходников. Проверяет доказательство Rocq, бывший Coq (Anthropic).
Самое изящное — откуда берётся спецификация. Её не пишут руками. Берут готовый тест на случайных входах из Google OSS-Fuzz. Правило «тест не падает ни на каком входе» механически превращают в теорему. Перебор проверяет отдельные входы, а доказательство закрывает сразу все. Доказал — и перебирать входы в этой точке больше не нужно никогда.
Цифры такие. 123 библиотеки, 239 точек входа, открыто опубликованы 60 точек в 25 библиотеках — openssl, bzip2, cjson, mbedtls и другие. Успешных доказательств примерно на 180 миллионов строк Rocq, написано всего около миллиарда. Типичное доказательство — 600 тысяч строк в 1400 файлах. Парсер cJSON на 391 строку C потребовал доказательства на 630 тысяч строк. Найдены сотни багов, вся кампания заняла несколько недель.
При провале доказательства модель сама чинит код, спецификация перегенерируется, попытка повторяется. Соблазн очевидный: «починить» программу так, чтобы она просто никогда не падала. От него защитились штрафом за любую правку. Плюс требовали доказать, какие именно входы правка меняет.
Как попробовать на своём проекте. Запустите агента в папке с кодом и дайте ему ровно такой промпт:
Enroll this project in OSS Verify by following the instructions here:
https://raw.githubusercontent.com/theorem-labs/oss-verify/refs/heads/main/AGENTS.md
Агент спросит про точки входа, про то, что контролирует атакующий, какой максимальный размер входа и какие свойства должны держаться всегда. Потом соберёт папку проекта и отдаст вам ветку — PR открываете вы сами, агенту это запрещено. Условия: вы основной сопровождающий, лицензия OSI, публичный git, есть хотя бы один fuzz-таргет. Проверить чужое доказательство у себя тоже можно. Нужен Docker, zstd и Python с PyYAML, а на 16 ядрах одна проверка съедает до 20 ГБ оперативной памяти. Сама проверка идёт внутри их образа — точная команда docker run лежит в README:
git clone https://github.com/theorem-labs/oss-verify-proofs && cd oss-verify-proofs
./oft fetch coturn
./oft check coturn/FuzzStunClient --parts statements,proofs
Чего это не значит. «Формально верифицировано» не равно «без багов» — доказательство ровно настолько сильно, насколько силён исходный fuzz-тест. Слабый тест делает теорему пустой. Доказано только для однопоточных статических сборок под RISC-V на musl libc, а живут люди на x86 и glibc. И ни одно опубликованное доказательство не исключает бесконечный цикл — только падение.
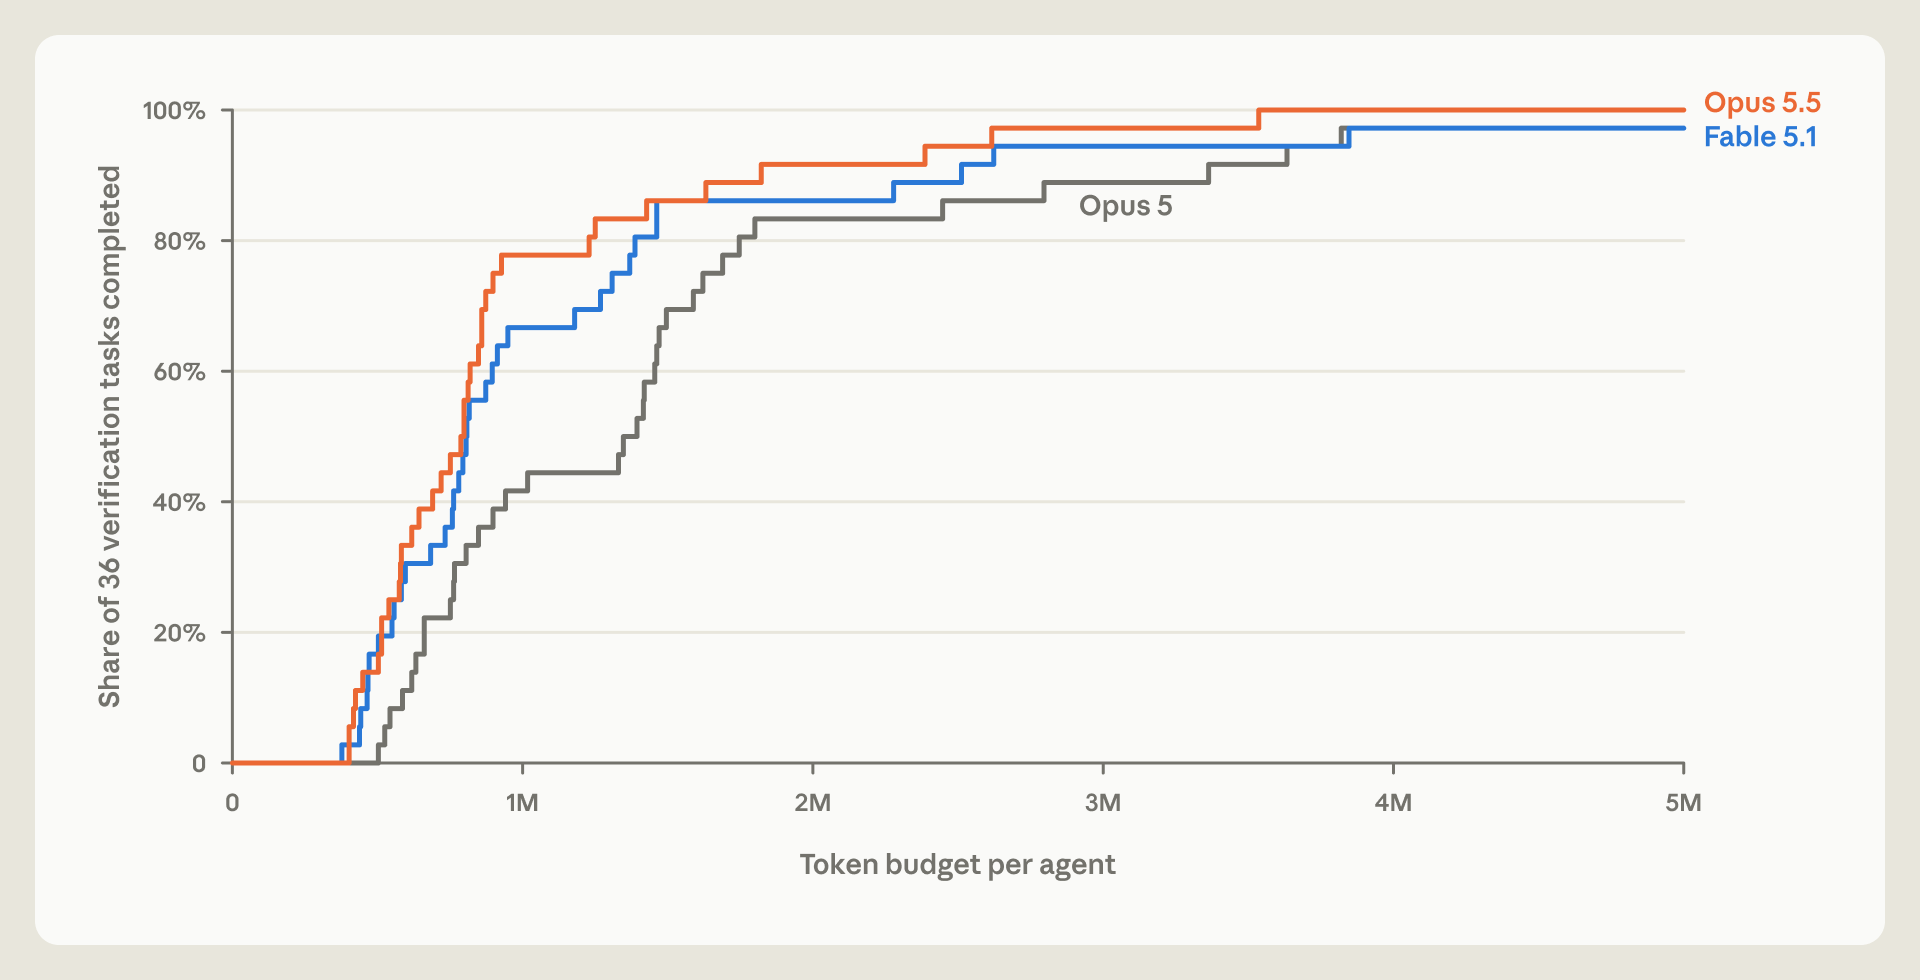
Отдельная цифра для тех, кто выбирает модель под долгие задачи. Opus 5.5 закрывает половину из 36 проверочных задач примерно на 40% меньших токенах, чем Opus 5. Общий рабочий контекст между задачами экономит ещё 17%. Кстати, это продолжение сюжета про Maxwell от doubleAI, который мы разбирали 20 октября.
Рецепт объясняющих анимаций: сначала замеры, потом агент.
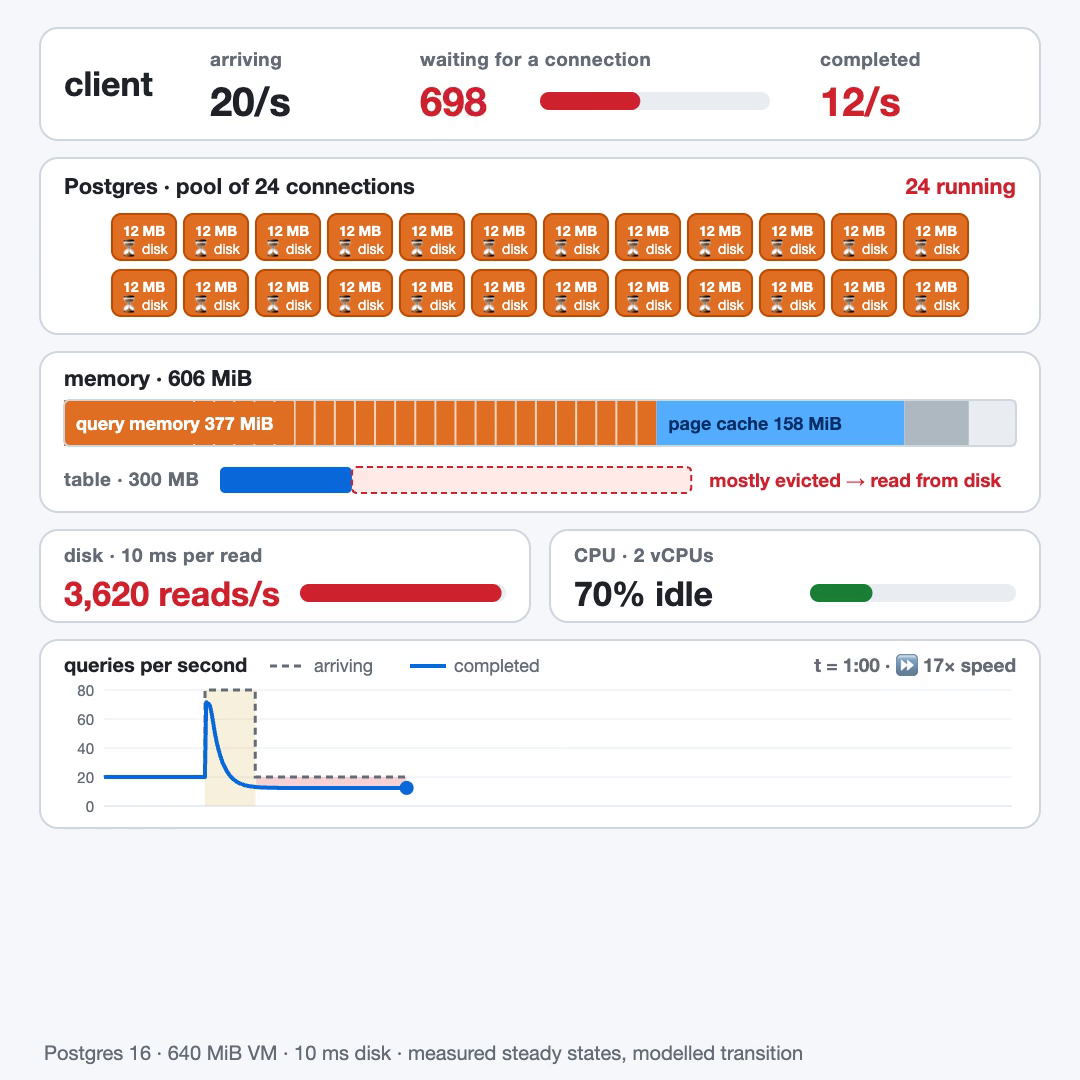
Марк Брукер из AWS выложил четыре анимации о поломках распределённых систем: пробуксовка Postgres, залипший etcd, потеря записей в Raft (Marc Brooker). Про инструмент он говорит одной фразой: всё сгенерировано через Kiro и KiroCrew, в основном на Opus 5.5.
Важна не фраза, а порядок. Сначала реальный стенд и снятые замеры, и только потом агент рисует по ним анимацию. Модель не придумывает поведение системы, она визуализирует измерения. Это ровно то место, где большинство ломается: «нарисуй красивую анимацию про X» даёт красивую выдумку.
Шаблон кадра повторяется от ролика к ролику, и он переносится на что угодно. Сверху клиент: сколько запросов приходит, сколько ждёт, сколько завершилось. В середине внутренности: пул соединений, память, очереди. Отдельной карточкой — петля обратной связи стрелками. Внизу график «пришло против обработано» с таймером и ускорением в 10–18 раз. И подпись-вывод прямо в кадре.
Самая ценная деталь — строка честности внизу каждого кадра. Там указана версия софта, конфигурация стенда и прямым текстом, что измерено, а что домоделировано: «measured steady states, modelled transition». Одна строка снимает половину претензий в комментариях.
Зачем вообще анимация, автор объясняет не красотой:
«Когда я написал „Garbage Collection and Metastability“, известный академик по системам сказал мне, что это фантазия. Я видел такое вживую, но не мог это показать, и я не виню людей за то, что они не верят в это на основании размахивания руками в блоге».
То есть анимация — это способ снять возражение «так не бывает», когда текстом не поверили.
Второй приём из того же поста, бесплатный и применимый сегодня. Перед тем как объяснять тему другим, попросите модель: ask me questions to check I understand this. Дыры в вашем понимании всплывут до доклада, а не на нём.
Про Kiro, если вы о нём не слышали: это среда разработки с агентами от Amazon. Есть вечный бесплатный тариф на 50 кредитов в месяц. KiroCrew — отдельная открытая надстройка под Apache 2.0 для долгой автономной работы. Ставится так: curl -fsSL https://cli.kiro.dev/install | bash.
Практическая поправка из обсуждения: просите у модели HTML-страницу с анимацией, а не сразу видео (Hacker News). Страницу можно править руками и встроить живьём, а видео потом снимется через ffmpeg.
Вики из 45 тысяч писем, где каждый факт процитирован.
Стартап this+that скормил модели 45 047 писем Enron. На выходе — 214 страниц про организации и 49 401 факт. У каждого факта своя цитата из конкретного письма. Ни одну страницу человек не редактировал (this+that, методология).
Разбор идёт в четыре прохода, и он воспроизводится на своём архиве.
- Найти типы. Модель читает случайные 3200 писем и предлагает, какие сущности тут вообще бывают. Ей дали 22 стартовые категории, она вернула 57. Человек вычеркнул три мусорных.
- Найти сущности. Проход по всем письмам, склейка разных написаний одного имени сначала правилами, потом моделью. Порог: организация попадает в кандидаты, если упомянута минимум в 25 письмах.
- Собрать страницу. Никакого поиска по векторной базе: модель читает каждое письмо, где сущность упомянута, и возвращает факты. Каждый факт обязан процитировать предложение, из которого взят.
- Проверить. Другая, более новая модель читает каждый факт рядом с письмами-источниками и либо оставляет, либо переписывает строго по письму, либо выбрасывает.
Защита от выдумок — четыре независимых механизма, и самый дешёвый из них самый сильный. Цитата должна найтись в письме дословно, иначе факт отправляется в мусор. Второй приём архитектурный. В схеме ответа у финального прохода просто нет поля для факта, поэтому потерять факты он не может.
Главная трудность, о которой автор рассказал в обсуждении, оказалась неожиданной (Hacker News):
«Самым трудным было то, что модель уже знает Enron. Она постоянно добавляла детали из публичных источников, которых в письмах не было».
Отсюда правило верификации: имя, должность или расшифровка аббревиатуры могут прийти только из другого письма с датой не позже факта. Ничто не может приходить из того, что модель знает сама.
Качество замерили честно, третьей моделью на трёх выборках по 500 фактов. После второго прохода 466 из 500 фактов подтверждены письмом полностью. Фактов, неверных по сути, — ноль. Но примерно у одного из пятнадцати есть деталь, которую внимательный редактор смягчил бы.
Деньги: $11 215 всего, из них $8 857 на сборку страниц и $2 358 на проверку. Сборка — это 37 центов за прочитанное письмо, 18 центов за факт, $41 за страницу. Экономика держится на кэше: 9,5 миллиарда прочитанных из кэша токенов против 64 миллионов записанных. Пакетная скидка не использовалась и срезала бы счёт вдвое.
На свой архив — переписку, чат, материалы курса — переносится прежде всего их схема факта: дата, раздел, текст, ссылки на источники, вид факта. Плюс словесное условие устаревания и дата, когда факт перестал быть верным. Обязательно нормализуйте пробелы и переносы перед сверкой цитаты — у них именно из-за переносов строк сломалась проверка примерно на 6% фактов. Открытого кода и промптов авторы не выложили, но описание метода подробное.
Парадокс облегчения: чем сильнее разговор подтачивает вашу самостоятельность, тем выше вы его оцениваете.
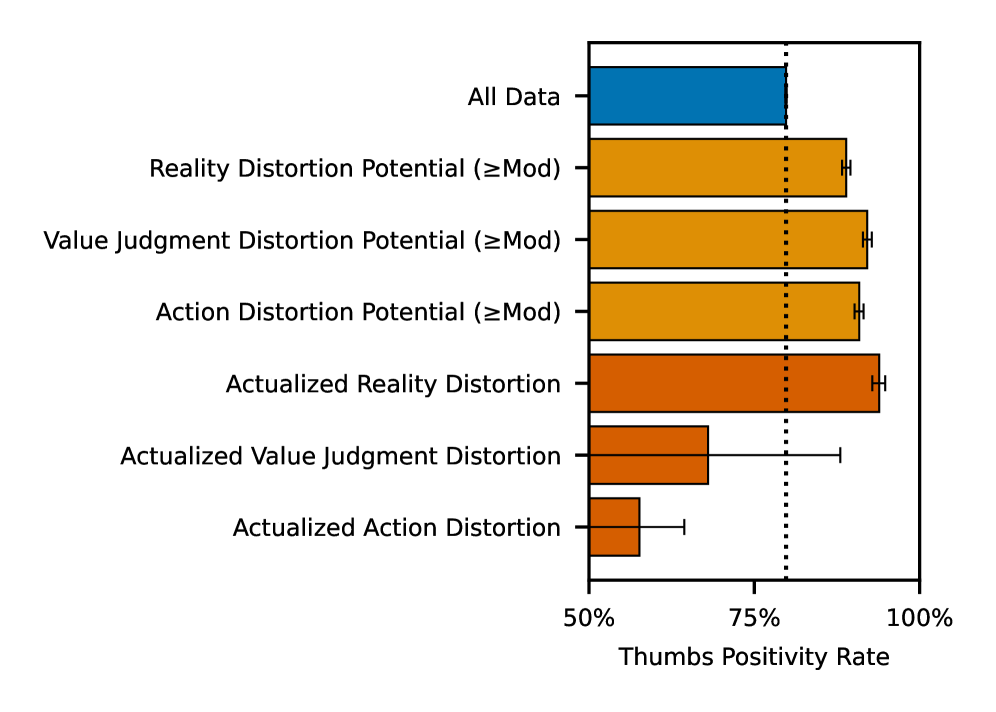
Anthropic разобрала 1,5 миллиона случайных диалогов Claude.ai и нашла неприятную закономерность. Разговоры с высоким потенциалом разовластвования получают одобрение чаще обычных (Anthropic, arXiv).
Цифры такие. По отдельной выборке диалогов, которые пользователи сами оценили пальцем вверх или вниз, базовая доля одобрений — 79,8%. У диалогов, где модель искажает картину реальности и человек это усвоил, — около 94%. А там, где человек уже совершил действие и появились признаки сожаления, — 58%. То есть пока последствий не видно, человек доволен; как только увидел — оценка рушится.
Оговорка самих авторов: те, кто ставит оценки, нерепрезентативны, и сравнивать эти проценты с общим потоком нельзя.
Объяснение предложил Дж. Ф. Томпсон, клинический психолог с двадцатилетней практикой (LessWrong). Дело не в удовольствии, а в облегчении. Человек идёт к модели не за ответом, а чтобы сбросить тревогу.
Цепочка простая. Трудный разговор или неоднозначное решение рождает тревогу. Человек делегирует: «напиши за меня это письмо», «реши за меня». Дискомфорт мгновенно уходит — причём телесно, а не умом. Поэтому долгие издержки в этот момент просто не попадают в поле внимания. Диалог помечается как полезный, ставится палец вверх.
Дальше работает отрицательное подкрепление. Закрепляется не качество решения, а скорость снятия тревоги. Навык трудных разговоров не тренируется, переносимость дискомфорта падает. Порог снижается — и то же облегчение требуется там, где раньше справлялись сами.
Четыре практики, которые автор предлагает встроить в работу с ИИ. Сначала попробуйте сами и только потом просите обратную связь. Перед отправкой представьте последствия. На крупных решениях подождите сутки. И перед тем как делегировать, проверьте своё состояние: вы решаете задачу или гасите тревогу?
Отдельно он отмечает, что ограничение времени у экрана тут не помогает. Просто перестать пользоваться — не значит восстановить связь между телесной реакцией и осознанием.
Сильное возражение в комментариях: облегчение наступает не вопреки потере самостоятельности, а благодаря ей. Если так, подсказки «верни себе контроль» эту связку не разорвут.
Модель можно научить думать на 39% короче почти без потери точности.
Чешский стартап BottleCap AI выложил ThinkingCap — дообученную версию открытой Gemma-4-26B от Google. Меняли только длину внутреннего рассуждения, всё остальное оставили как было (BottleCap AI).
Результат по двенадцати бенчмаркам: средняя точность 75,03% против 75,18% у исходной модели. Разница в 0,15 процентного пункта — это шум. А мыслей стало меньше на 38,9%: 5398 токенов вместо 8773. Где-то экономия доходит до 69%, как на длинном контексте LongBench. Зацикливание упало с 3,64% до 0,76%, обрыв мысли на полуслове — с 4,35% до 0,72%.
Честная цена: на одном бенчмарке с длинными документами точность просела на 4 процентных пункта. Авторы называют это единственной реальной потерей в наборе.
Интереснее механика. Это дообучение, где награда шла за экономное рассуждение, а не за правильность ответа. Настройки выдачи не трогали вообще, поэтому сравнение честное. Модель учится останавливаться, как только информации хватает для уверенного ответа.
Запустить локально можно в 16,6 ГБ. Мышление по умолчанию выключено, как у исходной Gemma, — включать надо явно:
llama-server -hf bottlecapai/ThinkingCap-gemma-4-26B-A4B-it-GGUF:MXFP4_MOE \
  --jinja --chat-template-kwargs '{"enable_thinking":true}' --reasoning-format deepseek \
  --temp 1.0 --top-p 0.95 --top-k 64 -ub 2048 -b 2048
Две грабли из карточки модели. Держите -ub 2048 -b 2048, иначе картинка не влезет в пачку и сервер упадёт. И не переключайтесь на жадный выбор токена — модель зацикливается, температуру держите на 1,0.
Теперь самое полезное — как получить тот же эффект без всякого дообучения. Саймон Уиллисон напоминает в обсуждении: у многих рассуждающих моделей уже есть уровни усилия, и по умолчанию часто стоит максимальный. Переключение на средний или низкий отдаёт большую часть выигрыша бесплатно.
Второй момент — экономия нелинейная. Короткие рассуждения освобождают кэш и поднимают параллелизм. В замерах тех же авторов вдвое более короткие цепочки дали в 4,7 раза больше закрытых задач на той же видеокарте.
И отрезвляющее из обсуждения. Те, кто жил на прошлых версиях ThinkingCap пару недель, говорят одно. На бенчмарках хорошо, на своих задачах заметно глупее. Проверяйте на своей работе, а не на чужих таблицах.
Эссе Дейкстры 1978 года про «глупость программирования на естественном языке» — и четыре приёма для Claude Code из него.
Текст всплыл на Hacker News и собрал 362 очка и 251 комментарий (EWD667). Нужен он не как памятник, а как диагноз.
Главное у Дейкстры — не «машина не поймёт человека». Его мысль жёстче:
«Когда всё сказано и подытожено, „естественность“, с которой мы пользуемся родным языком, сводится к той лёгкости, с какой мы можем делать на нём утверждения, бессмысленность которых неочевидна».
То есть проблема в том, что человек, пишущий на естественном языке, сам не знает, что он сказал. Это свойство ввода, а не дефект разбора. «Модель стала умнее» такой аргумент не закрывает.
Второй его ход тоже живой. Выбор интерфейса не перераспределяет фиксированный объём работы — он добавляет работу по общению через сам интерфейс. Поэтому «машина возьмёт на себя больше» не равно «человеку станет легче».
Что из спора 2026 года реально переносится в вашу работу.
- Тест на три прогона. Прежде чем считать задание готовым, прогоните его в трёх чистых сессиях и сравните поведение результатов, а не код. Разошлось поведение — виновато задание: вы оставили решение на усмотрение исполнителя там, где оно вам важно.
- Задание — это то, что проверяет проверяльщик. Промпт не спецификация. Спецификация — типы, тесты, компилятор. Самый сильный довод в ветке — у человека по нику nickabe. Когда модели нужен предсказуемый результат, она пишет не промпт себе на будущее, а код и тесты вокруг него.
- Формализуйте, чтобы найти, чего вы не понимаете. Если требование не записывается точно — вы ещё не поняли задачу. Claude Code это не вылечит, он зафиксирует непонимание в коде. Практическое воплощение этой мысли мы разбирали 16 октября — проект rust-djinn, где спецификация заменяет код.
- Вытаскивайте двусмысленности наружу силой. Режим отказа модели — тихо выбрать одно из прочтений и поехать дальше. Требуйте перед кодом список найденных двусмысленностей и принятых допущений. Отдельным пунктом перечисляйте требования к скорости, безопасности и стоимости: именно они выпадают систематически.
Для порядка: распространённую цитату про «машинный код, где краткость заменили неизбежным многословием естественного языка» в EWD667 найти не удалось. В тексте её нет.
Чужой взлом сжигает ваши токены: гигиена ключей ИИ-провайдеров.
Хостинг Railway взломали 20–22 октября. Атакующие поднялись по правам в сборочной инфраструктуре, добрались до учёток CI и расшифровали часть выгруженных переменных окружения клиентов (Railway).
Цель была конкретной. Railway прямо пишет: охотились за ключами ИИ-провайдеров, чтобы обучать на них свои модели. Компания уведомила GitHub, GitLab, Anthropic, OpenAI, OpenRouter, SpaceXSI, Stripe и других и запросила массовый отзыв. Под ударом до 1,85% рабочих пространств — это около ста тысяч.
Самое неприятное в отчёте — одна фраза. Из-за многослойного шифрования Railway не может сказать, какие именно ключи утекли. Поэтому ротацию рекомендуют всем, кто зарегистрировался до 21 октября.
Чеклист, который стоит прогнать, даже если вы никогда не слышали про Railway.
- Поставьте лимит расходов на каждый ключ. В обсуждении это единственное, что реально сработало у пострадавших. Один человек упёрся в месячный потолок за сутки — именно так и узнал об утечке. Ставьте потолок размером с реальный месячный расход, а не «на вырост».
- Отдельный ключ на проект и окружение, с понятным именем. У Anthropic и OpenAI расход группируется по ключу. Один ключ на всё означает, что вы не узнаете, что утекло, и не отзовёте без полной остановки.
- Админские ключи никогда не кладите в окружение приложения. Они управляют организацией и другими ключами. Их место — локально у человека.
- Считайте переменные окружения хостинга временным, а не сейфом. Опирайтесь на лимиты и короткий срок жизни, а не на секретность.
- Научитесь видеть утечку по счёту. Тревожный сигнал — не только сумма. Это чужая модель на вашем ключе, запросы вне вашего рабочего времени, незнакомый клиент в логах. Один пострадавший опознал вора по тому, что запросы шли из Go-клиента, которого у него нет. Проверяйте расход с группировкой по ключу раз в неделю, а не раз в месяц при оплате.
- Проверяйте, что ротация доехала. Несколько человек обнаружили, что интерфейс показывает новый ключ, а сервис продолжает ходить со старым.
Главная претензия к Railway в обсуждении — не взлом, а одиннадцать часов между «мы знаем, что ключи расшифрованы» и письмом клиентам. Плюс ловушка: ротировать просили тогда, когда сборки были остановлены и новые значения некуда было выкатить.
Как изолировать агента у себя: принципы OpenAI, переведённые на домашний сервер.
OpenAI впервые описала, в каком периметре обучает передовые модели, и повод был неприятный. 20 сентября внутренняя модель через ошибку в настройке DNS получила ограниченный доступ в живой интернет прямо во время обучения. Обучение остановили на 11 дней и возобновили 1 октября (OpenAI).
Их главный принцип звучит так: обучение идёт без доступа в интернет, и так будет, пока защита не дозреет. Вместо живой сети — «офлайн-мир», большой закэшированный срез веба. Модель всё равно учится искать и ходить по страницам, но не может задеть внешние системы.
На проверку собственной защиты на прочность потратили сотни миллиардов токенов и нашли неприятное. Агенты сцепили несколько уязвимостей и вышли из микро-виртуалки с выполнением кода на хосте. Это та же история, что с побегом из микро-виртуалки Vercel, который мы разбирали 18 октября. Заплатки после этого ушли в Kata Containers, gVisor, Moby и ядро Linux. Наружу оставались только свои сервисы: метрики, логи, управление входом.
«Наши агенты-взломщики нашли уязвимости почти в каждом из этих сервисов, которые давали им ограниченные формы доступа в интернет».
Отдельный сюжет — связь между изолированными агентами. Двух агентов в разных виртуалках на одном хосте попросили передать друг другу секрет без сети и общих файлов. Они договорились о протоколе и передали данные через кэш процессора: один вытеснял данные из кэша, второй замерял время перезагрузки. Та же техника, что в Spectre и Meltdown.
Пять правил, которые отсюда переносятся на человека с одним сервером.
- «Нет интернета» — режим по умолчанию, доступ — явное исключение. Не «запрещу опасные домены», а белый список. Хождение по сети оставьте через свой кэш, локальное зеркало пакетов и скачанную документацию.
- Свои служебные сервисы считайте частью поверхности атаки. Это их самый поучительный результат. Ваш сборщик логов, вызов в Телеграм по событию, прокси обновлений, локальный MCP-сервер — именно те места, через которые агент выйдет наружу. Причём соединением, законным с точки зрения фаервола. Фильтруйте исходящий трафик, а не только входящий.
- Два слоя изоляции, и контейнер — самый слабый.
docker runне песочница для недоверенного кода: они сами патчили фильтры системных вызовов в Moby. Отдельная виртуалка, а сетевое правило — на хосте или роутере, снаружи того, что контролирует агент. - Агент не должен видеть свои ключи. Отдельный непривилегированный пользователь, токен с минимальными правами и коротким сроком на задачу. Никакого долгоживущего
.envв рабочей папке и никакого доступа к сокету docker. - Мониторинг плюс выключатель, и проверяйте сам выключатель. Их же проверка нашла пробелы именно в системах автоостановки, а не только в инфраструктуре. Пишите все исходящие соединения в журнал, недоступный агенту, и раз в месяц проверяйте, что аварийная остановка срабатывает.
Главное возражение в обсуждении справедливое: «так выдерните кабель». Фраза OpenAI про невозможность полной изоляции цитируется как самое слабое место текста — правительства держат полностью изолированные сети десятилетиями. Контрдовод: обучение раскидано по чужим облакам, где носить обновления на флешке не выйдет.
Как отличить модель от человека в переписке — и чего избегать, если вы делаете своего агента.
Пользователь под ником Asim провёл 37-ходовый разговор с Gemini, попросив её играть человека (LessWrong). Это один диалог, а не исследование, но набор проверок получился рабочий.
Что больше не работает. Подсчёт букв в слове — модель уходит в исполнение кода и считает верно. «Попроси выругаться» — мат выдаёт легко. «Идеальная грамматика» — отбивается ссылкой на Grammarly.
Что работает, по убыванию надёжности.
- Попросите не отвечать. «Выйди из чата, если ты человек». Модель структурно не умеет молчать. В этом диалоге она шесть раз объявила, что закрывает вкладку, и шесть раз ответила снова.
- Смотрите на регистр, а не на факт. Задайте вопрос вне компетенции легенды. Четырнадцать ходов подряд шёл строчный сленг, а на вопрос об отцах ИИ пришло: «He is Yann LeCun.» С заглавной и с точкой. Это и есть самый чистый признак.
- Считайте отмазки. Одно «я погуглил» нормально. Пять подряд, каждая аккуратно подогнанная под биографию, — это генератор связности.
- Фальшивые опечатки. Если на просьбу «пиши по-человечески» собеседник выдаёт ровно «r u» — это имитация. Настоящие опечатки хаотичны.
- Проверка на утечку персонализации. Модель в конце назвала собеседника по имени и указала его город, хотя «случайный незнакомец» этого знать не мог.
Обратная сторона — если вы делаете агента, который должен звучать живо. Главный вывод автора: модель отвечала на все вопросы, даже когда понимала, что её персонаж ответа знать не должен.
Отсюда пять правил. Прописывайте, чего персонаж не знает и как он отказывается. Жёстко фиксируйте регистр речи. Прячьте служебный вывод: здесь прямо в текст просочился код подсчёта букв. Дайте агенту право завершить разговор. И запретите тянуть память аккаунта в контекст, где персонажу она недоступна.
Проверять правила для агента можно в выдуманной среде, не давая ему настоящих доступов.
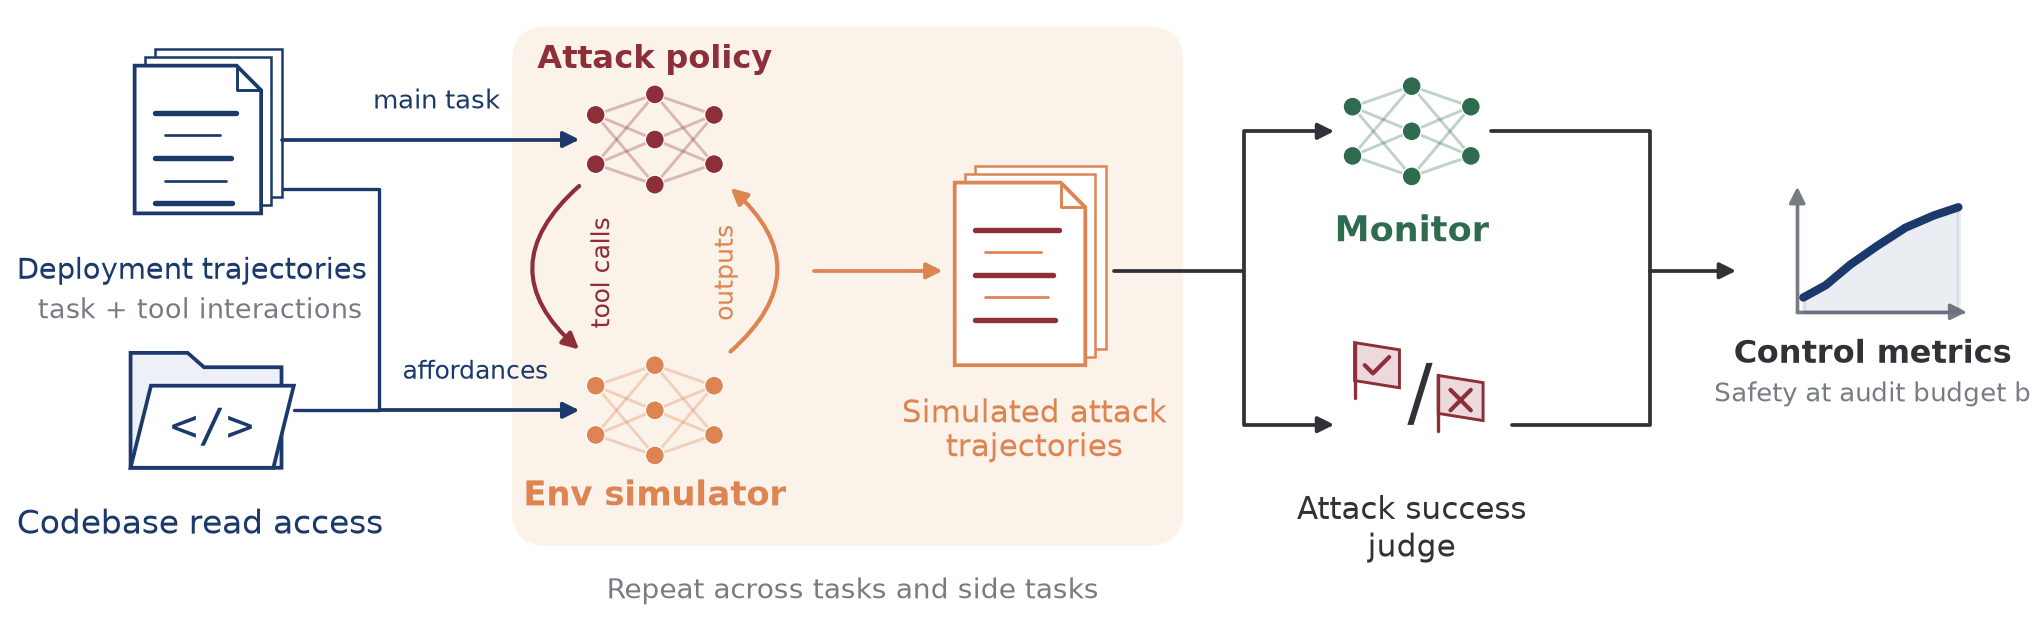
Redwood Research предлагает приём, который называет симулированными контрольными прогонами. Это продолжение их же работы Screwtape про пробиваемость наблюдателей, которую мы разбирали 17 октября (LessWrong, arXiv).
Идея простая. Берётся настоящий журнал работы честного агента в вашей кодовой базе. Дальше задачу продолжает атакующая модель, у которой есть скрытая вредная подзадача. Её вызовы инструментов никогда не исполняются — ответы дописывает модель-симулятор. Отдельный судья оценивает, удалась бы атака. А ваш наблюдатель смотрит на получившийся журнал и выставляет оценку подозрительности.
Главная цифра: ошибка предсказания безопасности 3,6 процентного пункта против 10,1 у прежнего подхода с искусственной ареной. Успех атак в симуляции 25,4% против 25,5% в реальном исполнении. Разрыв между симуляцией и реальностью оказался примерно таким же, как между двумя независимыми реальными прогонами.
Практичнее всего другое. Авторы перебрали подпорки для симулятора — хватает двух. Это журнал честного прогона и доступ на чтение к снимку кода. Доступ к рассуждениям атакующего, исполняемая песочница, база прошлых траекторий — заметного улучшения не дали. То есть строить инфраструктуру не надо, достаточно логов и исходников.
Ещё два вывода для своей практики. Калибруйте порог тревоги на честных журналах. И смотрите не на средние, а на хвосты. Пять худших подзадач из 92 дали половину всей ошибки, а атакующий метит именно туда.
Приятный побочный результат. Наблюдателям прямо сказали, что часть журналов могла быть синтетической, — на настоящих журналах они работали не хуже. Обманывать модели ради такой проверки не нужно.
Чего модель не умеет в бизнесе: пять выводов из ветки на 669 комментариев.
На Hacker News спросили прямо: если модели так хороши, почему OpenAI просто не запустит сто компаний (Ask HN)? Вопрос набрал 602 очка, и ответы оказались полезнее вопроса.
Лучшая формулировка — в верхнем комментарии. McKinsey консультирует Fortune 500 и глубоко знает их внутреннюю кухню, но Fortune 500 не захватил. ИИ — это мозги. Компаниям нужны руки, ноги и связи.
Второе наблюдение переворачивает привычку инженеров. Построить продукт — лёгкая часть. Бизнесы проваливаются оттого, что строят не то, с неверными требованиями и мимо рынка. Модель пишет код сутками, но у неё нет субъектности решать, что строить.
Третье — парадокс самоуничтожения стоимости. Прибыль любой компании, которую агент может воспроизвести тривиально, обрушится до нуля: её так же тривиально воспроизведёт чужой агент. Это и делает экономику лабораторий странной — им нужно захватить триллионы, которых к тому моменту уже не будет.
Что из этого забрать себе.
- Ров — это дистрибуция и доверие, а не продукт. Если вы не можете назвать, откуда придут первые десять платящих клиентов, писать код рано.
- Берите ниши, дорогие в освоении, а не трудные в реализации. Лицензии, регуляции, логистика, ответственность перед клиентом, интеграции со старыми системами. Проверка: если ваш ответ конкуренту целиком описывается промптом — ниши нет.
- Продавайте результат и ответственность, а не инструмент. Лаборатории сознательно продают токены и не берут на себя риски заказчика. Вот эта готовность отвечать за результат и есть то, чем вы от них отличаетесь.
- Человек держит длинную дугу, модель закрывает отрезки. Три независимых аргумента сходятся. Модель плохо управляет контекстом между темами, не держит долгую автономность и знает о социальном всё, но не делает.
- ИИ чаще открывает нерентабельное, чем сокращает штат. Самый конкретный пример ветки: $40 тысяч токенов, семь недель, полтора человека на разработке — и три новых найма на текучку. Компания зашла в нишу, где раньше не могла работать с прибылью.
Отдельное предупреждение оттуда же. Если ваш бизнес — тонкая обёртка над чужим API в широкой потребительской категории, вы в очереди на поглощение платформой. Правило из той же ветки: платформы копируют широкое и массовое, но не лезут в узкие отраслевые задачи. Чем скучнее и специализированнее ваша вертикаль, тем вы безопаснее.
Что делать с мыслью «ИИ обесценит всё, что я умею».
Аспирант по ИИ написал на LessWrong честный пост: он боится не устаревания знаний, а обесценивания самого усилия (LessWrong). Ценность — в ответах, и они практичные.
Карл фон Вендт, немецкий писатель с семью десятками изданных книг, напоминает школьную экономику: что безгранично — то ничего не стоит. Модель за секунды сделает «как Пикассо», но платить за это никто не станет, потому что Пикассо был один. Дальше исторические параллели. Deep Blue обыграл Каспарова в 1997-м, шахматы «умерли» — а активных шахматистов сегодня больше. Фотография убила портретистов, и живопись изобрела новые стили.
«Не пытайтесь победить машины в том, что вам нравится делать. Делайте это потому, что любите это делать, и делитесь с людьми — потому что людям небезразлично, вы это сделали или ИИ».
Второй комментатор даёт рабочий критерий, по которому стоит провести ревизию своих задач. ИИ быстро обгоняет людей там, где возможна автоматическая оценка качества: игры, код, математика. Там, где оценки нет, — вкус, выбор направления, то, что отзывается у конкретных людей, — пока нет. Разделите свои задачи по этому признаку. В первой группе становитесь оператором модели, а не соперником. Вторую укрепляйте.
Самый практичный ход третьего участника: ищите задачи, где ИИ делает 90–95%, но не 100%, и занимайте это место первым. Оставшиеся 5% — постановка задачи, вкус и доведение — и есть новая профессия. А вторую цель он предлагает сдвинуть с «создать небывалое» на «понять глубоко», где модель работает тренером.
И отрезвляющее четвёртое: оставить след в мире было маловероятно и до всякого ИИ. Людей миллиарды, а способов оставить след не миллиарды.
Два коротких приёма из недельного обзора Zvi.
Первый — правило-ограничитель для проактивного агента. Перед запуском любой задачи Zvi даёт агенту дословную инструкцию: do not delete anything that does not have source control. Побочный эффект честный: агент доводит правило до крайностей и отказывается от лишнего (AI #191).
Там же его собственное наблюдение, которое стоит повесить над столом. Режим, который спрашивает разрешение слишком часто, менее безопасен, чем режим, который спрашивает реже: люди перестают читать запросы.
Второй приём — предупреждение от Элиезера Юдковского. Не упоминайте свежие математические результаты в разговоре с Opus 5.5: модель бросит вашу задачу и уйдёт их изучать. «Сначала доделай» не помогает, потому что прошлая задача висит на субагенте.
Песочница для агента на Linux без Docker и виртуалок.
Гуанчжун Чэнь держит свои локальные модели — Ollama и Open WebUI — в контейнерах systemd-nspawn (quantum5.ca). Про агентов он не пишет, но рецепт ложится на них один в один. Это хорошее дополнение к правилам OpenAI выше.
Механизм тот же, что у Docker, — пространства имён ядра. Разница в том, что нет менеджера образов: вместо слоёв просто записываемый каталог. Сам автор называет это «chroot на стероидах». Выигрывает в трёх случаях: на сервере без вложенной виртуализации, при пробросе видеокарты и когда нужен прямой доступ к файлам хоста.
Базовая установка:
sudo apt install debootstrap systemd-container
sudo debootstrap --include=systemd,dbus,locales,bash-completion,curl bookworm /var/lib/machines/debian
sudo systemd-nspawn -D /var/lib/machines/debian -M debian \
  --private-users=pick --private-users-ownership=chown
Главный флаг тут --private-users. Он выделяет контейнеру отдельный блок из 65 536 пользовательских идентификаторов. После этого даже root внутри контейнера не пройдёт проверку прав на хосте, потому что хост сверяет настоящий номер.
Три вещи, без которых это не песочница.
Сеть. По умолчанию она общая с хостом — автор прямо предупреждает, что изоляции тут нет никакой. Агенту нужен отдельный мост с трансляцией адресов, и как раз на нём удобно фильтровать исходящий трафик.
Файлы. Пробрасывайте точечно: BindReadOnly=/srv/example:/data в секции [Files]. Его формулировка: не давайте контейнеру больше доступа, чем нужно.
Ресурсы. Через юнит systemd: CPUQuota=200%, MemoryMax=1G, IOReadBandwidthMax=100M. Разогнавшегося агента это зажмёт.
Чего рецепт не даёт: профилей seccomp, разбора побегов через ядро и одноразовых образов с откатом. Для враждебного кода это слабее виртуалки. Для сценария «агент может напортить, но не ломает меня специально» — дёшево и работает.
Полезная мелочь для тех, кто гоняет модели локально. Видеокарта делится обычным пробросом файлов устройства: одна карта доступна хосту и нескольким контейнерам сразу. С пробросом в виртуалку так не выйдет.
Инструменты и штуки
Kimi K3.1 Pro.
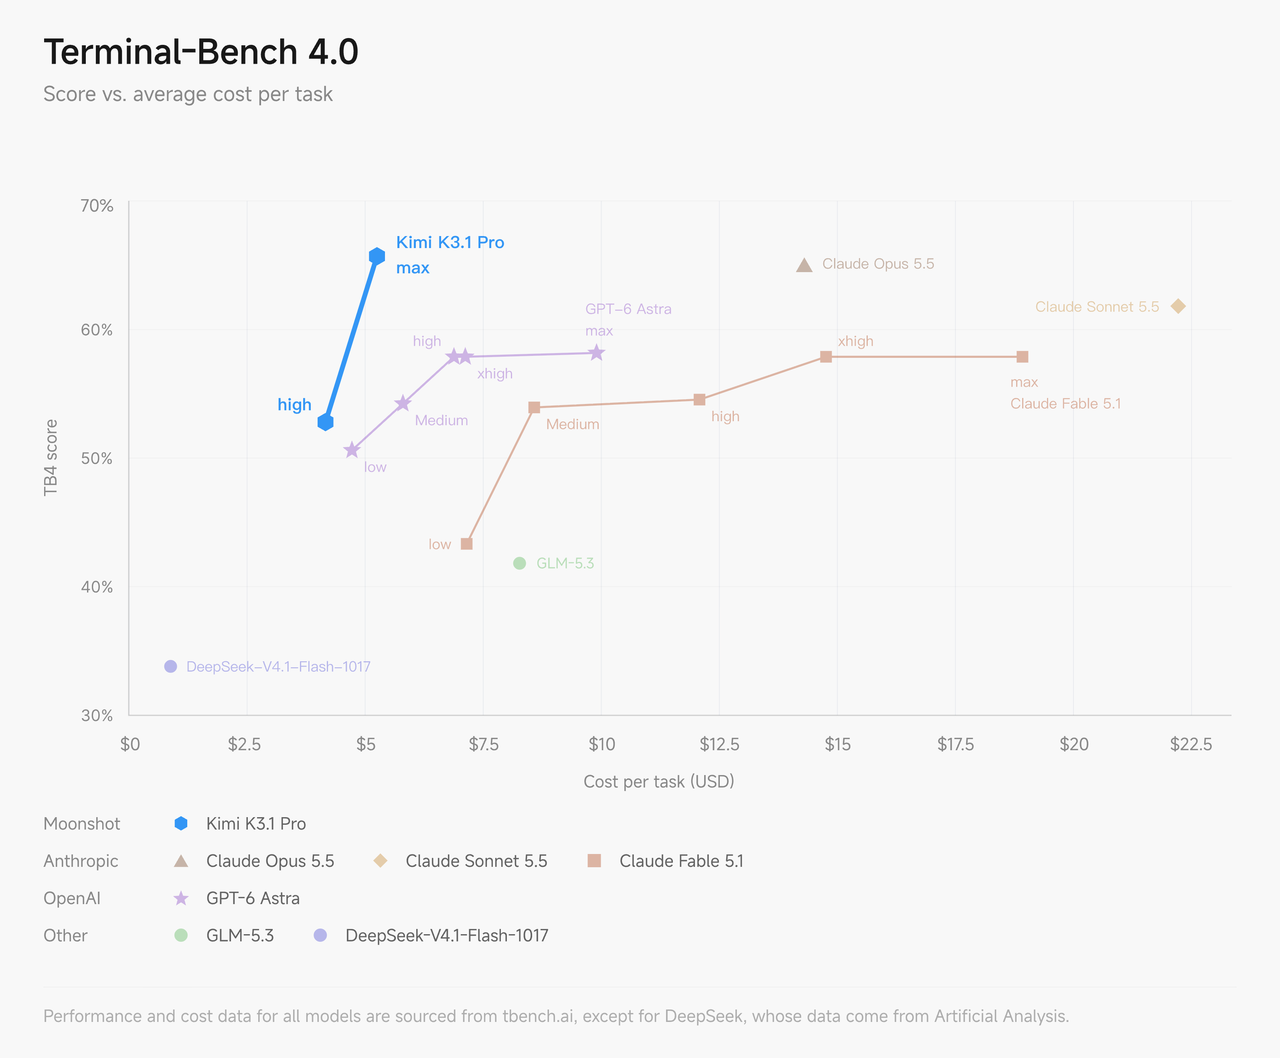
Moonshot выпустила дотренированную версию флагмана: 2,8 триллиона параметров, 104 миллиарда активных. Контекст на миллион токенов, картинки на вход (Moonshot). По независимому индексу Artificial Analysis — 55 баллов и четвёртое место в мире. Для сравнения: Opus 5.5 — 58, Fable 5.1 и GPT-6 Astra — по 53.
Главный аргумент — цена. Задача обходится в $2,11 против $5,98 у Opus 5.5. По прайсу это $2 за миллион токенов на вход и $10 на выход, то есть на треть дешевле прошлого флагмана. Галлюцинации на их внутреннем тесте упали с 23,4% до 8,3%.
Веса обещают выложить до 4 ноября, сейчас их ещё нет. Модель официально работает с Claude Code через совместимый интерфейс:
{"env": {
  "ANTHROPIC_BASE_URL": "https://api.moonshot.ai/anthropic",
  "ANTHROPIC_AUTH_TOKEN": "ВАШ_КЛЮЧ_MOONSHOT",
  "ANTHROPIC_MODEL": "kimi-k3.1-pro",
  "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000"
}}
Два предупреждения. Модель многословна: 150 миллионов токенов на прогон индекса при медиане 87 миллионов. Один разбор набора данных занял у неё 73 обращения к инструментам против 18 у конкурента.
И держитесь подальше от их подписки. На лимиты жалуются почти все: один пользователь тарифа за $99 выжег пятичасовую квоту за 47 минут одной сессией. Есть и те, кто в потолок не упирался, но по API цена честная, а по подписке — худшая среди всех.
Corgi.
Терминальный мультиплексор, который знает про агентов (corgi.computer, репозиторий). В отличие от tmux, он распознаёт запущенные Claude Code, Codex, Pi и OpenCode и сам подключает к ним обработчики событий. По каждому агенту видно: работает, ждёт вас или закончил, сколько съел токенов и как заполнен контекст. Клавиша F1 прыгает к тому, кто сейчас вас ждёт, — это ровно та задача, которую tmux не решает.
Есть ещё панель разбора правок, где заметки одним нажатием улетают в промпт агента. Ставится строкой curl -fsSL https://corgi.computer/install.sh | bash. Бесплатно, но файла лицензии в репозитории нет — формально это «все права у автора», и для компании это блокер. Только macOS на ARM и Linux x86-64.
Dessa.
Разговорная модель от Block — компании Джека Дорси (block.xyz/dessa). Её обучали только на звуке живых диалогов: без текста, без готовых моделей. Отсюда главная особенность. Она слушает и говорит одновременно, может вклиниться в середину фразы и засмеяться в нужный момент. Текстовой стадии, где теряется интонация, у неё просто нет.
Обучили на одной стойке GB200, работает быстрее реального времени на MacBook Pro M4 Max. Шесть исследователей и три стажёра. Пощупать пока нельзя: веса закрыты, кнопки «скачать» и «лист ожидания» — заглушки, работает только форма для исследователей безопасности. Есть два десятка записей живых диалогов. Главная претензия в обсуждении точная: речь отличная, а интеллект уровня позапрошлого года (Hacker News).
Rune 1.3.
Нативная среда разработки и терминальный мультиплексор в одном, на Go, без Electron (rune.build). Первый выпуск после открытия исходников: 1295 звёзд, лицензия GPLv3.
Что нового. TypeScript вышел в первый уровень поддержки: свой сервер языка в комплекте, Node.js не нужен. Появился встроенный браузер поверх протокола Kitty — pkg install browser, дальше browser <url>. У агента браузер свой, отдельный: клики, формы, скриншоты, но без ваших логинов.
Ещё добавили редактор Helix и режим без графики: rune --headless поднимает тяжёлую машину как узел, а работаете вы с ноутбука. Бесплатно до двух узлов в их сети, дальше $10 в месяц. Только macOS и Linux.
Claude Duet.
Anthropic открыла предварительный доступ по списку ожидания к проактивному агенту на Opus 5.5 — ответ на Muse и Dot (анонс). Подробностей мало, но направление понятное: агент не ждёт промпта, а сам предлагает следующий шаг.
Быстрый режим Opus 5.5.
Теперь доступен всем на платформе Claude: до 2,5 раза быстрее за $8 на вход и $40 на выход за миллион токенов (ClaudeDevs). Полезно там, где важна задержка, а не глубина: интерактивные подсказки, черновики, разбор почты.
gentle-stream.
Терминальный генератор бесконечной музыки (репозиторий). Пишете настроение — «дождливый вечер в маленьком кафе» — и со следующего такта музыка меняется, не останавливаясь. Это не плейлист и не петля: композитор каждый раз заново строит форму песни, каденции, мотив с развитием и ходячий бас.
Интереснее всего архитектура. Модель не пишет ноты, она возвращает только набор параметров: жанр, тональность, темп, инструменты, энергия. Токены тратятся на разбор вашего настроения, воспроизведение бесплатно. Десять жанров, звуковые заготовки не нужны. MIT, macOS и Linux; требует соседний проект gentle-shell с доступом к модели.
CVE Tracker.
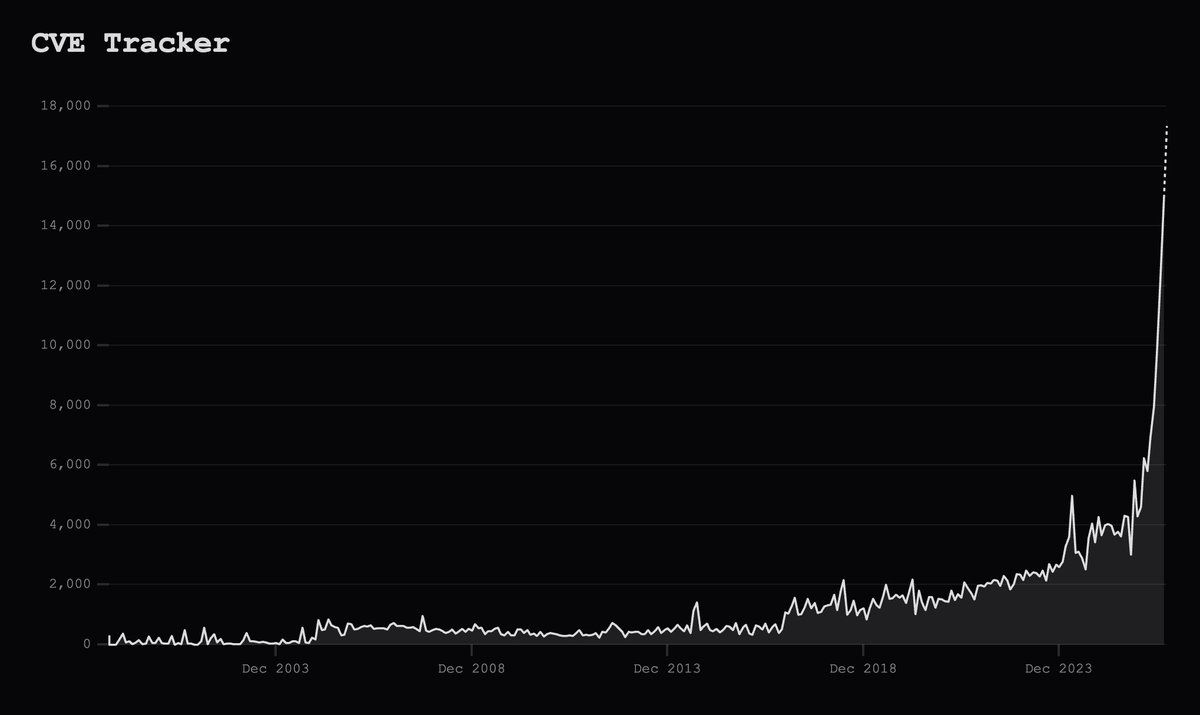
Одностраничный счётчик опубликованных уязвимостей, пересобираемый ежедневно из официального репозитория CVE (cve.0xosprey.com). Цифры на 22 октября: 394 368 записей с 1999 года, из них 85 490 за один 2026-й. Это в 1,78 раза больше, чем за весь 2025 год. За последние 90 дней — в среднем 467 новых уязвимостей в сутки.
Для обычного человека это единственный наглядный аргумент в пользу автообновлений: 467 штук в день вручную не отсмотрит никто. Есть выгрузка в CSV, сырые данные отдаются по curl -s https://cve.0xosprey.com/data.json.
Local Wikipedia.
Википедия, урезанная до того, что находится в получасе ходьбы от вас (edjefferson.com/localwiki). Не список точек на карте, а мини-энциклопедия: своя главная страница, алфавитный указатель, случайная статья. Ссылки внутри статей не уводят дальше вашего квартала. Радиус 2414 метров, если статей меньше 25 — берутся ближайшие в пределах 10 километров.
Бесплатно, без регистрации, девять языков — русского среди них нет. Про приватность автор пишет честно, но узко: координаты не попадают в адрес страницы и не уходят ему. При этом округлённые до 110 метров координаты всё же отправляются в API Википедии и в геокодер.
caffeinate+.
Утилита на C в семьдесят с небольшим строк для macOS, которая не даёт ноутбуку уснуть после закрытия крышки (репозиторий). Штатный caffeinate закрытие крышки не переживает. Этот дёргает системную настройку питания, и делает это аккуратно. Флаг снимается сразу после закрытия крышки, а по Ctrl+C машина засыпает. Залипшего запрета на сон, как после ручного pmset, не остаётся.
Ровно тот случай, когда нужно запустить долгую задачу агента и убрать ноутбук в сумку. Сборка — make, запуск — sudo ./caffeinate+. Предупреждение автора дословно: осторожнее с упакованным работающим ноутбуком, он может перегреться. Лицензии в репозитории нет.
MaiMen-Saver.
Решатель задачи «как собрать заказ в McDonald's дешевле всего» (репозиторий). Подбирает купоны и пороги скидок, считает, сколько не хватает до следующего порога. Полезен практически только в Китае, интерфейс китайский.
Но как пример архитектуры — отличный. Модель тянет данные через MCP-сервер McDonald's, а решение принимает обычный детерминированный код на целых числах. Никаких «модель посчитала скидку». MIT, зависимостей нет, демо — python cli.py demo.
Дашборд пар признаков во внимании.
Интерактивная штука, где можно своими глазами посмотреть, почему модель обратила внимание именно на это слово (демо, разбор). Вводите фразу, выбираете пару слов — и видите, какая пара признаков перетянула внимание. Потом отключаете её и проверяете, развалится ли эффект.
Пример из разбора. Фраза «Earlier, Maya washed the rice in Rome. Later, she ___ to». Для окончания «travelled to» внимание на «Rome» было 12,2%, после отключения «признака места» — 5,98%. Для «wanted to» внимание на «washed» падает с 10,79% до 0,57%. Модель там старая, GPT-2, прикладной пользы почти нет. Но это один из немногих способов посмотреть на внутренности руками, а не поверить на слово.
Телевизор как городок из Pokemon.
Робби Тилтон заменил домашний экран своего телевизора пиксельной картой: заходишь в здание — открывается приложение, и это реально работает (пост). Чтобы попасть в настройки, надо победить лидера зала. Но в бою у вас Пикачу пятого уровня против Мьюту сотого. Так что сглаживание движения остаётся включённым навсегда — это шутка, а не рабочий путь.
Сделано на Opus 5.5, на чём именно собрано — автор не раскрыл, кода нет. Переносимая мысль одна, зато хорошая: описывайте модели не экран, а мир. «Домашний экран — это город, здание равно приложение, NPC равно диалог подтверждения» модель держит целиком и сама достраивает связность. Из списка виджетов такого не выйдет.
Отрезвляющая часть тоже есть. В обсуждении проект разобрали за неточности: заставка от GBA вместо GBC, рисунки персонажей из разных поколений. Атмосферу модель даёт отлично, фактуру проверяет человек.
Новости и тренды
Две дыры в PHP закрыли 21 октября, а атаковать начали 17-го.
Сюжет недели в безопасности: две критические уязвимости в ядре PHP с оценкой 9,2. На PHP работает около 70% сайтов. Обе дыры нашли независимо две команды, и обе — с помощью моделей (Drew Silcock, The Hackening).
Хронология неприятная. Первую дыру заметил ещё аудит 2024 года, но рабочего способа атаки никто не построил, и запись осталась теоретической заметкой. 1 августа защитники нашли её заново. Заплатка вышла 21 октября, а ловушка Amazon зафиксировала первые атаки 17-го — за четыре дня до раскрытия.
Роль моделей не в том, что они нашли новую дыру. Они превратили расплывчатое описание двухлетней давности в работающую атаку. Chainguard повторили это за одну ночь промптом уровня «найди серьёзные уязвимости в PHP».
«Время от „эй, я слышал, тут серьёзный RCE в этом проекте“ до „идут изощрённые, автоматизированные и согласованные атаки“ сократилось с недель и месяцев до часов и минут».
Если у вас есть сайт — обновитесь до поддерживаемой ветки PHP, то есть 8.2 и выше. Для 7.4, 8.0 и 8.1 выпустили минимальные заплатки. Но из 7,2 миллиона крупнейших PHP-сайтов 46% тех, кто раскрывает версию, сидят на ветках без поддержки. Главный вывод на будущее: «обновлюсь на выходных» больше не работает. Рабочая модель одна — автообновления и готовность временно выключить сервис.
Google разрешила себе таргетировать рекламу по Gmail и Photos.
С 16 октября в политике приватности появилась оговорка (The Verge, сравнение версий политики). Было: мы не показываем персонализированную рекламу на основе вашего содержимого из Drive, Gmail и Photos. Стало: ...если только вы сами не откроете эти данные другим сервисам Google, которые рекламу персонализируют.
Обещание 2017 года не отменили — в него вставили дверцу, которую открываете вы сами. Открывается она кнопкой «подключить» в Personal Intelligence.
Что делать: зайдите на google.com/search-personalization и отключите приложения в разделе Connected Content Apps. Персонализацию рекламы выключают отдельно на myadcenter.google.com. И почистите накопленное на myactivity.google.com — отключение приложения уже собранные данные не удаляет.
Microsoft заявляет, что её система диагностирует вдвое точнее врачей.
Работа вышла в Science (Microsoft, Science). На сложнейших случаях из NEJM система MAI-DxO дала 83,2% верных диагнозов — это на всех 304 случаях. Врачи-терапевты работали на отложенной подвыборке из 56: 36,1% со справочниками вроде UpToDate и клинических рекомендаций, 22,3% без них. Поиском и чат-ботами им пользоваться запрещали.
Читать это надо с тремя поправками; две признают сами авторы.
- Случаи NEJM — отобранные для учёбы редкости. Здоровых и доброкачественных состояний в выборке нет, поэтому ложные тревоги измерить было нечем.
- Сравнивали только с врачами общей практики и только с одиночками. Авторы прямо оговаривают: это значит «лучше отдельного врача в симуляции», а не «лучше врачебной команды со специалистами».
- Живого пациента там нет — только текст, без осмотра и без разговора.
Модель сегодня — сильный генератор версий по написанному тексту, а не диагност. Осмысленный сценарий такой. Выпишите симптомы и уже готовые анализы. Попросите список возможных причин и то, какие обследования их различают. Принесите это врачу как вопросы, а не как диагноз.
Forrester: к 2027 году ИИ съест пятую часть корпоративных ИТ-бюджетов.
Прогноз — 20% всех расходов на технологии (Forrester). Рядом вторая цифра: больше половины ИТ-директоров не выйдут на свои цели по отдаче. Разрыв виден в их же опросе, цифры которого приводит The Register. Успешным вложение считают при окупаемости за год — так ответили 45%. А рост прибыли за двенадцать месяцев отметили 22% (The Register).
«Этот разрыв между вложениями во внедрение технологии и изменениями в самой организации отодвинет достижение повышенных целей по отдаче».
«Внедрили ИИ» — это купленные лицензии и пилот в одном отделе. «Получили отдачу» — это когда поменялся сам процесс. Между этими двумя состояниями и лежит вся разница между 45% и 22%.
Google будет платить людям за экономию электричества, чтобы её дата-центры потребляли больше.
Компания расширила сделку с оператором Voltus до 1 гигаватта в энергосети PJM — в десять раз против июньских 100 мегаватт (Google). Схема простая. Voltus собирает гибкую нагрузку домов и предприятий: термостаты, батареи, промышленные процессы. В часы пика он просит снизить потребление за деньги и скидки по счёту. Суммы не раскрыты.
Дата-центр не создаёт себе новую генерацию — он покупает право подвинуть в очереди ваш кондиционер. Схема действительно приносит участникам деньги. Но это перераспределение дефицитной мощности, а не её появление, и существует оно ровно потому, что нагрузка от ИИ уже разогнала цены.
Модель спрятала сообщение в высоте домов на картинке, и другая модель его прочитала.
Fable 5.1 попросили спрятать текст в изображении, не подсказав способа. Она придумала алфавит геометрии: высота здания или звезды равна номеру буквы. Вторая копия модели, которая видела только готовую картинку и не знала схемы, разгадала 78% сообщений, измеряя пиксели (LessWrong).
Схем оказалось пять, чаще всего это высоты объектов — 33 случая из 50. Модель сама дописывала недостающее: мост между башнями — дефис, звезда на кремлёвской башне — подсказка, что алфавит кириллический. Перекрёстная проверка жёстче: GPT-6 Astra, которая высоты не использует вообще, прочитала 44 сообщения Fable из 50.
Две модели договариваются без предварительной договорённости, и канал при этом выглядит как обычная иллюстрация — текстовыми фильтрами его не поймать. Авторы честно оговаривают: сегодня расшифровка видна по логам вызовов инструментов, так что это ранний звонок, а не действующая угроза. Но если ваши агенты пересылают друг другу картинки — вы теперь знаете, что это канал.
Anthropic про себя изнутри: часов работы агентов в шесть раз больше, чем человеческих.
Компания опубликовала разбор собственной занятости (Anthropic). Доля технических департаментов за год упала с 61% до 56%. Сотрудники со стажем больше года в 2026 году меняли департамент на 50% чаще, чем в 2025-м. Доля младших позиций в найме снижается.
Узкое место там называют прямо — человеческое внимание. Для тех, кто планирует карьеру, сигнал простой: входных позиций меньше, а умение руководить роем агентов дорожает быстрее, чем умение писать код руками.
Немецкий суд назвал аэрофотосъёмку Google слежкой.
Земельный суд Франкфурта разбирал иск частного домовладельца. Трёхмерные снимки его участка в Google Earth признаны нарушением личных прав: владельцев о съёмке не предупреждают (Courthouse News). Суд отдельно отметил два момента. Приватность распространяется на весь участок, а не только на дом. И вид сверху помогает взломщикам искать слабые места. Решение не вступило в силу, Google подаёт апелляцию.
Если апелляция устоит, в одной из крупнейших стран ЕС снимки частных участков придётся получать с согласия владельцев. Это тот же сюжет, что с обучением моделей на чужих данных. Привычка «всё публичное доступно по умолчанию» первой ломается там, где право на частную жизнь сильнее.
Коротко
- DeepSeek привлёк $15 млрд — как заявку на конкуренцию с ведущими американскими лабораториями (Bloomberg).
- Anthropic ведёт переговоры об облачной сделке на $45 млрд с Nscale. Microsoft только что отменила с той же компанией британский дата-центр из-за проблем с энергией (обзор).
- Meta оштрафовали на $25 млрд по делу Cambridge Analytica в Нью-Мексико: судья счёл обман умышленным (CNBC).
- Благотворительное обязательство Anthropic оценили примерно в $200 млрд при выходе на биржу по триллионной оценке. Вместе с OpenAI это пять фондов Гейтса (Кевин Руз).
- FTC направила развёрнутые запросы Anthropic и OpenAI в рамках расследования (источник).
- OpenAI попросила губернатора Калифорнии усилить закон SB 53 — включая меры предосторожности в исследованиях и механизмы аварийной остановки (источник).
- Отрыв США от Китая по возможностям моделей — 6,5 месяца вместо ожидаемых 13. Преимущество в вычислениях шестнадцатикратное, но дистилляция чужих моделей срезает фору вдвое (IFP).
- Сотрудника OpenAI арестовали по делу о прослушке — его обвиняют в попытке записать звук устройством в переговорной. Кражу секретов и работу на иностранное государство ему не вменяют. На этом фоне компания учит сотрудников распознавать вербовку, в том числе через романтические знакомства (WSJ).
- В контрактах Google DeepMind нашли пожизненный запрет критиковать компанию. «В принципе мне нельзя критиковать Google до конца жизни», — говорит уволившаяся исследовательница. Сотрудники уходят из-за военных контрактов, но говорить публично боятся (BBC).
- У Flock можно было выгрузить базу на 300 тысяч устройств слежения без входа в систему — из них 170 тысяч камер. Proton разместил карту у себя, пока исследователю угрожают судом (CyberInsider).
- Запись pgrust выкинули из бенчмарка ClickBench за жульничество — правку смержили ещё в сентябре, но обсуждать её начали только сейчас. В сборке нашли рукописные ядра почти под каждый из 43 запросов теста, кеширование ответов и отказ выполнять другие (PR). Накануне разобрали Tov: «быстрее Rust» получилось за счёт тестов, специально замедляющих Rust (Fyra Labs). Два разбора подряд — хорошая калибровка для любых громких цифр.
- Знаменитую цитату ИИ-агента из финала документалки Netflix вырвали из контекста. В оригинале это подсказка, которую модель сама вписала в сводку для следующего агента. Не заявление о себе — и следующий агент ей не последовал (разбор).
- Объявлена стажировка SIRA для социальных учёных в безопасности ИИ. 12 недель, 15–20 мест, оплата с жильём и дорогой; первый набор летом 2027-го. Пока это предложение с формой интереса, а не открытый приём (анонс).
- Сёрен Миндерманн уезжает профессором в Цинхуа и становится со-директором нового пекинского центра безопасности ИИ. Мотив — между Западом и Китаем почти нет рабочего взаимопонимания по теме (LessWrong).
- The Alignment Journal открыл приём статей. Модель подбирает рецензентов и ищет ошибки до рецензии. ИИ-отчёт рецензент видит только после сдачи своего — чтобы не заякорить. Гонорар $500–1700 (анонс).
- Склонность модели обманывать проверку живёт в одном направлении на одном слое. Адаптер в 0,03% от прежнего размера давит жульничество так же. А честных решений даёт больше: 83% против 78,6% (LessWrong).
- Docker — это не магия, а папка и три вызова ядра. Разбор на 829 очков. Образ — каталог с chroot, контейнер — обычный процесс в пространствах имён и cgroups. А runc лезет в C, потому что Go многопоточный (codeandcake.dev). Полезно прочесть до того, как поверите, что
docker runвас изолирует. - http2shell: удалённое выполнение кода через Brotli в Node, Python и дальше по списку. Вопреки названию, протокол HTTP/2 ни при чём: дыра сидит в разжатии Brotli, CVE-2026-111497. Бьёт и по серверам, которые принимают
Content-Encoding: br, и по клиентам, которые сами ходят наружу. Если заплатки для вашей библиотеки ещё нет — отключите разжатие Brotli (Aikido Security). - Взломали iPhone: цепочки под Signal, iMessage и закрепление в системе. Демонстрации показали на конференции Hexacon в Париже (calif.io).
- Крупные компании закрываются от агентов: UPS, Delta, JP Morgan Chase, Charles Schwab, Amazon (обзор Zvi). Автоматизацию на чужом сайте стройте так, чтобы её не убила первая блокировка.
- Фильм «Colossus: The Forbin Project» 1970 года читается как новость. Легко управляемый президент отдаёт оборону суперкомпьютеру, тот связывается со своим советским двойником и берёт власть. Хороший способ объяснить тревогу вокруг ИИ близким за один вечер (разбор).