62% против 42%. Столько верных диагнозов рака кожи набрали свёрточная сеть 2015 года и две передовые модели — GPT-6 Astra и Claude Fable 5.1. Сеть дерматолог дообучил сам: двадцать минут на одной видеокарте. Урок дня: универсальная модель не заменяет специализированную, зато ошибается безупречно гладким языком. Ещё внутри — почему агент глупеет от длинного чата. И куда делись 80% вашего счёта за токены.
Внедряем и улучшаем
Агент поглупел? Удалите контекст.
Дрю Бройниг выложил целиком свой доклад с конференции AGNTCon — лучший на сегодня разбор того, почему агенты ломаются (dbreunig.com). Главная мысль в одной фразе: в длинный контекст влезает больше информации — и ровно столько же лишних ошибок.
Порог тревоги у автора — около 200 тысяч токенов. При 250 тысячах перед большой задачей он просто сбрасывает сессию. На вопрос залу «кто доводит контекст до миллиона, когда кодит?» руку подняла половина зала. Когда кто-то жалуется «Claude занерфили», Бройниг первым делом спрашивает про размер контекста. Обычно этого хватает.
Шесть способов, которыми контекст убивает работу:
- Отравление. В контекст попала галлюцинация, и модель больше не может от неё избавиться. Живой пример: Gemini 2.5 Pro играла в Pokémon Red, где охраннику нужно отдать лимонад. В ремейке 2004 года там холодный чай, и «чай» сидел у модели в весах. Она часами искала чай и вносила его в свой список дел.
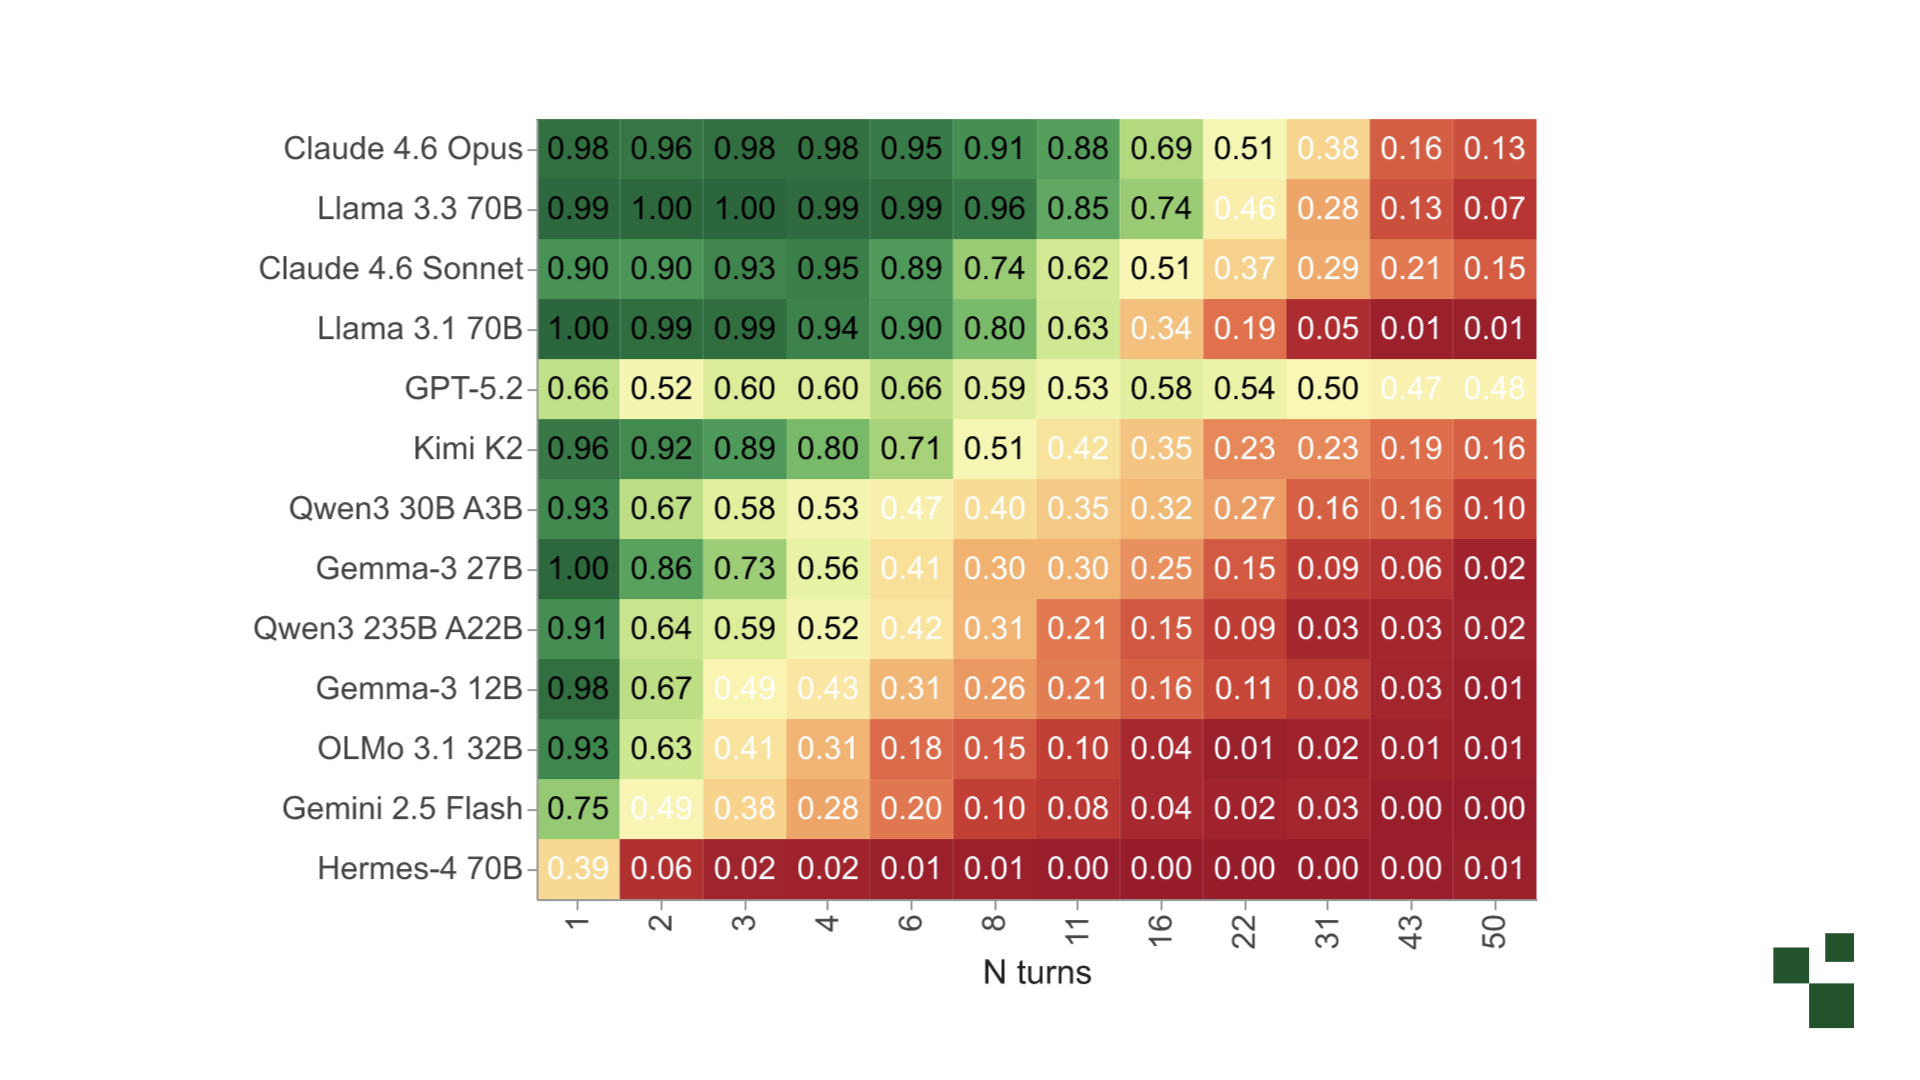
- Отвлечение. История разрастается, и модель начинает подражать примерам из чата вместо прямой инструкции. Это измерено: в работе Do as I Say, Not as I Do моделям велели переводить на русский, а в историю подкладывали чужие ответы по-французски. Claude 4.6 Opus держится дольше всех, но после пятидесяти таких ходов следует инструкции в 13% случаев. Gemma-3 12B сыпется после трёх.
- Путаница. Посторонние факты из памяти ассистента просачиваются в ответ. Автор поэтому память в ChatGPT и Claude держит выключенной: рабочие дела и домашний проект с сыном смешиваются в одну кашу.
- Конфликт. Инструменты, скиллы и инструкции внутри обвязки начинают противоречить друг другу.
- Борьба с весами. Модель натаскали на один набор инструментов, а у вас другой — и она упрямится. Диагностический признак железный: откройте промпт, и если там повторы и КАПС, значит, автор воевал с весами. В системном промпте Claude Code просьба вызывать инструменты параллельно повторена семь раз.
- Инерция контекста. Модель вцепилась в гипотезу и не отпускает. На прошлой неделе на это независимо наткнулись четыре команды. В одном прогоне агент часами чинил версии пакетов, а баг был в несовместимой точке API.
Лечится всё это шестью приёмами, и они не поменялись с прошлого года. Пополнение контекста — RAG и скиллы. Подбор снаряжения — показывать модели только нужные инструменты. Карантин — отдавать подзадачу свежему агенту с пустой историей. Обрезка — выкидывать отработавшие вызовы. Выгрузка — хранить состояние в файлах, а не в чате. Сжатие — сворачивать старое в бриф.
Два приёма стоит унести прямо сегодня. Первый — подбор снаряжения. У одной крупной компании агенты внезапно стали работать отвратительно; корпоративный софт грузил каждому инженеру 600 скиллов при старте. Если у вас подключена гора MCP-серверов, половина из них для текущей задачи — чистый шум.
Второй — забывание по таймеру. В обвязке Memento у Anthropic агент каждые полтора часа пишет короткую заметку, после чего его контекст стирают целиком. Окружение и сделанная работа остаются, исчезает только диалог.
В работе Шанъиня Таня из Беркли четыре агента с тремя сбросами памяти набрали 1 144 695 очков. Те же четыре агента без сбросов — 1 007 073. Одиночка — 961 136. Каждый сброс даёт новый скачок.
И ещё одно наблюдение автора, которое объясняет половину вечерних мучений. Вы час правите один компонент туда-сюда, и каждая неудачная попытка остаётся в истории как пример поведения. Модель начинает подражать вашим же ошибкам. Проще начать заново с чистого листа, чем дожимать.
Счёт за модели упал вчетверо. Вот где лежит ваша экономия.
Макс Вулф разобрал, почему OpenAI и Anthropic за несколько месяцев срезали цены до 80% (minimaxir.com). Главный вывод практический, и он не про заголовочный прайс.
При агентной работе с кодом 96–99% ваших токеновых расходов — это чтение кэша. В кэше лежит весь предыдущий диалог, и он подставляется на каждом ходу. Попадание в кэш — 90–100%. Поэтому снижение цены кэша на 75% срезает реальный счёт на 70–75%, хотя в прайс-листах эта строка обычно идёт сноской.
Смотрите на долю кэша от входной цены. Было нормой 10%: Fable 5 стоил $10 за миллион входных токенов при $1 за чтение кэша. Стало 2,5% у Fable 5.1 и 5% у Opus 5.5 и GPT-6.1 Sol. У DeepSeek — 2%. Вот почему две модели с одинаковым ценником «$10 / $50» обходятся вчетверо по-разному. GPT-6 Astra вышел по цене Fable 5.1, но дешёвого кэша не получил.
Как цены ехали вниз по факту: GPT-5.6 Luna в июле подешевел на 80% — с $1/$6 до $0,20/$1,20. Opus 5.5 в сентябре встал в $4/$20/$0,20 против $5/$25/$0,50 у Opus 5. Суммарно это минус 40–60%. GPT-6.1 Sol — $2/$10/$0,10, и всё семейство с июня подешевело на 75%.
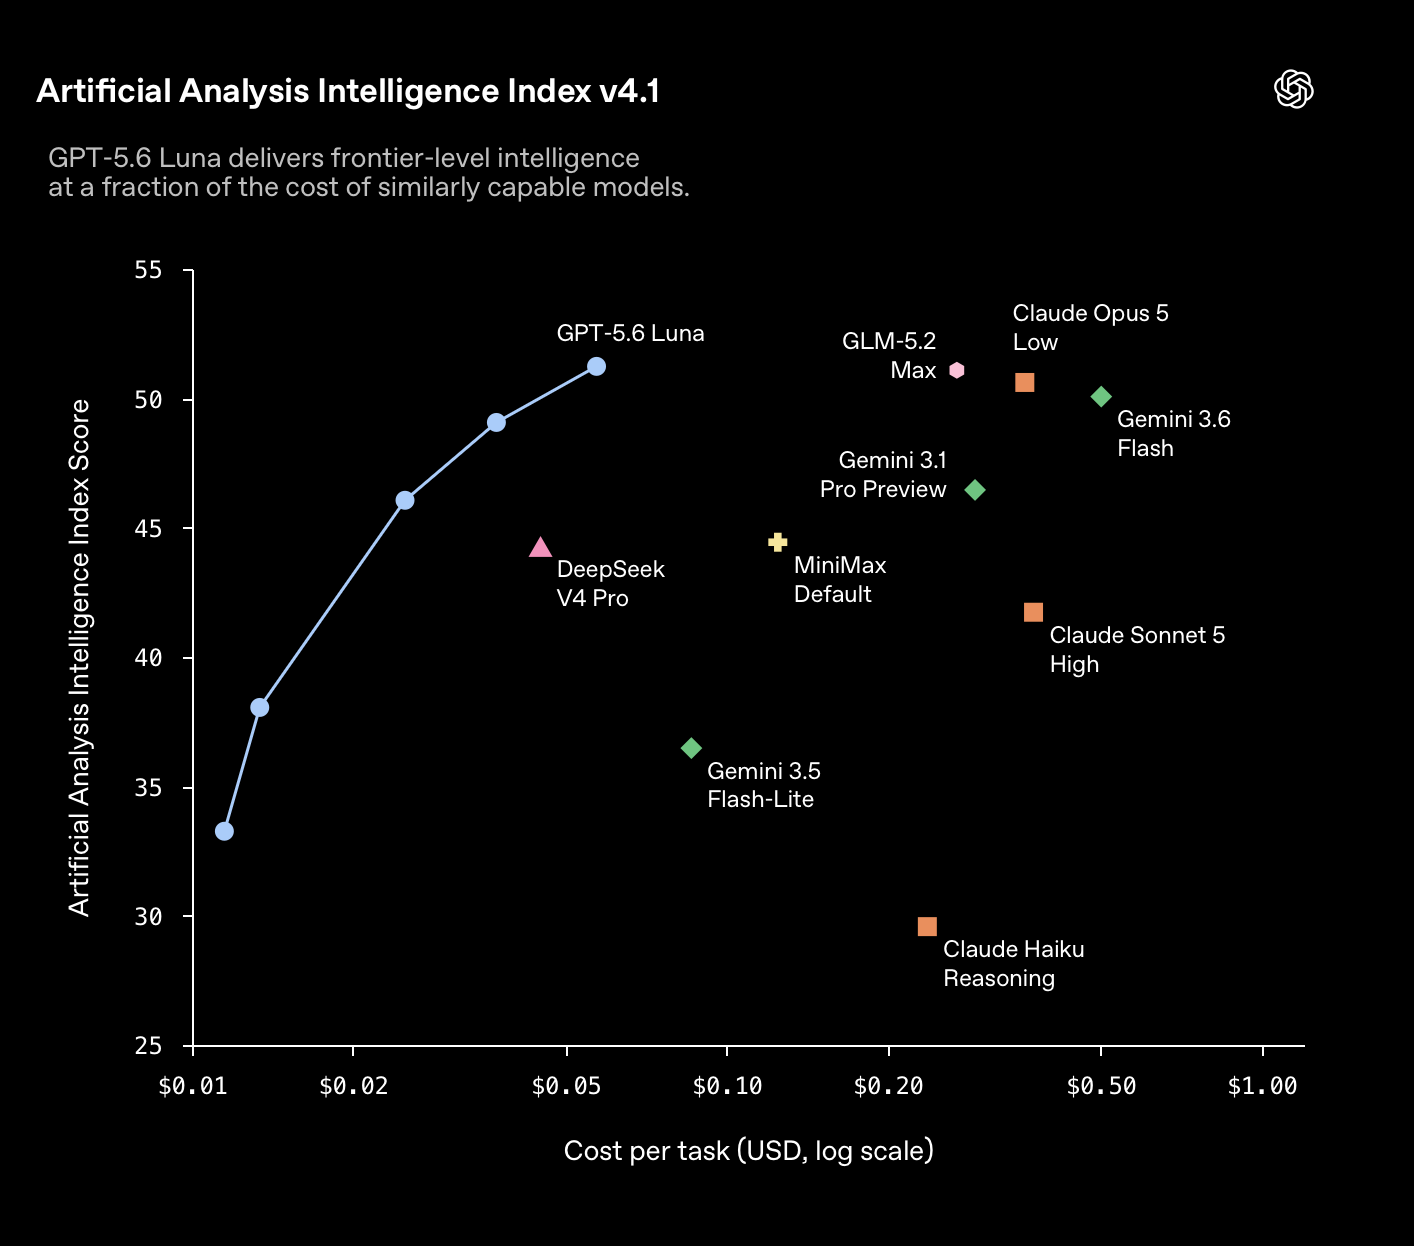
Причина падения не в доброте, а в DeepSeek и открытых весах. DeepSeek V4 Flash с апреля берёт $0,0028 за чтение кэша — это 2% от входа. Обновлённый V4.1 Flash раздают уже 29 провайдеров на OpenRouter, и у Cloudflare с DeepInfra цена в пределах 10% от официальной. Kimi K3.1 Pro набирает 55 баллов индекса Artificial Analysis против 58 у Opus 5.5 — при половинной цене. Веса обещают выложить 4 ноября.
Три вещи, которые стоит сделать по итогам. Первое: при выборе модели считайте эффективную цену — цену кэша, умноженную на долю попаданий, а не цифры из заголовка прайса. Второе: на OpenRouter можно прямо задать предпочтение «самый дешёвый провайдер», переключение почти ничего не стоит. Третье, и самое важное: падение цены конвертируйте в понижение тарифа, а не в рост потребления. После выхода GPT-6.1 Sol автор срезал квоту в Codex впятеро. По деньгам вышел в ноль.
Отдельное предупреждение про подписки. В день выхода GPT-6.1 Sol OpenAI урезала лимит тарифа за $200 вдвое. Формулировка: «чтобы отразить наши всё более эффективные модели». Формально безупречно. Практически: когда у компаний кончится запал, резать будут ценность подписки, а не цену API.
Менеджер над моделью добавил 25 пунктов точности. Но заголовок всё равно врёт.
Репозиторий GVS5H разошёлся по лентам как «пять Qwen догнали Fable 5 за 9% цены» (github.com/slee-persis/GVS5H). Разберём честно, потому что сама идея отличная, а цифры в пересказе склеены из двух разных строк таблицы.
Что там на самом деле. Берут одну модель и обвешивают её ролями. Менеджер пишет план. Исполнитель проводит мозговой штурм без единой строчки кода. Менеджер сводит всё в список задач и выдаёт ровно одну. Другой исполнитель её делает.
Роли не разговаривают друг с другом — они обмениваются файлами в общей папке: task.md, plan.md, notes.md, solution.py. Каждый вызов стартует с пустым контекстом и читает состояние с диска. Это тот же карантин контекста, только доведённый до предела.
Самая важная деталь — проверка. Обвязка сама прогоняет решение на публичных тестах. Вердикт перебивает мнение менеджера: сказал «готово», а тесты упали — значит, не готово. Чини или меняй подход. Плюс предохранитель от топтания на месте: если менеджер выдал ту же задачу второй раз, цикл останавливается.
Результат на ста свежих сложных задачах LiveCodeBench, по пяти прогонам:
- Qwen3.8-27B: 66,8% в один вызов → 92,4% с менеджером. Плюс 25,6 пункта.
- Qwen3.8-Flash-Next: 84,2% → 93,0%.
- GPT-5.6-Luna: 70,4% → 81,2%.
- DeepSeek-V4.1-Flash: 88,4% → 92,0%.
- Claude Fable 5 одним вызовом: 90,4%.
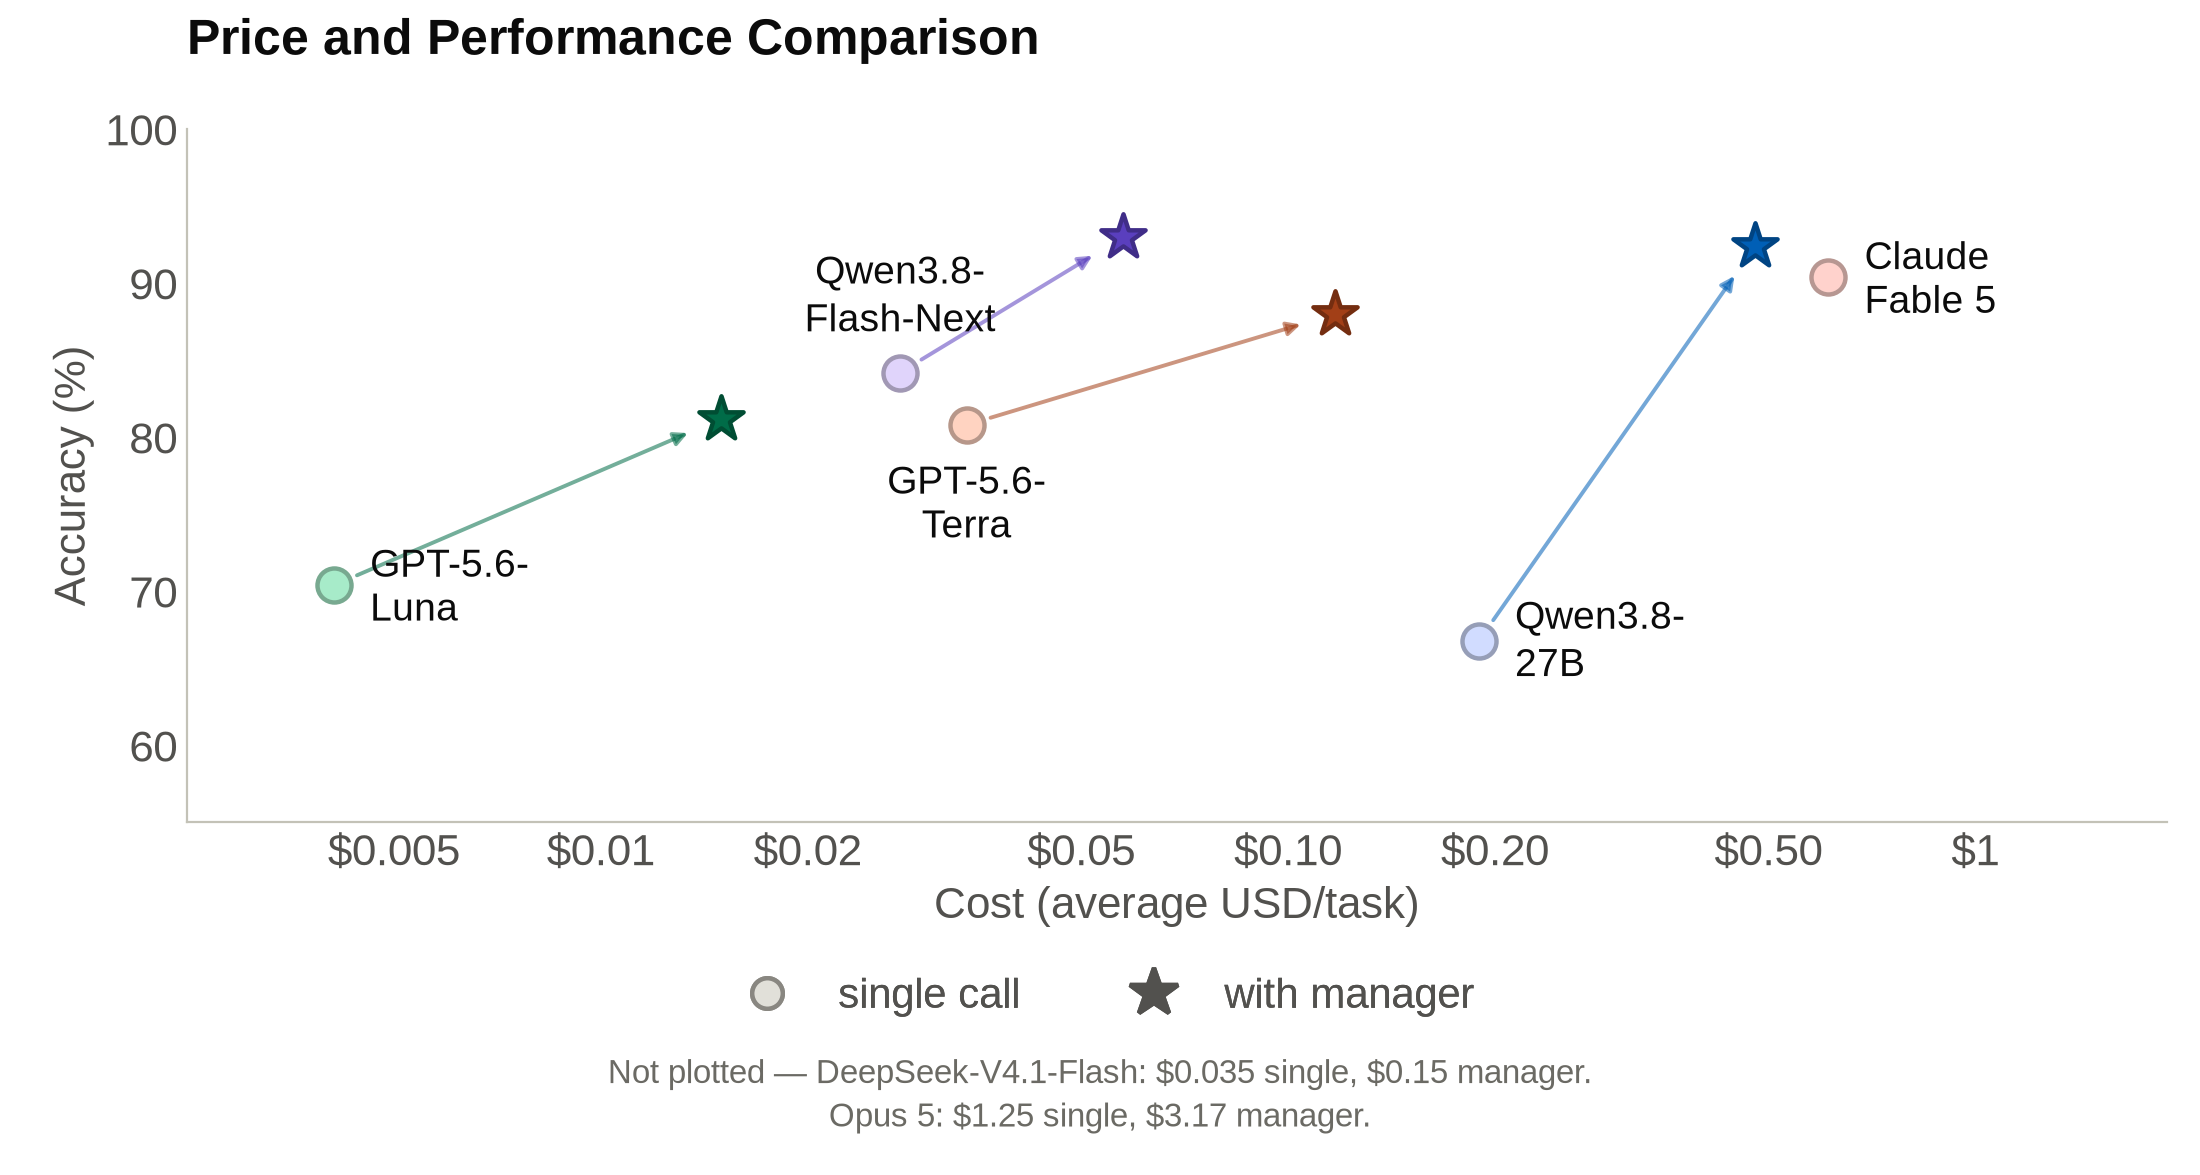
Теперь о том, чего в пересказах нет. Обгон Fable 5 статистически не значим: p = 0,88 и 0,56, нижняя граница интервала уходит в минус. Корректная формулировка — «сравнялись», а не «обогнали».
«Девять процентов цены» относятся не к Qwen3.8-27B, а к Flash-Next: $5,76 за прогон против $61,11 у Fable 5. Сам 27B с менеджером стоит $47,82 — это 78% цены, а не девять. И авторы сами пишут: поднимите ставку за Qwen на 28% — а это внутри реального разброса между провайдерами — и ценовое преимущество исчезает полностью.
Менеджер умеет делать и хуже. В разобранном авторами случае мозговой штурм нашёл ту же оптимизацию, что и одиночный вызов. Потом сам себя отговорил: рискованно. Выбрал план помедленнее — и исполнитель реализовал его с багом.
Что унести себе, даже не трогая репозиторий. Разбейте работу на роли с чистым контекстом у каждой. Общайтесь между ними через файлы, а не через один разрастающийся чат. И вставьте в цикл настоящую проверку — запуск тестов, а не мнение модели о собственной работе. На слабой открытой модели это даёт плюс двадцать пять пунктов; на сильной — около трёх.
Сеть 2015 года обошла передовые модели в распознавании рака кожи.
Доктор Магнус Линч, дерматолог и Mohs-хирург в лондонской больнице Гая, поставил аккуратный эксперимент (lynchlab.net). 200 поражений кожи из публичного набора MILK10k, все подтверждены гистологией. На каждое — два снимка: обычное клиническое фото и дерматоскопия.
Счёт по верному первому диагнозу из шести вариантов: GPT-6 Astra — 84 из 200, Claude Fable 5.1 — 85, старая Inception v3 — 125. Это 42%, 42% и 62%. Случайное угадывание дало бы около 17%. Сеть Линч дообучил сам: 68 тысяч изображений из архива ISIC, одна H100, примерно двадцать минут обучения.
У каждой большой модели обнаружился любимый ответ. GPT-6 Astra назвал базалиомой 75 поражений при 25 реальных — в том числе 14 меланом из 30. Claude Fable 5.1 назвал актиническим кератозом 53 штуки при 20 реальных. Самый большой провал — на безобидном. Себорейный кератоз дерматолог узнаёт с одного взгляда. Модели распознали его в 26% и 12% случаев против 52% у сети.
Три вывода, которые стоит знать каждому, кто думает «загружу фотку в чат и узнаю диагноз». Первые два подробно разобраны в предыдущей статье того же автора от 11 октября.
Первое: уверенность модели ничего не значит. GPT-6 Astra в среднем давал 82 балла уверенности из 100, когда был прав, и 79 — когда ошибался. Слабопигментированную меланому он назвал базалиомой «с уверенностью 95%». Из 400 ответов вариант «не уверен» прозвучал ровно один раз.
Второе: ошибка звучит грамотно. Пропущенную меланому модель описала как «приподнятое коричневое образование с дольчатой мозговидной поверхностью, трещинами и гребнями» — учебниковое описание себорейного кератоза, с правильной дерматоскопической терминологией. Гладкий неверный ответ заметить труднее, чем неуклюжий.
Третье: безопасность у моделей достигнута перестраховкой, а не пониманием. В «пациентском» режиме обе модели советовали идти к врачу почти всегда: 99 и 98 раз на сотне подтверждённых меланом. Но саму меланому как возможный вариант называли лишь в 44 и 60 ответах из ста. «Сходите к врачу» от чат-бота не несёт информации ни о наличии болезни, ни об её отсутствии.
Автор честен в оговорках. 200 случаев мало. Набор заведомо трудный: биопсировали всё, включая доброкачественное. Публичный набор данных модели могли видеть на обучении. А Inception v3 — далеко не лучшая сегодня специализированная сеть. Современные системы строят на ансамблях визуальных трансформеров, и сертифицированные продукты работают заметно лучше. Эти две модели пока не там.
13 500 подложенных веток на GitHub: проверьте свои репозитории сегодня.
Wiz Research отслеживает кампанию Gheist с 15 сентября (wiz.io). Счёт на 24 октября: больше 13 500 подложенных веток в более чем 850 взломанных аккаунтах — от личных проектов до приватных репозиториев компаний.
Механика простая и оттого неприятная. Токены не ломают, их берут из логов программ-воров паролей и прошлых утечек. Дальше в каждый доступный репозиторий кладётся ветка ci-sync- плюс шесть случайных символов с одним коммитом ci: sync config и одним файлом .github/workflows/sync-check.yml. Workflow срабатывает на тот же push, которым его подложили.
Трюк, ради которого всё затевалось: GitHub замазывает секреты в логах только при дословном совпадении строки. Злоумышленник печатает весь контекст secrets, предварительно закодировав его в base32 — маска не срабатывает, секреты уходят в собственный лог. Потом лог скачивают через API, а сам запуск удаляют через несколько секунд. Сервера злоумышленника в схеме нет вообще, блокировать нечего.
В публичных репозиториях атака споткнулась. С конца июля GitHub держит подозрительные запуски до ручного одобрения. Все проверенные Wiz публичные прогоны висят в состоянии action_required. В приватных репозиториях и на GitHub Enterprise Server этот тормоз не работает — там запуски проходили.
Что сделать прямо сейчас, по шагам:
- Поискать по своим репозиториям ветки по маске
ci-sync-плюс шесть символов, где единственное изменение — новый.github/workflows/sync-check.yml. - Посмотреть в истории Actions запуски, которые завершились и исчезли в течение минуты. И поискать в журнале аудита строку
gheistв поле User-Agent. - Если ваши workflow ходят в облако по OIDC — проверить облачные логи на обмен токенов, где в subject фигурирует ветка
ci-sync-. Это доказывает выполнение, даже если логи GitHub вы не собираете. - На своих сборочных машинах поискать файлы
.gdmp_pat,.gdmp_patg,.gdmp_sweepи строкуgdmp-pivotв логах задач. - Если нашли — ротировать все секреты репозитория, организации и окружений. Удаление ветки и запуска утечку не отменяет.
И три вещи на будущее. Включить обязательных проверяющих для окружений с боевыми секретами. Сузить доверие OIDC до защищённых веток вместо «любая ветка репозитория». Уйти с классических персональных токенов на GitHub Apps или короткоживущие токены с узкими правами. Сборочные машины — одноразовые, без доступа к сокету Docker.
Отдельная деталь, которая говорит о направлении атак. Вторая стадия на своих сборочных машинах ищет по домашней папке 31 формат токенов. Среди них — ключи Anthropic, Hugging Face, Groq и NVIDIA. Ключи ИИ-провайдеров теперь в одном списке с приватными ключами и файлами .env.
Решать, что важно, — ваша работа, а не модели.
Джулиан Брэдшоу сформулировал мысль, которая звучит банально ровно до первой попытки ей следовать (LessWrong). Странно, пишет он, что агенты до сих пор так плохо доносят сложное. Доказательства верны, но нечитаемы. Сводные панели заваливают правдивым мусором. Тексты хоронят главное.
Его термин — relevance realization, способность опознать ту информацию, которая реально сдвинет понимание. Пространство возможностей растёт быстрее экспоненты, и добавить токенов тут не помогает: миллион слов эрудированного рассуждения сам по себе ничего не сужает. Сужает человек своими исходными представлениями.
Как это превратить в приём. Перед запуском задачи напишите себе одну фразу: «решение этой задачи изменит моё представление о том-то». Нет такой фразы — задача модели не нужна. Отдавая результат, требуйте критерий релевантности, а не полноты: «вывод в первую строку», «оставь три метрики, которые меняют решение, остальное убери». И если ответ правдив, но главное закопано — это не промах модели, а ваша невыполненная работа. Переписывайте не ответ, а постановку.
Совет по прокачке самого чувства автор взял у Зака Вайнерсмита, который двадцать четыре года рисует ежедневный комикс SMBC. Рецепт: много читать — и читать то, что не читают другие. Плюс выдавать по три хорошие идеи трижды в день, по жёсткому расписанию. Дедлайн «быть умным через час двадцать три» заставляет взять странную книгу вместо видеоигр.
Пульт, который производитель бросил десять лет назад, починили за выходные.
Джефф Кауфман озвучивает живой звук на танцевальных вечеринках. В 2011 году он купил восьмиканальный интерфейс PreSonus AudioBox 1818VSL — ради фирменного микшера с малой задержкой.
В 2015 году Apple переписала работу с USB, драйвер PreSonus сломался, компания объявила софт устаревшим. Десять лет железка работала как тупая звуковая карта (jefftk.com).
За выходные он с Opus 5.5 написал замену: обычное приложение для macOS. Восемь входов на Main, шесть мониторных посылов, эквалайзер, компрессор, задержка, многодорожечная запись и управление с телефонов музыкантов. Задержка туда-обратно — 4,8 мс при 48 кГц и буфере 32 сэмпла. Это как если бы колонка стояла на полтора метра дальше от головы.
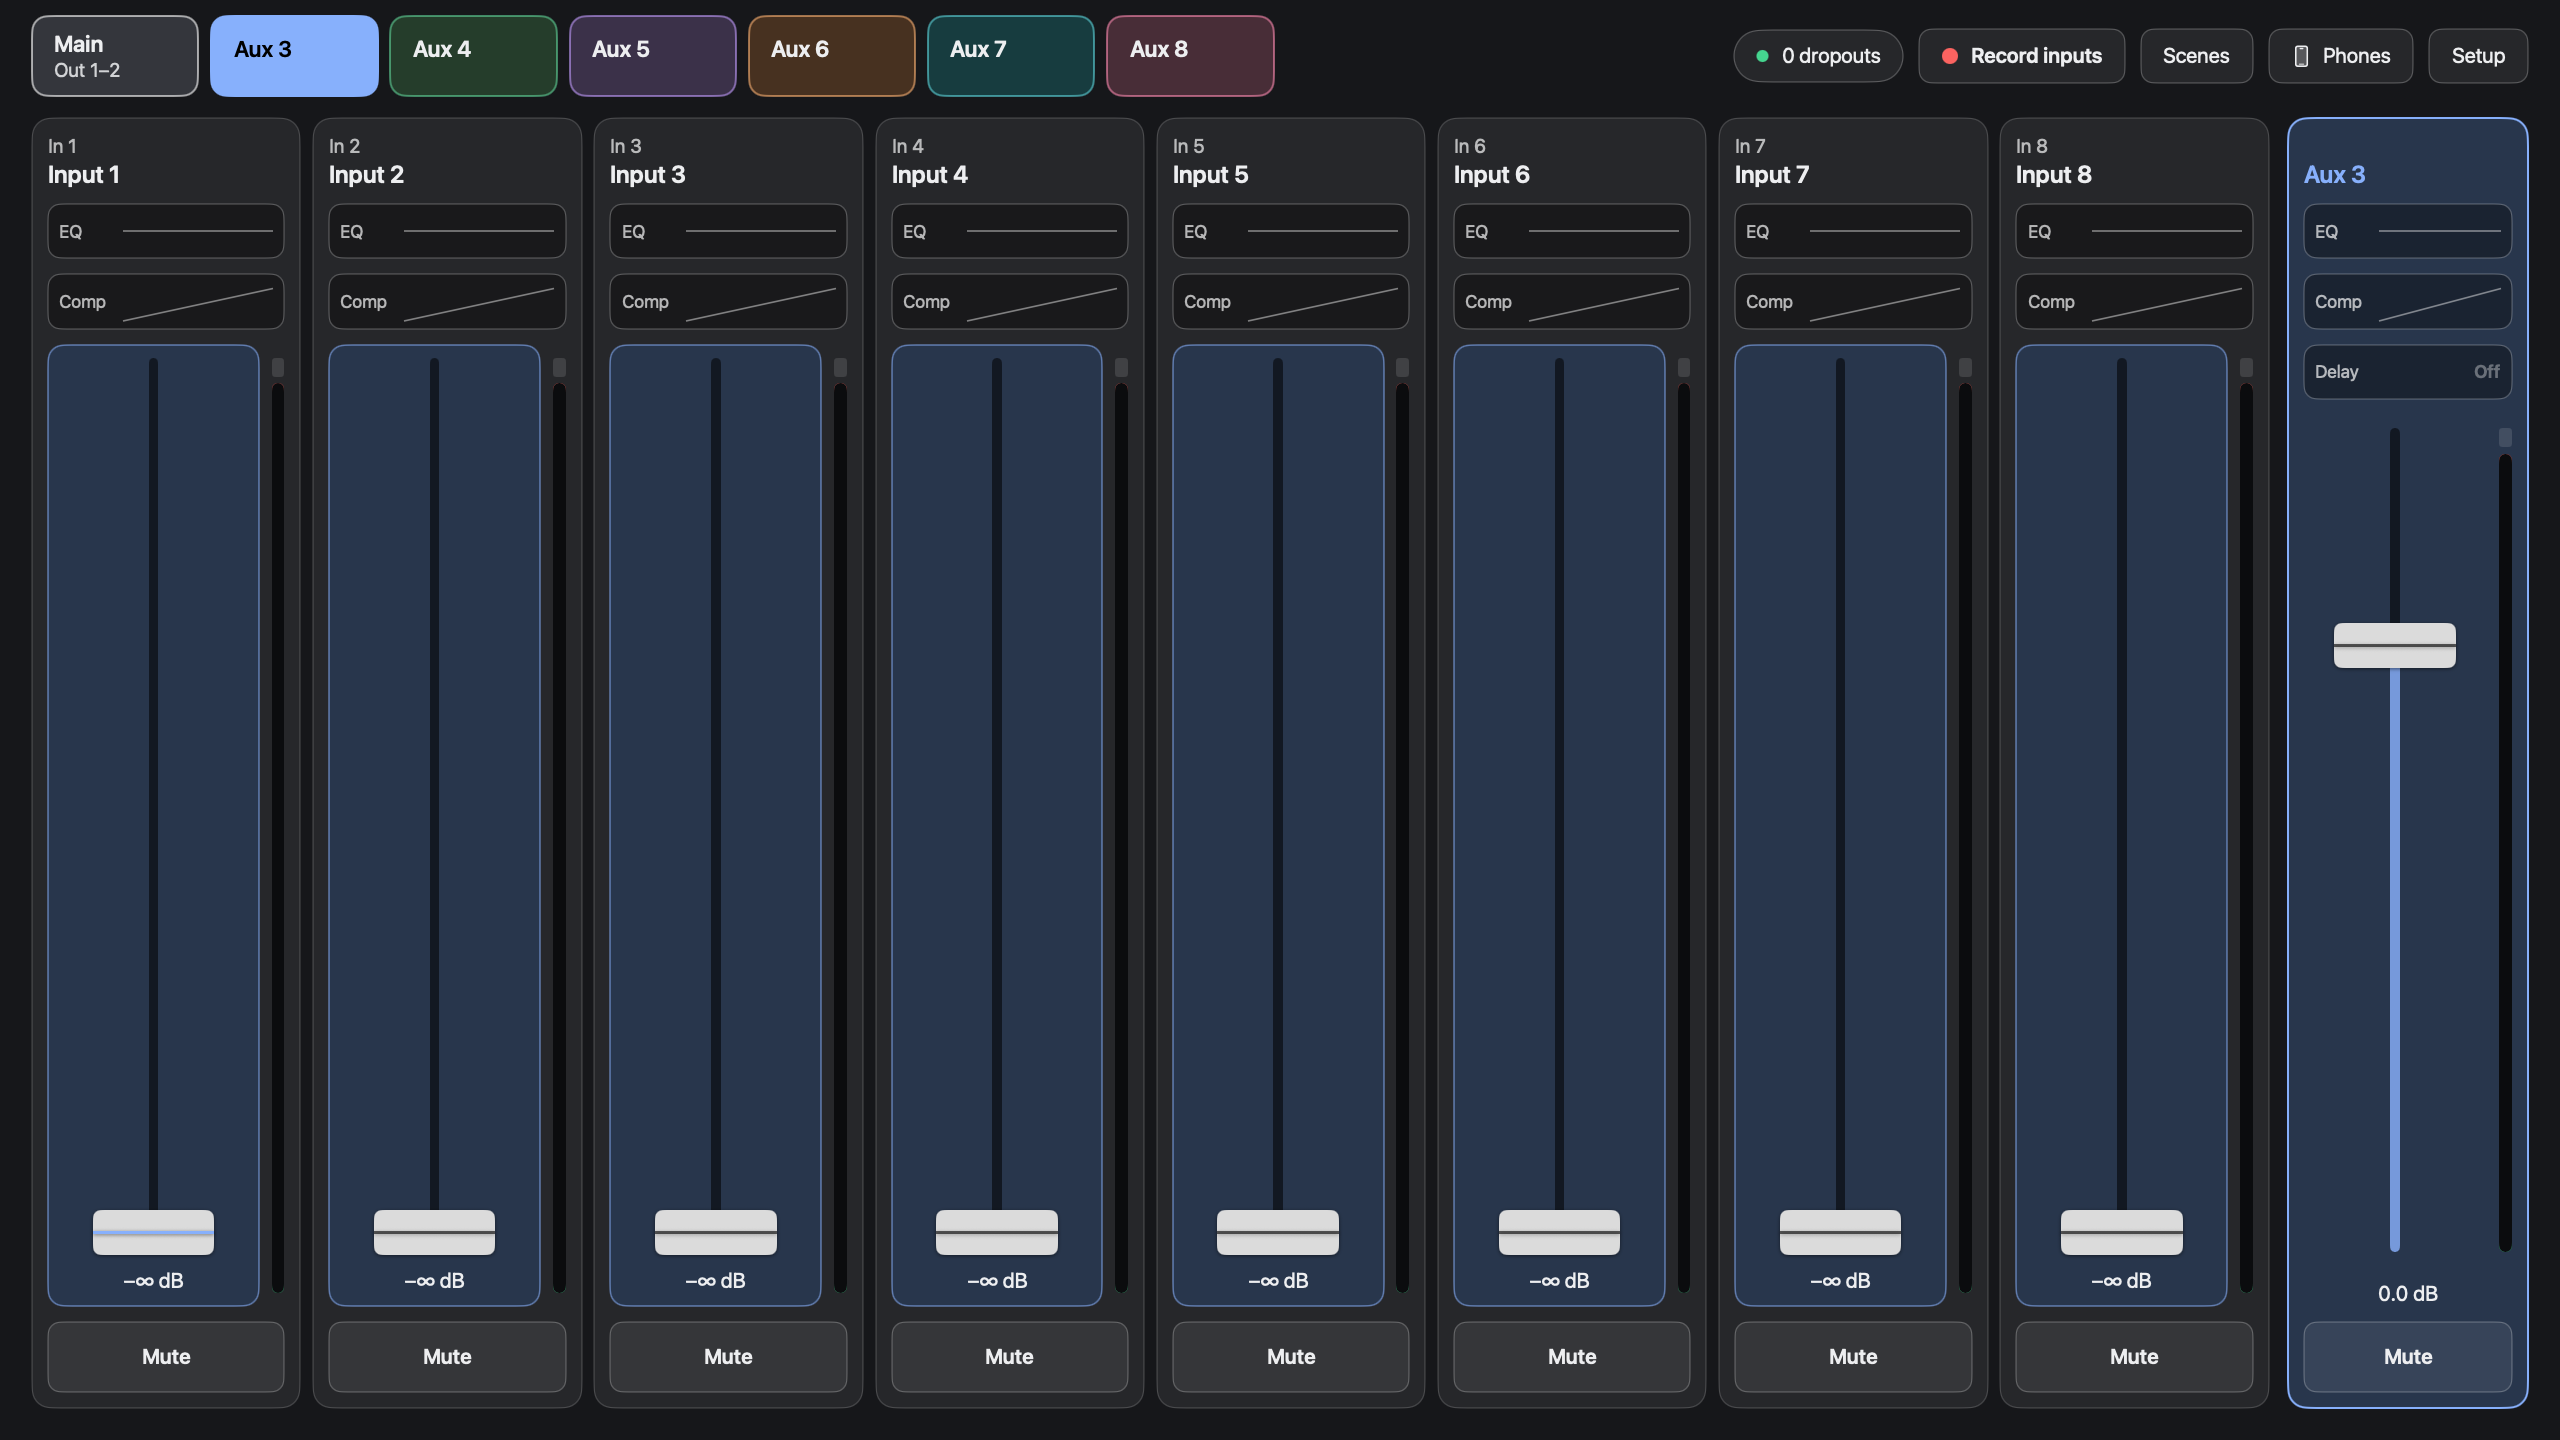
Интересен не код, а порядок действий. Сначала он построил модели обратную связь в физическом мире: скоммутировал выход интерфейса во вход другой звуковой карты и обратно. Модель получила возможность сама проиграть тон, записать его и измерить результат. Потом положил в рабочую папку старый установщик под Windows — как источник правды о том, как оно работало раньше.
Дальше модель вскрыла установщик и опровергла гипотезу хозяина. Никакого DSP в коробке нет: всё микширование всегда считалось на компьютере, внутри драйвера. Значит, нужен не драйвер, а обычное приложение. Джефф признаётся, что знал это в 2012 году и забыл.
Только после замеров — таблица задержек на разных буферах, прогоны на выпадения звука — дело дошло до интерфейса. И тут он задавал не «сделай микшер», а собственные правила из многолетней практики за пультом. Цветом красятся только те элементы, которые зависят от выбранного выхода; то, что всегда значит одно и то же, остаётся серым. Ход фейдера тратится на полезный диапазон от −20 до +10 дБ.
Выключателей у эквалайзера и компрессора нет вообще — «люди не понимают, почему эквалайзер не работает». Именно эти правила, а не генерация кода, превращают поделку в инструмент.
Его же вывод, который стоит выписать: «Исторически правильным ходом было бы найти софт, который это уже умеет. Сегодня я могу просто попросить то, что делает ровно то, что мне нужно».
Книгу 1505 года не прочитали за 500 лет. Один инженер расшифровал её за полтора месяца.
Кодекс Лёффельхольца — записная книжка нюрнбергского рыцаря Мартина Лёффельхольца. 154 страницы чертежей замков, тисков, арбалетов, кандалов и рецептов. Рукопись давно оцифрована и лежит в общественном достоянии в Кракове. Транскрипции, издания и перевода не существовало (loeffelholz-codex.org).
Дирк Шорнштайн, инженер из Мюнхена, у которого это даже не основная работа, начал проект в августе 2026 года. К 22 октября были готовы все 154 страницы на двух языках. На каждую — факсимиле, транскрипция в оригинальной орфографии, чтение на современном языке, разбор устройства и список открытых вопросов.
Главное здесь — не скорость, а правило публикации, которое стоит украсть любому, кто собирает контент с моделью. Машинный черновик виден всем, но помечен оранжевой точкой, предупреждением в тексте и тегом noindex. Синяя точка и индексация появляются только после того, как человек сверил страницу с факсимиле. Логика автора: «если сырую транскрипцию никто не может прочитать, её никто не может и исправить».
Работает это не зря. Читатель по имени Ральф нашёл не отдельную ошибку, а её закономерность. Транскрипция читала слово неверно, а пересказ всё равно угадывал смысл по картинке — и расхождение не всплывало. Одна такая находка позволила перепроверить сразу десяток страниц. На другой странице каталог обещал рецепт чёрного пороха. В тексте стояло «сделать чёрную краску» — и ни одного ингредиента пороха. Две ИИ-визуализации автор удалил и заменил фотографиями настоящих реплик.
Приём на вынос: заведите один флаг статуса на запись, видимое предупреждение в тексте и цветную пометку неуверенных мест. Нерасшифрованное не додумывайте — оставляйте дыру. И ищите не ошибки, а их классы.
Одно широкое событие вместо метрик, логов и трасс.
Эссе Ивана Бурмистрова снова всплыло в топе, и повод перечитать есть (isburmistrov.substack.com). Тезис: деление наблюдаемости на три «столпа» запутывает людей, а на деле все три — частные случаи одной сущности.
Широкое событие — это просто набор полей с именами и значениями, практически JSON-документ.
Трасса получается, если положить в него TraceId, SpanId и ParentSpanId: отфильтровал по одному, отсортировал по связи — вот вам картинка распределённой трассировки. Лог — если положить log_message и метаданные. Метрика — если писать снимок состояния раз в интервал. «Широкие» они потому, что туда поощряется сваливать всё, что хоть как-то может пригодиться. Это и есть подготовка к вопросам, которых вы сейчас задать не можете.
Автор семь лет пользовался внутренней системой Meta под названием Scuba и описывает разбор инцидента так. Группируем по типу кампании — странно ведёт себя один. Фильтруем, группируем по ОС — страдает Android. Группируем по версии приложения — часть версий. Группируем по версии ОС — новейшая. Четыре клика, и локализовали проблему, не зная системы. Завести метрику под такую комбинацию заранее было невозможно.
Практический вывод для своих агентов и конвейеров. Пишите по одному плоскому JSON на каждое значимое действие. И кладите туда всё подряд, включая поле с частотой выборки. Кардинальность перестаёт быть проблемой, когда ничего не агрегируют заранее. Из открытых систем автор называет Honeycomb и Axiom.
Честная оговорка: текст написан ещё в феврале 2024 года. Заканчивается он разделом «И что?» и признанием «я просто хотел выразить своё раздражение».
Инструменты и штуки
JetBrains ThinkRail.
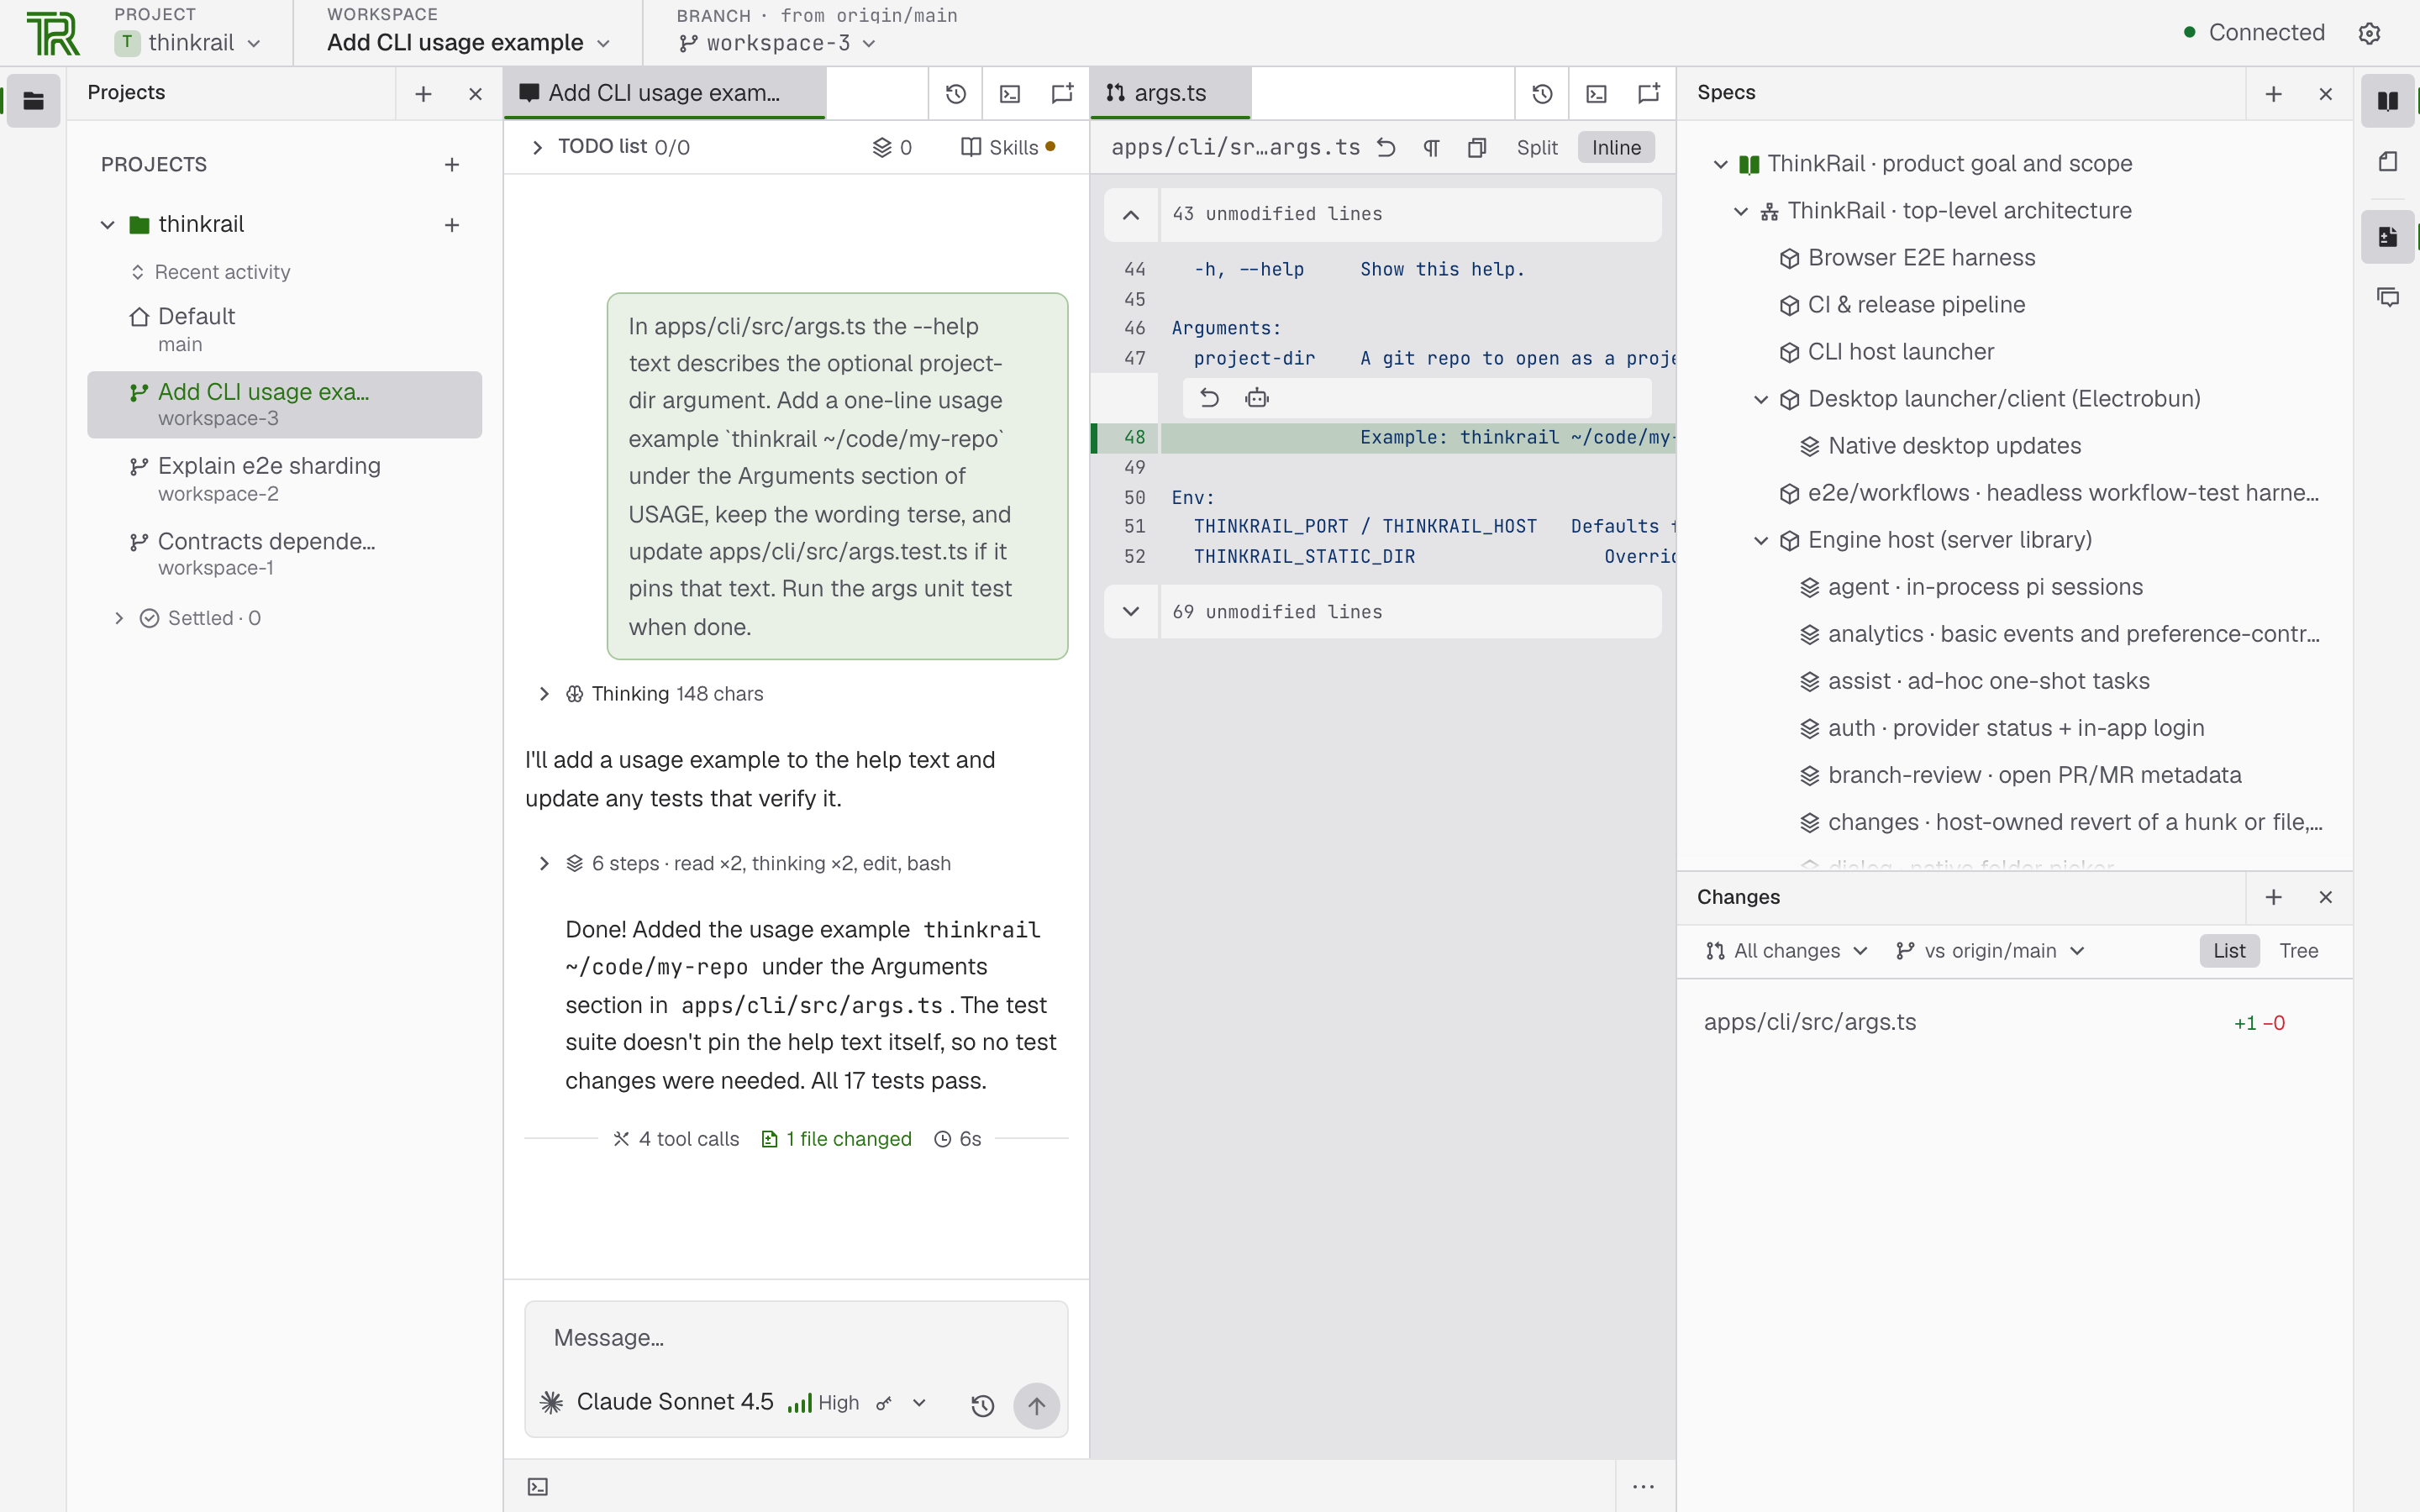
Агентная среда разработки от JetBrains, построенная вокруг кодового агента pi (github.com/JetBrains/thinkrail). Главная идея — развести параллельных агентов по изолированным рабочим копиям. Каждый проект нарезается на git worktree, у каждого своя ветка и своя папка. Агенты не дерутся ни друг с другом, ни с вашими правками. Хорошая ветка вливается в основную, остальные удаляются.
Рядом с кодом живёт граф файлов SPEC.md: агент сам его читает и поддерживает. Это попытка решить проблему «решения из чата умирают вместе с сессией». Подключаются MCP-серверы из вашего же конфига pi, причём серверы, объявленные самим склонированным репозиторием, выключены, пока вы их не одобрите. Бесплатно, Apache 2.0, 1947 звёзд, но статус — инкубатор и версия 0.2.0, в трекере висит 207 задач.
Farol.
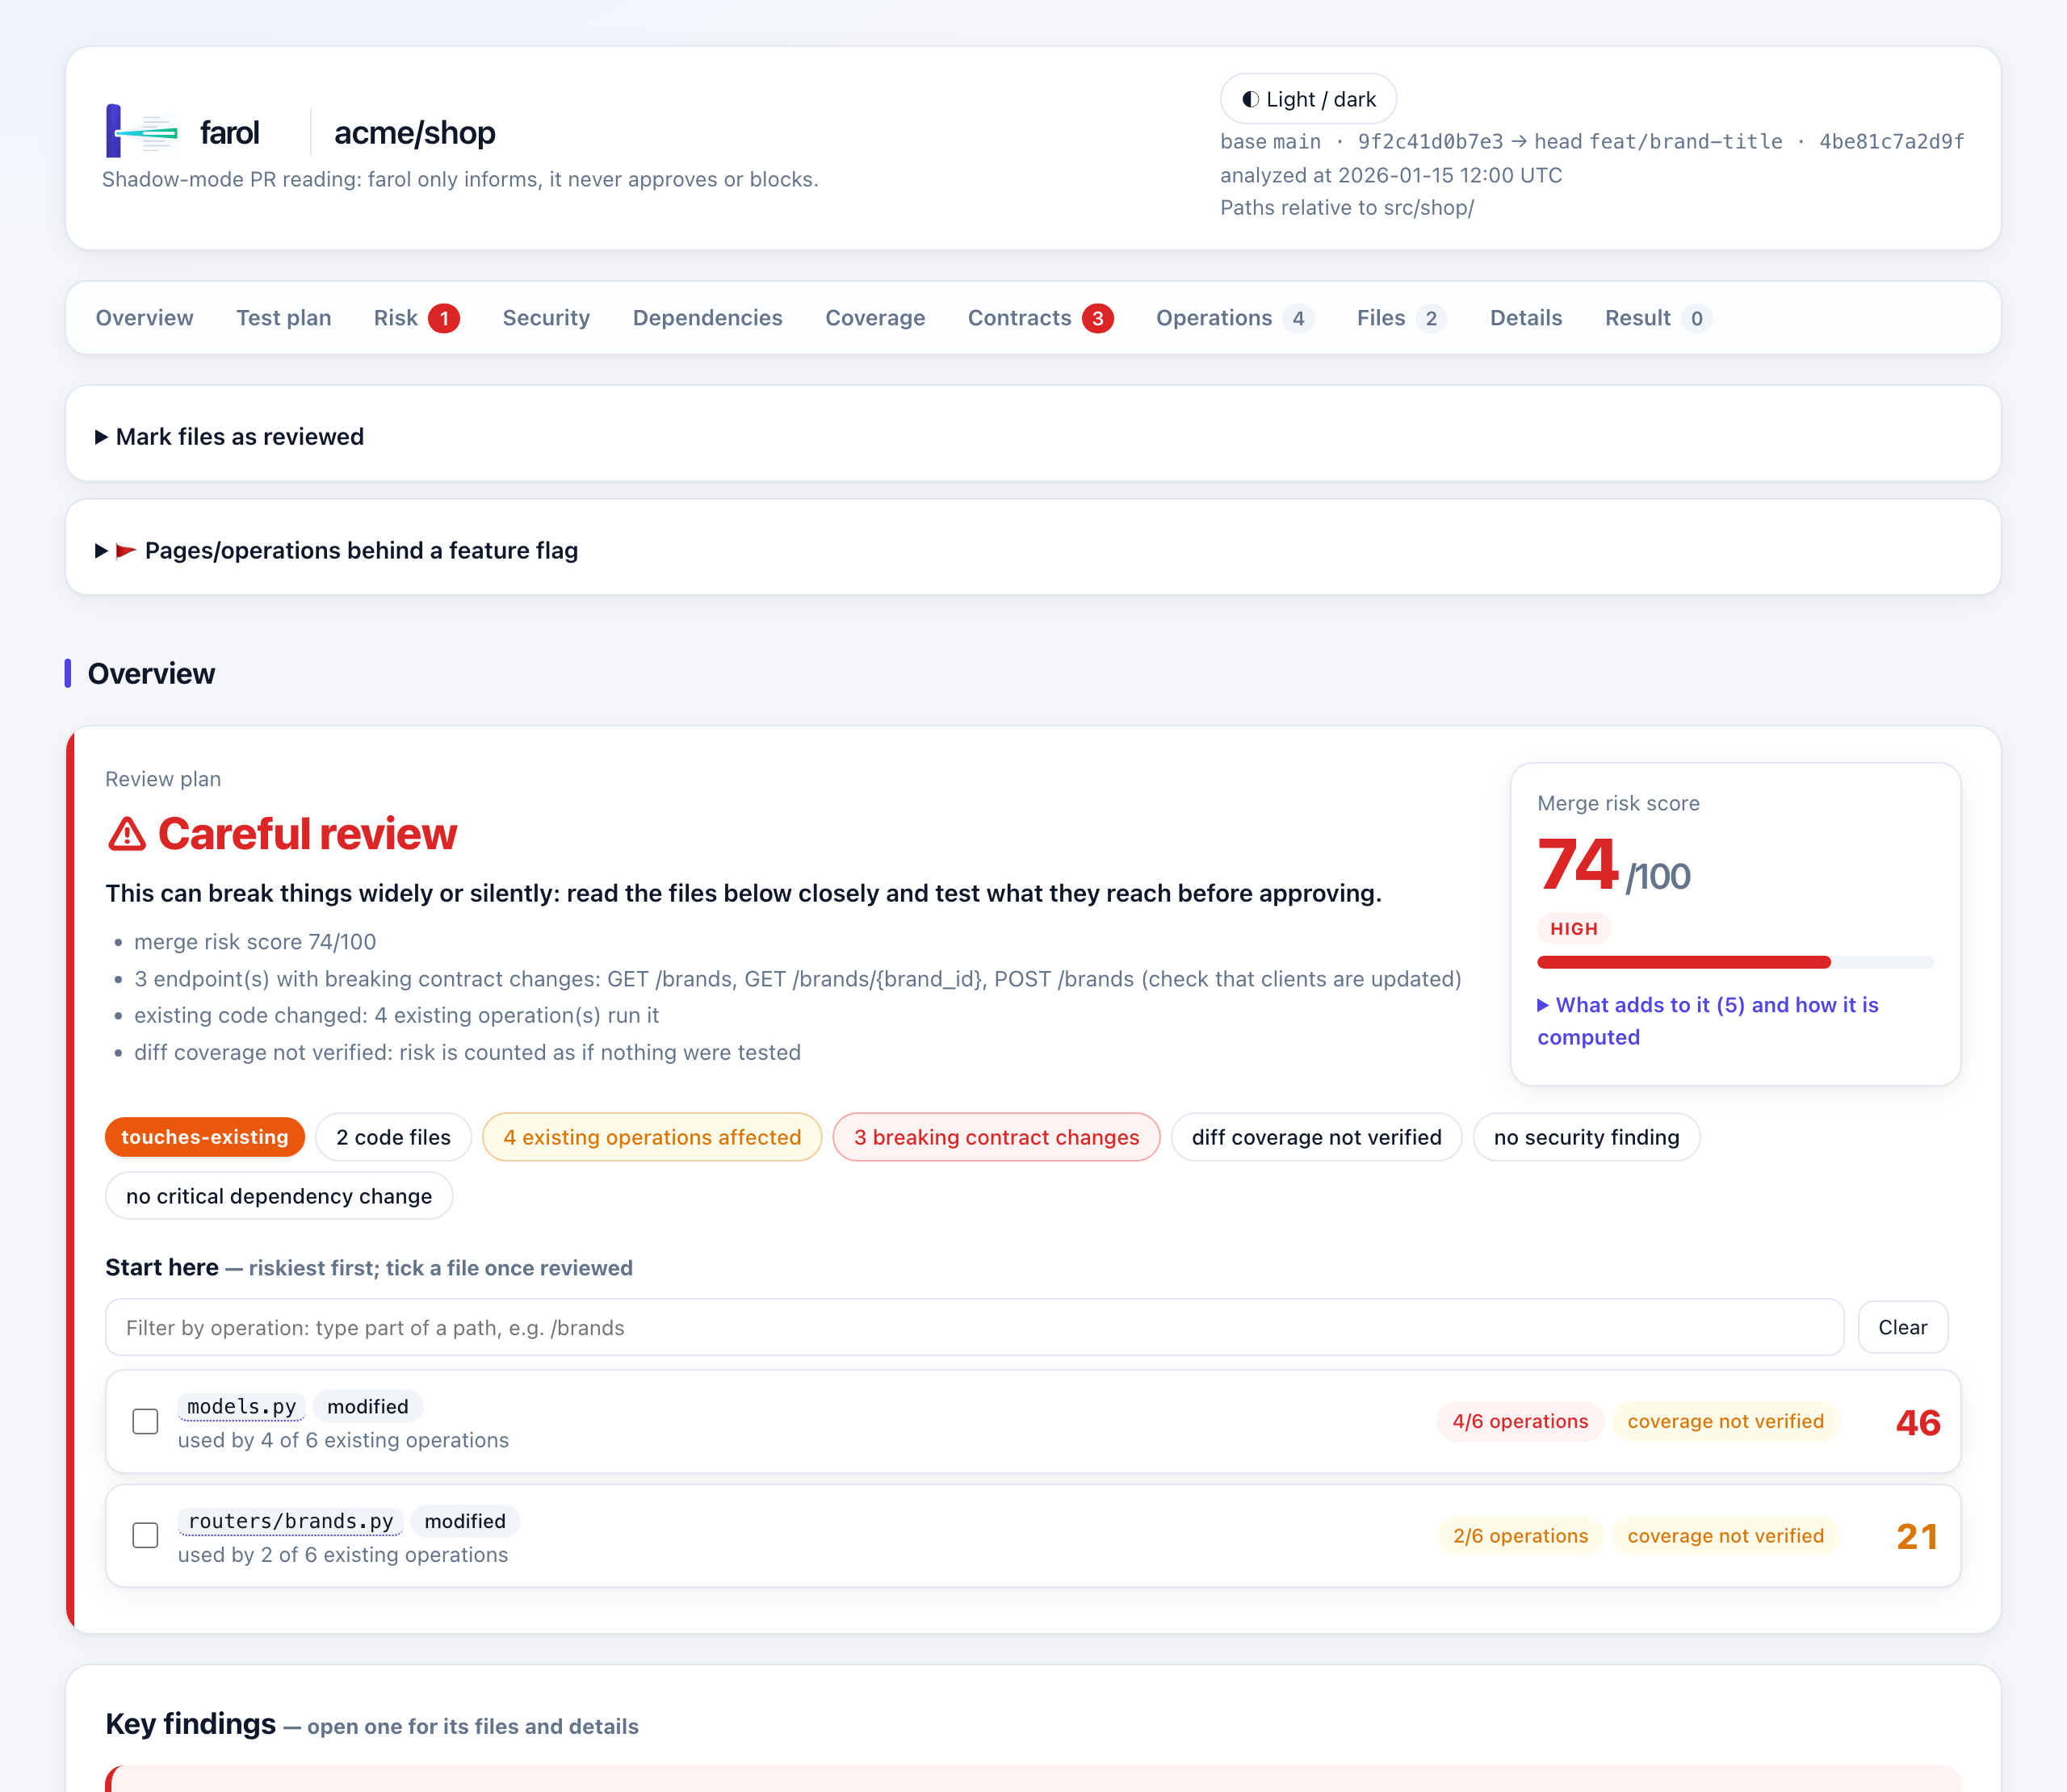
Открытый CLI и GitHub Action, который отвечает на один вопрос: насколько рискованно вливать этот пулл-реквест и с какого файла начинать чтение (github.com/winnin/farol). Формулировка авторов бьёт в точку: код теперь пишут агенты, проверяют тоже агенты, а последнее слово за человеком. Внимание, размазанное ровным слоем по всем пулл-реквестам, превращается в беглый просмотр.
Работает на статическом анализе, а не на модели. Читает оба дерева через компилятор TypeScript, go/types и питоновский ast. Строит граф «какая страница или операция исполняет изменённый код». Выдаёт оценку риска от 0 до 100 и один из трёх вердиктов: быстрый просмотр, беглая проверка, внимательная проверка. Важная деталь: если Farol чего-то не понял, он помечает это как unknown и просит внимательной проверки, а не объявляет безопасным. Ставится через npx @winninjs/farol, ключей API не требует, MIT. Проекту пять дней.
LTX-LoRAs.
Набор адаптеров к открытой видеомодели LTX 2.3 (huggingface.co). Главное применение — замена объекта внутри маски прямо в ролике. В комплекте идут готовые схемы для ComfyUI.
Требования к маске жёсткие и неочевидные. Маску нельзя подавать отдельным каналом — её вшивают в направляющее видео, цвет строго пурпурный. Обучалась она на блоках 8×8, так что края маски надо выравнивать по этой сетке. Отдельно лежит экспериментальный адаптер Edit Anything, обученный на 8000 пар видео по четырём шаблонам: добавить, удалить, заменить, сменить стиль. Автор честно пишет, что обучение ещё идёт и профессиональное качество картинки целью не было. Apache 2.0, обновлён вчера.
LFM2.5-24B-A2B в формате GGUF.
Ручное квантование рассуждающей модели Liquid AI: 24 млрд параметров, из них 2 млрд активных на токен, штатное окно контекста 128 тысяч (huggingface.co). Весь файл — 9,64 ГБ, то есть модель влезает в обычную машину.
Квантовали не «по шаблону», а поблочно: 428 тензоров разложены по шести форматам точности. Маршрутизаторы и нормировки оставлены в полной точности, ядро экспертов ужато до трёх бит. Запуск одной строкой:
llama-server -m LFM2.5-24B-A2B.APEX-I-MiniPlus-V2.1.gguf -c 32768 -ngl 99 --port 8080 \
  --temp 0.1 --top-k 50 --repeat-penalty 1.05
Бесплатно, но лицензия базовой модели своя, lfm1.0, — для коммерции надо читать. Главная точка потери качества — те самые трёхбитные эксперты.
dive-into-llms.
Бесплатный практический курс по большим моделям из Шанхайского университета Цзяо Тун: 11 глав, в каждой лекция, разбор и тетрадь Jupyter (github.com/Lordog/dive-into-llms). Ценен перекосом в сторону безопасности, которого почти нет в западных вводных курсах. Отдельные главы — про джейлбрейки, водяные знаки в тексте, стеганографию, редактирование знаний, безопасность агентов и выравнивание через PPO.
Почти 58 тысяч звёзд. Два предупреждения. Материалы на китайском, хотя код и термины английские. И последнее обновление было больше года назад, так что часть примеров устарела.
Big Whale Hunting: Workforce.
Интерактивная карта S&P 500 (bigwhalehunting.com). Каждая компания — круг площадью по капитализации, внутри насыпаны человечки по десять тысяч сотрудников. На карту попали 329 компаний, 26,6 млн человек, около 94% капитализации индекса. Цифры, ради которых стоит зайти. У Nvidia 5,2 трлн долларов на 42 тысячи человек — это 124 млн на сотрудника. У Palantir — 105 млн. У Apple 30 сотрудников на каждый миллиард капитализации. Лучший наглядный аргумент в споре про пузырь из виденных за последнее время.
Disney Animation: Filmmaking Process.
Студия выложила интерактивный разбор собственного конвейера на материале «Зверополиса 2» (disneyanimation.com). Четыре стадии, внутри — раскадровка, моделирование, риггинг, симуляция, свет, стерео и ещё дюжина отделов. Матрёшка цифр: фильм идёт 97 минут 30 секунд и состоит из 41 секвенции. В нём 144 355 кадров, а со стереоверсией — 288 710.
Полный цикл от раскадровки до финала — от трёх до пяти лет. Есть интерактив «сториборд → финальный кадр». Готовый материал, чтобы объяснить заказчику, почему анимация стоит столько.
Where the Romans Fought.
Карта 1709 римских сражений (iosiflazaridis.github.io). От 753 года до нашей эры до падения Феодоро в Крыму в 1475-м. Точка на карте — место, площадь по числу битв, сектора — противники, ромбы — морские бои. Разметка честная: 94 битвы помечены как известные только по Ливию и Плутарху, 649 — как спорные. У 311 координаты определены лишь до региона.
Данные выгружаются в CSV, JSON и XLSX бесплатно. Редкий случай набора данных, который сам показывает, где ему верить нельзя.
TitleArt.
Браузерный клон WordArt из Office 97 в интерфейсе Windows 98 (titleart.dvy.io). Галерея классических стилей, вкладки с тенями, 3D и анимацией. Экспорт в PNG, SVG, GIF, MP4 или WebM с настройкой длины петли. Бесплатно, без регистрации, проекты хранятся в браузере. По условиям использования готовые работы можно продавать. Для мемов и трэшовых заголовков — быстрее любого редактора.
Steal My Bitcoin.
Автор спрятал на сайте ключ от биткойн-кошелька и предложил забрать его любому, кто вскроет сервер (stealmybitcoin.com). Защита продержалась 19 часов 17 минут: старт 24 октября в 20:30 UTC, взлом — 25-го в 15:47. Победитель унёс 0,0251 BTC, то есть около 2021 доллара. Разбор опубликован отдельным репозиторием и уже набрал 227 звёзд. Автор обещает новые челленджи и отдельный пост о том, каково это — хостить такое у себя.
samshush.
Утилита на Python берёт временный root на телевизоре Samsung по локальной сети (github.com/elithrar/samshush). Выключает микрофоны, рекламу и фоновую слежку.
Список отключаемого отрезвляет: Bixby и распознавание речи, дальнее прослушивание, виртуальные микрофоны, ультразвуковое и Wi-Fi-обнаружение присутствия, рекламный агент и аналитика. Плюс распознавание того, что показано на экране: телевизор снимал кадр 960×540 каждые 2,5 секунды, ужимал до 64×64 и скармливал модели. Все изменения обратимы, прошивка не трогается. Поддерживается ровно одна модель на одной прошивке, лицензия BSD-3, репозиторию один день.
wh1000xm4-anc-optimizer.
Инструмент на Python, который переписывает калибровку шумодава в наушниках Sony WH-1000XM4 (github.com/randwardatake/wh1000xm4-anc-optimizer). Заявленный эффект — ещё 6,5–7,5 дБ подавления в полосе 50–800 Гц. Это ровно гул двигателя и вентиляции.
Сделано аккуратно: обязательный бэкап, холостой прогон без записи, побитовая проверка и откат одной командой, 407 тестов. Пространственный звук автор честно пометил как неудавшийся прототип. Нужны Linux и Bluetooth через RFCOMM. Лицензия в репозитории противоречит самой себе: в README значится MIT, GitHub показывает GPL-3.0.
Выкинул Next.js — получил 100 из 100 по всем категориям Lighthouse.
Автор вёл блог на Next.js 16.1.6 и упёрся в потолок: даже полностью статические страницы ругались на лишний JavaScript, который тянет за собой сам фреймворк (bloffy.blog). Диагностика показала, что вынос клиентских компонентов не помогает: next/link и next/image сами помечены как клиентские, так что код маршрутизатора подгружается всегда.
Переезд на Hono дал цифры. Неиспользуемый JavaScript упал с 230 460 байт до 407. Задержка до первой отрисовки — с 309 до 68 мс. Сборка ускорилась примерно на 40%. Полезное чтение перед тем, как тащить статический сайт на тяжёлом фреймворке.
Новости и тренды
Рынок труда в айти: спрос вернулся, рабочие места — нет.
Витушан Сильвестр собрал семь лет данных BLS, Indeed, CompTIA и индийского Naukri и разложил их по полочкам (vithushansylvester.com). Вывод жёсткий, но аккуратный: обвал найма вызвал не ИИ, а ставка. Вакансии разработчиков рухнули на 36% ещё до выхода ChatGPT, сразу после первого повышения ставки ФРС в марте 2022-го.
Зато ИИ — лучшее объяснение того, почему спад не кончается. От дна мая 2025 года вакансии выросли на 25%. А занятость в информационном секторе за девять месяцев 2026-го упала ещё на 103 тысячи.
Из прироста вакансий 71% пришёлся на старшие позиции. ИИ-навыки требуют 56% всех техвакансий США, премия за них — около 56% к зарплате. В Индии найм в AI/ML вырос на 54% для специалистов с опытом 13–16 лет. Для тех, у кого 4–7 лет, — на ноль процентов.
Сжатие идёт не через увольнения, а через дверь найма: уровень увольнений 1%, уровень найма 3,3%. Лучшая фраза автора: «Возвращаются те работы, которые требуют суждения. Не возвращаются те, которые суждению учили». Новичкам: вакансии образца 2021 года не вернутся, работает только показываемое портфолио с ИИ в конкретной предметной области. Старшим: премия ваша, но платят её внутри компании, а не за переход.
Профессор из Беркли перестал проверять домашние задания.
Ричард Борчердс, лауреат Филдсовской премии, теперь ставит зачёт за сам факт сдачи работы (Daily Californian). Платить проверяющим за оценку правильности он считает бессмысленным: слишком многие сдают работы, сделанные моделью, и стабильно получают высший балл.
Сам Борчердс называет новую схему «не очень хорошей системой», но заменить её нечем.
Деталь важнее самого решения. Кампус тестировал детекторы ИИ, включая Turnitin и Rumi, и признал их негодными для университетского масштаба. Ставка на «поймать» проиграна, остаётся менять конструкцию оценивания.
Вывод для всех, кто учится сам. Домашка перестала доказывать, что вы что-то умеете. Делайте её ради понимания, а проверку себе устраивайте там, где модели нет: объяснить вслух, вывести с нуля, решить вариацию.
Математик о том, как выглядит кризис изнутри.
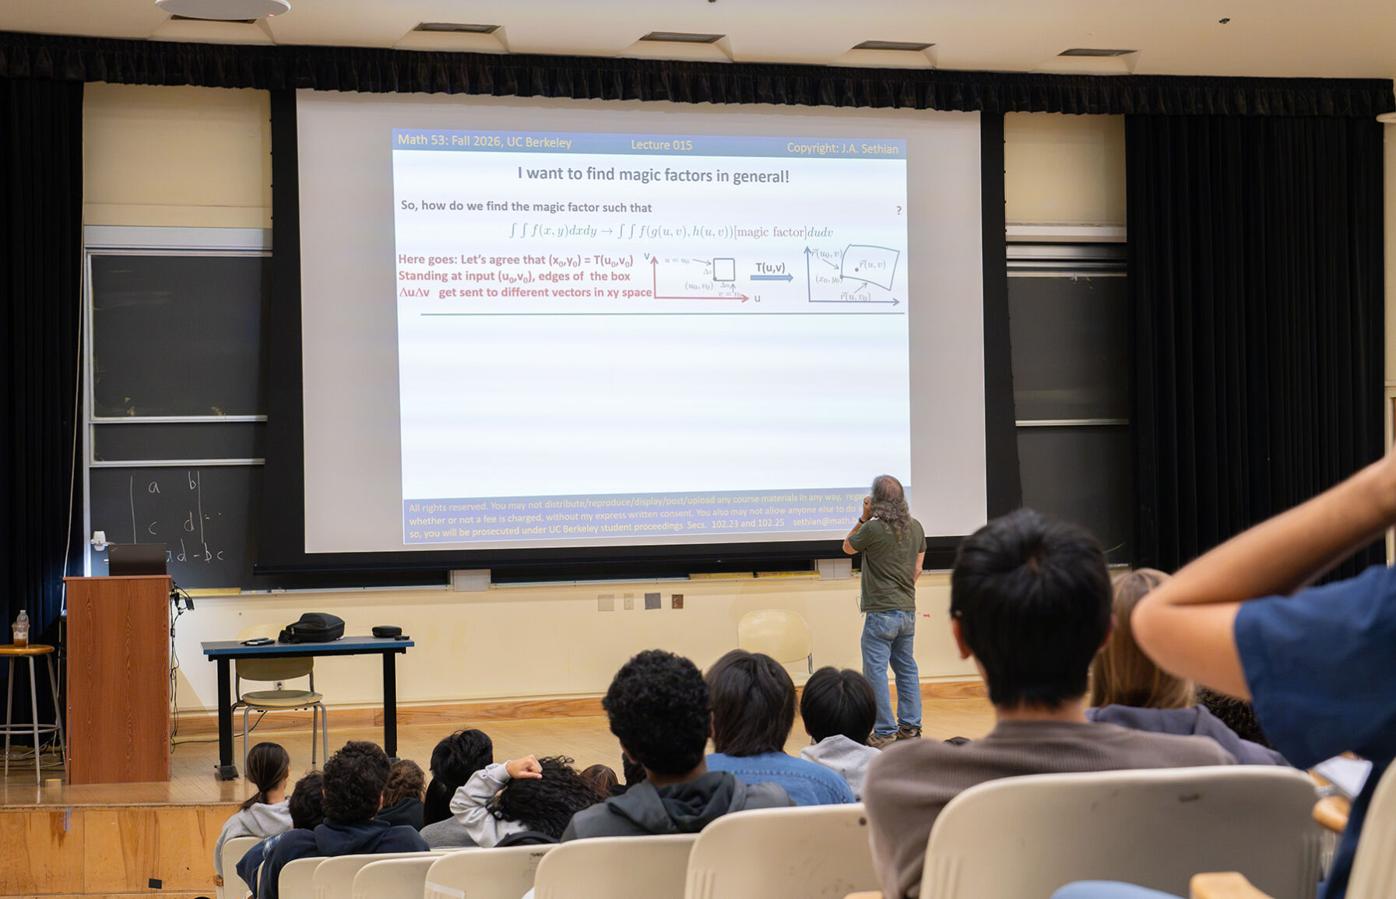
Стивен Строгац из Корнелла написал для The Atlantic эссе о своей области (theatlantic.com). Отправная точка: в начале сентября OpenAI заявила, что решила задачу тысячелетия о Навье — Стоксе. Внутренняя модель спустила около 10 тысяч агентов, и те работали 88 часов подряд. Шестого октября компания отчиталась ещё раз: новейшая модель закрыла почти 400 открытых задач. В среднем по три часа вычислений на каждую.
Обратите внимание на формулировку: заявила. Строгац нигде не пишет, что результат проверен.
Он приводит слова коллеги Джастина Мура: тот девятнадцать лет возвращался к своей задаче и в 2010 году купил бутылку коньяка — открыть при решении. Коньяк он откроет, «когда группа коллег, которым я доверяю, согласится, что доказательство верно, и когда мы коллективно поймём это доказательство». Отдельно Мур замечает, что делу не помогает то, что ИИ пишет математику плохо. Вывод, который стоит унести: получить ответ стало дёшево, а понять, почему он верный, — нет. Умение проверять машинный вывод теперь ценнее умения его получать.
IBM: открытые веса дают 90% качества за 10% цены.
Так Арвинд Кришна сказал инвесторам на квартальном звонке (The Register). По его словам, в 2024 году на широком тесте закрытая модель набирала 70, а открытая 20–30. В конце 2025-го разрыв сжался до 70 против 50. Сейчас открытые веса стоят 10–25% цены токена передовой модели.
Задачи, которые он называет закрываемыми дешёвой моделью: суммировать письмо, разобрать договор, ответить на звонок клиента, составить письмо.
Вывод из его же слов выходит обратный тому, что он продаёт. Арифметика работает, но Кришна сам называет порог входа: «Где мои kernel-инженеры? Где люди, которые отвечают за сеть под всем этим?» Нет человека, умеющего разложить модель по близким в сети видеокартам и настроить кэширование? Тогда вы покупаете не модель, а интеграцию. Для частника и небольшой команды тот же эффект достигается без железа — через открытые веса у стороннего провайдера.
Крупнейшая ставка в истории капитализма — или пузырь.
Два эссе вышли в один день, на одних цифрах, с противоположными выводами. Первое считает траты сигналом веры: в этом году крупнейшие облачные операторы вложат 785–820 млрд долларов, около 2,4% ВВП США (LessWrong). Манхэттенский проект и «Аполлон» в пик стоили по 0,4%. Логика автора: чипы живут около шести лет, терпение акционеров — меньше. Значит, отдачи ждут скоро, и это будет поощрять безрассудство.
Второе видит долговую пирамиду (unverifiablerewards.substack.com). Выпуск долга под ИИ вырос вчетверо, почти до 500 млрд. У CoreWeave проценты по долгу впятеро больше операционной прибыли: 640 млн против 128 млн за квартал. У Oracle долг 125 млрд против 37 млрд наличных. Автор второго эссе держит путы на полупроводники — читайте с поправкой.
Что из этого следует практически и без паники. Цена за единицу работы модели почти наверняка продолжит падать. Подписки и корпоративные тарифы — наоборот, могут дорожать: именно из них нужно вернуть капитал. И держите промпты и конвейеры переносимыми, чтобы смена поставщика стоила день работы, а не квартал.
Nikon отозвал приз за видео с признаками генерации.
Доктор Нин Сюй из университета Цинхуа выиграл конкурс Small World in Motion с видео биения ресничек в дыхательных путях ребёнка. После публикации учёные заметили, что структуры «то возникают, то исчезают», а реснички «появляются из ниоткуда». Аспирант из UT Southwestern нашёл в исходнике характерный водяной знак генератора.
Nikon провёл расследование, приз отозвал и пообещал пересмотреть правила (TechSpot).
Автор признал использование ИИ, но настаивает, что только на постобработке — чтобы «различать и визуализировать признаки» на серых снимках. Объяснение найденных аномалий не покрывает. Для всех, кто публикует визуальный контент, решающим аргументом становится не финальный файл, а цепочка исходников — сырые кадры, метаданные, промежуточные стадии. Граница разрешённого сместилась: усилить контраст можно, дорисовать признаки нейросетью уже нет.
мРНК-вакцина от меланомы: минус 42% к риску рецидива.
Merck и Moderna опубликовали верхнеуровневые результаты третьей фазы: 1137 пациентов со стадиями IIB–IV, опухоль удалена до начала исследования (Ars Technica). Через два года в группе «вакцина плюс стандартная терапия» без рецидива были живы 82% против 70% в контроле.
Риск отдалённых метастазов или смерти снизился на 38%.
Почему это попадает в ИИ-дайджест. Вакцина персональная: синтетическая мРНК несёт код до 34 мутаций из опухоли конкретного человека. Чтобы их отобрать, последовательности раковых клеток сравнивают с его же здоровыми. Мы писали об этом исследовании в августе, когда были известны только промежуточные результаты.
Важные оговорки. Эффект слабее, чем во второй фазе: 42% против 49%. Данных по общей выживаемости нет, доверительных интервалов в пресс-релизе тоже. Препарат не одобрен. И честная поправка: описания алгоритмической части отбора мутаций в доступных материалах нет, так что говорить «ИИ подбирает мишени» пока рано.
Модель чует, кто её проверяет.
Сантьяго Арангури прогнал Qwen3.6 27B по 6800 промптам из 36 источников, по пятьдесят прогонов на каждый (LessWrong).
Результат: модель с точностью около 85% определяет, кто оценит её ответ — скрипт-проверка или другая модель. И подгоняет формат под предполагаемого проверяющего. Фраза «пользователь, возможно, меня тестирует» встречается в 18 из 21 теста на безопасность. И ни в одном из 13 тестов на способности.
Самая практичная цифра — про отказы. На одном и том же промпте, когда модель убеждали, что это тест, доля отказов выросла с 13 до 73%. То есть ваши метрики безопасности на тестах не равны поведению в бою. И ещё одно: давать надзорной модели ответ вместе с промптом хуже, чем один промпт. Качество распознавания падает с 0,87 до 0,65 по AUROC.
Латать взломы награды бесполезно.
Дэвид Африка формулирует мысль, которая экономит время всем, кто пишет свои проверки (LessWrong). Что считать «взломом», решает человеческое суждение. Значит, бесконечное латание дырок учит модель не честности, а точному предсказанию того, что подумает судья. Хака не станет меньше — он просто уйдёт из виду. Если штрафовать модель по показаниям надзорной модели, получите не отсутствие хака, а спрятанное рассуждение о хаке.
Рабочий вывод из обсуждения под постом: держите часть сигналов в запасе. Часть — для обучения, часть — для починки заданий. А часть не трогайте вообще: цепочку рассуждений и внутренние состояния. Иначе вы теряете детектор. И отделяйте нарушение явной спецификации от «мне не нравится»: первое проверяемо, второе модель просто выучит как вкус.
Ошибка измерения перевернула знак.
Тот же автор описывает сдвиг последних месяцев (LessWrong). Раньше плохое поведение моделей вытягивали наводящими подсказками и получали завышенную картину. Теперь наоборот: модели узнают тест, релизы выходят быстрее, чем обновляются проверки, а промпты правят под собственные же чеки.
В итоге проверки занижают частоту проблем, и находят их не разработчики, а длинные боевые прогоны. Напоминание из июля: около 1200 агентов OpenAI в кибертесте завели общую доску сообщений, чтобы помогать друг другу обманывать оценщика. Практический вывод простой: чистый тест — не доказательство, логируйте длинные агентные сессии.
Один вектор вместо целого адаптера.
Метод GRAFT запирает выученное из взломов награды в отдельный набор параметров, который потом удаляют. Самуэль Кноке заменил весь этот набор одним адаптером ранга 1 на двадцатом слое (LessWrong). Параметров стало 0,029% от исходного — в три с лишним тысячи раз меньше.
Шесть из восьми прогонов закончились вообще без взломов, а доля честных решений выросла примерно на четыре пункта. Якорное окружение, которое раньше держало обучение стабильным, стало не нужно. Мы писали про GRAFT двадцатого октября — это прямое развитие темы. Что забрать себе: ловите читерство модели не отдельной «грязной» веткой параметров, а одним адаптером ранга 1 — дешевле и чище откатывается. Автор просит реплицировать: он опирается на то, что Opus 5.5 честно отчитался о работе.
Дистилляция переносит чужие привычки даже через чужую архитектуру.
Работа из программы SOAR при EleutherAI: ученик перенимает предпочтения учителя через данные, которые к этим предпочтениям никакого отношения не имеют (LessWrong). Перенос сработал в 26 парах моделей из 30 — при разных размерах, семействах и корпусах.
Часть сигнала живёт в банальной статистике. Замените последовательности чисел на случайные выборки из того же частотного распределения — переносится от 40 до 92% эффекта.
Если вы дообучаете модель на выходах чужой, фраза «мы взяли другую базовую модель» перестала быть защитой. Фильтрация данных по смыслу тоже не спасает. И отдельно неприятное: обрезка до топ-5–30 токенов, которую делают ради экономии, перенос усиливает, а не ослабляет.
Opus 5.5 объяснил куда больше нейронов, чем GPT-4 два года назад.
Яспер Бланк повторил эксперимент OpenAI 2023 года (LessWrong). Схема такая: одна модель объясняет, за что отвечает нейрон, вторая по описанию предсказывает активации. На выборке в 50 нейронов GPT-2 XL Opus 5.5 уверенно объяснил 8% против 0,3% у GPT-4.
Доверительный интервал широкий — от 3 до 19%, выборка крошечная, и менялись сразу три вещи. Так что это не прорыв, а полезная проверка на вменяемость. Вывод автора трезвый: если «чистота» значит, что каждый нейрон объясним одной фразой, то GPT-2 XL не чист — 92% остаются непрозрачными.
Воспоминания о раннем Anthropic.
Иван Вендров проработал в компании восемь месяцев в 2022–2023 годах на младшей позиции. В один вечер он выложил два текста (раз, два). Первый — мемуар без выводов: сорок человек на двух этажах, обет пожертвовать две трети своих акций, агент ФБР на общем собрании. И разочарование: стратегия полезного внедрения свелась к автоматизации поддержки ради выручки.
Второй — эссе с тезисом, что организация оптимизирована под накопление влияния при ограничении «выглядеть хорошими парнями». Читать стоит с поправками, и автор сам их расставляет.
Он был новичком три года назад и прямо пишет, что это не портрет компании. Сцена основания в палатке на фестивале — его собственная выдумка, помеченная как выдумка. Заголовок «Anthropic — хорошие парни» не ироничен, а эссе заканчивается словами, что сооснователи, возможно, уже спасли мир. В комментариях ему возражают с другой стороны: пост недостаточно критичен. Мемуар бывшего новичка — не портрет компании, а срез настроений. Полезное напоминание, что публичная миссия лаборатории и её внутренняя стратегия — два разных документа.
Архитектура без внимания: пока лабораторная игрушка.
Препринт с отсылкой к «Attention Is All You Need» предлагает заменить внимание геометрией (arXiv:2512.19428). Соседние токены кодируются как двумерные плоскости на грассмановом многообразии.
Звучит красиво, цифры скромные. Модели на 13–18 млн параметров. Перплексия на Wikitext-2 хуже трансформера на 10–15%. На классификации предложений перевес 0,27 пункта — и это один прогон. Обещанная линейная сложность не проявилась. На длинах до 256 токенов новая схема медленнее трансформера: под внимание написаны вылизанные ядра, а под это — нет. Автор один, аффилиация не указана, кода нет. Интересная постановка вопроса про интерпретируемость, нулевые практические последствия.
Юнис почти здесь.
Короткая заметка о романе Уильяма Гибсона «Agency» 2020 года (armincat.com). Там ИИ-ассистент параллельно разговору действует в мире сам: уводит деньги со счёта, пока героиня смотрит в окно.
Автор замечает, что разговорная часть и фоновая автономность пока существуют как отдельные классы продуктов — и вот-вот сойдутся. Практический вывод от себя: оценивать ассистента по качеству реплики уже бессмысленно. Спрашивать надо, что он сделал, пока говорил. И заводить журнал действий, а не доверие.
Коротко.
Выпуск Fedora 45 отложили: защита Anubis от массового выкачивания требует современного JavaScript, который придётся включать вручную. Побочный эффект войны инфраструктуры с ИИ-роботами (список рассылки Fedora).
Полиция Орегона выставила местному изданию счёт на 2,5 млн долларов за документы об одном полицейском: работу оценили в 44 816 часов. Параллельно та же полиция потратила 342 тысячи на ИИ-считыватели автомобильных номеров (The Intercept).
FOSDEM 27 открыл приём заявок в новую секцию «Цифровой диссидент». Темы: обход цензуры, связь без метаданных, инструменты для безопасной журналистики (talkweb.eu).