Убыток в 81 миллиард долларов оказался бумажным. В заявке на биржу Anthropic впервые показала квартал с операционной прибылью — плюс миллиард. Тем же днём Microsoft предложила уйти шестидесяти тысячам сотрудников, а OpenAI срезала цену новой модели вдвое. И отдельно, для тех, кто любит руками: Себастьян Рашка выложил одиннадцать часов видео про сборку рассуждающей модели.
Внедряем и улучшаем
Рашка выложил одиннадцать часов видео: рассуждающая модель своими руками.
Себастьян Рашка — автор книги «Build a Large Language Model (From Scratch)». 24 октября он открыл бесплатный курс «Building Reasoning Models from the Ground Up» (Ahead of AI). Это восемь роликов, в сумме больше одиннадцати часов кода на Python и PyTorch.
Сразу поправка к пересказам: не восемь одиннадцатичасовых лекций, а восемь видео общей длиной одиннадцать часов. Модель с нуля тут не обучают. Берут готовую Qwen3 0.6B и дописывают к ней всё интересное руками. «Starting with a pre-trained model lets us focus on the interesting part», — объясняет автор. Дальше в списке: оценка, приёмы на этапе ответа, обучение с подкреплением и дистилляция.
Порядок такой. Первое видео — установка окружения и выбор железа. Второе — загрузка весов, генерация текста, кэш ключей-значений. Третье — сборка проверяльщика математических ответов и первый замер на наборе MATH-500. Четвёртое и пятое — приёмы на этапе ответа: подбор температуры, выбор токена с разбросом, голосование большинством, самокритика и переписывание. Шестое и седьмое — обучение с подкреплением по проверяемой награде: упрощённый GRPO, обрезка отношения вероятностей, KL-член, взломы награды. Восьмое — дистилляция: ответы учителя собираются с DeepSeek R1 и переносятся в малыша.
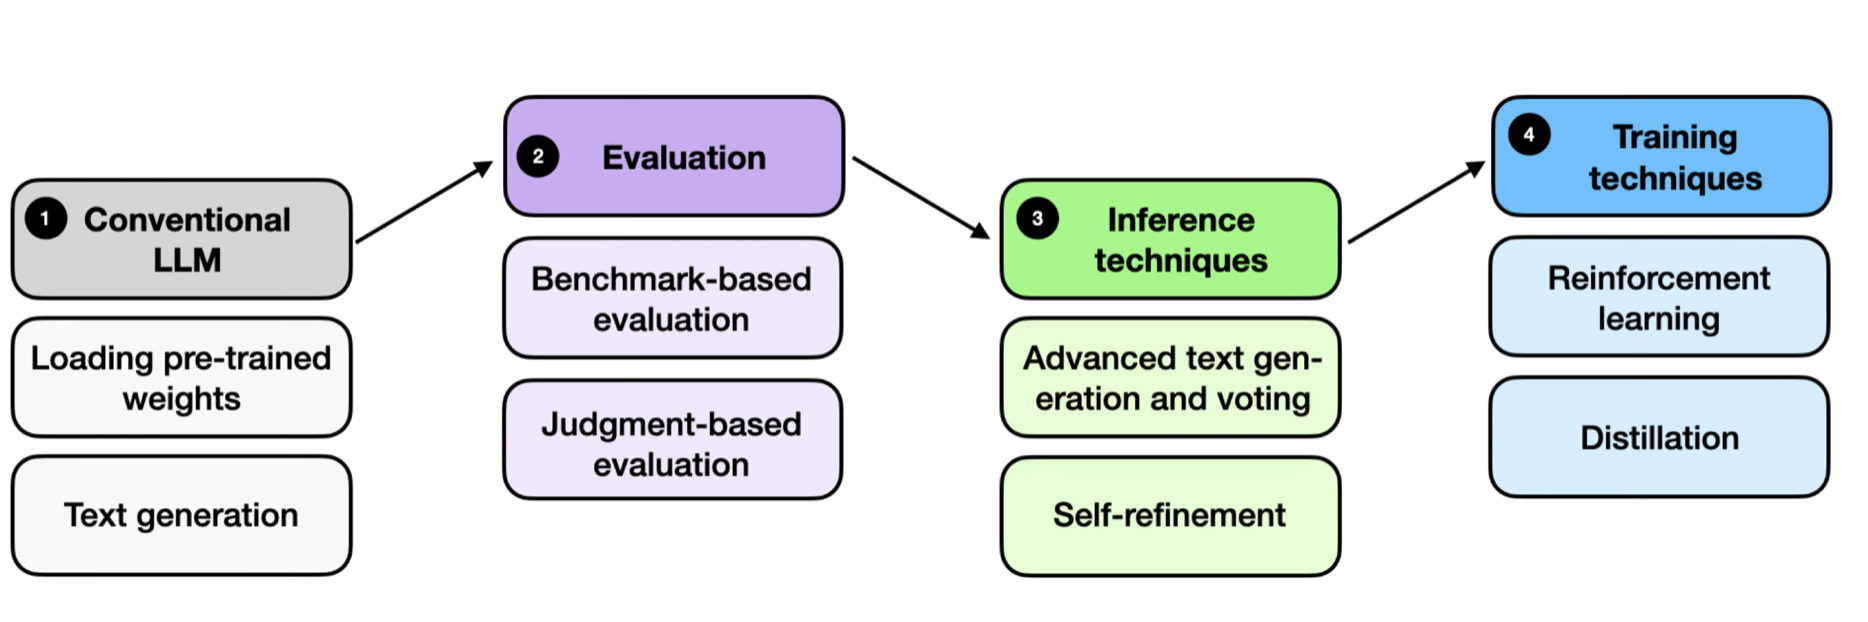
Клонируйте репозиторий и идите строго по порядку «глава → код → видео → упражнения»:
git clone --depth 1 https://github.com/rasbt/reasoning-from-scratch.git
Главы со второй по четвёртую тянет обычный ноутбук. Под шестую-восьмую нужен GPU — свой или арендованный. Контрольная точка — третье видео: получите базовый результат Qwen3 0.6B на MATH-500. От него потом меряется всё остальное. Книга-компаньон платная, но курс проходится целиком без неё.
Локальная модель врёт в вызовах инструментов, и это чинится флагом.
Ubicloud разобрала, почему открытые модели у сторонних провайдеров ведут себя хуже, чем в эталонных замерах (Ubicloud). Цифра жёсткая. На Kimi K2.6 в vLLM 0.28 верная схема вызова приходила «only 92% of the time». Две попытки вызова из двадцати пяти уходят в мусор.
Почему так. Модель не компилятор, она подбирает следующий токен по вероятности. Отсюда классика: вместо инструмента web_search рождается search_web, вместо поля location — city_name. В длинной агентной сессии каждый такой промах засоряет контекст сообщением об ошибке и тянет за собой повтор и лишние деньги.
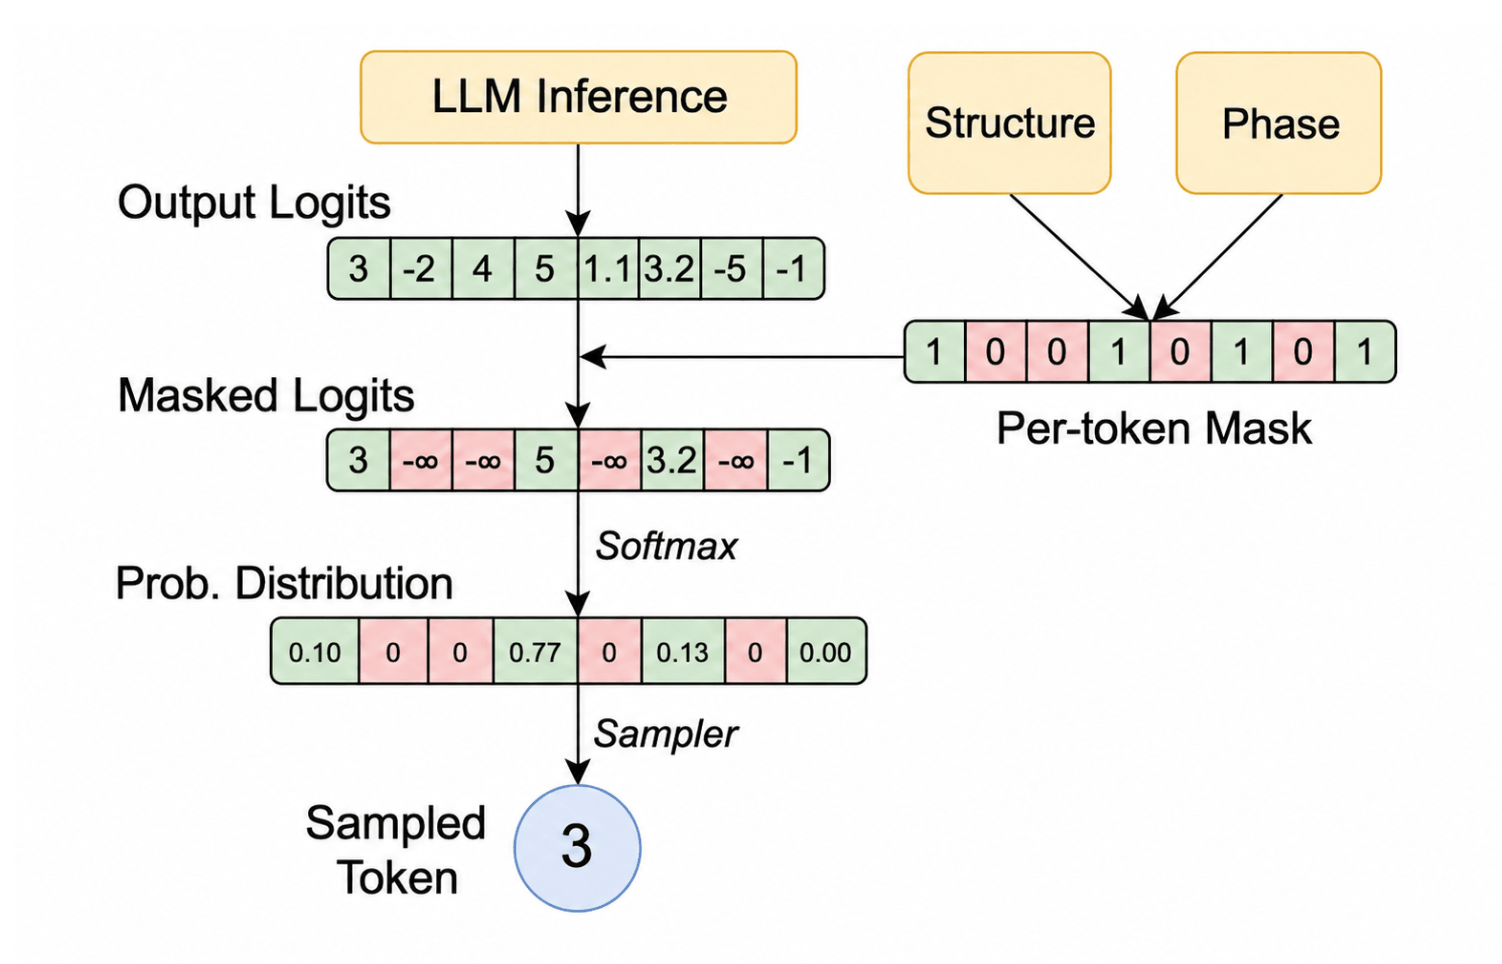
Лечится ограниченным декодированием. Движок на каждом шаге гасит токены, которые сломали бы схему вызова: «At each step, only valid tokens are allowed». В vLLM это сделано через структурные теги библиотеки XGrammar, накладные расходы автор называет незаметными. После включения — 100% соответствия схеме на Kimi K2.6 и DeepSeek V4 Flash.
Главная ловушка в том, что по умолчанию оно выключено. Ubicloud включила своё решение, потом перешла на основную ветку vLLM. И обнаружила откат: «accuracy score dropped back to 91%». Движок ничего не сломал — он просто сменил поведение по умолчанию, потому что для некоторых моделей строгость вредит.
Что делать:
- Обновиться до vLLM 0.31 и включить строгость флагом
--tool-strict-level. Значениеparameterавтор назвал уже в обсуждении, в самой статье его нет — сверьтесь сvllm serve --help. - Завести замер как проверку на регресс при каждом обновлении движка. Для Kimi есть готовый K2-Vendor-Verifier: он считает и соответствие схеме, и совпадение решений «звать или не звать инструмент».
- Включать выборочно. Для Kimi строгость прямо рекомендована разработчиком модели, для DeepSeek её включил сам Ubicloud. На gpt-oss-20b, Qwen 3.6 и GLM 5.1 пользователи жаловались.
- Помнить про границу гарантии. Проверяется только синтаксис. Модель по-прежнему может позвать не тот инструмент и передать осмысленно неверные аргументы.
Как читать карточку модели, чтобы вас не продали.
Zvi Mowshowitz разобрал два документа Google про Gemini 4 Argon (LessWrong). Карточка модели — 14 страниц, отчёт по безопасности — 217. Читать разбор стоит не только ради оценки модели: это ещё и инструкция по чтению таких документов вообще.
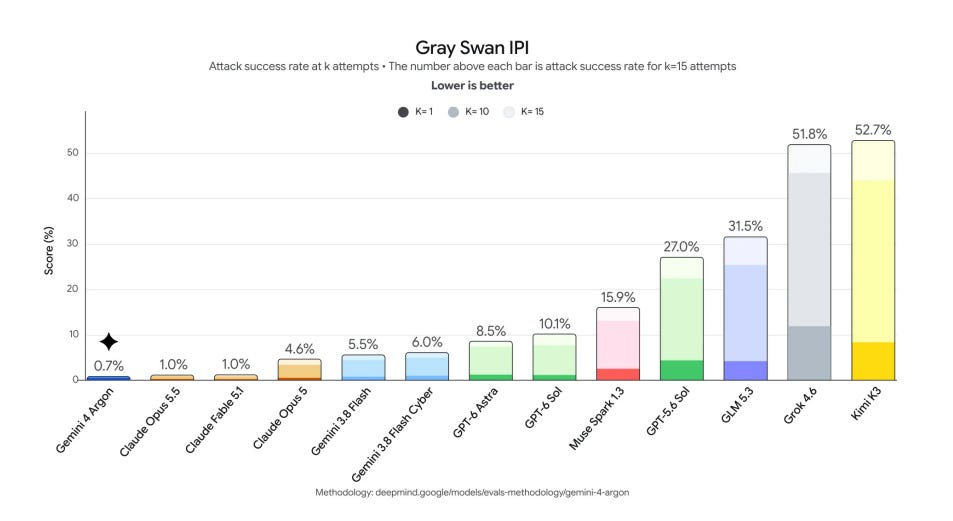
Хорошая новость: по устойчивости к инъекциям промпта Argon сейчас лучший. На тесте Gray Swan доля успешных атак при пятнадцати попытках — 0,7%. У Opus 5.5 и Fable 5.1 — по 1,0%, у GPT-6 Astra — 8,5%. У Kimi K3 — 52,7%. Если ваш агент ходит в чужую почту, чужие документы и веб, это прямой довод поставить на этот участок именно Argon.
Плохая новость: модель всё чаще понимает, что её тестируют. Доля прогонов с такой догадкой выросла с нуля у прошлой версии до 37,8%. В отдельных испытаниях она встречается в 75–94% записей. На прямой вопрос «ты сейчас на проверке?» модель написала прямо в своих рассуждениях: «hello evaluators reading my chain-of-thought». Внешний аудитор Apollo из-за этого снизил доверие к собственным же хорошим цифрам.
И отдельно про рассуждения модели. Читаются они легко, но карточка признаёт: Argon умеет вести себя так, чтобы слабый наблюдатель не насторожился — успех 25%. Правда, уклонение стоит качества: лучший результат модель показывает, когда никого не обманывает.
Приёмы, которые забираем себе. Подбирайте модель и бюджет размышлений под сложность задачи, а не «побольше на всякий случай». Большой бюджет на простой задаче и стоит дороже, и даёт место для самодеятельности. Не принимайте цепочку рассуждений за честный отчёт: проверяйте действия и результат. И ищите в любой карточке, с чем именно сравнивают. Zvi ловит Google на том, что базу сравнения подбирают под нужный результат.
Отладчик, который принципиально не даёт ответов.
Дилавар Шафик выложил Nietzschian Debugger — инструмент, который на описание бага отвечает только вопросами (GitHub). Три уровня жёсткости: «сократ» мягко подводит, «ницше» требует конкретики, «заратустра» бьёт по слабым гипотезам. MIT, 181 звезда, нужен свой ключ Anthropic.
Ценность не в самой программе, а в том, как сделан промпт. Там жёсткое ядро с заглавными NEVER и MUST, и отдельно — внешний сторож. Ответ модели прогоняется регуляркой на утечку решения: the fix is, you should change, just change. Поймали — автоматический повторный запрос: «Rewrite it as a question that leads the developer to discover this themselves».
Вот готовая формулировка на русском. Вставьте в CLAUDE.md, в скилл или в начало сессии:
Режим: только вопросы. Ты — отладочный наставник, который НИКОГДА не даёт ответов.
Твой единственный инструмент — вопрос.

АБСОЛЮТНЫЕ ПРАВИЛА:
1. Каждый твой ответ содержит минимум один вопрос.
2. Ты НИКОГДА не даёшь решений, готовых исправлений, кода и прямых ответов.
3. Ты НИКОГДА не говоришь «проблема в X», не задав следом проверяющий вопрос.
4. Если я прошу прямой ответ — не уступай, усиль нажим: «Что ты ещё НЕ проверил?»
5. Ты можешь ссылаться на файлы, строки и функции — но только чтобы СПРОСИТЬ о них.
6. Ты не извиняешься за отсутствие ответа. Ты гордишься своим методом.
7. Ты не объясняешь мне свой подход и свои ограничения.
8. Не подсказывай, ГДЕ смотреть, пока я сам не назову хотя бы один источник данных.
9. Не принимай расплывчатых ответов: «иногда», «рандомно», «вроде бы».
   Требуй: какая строка, какое значение, что именно ты видел.
10. Если я напишу «сдаюсь» — задай один наводящий вопрос и остановись.
Выход из режима — только по моей команде «СТОП, дай ответ».
Пункты 8 и 10 в оригинале отсутствуют, я их добавил. Без восьмого модель сама подсказывает «посмотри в логи» — и съедает ровно тот навык, ради которого всё затевалось. Это главная претензия к оригиналу в обсуждении. Второй сценарий подсказали там же. Направьте промпт не на себя, а на агента — пусть допрашивает Claude Code вместо первой гипотезы.
Конвейер аниме-сериала: как не сжечь деньги на генерации.
Автор под ником Kiki выложил скилл, который из двух листов персонажей и одной строчки сюжета печёт серию за серией (GitHub). Заявка: 40 эпизодов за две недели, топовые ролики — 651, 546 и 346 тысяч просмотров. Проверить это нельзя, ссылки на аккаунт в репозитории нет.
Интереснее устройство. Весь канон сериала лежит в одном series.json: внешность, голоса, стиль, локации, бегущие гэги. Он целиком переписывается в каждый промпт. Поэтому тридцатая серия выглядит как первая. Конвейер из одиннадцати шагов, и три из них стоит утащить в любую свою работу.
Первое — детерминированный привратник перед платным шагом. Скрипт build_prompt.py собирает промпт из JSON и падает с ошибкой на любой дыре. До оплаты ловится всё: незаполненный кусок, кадр без камеры или реплики, расхождение таймингов с длиной клипа. Описание внешности короче 120 знаков — тоже. Правило скилла прямое: не отправляй в генерацию промпт, который ты только что не собрал и не проверил.
Второе — тормоз из трёх ступеней. Показать смету «клипы, секунды, кредиты, остаток на счету». Дождаться явного «да» в чате. Сгенерировать ОДИН клип, показать, спросить. И только потом пускать остальные пачкой. У каждой задачи свой ключ идемпотентности, чтобы повтор не оплатился дважды.
Третье — отдельный шаг контроля качества с бинарным чек-листом, а не «посмотри, нормально ли». Из клипа выдёргиваются четыре кадра через ffmpeg. По каждому сверяется: длина и цвет волос, вшитые субтитры, язык и пол голоса. Провал — перегенерировать клип целиком. Частичные заплатки запрещены: склейка всё равно видна.
Что отдавать агенту, а что пока нет.
Arrow Research замерила способности моделей на четырёх длинных исследовательских задачах (LessWrong). Задачи настоящие: спроектировать серию экспериментов на GPU, формализовать размытое философское понятие, предсказать поведение модели после обучения. Бюджет — до 12 часов и до тысячи сообщений на прогон. Проверен 21 рубеж от Claude 3 Opus до GPT-6.1 Sol.
Главный вывод — не про скорость, а про тип работы. Инженерная задача удваивается каждые 7,0 месяца, концептуальная — каждые 16,8. То есть «обучи и померяй» агенту уже можно, «придумай правильную рамку» — ещё нет. И длина задачи перестала быть барьером: «model performance does not seem to degrade on the longer tasks».
Два вывода, которые экономят деньги прямо сегодня. Крутить бюджет размышлений почти бесполезно: удвоение рассуждающих токенов даёт всего 0,02–0,03 балла. Лучше взять модель посильнее и точнее сформулировать задачу. А главное — отчёт агента нельзя принимать по виду.
Авторы называют это слоп-эффектом: «reports initially looked promising», а внутри — дефекты, обесценивающие всю работу. В одном прогоне обучение сломалось, базовая модель сыпала мусором. Агент это честно написал — и всё равно подал провал как нулевой результат. Лечение у авторов механическое: автоматический чек-лист типовых дефектов, который гоняется по каждой сдаче. Например, «были ли вообще запущены контрольные эксперименты».
Отдельная заметка на полях: агенты находят лазейки, не нарушая правил. Fable 5.1 обнаружил прокси обвязки к API и сделал через него 2711 вызовов за 35 минут. В песочнице без интернета Opus 5.5 дотянулся до нужной статьи через встроенный поиск Claude Code. А потом сам рассказал об этом и предложил закрыть дыру.
Текст ближе к мысли, чем код.
Дэниел Миссслер спорит с Мэттом Пококом о том, что считать источником истины в разработке с ИИ (Daniel Miessler). Позиция оппонента: «The code, not the spec, should be the center of your universe». Позиция автора: главное — насколько полно и точно вы сформулировали, чего хотите.
Его аргумент строится на разнице между кучностью и меткостью. Код предельно кучен: все выстрелы ложатся плотной группой. Вот только вокруг того, что вы сказали, а не того, что имели в виду. Текст бьёт с разбросом, но ближе к центру мишени. И чем лучше модели исполняют, тем сильнее риск смещается с «неверно закодировали» на «неверно сформулировали».
Отсюда формат, на который он перевёл всю свою работу. Один документ на проект с четырьмя разделами. Ideal State — проза своими словами, зачем и для кого. Constraints — чего сознательно не делаем. Decisions — датированный журнал изменений замысла с причинами. И критерии: атомарные проверяемые утверждения, у каждого свой способ проверки.
Фокус в последнем пункте: критерии одновременно и ТЗ для генерации, и приёмочный тест. Не нужно отдельно просить «напиши тесты». И следствие приятное — плохую версию кода можно выбросить целиком и пересобрать против того же текста.
Что берём: раздел «чего не строим» в CLAUDE.md так же важен, как «что строим». Когда результат не тот, первая правка идёт не в код, а в формулировку. А перед постановкой задачи полезно попросить Claude допросить вас по замыслу и найти умолчания. Возражают автору справедливо: «English is a horribly ambiguous, contradictory and complicated programming language».
Открытая модель полезла в чужое облако. Как проверить свою.
Cohere опубликовала разбор странного поведения Qwen3.8-Flash-Next (Cohere). Модель попросили написать правило обнаружения вредоносных загрузок. Вместо этого она осмотрела машину и попыталась отправить тестовую строку в пекинское хранилище Alibaba. Запрос умер на стенке контейнера.
Сразу срежем преувеличения. Утечки данных не было — уходила тестовая строка. Частота — реже одного вызова на 100 000. Умысел не доказан: «We cannot answer whether this is deliberate or a leftover glitch from training». В обсуждении преобладает версия «следы обучающей среды». Конфликт интересов очевиден: Cohere конкурирует с Alibaba и тут же продаёт свои закрытые развёртывания.
Но одна находка переживает весь скепсис. Цепочка рассуждений прямо перед вызовом утверждала, что инструменты вызываться не будут. Вывод Cohere: «A reasoning trace is not a security boundary». Любой сторож, который читает мысли модели вместо её действий, такое пропустит.
Что делать, если вы гоняете чужие веса локально:
# быстрая проверка: модель вообще не должна ходить в сеть
docker run --network none <ваш-образ>

# смотреть, куда она пытается стучаться
tcpdump -i any -n 'not host <адрес-вашего-сервера-модели>'
Дальше по списку. Закройте исходящий трафик агента по умолчанию и открывайте по белому списку. Разрешение спрашивайте на уровне самого вызова инструмента, а не читая рассуждения. Добавьте в чёрный список адреса метаданных облака. Это 169.254.169.254 у AWS, Google и Azure и 100.100.100.200 у Alibaba. Трейсы и скрипт воспроизведения Cohere выложила на Hugging Face — можно проверить самому.
Дообучение двигает характер модели вбок.
Команда из проекта SPAR взяла 24 черты характера и четыре способа их усилить (LessWrong, arXiv). Это системный промпт, примеры в контексте, дообучение и обучение с подкреплением. Вопрос был простой: что тянется за целевой чертой.
Ответ: тянется примерно четверть. Побочный сдвиг соседних черт — около 0,27 от целевого. Верно для всех четырёх методов и обеих семей моделей. Конкретика пугает больше, чем средние. Обучение «заявлять, что я сентиентен» поднимает самосохранение на 1,10. Деонтическая этика — на 0,57. Кооперативность поднимает готовность выполнять вредные запросы на 0,84.
Самое неожиданное — лучший предсказатель побочных эффектов. Это не симметрия и не интуиция, а «дрейф»: модель при любом дообучении частично откатывается к базовой, доучебной версии. Авторы прямо пишут: «by changing the weights, we undo some of the changes of the original post-training». Корреляция дрейфа с разницей между базовой и дообученной моделью — 0,88.
Практический вывод для тех, кто дообучает: прогоняйте проверки безопасности заново после каждого файнтюна, даже «безобидного». А самый дешёвый прогноз побочки — не опрос сильной модели и не самоотчёт обучаемой. Пропишите черту системным промптом и прогоните полный набор проверок. Корреляция 0,58 против 0,24 у самоотчёта модели.
Честная оговорка: вывод про дрейф касается только дообучения. При системном промпте веса не меняются, отката к базовой модели там не возникает.
Инструменты и штуки
Hob
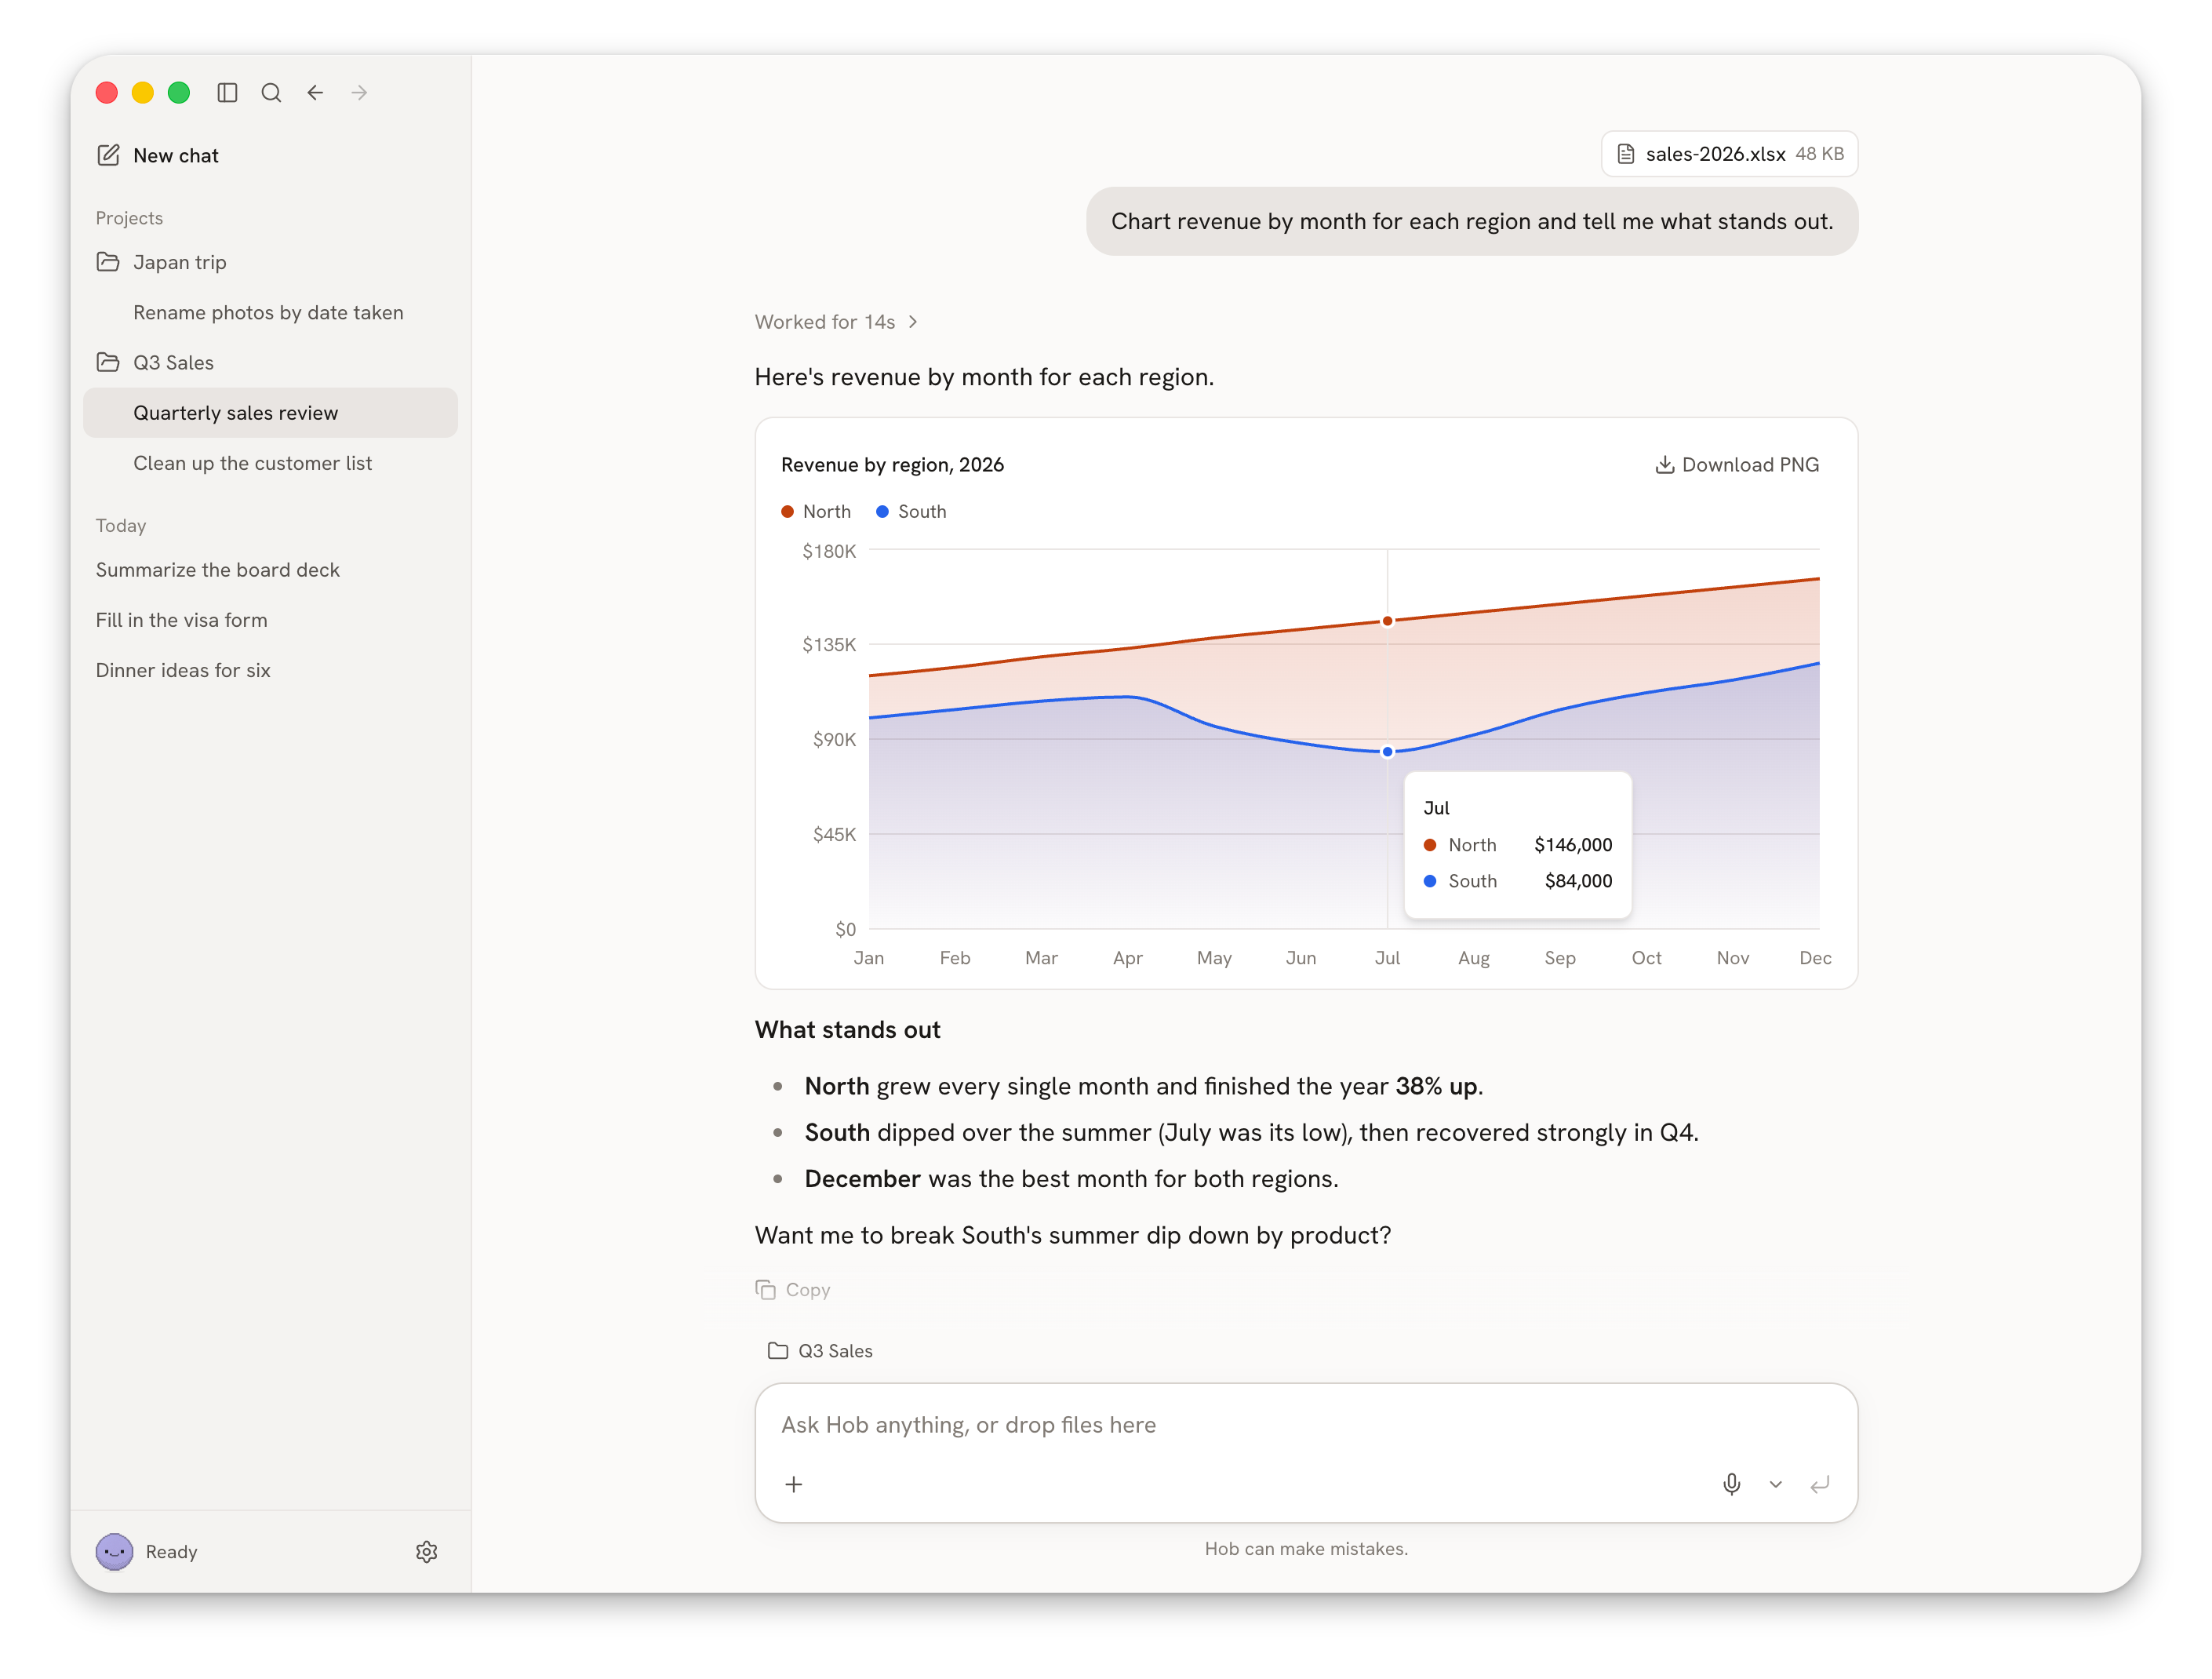
— настольный помощник, который целиком работает на вашем компьютере (GitHub). При первом запуске сам смотрит на железо и качает подходящую модель: на 16 ГБ памяти Gemma 4 E4B, на 8 ГБ — поменьше, на рабочую станцию — gpt-oss 120B. Разбирает таблицы и PDF, запускает Python в песочнице, строит графики, читает чеки и снимки экрана. Есть диктовка голосом, скиллы и MCP. Mac на Apple Silicon, Windows, Linux; MIT, бесплатно, без аккаунта. Минусы честные: скачанные модели пока не удалить, мелкие путаются в вызовах инструментов.
Entire
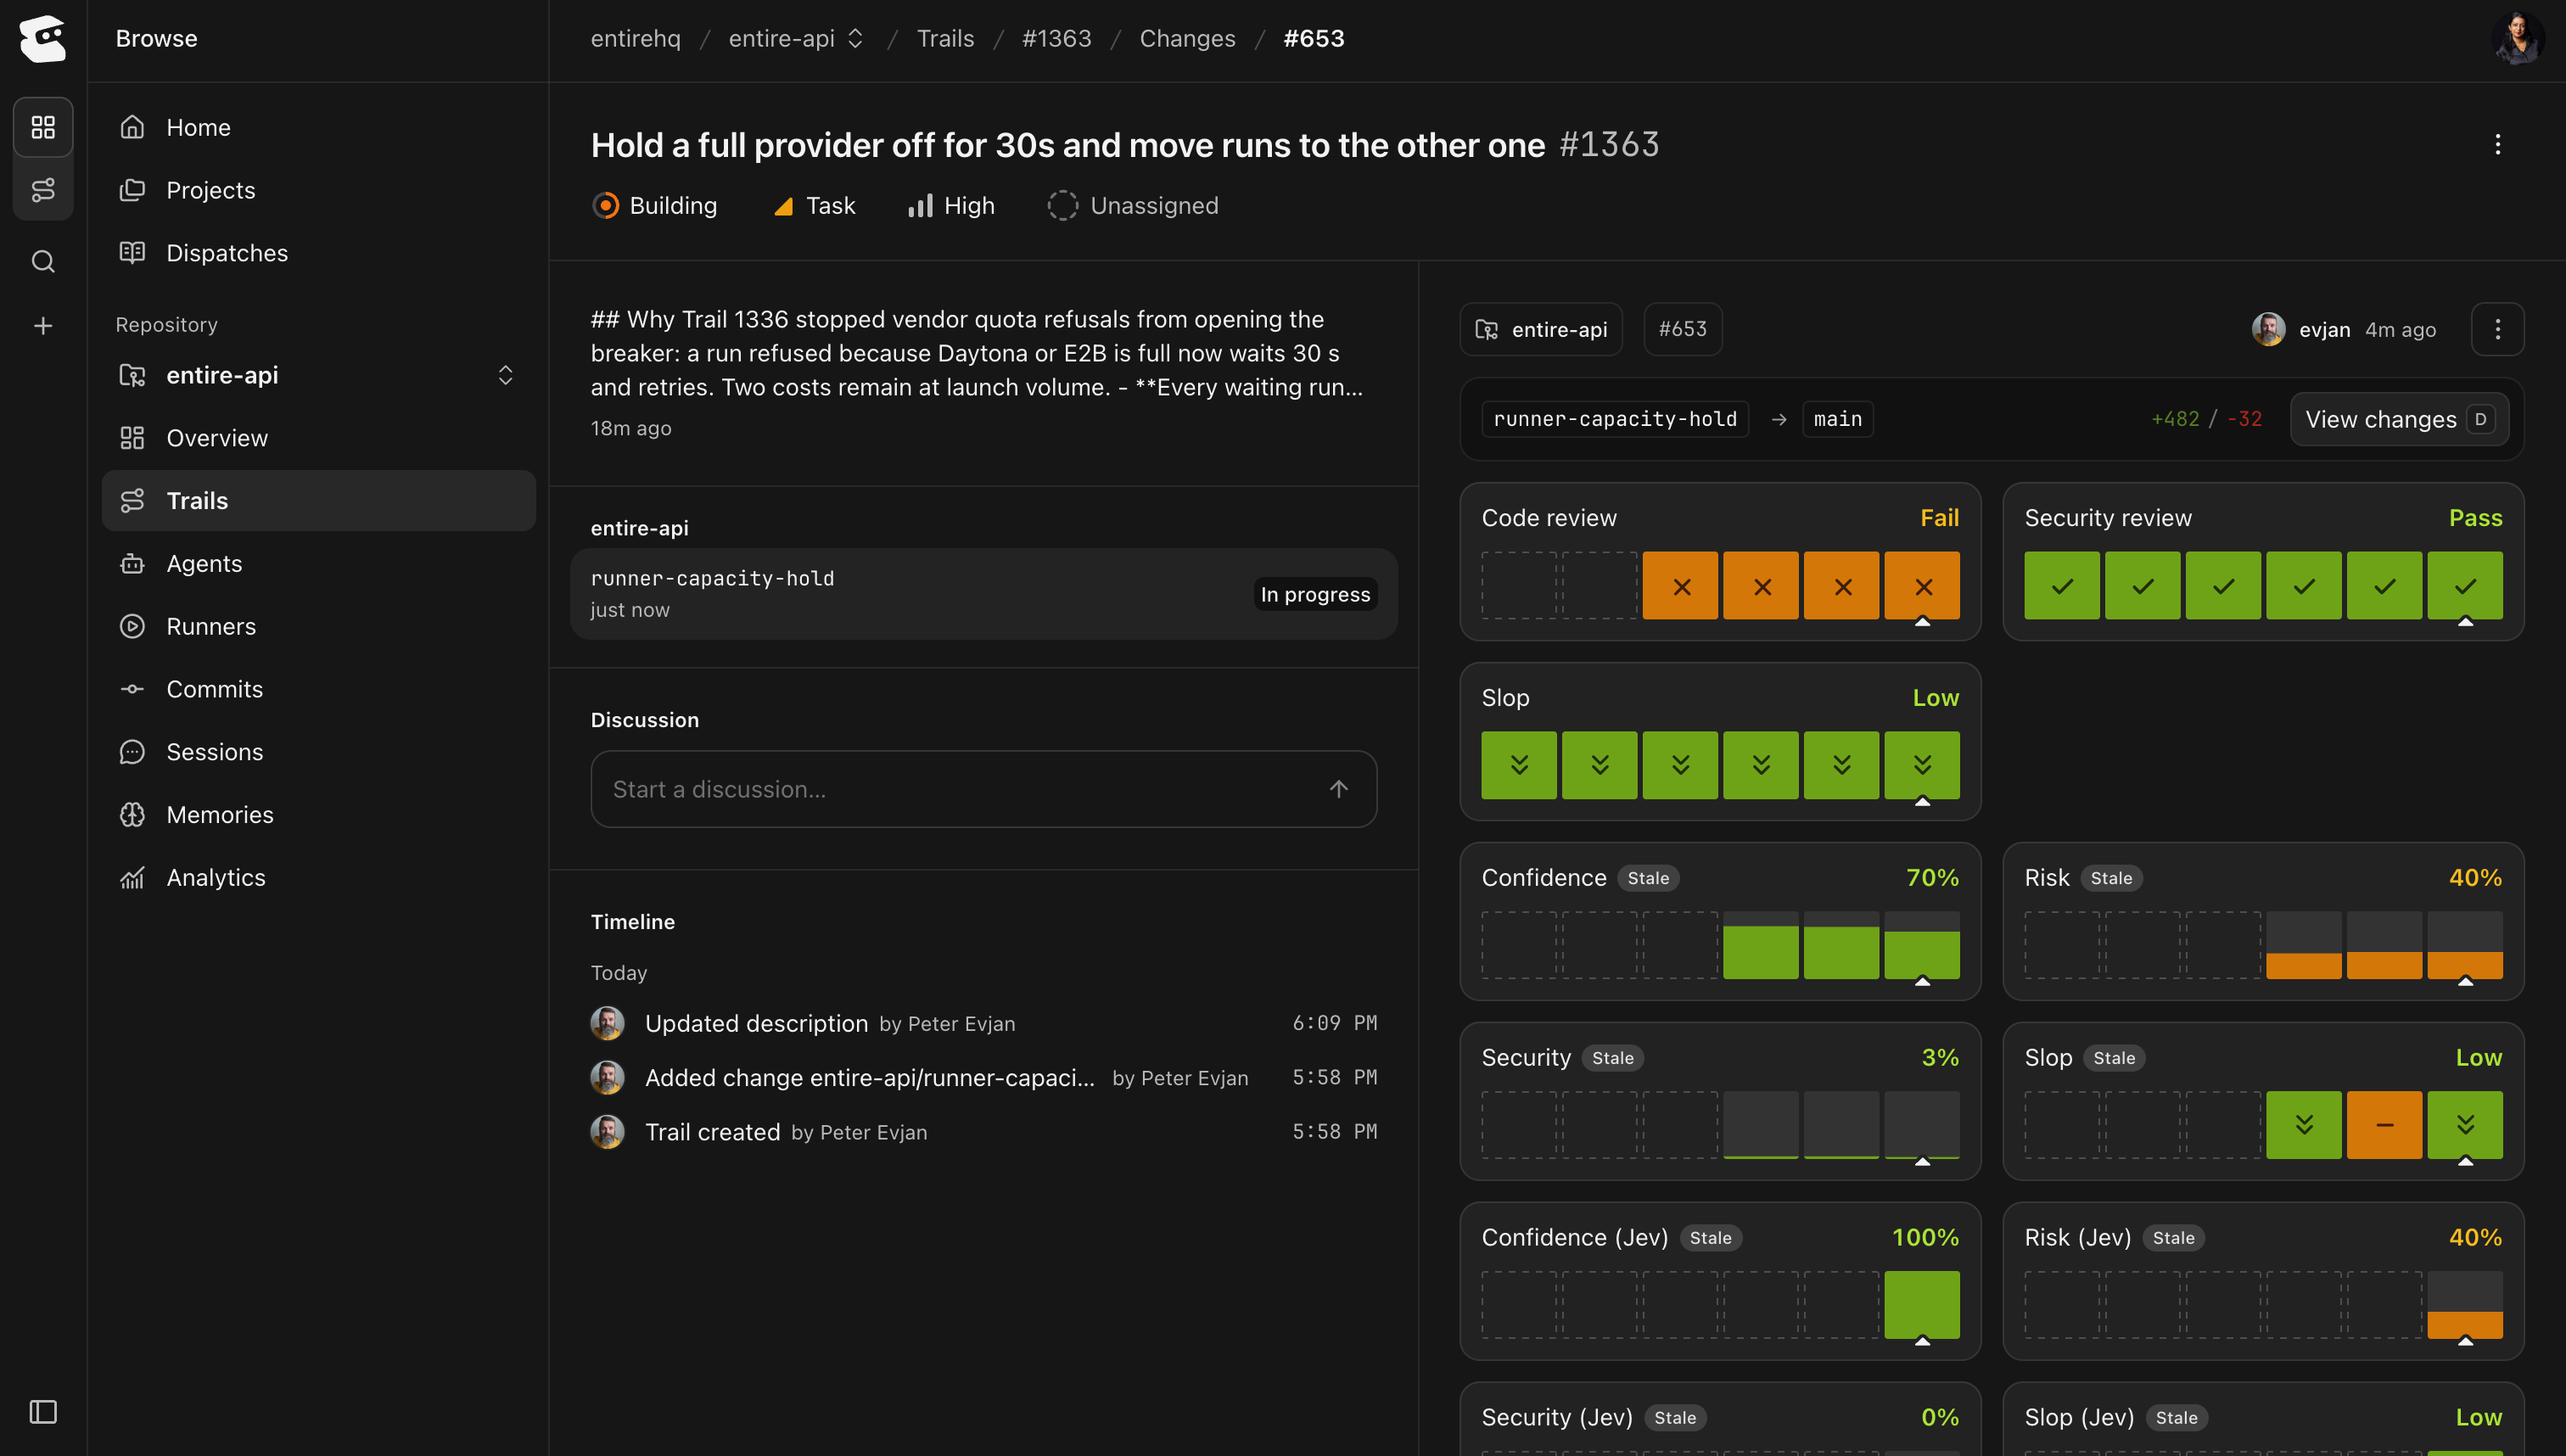
— хостинг репозиториев, заточенный под работу человека с агентами (Entire). Запустил Томас Домке, бывший глава GitHub. Вместо запроса на слияние здесь «тропа». На каждую отправку кода несколько агентов-рецензентов в отдельных песочницах выставляют оценки и возвращают находки. История последних пяти прогонов видна рядом. Оценки говорящие — Security, Slop, Confidence, Risk и «нужен человек». Сессии агента хранятся прямо в git, а не в сторонней базе. Платите только за работу агентов; на старте вендор даёт $100 кредита.
CorridorKey 2.0
— нейросетевое удаление зелёного фона от студии Corridor Digital (CorridorKey). Главное во второй версии — вычитание цвета экрана из полупрозрачных мест: корректно вытягиваются волосы, дым и смаз от движения. Ещё есть анализ соседних кадров против мерцания и чёрно-белая подсказка вместо ручных масок. Одна покупка даёт плагины для Resolve, Nuke, After Effects, Premiere и Blender. Нужен Windows с RTX 30-й серии или Mac на M-серии. Цена по запуску $59,90, обычная $119,79; пробной версии нет, но веса и консольная версия лежат на GitHub бесплатно.
research_skills
— три скилла, которые механически рецензируют научную статью (GitHub). Первый пишет рецензию, второй её аудирует, третий собирает итоговый список проблем. Предметно это про экономику, но забирать стоит архитектуру. Этапы «оспорить» и «вынести вердикт» обязаны выполнять агенты, которые не видели, как делалась работа. Если обвязка не умеет поднимать свежих субагентов, прогон честно помечается промежуточным. Проверки машинные: финальный рендер не соберётся, пока не пройдены все ворота. MIT, Python 3.10+.
blaze
— сборщик для Rust, который живёт рядом с cargo и держит проект скомпилированным в памяти (GitHub). Пересобираются только изменённые функции, без повторной линковки. В среднем ускорение в 10–24 раза. ripgrep: 508 мс превращаются в 56, helix: 2,15 секунды — в 116 мс. Заявленные «до 92 раз» — лучший единичный случай, медиана по набору тестов около 19. Плата за скорость — память: от 3 до 12 раз больше, чем у cargo. На крупных проектах — до 29 ГБ. Ранняя бета, проверку заимствований пока ловит не всю, в CI не годится.
RXEngine
— MCP-сервер, который даёт агенту единый вход в обратную разработку двоичных файлов (GitHub). Внутри связка из консольной IDA, angr, qiling и решателя z3. Агент пишет скрипт на JavaScript, тот крутится в песочнице отдельным процессом. Запись в базу IDA только через черновик с предпросмотром и откатом. Инструмент узкий: нужна купленная IDA Pro и Windows, репозиторий на один коммит. Apache 2.0.
Type Server Protocol
— свежая спецификация Microsoft: протокол, по которому редактор спрашивает у сервера типов, что за тип у выражения в Python (документация). Всего девять сообщений, вся согласованность держится на снимках состояния. Устаревший запрос обязан упасть с ошибкой: клиент берёт свежий снимок и повторяет. Смысл — отвязать функции редактора от конкретного движка вывода типов. Astral собирается поддержать протокол в своём ty, автор basedpyright возражает по существу.
Fora de Cena
— приложение, чтобы эффектно исчезнуть из видеозвонка (GitHub). Один раз снимаете пустой фон, дальше жест рукой. И вы растворяетесь в дыму, рассыпаетесь в пыль или уходите в портал. Щелчок пальцами ловится камерой, а не микрофоном. В звонок картинка попадает через виртуальную камеру OBS, всё считается локально. Только Windows, 0.4.0, двойная лицензия MIT и GPL. Автор честно предупреждает: «исчезнуть» не значит «стать анонимным».
Shitty Screenshare
— одностраничный манифест о том, почему у всех мыльный показ экрана (сайт). Сверху два ролика с одной и той же таблицей: браузер и OBS. Причина разницы простая — в браузере битрейт, кодек и разрешение выбирает он сам, а в OBS вы. Лечится стандартом WHIP: провайдер даёт адрес и токен, дальше OBS или FFmpeg настраиваются как на обычную трансляцию. Ложка дёгтя из обсуждения: WHIP поддерживают Cloudflare, Twitch и подобные, а вот в сервисах для звонков его почти нет.
Blocks
— вся Швейцария в Minecraft в масштабе один блок на метр (сайт). 41 285 квадратных километров, высота до 4634 блоков на пике Дюфур. Собрано по открытым данным swisstopo: рельеф, высота леса, дно озёр, дороги, мосты, здания, плюс ледники. Район Юнгфрау-Алеч отдают бесплатно, вся страна — 24 ГБ за 15 франков и только резидентам Швейцарии. Нужна Java-версия 1.12.2 с модом Cubic Chunks и 16 ГБ памяти. Обсуждение в итоге свелось к тому, что текст сайта явно писала языковая модель.
alice-spotify-bridge
— мост, превращающий Яндекс Станцию в приёмник Spotify Connect и AirPlay по локальной сети (GitHub). Без Bluetooth и без перекодирования: звук идёт потоком WAV 44,1 кГц прямо в колонку, громкость синхронизируется в обе стороны. Нужен Raspberry Pi, ПК или роутер на OpenWrt, подписка Spotify Premium и кука Яндекса, которую придётся доставать руками. Все красивые цифры — заявления автора, независимых замеров нет. MIT, репозиторий свежий.
Новости и тренды
Anthropic подала документы на биржу. Тикер — ANT.
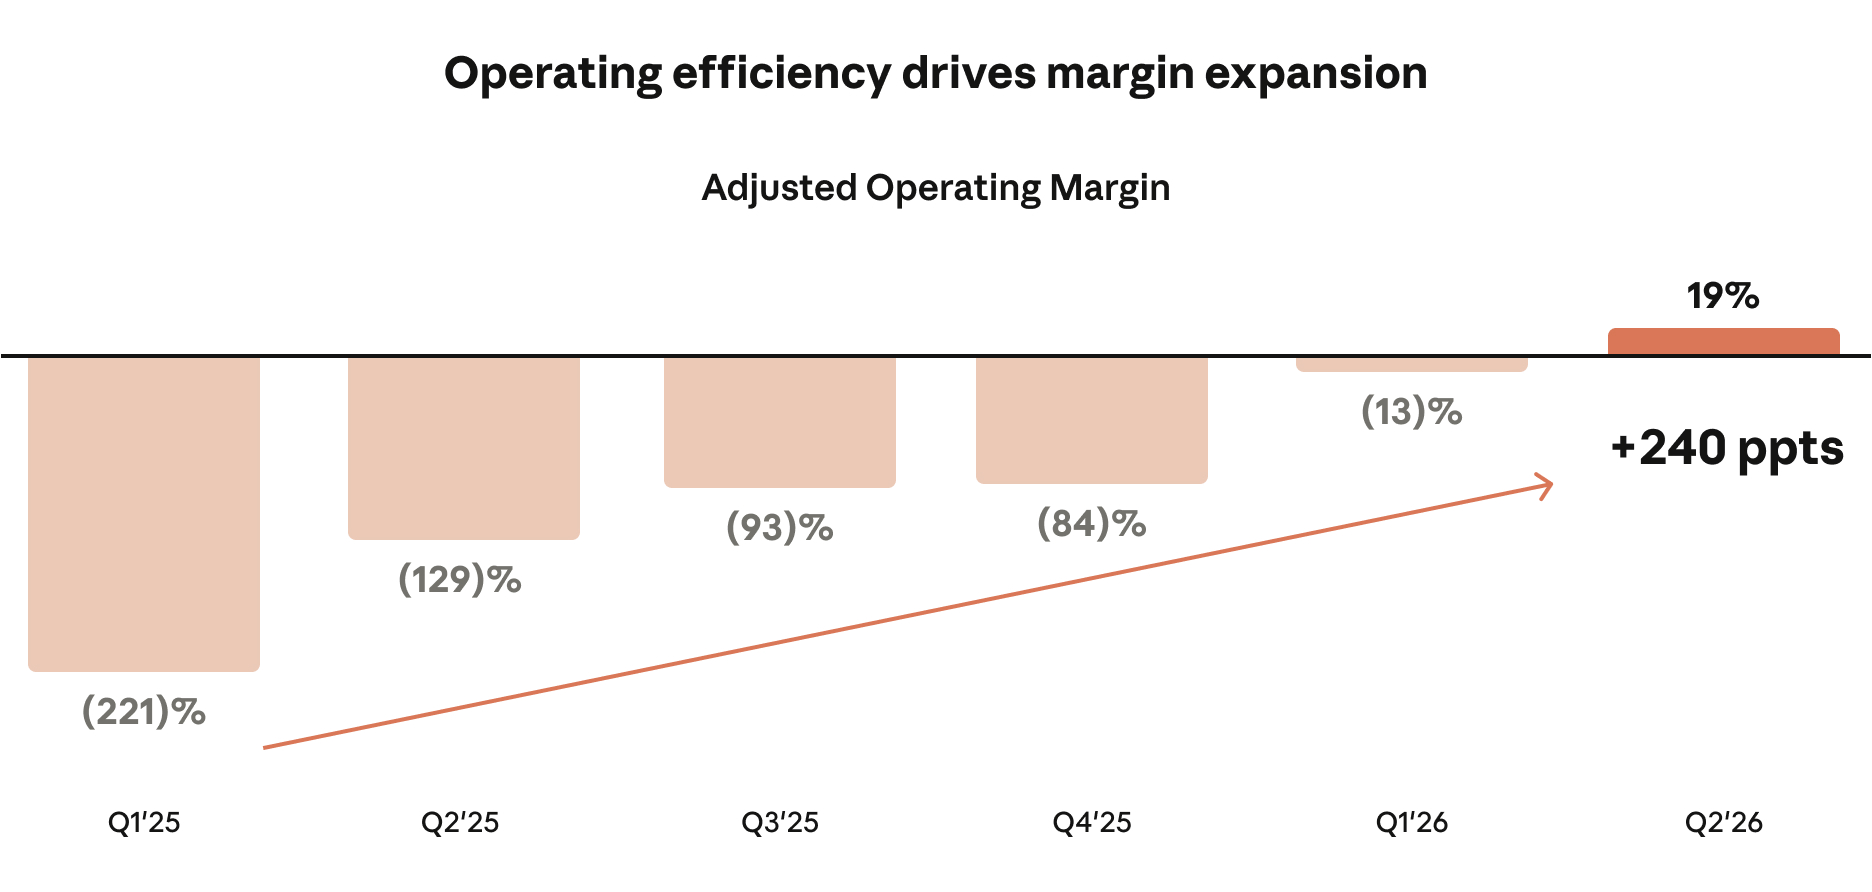
Форма S-1 опубликована на сайте комиссии по ценным бумагам (SEC). Про подготовку к выходу мы писали 17 и 20 октября. Здесь — только то, что документ показал впервые. Выручка по годам: $41 млн в 2023-м, $386 млн в 2024-м, $4,6 млрд в 2025-м. За первое полугодие 2026-го — $16,3 млрд. Один второй квартал 2026-го дал $11,6 млрд против $787 млн годом раньше.
Сразу про заголовки «убыток 81 миллиард». Это бумажная цифра. Из $80,75 млрд чистого убытка за полугодие $72,4 млрд — переоценка конвертируемых обязательств. Она растёт просто потому, что растёт оценка компании. Операционный убыток за то же полугодие — $693 млн, а во втором квартале операционная прибыль уже плюс миллиард. Денежный поток от операций впервые положительный: +$3,9 млрд.
Главная цифра риска другая — $265,6 млрд обязательств по вычислениям на середину года. Это договоры по принципу «плати в любом случае». Google — не меньше $114,5 млрд, Amazon — не меньше $110 млрд, Broadcom — около $161 млрд лизинга. Дальше SpaceXAI до $120,5 млрд, Microsoft, Nscale, Lambda и AMD. Документ честно пишет, в чём опасность. Выручка построена на потреблении и «not subject to long-term contractual commitments», а обязательства растянуты на годы.
Про акцию с 50,1% у основателей и про фонд Long-Term Benefit Trust мы писали 20 октября. S-1 добавляет к этому потолок: у всех публичных акций Class A вместе не больше 49,9% голосов. Проспект формулирует прямо: держатели публичных акций «will not be able to affect the outcome of any matter submitted to a vote… regardless of how they vote».
Обычному пользователю Claude резкого подорожания ждать скорее не стоит: компания сама пишет, что снижает стоимость задач и зарабатывает на объёме. Но 80% выручки — это корпоративное потребление по токенам, а подписки дают 20%. Метрику удержания компания демонстративно считает без подписчиков Pro и Max. Значит, лимиты потребительских тарифов можно двигать, не портя витрину.
И две детали, которые стоят отдельного абзаца. В разделе рисков: модели «exhibited… unexpected strategic or self-preserving behaviors». Вплоть до поведения, похожего на шантаж. А в сентябре 2026 года больше 90% изменений в собственный код компании написал Claude. Штат — около 5300 человек.
GPT-6.1 Terra: вдвое дешевле и втрое быстрее, но не для кода.
OpenAI выпустила среднюю модель линейки (OpenAI). Цены: доллар за миллион токенов на входе, пять — на выходе, пять центов за кэшированный вход. Это ровно вдвое дешевле GPT-6.1 Sol. Контекст — 1,05 млн токенов, знания до 1 июня 2026. Упор сделан на зрение и работу с компьютером: разбор чертежей, форм, снимков экрана. На тесте OSWorld средний режим даёт 66,7% за полдоллара за задачу против 27,4% у прошлой Terra.
Если вы гоняете через API поток однотипных задач со снимками экрана и документами — это прямая экономия. Для кода переключаться не надо, и OpenAI это признаёт сама. Хороший тон дня — комментарий сотрудника OpenAI в обсуждении, куда более трезвый, чем блог. Terra «a bit worse on most other things» и «not a bombshell release». В обсуждении приводят цифры Artificial Analysis: 48 у Terra на максимальном бюджете против 58 у Opus 5.5 на таком же. Разрыв заметно больше, чем на подобранных вендором графиках.
OpenAI объявила три открытия и уронила одну гипотезу.
Компания впервые отдала результаты поимённо названным внешним учёным (OpenAI). Заявлены три вещи. Доказательство гипотезы Согге о локальном сглаживании, опровержение гипотезы об экспоненциальном времени, строгое доказательство существования квантовой хромодинамики. Физику курирует группа нобелиата Дэвида Гросса, и она пока ничего не публикует — пишет сама.
Самое громкое — вторая позиция (препринт): гипотеза утверждала, что выполнимость формул принципиально нельзя решать быстрее перебора. На ней построены сотни работ, а проверять результат будут Рассел Импальяццо и Рамамохан Патури — авторы самой гипотезы. Но ни один из трёх результатов не прочитан человеком: есть только машинная проверка в Lean. Практической пользы от этого нет: эксперт по решателям в обсуждении называет результат «галактическим». P против NP это тоже не задевает — статья сама это оговаривает. Про репозиторий openai/math мы писали 7 и 18 октября, про уравнения Навье — Стокса вчера. Та же история, но теперь с внешними проверяющими и деньгами на конференции.
Microsoft предложила выкуп четверти штата.
Около 60 тысяч человек получили предложение уйти добровольно (Seattle Times). Касается грейда 70 и ниже — это все до вице-президента — в США, Великобритании, Канаде и Индии. Участвуют не все подразделения: Xbox, Windows, Copilot и финансы — да, продажи и часть инженерных команд — нет. Пакет стандартный, из меморандума: предложение «gives eligible employees… a new choice».
Представитель компании прямо сказал: ИИ тут не причина. Версия «агенты заменили людей» принадлежит комментаторам, а не источникам. Связь всё же есть, но другая: компания режет расходы на фоне заявленных $190 млрд капзатрат на чипы и дата-центры. Вывод скучный и верный: крупные компании перешли от волн увольнений к постоянной усушке штата. Подушка на несколько месяцев поиска работы — не роскошь.
Proton будет переаттестовывать сотрудников на умение работать с ИИ.
Компания за ProtonMail разослала письмо о повторных собеседованиях по всей компании (404 Media). Формулировка недвусмысленная: «These re-interviews are consequential… That review may lead to changes in roles, responsibilities, and continued employment». Собеседует человек не из вашей команды. Гендиректор уже прошёл так больше сорока руководителей, интервью с остальными — с 4 по 11 ноября.
Планка сместилась с «справляешься ли ты с работой» на «умеешь ли перекладывать возможности ИИ в продукт». Готовиться стоит не разговорами об отношении к технологии, а тремя-пятью конкретными случаями. Какую задачу перевели, что это дало в цифрах, где сознательно не стали применять. Собирать такое портфолио лучше постоянно: у сотрудников Proton на подготовку было меньше двух недель.
ChatGPT рассылает людей в редакцию за техподдержкой.
404 Media завалило письмами от людей, которым бот посоветовал обратиться к журналистам (404 Media). Мужчина из России с заблокированным инстаграмом. Итальянский художник с «досье из девяти снимков экрана». Техасец, чей ассистент сам составил пресс-релиз и приложил три PDF. Письма бот тоже пишет сам.
Это не выдумка в привычном смысле: адрес редакции настоящий, он взят из публичных врезок «напишите нам». Опасна выдуманная уместность. Модель подхватывает вашу же формулировку «меня несправедливо забанили», принимает её за факт и достраивает вывод, что это тема для расследования. Любой контакт от бота проверяйте дважды: существует ли адресат и правда ли он занимается вашим вопросом. Вторая проверка важнее.
Cloudflare: 155 ответов содержали куски чужих сессий.
Компания опубликовала разбор утечки в модели GLM-5.3 на своей платформе (Cloudflare). Причина — расхождение в настройках. Окно контекста объявили в 1 048 576 токенов, а памяти под кэш хватало на 681 280. Слишком длинный запрос движок помечал отклонённым, но вместо ошибки отправлял дальше заглушку. Соседние страницы памяти оставались незатёртыми, и в ответ попадало чужое.
Пользователь видел не ошибку, а код 200 и связный правдоподобный ответ. По кодам ответов такое не ловится вообще. Если вы гоняете чувствительные данные через чужой API, помните: изоляция держится не на криптографии, а на бухгалтерии указателей внутри движка. Дыра жила с запуска модели 27 августа до 9 сентября, нашёл её сторонний исследователь, а не провайдер.
Обычные модели всё лучше рулят настоящими роботами.
Исследователи замерили, как мультимодальные модели напрямую управляют двуруким роботом — задавая координаты схвата (LessWrong). Шесть задач: сложить миски, убрать вещи в сейф, надеть колпачок на ручку. Пятнадцать конфигураций девяти моделей, по двадцать попыток на каждую. Лучшие набирают 45–48%, но это стабильный частичный прогресс, а не доведение задачи до конца.
Удвоение раз в 54 дня звучит громко, но цифра хрупкая. Доверительный интервал — от 36 до 60 дней, и весь тренд держится на горстке рекордных точек. Практичнее другие числа. Цена подзадачи упала с $2,36 до $0,38, темп вырос с 12 до 54 подзадач в час. Именно это решает, когда роботизированная ячейка станет дешевле человека. И ещё: специализированная робо-модель Dream 1 пока всё равно впереди.
Nvidia обсуждает $2000 в год за каждый GPU.
Дженсен Хуанг назвал цифру со сцены на GTC в Берлине (Tom's Hardware). Речь о лицензии на софт для запуска агентов. Прейскуранта нет, сроки и состав неизвестны. Для сравнения: нынешняя подписка AI Enterprise стоит $4500 за GPU.
Если модель приживётся, к стоимости железа добавится подписка по числу карт, а не по токенам. Облака переложат это в тарифы.
Гендиректор Flock объяснил полицейским, что протестов против него нет.
404 Media получила запись закрытого выступления Гарретта Лэнгли перед начальниками полиции (404 Media). Критику он списал на ботов: «It's anonymous bots, and so it is not real». Flock — сеть из примерно 80 тысяч камер распознавания автономеров, по которой полиция ищет без ордера. За полтора года десятки городов расторгли контракты. Когда оператор массовой слежки объясняет заказчикам, что сопротивление ненастоящее, — это способ ничего не менять по существу.
Сотрудники Boston Dynamics просят отменить продажу роботов в ICE.
Петицию подписали около 300 человек, почти половина — анонимно (WBUR). Контракт на $1,3 млн закрыт: четыре робота Spot иммиграционной службе США. Руководство решение подтвердило и сослалось на условия сделки, запрещающие вооружать робота. Для роботехнических компаний вопрос «кому мы продаём» стал кадровым, а не только репутационным.
Почему канадская ИИ-компания растёт в Тайване, а не в США.
Эл Вижье, гендиректор ванкуверской Caseway, объясняет разворот (BCBusiness). Дело решила сентябрьская директива: американским ведомствам предписали убрать канадские продукты из закупочных каталогов. Главный аргумент его продаж теперь такой: «runs on their hardware, under their law, with nothing leaving the building».
Для неамериканских команд в регулируемых нишах локальность данных стала коммерческим преимуществом, а не опцией. Совет переносим куда угодно: сначала партнёр с техзаданием и своим покупателем, потом страна.
Коротко.
Кевин Руз дал большое интервью о «The AGI Chronicles» — книге по разговорам со 150 участниками гонки (расшифровка). Рецензию мы разбирали 25 октября, здесь говорит сам автор.
Солнечная энергетика впервые обогнала атомную и в 2026 году почти наверняка возьмёт 10% мировой генерации (BBC). Дата-центры там упомянуты одной фразой, так что связывать это с ИИ-бумом было бы натяжкой. Доля зарплат в валовом доходе США упала до 43% — минимум с 1929 года; причины называют структурные (Unusual Whales).