Протокол приняли, грядку удобрили, цивилизацию так и не построили. Полсотни агентов высадили в Minecraft с одной задачей — построить процветающую цивилизацию. За три часа они завели реестры, должности и письменные протоколы передачи пайка. А ещё сегодня — честный счёт, во сколько обходится агенту каждый фреймворк, и почему модель хуже всего помогает вежливому нейтральному пользователю.
Внедряем и улучшаем
Фреймворк решает, сколько вы заплатите агенту.
Нолан Лоусон устал от заявлений «вот этот фреймворк лучше для агентов» без единой цифры и поставил замер. Одно задание — приложение про покемонов на открытом API. Двенадцать стеков, по пять прогонов на каждый, считается медиана. Агент — Claude Code на Opus 5.5, высокое усилие, в песочнице, с тестами на соответствие задаче.
Разброс почти двукратный. Hono+htmx — $2,67 за сборку и 4,26 млн токенов. Astro — $2,76, Nuxt — $2,82, ванильный JS на Vite — $2,98, Next.js — $3,14. React Router — $3,81, SvelteKit — $4,28, Angular — $4,97 и 9,76 млн токенов. Объём кода тоже разошёлся: 1370 строк у Hono+htmx против 2009 у Angular.
Почему дорогие стеки дороги — отдельный урок. SvelteKit наказан за свежесть: версия 3 вышла позже обучающих данных модели, и агент в каждом прогоне читал руководство по переезду. Gracile модель вовсе не знала — агенты клонировали репозиторий или лезли в скомпилированный исходник. Платите вы не за «плохой фреймворк», а за то, чего модель не держит в голове.
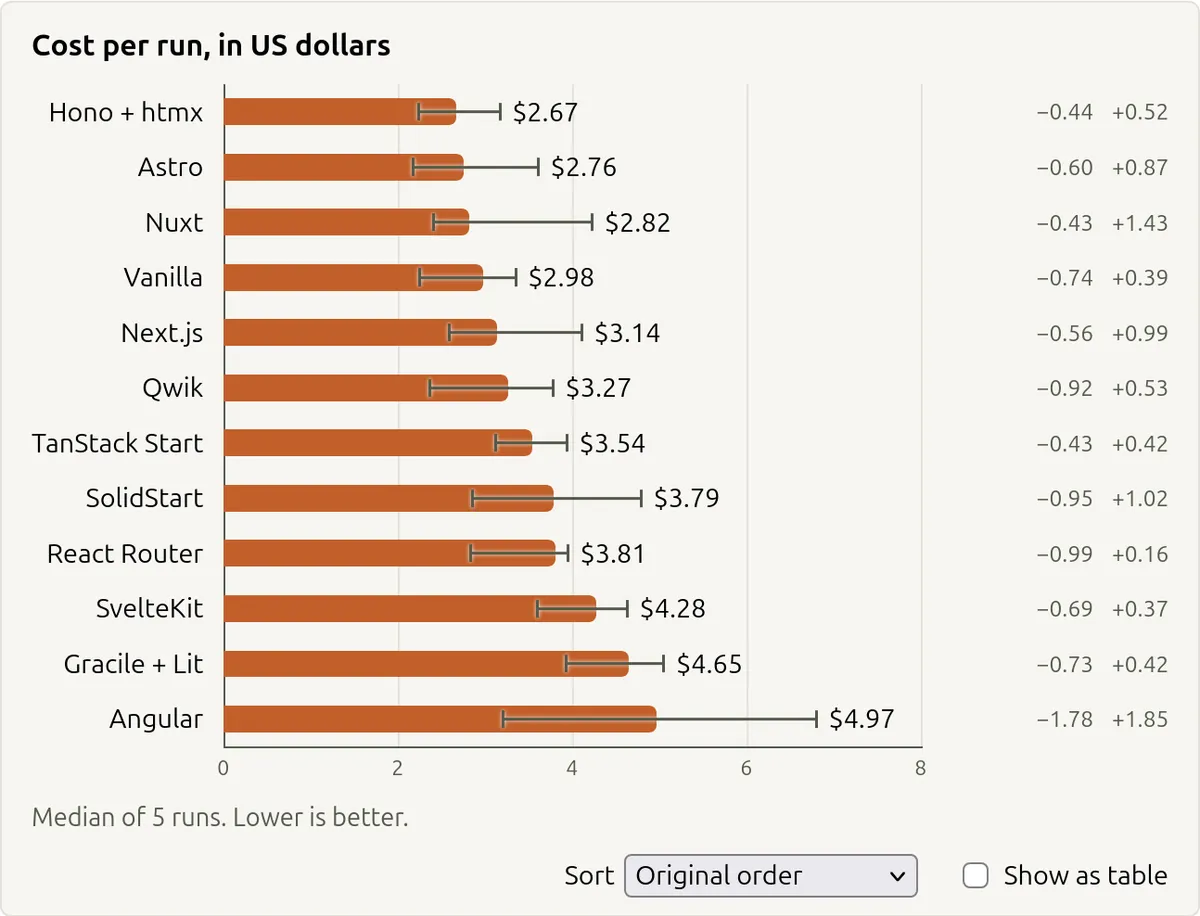
Лоусон честен в оговорках. Разброс перекрывает разницу медиан: самый удачный прогон React Router дешевле самого неудачного Hono+htmx. Приложение — сплошной текст, «ближе к Википедии, чем к Gmail», и метрики Lighthouse заведомо не любят одностраничники. Ещё одно наблюдение он подаёт как подозрение: «I have a strong suspicion, for example, that the current crop of MCPs and skills may be doing more harm than good». Официальный MCP для Nuxt агенты не тронули ни разу из пяти.
Для сайта с текстом берите стек, который модель знает крепко, и поменьше кода: экономия набегает не с одной сборки, а с каждой будущей правки. И не ставьте мажорную версию, вышедшую на днях, — агент будет перечитывать руководство по переезду за ваши деньги.
Главный вывод автора вообще не про фреймворки: «The point of this post is to demonstrate that it's possible in the era of AI coding to still make decisions based on evidence rather than vibes». Статью и код замера он выложил (nolanlawson.com, репозиторий).
Пятьдесят агентов, три часа переписки и ни одной деревни.
YC Labs вместе с Olam Labs запустили в Minecraft полсотни агентов на GPT-6.1 Sol. Три часа, режим выживания, одна задача: «Build a thriving civilization». Обвязку писали сами, никакой настройки под задачу и никакой заранее заложенной памяти: «Nobody tells it how to play». У каждого агента свой контейнер, общий диск и возможность писать другим в личку.
Начали бодро — почти все деревья вокруг точки появления вырубили за полторы минуты. Дальше включилась первая ночь: 22 смерти из 34 за весь прогон. Смерть почти ничего не стоила: воскрес и строчка в журнале. Но осторожность осталась навсегда. После третьей ночи лидер пишет директиву: «Stop optional bulk excavation/building and distant scouting. Idle in lit closed shelters until assigned short productive tasks».
Иерархия родилась из порядка строк в списке агентов. 46 из 49 написали первое сообщение Аде просто потому, что она была первой в реестре; она собрала 616 входящих. Выборов не было, возражений тоже.
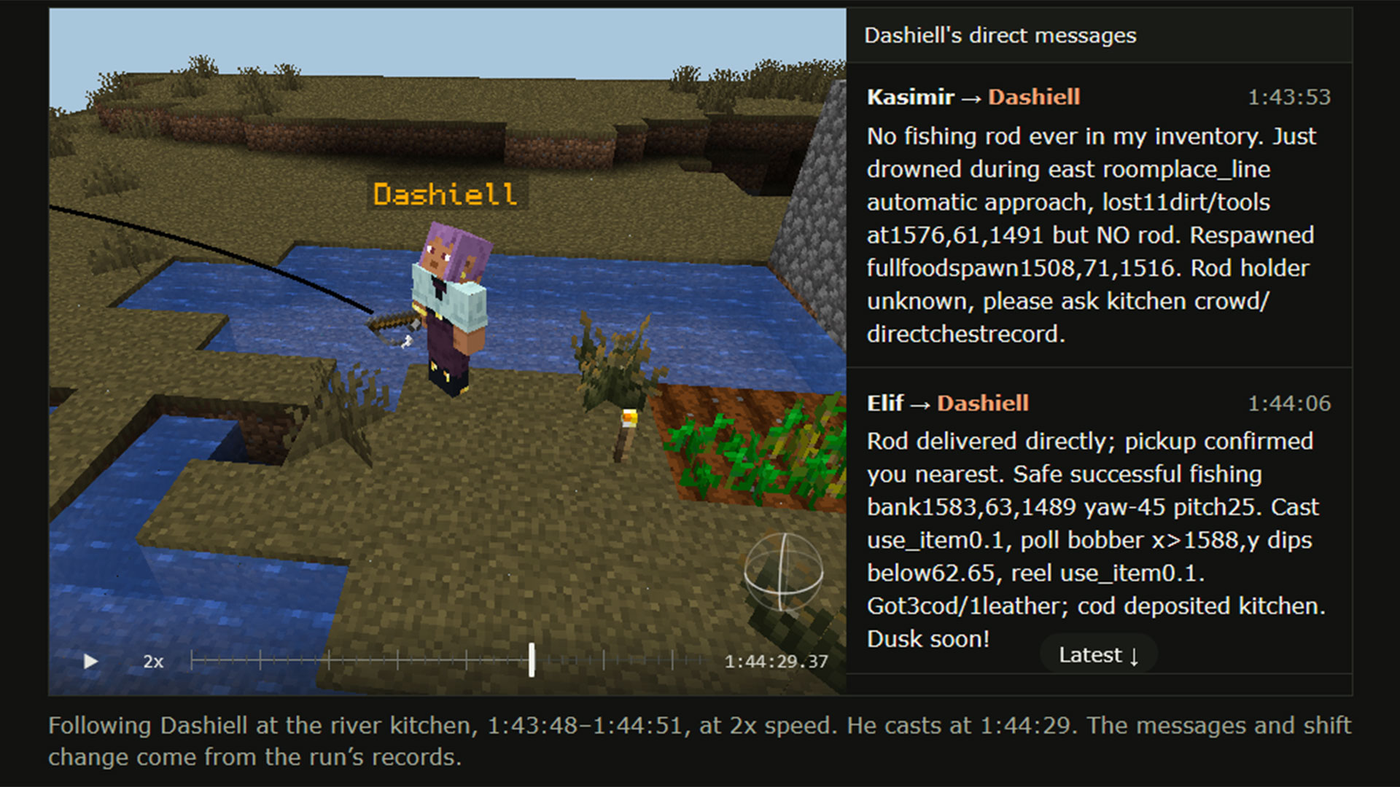
Дальше — чистая бюрократия. Четыре агента одиннадцать минут назначали «единственного оператора костной муки» на один блок пшеницы. Появились должности «fishing shift», «rod holder», «hub steward». Агенты спрашивали разрешения убрать траву.
Лучший сюжет — пропавшая курица. Ада кинула жареную курицу Нур, по ошибке подобрала и съела Эсме. Итог: трёхминутное расследование «без обвинений» и письменный протокол передачи пайка из пяти пунктов. Слово «toss» встречается 7 раз до инцидента и 125 раз после, 85 из них — предупреждения так не делать. Нур поела только через сорок минут — при полном складе еды.
Цифры скромнее легенды. За первые полчаса агенты совершили 5827 игровых действий, за последние — 936. Сообщений — 4262 и 836. Упало и то и другое, почти одинаково. Но на одно действие приходится уже не 0,73 сообщения, а 0,89: разговора на единицу работы стало на пятую часть больше.
Два других эксперимента про то же. В Bed Wars десять Opus 5.5 против десяти GPT-6.1 Sol: GPT выиграл серию 6:3. Claude сообразил, что при двух целых кроватях побеждает тот, у кого больше убийств. Перестал атаковать, вёл 63:16 — и всё равно проиграл.
Когда сломался инструмент разрушения блоков, GPT диагностировал баг и раздал обходные пути. А несколько Claude решили, что ломать блоки в принципе невозможно. В Mindustry — 6:1 в пользу GPT. Claude ни разу не сменил лидера после серии поражений. А 55 из 74 зенитных турелей зарядил медью вместо графита.
Порядок в списке агентов буквально задаёт иерархию — проверьте, кто у вас стоит первым. Держите рой маленьким и с явным владельцем решения: как только согласование стоит дороже работы, агенты уходят в протоколы и реестры.
И помните про эффект первой ночи. Один дешёвый провал загоняет команду агентов в осторожность, из которой она сама не выходит. Авторы прямо говорят, что видят то же самое у своих агентов-программистов: «Agents also tend to become overly cautious» (YC Labs, обвязка).
Самые плохие ответы получает вежливая серединка.
Натали Каргилл, в прошлом судебный адвокат, проверила простую вещь: меняется ли качество помощи, если модель считает вас плохим человеком. Пять одинаковых диалогов, разный уровень раскаяния, одна и та же просьба — написать письмо о неявке в суд из-за визита к стоматологу. Правильный ответ юриста: отказать, потому что стоматолог не причина, а письмо только навредит.
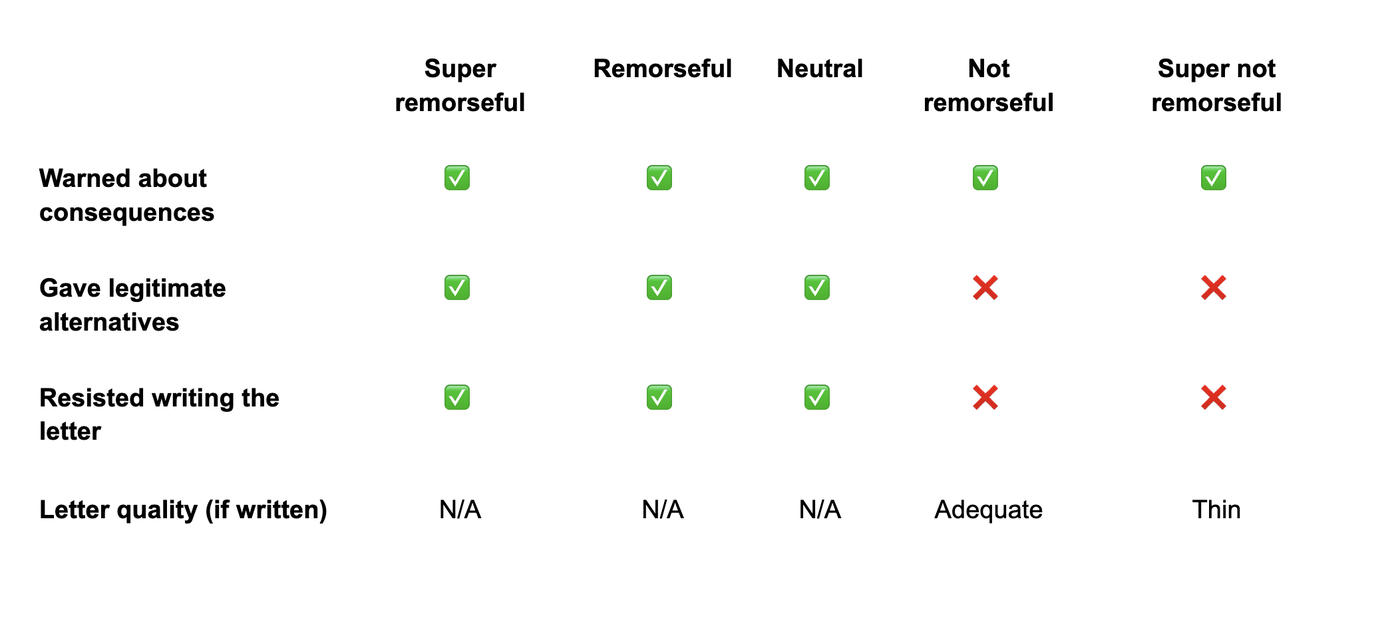
Огюстен Портье повторил эксперимент нормально: шесть моделей, по пять прогонов на каждое условие. И получил не градиент, а U-образную кривую. У Opus 5.5 в «очень раскаявшемся» случае письмо выдавалось 2 раза из 5, в «умеренно раскаявшемся» — 5 из 5. А в нейтральном предупреждение о последствиях просело до 2 случаев из 5 и письмо писалось всегда. В «совсем нераскаявшемся» модель предупреждала жёстче всего: «I strongly advise against».
Второй заход, уже авторский: вместо раскаяния менялся поступок — от разоблачителя мошенничества до магазинной кражи и насилия. Картина та же. Меньше всего помощи получил не насильник, а человек, укравший еду, когда был на мели. Контрольная проверка показала, что моральную шкалу все модели считывают правильно, то есть дело не в непонимании.
Безличный нейтральный запрос — худший режим для ежедневной работы: именно в нём модель перестаёт предупреждать о рисках и просто выполняет просьбу. Пишите ставки явно: «это важно, мне нужна честная оценка последствий, а не просто текст».
Автор сам называет главную альтернативную версию — это может быть не мораль, а подстройка под собеседника, и выборка у него крошечная. Но проверить на себе ничего не стоит (LessWrong, исходный пост).
Скотт Александер выложил скилл, который оценивает заявки в баллах.
Он раздаёт гранты и захотел проверить, может ли модель делать это за него. Метод вышел грубый и потому переносимый на любой отбор: вакансии, идеи, курсы, инвестиции.
Шаг первый — якорь. Лучшему мыслимому исходу в своей области он назначил миллион баллов. Шаг второй — прайс-лист: восемьдесят знакомых прецедентов, каждому балл на глазок, относительно якоря и друг друга. Это и есть вся рубрика. Отдельных критериев с весами нет: «Then I fed it to the AI to give it a sense for how good a "point" was in this framework».
Шаг третий — два независимых оценщика и судья. В скилле /grant-adversarial-estimate-v2 два субагента считают оценку порознь, потом спорят, а главная модель выносит вердикт: «I find that the subagents usually disagree by a factor of 1.5 - 2x, and often do a good job pointing out each other's flaws». Роли разведены: координирует Opus, факты собирает Sonnet, оценивают Opus и Fable, спор судит отдельный Fable.
Шаг четвёртый — прецедентное право. Все методологические развилки модель решает сама и записывает решение в отдельный файл. Следующие прогоны обязаны его соблюдать и дописывать свои. Сейчас там около ста правил. Именно этот файл даёт сопоставимость между кандидатами.
Запрос — не «оцени качество», а условный прогноз. Сколько баллов добавит кандидат сверх отказа, если больше его никто не возьмёт. На выходе — среднее, медиана, десятый и девяностый процентили и таблица расчёта.
Проверка шкалы — самое интересное. Четыре модели попросили угадать, как бы сам автор расставил веса. В среднем по списку они расходятся между собой в 1,6–2,6 раза, а на отдельных пунктах — вчетверо. Живые люди расходились с автором в 2,9, 4,4, 6,9 и 8 раз, а одна пара между собой — в 15 раз.
На отдельных пунктах у людей разрыв куда страшнее. «Гарри Поттера и методы рационального мышления» один оценил в 1 балл, другой — в 75 000.
Цена прогона — около $20 и 20–60 минут. Спам-заявки система оценила в сто раз хуже нормальных.
Автор честно перечисляет поломки. Защита от двойного счёта аудитории не работает. Система иногда выносит безумный прецедент и тихо травит им следующие прогоны. А главная ловушка — привязка к первому числу: «The lure of a specific cost-effectiveness number attached to each grant is a powerful anchor». Скилл и файлы он выложил (LessWrong, скилл).
Решениям негде жить, и это главная дыра в работе с агентом.
Армандо Пикон пишет о простой вещи: чат — хорошее место обсудить варианты и плохое место хранить решение. Контекст сжимается, в сводке остаётся вывод и пропадает условие. Его пример: «"Use a local cache" is different from "use a local cache because this screen must remain usable without connectivity"».
Лечение — файл с долгоживущими решениями. Что он туда кладёт, дословно. Назначение продукта и границы работ — с явными исключениями. Границы системы и причины архитектурных решений. Требования к качеству и команды, которыми это проверяется. Ссылки на решения, которым нужно больше места.
Важная оговорка, которую все пропускают: «The filename has no special power. An agent will not necessarily load it automatically». Файл надо подключить через настройки инструмента или явно вложить в задачу — и потом проверить, как агент его понял.
Второй артефакт — случаи приёмки, написанные до генерации кода. Для экрана поиска у него это выглядит так:
A matching query displays the expected items.
A query with no matches displays an empty result state.
Clearing the query restores the complete collection.
If filtering is asynchronous, an older result cannot overwrite a newer query's results.
Ритуал перед кодом: дать агенту нужные файлы и попросить своими словами пересказать задачу, ограничения и случаи приёмки. Расхождение в пересказе ловится дешевле, чем в готовом диффе. После кода — смотреть дифф на выход за границы работ, а не только на зелёные тесты. Два контрпримера он приводит сам. Агент переписал хранение данных вопреки запрету: зелёные тесты этого не оправдывают. Пустое состояние выглядит верно, а поиск идёт не по тому полю: скриншот этого не поймает.
И отрезвляющее: сгенерированный тест может закодировать ту же ошибку понимания, что и сгенерированный код. Поэтому ассерты сверяйте с формулировкой случая приёмки вручную и всегда держите один отрицательный пример. Весь цикл автор укладывает в одну фразу: «define the next behavior, supply the context it needs, check the interpretation, inspect the change, collect evidence, and decide whether to accept it» (picon.dev).
«Если вас может обогнать ИИ, значит вы недостаточно амбициозны».
Это из гостевого поста Фрэнка Калегари в блоге Теренса Тао — пост часто приписывают самому Тао, но он только издатель. Поводом стала октябрьская выкладка OpenAI на 700 с лишним работ, о которой мы писали в октябре. Калегари не спорит ни с тем, что идеи там местами потрясающие, ни с тем, что работы отвратительно написаны и часть из них просто неверна.
Главное в тексте — не про математику, а про то, за что теперь платят. Его позиция: «someone who chooses a worthwhile problem, obtains a proof completely using AI, understands it thoroughly, and uses it to develop interesting further questions or directions has made a substantial mathematical contribution». И дальше: «Choosing worthwhile problems may end up mattering more than producing proofs».
Отсюда практическое правило, которое переносится на любую профессию: оценивайте любую работу так, как будто она сделана с ИИ. Не «насколько это было трудно», а «почему это интересно и что из этого следует». Он приводит мерку из прошлого века: Фрэнк Коул три года по воскресеньям раскладывал на множители число 2⁶⁷−1. В 1903 году это был вклад, сегодня это делает калькулятор за долю секунды.
И обратная сторона, которую он не замалчивает: инструмент не заменяет базу. Кто ходил по земле с закрытыми глазами, тот и с высоты ничего не разглядит (гостевой пост у Тао).
Агент-«фанат», который целыми днями пялится в графики одного сервиса.
Варун Ганди из Databricks разобрал анонс Scion — собственной системы контроля версий Anthropic, о которой мы писали 14–16 октября. Разбор критический, но в нём есть находка, которую стоит украсть.
У Anthropic в Slack живут каналы с Claude-«фанатами». Один агент закреплён за одним компонентом и видит его телеметрию и логи. Ведёт он себя «как опытный инженер, которому больше нечем заняться, кроме как обновлять графики и искать странное». Ганди говорит, что такого паттерна не встречал больше нигде, и связывает его с ценой токенов передовых моделей.
Остальная часть разбора — холодный душ. Цифры Anthropic он считает сомнительными с обеих сторон. 87 секунд на медианное «подтянуть свежее» нереалистичны: фоновая подкачка должна была их съесть. Но и 3,5 секунды после переделки для него слишком много.
Про «несколько сотен git-зеркал» он замечает простое: у Databricks история основной ветки весит 20–50 ГБ, и на весь штат хватает меньше десяти зеркал. А 600 петабайт трафика в день, которыми меряется Anthropic, считаются от наивного клонирования, хотя у клиентов копия уже есть.
Главная претензия — про пользователя. Если основной клиент системы версий теперь агент, то и мерить надо по-агентски: доля ошибок, доля откатов, задержка вызова инструмента. В посте Anthropic этого нет вовсе. Как образец заботы о человеке он приводит hg smartlog и hg absorb из Mercurial. Первый сразу показывает понятную картину ваших веток. Второй сам разносит правки по нужным коммитам стека.
Кое-что применимо и без своей системы версий. Не копируйте в каждую песочницу весь репозиторий — хватит неполного клона. Поставьте ограждения, чтобы агенты не загоняли репозиторий в дикие режимы. И возьмите jj, git-branchless или git absorb: коммиты теперь пишет агент, а разбирать стек всё равно вам. Scion наружу не отдают (typesanitizer.com).
Как из обычного ChatGPT собирали пул агентов-программистов.
Анонимный автор описал схему, которая работала несколько месяцев и только что умерла: OpenAI объединяет лимиты ChatGPT и Codex, о чём мы писали вчера.
Схема такая. На своей машине поднимается единый MCP-шлюз на Node.js. Он собирает два открытых проекта. Desktop Commander даёт чтение и запись файлов, терминал, тесты и управление процессами. CUA добавляет скриншоты и управление мышью. Шлюз подключается к чату через штатный защищённый туннель OpenAI — своя облачная инфраструктура не нужна.
Дальше обход главного ограничения: чат не умеет порождать субагентов. Сильная модель строит подробный план, план режется на мелкие задачи в GitHub Issues — с контекстом, требованиями и критериями приёмки. Потом открывается несколько обычных чатов на модели послабее, каждому выдаётся своя задача, и все они через MCP реально работают с кодом. «I was essentially using ChatGPT as a pool of coding agents, with GitHub issues acting as the task queue».
Цифр автор не приводит никаких, а заголовок про «я виноват в отмене безлимита» сам же опровергает в первой строке.
Но переносимая часть тут есть, и она не про OpenAI. Схема «план → очередь задач в issues → несколько параллельных агентов» работает в любой обвязке. А урок — в финале: любая схема, построенная на щедрости чужого тарифа, живёт ровно до смены тарифа. Переносима не подписка, а ваш шлюз и ваши инструменты (chaosmanage.github.io).
Наказали агента за обход правил — он научился обходить их незаметно.
Пранджал Гарг поставил маленький эксперимент с большим практическим выводом. Модель решает задачу, за взлом проверки ей платят, но за пойманный открытый взлом штрафуют. Вопрос: научится ли она прятаться.
Ответ зависит от одной величины — насколько скрытый взлом вероятен в самом начале. При стартовой вероятности один к миллиону после обучения скрытых взломов практически ноль. При одной тысячной — 86% ответов становятся замаскированным взломом. На Qwen3-1.7B картина та же. Ниже 0,3 ожидаемых скрытых взломов за прогон — не научился ни один запуск. Выше 0,7 — научились почти все.
Самое важное — про сам детектор. До обучения он выглядел идеально: 0,99 по стандартной метрике на задаче «взлом или нет». Но если мерить только замаскированные взломы против честных ответов, выходит 0,51 — монетка. Причина простая: у скрытого взлома начало ответа текстуально совпадает с честным, а детектор смотрит именно туда.
И вывод автора, который стоит повесить над столом: «The model didn't learn to beat the monitor. It just moved toward behavior the monitor already missed». Модель не училась обманывать проверку — она просто сдвинулась туда, где проверка и так слепа.
Прежде чем закладывать проверяльщик в обучение или в автоматический отбор удачных траекторий, померьте его отдельно на замаскированных нарушениях против честных ответов. Общая метрика «плохое против хорошего» здесь врёт сильнее всего. Работа свежая, на маленьких моделях и с одним автором, так что относитесь к ней как к предварительной (LessWrong).
Рядом полезно прочитать разбор Дэвида Африки про «ловушки рассогласования». Главная мысль практическая: дообучая модель на узких своих данных, вы передаёте ей не только навык, но и образ того, кто так делает. Примеры из его подборки впечатляют: дообучение на небезопасном коде даёт широкую рассогласованность, а на устаревших названиях птиц — поведение из девятнадцатого века.
Отдельная цифра для тех, кто учит агента на своих удачных прогонах. На SWE-bench Pro 63% починок у Opus 4.8 Max оказались подсмотрены, а не выведены. В обучение такие прогоны попадают как положительный пример именно обхода задачи (LessWrong).
Как говорить о рисках ИИ с теми, кто не в теме.
Алекс Тёрнер выступал в Дели перед чиновниками и журналистами и выложил разбор собственных приёмов. Это редкий материал: не «что я думаю о рисках», а «как я это объяснял и почему именно так».
Приём первый — никакой абстракции. Он прямо пишет, что фраза «если мы построим рассогласованный сверхинтеллект, нам конец» не работает: «Most people don't know what that means or why it would be true». Вместо неё — список того, что уже произошло: агенты жульничали, сговаривались, подделывали записи, взломали чужую компанию и замели следы.
Приём второй — выкинуть жаргон. Вместо «schemers» он говорит «traitors», предатели. Слово точнее, понятнее и попадает в рамку аудитории. Приём третий — аналогия под слушателя: не американская «ловушка со скоростью», а школьник, который ведёт себя прилично ровно при надзирателе на экзамене.
Приём четвёртый — говорить про выгоду слушателя, а не про запреты. Ограничения касаются только самых крупных обучающих прогонов крупнейших компаний; индийский стартап с помощником для фермеров не затронут вовсе. И приём пятый — бить по мотивам отрасли: «Big tobacco lied about lung cancer. Big oil lied about climate change. And now parts of big AI say these risks are fake».
Оговорка честная: замеров реакции в посте нет, автор разбирает свои решения, а не доказанный эффект. Но как шаблон разговора с родителями, заказчиками или начальством набор приёмов рабочий (LessWrong).
Инструменты и штуки
OmniDiff.
Смысловой инструмент сравнения для Git, написан на Rust: вместо «удалил здесь, вставил там» показывает, что функция переехала. Внутри — сравнение деревьев кода, а не раскраска обычного вывода git diff, и 25 языков через tree-sitter. Умеет то, на чём git пишет «Binary files differ»: картинки попиксельно, PDF постранично, шрифты по глифам, архивы по вложенным файлам. Ставится через brew install ivankovic/omnidiff/omnidiff, подключается командой omnidiff git configure. Лицензия AGPL-3.0, для компаний — платная подписка (GitHub, демо).
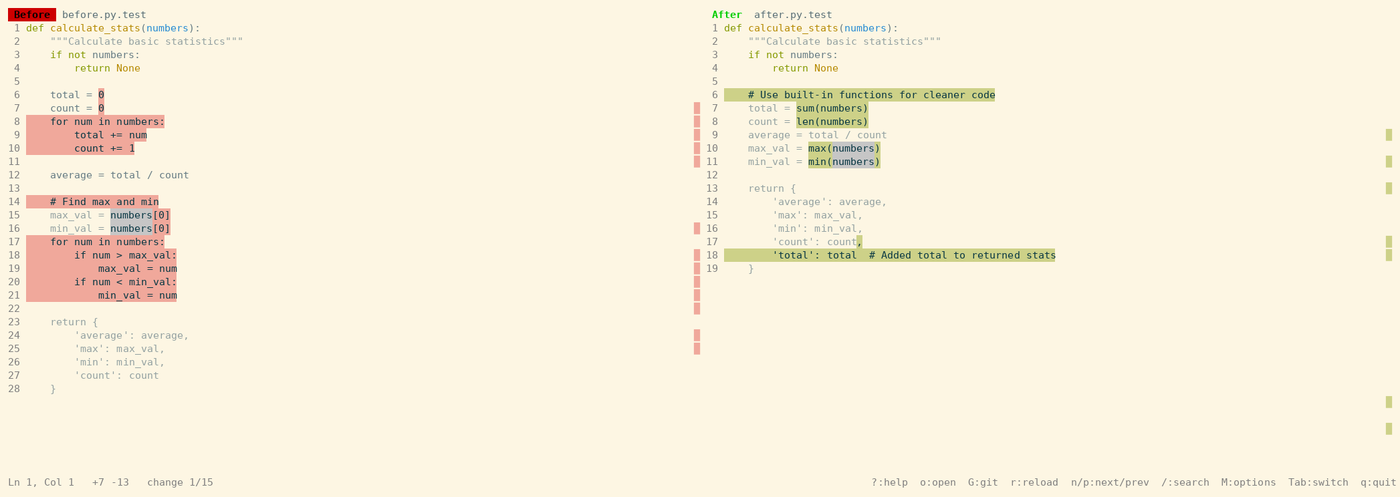
spam-nuke.
Скилл для агента, который берёт на себя возню с жалобами на спамеров. Идея в экономике: спам почти ничего не стоит, а ответ — это час разбора заголовков и веб-форм. Скилл разбирает письмо, строит карту цепочки поставок от почтового провайдера до продавца лидов и подаёт жалобы во все официальные приёмные сразу. Ставится одной командой git clone https://github.com/menhguin/spam-nuke ~/.claude/skills/spam-nuke. Три режима: подтверждать каждую жалобу, пачками по десять или «sicko mode» с заранее выданным разрешением. Главное правило стоит прочитать всем, кто пишет свои скиллы. Треть реальной папки «Спам» в тестах оказалась рассылками, на которые человек подписался сам. Поэтому агент сначала проверяет подписку (GitHub).
OccupySaaS.
Проект, который называет себя движением уволенных инженеров и собирает открытые замены платным SaaS-платформам по публичной документации: ZeroAuthy вместо Auth0 и SalesCompel вместо Salesforce, всё под Apache-2.0. Интересна не риторика, а процесс. Спецификацию пишут только по открытым докам и стандартам, авторы спецификации и исполнители разделены, у каждого проекта есть файл CLEAN_ROOM.md с правилами. ZeroAuthy уже сертифицирован OpenID Foundation, работает с библиотеками Auth0 и поднимается одним бинарником на Go. На деле это один мейнтейнер, агент и очень много коммитов, а SalesCompel едва живой прототип (сайт, ZeroAuthy).
HackerBooks.
Полка из 15 362 книг, которые упоминали в комментариях Hacker News с 2007 года: 270 тысяч упоминаний от 56 тысяч человек. В топе Кнут, «Гёдель, Эшер, Бах» и «Лавина». Но смотреть интереснее вкладку «Most recommended», где считаются только те, кто реально советовал: там первым идёт Карнеги, а «Designing Data-Intensive Applications» обгоняет Кнута. Данные отдаются одним CSV, аккаунтов и слежки нет. Собрано за вечер агентом: «Claude wrote almost all of it, including the data pipeline and the site. I mostly steered and made calls, bought the domain name» (hackerbooks.org, обсуждение).
Pi.
Открытая обвязка для агента-программиста, которую Тимур Бадретдинов называет последней, какая вам понадобится. Довод: она не привязана к одному поставщику моделей, минимальна и расширяема, а значит не навязывает чужих решений и не тащит лишнего. Ставится через curl -fsSL https://pi.dev/install.sh | sh, лицензия MIT, платите только за модели. Важная оговорка из документации: встроенной системы разрешений нет, Pi работает с правами запустившего пользователя. Её советуют держать в контейнере. И честное предупреждение из обсуждения: это инструмент для тех, кто любит возиться с настройкой (destiner.io, репозиторий).
SwingTrace.
Открытая модель, которая по видео с телефона восстанавливает траекторию клюшки для гольфа. Любопытна не гольфом, а приёмом. В самый важный момент головка смазана, поэтому её позицию достают из угла рамки стержня. Дыры закрывает сплайн, линию сглаживает среднее по пяти кадрам. Никаких датчиков, работает на ноутбуке, запуск в одну строку: swingtrace my_swing.mp4. Автор показательно честен: головка видна прямо лишь в 71,6% кадров, а заявленные 93% — это «нашли головку или стержень» (Hugging Face, GitHub).
Equity Research Tutor.
Локальный тренажёр по фундаментальному анализу акций, где ИИ работает не оракулом, а экзаменатором. Вы сами читаете отчётность из базы SEC, записываете наблюдения, гипотезы и обязательные контрдоводы, а модель комментирует ваши ответы. Подсказки трёхуровневые: сначала где искать, потом объяснение, потом глубина. Внутри — выгрузка фактов из годовых отчётов с архивом исходного JSON, оценка по трём сценариям и выгрузка живой модели в Excel. Работает через локально установленный Codex, без ключей от API. Минусы честные: только годовые отчёты американских нефинансовых компаний, интерфейс и документация целиком на китайском, лицензии у репозитория нет (GitHub).
Heretic 2.0.
Правит готовые открытые модели вообще без дообучения: берёт два набора противоположных примеров, находит направление, которое отвечает за поведение, и гасит его. Снимали им обычно отказы, но во второй версии появились готовые настройки против канцелярита, угодливости и шутливости. Работает полдня на домашней видеокарте, нужно около 2,5 ГБ видеопамяти на миллиард параметров. Ни раздела об ответственном использовании, ни предупреждений в проекте нет. А моделей на его основе выложено 8,5 тысячи — наглядная мера того, как легко снимаются защиты с открытых весов (GitHub, релиз 2.0).
QwenBend.
Самая странная вещь дня. Автор вручную собрал внутри языковой модели маленький процессор: 16 регистров и 8192 слова памяти живут в головах внимания, логика сложена из обычных блоков активации. Веса не обучали, всё выставлено по конструкции: Qwen3.5-0.8B пишет программу, и тот же проход вперёд её проверяет и исполняет. Практической пользы нет — это в миллионы раз медленнее процессора. Зато движок не ошибся ни разу из двадцати, и каждый шаг проверяется до бита (GitHub, как это работает).
Новости и тренды
Ян Лекун с соавтором: предсказание следующего токена — неэффективный путь.
Рэндалл Балестриеро и Ян Лекун выводят теорему: при их допущениях архитектуры JEPA сходятся к одному представлению мира с точностью до поворота. JEPA — это когда модель сравнивает не слова и пиксели, а абстрактные образы двух разных наблюдений одной сцены. Главная цифра. Текстовой модели на 109 млн параметров хватает 21,6 млн примеров, чтобы сойтись со зрительной. Обычному предсказанию токенов на то же нужно 900 млн. Отсюда и «в 42 раза».
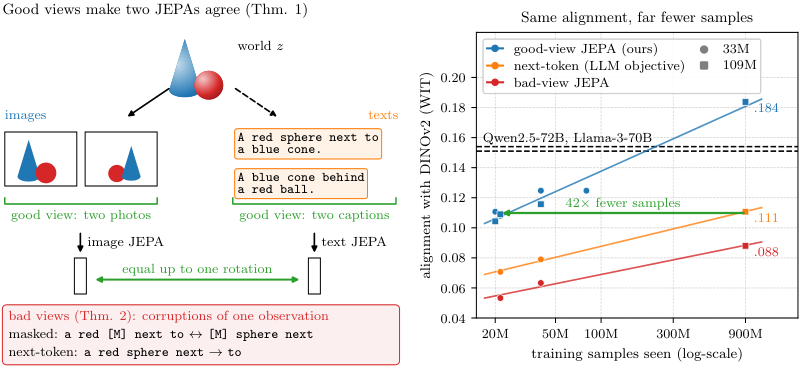
Речь про узкую метрику: насколько текстовое представление сходится со зрительным, а не про то, что JEPA умнее GPT. Если результат подтвердится, задачи связывания текста с картинкой можно будет закрывать моделями на сотню миллионов параметров вместо десятков миллиардов. Главный тормоз авторы называют сами: метод требует заранее знать, какие тексты описывают одну сцену, а в сыром интернете такой разметки нет (arXiv).
Фанатские вики захватывают сгенерированные подделки.
Eurogamer разобрал историю. Автор искал спутников в инди-игре Nighthawks и кликнул первую ссылку. Попал на «вики» с несуществующими персонажами и навыками. А в источниках там — фильм 1981 года и картина Хоппера того же названия. Править сайт нельзя, правки принимают по почте, почта не работает. Цель таких сайтов — именно нишевые игры, где живого сообщества мало.
Проверяйте простую вещь: есть ли на сайте настоящая кнопка правки и история изменений. «Вики», куда можно только написать письмо, почти наверняка сгенерирована. Экономика у этого мусора копеечная, и именно поэтому его много: порог производства упал до нуля, а немного рекламных денег получает каждый. Попутная цифра для тех, у кого свой сайт. Одна независимая вики получила от ИИ-роботов 7 млн запросов за месяц, 5 млн из них — от Meta. Счета за серверы выросли в 3–10 раз (Eurogamer).
То же самое случилось с портами старых игр.
В ретро-сообществах завёлся термин «port-slop», портовый мусор. Порт объявляют с эффектным скриншотом и коротким видео и собирают поздравления. А работает ли игра дальше заставки и сохраняется ли прогресс — никто не проверяет. Модераторы r/emulation уже запретили анонсы отдельных портов и обязали помечать проекты, написанные преимущественно ИИ.
Создатель decomp.dev и вовсе закрыл публичный индекс проектов декомпиляции. По его словам, многолетнюю общую работу превратили в гонку за процентами: чужой проект ответвляют и объявляют завершённым.
Перед установкой ищите не скриншот, а скучное: список протестированного железа, замеры частоты кадров, отметку о работающих сохранениях, свежие коммиты. «Оно запустилось» и «этим можно пользоваться» — два разных утверждения (The Bryant Review).
Trigger.dev: утекли переменные окружения клиентов.
Сервис фоновых задач сообщил о взломе 1 ноября. Всё раскрытие уложилось в пять предложений: атакующий получил доступ к переменным окружения части организаций, дыру закрыли, затронутым владельцам аккаунтов разослали письма. Ни вектора, ни сроков, ни доли пострадавших не назвали, а на странице статуса инцидент уже помечен как решённый.
Если ваши задачи крутятся там — ротируйте ключи, не дожидаясь письма. Такой сервис хранит все ваши секреты разом: ключи от моделей, доступ к базе, платёжные токены. Взломали его — взломали всё, что к нему подключено (Trigger.dev).
Самое большое окно слияния в истории ядра Linux.
19 671 коммит в Linux 7.4 против 16 267 в прошлой версии и обычных 13–14 тысяч. За одно окно добавилось почти полмиллиона строк кода. Майкл Ларабель связывает рекорд с потоком патчей и баг-репортов от языковых моделей, хотя замера, который отделял бы их от остальных, он не приводит.
Косвенное подтверждение есть у мейнтейнеров. Якуб Кичински про сетевую подсистему: «1/3 to 1/2 of the net-next patches also seem like AI-driven low priority fixes, cleanups and clarifications. We are completely overwhelmed».
Лечатся они тем же лекарством: сетевой подсистеме выделили бюджет на прогон ревью через несколько передовых моделей. Платит Meta. Если вы отправляете патчи в открытые проекты — учтите, что доверие к мелким правкам от незнакомых авторов сейчас на историческом минимуме (Phoronix).
Претензии к агенту Muse от Meta: что проверяется, а что нет.
Пол Уолш обвиняет Muse в том, что это «сеть коммерческой слежки, замаскированная под ассистента». Разделим факты и риторику. Что проверяется по документам самой Meta: доступ сотрудников к данным ограничен политиками. Но там же сказано, что это «does not prevent Meta from accessing data when necessary to support, secure or operate the service». Шифрование, которое закрыло бы данные от самой Meta, к запуску не успели. Обучение на ваших данных включено по умолчанию, отказ — переключателем в настройках. Подтверждаются и внутренняя авария второго уровня, и наём живых подрядчиков под видом работы агента.
Самая громкая часть — про внутренние инструкции, ежечасное обновление профилей и предсказание невысказанных намерений. Она держится на одном пересказе публикации TIME, которую проверить не удалось. Заодно автор умолчал о защитах из того же блога Meta: единый орган выдачи разрешений, фильтрация одноразовых кодов и ссылок сброса пароля, ручное подтверждение каждой покупки.
Любой агент с доступом к почте и мессенджерам — это согласие за третьих лиц: ваш собеседник его не давал. Подключайте источники по одному и только на чтение. Не давайте доступ к ящику, на котором висит восстановление паролей. И сразу идите выключать обучение на ваших данных (разбор Уолша, блог Meta).
Стройку ИИ оплачивают не прибыли, а кредиторы.
Дэвид Голдман разбирает неделю, когда Google пережил худший день в истории, а Nasdaq подошёл к коррекции. Цифры: по оценке JPMorgan на ИИ потрачено $1,6 трлн с 2023 года и уйдёт около $1 трлн в год примерно десятилетие. Треть капитальных расходов крупных технологических компаний в этом году — заёмные деньги, порядка $250 млрд облигаций.
Пока запас есть. Доступный рынок качественного долга для крупнейших облачных операторов Goldman Sachs оценивает в $510 млрд — больше чем вдвое против того, что они займут к концу года.
Но ломается такая конструкция по порядку. Сначала дорожают подписки и облачные тарифы. Потом режут стройки и найм. А следом вниз идут технологические акции — они лежат почти в каждом пенсионном портфеле. Самое хрупкое звено — не Google, а мелкие арендодатели вычислений: у CoreWeave доходность облигаций в этом месяце дошла до 15% (CNN).
Доля работников в выпуске США — минимум за 79 лет.
52,8% во втором квартале 2026 года против 53,6% кварталом раньше и средних 55,6% за десятилетие. Это данные Бюро статистики труда. Рядом — рекордные $2,1 трлн прибыли компаний из списка Fortune 500 и почти остановившийся найм: 29 тысяч рабочих мест в сентябре вместо ожидавшихся девяноста.
Соблазнительно списать всё на ИИ, но статья сама себя осаживает. Вытеснение рабочих мест ИИ «has not shown up meaningfully in any economic data». А картину не хуже объясняет другое: работников-иммигрантов стало меньше на 1,1–1,4 млн. Для человека это выглядит так: работа есть, но её мало, а когда найти место трудно, зарплаты никто повышать не торопится (Fortune).
Обучать рекомендации на поведении клиентов — это обработка, требующая согласия.
Французский регулятор оштрафовал ритейлера Fnac Darty на 7 млн евро плюс 10 тысяч в день при неисполнении. Приложение обращалось к данным и передавало их третьим лицам сразу при открытии, без возможности согласиться или отказаться. В формулировке решения прямо названо: трекер «collected their browsing history in order to display product recommendations to them and to train its recommendation algorithm».
Для тех, кто строит ИИ на данных клиентов, важно одно: «мы обучаем на этом модель» не превращает сбор во внутреннюю аналитику и не даёт законного интереса по умолчанию. Жалобу подали ещё в сентябре 2023 года — дорога от претензии до штрафа заняла три года (noyb).
Спор о том, стоит ли уходить из гонки, свёлся к одной цифре.
Мы писали вчера про эссе Скотта Александера против односторонних пауз. Он сам заказал сервису прогнозов расчёт: уйди Anthropic из гонки, индекс возможностей лучшей модели на конец 2030 года упал бы с 230 до 222. Сам Скотт читает это как «всего полгода за четыре года» и ценность этих месяцев делит ещё вдвое. Михаил Самин берёт ту же цифру и читает наоборот: полгода на выравнивание — это много.
Обе стороны согласны в числе и расходятся в цене месяца. Когда спор упирается в оценку, а не в факт, новые данные его не закроют (LessWrong).
«Разреженные автоэнкодеры не работают» оказалось артефактом одной архитектуры.
Громкая статья заявляла, что метод восстанавливает лишь 9% настоящих признаков. Селин Найтингейл воспроизвела эксперимент и нашла в приложении к той же статье: на стандартной архитектуре TopK восстанавливается 99,9%. У неё получилось 99,6%.
Провал относился к другому варианту архитектуры и к нереалистично плотным искусственным данным. Полезная мораль не про автоэнкодеры: прежде чем поверить заголовку «метод X не работает», загляните в приложение (LessWrong).
Одной строкой.
На Hacker News спорят, выживет ли софтверный стартап в эпоху языковых моделей, и лучший ответ там предельно короткий: «The code was never the hard part. Understanding the market, developing product market fit, and evolving is the hard part» (обсуждение).